
ColPaliとは?PDFのページ画像から図表も含めて検索する仕組み

AIの初心者
PDFを検索できるようにしたのに、知りたい内容が載ったグラフを見つけられません。文字は読み取れているはずなのですが。

AI専門家
文字を取り出すだけでは、線の動きや表の行列、注釈の位置関係が検索に伝わらない場合があります。ColPaliは、文書のページを画像として扱い、質問に関係するページを探す方式です。
AIの初心者
では、図表の数値を読み取って、質問への答えまで出してくれるのですか?
AI専門家
ColPaliの担当は、まず根拠になりそうなページを見つけることです。数値の読み取りや回答の作成は、そのページを確認する人や別のモデルが担当します。この役割分担から見ていきましょう。
ColPaliとは。
ColPali(コルパリ)は、PDFなどの文書ページを画像として表現し、自然言語の質問に関連するページを検索する方式です。視覚言語モデルでページと質問をそれぞれ複数のベクトルに変換し、部分ごとの関連度を集めて順位を付けます。文字に加えて図表や配置も検索の手がかりにでき、OCRによる文字の事前抽出を必須としない点が特徴です。
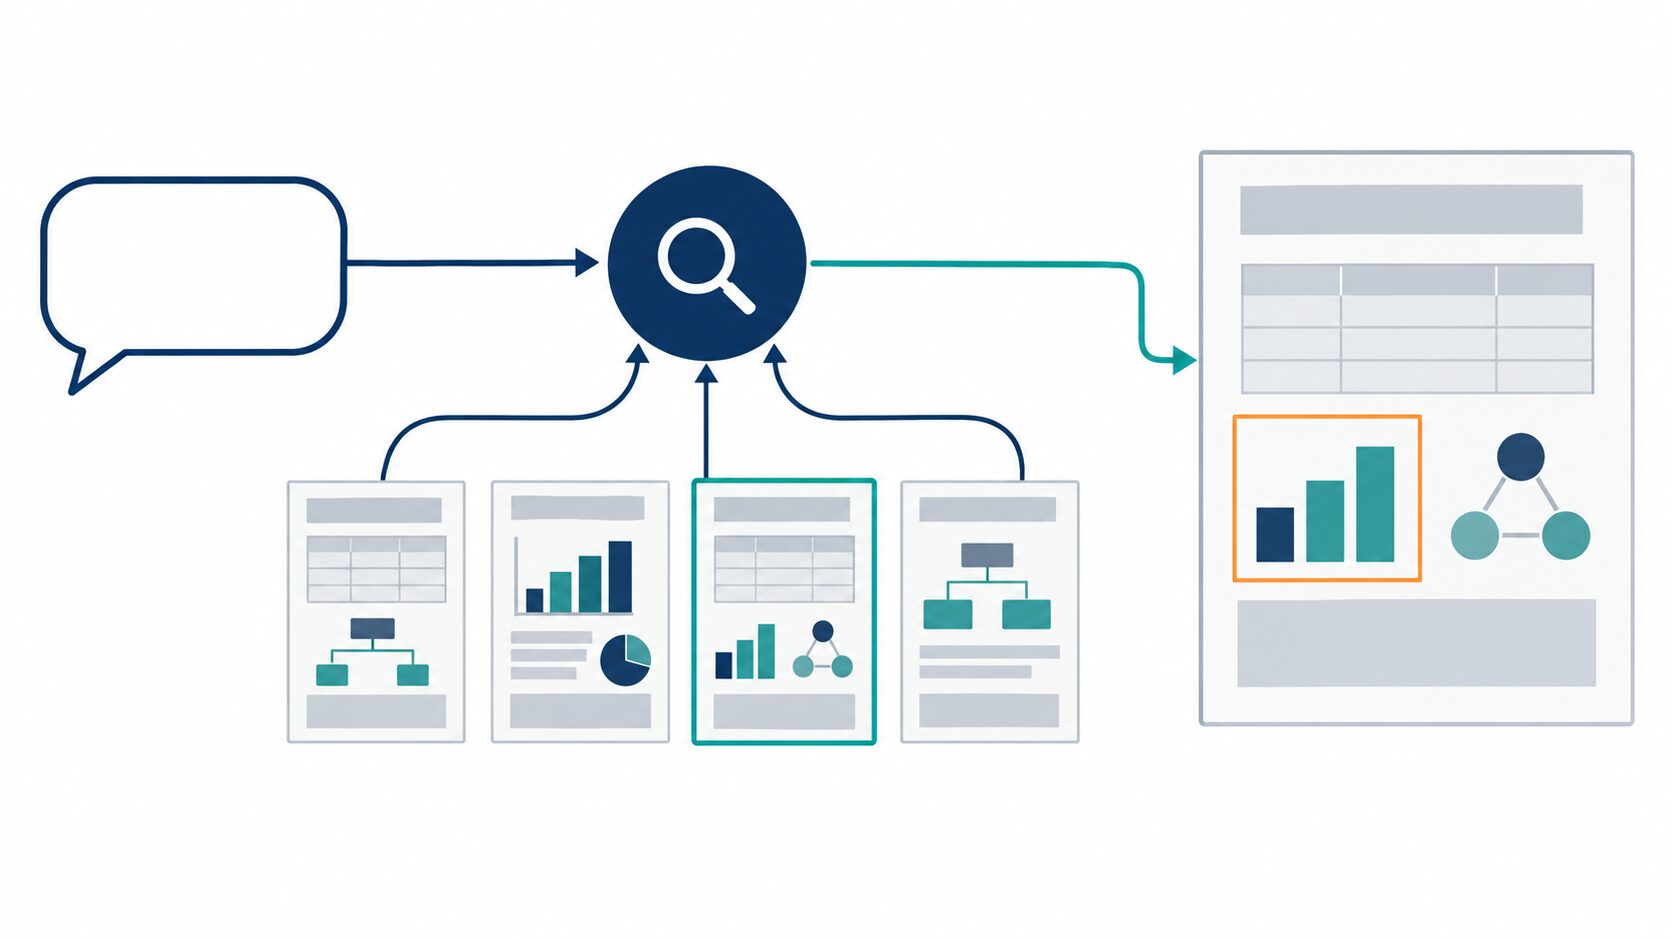
入口は「何を知りたいか」という質問、出口は関連するページです。たとえば決算資料から「売上と利益率の変化が分かるページ」を探すとき、文章だけでなくグラフを含めて候補を選ぶ、という使い方を考えます。
テキストだけでは探しにくいPDFとColPaliの役割
PDF検索の難しさは、文字が読めないことだけではありません。文字を正しく抽出できても、ページ内の関係が失われると探しにくくなります。図表の多い資料では、内容の一部が文章になっておらず、見た目から読み取る必要があるためです。
決算資料の棒グラフを例にすると、「売上」「第1四半期」「第2四半期」という文字は抽出できても、棒の高さが増えたことまで文字列に含まれるとは限りません。利益率の折れ線を重ねた複合グラフなら、左右の軸の単位や凡例との対応も重要です。文字の一覧だけでは、質問が求める変化を捉えにくいことがあります。
表でも、行見出しと列見出しの対応が崩れると、どの数値がどの期間のものか曖昧になります。図の近くにある注釈や、矢印で示された手順も同様です。ColPaliはページ画像を入力にすることで、こうした視覚的な情報を検索に利用する道を開きます。ただし、配置を残せることと、その意味を常に正しく理解できることは別です。
用途としては、図表の多い報告書、プレゼン資料、構成図付きのマニュアルなどが考えられます。資料の中身に合う説明文を人手で付けなくても、ページ画像から検索用の表現を作れる点に価値があります。一方、文章が中心で文字をきれいに抽出できる規程集などでは、通常のテキスト検索も有力です。
ページ画像と質問を複数ベクトルで照合する仕組み
仕組みは、資料を登録する処理と、質問を受け付ける処理に分けると理解しやすくなります。両方で使うベクトルとは、特徴を数値の並びで表したものです。検索では、その数値同士の近さを手がかりに、質問とページの関連度を計算します。
登録時には、まずPDFをページごとの画像に変換します。次に、画像と文章を扱える視覚言語モデル(VLM)を使い、ページの小領域であるパッチに対応する複数のベクトルを作ります。これらをページIDと結び付け、検索用の索引に保存します。画像ファイル自体と検索用のベクトルは別のデータです。
検索時には、質問をトークンという語や文字の断片に分け、その各部分もベクトルに変換します。そして質問側の各ベクトルについて、ページ側で最も類似度の高いベクトルを探し、その類似度を足し合わせてページのスコアを求めます。複数のページでこのスコアを比べ、上位の候補を返します。
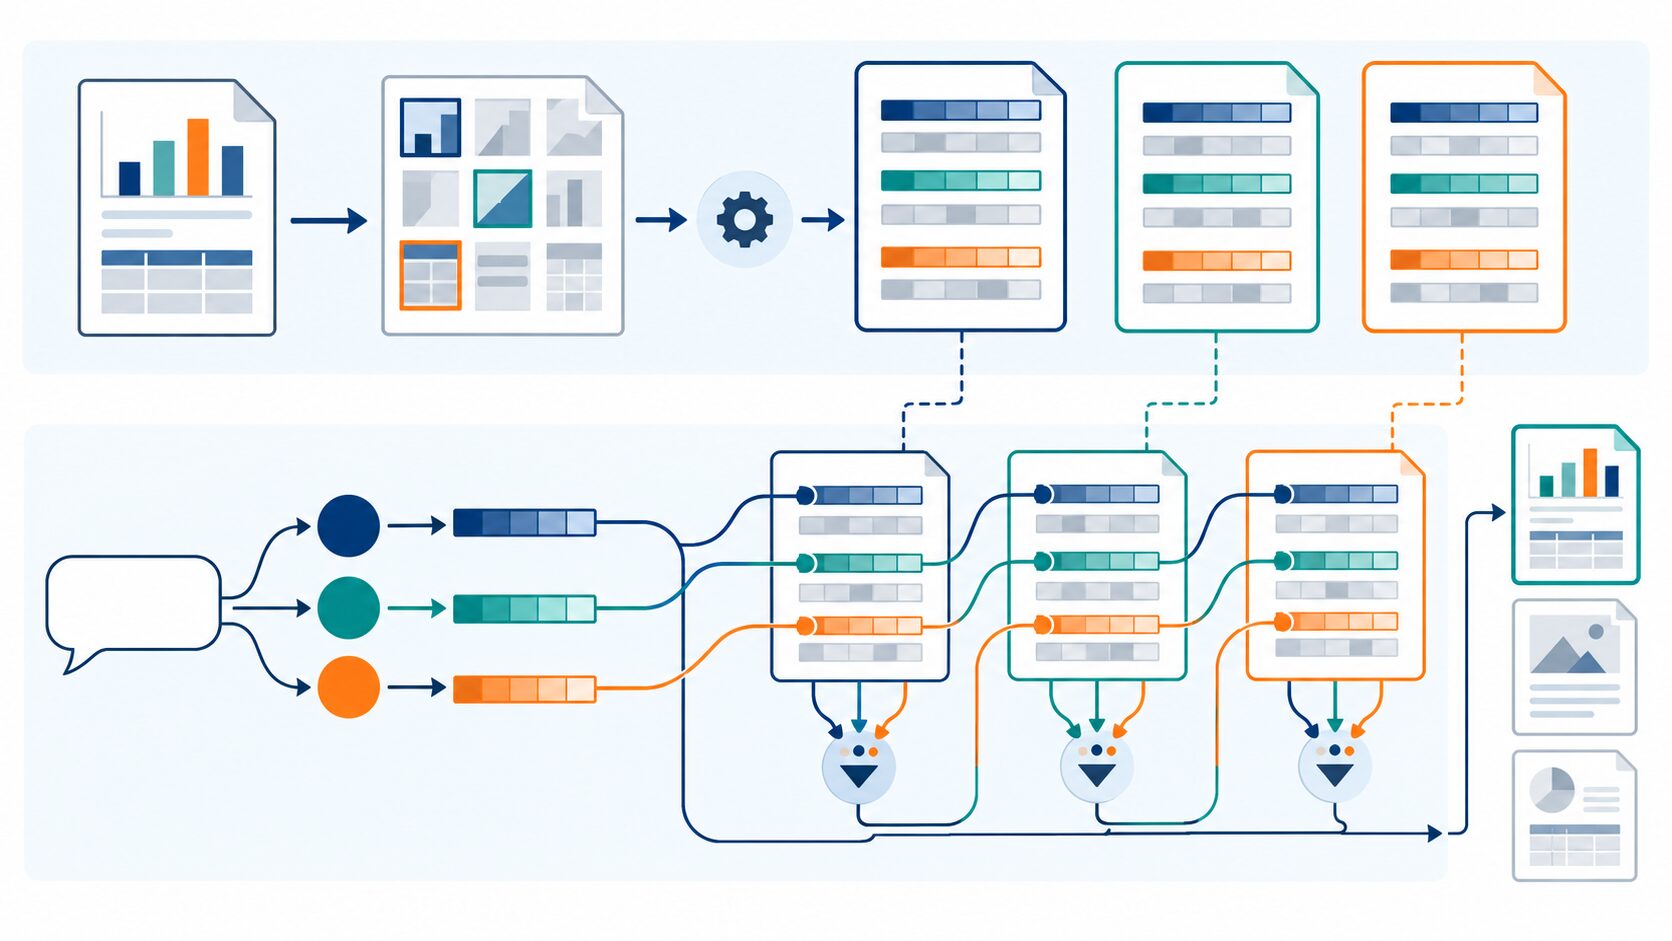
この考え方を遅延相互作用(Late Interaction)と呼びます。ページの表現は先に計算しておき、質問が来た段階で部分同士を照合するためです。ページごとに質問と画像を最初から一緒に処理し直す構成とは異なり、登録済みの表現を繰り返し使えます。
ページ全体を一つのベクトルにまとめる方式に比べ、複数のベクトルを残す方式は、見出し、図、表などの局所的な特徴を照合に使いやすくなります。ただし、各ベクトルが一つの意味や図の部品ときれいに対応するとは限りません。スコアも「このページが正解である確率」ではなく、候補を並べるための指標です。
また、OCR不要という説明は「文字を使わない」という意味ではありません。画像内の文字もモデルにとって重要な情報です。省けるのは検索前に別のOCR処理で文字列を取り出す工程であり、読みにくい文字や低画質の影響までなくなるわけではありません。
OCR・ColBERT・類似画像検索との違い
関連技術を比べる際は、入力だけでなく、何を出力する処理なのかに注目しましょう。OCRは画像から文字を取り出す処理で、ColPaliは質問に関係するページを選ぶ処理です。OCRそのものと文書検索は、処理の段階が異なります。
| 技術・構成 | 入力・処理対象 | 主な出力 | 用途 |
|---|---|---|---|
| OCR | 文字を含む画像 | 抽出した文字列や文字の位置 | 紙資料の電子化、文字の再利用 |
| OCR中心の文書検索 | 質問と、画像から抽出した文字 | 関連する文書や文章の候補 | キーワードや文章の意味による検索 |
| ColBERT | 質問と文書のテキストトークン | 関連度で順位付けした文章など | 複数ベクトルを用いるテキスト検索 |
| ColPali | 質問と文書ページの画像表現 | 関連度で順位付けしたページ | 図表や配置も手がかりにする文書検索 |
| 典型的な類似画像検索 | 参照画像と検索対象の画像群 | 特徴が近い画像 | 似た商品画像や写真の探索 |
OCR中心の検索は、文字を取り出した後に、キーワード検索や意味を比べるベクトル検索を行います。抽出結果が正しければ、製品番号や契約条項の語句を検索しやすく、見つけた文字をコピーして再利用することもできます。表構造や配置を保存する処理を組み合わせる構成もあり、必ず視覚情報をすべて失うわけではありません。
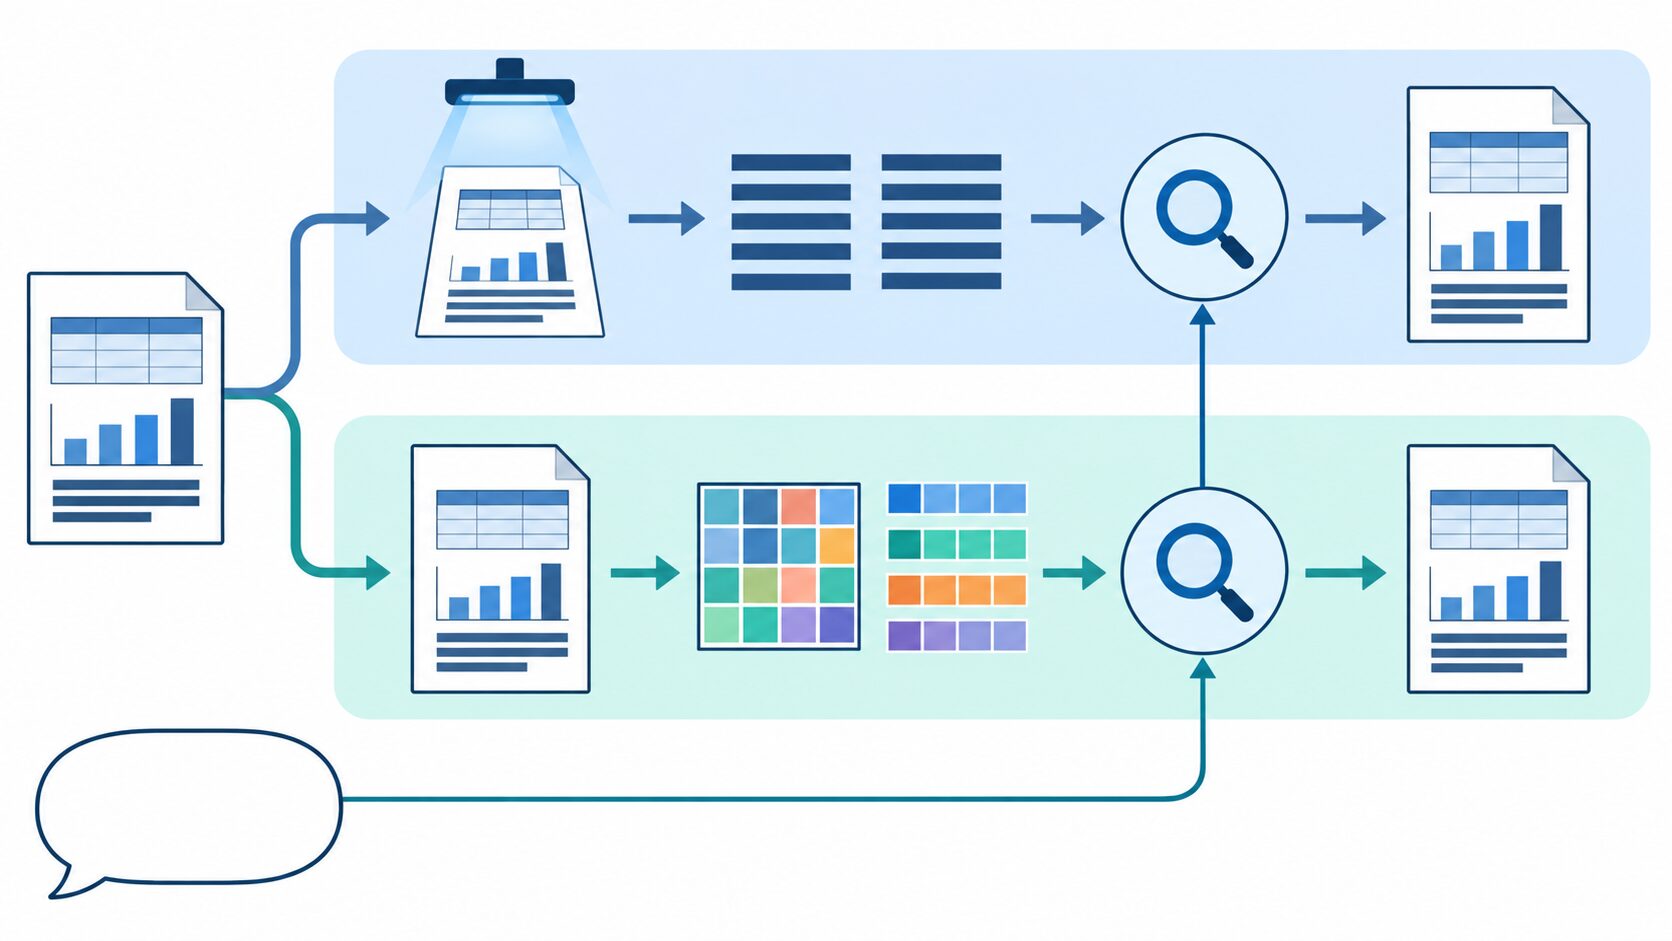
ColPaliでは、ページ画像から検索用の表現を直接作ります。検索のために文字抽出や図表の説明文作成を積み重ねる工程を減らせる一方、抽出済みの文字列が自動的に手に入るわけではありません。ページを探した後に文字データが必要なら、その段階でOCRを加えることもできます。
ColBERTとの共通点は、複数ベクトルを残して遅延相互作用で照合する考え方です。ColBERTが基本的に質問と文章のトークンを比べるのに対し、ColPaliは文書側をページ画像の表現へ広げています。画像を入力できる違いと、照合方法の共通点を分けると整理できます。
類似画像検索には幅広い方式がありますが、「この写真に似た写真を探す」用途と、ColPaliの用途は区別できます。ColPaliが目指すのは、見た目が似たページの収集よりも、言葉で尋ねた内容に関係するページの取得です。文字列の厳密な一致も重視する業務では、キーワード検索と組み合わせる選択肢があります。
決算資料を例に見る検索と根拠ページの提示
架空の企業の決算資料に対し、「売上は増えたが利益率が下がった四半期を示すページは?」と質問する場面を考えます。資料には、業績を説明する本文、売上と利益率の複合グラフ、数値を詳しく示す補足表が別々のページにあるとします。
文字中心の検索では、「売上」や「利益率」という語を含むページが候補になります。しかし、増減の関係がグラフだけで示されていれば、質問と同じ表現が本文にないこともあります。ページ画像による検索では、グラフや凡例、周囲の文字の情報も関連度の判断材料にできる可能性があります。
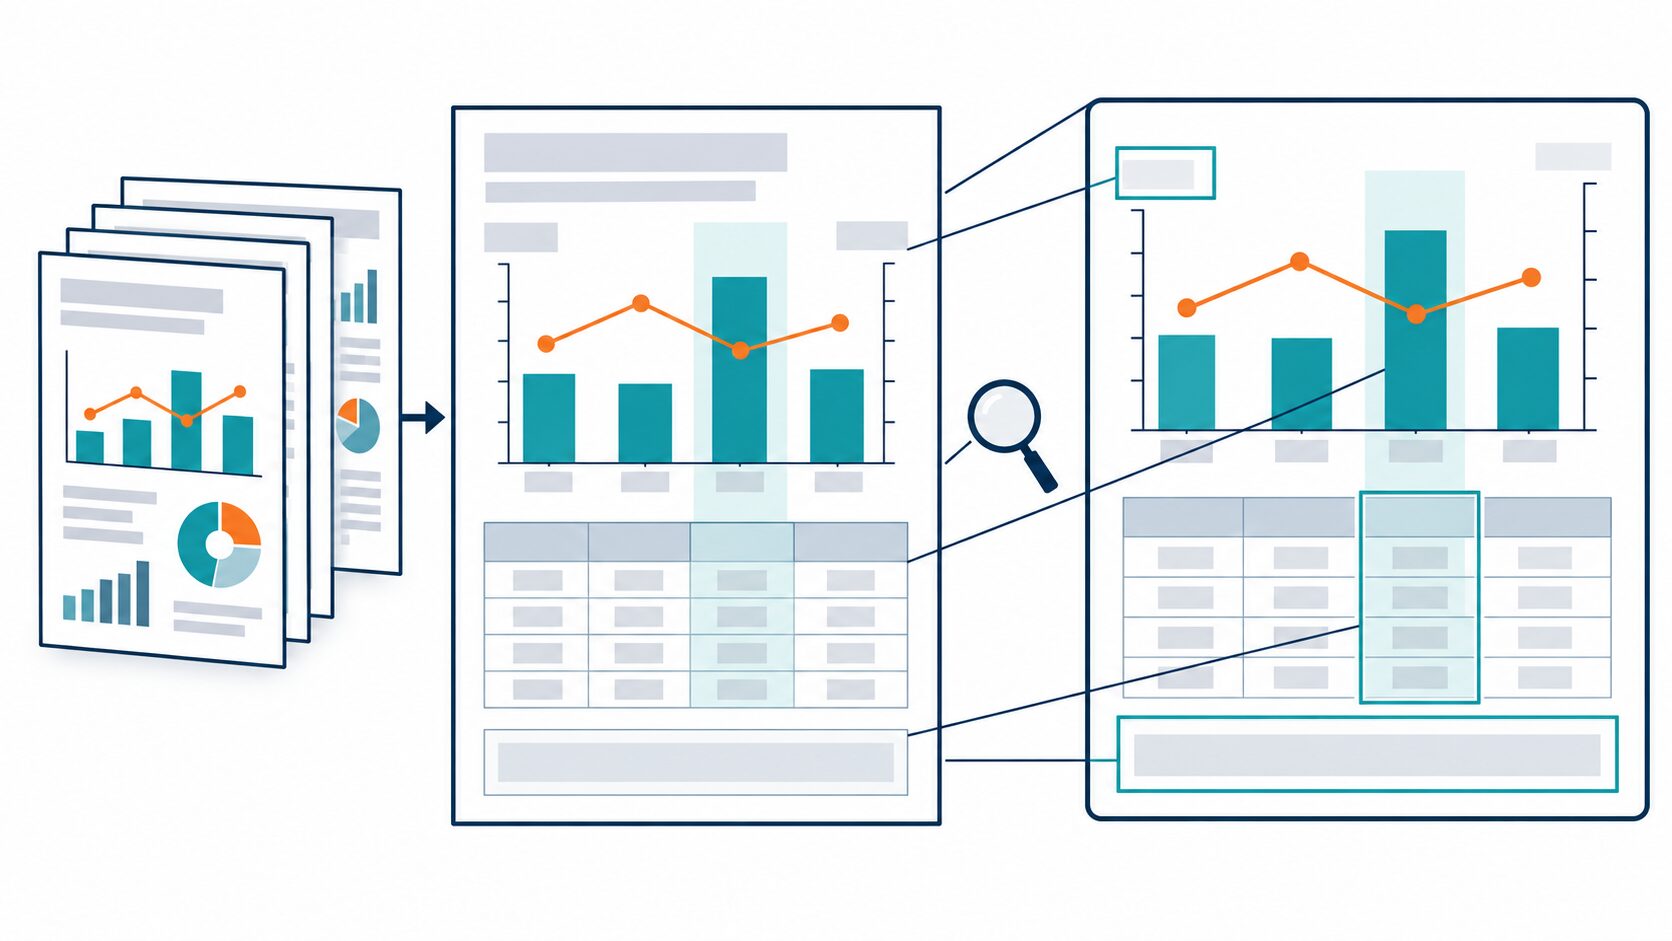
検索画面には、候補ページの画像だけでなく、資料名とページ番号も表示します。たとえば「架空企業・決算説明資料、PDFの12ページ目」のように示せば、利用者は周辺の説明も確認できます。グラフのページと補足表のページを複数提示することで、傾向と具体的な数値を行き来しやすくなります。
この例は利用方法を説明するもので、検索順位や正答を測定した結果ではありません。関連するグラフを取得できても、質問の条件を満たす四半期が確定したことにはなりません。売上の棒と利益率の線がどの軸に対応するか、売上の単位は何か、前年同期比と前四半期比のどちらを比べるかを確認する必要があります。
さらに、利益率が下がった理由まで問うなら、グラフだけでは根拠が不足します。費用や事業構成を説明する文章など、別の根拠も探す必要があります。数値の確認や計算、原因の説明を検索スコアだけで代用しないことが、業務で使う際の基本です。
RAGに組み込むときの役割分担
RAGは、検索して取得した資料を回答生成に利用する構成です。ColPaliを組み込む場合、担当するのは回答の根拠になりそうなページを取得する部分です。検索方式と回答モデルは別々に選び、役割に応じて接続します。
基本の流れは、質問を受け取り、ColPaliで候補ページを取得し、そのページ画像と質問を画像対応の回答モデルへ渡す、という順序です。回答モデルはページの内容を読み取り、根拠を示しながら回答を作ります。テキストだけを受け取るモデルへ画像をそのまま渡しても、この流れは成立しません。
正確な引用が必要なら候補ページにOCRを適用し、数値の計算が必要なら表を抽出して計算処理へ渡す方法もあります。ただし、OCRや表抽出の結果にも誤りはあり得ます。売上と利益率の例なら、抽出した列の対応や単位を確かめた上で、どの期間に条件が成立するかを調べます。
出典を維持するには、登録時からページIDと資料名、版、ページ番号、元ファイルの所在をひも付けます。PDFファイル上の通し番号と、紙面に印刷された番号が異なる資料もあるため、表示のルールを決めておくと混乱を減らせます。回答から元ページへ戻れることが、利用者による確認を支えます。
また、複数ページにまたがる問いでは、検索上位の1ページだけで答えさせると根拠が欠けることがあります。取得する候補数や前後ページの追加を検討し、必要な根拠がそろわなければ回答を保留できる設計にします。正しいページが取れたかと、そのページを使って正しく答えたかは、分けて評価します。
導入前に確認する精度・容量・実装
導入の判断には、実際に使う文書と質問の組み合わせが必要です。公開データでの性能が良くても、社内の日本語資料や、文字の小さいスキャンPDFで同じ結果になるとは限りません。代表的な資料から、正解ページを人が確認できる質問を用意することから始めます。
画質の確認では、画像化した際の解像度、傾き、文字のにじみ、細いグラフ線などを見ます。元画像の解像度を上げても、モデルへの入力時に縮小されれば小さな文字が読めるとは限りません。日本語についても、本文だけでなく縦書き、略語、表の見出しなど、自分たちの資料に含まれる表現で試します。
検索の評価では、正解ページが上位5件などに入る割合、無関係なページの混入、必要なページの取りこぼしを確認します。複数ページが必要な問いなら、そのうち1ページだけ見つけた場合と、必要なページをすべて見つけた場合を分けます。OCR中心の検索とも、同じ資料・質問・候補数で比べると違いを判断しやすくなります。
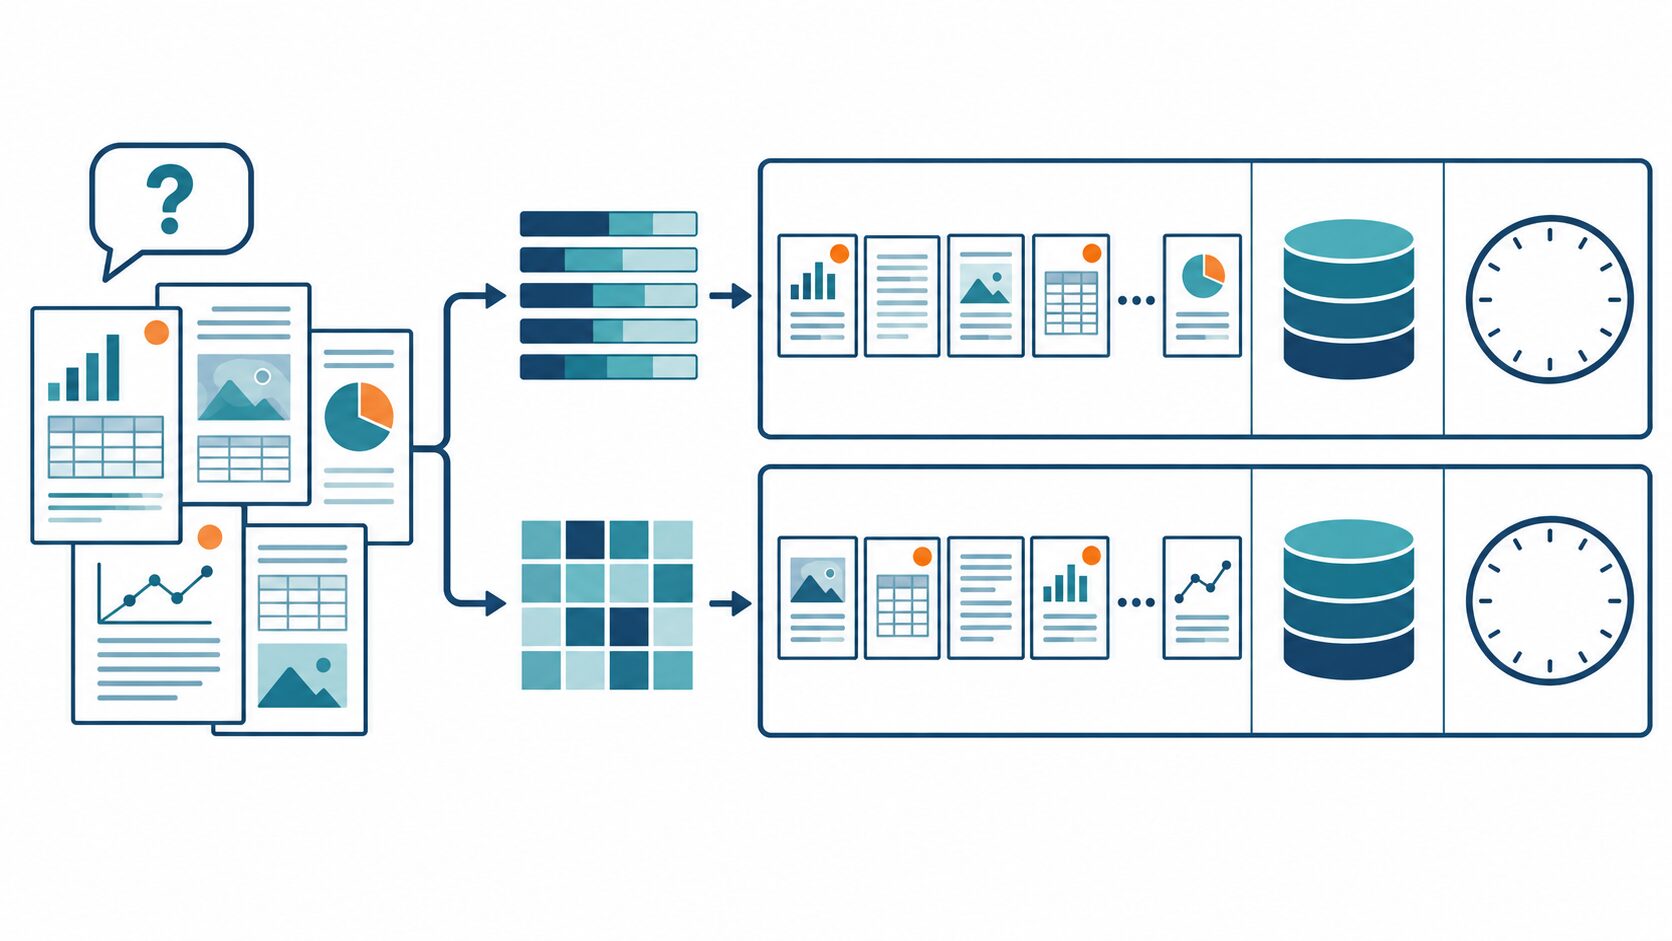
運用面では、複数ベクトルの保存容量と、索引作成・検索にかかる計算量を測ります。同じ条件なら、一つのベクトルを保存する構成より容量が増えやすく、ページ画像の保管も必要です。質問への応答時間と、資料を追加したときの登録時間は別々に確認しましょう。圧縮や候補の絞り込みを行う場合も、検索精度への影響を併せて確かめます。
実装の選択では、原著で提案された方式と、それを使うためのライブラリや後継モデルを区別してください。2026年10月4日時点の事前調査では、公式リポジトリでcolpali-engineが非推奨とされ、新規利用向けにSentence Transformers v6のMultiVectorEncoderが案内されています。実装案内は更新されるため、導入時には公式リポジトリで案内の更新日と対象バージョンを確認してください。
併せて、選ぶモデルの対応言語、必要なメモリ、対応する索引や検索基盤、モデルとライブラリそれぞれのライセンスを確認します。古い実装例をそのまま使う前に、利用するモデルと実装の組み合わせが対応しているかを見ることが大切です。
ColPaliは、図表や配置に意味がある文書から根拠ページを探すための選択肢です。まず手元の資料で「必要なページを見つけられるか」を確かめ、その上で回答生成や文字抽出を組み合わせると、目的に合う文書検索を組み立てやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月6日 | 初回公開 |