
ベイジアンネットワークとは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「ベイジアンネットワーク」とは、どんな仕組みですか?名前が難しくて、何に使えるのか想像できません。

AI専門家
物事の状態を丸と矢印でつなぎ、それぞれの起こりやすさを確率で表すモデルだよ。例えば「雨が降るか」と「地面が濡れるか」を結びつけて、雨の有無によって地面が濡れる確率がどう変わるかを表せるんだ。ただし、矢印を描くだけで原因と結果の関係が証明されるわけではないよ。
AIの初心者
雨が降ったときの予測だけでなく、地面が濡れているのを見て、雨が降ったかどうかを推測することもできますか?
AI専門家
できるよ。地面が濡れているという情報を使い、雨が降った確率を計算し直せるんだ。水まきなど別の可能性もモデルに含めれば、複数の情報を組み合わせて考えられる。観測できた情報から、まだ分からない事柄の確率を推定するのが得意なんだよ。
ベイジアンネットワークとは
ベイジアンネットワークは、確率変数の依存関係を有向非巡回グラフ(DAG)と条件付き確率分布で表す確率モデルです。確率変数とは、「雨が降る・降らない」のように、どの値を取るかに不確かさがある変数のことです。変数同士の関係を図で示し、その関係に沿って確率を計算します。
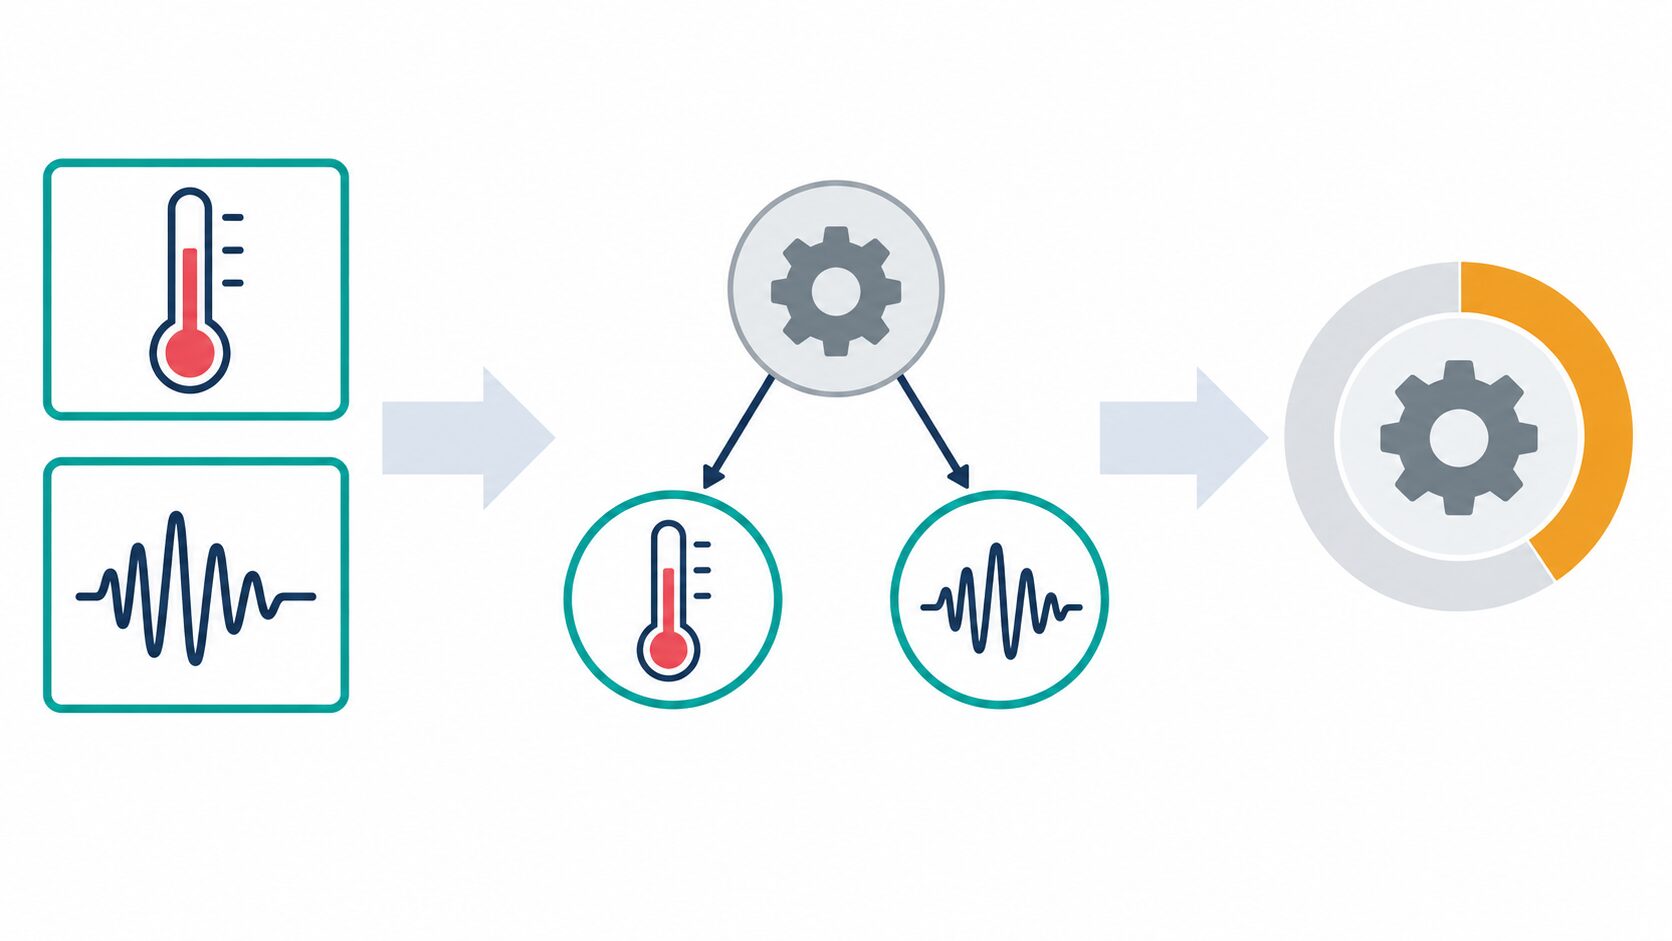
例えば、機械の温度や振動は観測できても、内部の故障箇所はすぐには分かりません。ベイジアンネットワークでは、このような観測情報を手がかりに、故障の候補がどれほどありそうかを求められます。予測だけでなく、複数の候補を比較する診断支援にも使える考え方です。
この記事では、雨と地面の例を使って、図の読み方から確率の更新、モデルの作り方まで順に説明します。ベイズの定理やナイーブベイズとの違い、実際に使う際の注意点も確認しましょう。
ベイジアンネットワークの基本構造
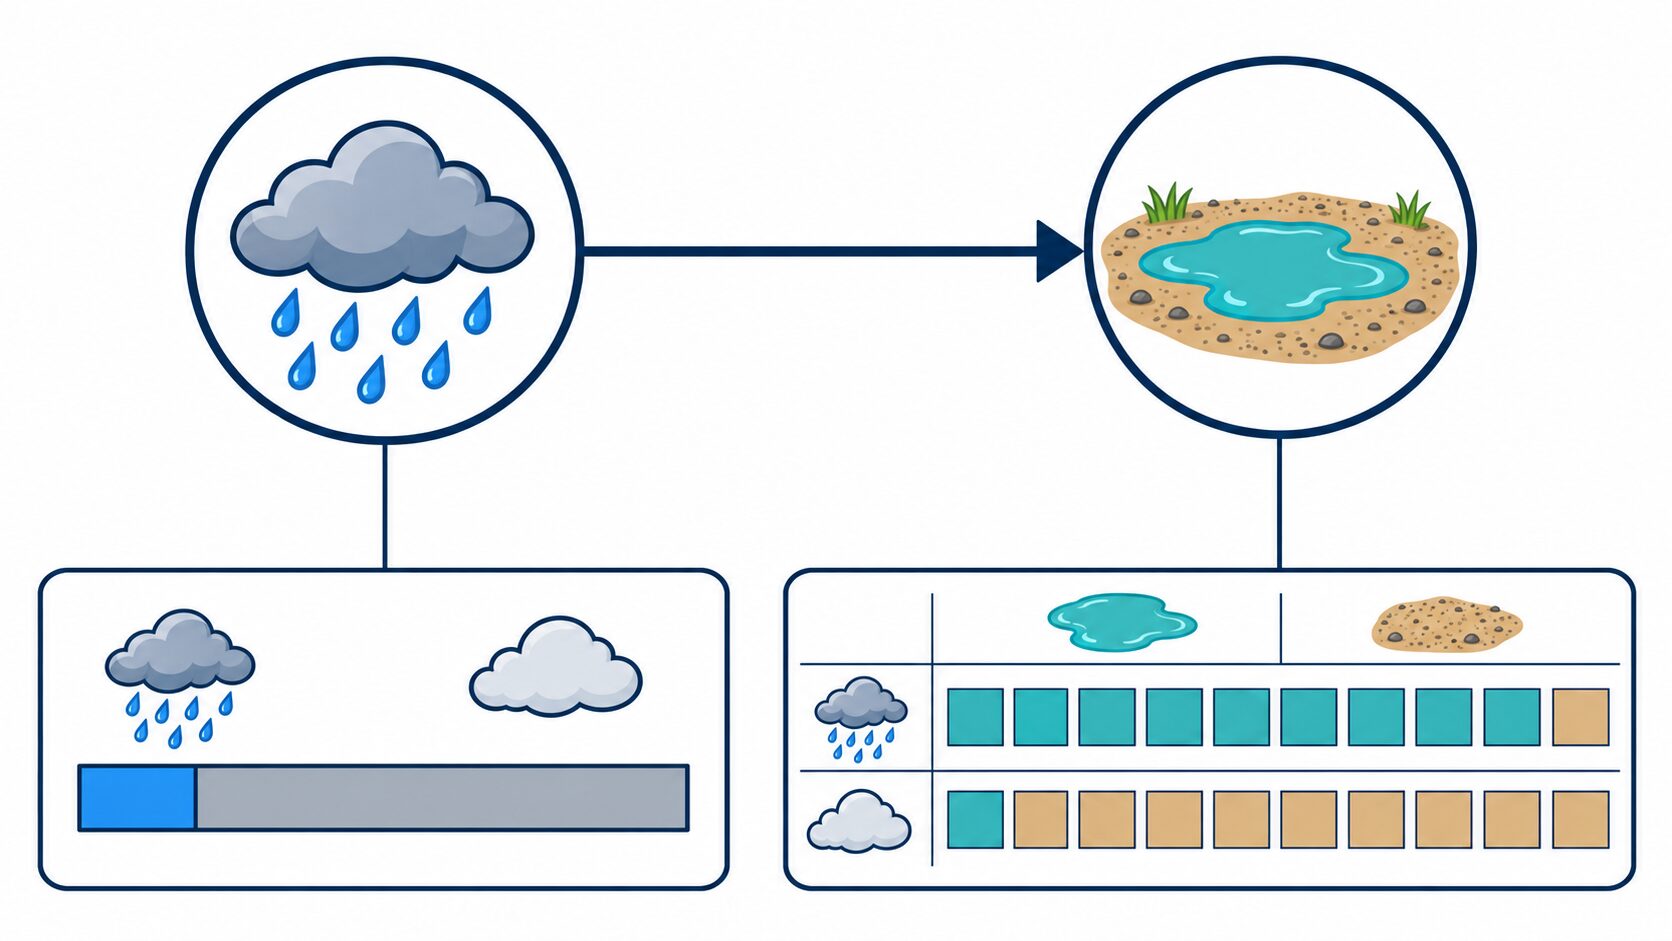
ベイジアンネットワークを構成するのは、変数を表す節点、節点を結ぶ矢印、各変数の確率分布です。節点はノードとも呼ばれます。「雨の有無」と「地面の濡れ」を節点にし、雨から濡れへ矢印を引くと、雨の状態を条件にして濡れの確率を表すモデルになります。
ここでは、雨の有無を \(R\)、地面の濡れを \(W\) とします。この二つの変数が同時にある状態を取る確率は、次のように表せます。
\(P(R,W)=P(R)P(W\mid R)\)左辺は雨と濡れの「同時確率」です。右辺の \(P(R)\) は雨の確率、\(P(W\mid R)\) は雨の状態が分かっているときの濡れの確率を表します。縦線の右側にあるものが条件です。まず雨の起こりやすさを考え、そこに雨の有無に応じた濡れの起こりやすさを掛ける、と読むと理解しやすくなります。
矢印が入ってくる側から見て、直接つながる出発側の節点を「親」と呼びます。この例では雨が濡れの親です。複数の変数を扱う場合も、各変数について「親の状態が分かっているときの確率」を用意し、それらを掛け合わせて全体の同時確率を表します。
図は有向非巡回グラフ(DAG)でなければなりません。「有向」は矢印に向きがあること、「非巡回」は矢印の向きに沿って進んでも出発点に戻らないことです。そのため、同じ時点の雨と濡れを互いに矢印で結んで輪にすることはできません。時間をまたぐ変化を扱うときは、時点ごとの変数を用意するなど、構造を工夫します。
変数が「あり・なし」のような離散的な状態を取る場合、確率は条件付き確率表(CPT)にまとめられます。親がない雨の節点には、観測前の事前確率を設定します。以下では説明用に、雨ありを20%、雨なしを80%とし、濡れの確率を次のように置きます。これらは実測値ではなく、計算を理解するための架空の設定です。
| 親の状態:雨の有無 | 地面が濡れる確率 | 地面が乾いている確率 |
|---|---|---|
| 雨あり | 90% | 10% |
| 雨なし | 10% | 90% |
親の状態を一つに固定したとき、子が取り得る全状態の確率の合計は1、つまり100%になります。雨が降らなくても濡れる確率を残しているのは、水まきなど、雨以外にも濡れる理由があるためです。この二変数モデルでは、そうした理由を個別の節点には分けず、「雨なしで濡れる確率」にまとめています。温度のような連続値をそのまま扱うモデルでは、表の代わりに確率密度などで分布を指定します。
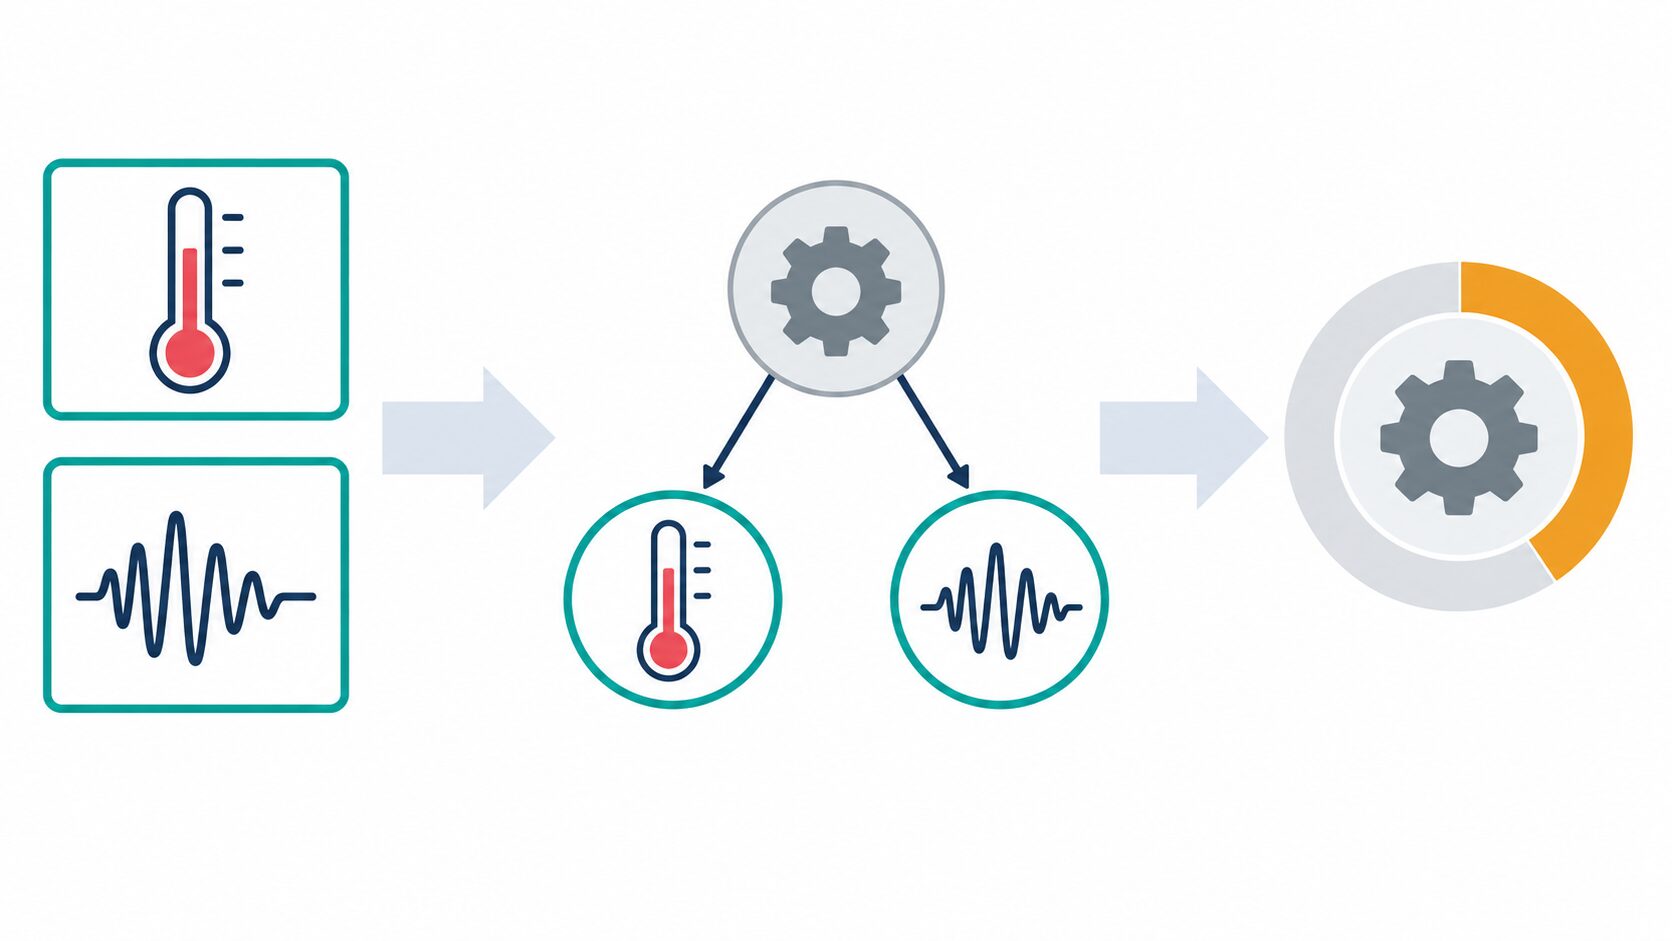
変数が多い場合に役立つのが「条件付き独立性」です。これは、ある情報が分かっていれば、別の情報を追加しても対象の確率が変わらないという性質です。例えば、故障状態が分かれば温度と振動を独立に扱えると仮定するモデルでは、それぞれの確率を別々に設定できます。あらゆる状態の組み合わせを一枚の大きな表にするより、必要な情報を少なくできるのです。ただし、この仮定が対象の現象に合うかは確認が必要です。
また、矢印はモデルで扱う依存関係を表し、それだけで因果関係を保証するものではありません。雨と濡れのように原因から結果へ描くと自然な例もありますが、データ上の関連を図にしただけでは、「一方を変えれば他方が変わる」とまでは判断できません。
雨と地面の例でわかる確率推論
確率推論とは、分かっている情報を条件にして、まだ分からない変数の確率を計算することです。新しい観測を得たときの更新には、次のベイズの定理が使えます。ここでは \(R=1\) を「雨あり」、\(R=0\) を「雨なし」、\(W=1\) を「地面が濡れている」とします。
\(P(R=1\mid W=1)=\frac{P(W=1\mid R=1)P(R=1)}{P(W=1)}\)前の節の架空のモデルで、地面が濡れているのを見たとしましょう。知りたいのは「濡れているという条件のもとで、雨が降った確率」です。まず、濡れる場合を「雨があって濡れる」と「雨がなくても濡れる」に分け、全体として濡れる確率を求めます。
\(P(W=1)=0.2\times0.9+0.8\times0.1=0.26\)雨があって濡れる確率は18%、雨がなくても濡れる確率は8%なので、濡れる確率は合計26%です。そのうち、雨があって濡れる場合の割合を求めると、観測後の雨の確率になります。
\(P(R=1\mid W=1)=\frac{0.18}{0.26}\approx0.692\)つまり、地面の濡れを観測する前は20%だった雨の確率が、観測後は約69.2%になります。1,000回の状況に当てはめた期待度数で考えると、雨があって濡れるのは180回、雨がなくても濡れるのは80回です。濡れる合計260回のうち180回が雨あり、と考えても同じ割合になります。実際に1,000回観測すれば必ずこの件数になる、という意味ではありません。
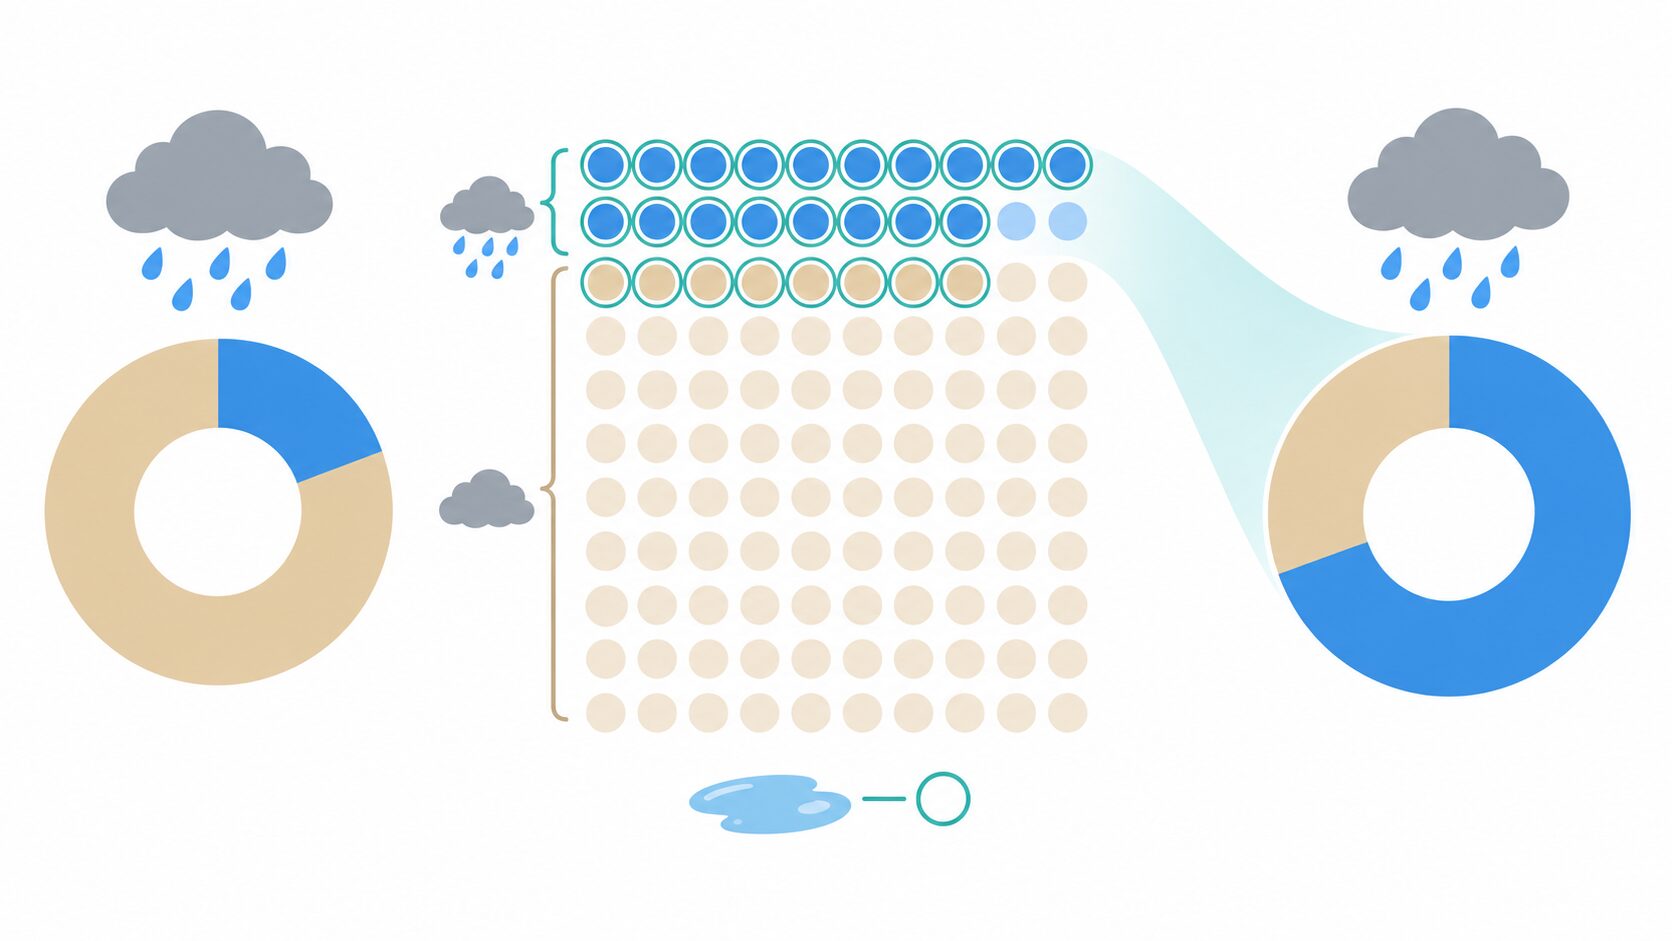
この計算で使う「事前確率」「尤度」「事後確率」は、次のように区別できます。
- 事前確率:今回の濡れを観測する前に設定していた、雨の確率20%です。
- 尤度:雨があったと仮定したとき、今回の観測である「濡れ」がどの程度起こりやすいかを表します。この例では90%で、雨なしの仮定では10%です。
- 事後確率:濡れの情報を反映した後の雨の確率で、約69.2%です。
注意したいのは、\(P(W=1\mid R=1)\) と \(P(R=1\mid W=1)\) は異なることです。「雨なら90%の確率で濡れる」からといって、「濡れていれば90%の確率で雨」とはなりません。雨そのものの起こりやすさと、雨以外で濡れる可能性も考慮する必要があります。
このように、雨から濡れを予測することも、濡れから雨を推定することもできます。推論の向きに合わせて矢印を描き直す必要はありません。同じ同時確率のモデルを使い、どの変数を観測済みとして扱うかを変えています。
次に、水まきも節点として加え、雨と水まきの両方から濡れへ矢印を引く別のモデルを考えます。この場合は、雨と水まきの組み合わせごとに濡れる確率を設定し直します。濡れを観測した後で水まきもあったと分かれば、濡れを説明する別の理由が得られるため、雨の見込みが下がる場合があります。これを「説明消去」と呼びます。ただし、変化の方向や大きさはモデルの構造と確率設定によります。先ほどの二変数モデルの計算結果を、そのまま流用することはできません。
観測情報を取り込んで条件付き確率を求めることが、ここでいう確率の更新です。「確率伝搬」は、その計算をネットワーク上の情報のやり取りで進める方法の一つを指します。更新そのものと、更新を実行する計算方法は区別して理解するとよいでしょう。
専門家の知識とデータからモデルを作る
ベイジアンネットワークを作るときは、最初に「何を知りたいのか」を決めます。例えば、機械の現在の故障箇所を推定するモデルと、翌日までに故障する可能性を予測するモデルでは、必要な変数やデータの時間範囲が変わります。目的を決めずに、集められる情報をすべて節点にすると、構造も確率の推定も複雑になります。
- 変数と状態を定義する:故障の有無、温度、振動など、目的に関係する項目を選びます。温度を「正常・高温」に分けるなら、その境界と測定時点をそろえます。故障の有無も、点検で確認した状態なのか、記録上の分類なのかを明確にします。
- 構造を設計する:どの変数を親にするかを決め、循環のない図を作ります。専門家の知識で組み立てる方法、データから構造を探索する方法、両者を組み合わせる方法があります。
- 確率を設定・推定する:親のない節点の確率と、親の各状態に対する条件付き確率を用意します。履歴データから推定するほか、データが少ない部分に専門家の見積もりを使うこともできます。
- 別のデータで評価する:モデル作成に使わなかったデータで、予測や候補の推定がどの程度合うかを調べます。正解率だけでなく、出した確率と実際の発生頻度が対応しているかも確認します。将来を予測する用途では、過去で学習し、それより後の期間で評価する方法が考えられます。
学習は、大きくパラメータ学習と構造学習に分かれます。パラメータ学習は、矢印のつながりを固定したうえで、確率表などの数値をデータから推定することです。構造学習は、変数のつながり方自体も候補から探索することを指します。構造が決まった後には、その構造に対応する確率も必要です。
例えば、専門家が「故障状態から温度と振動へ矢印を引く」という構造を設計し、正常時と故障時の運転履歴から、それぞれの状態で高温や大きな振動が現れる確率を推定できます。これが知識とパラメータ学習を組み合わせる例です。知識だけではつながりが分からない場合には、データから構造候補を探し、専門家が妥当性を検討する進め方もあります。
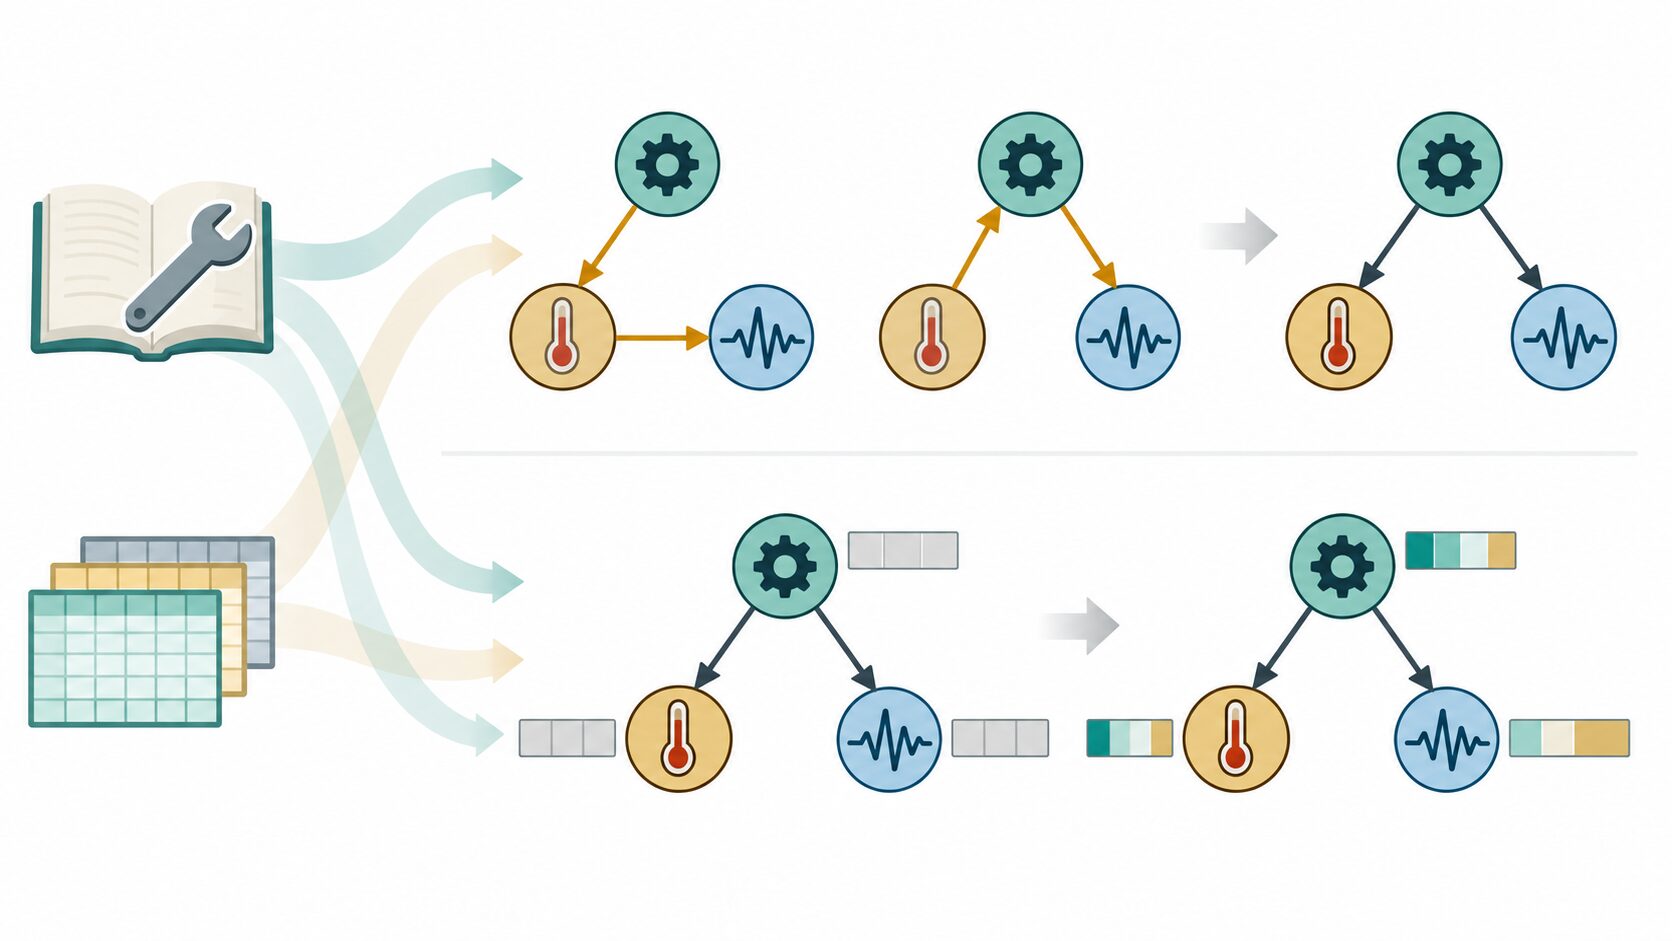
ただし、データに合う構造が見つかっても、因果関係が証明されたことにはなりません。観測データだけでは向きを区別できない構造もあり、記録されていない共通の要因が関連を生んでいることもあります。学習した図は、測定方法や現場の知識と照らし合わせて解釈する必要があります。
医療・販売・金融・製造・防災での活用例
ベイジアンネットワークが役立つのは、複数の手がかりから、直接は観測しにくい状態や今後の出来事を推定したい場面です。以下は分野ごとの利用イメージであり、特定のシステムの導入実績や精度を示すものではありません。
| 分野 | 入力する情報の例 | 推定する対象と用途 |
|---|---|---|
| 医療 | 症状、検査結果、既往歴 | 考えられる病気の候補とその確率を求め、診断の検討を支援する。 |
| 販売・マーケティング | 購買履歴、閲覧履歴、商品の関連性 | 次に購入しそうな商品を推定し、推薦する候補を絞る。 |
| 金融 | 返済履歴、収入に関する情報、取引の金額や時間帯 | 信用リスクや不正利用の疑いを推定し、確認が必要な案件を探す。 |
| 製造 | 機械の温度、振動、動作音、点検記録 | 故障箇所の候補や故障発生の可能性を推定し、保守・品質管理を支援する。 |
| 防災 | 雨量、地盤条件、過去の災害記録 | 災害の発生リスクを推定し、監視や備えを検討する材料にする。 |
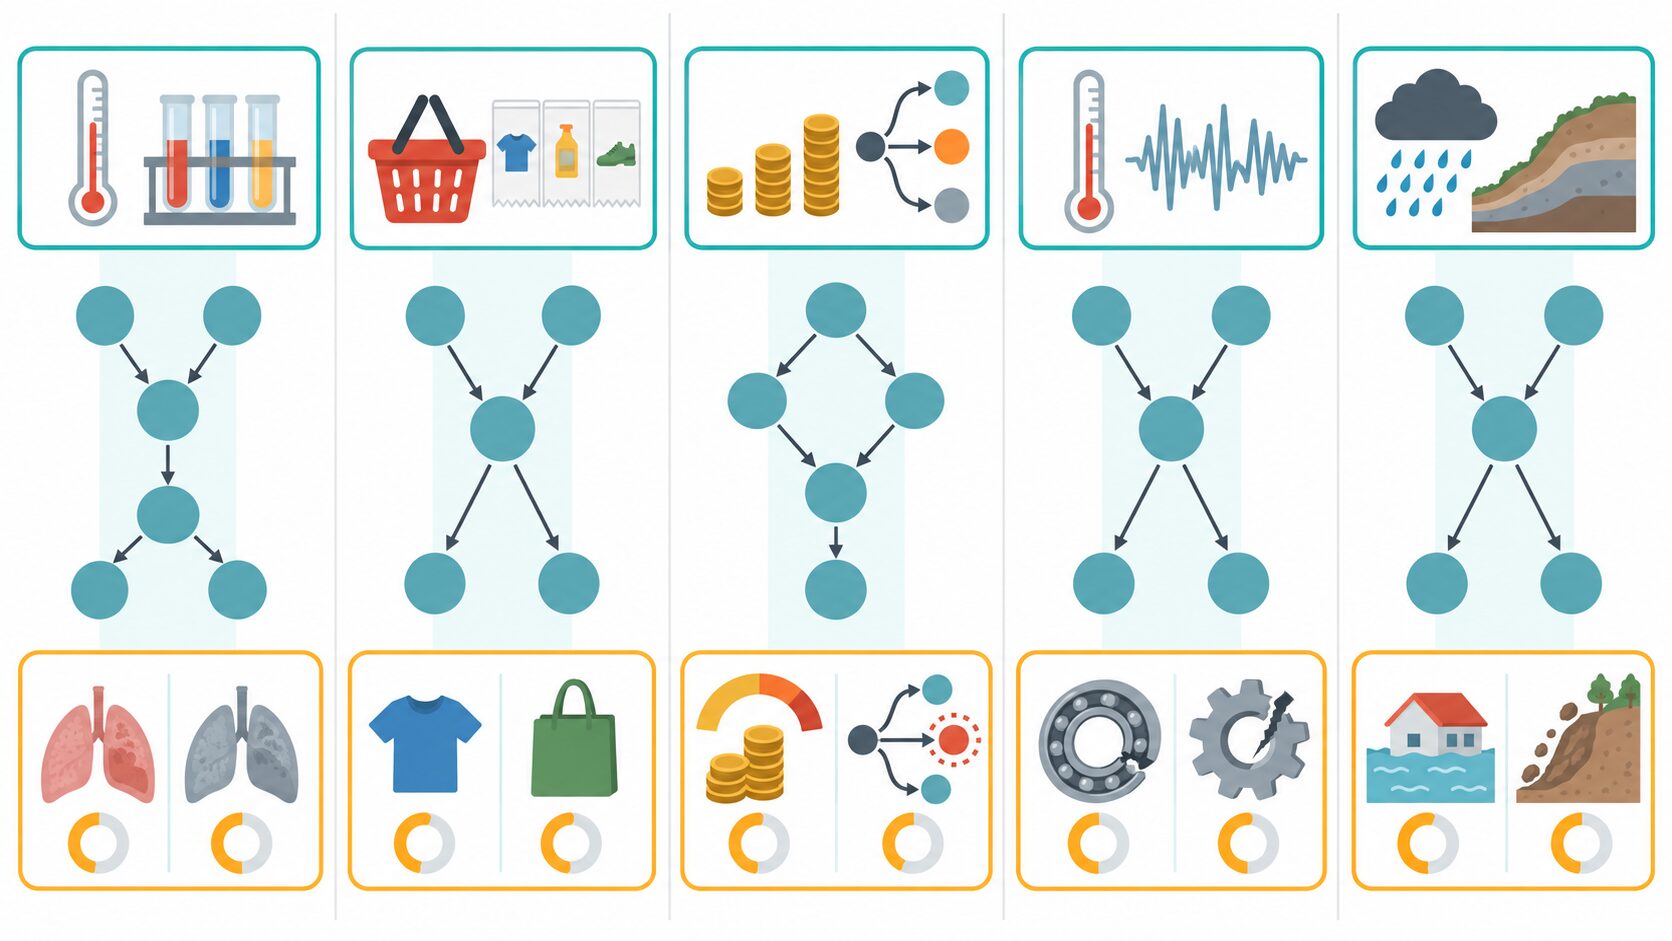
例えば製造業では、温度だけでは複数の故障が候補に残っても、振動や点検結果を加えることで、候補の確率が変わります。最も確率が高い候補だけでなく、ほかの候補がどれくらい残っているかも見られるため、追加の確認を検討する材料になります。ただし、どの確認を選ぶかには、確認にかかる費用や見逃した場合の影響も関わります。
どの分野でも、出力は選んだ変数、設定した構造、学習データを前提とする確率です。病気や故障を自動的に確定するものでも、金融取引や災害の結果を保証するものでもありません。販売で購入可能性が高いと分かっても、その人に広告を出したことで購入が増えるかは別の問いです。予測を何の判断に使うのかまで決めて、モデルの出力を読み取ることが大切です。
ベイズの定理や他の学習手法との違い
「ベイズ」という言葉が共通していても、ベイズの定理とベイジアンネットワークは同じものではありません。ベイズの定理は確率を更新するための関係式、ベイジアンネットワークは複数の変数の同時確率分布を表現するモデルです。前者を使って後者の推論を説明できるので、互いに競合する手法として選ぶ関係ではありません。
| 用語・手法 | 基本的な考え方 | ベイジアンネットワークとの関係・違い |
|---|---|---|
| ベイズの定理 | 事前確率と観測の起こりやすさから、観測後の確率を求める関係式。 | ネットワークそのものではなく、雨の数値例のような確率更新に使う。 |
| ベイジアンネットワーク | 変数間の依存関係をDAGと条件付き確率分布で表すモデル。 | 複数の変数について、観測された状態から未観測の状態を推定できる。 |
| ナイーブベイズ | クラスが分かれば各特徴量は互いに独立、という仮定を置く分類モデル。 | クラスから各特徴量へ矢印を引く、ベイジアンネットワークの一形態として表せる。 |
| ニューラルネットワーク | 計算単位を接続し、重みなどのパラメータを学習して入力を出力へ変換するモデル。 | 節点は通常、計算を担う単位であり、現象の変数と条件付き確率を直接表す節点とは意味が異なる。 |
ナイーブベイズの独立性は、「特徴量がいつでも無関係」という意味ではありません。例えば、文章を分類する場合、分類先のクラスを条件としたときに、各単語の出現を独立として扱います。この仮定によってモデルが簡単になり、推定する確率を減らせます。一般のベイジアンネットワークでは、必要に応じて特徴量同士の依存関係も構造に含められます。
ニューラルネットワークも図で表せますが、図が示すものが違います。画像を入力して特徴を学習する場合と、故障・温度・振動の関係を明示して推論する場合では、求めるモデルの性質が異なります。どちらが高精度かは、データ量、問題の性質、構造の設計などに左右され、一律には決まりません。
両者を組み合わせることも考えられます。例えば、画像の特徴をニューラルネットワークで抽出し、それをほかの観測情報とともにベイジアンネットワークで扱う構成です。その場合も、前段の出力には誤りがあり得るため、システム全体としての推定結果を評価する必要があります。
ベイジアンネットワークの強みと注意点
大きな強みは、変数の関係を可視化し、専門家の知識とデータを組み合わせ、複数の観測から推論できることです。何を変数として選び、どの関係を仮定しているのかが図に現れるため、分析担当者と現場の担当者がモデルについて話し合いやすくなります。ただし、図を描けば必ず理解しやすくなるわけではなく、節点が増えすぎると全体の把握は難しくなります。
すべての変数を観測しなくても推論できます。分からない変数について、取り得る状態の確率を足し合わせる「周辺化」を行えば、必要な確率を求められます。連続値の場合は、対応する積分を行います。これは不明な値を勝手に一つに決めることとは異なります。一方、学習用データに欠測がある場合は、欠測の生じ方や推定方法を検討する必要があり、何も処理せず正しく学習できるとは限りません。
親や状態を増やすと、確率表が大きくなります。例えば、二つの状態を取る親が10個あると、親の状態の組み合わせだけで1,024通りになります。それぞれについて子の確率を推定するには、多くのデータや妥当な制約が必要です。関係がありそうだからと矢印を増やし続けると、ほとんど観測されない組み合わせが生じ、推定が不安定になることがあります。
計算の負荷は、変数の数だけでなく構造にも左右されます。小さなモデルは雨の例のように手計算できますが、つながりが複雑になると、厳密な推論に大きな計算量を要します。構造学習も、多数の図の候補を調べるため負荷が高くなり得ます。そのため、用途によっては構造を制限したり、標本抽出などの近似的な計算を使ったりします。コンピューターを使えば、どんな規模でも容易に解けるわけではありません。
データ量だけで精度の向上は保証されません。故障した機械の記録ばかりを集めれば、通常の運転状況における故障確率を適切に推定できない可能性があります。誤った独立性の仮定、測定の誤差、少ない事例も結果に影響します。観測されなかった状態を安易に確率ゼロとすると、その状態は起きないと強く仮定することになるため、少数データを補う確率の設定方法も検討が必要です。
評価では、当たったかどうかに加え、確率の信頼性を見ます。高い確率を出した出来事が実際にも相応の頻度で起きているか、運用先のデータでも同様の結果になるかを確認します。設備の更新や顧客層の変化などで前提が変われば、確率表だけでなく、変数や構造そのものを見直すことも必要です。
観測からの予測と、介入の効果は区別します。高温と故障に関連があるからといって、「機械を冷やせば、その分だけ故障が減る」とは限りません。高温が故障の結果として現れている可能性もあるためです。何かを意図的に変えたときの効果を知るには、矢印を因果として解釈できる追加の仮定や専門知識、場合によっては実験などの情報が必要になります。
導入や学習を始める際は、次の四点を確認すると、モデルの役割を具体的にできます。
- 目的:何を推定し、その確率をどの判断に使うのか。
- 変数:観測できる項目と推定したい項目は何か。状態や時点の定義はそろっているか。
- データ:必要な状態の組み合わせを含んでいるか。偏りや欠測をどう扱うか。
- 評価方法:別のデータで何を確かめ、運用後にどの条件でモデルを更新するか。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月4日 | 雨の数値例と学習手順を加筆し、因果関係の注意点と関連手法の比較を補足 |