
変分オートエンコーダ(VAE)とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「変分オートエンコーダ」って、どんな技術ですか?画像を作れると聞いたのですが、仕組みがよくわかりません。

AI専門家
画像の特徴をコンパクトな数値で表し、その数値から画像を作る仕組みだよ。元の画像に近いものを復元するだけでなく、学習した特徴に沿う新しい画像も作れるんだ。
AIの初心者
元の画像を渡さなくても、新しい画像を作れるんですか?
AI専門家
できるよ。そのために、特徴を表す数値の出やすさも考えながら学習するんだ。手書き数字なら、数字らしい形を保ちながら、傾きや線の太さが違う画像を作ることを目指すよ。
変分オートエンコーダ(VAE)とは
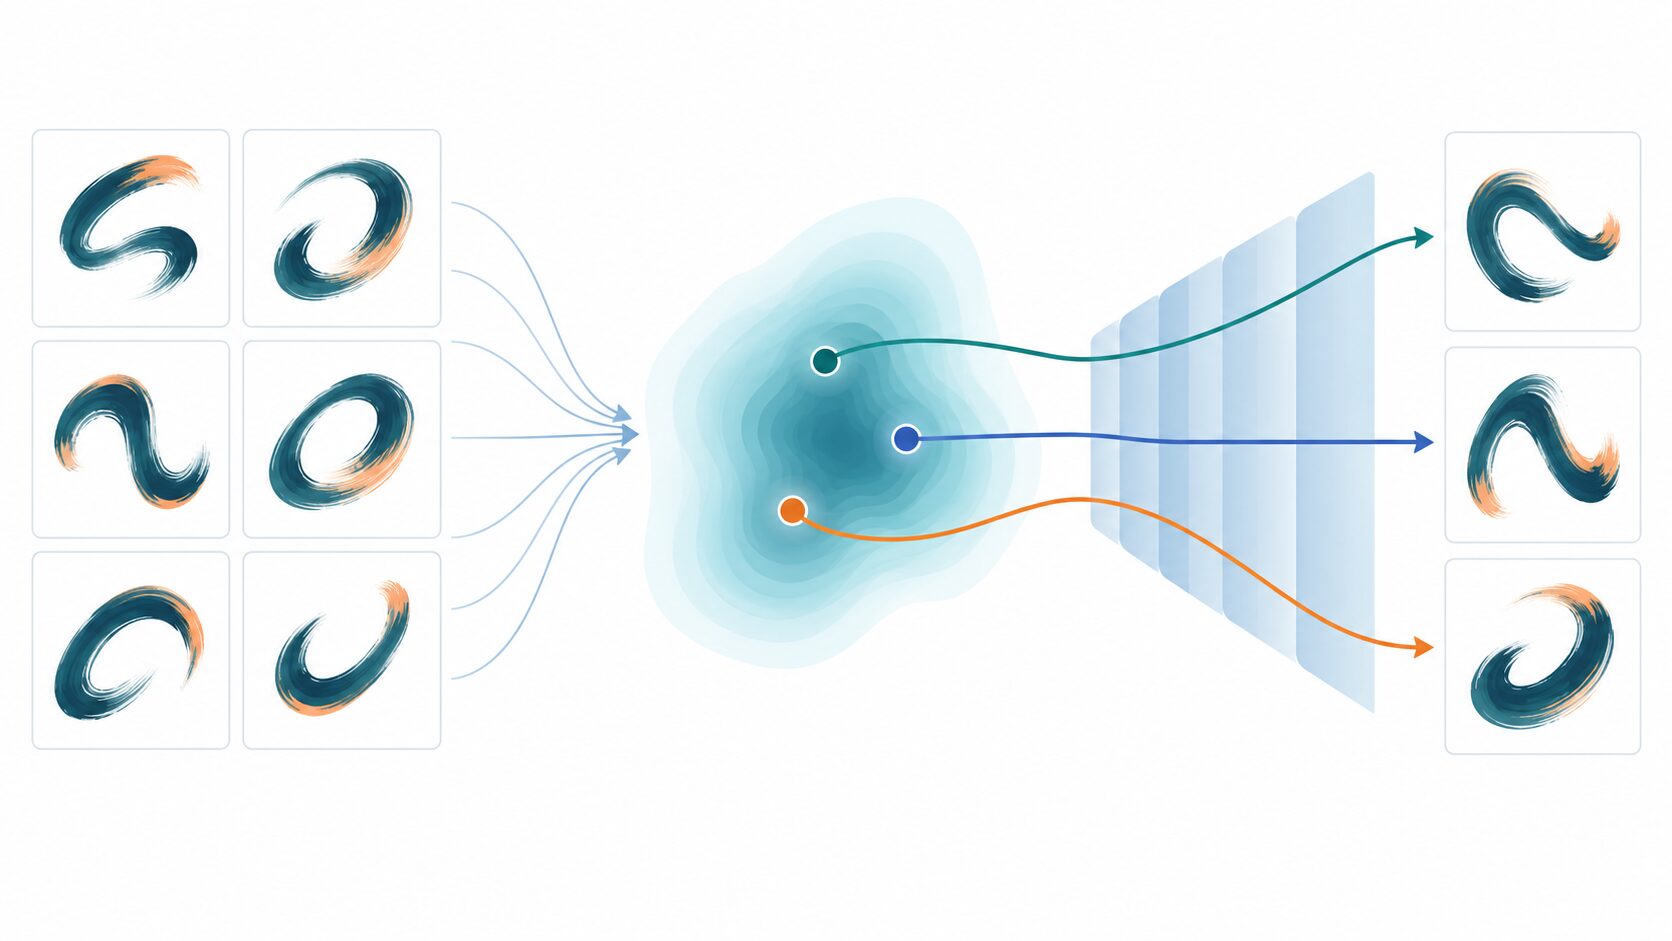
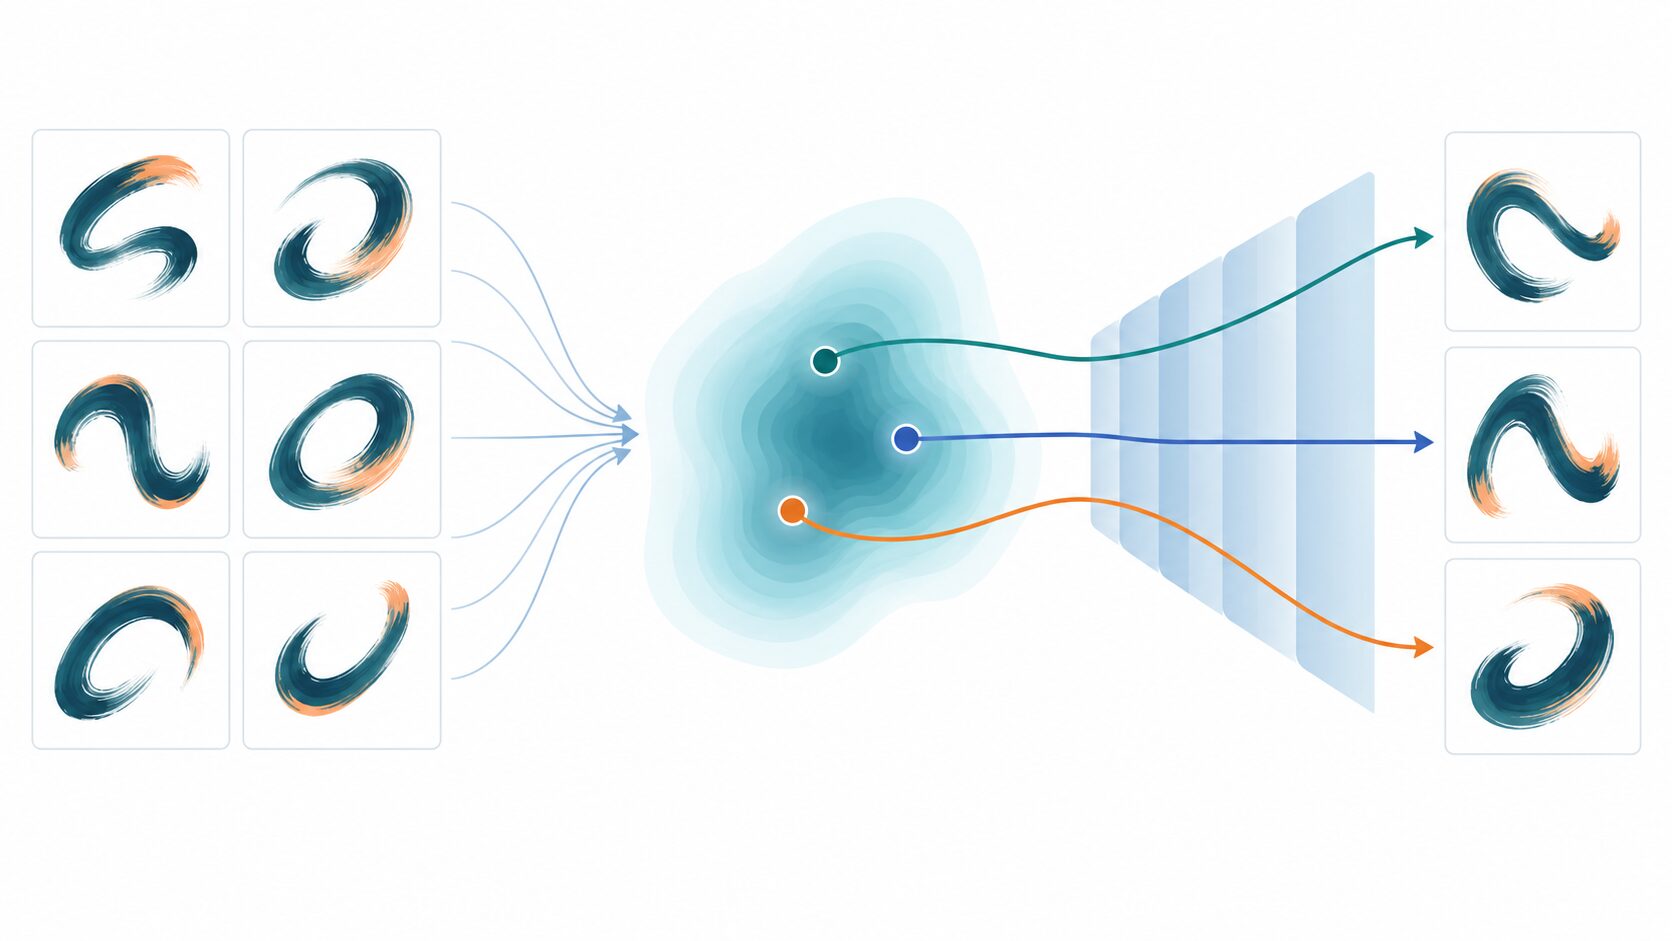
変分オートエンコーダは、画像などの特徴を「潜在変数」というコンパクトな数値の組で扱う、確率的な生成モデルです。入力から潜在変数の分布を推定するエンコーダと、潜在変数からデータを作るデコーダを組み合わせます。元のデータを再現することと、新しいデータを生成しやすい分布を学ぶことを、同時に目指す点が特徴です。
画像生成の流れをつかむには、画像の特徴を学ぶ段階と、学んだモデルで画像を作る段階を分けて考えると理解しやすくなります。以下では手書き数字を例に、確率分布の役割、学習方法、ほかの生成モデルとの違いを順に見ていきます。
変分オートエンコーダはどんな生成モデルか
VAEは「Variational Autoencoder」の略で、日本語では変分自己符号化器、変分自動符号化器とも呼ばれます。「符号化」はデータを別の表現に変換すること、「復号」はその表現からデータを作り直すことです。VAEでは、この変換を担うニューラルネットワークを学習させます。
生成モデルは、学習データにどのようなパターンが現れるかを捉え、その特徴に沿ったデータを作るモデルです。たとえば、多くの手書き数字には線の曲がり方や太さ、傾きに共通点とばらつきがあります。VAEは、こうした違いを表せる潜在表現と、それを画像に変換する方法を学びます。扱うデータに合わせて設計すれば、画像以外の音声や分子構造などにも応用できます。
ここで区別したいのが、再構成と新規生成です。再構成では、ある人が書いた「3」の画像を入力し、その形に近い画像を出力します。元の線や傾きがどれくらい保たれるかが評価の対象です。新規生成では、元になる画像を渡さずに潜在変数を選び、学習した数字の特徴に沿う画像を作ります。
新しい筆跡に見える画像を作れても、それだけで品質や独創性が保証されるわけではありません。再構成が得意か、入力なしでも数字らしい画像を作れるか、似た画像ばかりにならないかは、それぞれ確認する必要があります。また、基本的なVAEは画像だけでも学習できますが、生成する数字の種類を指定するには、後述する条件付きVAEなどの仕組みが必要です。
エンコーダとデコーダで画像を生成する仕組み
入力画像を\(x\)、潜在変数を\(z\)と書くと、再構成は「画像から分布を推定する」「その分布から数値を取り出す」「数値から画像を作る」という流れになります。エンコーダとデコーダは、この流れの両端を担当します。
- エンコーダが潜在変数の分布を推定する。画像を受け取り、その画像に対応しそうな潜在変数の分布\(q(z\mid x)\)を求めます。これは近似事後分布と呼ばれ、典型的なVAEでは、各成分の平均と分散をニューラルネットワークで出力します。
- 分布から潜在変数をサンプリングする。推定した分布に従って、数値の組である\(z\)を一つ取り出します。平均は値の中心、分散は値のばらつきの大きさを表します。分布は値の出やすさを決めるもので、取り出された数値ベクトルそのものとは区別します。
- デコーダが画像を生成する。潜在変数を受け取り、画像の条件付き分布\(p(x\mid z)\)を表します。実装では画素ごとの平均値や確率などを出力し、そこから再構成画像を得ます。表示用には分布の平均に相当する画像を使うこともあります。
学習時には、ランダムに値を取り出す処理を挟んでも、エンコーダまで誤差の情報を伝えられるようにする工夫が必要です。代表的なのが「再パラメータ化」です。正規分布を使う場合、潜在変数を次のように表します。
\(z=\mu+\sigma\odot\epsilon,\qquad \epsilon\sim\mathcal{N}(0,I)\)\(\mu\)はエンコーダが求めた平均、\(\sigma\)は標準偏差です。\(\epsilon\)は平均0・分散1の標準正規分布から取り出した乱数で、\(\odot\)は成分ごとの掛け算を表します。乱数を別に用意し、その広がりと中心をエンコーダの出力で調整することで、平均や標準偏差を勾配に基づいて学習できます。
一方、入力画像なしで新規生成するときは、通常、エンコーダを使いません。あらかじめ定めた事前分布\(p(z)\)から潜在変数を取り出し、デコーダに渡します。事前分布には標準正規分布を使うのが典型例です。学習したデコーダが、その数値を数字らしい形や線の濃淡に変換します。
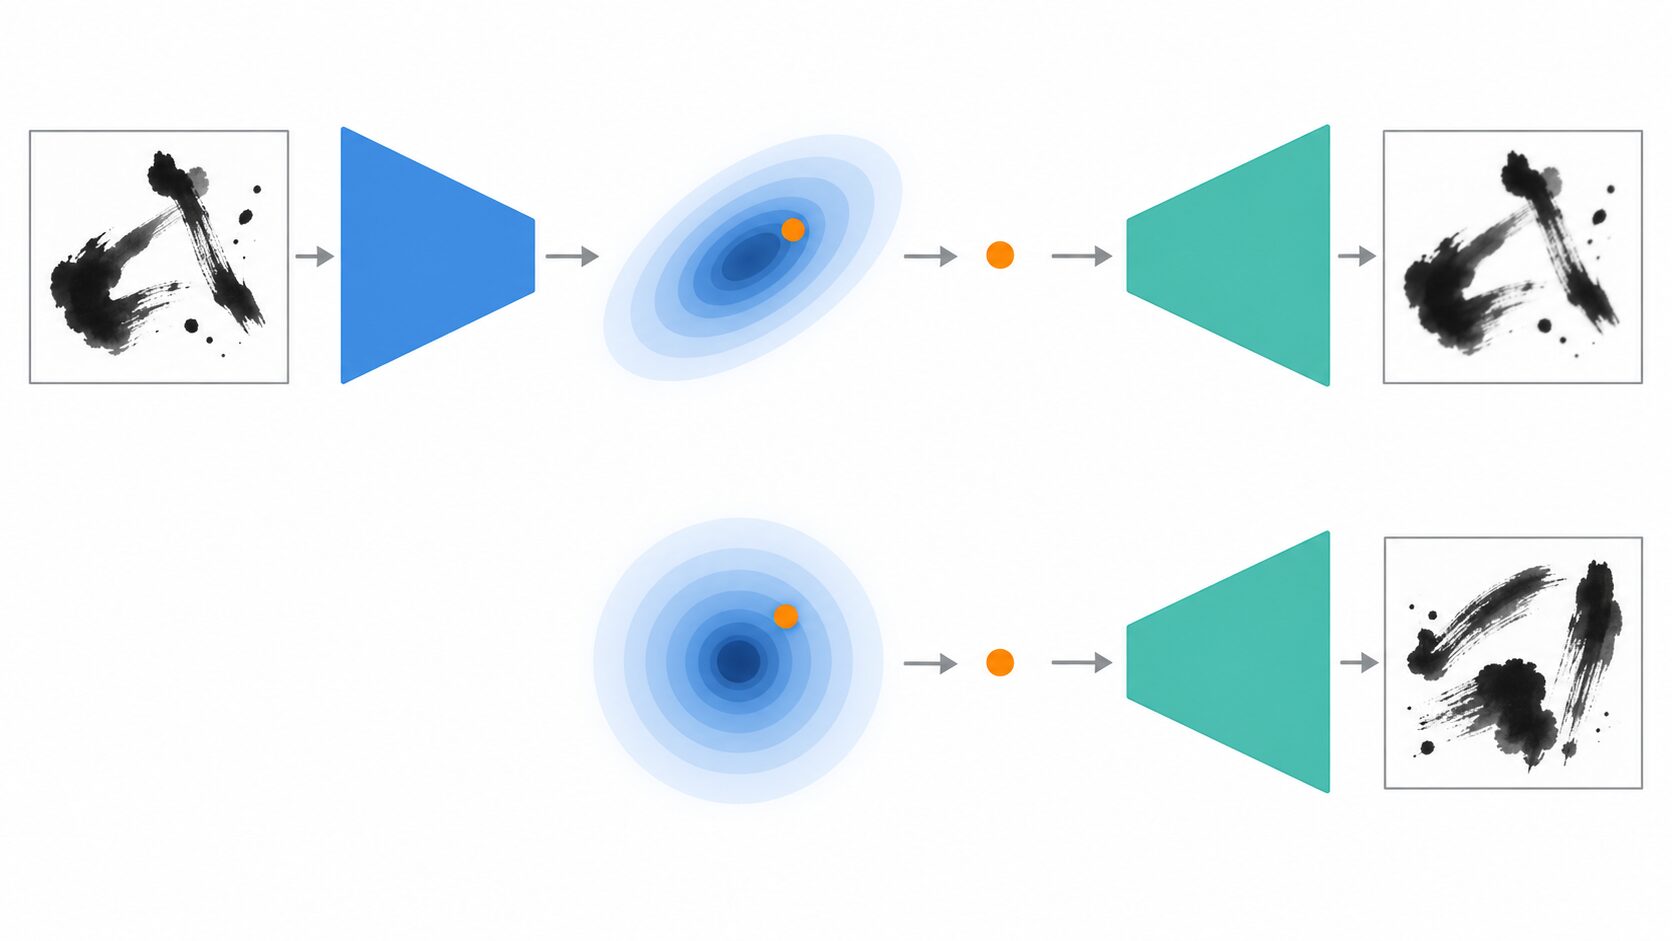
二つの経路では、潜在変数を取り出す分布が異なります。この違いがあるため、入力を再現する練習だけでは、新規生成に適したモデルになるとは限りません。そこで学習では、再構成の良さに加えて、分布同士の関係も調整します。
再構成と分布の整合を両立させる学習
ある画像\(x\)が観測されたとき、その画像を生みそうな潜在変数の分布が、真の事後分布\(p(z\mid x)\)です。しかし、複雑なニューラルネットワークを使う生成モデルでは、この分布を直接計算するのは一般に困難です。そこで、扱いやすい分布\(q(z\mid x)\)で近似します。このように分布を近似して推論する方法を、変分推論と呼びます。
VAEの学習目標は、入力をよく再現しながら、近似事後分布を事前分布から離れすぎないようにすることです。そのために使うELBO(証拠下限)は、次の二つの項で構成されます。
\(\mathcal{L}(x)=\mathbb{E}_{q(z\mid x)}[\log p(x\mid z)]-D_{\mathrm{KL}}(q(z\mid x)\,\|\,p(z))\)前半は「再構成項」です。入力から推定した分布で潜在変数を選んだときに、デコーダが元の入力に高い確率を与えられるほど大きくなります。\(\mathbb{E}\)は、その分布に従って値を取り出した場合の平均を表します。直感的には、「手書きの3を入力したら、線の形や位置をできるだけ保って戻せるか」を評価する項です。
後半の\(D_{\mathrm{KL}}\)は「KLダイバージェンス」で、近似事後分布と事前分布の食い違いを測ります。KLダイバージェンスは常に0以上で、一般の距離とは異なり、比べる向きを入れ替えると同じ値になるとは限りません。この項を小さくすることで、入力ごとの潜在表現が事前分布から大きく離れることを抑え、そこから取り出した値でも生成しやすい潜在空間を促します。
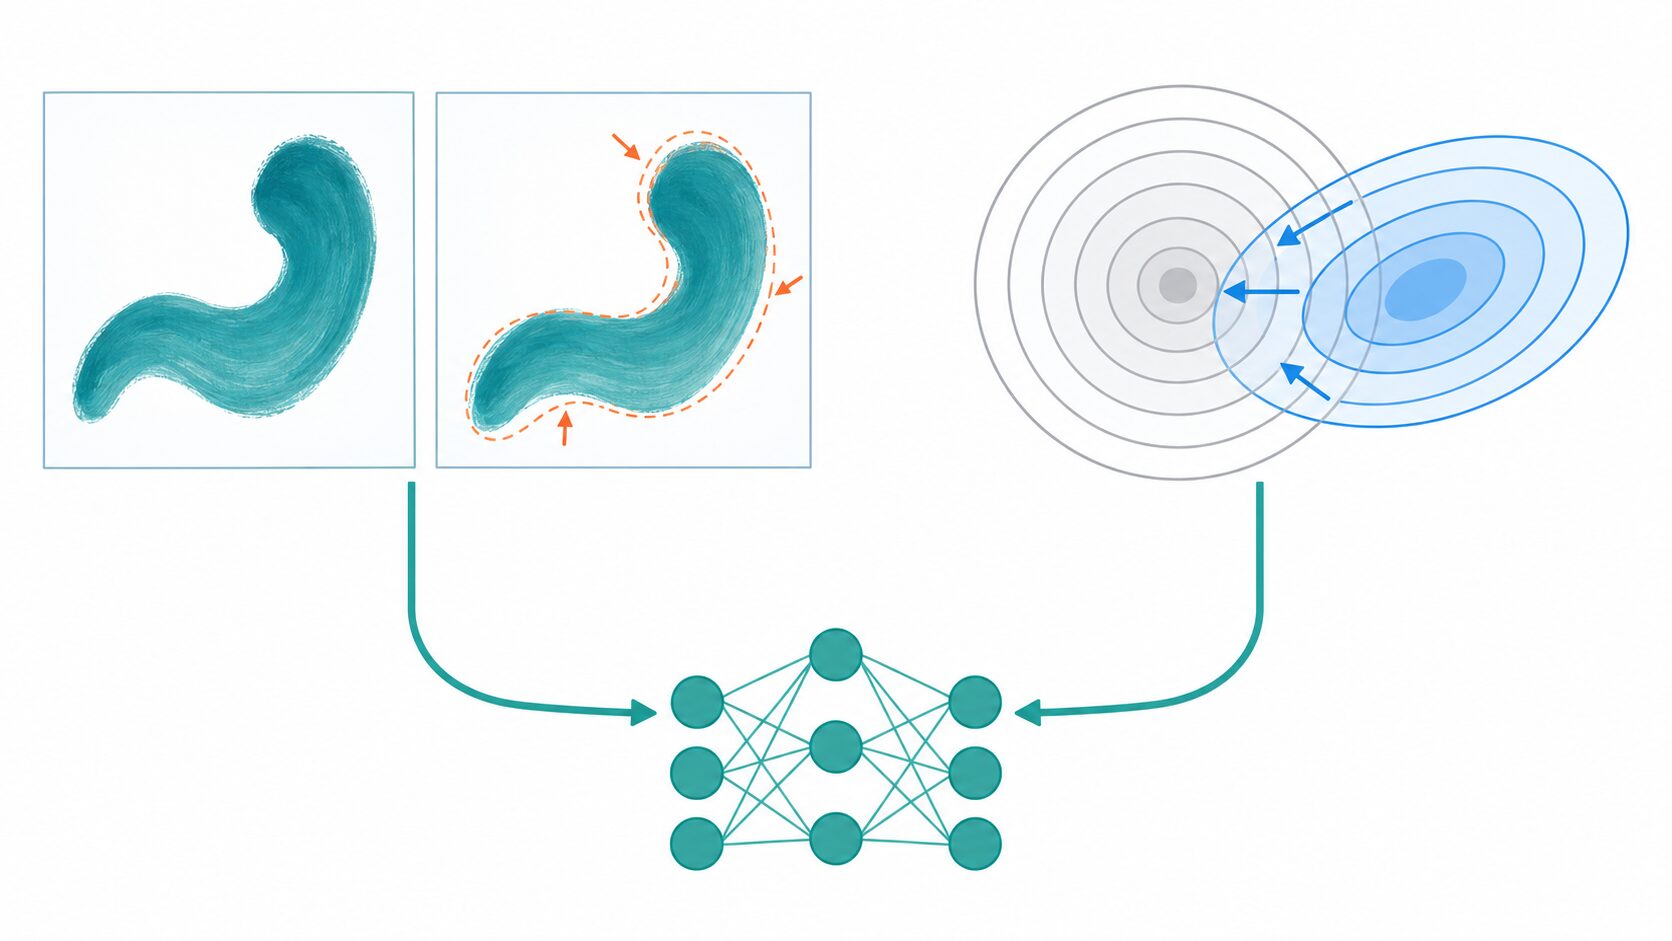
ELBOは、観測データの対数尤度を下から評価する量です。難しい計算を直接行う代わりに、この下限を大きくするように学習します。実装では、ELBOの符号を反転させた「負の再構成項とKL項の合計」を損失として最小化するのが基本です。再構成項の具体的な形はデコーダで仮定する分布によって変わり、分散を固定した正規分布なら、画素の二乗誤差に対応する形になります。
二つの目的のバランスも重要です。再構成ばかりを重視すると、個々の画像は戻せても、事前分布から取り出した値での生成がうまくいかないことがあります。反対に、分布を揃える働きが強すぎると、入力ごとの細かな違いを潜在変数に残せなくなります。データ量やモデルの大きさ、計算時間を増やすだけで、この問題が解決するとは限りません。
学習を試すときは、学習に使っていない画像の再構成、新規生成した画像、再構成項とKL項の推移を併せて確認すると、改善すべき点を見つけやすくなります。損失の合計値だけでは、画像の細部が失われているのか、潜在変数が十分に使われていないのかを判断しにくいためです。
潜在空間で画像の特徴を変える具体例
潜在変数\(z\)が取り得る座標の集まりを「潜在空間」と呼びます。画像を画素の並びとして扱う代わりに、学習された特徴を数値の組として扱う空間です。説明図では平面として描くことがありますが、実際の潜在変数は、用途やモデルに応じて多数の成分を持ちます。
たとえば、細い線でまっすぐ書かれた「3」と、太い線で右に傾いた「3」を用意します。それぞれをエンコーダに通し、近似事後分布の平均を代表の座標として使います。二つの座標の中間を少しずつ移動し、その都度デコーダで画像に戻すと、線の太さや傾きが徐々に変わる様子を観察できることがあります。これが潜在空間での「補間」です。
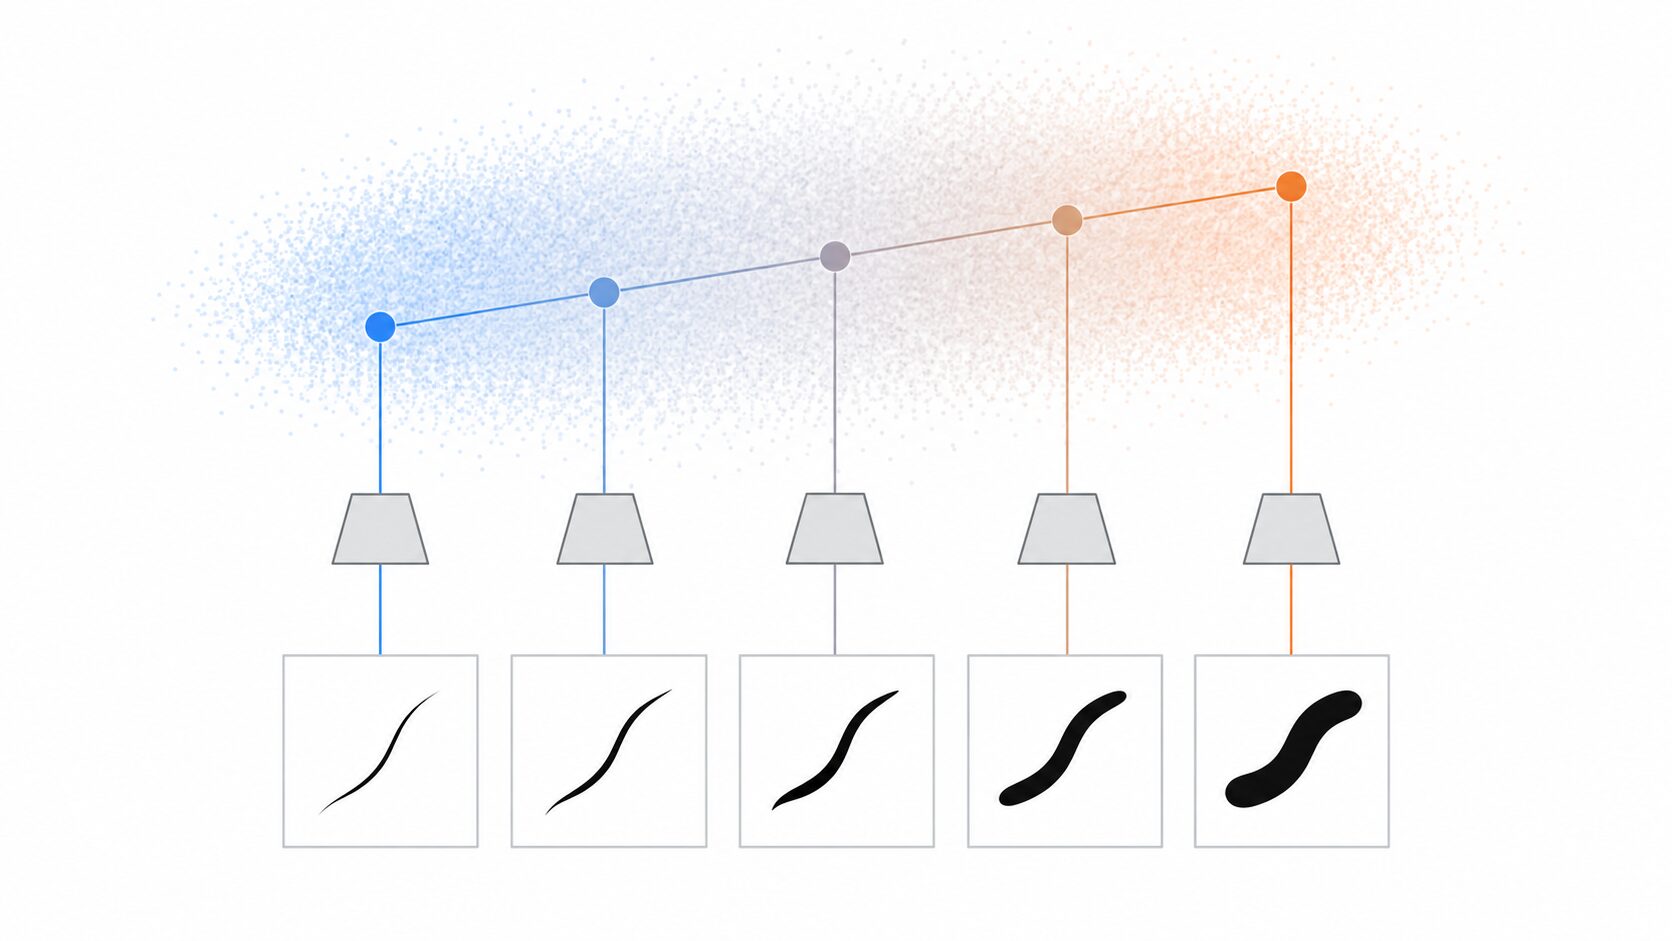
潜在空間での操作では、二枚の画像の画素を直接混ぜ合わせるのではなく、中間の座標をデコーダに渡します。顔画像を学習したモデルでも、異なる表情の画像に対応する座標の間を移動することで、表情が変化する画像を得られる場合があります。画像生成だけでなく、編集やデザイン候補の探索につながる考え方です。
ただし、潜在空間の各軸が、人間にとって明確な一つの意味を持つ保証はありません。一つの成分を変えたとき、線幅と傾きが同時に変わることもあります。顔の場合も「この軸は目の大きさ」「別の軸は口の位置」と自動的に分かれるとは限らず、特定の特徴だけを操作するには追加の設計が必要です。
座標が近いほど必ず見た目が似る、途中の座標なら必ず自然な画像になる、とも断定できません。補間の結果は、学習データ、潜在空間の構成、学習の進み具合に左右されます。実際に中間の画像を並べて、形が崩れていないか、意図しない特徴まで変わっていないかを確かめることが大切です。
通常のオートエンコーダ・GAN・拡散モデルとの違い
VAEは、エンコーダとデコーダを持つ点で通常のオートエンコーダ(AE)と共通しています。一方、画像を生成する技術には、GANや拡散モデルもあります。違いをつかむには、学習で何を目標にするかと、生成時にどのような処理を行うかを比べるとよいでしょう。
| モデル | 主な学習方法 | 生成・復元の方法 | 特徴と注意点 |
|---|---|---|---|
| 通常のオートエンコーダ(AE) | 入力と再構成結果の誤差を小さくする | 入力を潜在表現に変換し、デコーダで復元する | 圧縮や特徴抽出が中心。基本形では、自由に選んだ潜在座標から自然な画像が出る保証はない |
| 変分オートエンコーダ(VAE) | 変分推論を用い、再構成と分布の整合を含むELBOを最大化する | 入力から推定した分布、または事前分布から潜在変数を取り出し、復号する | 再構成と確率的な生成を一つの枠組みで扱える。典型的な構成では細部がぼやける場合がある |
| GAN | 生成器と、本物か生成物かを見分ける識別器を競わせる | 乱数などを生成器に渡して画像を作る | 鮮明な画像を生成できる場合がある。学習の不安定さや、似た出力に偏る問題に注意が必要 |
| 拡散モデル | ノイズを加えたデータから、ノイズを除く過程などを学ぶ | 通常はノイズから始め、段階的に画像へ近づける | 多段階の生成が基本。品質や計算量はモデル構成、生成手順、ステップ数などに依存する |
通常のAEは、入力画像をうまく再現できるように潜在表現を学びます。しかし、入力が配置された領域の間や外側から適当に座標を選んでも、自然な画像になるとは限りません。VAEでは、分布に関する制約を学習目標に加えることで、事前分布からの生成を可能にする方向へ学習します。
潜在変数やランダム性を使うこと自体は、VAEだけの特徴ではありません。GANも一般にランダムな潜在変数を入力に使います。VAEを特徴づけるのは、入力に対応する分布を変分推論で近似し、再構成と分布の整合を同時に学ぶ点です。
画質や速度の優劣も、モデル名だけでは決まりません。基本的なVAEは潜在変数からデコーダの一度の処理で画像を得られますが、画像の大きさやデコーダの規模によって計算量は変わります。また、潜在拡散モデルでは、VAE系の圧縮・復元器を併用する場合があります。その場合、圧縮された空間で拡散モデルが生成を担い、最後にデコーダが画像へ戻すため、複数の技術が役割を分担しています。
画像生成から異常検知までの活用例
VAEの使いどころは、新しい画像を作る用途と、学習したデータの特徴を利用して入力を分析・変換する用途に分けて考えられます。どちらでも、生成物の見た目と、実際の仕事で役に立つかどうかは別に評価します。
画像生成・編集やデザイン候補の探索では、潜在変数を変えて複数の候補を作り、比較する使い方が考えられます。映画やゲームのキャラクター、広告用の図案、服やアクセサリーのデザインなどが例です。潜在空間の補間を使えば、二つの案の中間に当たる形も探せます。ただし、制作時間の短縮や品質向上につながるかは、候補を選び直す時間や修正作業も含めて判断する必要があります。
製造現場の異常検知では、正常な製品の画像を中心に学習させ、検査画像と再構成画像の差を異常の手掛かりにします。たとえば、表面に傷がある画像を入力したとき、正常な模様は再現できても傷の部分を再現しにくければ、その差が大きくなります。画像全体の再構成誤差で異常度を求めたり、場所ごとの差から確認すべき領域を示したりする考え方です。
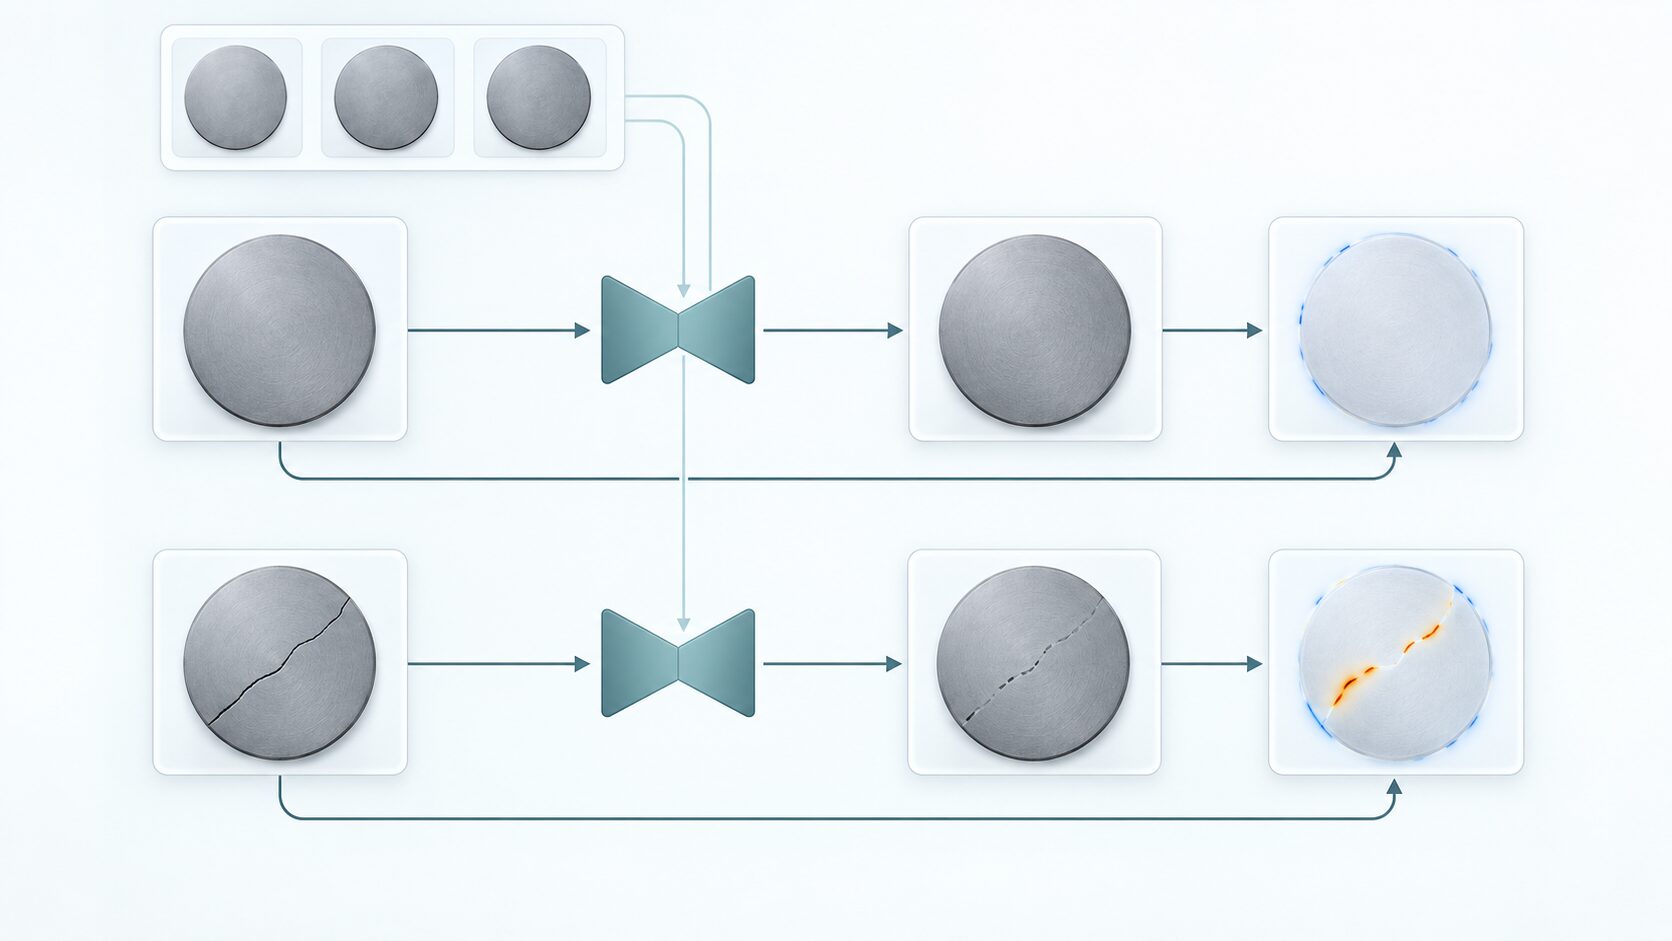
ただし、異常な部分までうまく再構成してしまうと、見逃しが起こり得ます。反対に、正常品でも照明や撮影角度が変わると誤差が増え、誤検知につながる場合があります。「誤差が大きいから必ず欠陥」とは扱わず、実際の検査条件のデータで判定のしきい値を調整し、見逃しと誤検知の両方を測ることが必要です。
医療画像のノイズ除去も、研究・応用の対象です。目的に合うデータや学習方法を用い、画像の重要な構造を保ちながら不要な変動を減らすことを目指します。ただし、見た目が鮮明になっても、診断精度が上がったことにはなりません。小さな病変が失われたり、元の画像にはない構造が現れたりしていないかを含め、用途に応じた検証が求められます。
分子構造、音声・音楽、文章の生成では、データの表現方法から設計する必要があります。分子なら原子と結合、音楽なら音の高さや長さ、文章なら語やトークンの並びなどを扱います。画像用のVAEをそのまま当てはめれば同じように生成できるわけではありません。また、分子として成立する構造を出力できても、薬としての有効性や安全性が確かめられたことにはならず、別途評価が必要です。
好みに合わせた服装提案、学習状況に応じた教材生成、個別の学習支援も、応用の構想として考えられます。ただし、これらには利用者の好みや理解度を捉える仕組み、候補を選ぶ仕組み、内容の適切さを確認する工程などが必要です。VAE単体で一人ひとりに合ったサービスや学習効果が実現すると断定することはできません。
VAEの限界と条件付き生成への発展
VAEでは、再構成の正確さ、生成画像の自然さ、多様性、操作のしやすさを分けて評価することが大切です。元の画像に近く戻せるモデルでも、新規生成で出力が偏ることがあります。逆に、多様な画像が出ても、細部が曖昧だったり、指定した特徴を保てなかったりする場合があります。
典型的な構成で課題になるのが、細部のぼやけです。たとえば、画素の二乗誤差に対応する再構成項では、細部の候補が複数あると、それらを平均したような出力が有利になる場合があります。潜在表現に十分な情報を残せないことも、細かな模様の再現を難しくします。毛並みや葉脈のような細い構造を扱うには、データ、出力分布、ネットワーク、学習目的を含めた検討が必要です。
もう一つの課題が「事後崩壊」です。近似事後分布が入力によらず事前分布に近い状態となり、潜在変数が入力ごとの情報を十分に伝えなくなる現象を指します。デコーダが潜在変数を使わずにデータのパターンを説明できる場合などに起こり得ます。学習では、KL項が小さいという理由だけで良い状態だと判断せず、潜在変数を変えたときに出力へ適切な変化が現れるかも確認します。
学習データの偏りにも注意が必要です。限られた筆跡の数字しか学んでいなければ、生成する筆跡も偏る可能性があります。学習時と大きく違う画像など、分布外のデータに対しては、再構成や異常度の判断が期待どおりに働くとは限りません。対象となるデータの範囲を決め、その範囲を代表する評価用データで確かめることが重要です。
生成内容を制御する発展形に、条件付きVAE(CVAE)があります。画像と一緒に数字の種類などの条件を与えて学習させ、生成時にもその条件を指定します。たとえば「3」というラベルを与えたうえで潜在変数を変えれば、数字の種類を揃えながら筆跡に変化をつけることを目指せます。条件をどのように与えるかは、モデルの設計と学習データに依存します。
基本的なVAEが、「赤い服を着た笑顔の女性」のような自由な文章指示を、そのまま理解するわけではありません。文章を条件に使うには、その意味を数値に変換する仕組みや、文章と画像の対応を学ぶためのデータ・構成が必要です。生成を制御できることと、あらゆる指示を正確に実現できることは区別して考えます。
今後の発展を考えるうえでの焦点は、細部の表現、潜在変数の活用、条件に沿った制御、用途ごとの検証です。VAEは、データを確率的な潜在表現へまとめ、そこから再構成や生成を行う仕組みを学ぶうえでも役立ちます。まずは手書き数字の再構成、事前分布からの生成、潜在空間の補間を見比べると、それぞれの役割と限界を具体的に理解できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月4日 | 確率分布と学習目的の説明を改め、生成モデルの比較と応用上の注意を追記 |