
VLAとは?画像と言葉をロボットの動作につなぐ視覚・言語・行動モデル

AIの初心者
画像を見て「赤いカップがあります」と答えるAIなら知っています。そのAIに頼めば、ロボットもカップを運べるのでしょうか?

AI専門家
物を見分けるだけでは、腕をどちらへ動かし、いつつかむかは決まりません。画像や言葉の指示から、ロボットが実行する動作を生成するのがVLAです。
AIの初心者
「何をするか」を理解してから、実際に手を動かすまでをつなぐのですね。途中でカップの位置がずれたらどうなりますか?
AI専門家
実行後の様子を観測し、次の動作を更新する仕組みが重要になります。指示の理解、動作の生成、機体の制御に分けて考えると、その役割がわかります。
VLA(視覚・言語・行動モデル)とは。
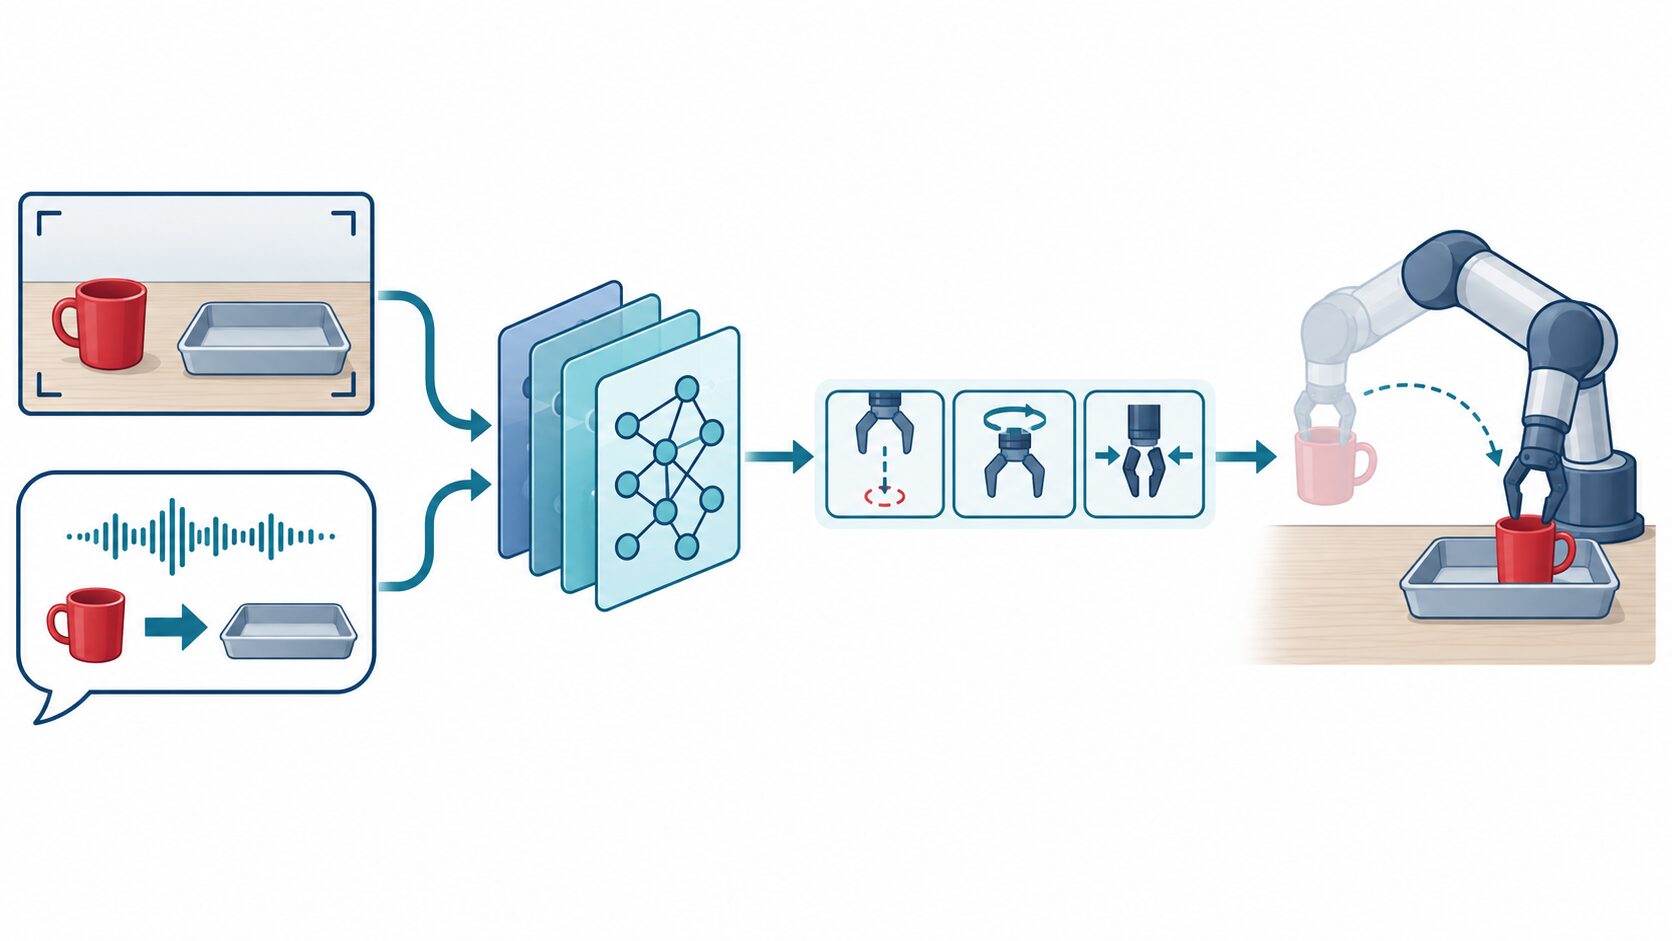
VLAはVision-Language-Actionの略で、画像と言語による指示などを入力として、ロボットの行動を生成するモデルです。周囲の状況を説明するだけでなく、手先の移動や物をつかむ指令など、実行につながる動作表現を出力する点に特徴があります。
「赤いカップをトレーに置いて」という短い依頼にも、対象の特定、つかみ方の選択、移動、置いた結果の確認が含まれます。この例を通じて、VLAの仕組みと関連技術との違い、実用化で確認すべき条件を見ていきましょう。
VLAの入力と出力:画像と言葉を動作につなぐ
VLAを理解する鍵は、「見た内容を答える」ことから「目的に沿って動く」ことへ、出力の役割が広がる点です。カメラに机の上のカップとトレーが映り、「赤いカップをトレーに置いて」という指示が与えられると、それらの情報をもとに動作を生成します。画像は現在の状況、言葉は達成したい目的を伝えます。
入力は画像と言葉だけとは限りません。構成によっては、関節の角度、手先の位置、つかむ部分の開閉状態といった機体の情報も受け取ります。同じカップが見えていても、腕が伸びた状態と折り畳まれた状態では、次に必要な動きが異なるからです。過去の観測を使うか、どのセンサーを使うかもモデルやシステムによって変わります。
出力の形式にも違いがあります。手先をどの方向へどれだけ動かすか、どの向きにするか、物を挟むグリッパーを開くか閉じるか、といった指令が一例です。関節の目標値を出す構成や、短い動作の列をまとめて出す構成もあります。これらは、機体側の処理や制御器が利用する、数値などで表された動作です。
そのため、「カップを持ち上げます」という文章を生成しただけでは、実行可能な動作が得られたことにはなりません。一方、VLAが必ずモーターへ直接電流を指定するわけでもありません。モデルの行動出力をどのように実際の運動へ変換するかは、ロボットとの接続方法を含めて決まります。
代表的な学習方法では、作業中の画像、指示、実演した動作を対応づけます。たとえば、人がロボットを操作してカップを移す際の観測と動作を記録し、状況に応じた行動を学ばせます。ただし、実演を学習したことと、あらゆる置き方で成功することは別です。実機では動いた結果を再び観測し、次の動作を更新する流れが重要で、一度の推論だけで作業全体の成功が決まるわけではありません。
VLM・マルチモーダルAI・経路計画との違い
VLAは、複数の種類の情報を扱うマルチモーダルAIの一種と捉えられます。マルチモーダルAIという言葉だけでは、出力が文章なのか、画像なのか、ロボットの行動なのかは決まりません。VLAは、その中でも視覚・言語と行動を結びつけるモデルを指します。
似た略語のVLMはVision-Language Modelで、画像と言語を扱うモデルです。代表的な使い方は、画像の内容に答えたり、対象を説明したりすることです。両者の違いは、単に画像を認識できるかではなく、出力が何のために使われるかにあります。
| 技術・概念 | 主な入力 | 出力・役割の例 |
|---|---|---|
| マルチモーダルAI | 画像、文章、音声など複数の形式 | 理解や生成を行う広い分類。出力形式は用途による |
| VLM | 画像と質問・指示など | 「赤いカップが机の右側にある」と説明する |
| VLA | 画像、言語指示、必要に応じて機体の状態 | カップに手を近づけ、つかむための動作を生成する |
| 経路計画 | 現在位置、目標、障害物や動作の制約など | 目標までどの経路を通るかを求める |
同じカップの画像でも、「何が写っているか」という質問と、「これを移して」という指示では必要な出力が違います。VLMが位置や対象の情報を出し、それを別の処理が利用してロボットを動かす構成も可能です。したがって、VLMがロボットに使われないという意味ではなく、モデルが担う範囲を見分ける必要があります。
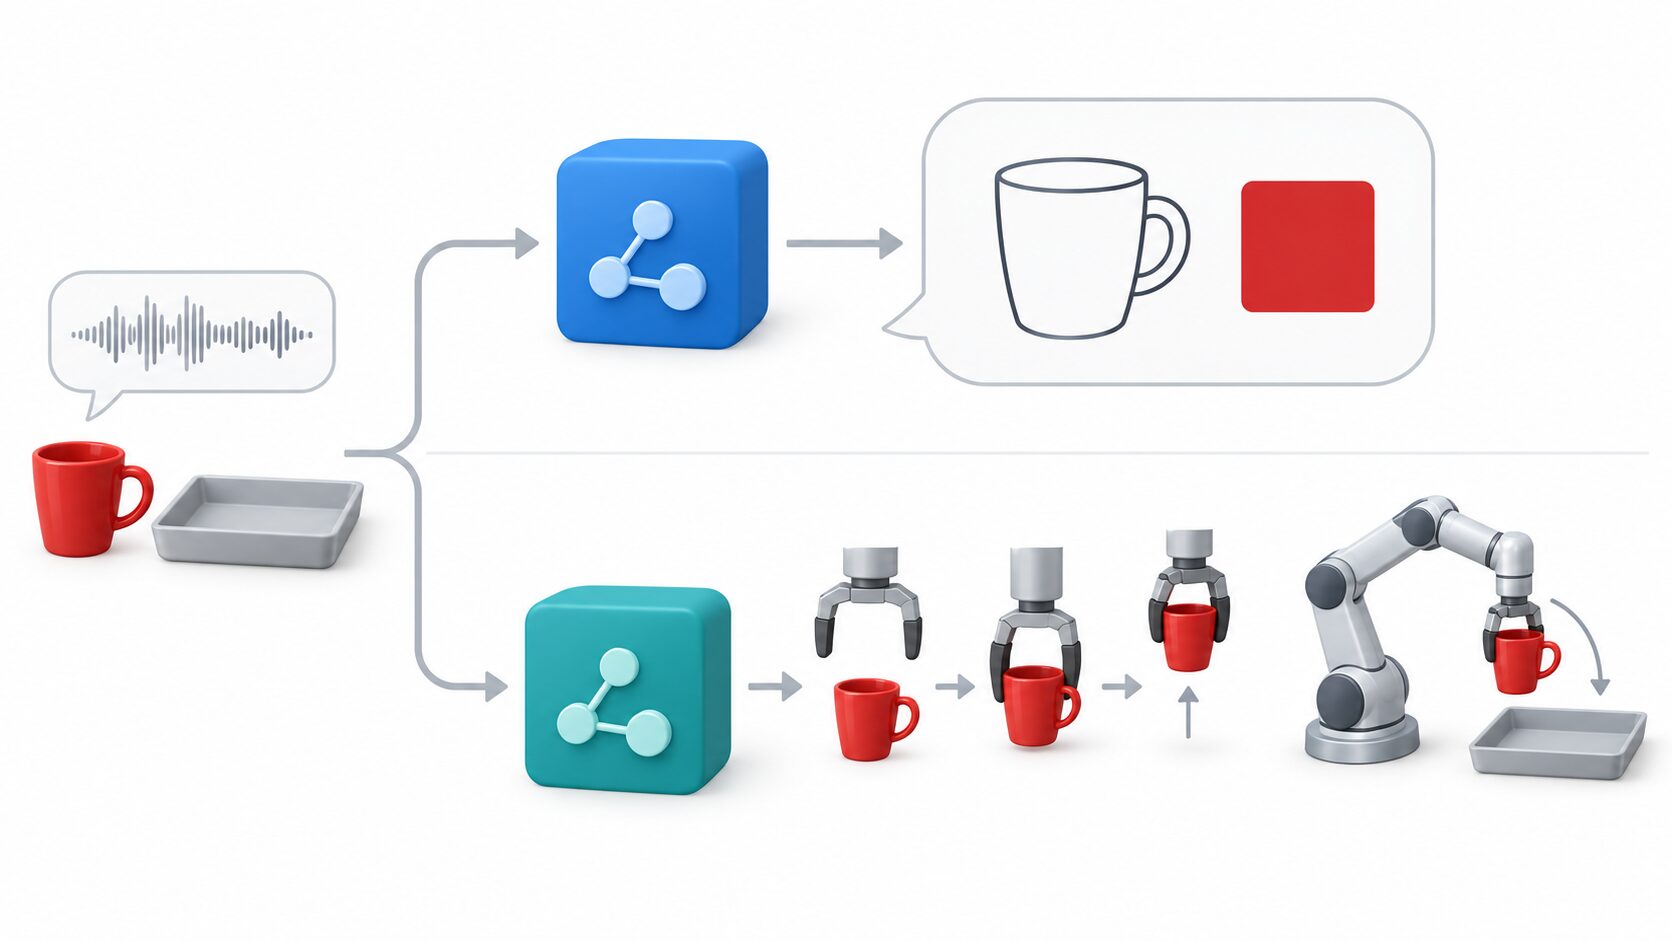
経路計画は、カップへ向かう腕が途中の物にぶつからないように経路を求める、といった処理です。言葉から作業の意味を理解することとは役割が異なり、VLAと組み合わせて使えます。学習した動作を出せるからといって、障害物や機体の制約を考慮する処理まで、常に置き換えられるわけではありません。
指示の理解・計画・動作生成・制御の役割分担
言葉が実際の運動になるまでには、複数の役割があります。カップ移動を例にすると、次のように整理できます。これは理解のための分け方であり、すべての製品が五つの独立したモデルを使うという意味ではありません。
- 指示の理解:赤いカップが移動対象で、トレーが置き場所だと捉える。「置く」という目的を、単に持ち上げる動作と区別する。
- 対象・空間関係の把握:カップとトレーの位置、手前にある障害物、手が届く範囲など、作業に必要な状況を把握する。
- 手順の選択:カップに近づく、つかむ、持ち上げる、トレーまで運ぶ、下ろして離す、といった順序を決める。
- 動作の生成:現在の観測に応じて、手先の移動量や向き、グリッパーの開閉など、機体で実行する動作を出力する。
- 機体の制御:与えられた目標に関節や駆動系を追従させ、腕やグリッパーを実際に動かす。
このうち、身体や周囲の環境を踏まえて判断する推論は、Embodied Reasoningと呼ばれます。「カップの上をつかめるか」「先に別の物を避ける必要があるか」といった、現実の作業条件に関わる判断です。上位の処理が目標や手順を決め、それを受けたVLAが具体的な動作を生成する構成が考えられます。
ただし、独立した計画モデルがすべてのVLAに必要なわけではありません。指示と観測から動作をまとめて学習する構成もあり、どこまでを一つのモデルに担当させるかは設計によります。「推論用のモデルがあるか」だけで能力を判断せず、目標の選択と動作の実行がどう接続されているかを見ることが大切です。
低レベル制御は、動作の目標を機体の運動として実現する役割です。たとえばVLAが「手先を少し前へ」という動作を出した場合、制御側では機体に応じて関節を動かします。作業の意味を理解することと、関節を目標どおりに動かすことは、異なる問題として扱えます。
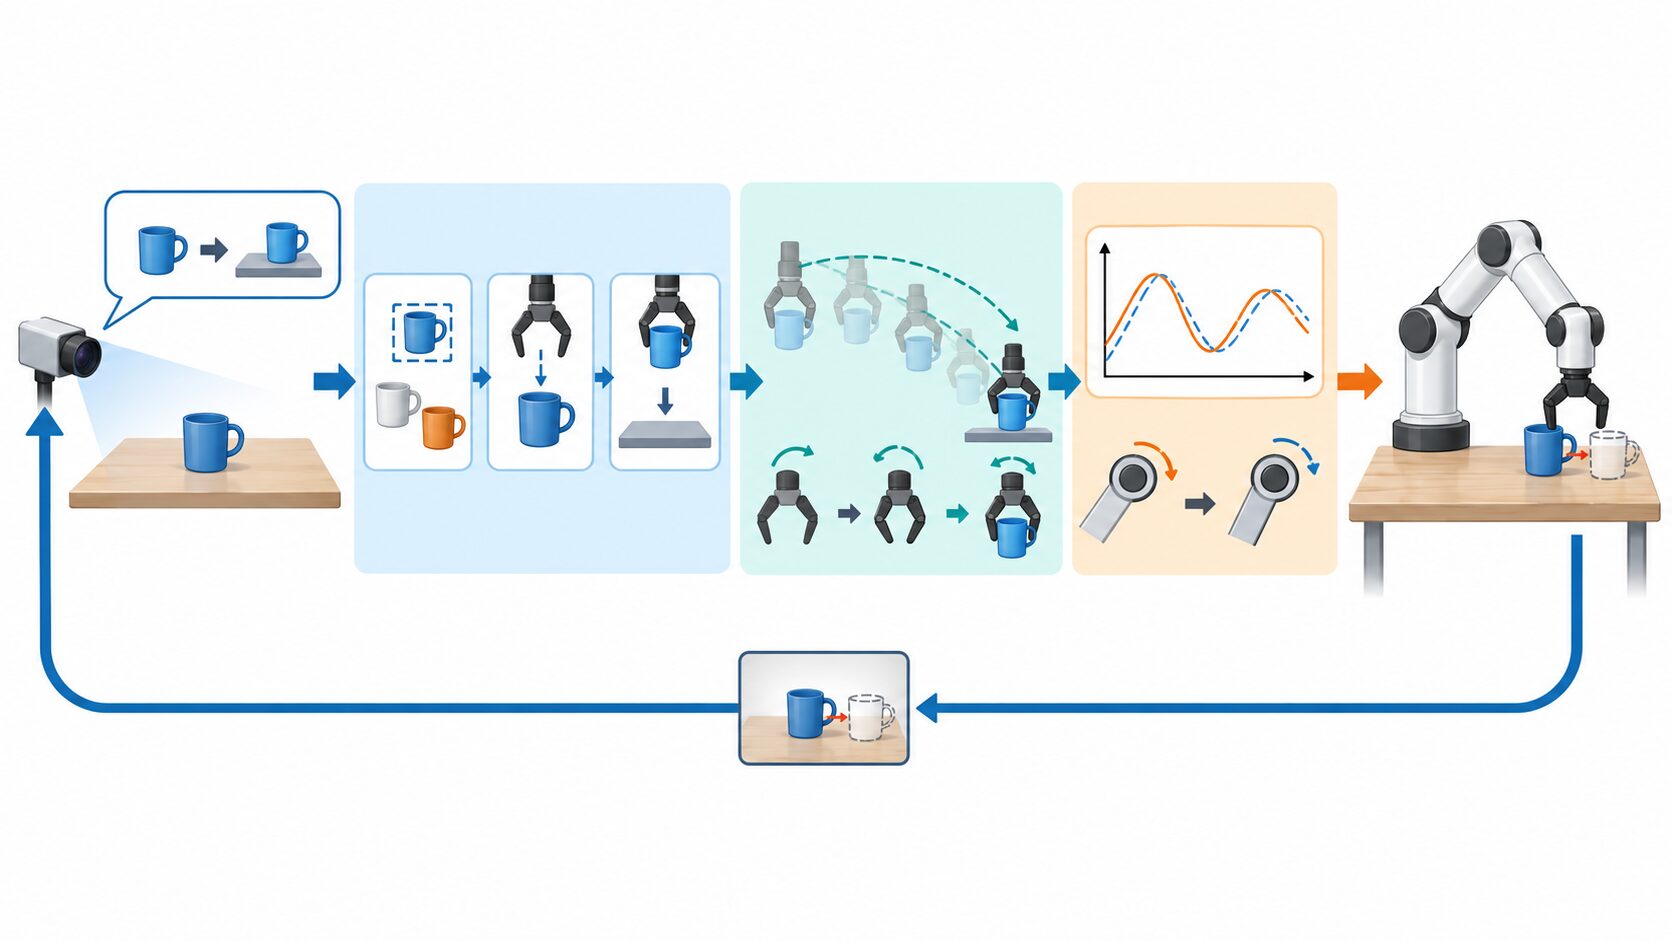
実行中は、観測、推論・動作生成、制御、再観測という循環が重要になります。手が近づいたときにカップがずれたなら、新しい位置を反映する必要があります。ただし、手でカップが隠れたり、つかんだ後に滑ったりすると、変化を十分に捉えられない場合もあります。再観測できることと、失敗を必ず検知して修正できることは同じではありません。
ロボットの身体が変わると何が難しいのか
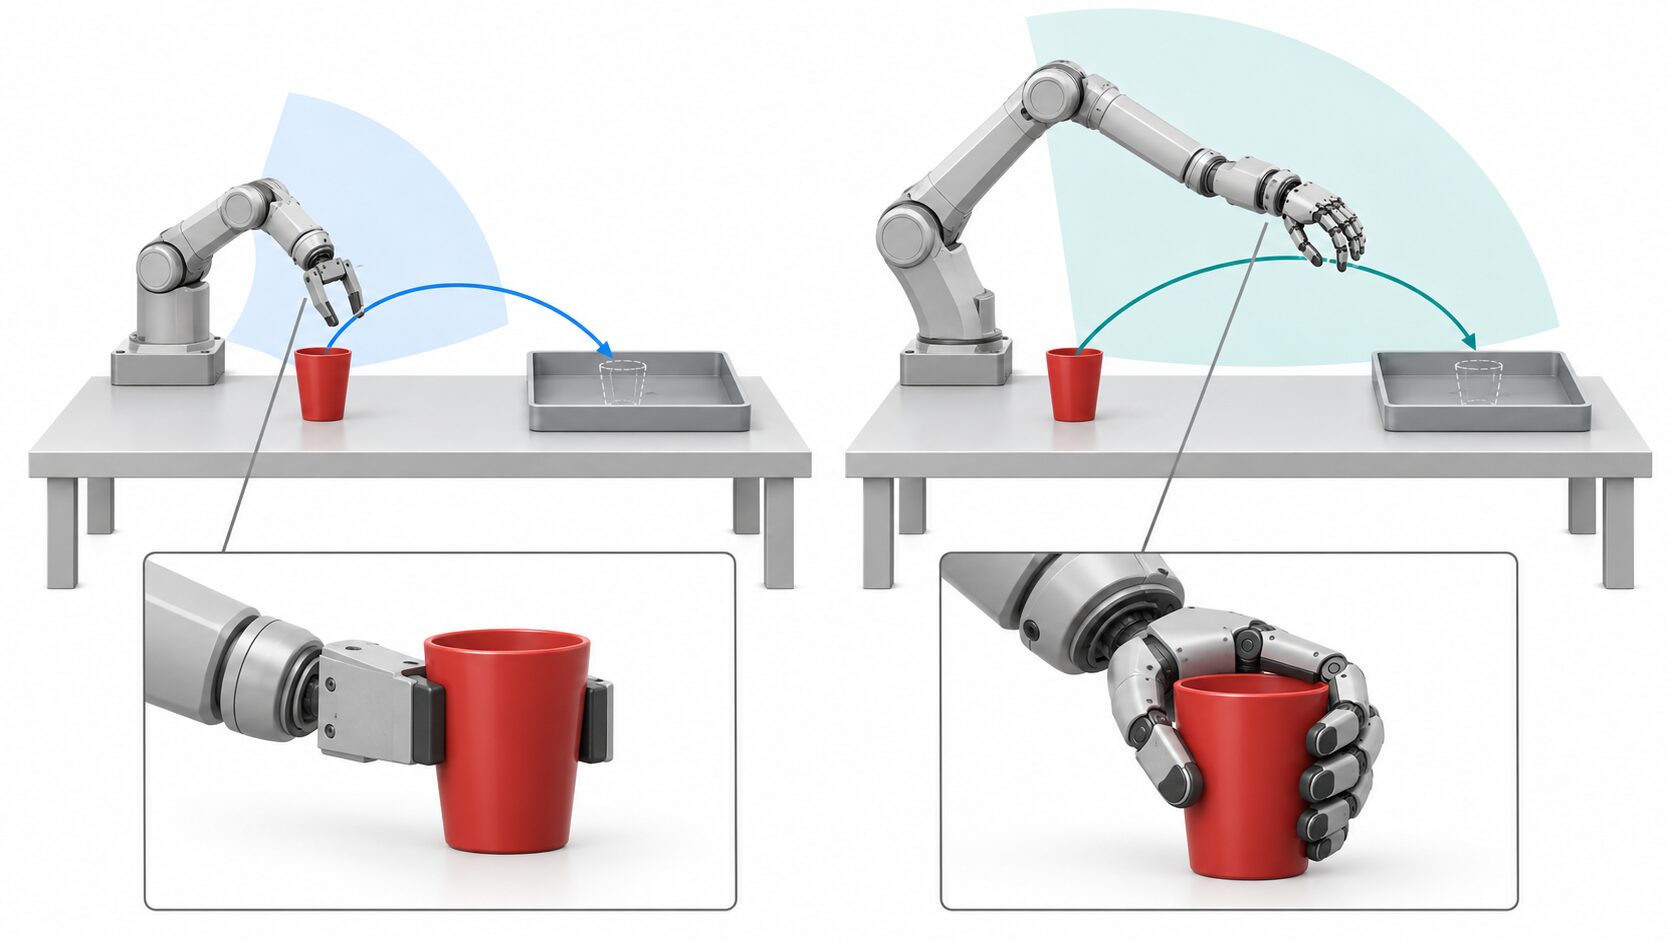
同じ指示を理解できても、別のロボットで同じ動作をそのまま使えるとは限りません。腕の長さ、関節数、可動範囲、物をつかむ機構が変わると、届く場所や取れる姿勢も変わります。ある機体でカップに届いた関節の目標値が、別の機体でも同じ位置を意味するわけではありません。
二本指のグリッパーなら、カップを両側から挟む動作を考えられます。一方、多指ハンドでは、複数の指をどこに当て、どのように曲げるかも関わります。必要な動作の項目や数が異なるため、単に出力値をコピーするだけでは対応できません。同じ「つかむ」という目的にも、身体に応じた実現方法があります。
カメラの位置も影響します。机を上から見るカメラと、手首について腕と一緒に動くカメラでは、カップの見え方や物が隠れるタイミングが違います。さらに、画像上の位置と、実際に手を動かす方向との対応も必要です。モデルだけでなく、カメラと機体の位置関係の調整が関わることもあります。
複数の機体で集めたデータを使う学習や、導入する機体のデータで追加学習する方法は、対応範囲を広げる手段です。それでも、任意のロボットへの無調整の転用を保証するものではありません。利用できる機体、入力する状態情報、出力する動作の形式を確認し、接続後は実機での評価が必要です。
身体への適応とは別に、環境への汎化も課題です。汎化とは、学習時と異なる状況にも対応することを指します。赤いカップを扱えても、輪郭が捉えにくい透明なカップや、物が重なった机では失敗するかもしれません。機体が変わった問題と、対象物・照明・配置が変わった問題を分けると、追加するデータや評価条件を選びやすくなります。
オンデバイスVLAが役立つ場面と制約
VLAの用途として考えられるのは、工場や倉庫での物品操作、施設での片づけなどです。対象物や配置が変わる作業では、画像から状況を捉え、言葉で目的を指定できることに価値があります。ただし、「片づけ」という指示で何でも扱えるという意味ではありません。物の種類、重さ、置き場所、作業空間などにより、実用的に任せられる範囲は変わります。
このような作業で、機体側の計算装置などを使って推論する方式がオンデバイスVLAです。通信先へ画像を送り、結果が戻るのを待つ処理を減らせるため、通信遅延や回線断の影響を抑えるうえで役立ちます。施設の中を移動しながら物品を回収する場合、場所によって通信が不安定になることへの対処として考えられます。
また、画像を外部へ送らずに処理できる構成は、作業空間の映像を外に出したくない場合にも有用です。ただし、オンデバイスで推論していても、記録や遠隔監視のためにデータを送るシステムはあり得ます。画像の扱いは、推論の場所だけで決めつけず、保存や送信の仕組みも含めて確認する必要があります。
制約は、搭載できる計算資源です。大きなモデルを動かすには、処理性能やメモリーが必要になり、消費電力や発熱も問題になります。電池で動く移動ロボットなら、推論のための電力も稼働時間に関わります。小さなモデルにすれば負担を抑えられる可能性がありますが、必要な精度と応答時間を実際の機器で評価しなければなりません。
上位の計画はクラウドで行い、近くの物をつかむ動作は機体側で生成するなど、役割を分ける構成も可能です。その場合は、通信が切れたときにどの処理まで継続できるかが重要になります。オンデバイス化は処理の配置に関する選択であり、それだけで安全性や高精度を保証するものではありません。
デモの成功と実用化を分ける評価・安全性
ロボットが一度カップを運ぶ映像は、ある条件で動作できたことを示します。しかし、毎日の作業を安定して任せられるかを判断するには情報が足りません。何回試して何回成功したか、対象物や配置をどこまで変えたか、所要時間はどの程度か、人がどれだけ助けたかをセットで確認します。
成功の定義もそろえる必要があります。「カップを持ち上げた」と「指定のトレーに倒さず置いた」では、達成した作業が違います。途中で人がカップを直した試行をどう扱うかによっても数値は変わります。同じ成功率でも、評価条件が異なれば、そのまま性能の優劣を比べることはできません。
| 確認する項目 | 見るべき内容 |
|---|---|
| 試行数と成功率 | 試行の総数、成功とする到達状態、人の介入を含めるか |
| 対象物と環境 | 未知の物体、配置、照明、周囲の物の多さを変えた結果 |
| 所要時間と介入 | 作業完了までの時間、停止や人の補助が必要になる頻度 |
| 失敗後の挙動 | 把持失敗や通信断の検知、停止、再試行、人への引き継ぎ |
評価では、正常に進む場面に加えて、失敗する条件も調べます。つかみ損ねたのに次の移動へ進まないか、物の位置が見えなくなったときに動き続けないか、回線が切れたらどう振る舞うか、といった点です。再試行も、同じ動きを繰り返せばよいとは限りません。落ちた物が作業範囲を外れた場合などは、人への引き継ぎが必要になることがあります。
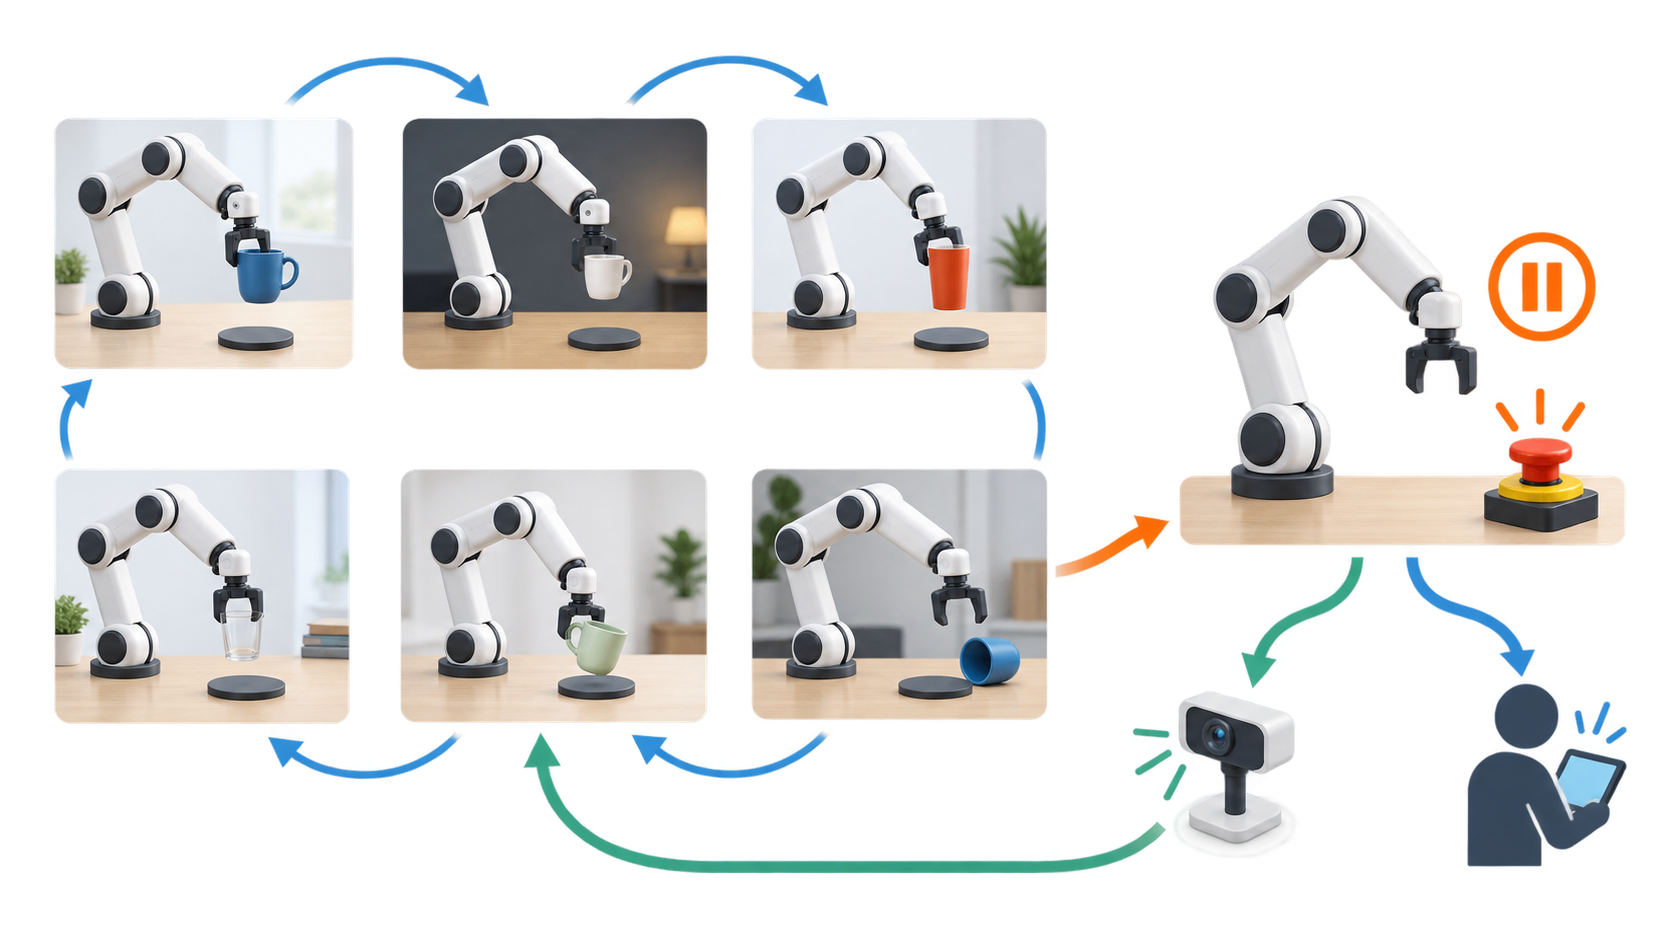
衝突防止、速度や力の制限、非常停止などは、ロボットシステム全体で設計する必要があります。VLAが言葉や状況を理解する能力だけに頼るのではなく、機体、制御、センサー、作業場所、運用手順を含めて考えます。モデルの作業成功率が高いことと、人や設備の近くで安全に運用できることは、分けて判断すべき事項です。
導入やデモの評価では、次の四点を明確にすると、期待と実力の差を捉えやすくなります。
- 対象作業:何をどこまでできれば完了か。扱う物と成功の条件が決まっているか。
- 機体:どの腕・ハンド・カメラで確認された能力か。導入する機体への調整が必要か。
- 環境:配置、照明、通信、人の立ち入りなど、運用する条件が評価に含まれるか。
- 評価と復旧:反復試行の結果があり、失敗時に停止・再開・引き継ぎを行えるか。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月6日 | 初回公開 |