
推測統計学とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「推測統計学」は、一部を調べて全体の様子を推測する方法なんですよね。でも、一部のデータだけで、全体についてどこまで分かるんですか?

AI専門家
例えば、よくかき混ぜたスープなら、スプーン一杯の味見が鍋全体の味を知る手がかりになりますね。調査でも、全体の特徴を捉えられるように一部を選ぶことが出発点です。ただし、選ぶ相手が変われば結果も変わるので、推測の不確かさも一緒に評価します。
AIの初心者
人の意見や魚の大きさは、スープのように均一にはなりませんよね。調べる相手によって結果が違っても、推測はできるのでしょうか?
AI専門家
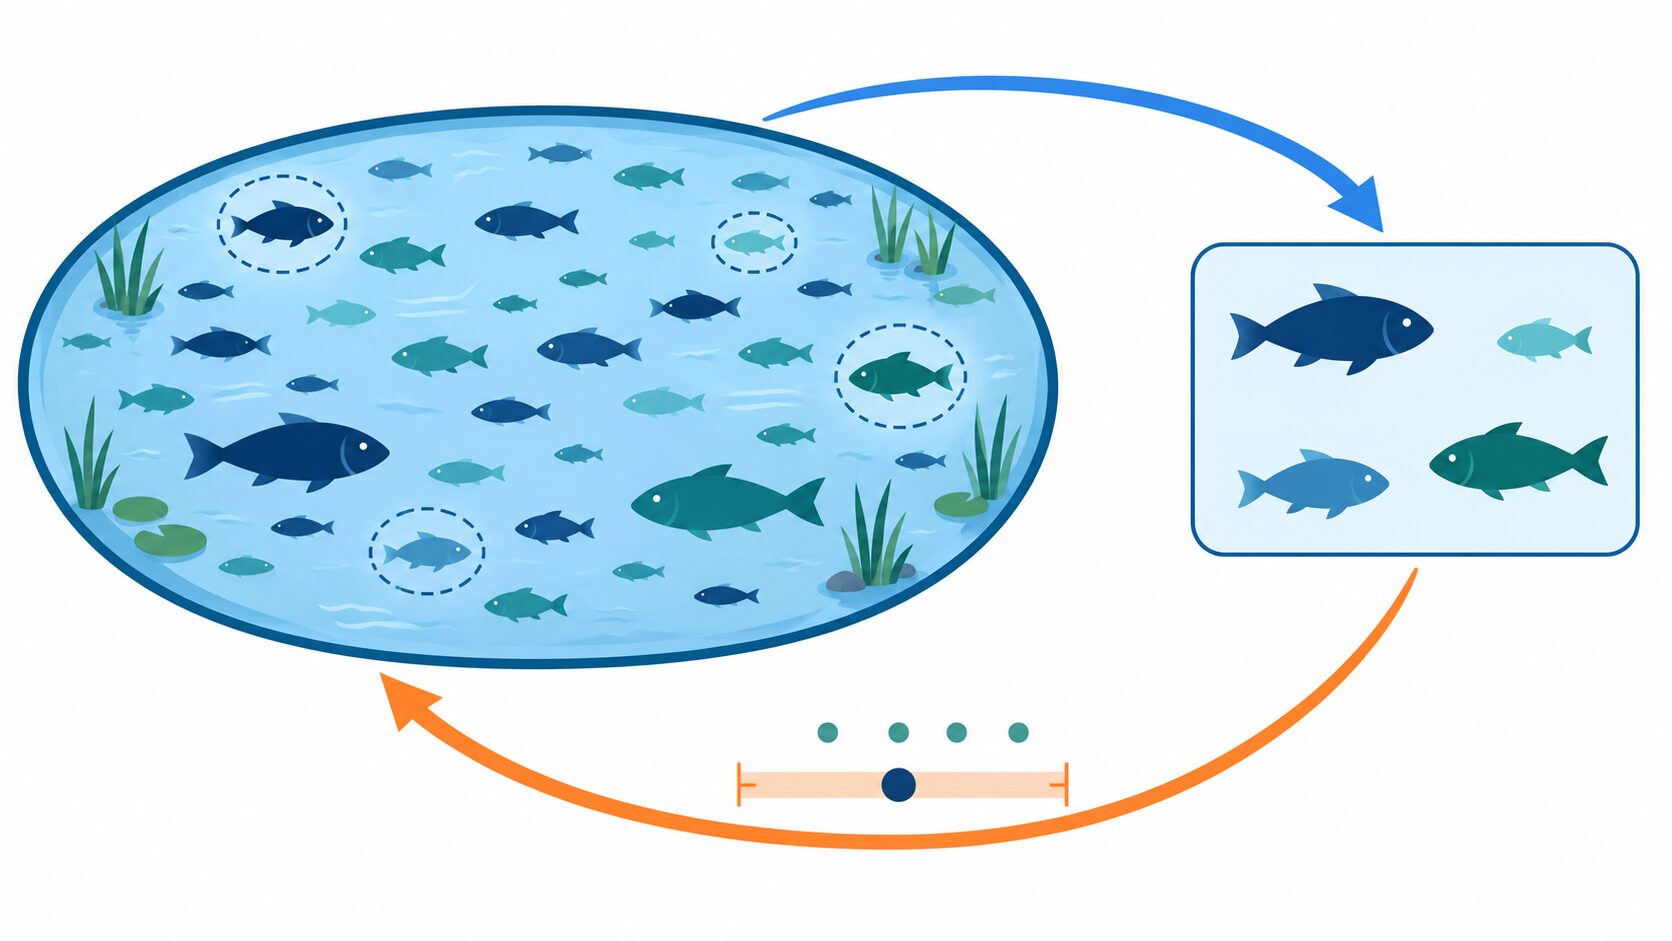
はい。その違いを確率の考え方で扱います。例えば、魚の平均体長を一つの値で見積もるだけでなく、推定にどのくらいの幅があるかも示します。ただし、池の端の魚しか捕まえないような選び方の偏りは、計算だけでは解消できません。データの集め方と結果の読み方をセットで考えることが大切です。
推測統計学とは
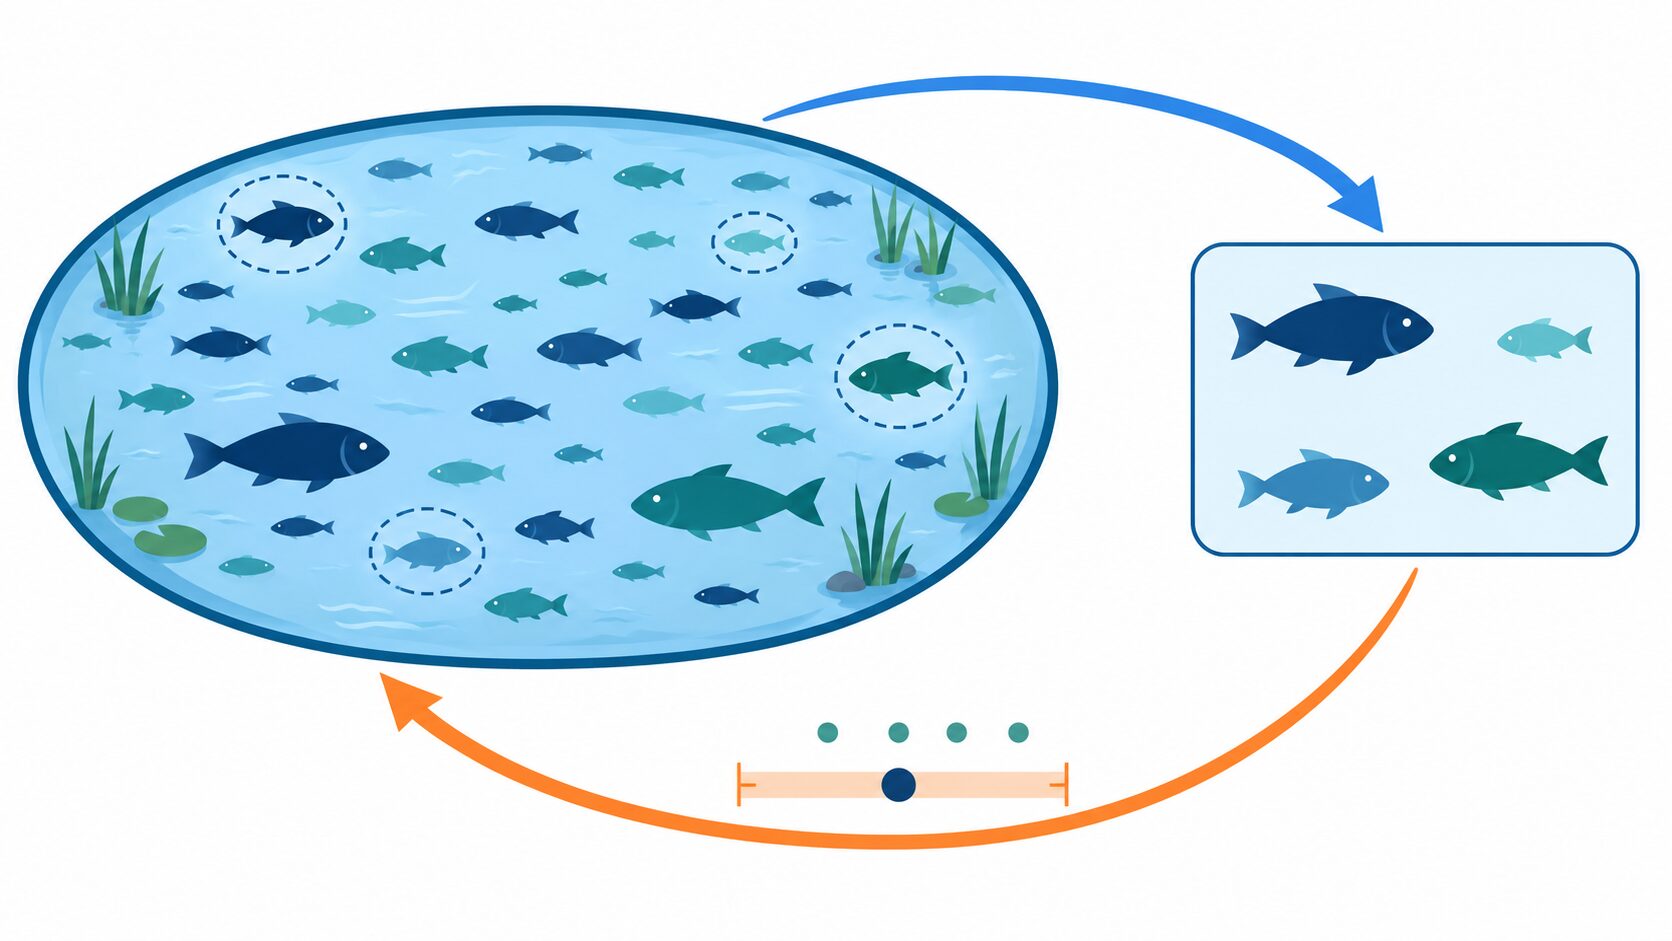
推測統計学は、一部のデータである「標本」から、知りたい全体である「母集団」の性質を推測し、その不確実性も評価する統計学の分野です。平均や割合などの未知の値を見積もる「推定」と、仮説とデータの整合性を調べる「検定」が基本になります。
一部を調べれば無条件に全体が分かるわけではありません。誰を、どこから、どのように選んだかという調査設計と、偶然によるばらつきを扱う仕組みが推測を支えます。以下では、池の魚の平均体長を身近な例に、標本の選び方から信頼区間・検定の読み方までを順に説明します。
推測統計学の役割と記述統計学との違い
全国の小学生の平均身長を知りたいとき、全員を同じ時期に測る全数調査には、多くの費用と時間がかかります。そこで、対象となる小学生の一部を選んで測り、その結果から全体の平均身長を見積もります。この場合、全国の小学生全体が母集団、実際に調べた小学生の集まりが標本です。
母集団は、分析する前に範囲を決めます。「全国の小学生」であっても、何年のどの時点を対象とするかによって構成が変わります。母集団の平均を「母平均」、ある特徴を持つ人や物の割合を「母比率」と呼びます。これに対し、標本から計算した平均は「標本平均」、割合は「標本比率」です。推測統計学では、観測できた標本の値を手がかりに、未知の母平均や母比率を推測します。
ここで区別したいのが、記述統計学との役割の違いです。記述統計学は、手元のデータを平均・割合・グラフなどで要約します。推測統計学は、そのデータを超えて対象集団について述べるために、標本の選び方や推定値のばらつきまで考えます。
| 比較する点 | 記述統計学 | 推測統計学 |
|---|---|---|
| 主な目的 | 調べたデータの特徴をまとめる | 標本から母集団の特徴を推測する |
| 平均身長の例 | 調べた小学生の平均身長を計算する | その標本平均から全国の小学生の母平均を見積もる |
| 主な道具 | 平均、中央値、標準偏差、集計表、グラフ | 点推定、信頼区間、仮説検定など |
| 結果を読む視点 | 手元のデータがどのような特徴を持つか | どの集団に結論を広げられ、推測にどれほど不確実性があるか |
同じ標本平均でも、調べた人の特徴を説明するのか、調べていない人を含む全体の平均を推測するのかで役割が変わります。実際の分析では、まず記述統計で分布や外れ値を確認し、そのうえで推測統計に進むことが多く、両者はつながっています。
推測統計学の基本となる「推定」は、「全体の平均はどのくらいか」といった値の見積もりです。「検定」は、「全体の平均はある基準値と等しい」という仮説に対し、得られたデータがどの程度整合するかを調べます。現在の平均身長や支持率も対象になるため、推測統計学は未来予測だけを指す言葉ではありません。
母集団を捉える標本の選び方
標本から全体を推測するには、まず標本の集め方を考える必要があります。池の魚の平均体長を調べるのに、池の端にいる魚だけを捕まえたとしましょう。大きな魚が端に集まりやすければ、標本平均は池全体の平均より大きくなりやすくなります。このように、選び方によって特定の特徴が過剰に含まれることを「選択の偏り」といいます。
調査を設計するときは、対象の魚の種類や調査期間を決め、どの場所・深さまで調べるかを明確にします。網の目が粗く小さな魚を捕まえにくい場合も、偏りの原因になります。人を対象にする調査なら、連絡できる人の名簿に抜けがないか、回答しない人に共通の特徴がないかも確認します。
標本を選ぶ代表的な方法には、次の違いがあります。学校や児童を例にすると、何を一つの抽出単位にするかが分かりやすくなります。
| 抽出方法 | 選び方 | 小学生を調べる例と注意点 |
|---|---|---|
| 単純無作為抽出 | 母集団全体から、各個体が等しい確率で選ばれるように無作為に抽出する | 全児童の名簿から、くじのように一定人数を選ぶ。対象を網羅した名簿が必要 |
| 層化抽出 | 母集団を地域や学年などの層に分け、各層から無作為に抽出する | 地域・学年ごとに児童を選ぶ。各層の人数や抽出割合を考慮して全体を集計する |
| クラスター抽出 | 母集団を学校などの集団に分け、一部の集団を無作為に選んで、その集団全体を調べる | 選ばれた学校の全児童を測る。訪問先をまとめられるが、同じ学校の児童は特徴が似ている場合がある |
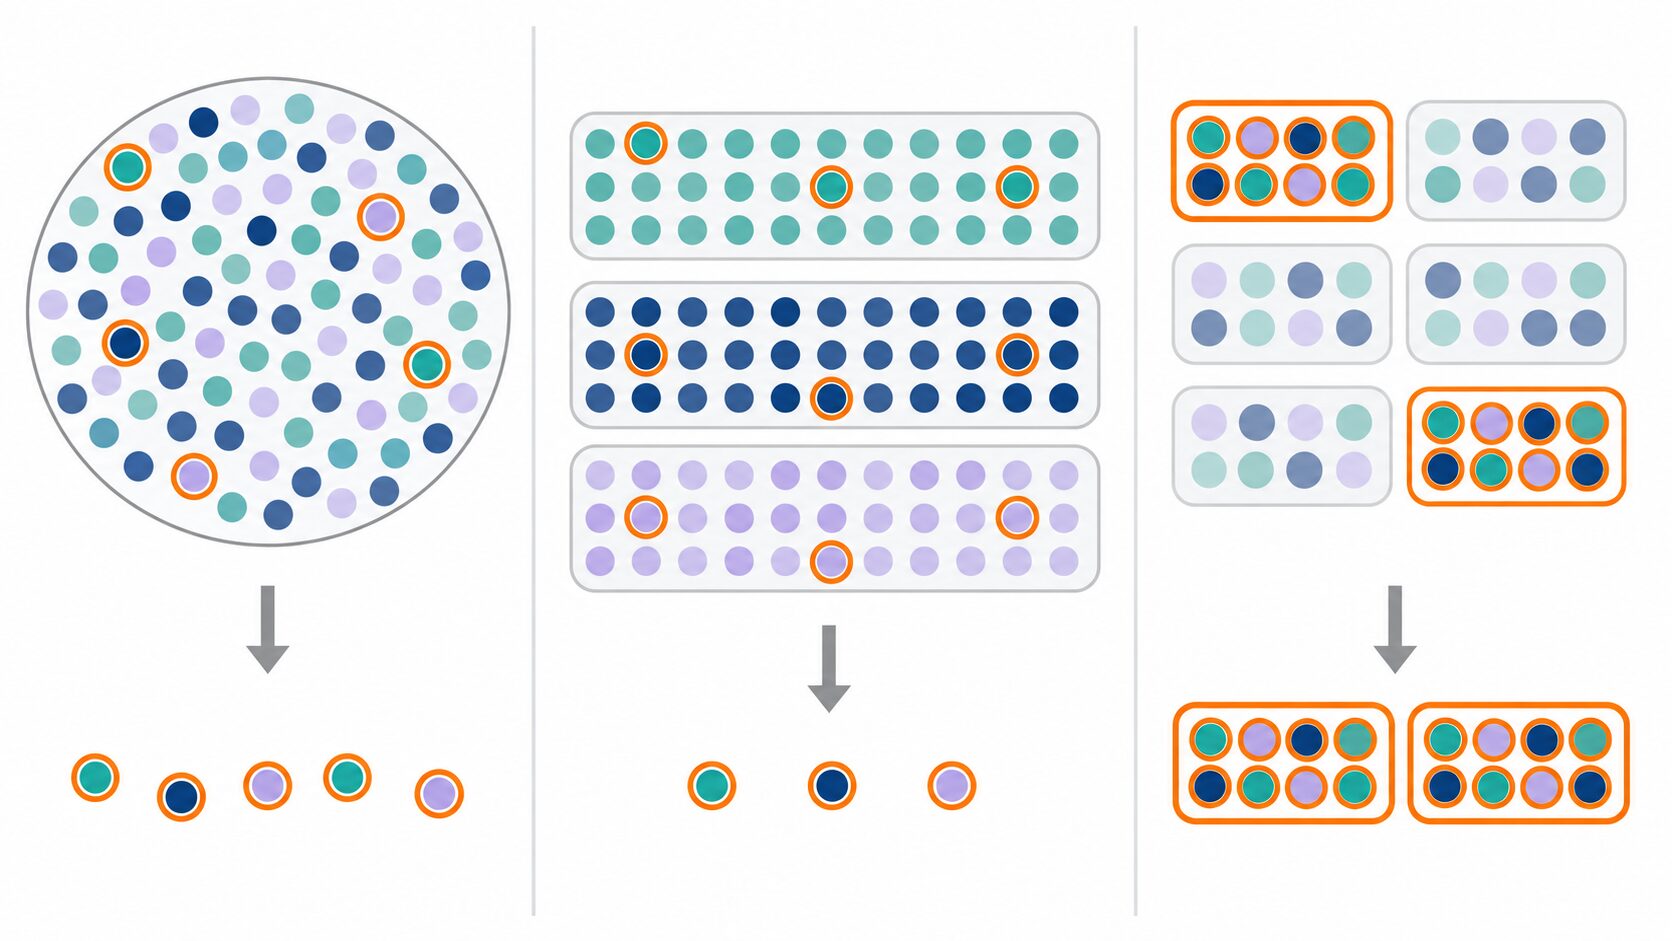
層化抽出は、分けた各層から標本を集める方法です。一方、ここでのクラスター抽出は、一部の集団を選んで、その中をまとめて調べます。層化抽出で人数の少ない層から多めに標本を取った場合は、全体の平均を計算するときに母集団の構成に合わせた重み付けが必要です。クラスター抽出では、集団内の似通い方を考慮して推定の精度を評価します。
同じ抽出条件なら、標本サイズを増やすと偶然による推定値のばらつきは減りますが、選び方の偏りは解消しません。池の端だけで大量に魚を捕まえても、池の中央にいる魚の情報が不足している点は変わりません。また、測定器のずれや、調査員ごとに異なる測り方による誤差も、人数を増やすだけでは直せません。
標本サイズは、データに含まれる人数や個数のことです。必要な精度に加え、調査費用・時間・回収できる見込みを踏まえて決めます。標本を増やすことと、抽出範囲や測定方法を改善することのどちらが有効かを、調査の目的に合わせて判断します。
推測を支える確率分布と標準誤差
確率分布は、どのような値がどのくらい起こりやすいかを表すものです。サイコロなら、それぞれの目が出る確率に対応します。魚の体長のような連続的な値では、「ある長さの範囲に入る確率」として捉えます。推測統計学では、個々の観測値の分布に加えて、標本平均などの統計量がどのくらい変動するかも確率分布で扱います。
例えば、池から一定数の魚を選んで平均体長を計算する調査を、同じ条件で繰り返す場面を考えます。選ばれる魚が変わるため、標本平均も毎回少しずつ変わります。その標本平均の分布を「標本分布」と呼びます。実際に何度も調査し直さなくても、抽出方法や統計モデルの前提を使って、このばらつきを評価できることが推測の仕組みです。
独立に同じ分布から得られ、有限の分散を持つデータについて、標本平均の標準誤差は次の式で表せます。
\(\mathrm{SE}(\bar{X}) = \frac{\sigma}{\sqrt{n}}\)ここで、\(\bar{X}\) は標本平均、\(\sigma\) は母集団の標準偏差、\(n\) は標本サイズです。\(\mathrm{SE}\) は標準誤差を表します。母集団の標準偏差が分からないときは、標本から求めた標準偏差を使って標準誤差を推定します。
標準偏差が「個々の魚の体長の散らばり」を表すのに対し、標準誤差は「調査を繰り返したときの推定値のばらつき」を表します。魚の体長に大きな個体差があっても、適切な方法で多くの魚を調べれば、平均体長の推定値のばらつきは小さくできます。
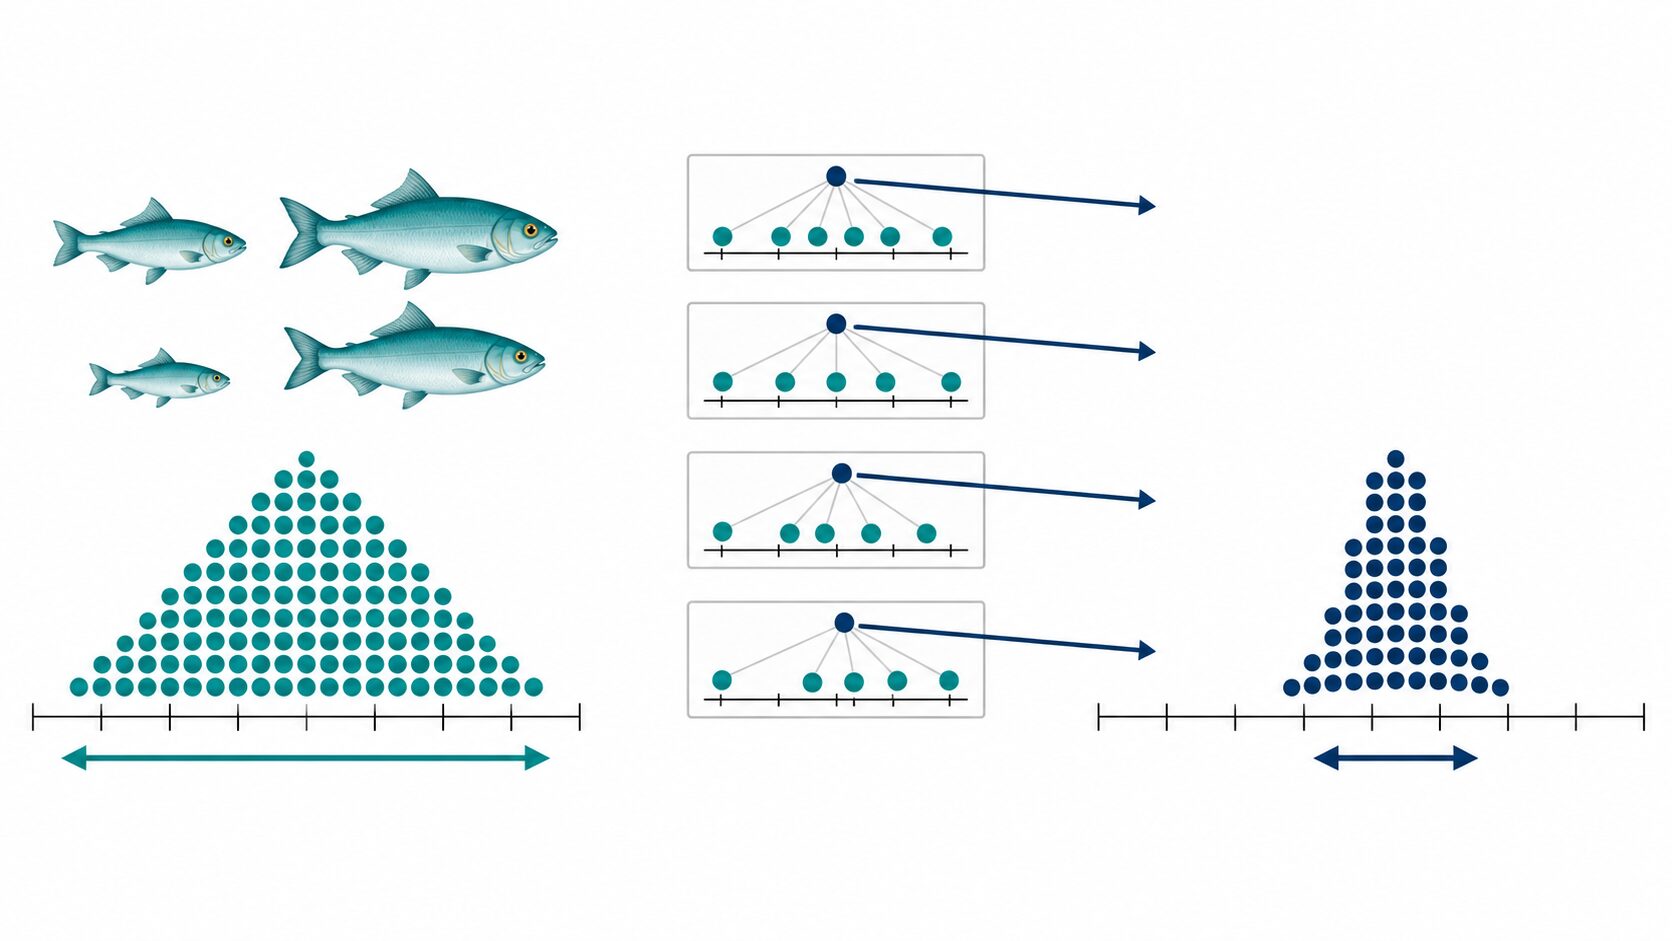
上の式では、母集団のばらつきなどの条件が同じなら、標本サイズを4倍にすると標準誤差は半分になります。例えば、独立な観測数を100から400へ増やす場合が該当します。精度を高めるには相応のデータ数が必要で、人数を2倍にしても標準誤差は半分にはなりません。なお、池の魚の大部分を重複なく調べる場合や、学校単位でまとめて抽出する場合には、抽出方法に応じた補正や計算が必要です。
確率分布には複数の種類があり、推定や検定の目的に応じて使い分けます。データそのものの分布を表す場合と、データから計算した統計量の分布を表す場合がある点にも注目してください。
| 確率分布 | 形や特徴 | 主な用途と前提 |
|---|---|---|
| 正規分布 | 平均を中心とした左右対称の釣鐘型。平均が位置、標準偏差が広がりを決める | 測定値のモデルや、標本平均の分布の近似に使う。元のデータが必ず正規分布になるわけではない |
| t分布 | 左右対称で、標準正規分布より裾が厚い。自由度が増えると標準正規分布に近づく | 母標準偏差が未知のときの平均の信頼区間やt検定に使う。特に少数のデータでは、独立性や母集団の正規性などの確認が重要 |
| カイ二乗分布 | 0以上の値を取り、自由度によって形が変わる | 正規母集団の分散に関する推定・検定や、カテゴリ別の件数を使う適合度検定・独立性の検定に使う |
適合度検定は、観測された件数の分布が想定した割合と整合するかを調べます。独立性の検定は、クロス集計した二つのカテゴリ変数に関連があるかを調べます。これらのカイ二乗検定では、各区分に期待される件数が十分かなど、近似を使うための条件も確認します。
また、独立性や分散に関する一定の条件の下では、標本サイズが大きくなるにつれて標本平均の分布が正規分布で近似できるようになります。これが「中心極限定理」の基本的な考え方です。ただし、元のデータ自体が正規分布に変わるわけではなく、近似に必要な標本サイズも分布の歪みなどによって異なります。すべてのデータに同じ分布や手法を当てはめないことが大切です。
推定:点推定と区間推定
推定とは、標本の情報を使って、母平均や母比率などの未知の値を見積もることです。推定値を一つの数値で示す方法を「点推定」、不確実性を考慮した範囲で示す方法を「区間推定」といいます。
説明用の仮定として、適切に選んだ魚の標本平均が16.5cmで、母平均の95%信頼区間が15〜18cmと計算されたとします。16.5cmを池全体の平均体長の見積もりとして示すのが点推定です。一方、15〜18cmという幅と95%という信頼水準を示すのが区間推定です。これらの数値は実際の調査結果ではありません。
| 方法 | 説明用の例 | 読み取れること | 単独では分からないこと |
|---|---|---|---|
| 点推定 | 母平均の推定値は16.5cm | 未知の母平均を、どの値と見積もったか | 抽出の偶然によって推定値がどのくらい変動し得るか |
| 区間推定 | 母平均の95%信頼区間は15〜18cm | 所定の信頼水準で作る区間の幅を通じた、推定の精度 | 個々の魚の体長の範囲や、選び方の偏りを含むすべての誤差 |
95%信頼区間の「95%」は、同じ抽出と区間の計算を繰り返したとき、作られた区間の約95%が真の母平均を含むという、手続きの性質を表します。この解釈は、抽出方法や計算に用いたモデルの前提が成り立つことに基づきます。
対象の池と時点を固定すれば、母平均は一つの値です。一方、標本が変わると、計算される区間の端点が変わります。繰り返しの中には母平均を含む区間も、含まない区間もできます。100回のうち必ず95回含むという意味ではなく、長く繰り返した場合の割合を述べています。
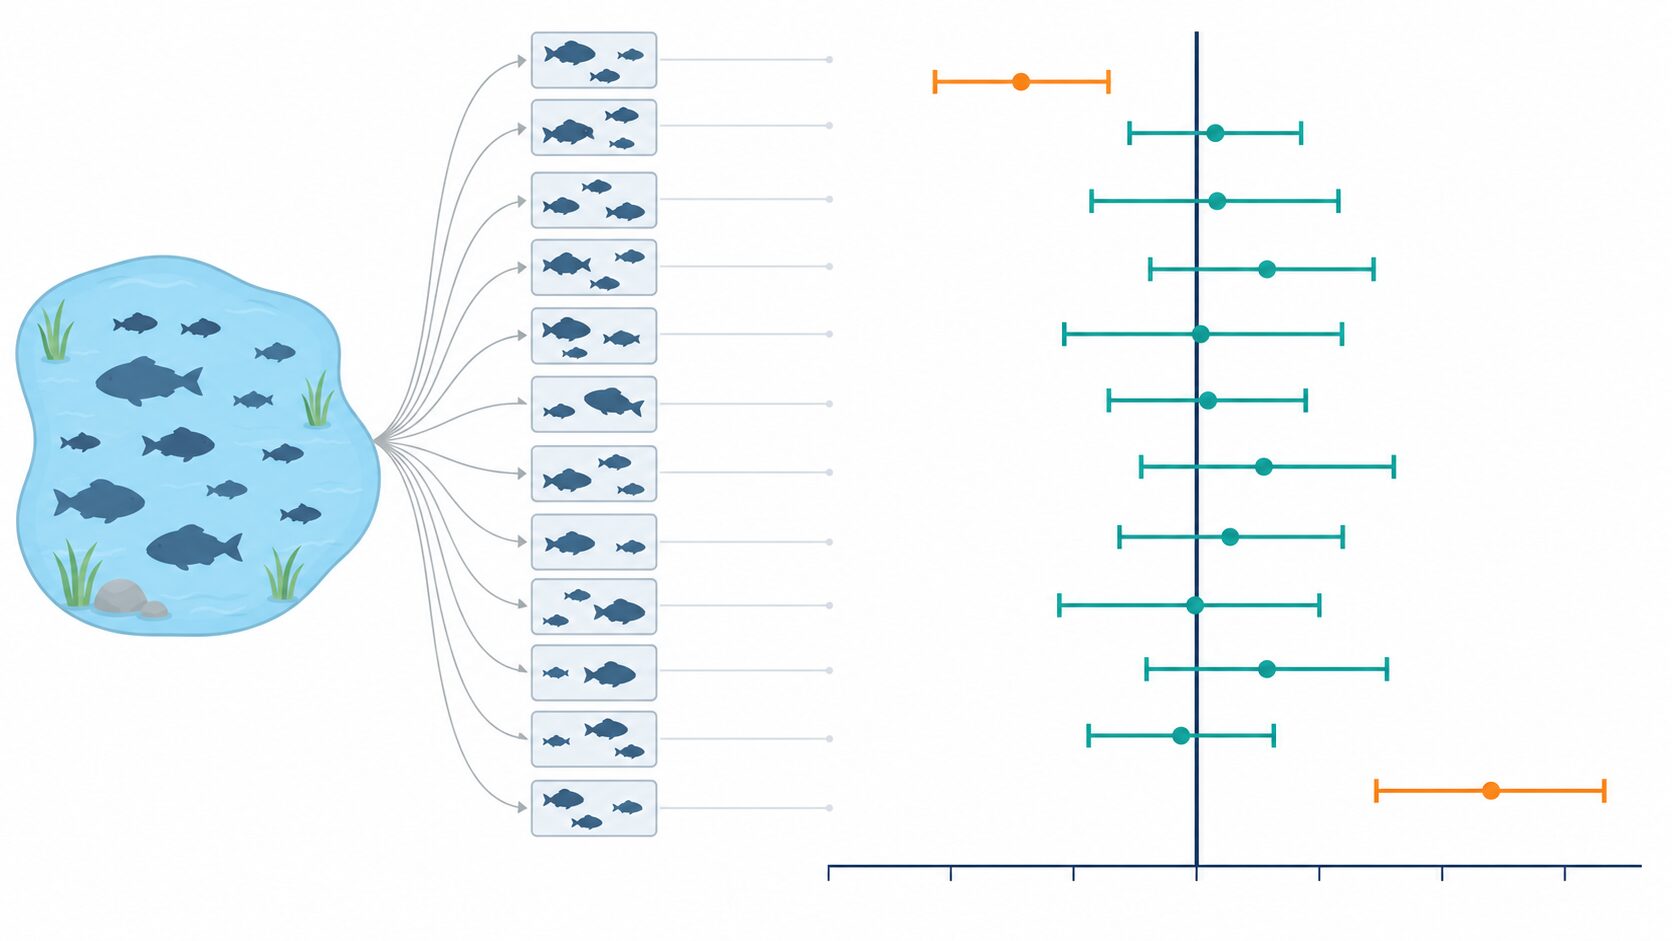
したがって、通常の頻度論の信頼区間を「今回得られた15〜18cmの区間に、母平均が95%の確率で入る」とは解釈しません。また、「池の魚の95%が15〜18cmの体長である」という意味でもありません。ここで推定しているのは、個々の魚の体長ではなく池全体の平均体長です。
信頼区間の幅を左右する主な要素は、次の三つです。
- 標本サイズ:抽出方法などの条件が同じなら、標本を増やすほど標準誤差が小さくなり、区間は狭くなります。
- データのばらつき:標本サイズなどが同じなら、個々の値の散らばりが大きいほど、区間は広くなります。
- 信頼水準:同じデータと計算方法なら、95%から99%へ信頼水準を上げると、区間は広くなります。
高い信頼水準にするほど、真値を含む割合を高めるために広い範囲が必要になります。区間が広すぎる場合は、判断に必要な精度が得られているかを検討します。結果は「推定値16.5cm、95%信頼区間15〜18cm」のように併記すると、見積もりの中心と不確実性を一緒に読めます。
検定:帰無仮説と有意水準
検定は、母集団について立てた仮説と、得られたデータの整合性を調べる方法です。基本となるのは、「仮説が正しく、計算に使うモデルも適切だとしたら、この結果はどのくらい起こりにくいか」という問いです。検定の判断には不確実性が残るため、仮説の正しさを直接証明する手続きとは区別して理解します。
説明用の例として、対象地域・年齢範囲・調査時期を定めた成人男性の平均身長を考えます。比較の基準を仮に170cmとすると、「母平均は170cmである」が帰無仮説、「母平均は170cmではない」が対立仮説になります。170cmは考え方を示すための数値で、実際の平均身長について述べているわけではありません。
この対立仮説では、170cmより高い場合と低い場合の両方を調べるため、「両側検定」を使います。「170cmより高いか」だけを問う片側検定とは判断の対象が異なるので、データを見てから都合のよい方向へ切り替えず、研究や調査の目的に沿って事前に決めます。
- 仮説と有意水準を決める:帰無仮説・対立仮説を定め、誤って棄却する頻度を制御する基準として、例えば5%の有意水準を設定します。
- データと前提を確認する:対象に合った標本か、観測が独立か、測定方法は適切か、選んだ検定の分布に関する条件を満たすかを確認します。
- 検定統計量を計算する:平均を比較する検定なら、標本平均と仮説上の平均との差を、標準誤差に照らして評価します。母標準偏差が未知で前提が合う場合には、1標本t検定が候補になります。
- p値を求める:帰無仮説と統計モデルの下で、観測された結果と同程度か、それ以上に極端な結果が出る確率を計算します。
- 有意水準と比較して判断する:p値が事前に決めた有意水準以下なら帰無仮説を棄却し、それを上回る場合は棄却できないと判断します。
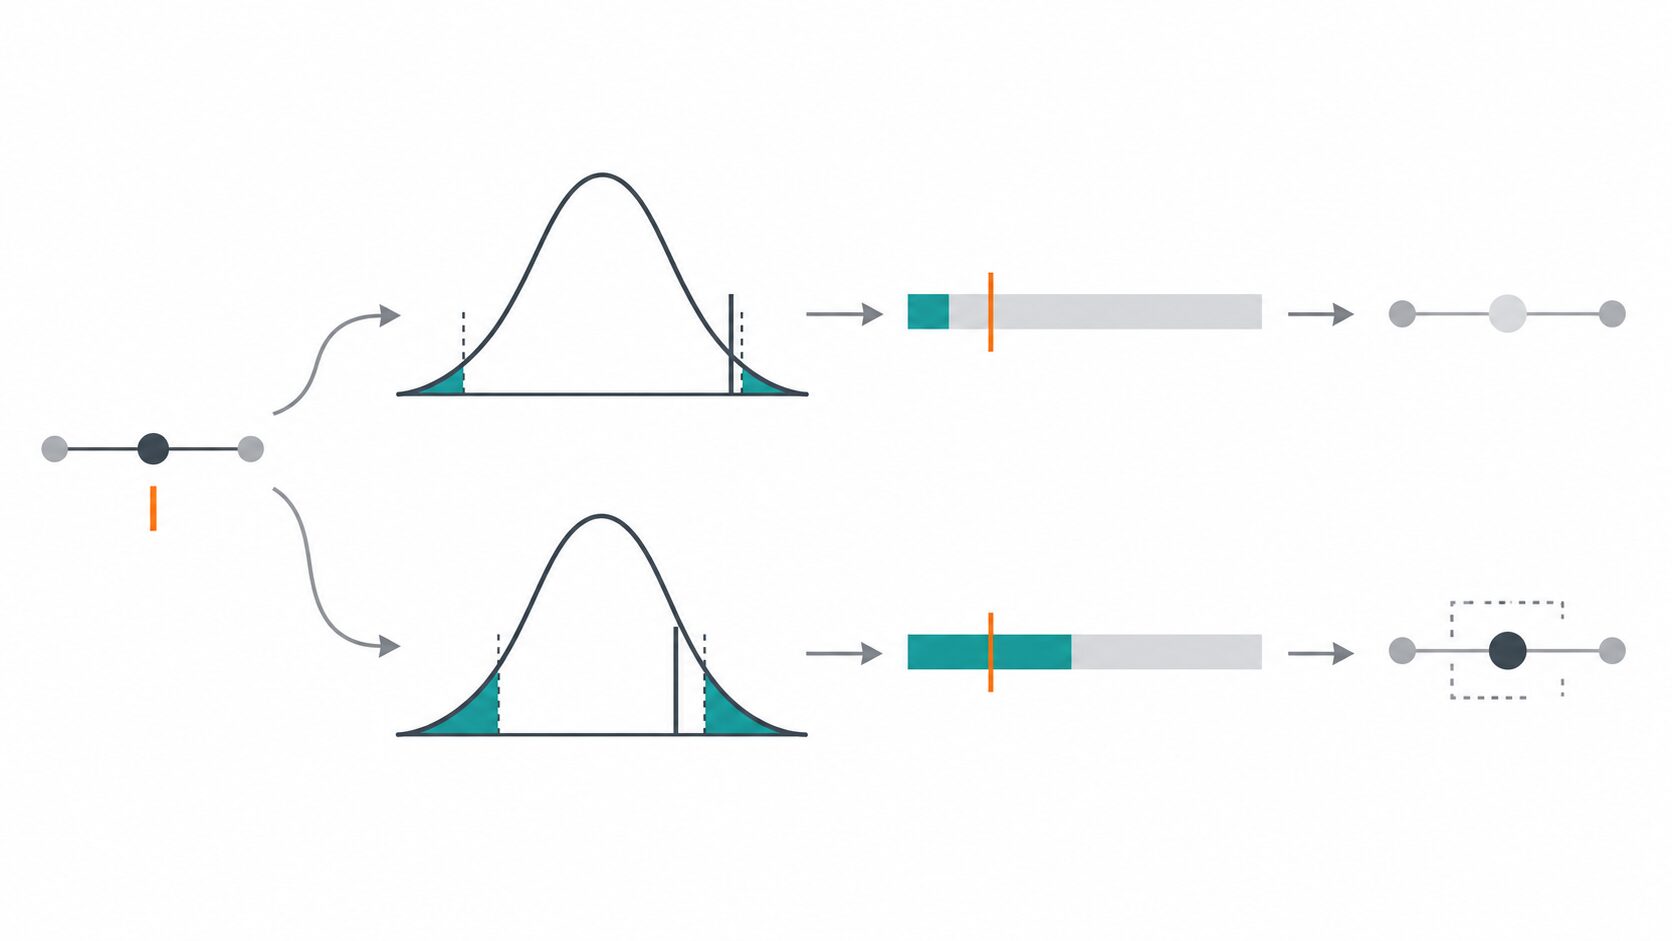
両側検定でいう「極端な結果」には、基準値から大きい方向にも小さい方向にも離れた結果が含まれます。重要なのは、p値は「帰無仮説が正しい確率」ではないことです。帰無仮説などを仮定したうえでの、データの起こりにくさを表しています。
有意水準5%は、帰無仮説が実際には正しい場合に、それを誤って棄却する割合を、前提の下で5%以下に抑えるための基準です。この誤りを「第1種の過誤」と呼びます。今回の結論が誤りである確率を5%と計算した、という意味ではありません。
例えば、事前に有意水準を5%と決め、仮にp値が0.03だったとします。0.03は0.05より小さいため、帰無仮説を棄却し、母平均が170cmと異なることを示す統計的な証拠が得られたと判断します。ただし、対立仮説が確実に正しいことまで証明したわけではありません。
反対に、帰無仮説を棄却できなくても、「差がない」と証明したことにはなりません。標本が少なかったり、データのばらつきが大きかったりすると、実際に差があっても見逃すことがあります。この見逃しが「第2種の過誤」です。存在する差を検出する確率を「検出力」といい、差の大きさ・標本サイズ・ばらつき・有意水準に左右されます。調査前に、どの程度の差を捉えたいのかを決めておくことが役立ちます。
検定は推定と合わせて読むと、判断の意味が明確になります。同じ前提と対応する計算方法による平均の両側5%検定と95%信頼区間では、仮説の値が区間の外にあることが棄却に対応します。信頼区間も確認すれば、差が検出されたかに加えて、どの程度の差がデータと整合するかを検討できます。
推測統計学の活用例
推測統計学は、全員・全製品を調べるのが難しいときや、観測された違いを偶然のばらつきと照らし合わせたいときに使われます。どの分野でも、知りたい対象、実際に調べた標本、推定・検定する内容を対応させることが出発点です。
| 分野 | 知りたいこと | 調べる標本 | 推定・検定の使い方 |
|---|---|---|---|
| 世論調査 | 対象となる有権者や住民の支持・賛否の割合 | 定めた方法で選び、回答を得た人々 | 支持率や賛成率を推定し、標本抽出による不確実性を評価する |
| テレビ視聴率調査 | 対象地域・時間帯の視聴状況 | 調査対象として選ばれた世帯や個人 | 母集団の構成を考慮して視聴の割合を推定する |
| 選挙の出口調査 | 投票した人の投票先の割合 | 選ばれた投票所などで回答した投票者 | 投票先の割合を推定し、選挙情勢を判断する材料にする |
| 市場調査・売れ行き予測 | 顧客の購入意向や条件ごとの需要 | 対象顧客の一部や、試験販売で得たデータ | 購入意向の割合や施策間の差を推定し、前提を置いて販売見込みを考える |
| 経済分析 | 対象企業・世帯の経済活動や指標間の関係 | 調査した企業・世帯や、一定期間の観測データ | 平均・割合・変数間の関係を推定し、仮説を検定する |
| 臨床試験 | 治療群と対照群の結果にどの程度の差があるか | 参加条件を満たし、試験に参加した患者 | 無作為割付による群間差を推定し、信頼区間や検定で評価する |
| 製造業の品質管理 | 不良品率、工程の変化、製品の耐久性や寿命 | 対象ロットや工程から抜き取った製品 | 不良品率や寿命を推定し、工程の異常や基準からの変化を調べる |
世論調査・視聴率調査・出口調査では、調査がカバーする集団を確認します。例えば、一部の投票所での出口調査から投票全体を推測するには、投票所の選び方や回答しない人の傾向、調査対象に含まれない投票方法の扱いなどが関わります。標本から出した割合を、そのまま無条件にすべての人へ広げることはできません。
市場調査や経済分析では、対象集団への推測に加えて、将来に同じ関係が続くかが問題になります。購入意向があることと実際に購入することは一致するとは限りません。また、過去の販売データから売れ行きを予測する場合は、価格・季節・顧客構成などが変わる可能性を考慮します。時系列データでは、近い時点の値どうしが関連することもあり、独立な観測を前提にする計算をそのまま使えない場合があります。
臨床試験では、参加者を治療群と、標準治療や偽薬などを用いる対照群へ無作為に割り付ける設計が用いられます。割付によって群の背景の偏りを抑えながら、あらかじめ決めた評価項目の群間差を推定・検定します。平均値を比べる場合と、ある結果が起きた割合を比べる場合では、適した分析方法が異なります。試験の参加条件に含まれない患者にも同じ結論が当てはまるかは、別途検討が必要です。
製造業では、抜取検査で不良品率を推定するほか、工程データの変化から異常の兆候を捉えます。製品を壊す耐久試験では、すべての製品を調べてから出荷することができないため、標本を使う意味が特に大きくなります。寿命を評価する際には、試験終了時にまだ壊れていない製品の情報も適切に扱うなど、調べたい性質に合う手法を選びます。
結果を読み違えないための注意点
統計的に有意な差があることと、実務上重要な差があることは別です。標本サイズが大きいと、ごく小さな差でも検出されることがあります。p値だけで判断せず、平均との差や割合の差など、効果の大きさと信頼区間を確認します。その差が費用・時間・品質などの判断を変えるほどの大きさかは、目的に照らして考える必要があります。
逆に、有意差が得られなかった場合でも、信頼区間が広ければ、実用上重要な差が残っている可能性があります。「差が検出されなかった」と「重要な差がないと十分な精度で判断できた」を区別するためにも、区間の幅が役立ちます。分析する項目を大量に増やし、有意になった結果だけを取り上げると、偶然の差を強調しやすくなるため、何を事前に調べると決めていたかも確認します。
また、データで見つかった関連から、すぐに因果関係を結論づけることはできません。例えば、ある学習サービスの利用者の成績が高くても、もともとの学習意欲や学習時間の違いが関わっている可能性があります。観察された関連について検定で有意差が得られても、ほかの要因による説明が自動的になくなるわけではありません。
この点で混同しやすいのが、「無作為抽出」と「無作為割付」です。どちらも無作為化を使いますが、目的とする推測が異なります。
| 方法 | 何を決めるか | 主に支えること | 残る確認事項 |
|---|---|---|---|
| 無作為抽出 | 母集団の中から誰を調べるか | 標本の結果を母集団へ一般化すること | 抽出対象の抜け、無回答、測定方法などによる偏り |
| 無作為割付 | 参加者をどの処置・比較群に分けるか | 群間比較における因果関係の推論 | 試験中の脱落や処置の実施状況、参加者以外へ結果を広げられるか |
無作為に群へ分けた試験でも、参加者が母集団から無作為に選ばれているとは限りません。したがって、試験内での群間差を評価することと、その差を別の年齢層や地域の人にまで当てはめることは、それぞれ検討します。
調査結果や分析レポートを読むときは、次の順番で確認すると、結論が成り立つ範囲を捉えやすくなります。
- 対象集団を確認する:誰・何についての結果か、地域・年齢・期間などの範囲が明示されているかを読みます。
- 収集方法を確認する:標本サイズだけでなく、選び方、調査範囲、無回答や欠測、測定方法を確認します。
- 手法の前提を確認する:観測の独立性、必要な分布の条件、群分けや重み付けなどが分析に合っているかを見ます。
- 不確実性と差の大きさを確認する:推定値・信頼区間・p値を組み合わせ、どの程度まで言える結果なのかを判断します。
通常の信頼区間が狭くても、調査対象から特定の人々が抜けている影響や、測定方法による偏りまで含めて評価できているとは限りません。また、調査対象外の地域や将来の時期へ結論を広げるには、対象の違いや条件の変化を確かめます。
推測統計学を学ぶ際は、「どの母集団について知りたいのか」「どのように標本を得たのか」「値を推定するのか、仮説を検定するのか」を一つの例で追ってみてください。標本の選び方、推定値、結果の不確実性を結び付けて考えることが、一部のデータから全体を慎重に読み取るための基本になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月5日 | 標本の選び方と標準誤差を補い、信頼区間・検定の解釈を修正 |