
世界モデルとは?行動の先を予測するAIと動画生成・シミュレーションの違い

AIの初心者
世界モデルとは、AIが現実そっくりの動画を作る技術ですか?

AI専門家
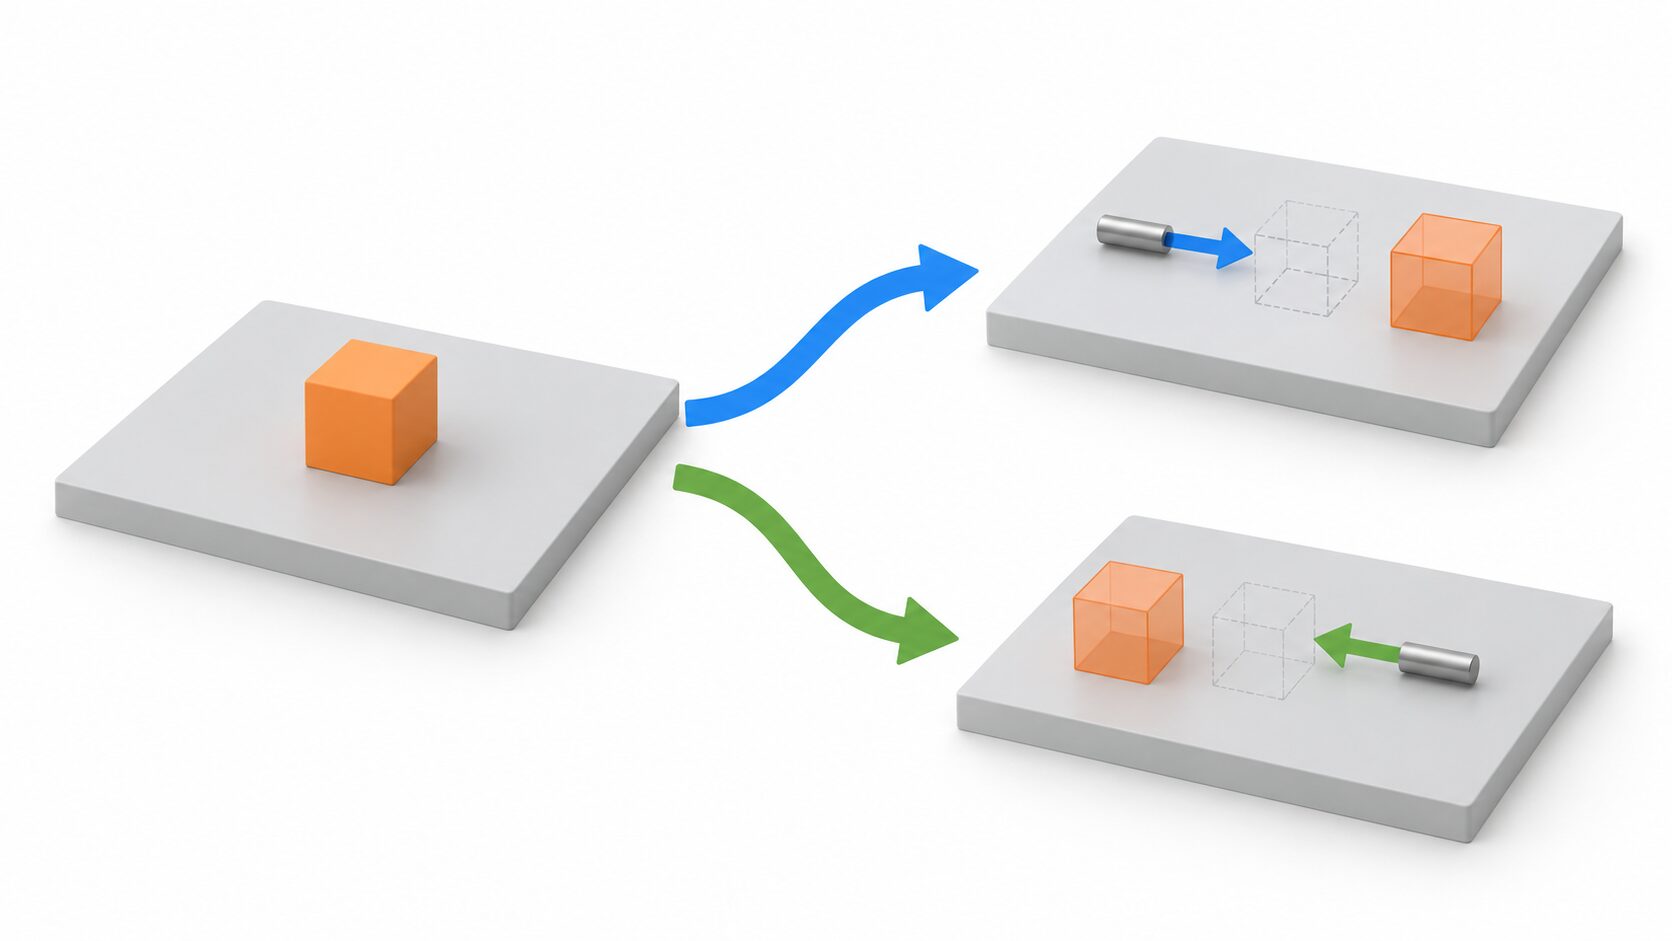
映像を作るものもありますが、中心にあるのは環境の変化を予測する役割です。行動も扱うモデルなら、「積み木を右へ押したらどう動くか」を予測できます。
AIの初心者
先に結果を予測できれば、ロボットが動き方を選ぶ助けになりそうですね。
AI専門家
その通りです。ただし、予測する仕組みと行動を選ぶ仕組みは分けて考えます。自然に見える予測でも、現実と同じ結果になるとは限りません。
世界モデルとは。
世界モデルとは、環境の状態や変化を内部に表現し、その先を予測するためのモデルです。この記事では、データから環境の変化を学ぶ方式を中心に説明します。行動を入力として扱う場合は、現在の状況と操作をもとに、その後に何が起こるかを予測し、計画や学習に利用できます。
たとえば、同じ積み木でも右へ押す場合と左へ押す場合では、移動先が変わります。この「行動によって分かれる未来」を考えると、動画生成やシミュレーションとの関係も整理しやすくなります。
世界モデルは環境の何を予測するのか
世界モデルが扱う「世界」は、必ずしも地球全体や現実のすべてを意味しません。ゲームなら画面内の状況、ロボットなら机の上と周囲の物体など、取り組む課題に関係する環境が対象です。その環境を内部で表し、時間が進むとどう変わるかを予測します。
積み木を動かす課題なら、現在の位置、向き、動いているかどうかといった情報が候補になります。押す方向や強さも扱うモデルであれば、それらを変えたときの次の位置を予測できます。「積み木がある」と認識するだけでなく、「このように押せば、こちらへ移る」と変化を捉える点が特徴です。
ただし、世界モデルという言葉だけで、必ず行動入力を備えているとは限りません。観測の続きや環境の時間変化を予測するものも含めて使われます。行動を選ぶために利用したい場合は、単に未来を予測するだけでなく、異なる操作に対する結果を比べられるかが大切です。
また、環境の情報をすべて保持する必要もありません。積み木を目標位置へ運ぶだけなら、木目の細部よりも位置や接触の状態が役立ちます。一方、色ごとに仕分ける課題では色も必要です。何を残し、何を省くかは目的によって変わり、見た目を簡略化した内部表現でも、行動の判断には役立つことがあります。
広い意味では、「物体Aは物体Bの上にある」といった記号やルールで環境を表す考え方も、世界モデルの話題に含まれます。本記事の中心は、観測や経験のデータから変化の規則を学ぶ方式です。この範囲を押さえると、環境についての知識一般と、機械学習による予測モデルを混同せずに読めます。
観測・行動・次の状態をつなぐ仕組み
典型的な流れは、観測から内部状態を作り、行動と組み合わせて次の状態を予測するというものです。ここでの「状態」は、先を考えるために必要な状況の表現を指します。実際の構成は方式によって異なりますが、次の三つに分けると理解しやすくなります。
- カメラ画像やセンサー値、これまでの観測履歴を受け取り、今の状況を内部で表す。
- その内部状態と「右へ押す」などの行動を使い、次にどのような状態へ移るかを予測する。
- 必要に応じて、予測した状態を画像に戻したり、目標への近さや得点に相当する報酬を予測したりする。
観測と状態は同じではありません。静止画が一枚あるだけでは、積み木が止まっているのか、右へ滑っている途中なのか判断できない場合があります。そこで、直前の画像や過去の動作も手掛かりにします。内部状態は、直接見える情報と履歴から推定した情報をまとめたものになり得ます。
その表現も、画像そのものとは限りません。画像の特徴を数値のまとまりへ圧縮した「潜在表現」を使う方式があります。これは、人が名前を付けた位置や速度だけを保存するとは限らず、予測に役立つ特徴を学習して表したものです。後の判断に使えれば、途中で毎回きれいな画像を描き直す必要はありません。

学習では、たとえば「押す前の観測、押した方向、押した後の観測」という組を使い、予測した変化と実際の変化が近づくようにモデルを調整します。学習後は、予測した状態をもとにさらに次を予測し、何手か先まで仮想的に進められます。結果が一つに決まらない状況では、複数の起こり得る結果や、その確率を扱う設計もあります。
ここで、世界モデルと「方策」「計画器」を分けることが重要です。方策は状況に応じた行動を出す仕組み、計画器は候補となる行動や手順を比較する仕組みです。世界モデルが「右へ押すと目標へ近づく、左へ押すと離れる」と予測し、その情報を使って計画器が右を選ぶ、という役割分担ができます。予測できることと、目的に合う行動を選べることは別の能力です。
動画生成・ゲームエンジン・sim2realとの違い
これらの用語は、同じものを別の名前で呼んでいるわけではありません。一方で、互いに重なる部分もあります。整理するには、何を目的とし、変化をどう作り、行動とどう関わるかを比べると分かりやすくなります。
| 概念 | 主な目的 | 変化の作り方 | 行動入力と世界モデルとの関係 |
|---|---|---|---|
| 学習型の世界モデル | 環境の変化を予測し、計画や学習などに使う | データから学んだ規則で次の状態を予測する | 行動を扱う方式では操作ごとの結果を予測する。映像の出力は必須ではない |
| 動画生成 | 指示や条件に合う映像を作る | 学習したモデルで時間に沿った映像を生成する | 操作に応答する方式もあり、世界モデルと重なる場合がある |
| ゲームエンジン | ゲーム内の環境や動作を実行する | 設計されたルールや物理計算などで状態を更新する | 入力に応じて環境を変える。学習型のモデルと組み合わせることもできる |
| sim2real | 仮想環境で得た学習結果を現実に移す | 環境を作る方式ではなく、学習結果の転移を扱う | 仮想環境として世界モデルを使う場合があるが、予測モデルそのものではない |
通常の動画生成では、「積み木が机を滑る映像を作る」という指示に応じた出力が目的になります。これに対して行動を扱う世界モデルでは、「今ここで左へ押したら、次はどうなるか」という条件付きの変化が重要です。途中の操作を変えたとき、その後の展開も適切に変わる必要があります。ただし、操作入力に対応する動画モデルもあるため、映像を出すかどうかだけで分類はできません。
ゲームエンジンとの違いは、環境を動かす規則の得方にあります。物理計算なら、物体の質量や摩擦などの設定と計算規則をもとに動きを求めます。学習型の世界モデルは、経験データから得た変化の規則で予測することが中心です。ゲームエンジンにも学習済みの機能を組み込めるため、この対比はシステム全体を二つに分断するものではありません。
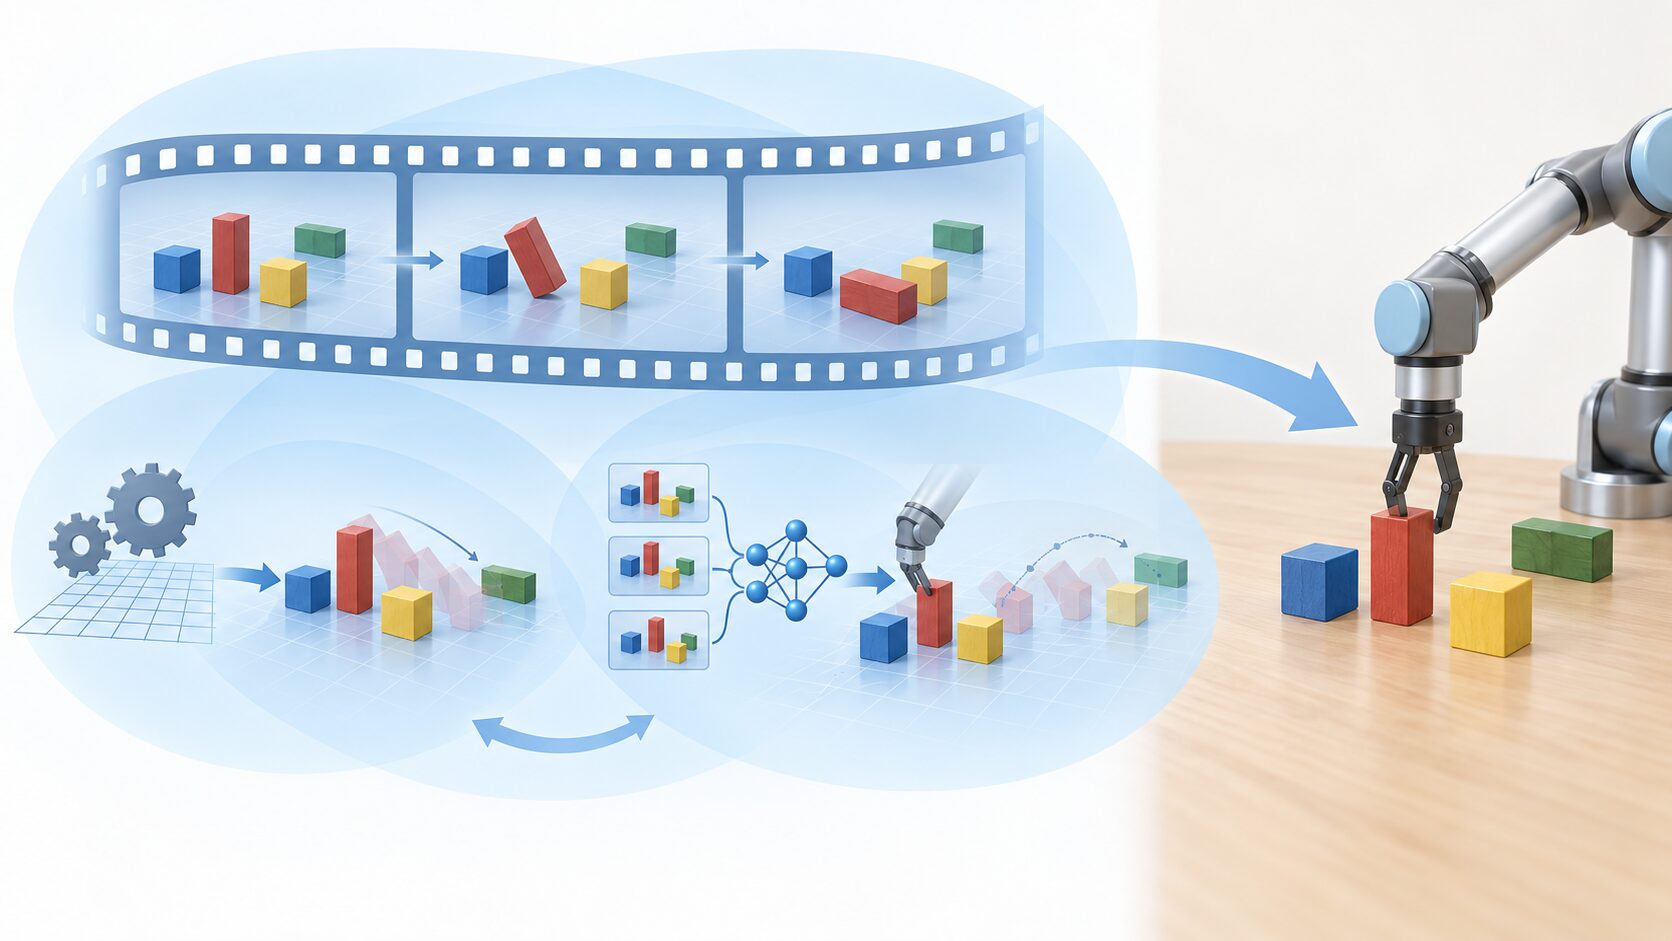
「シミュレーション」は、ある条件で何が起きるかを模擬する、より広い言葉です。設計した計算規則で行う場合も、学習した世界モデルで行う場合もあります。その仮想環境で練習したロボットを実機で動かす段階が、sim2realにつながります。世界モデルは予測の仕組み、シミュレーションは模擬する行為や環境、sim2realは現実への転移というように、役割の違いで捉えましょう。
従来研究とGenieに見る世界モデルの具体例
代表的な研究例の一つが、2018年に発表された論文「World Models」です。観測を圧縮する部分、時間的な変化を予測する部分、行動を出す制御器を組み合わせ、学習した環境の表現を制御に使う考え方を示しました。2018年を、この概念そのものが初めて生まれた年と捉える必要はありません。
この研究を読む際の要点は、環境の見た目を細部まで再現することよりも、圧縮した観測や変化の予測が行動に役立つという関係です。ゲーム画面から必要な特徴を取り出し、時間の流れを内部で表し、それを手掛かりに操作を決めます。人が見られる動画の品質だけを評価しても、こうしたモデルの役割は十分には分かりません。
一方、Google DeepMindのGenie 3は、操作入力に応じて環境の映像を生成する例です。あらかじめ決まった映像を再生する場合と異なり、利用者が進む方向などを変えると、それに応じた場面が生成されます。積み木の例に置き換えるなら、「押す映像を見る」段階から、「操作に応じた続きを得る」段階へ進むイメージです。
また、Genie 3というモデルと、Project Genieという体験用サービスは区別して捉えます。モデルは環境の変化を生成する技術の側であり、サービスはそれを利用者が操作できる形で提供する側です。「世界モデル」はこれらだけを指す固有の名称でも、2026年に初めて現れた技術でもありません。
従来研究と対話型の環境生成では、重視する表現や見せ方が異なります。両者をつなぐのは、環境の変化を内部で扱い、その先を予測・生成するという発想です。ただし、操作に反応して映像が続くことだけで、ロボットの制御や物理現象の予測にも十分な精度があると判断することはできません。
エージェント学習やロボットにどう役立つか
世界モデルを使う利点は、実際に行動する前に候補を試せることです。環境を観測して行動するAIをエージェントと呼びます。エージェントがモデル内で仮想的に試行できれば、実環境での操作に時間や費用がかかる場合に、試行回数を減らせる可能性があります。
積み木を目標の印まで動かすロボットを考えましょう。まずカメラで積み木と目標の位置を観測します。次に、弱く右へ押す、強く右へ押す、押す向きを少し変える、といった候補について結果を予測します。その中から目標へ近づくと見込まれる行動を選び、実際に動かします。
実行後には、もう一度カメラで位置を確かめます。予測より手前で止まっていたら、その新しい観測から次の操作を考えます。観測、仮想試行、行動選択、実行、再観測を繰り返すことで、予測と現実のずれを、その後の判断に反映できます。最初に予測した長い手順を最後までそのまま実行する必要はありません。
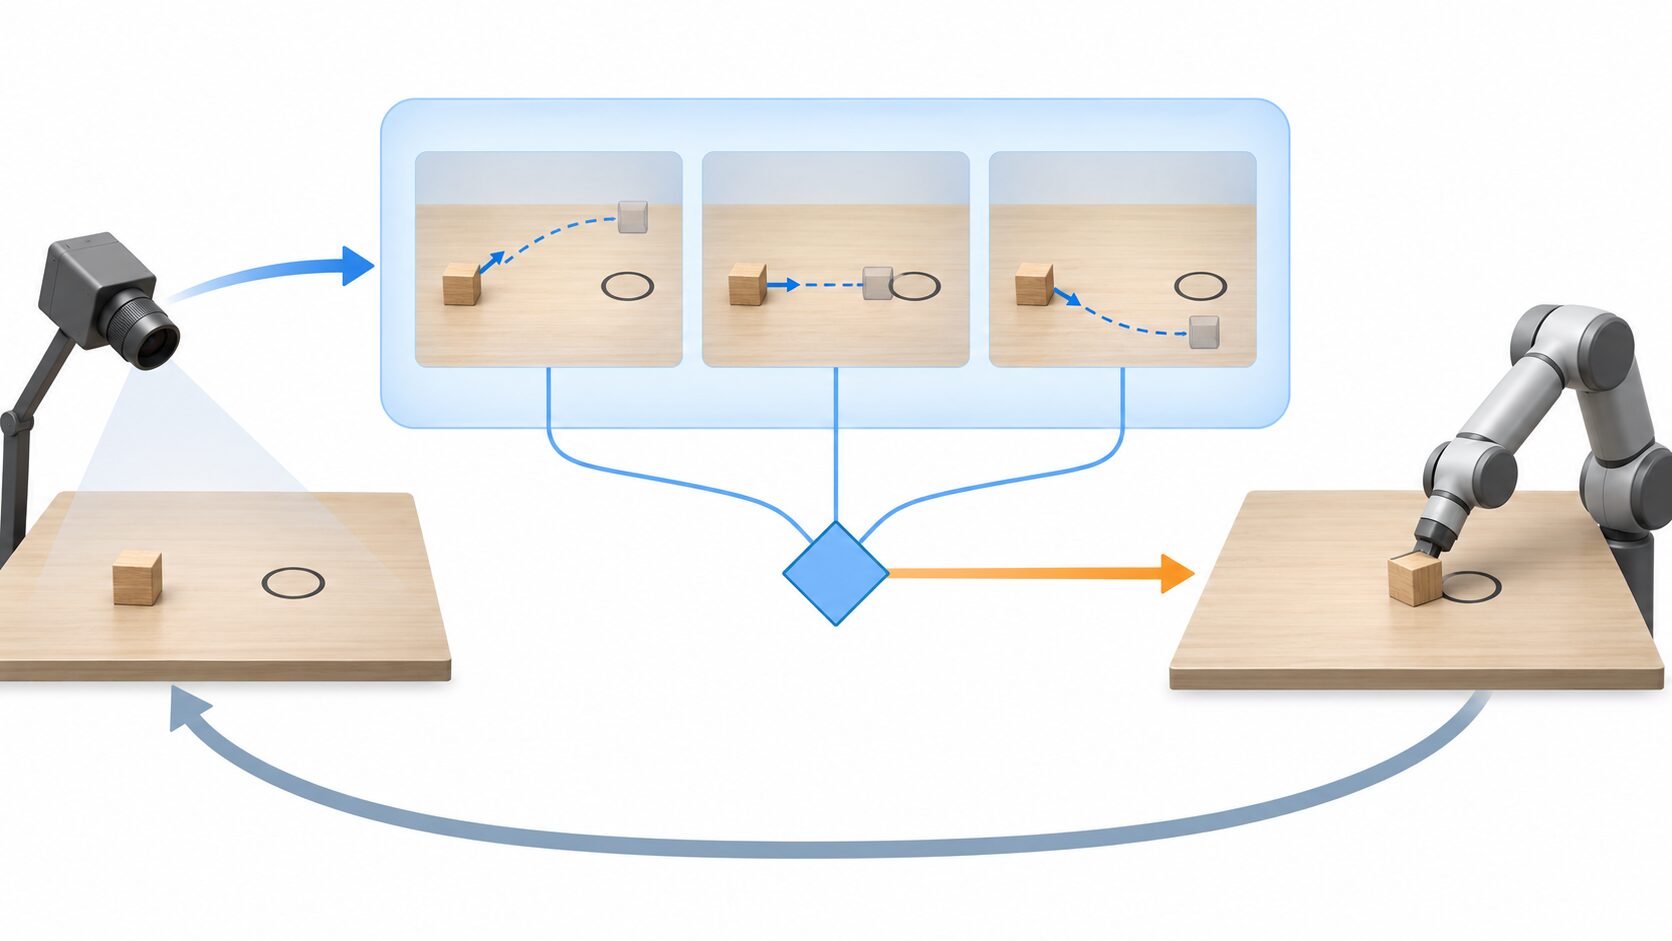
利用方法には、行動を決めるたびに先を予測する計画と、モデル内での経験を使って方策を学ぶ方法があります。後者は、仮想的な試行から「この状況ならこの行動がよい」という対応を身に付ける使い方です。実行時に毎回多数の未来を比較するか、事前に学んだ方策から行動を出すかは、設計によって異なります。
用途としては、ゲーム内エージェントの学習、物体を動かすロボットの操作、自動運転研究での場面検討などが考えられます。ただし、モデル内で高い成績が出ることと、実機で安定して動くことは別に確認する必要があります。研究では限定した課題で有効性を調べられますが、実運用では使用条件に合った精度や失敗時の挙動も問われます。
sim2realとの接続でも、データから学んだ環境だから現実との差が消えるわけではありません。たとえば、学習時と机の材質が変わるだけでも、積み木の滑り方は変わります。仮想環境の経験を現実へ移すには、どの条件の違いが行動の結果に影響するかを確かめることが必要です。
見た目の自然さと物理的な正確さは別
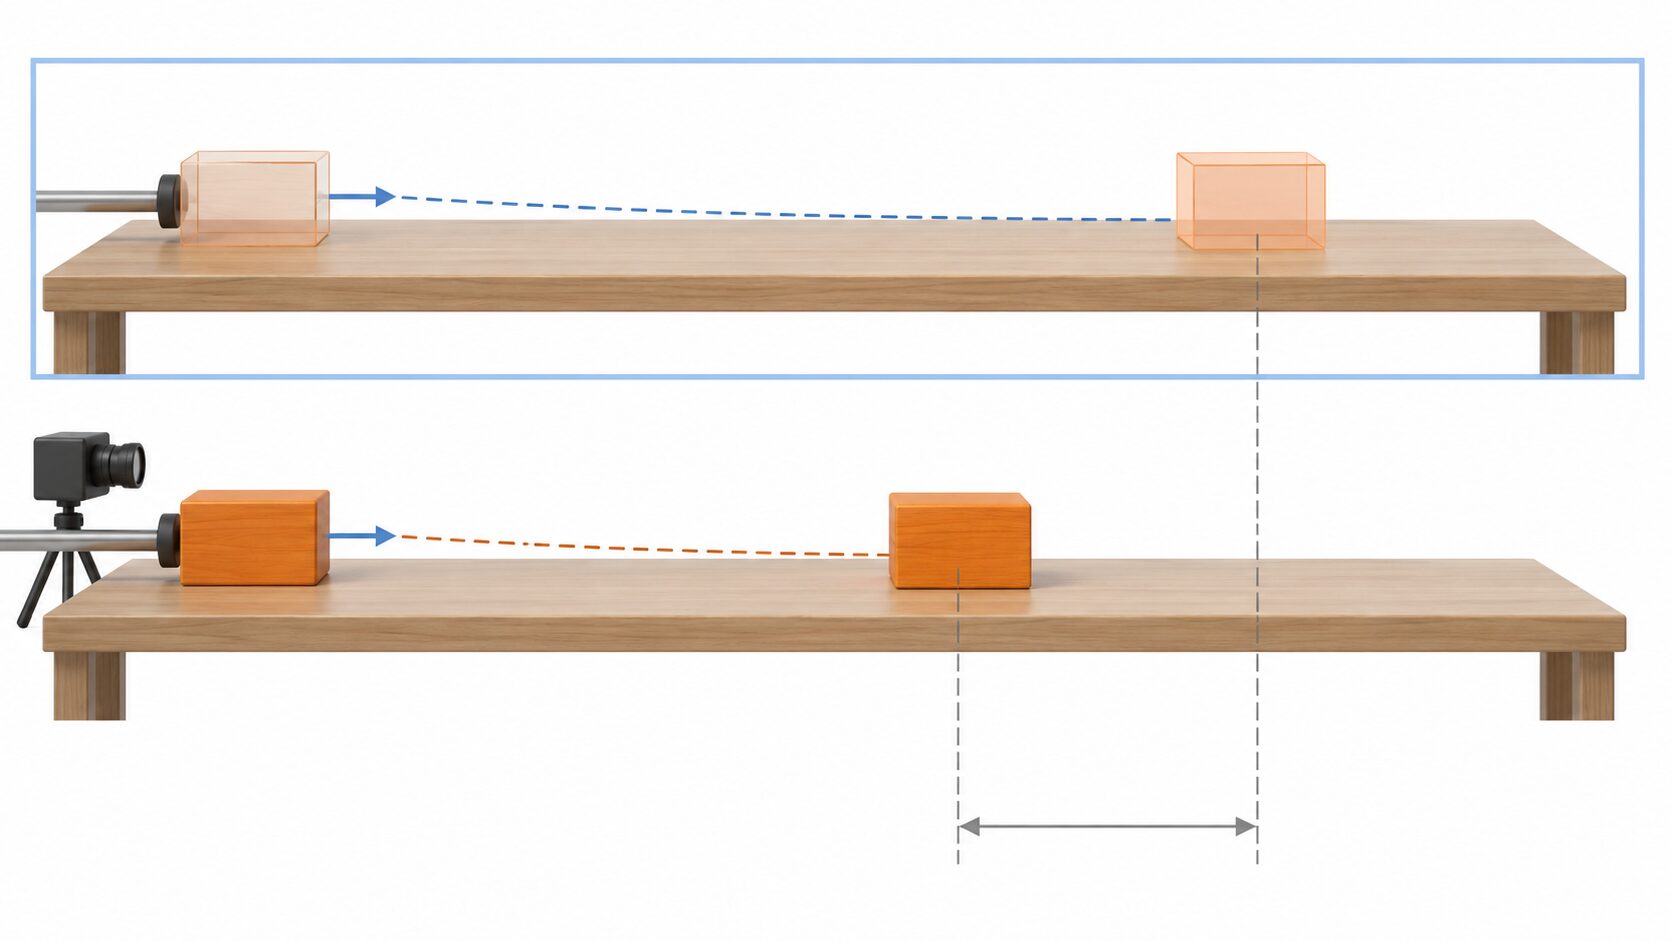
世界モデルを評価するときは、滑らかで自然な映像だけを根拠にしないことが大切です。積み木が押されて滑り、静かに止まる映像はもっともらしく見えます。しかし、実際には摩擦の影響でもっと手前に止まるなら、位置を合わせるロボットにとっては不正確な予測です。
衝突した物体がどう動くか、隠れた物体が同じ場所に存在し続けるか、同じ操作に一貫した応答があるかも確認点になります。短い場面では目立たないずれでも、予測を繰り返すと積み重なります。少し間違った位置から次の動きを予測すると、その先の接触相手や移動経路まで変わり、長い予測ほど結果が大きく外れることがあります。
不確かさには、経験不足と観測の限界も関わります。学習していない材質や形の物体には、過去に得た規則がうまく当てはまらない場合があります。また、外見が同じ積み木でも重さが違えば、動き方が変わり得ます。画像から分からない情報を、モデルが常に正しく補えるわけではありません。
さらに、モデル内で方策を学ぶと、予測の誤りを利用するような行動が選ばれる場合があります。たとえば、モデルが特定の押し方で積み木を不自然に遠くへ動かしてしまうと、エージェントはその操作を有利だと学ぶかもしれません。モデル内の得点だけを上げても、現実の課題が解けるとは限らない理由です。
評価では、見栄えに加えて、行動を変えたときに結果が適切に変わるか、時間をまたいで物体や状況が一貫しているか、位置などの予測が実測に合うかを確認します。そして、最終的な目的をどの程度達成できたかも見ます。積み木の操作なら、映像の自然さだけでなく、停止位置の誤差や、目標範囲へ運べた割合が役立つ指標です。
利用を判断する際は、何を予測し、どの行動を扱い、どの条件で検証されたかを確かめましょう。操作できる仮想環境を楽しむ用途と、現実の機械を動かす用途では、必要な正確さが異なります。世界モデルの価値は、どれほど現実らしく見えるかだけでなく、目的に必要な変化をどれほど頼れる形で予測できるかにあります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月7日 | 初回公開 |