
分散説明率とは?計算方法・決定係数R²との違いを具体例で解説

AIの初心者
「説明された分散」や「分散説明率」って、何を表す言葉ですか?予測が当たった割合とは違うのでしょうか?

AI専門家
分散説明率は、予測モデルがデータのばらつきをどれくらい捉えたかを見る指標だよ。例えば、気温からアイスクリームの売上を予測するとき、売上の増減をどこまで捉えられたかを確かめるんだ。
AIの初心者
気温だけでは、曜日やお店の場所による売上の違いまでは捉えきれなさそうですね。分散説明率が高ければ、予測は正確だと考えてよいですか?
AI専門家
そこには注意が必要だよ。増減の形が合っていても、毎回同じだけ多く予測するずれは、この指標では見落とすんだ。決定係数や誤差の大きさも一緒に見ながら、計算方法を確認していこう。
分散説明率(Explained variance score)は、実測値の分散に対して、予測後に残る誤差の分散がどれだけ小さいかを表す回帰モデルの評価指標です。一般に1に近いほどデータの変動をよく捉えていますが、負の値になることもあり、1でも予測値が実測値と一致するとは限りません。
この記事では、分散説明率の意味と計算方法を3件のデータで確かめ、決定係数R²との違い、モデル比較での使い方、主成分分析の寄与率との区別まで説明します。「0.8なら正解率80%なのか」「どのくらいの値ならよいのか」という疑問も、指標の仕組みから考えていきましょう。
分散説明率とは?回帰モデルが捉えたばらつきの指標
分散は、データが平均値のまわりにどれくらい広がっているかを表します。毎日のアイスクリームの売上がほぼ同じなら分散は小さく、日によって大きく違うなら分散は大きくなります。
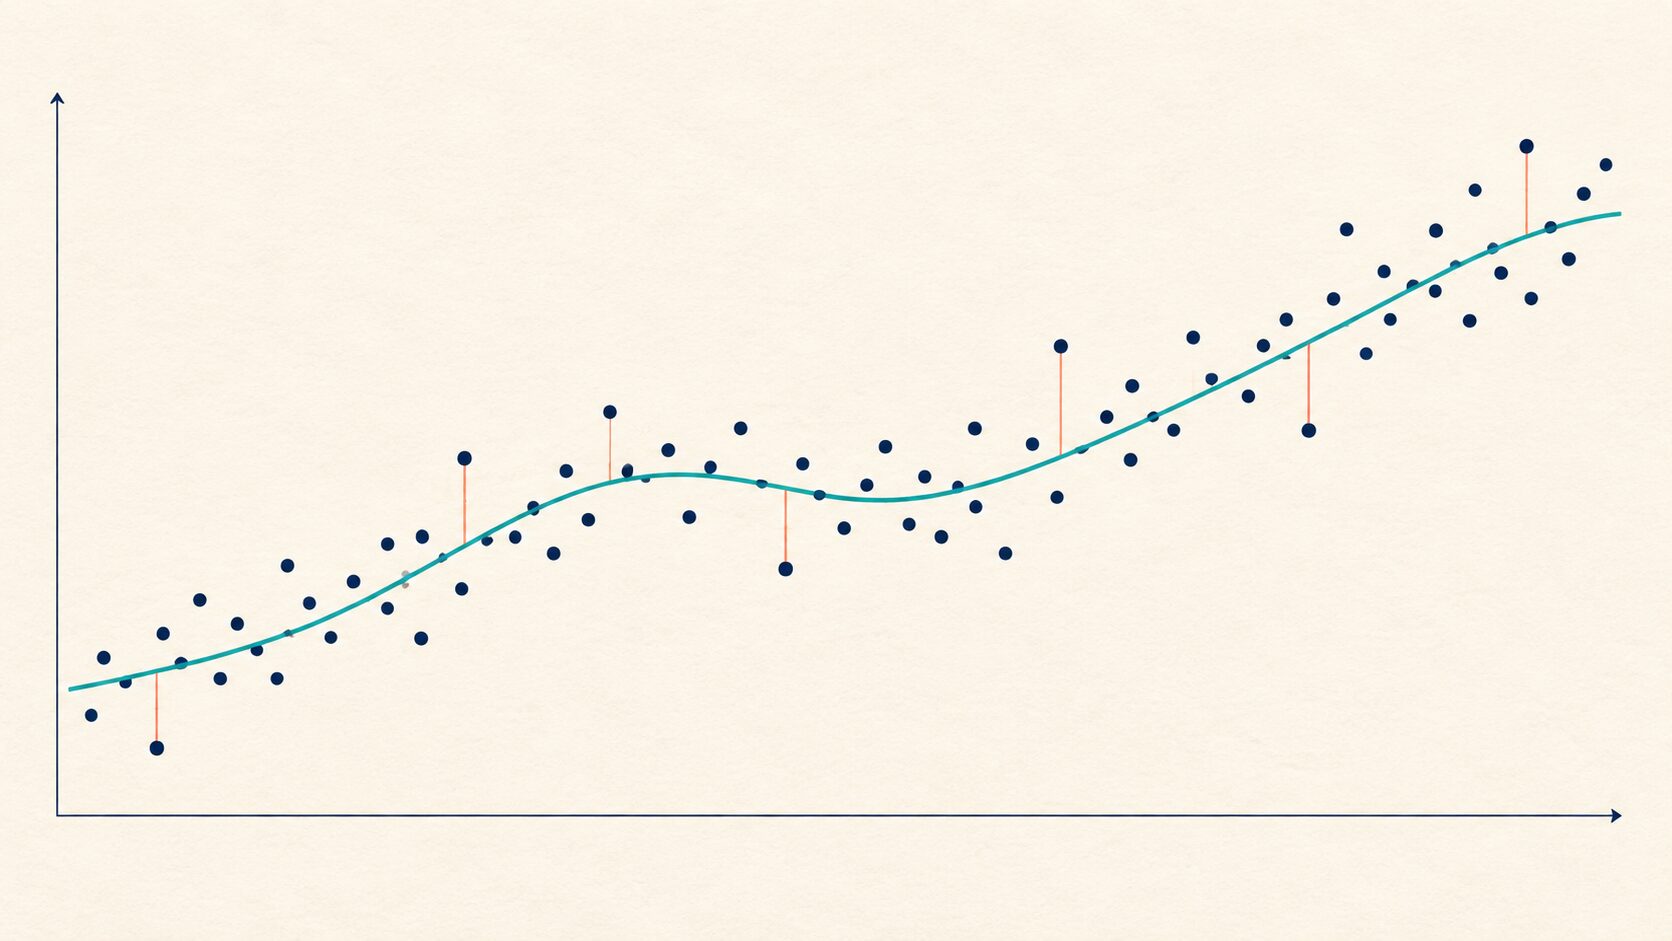
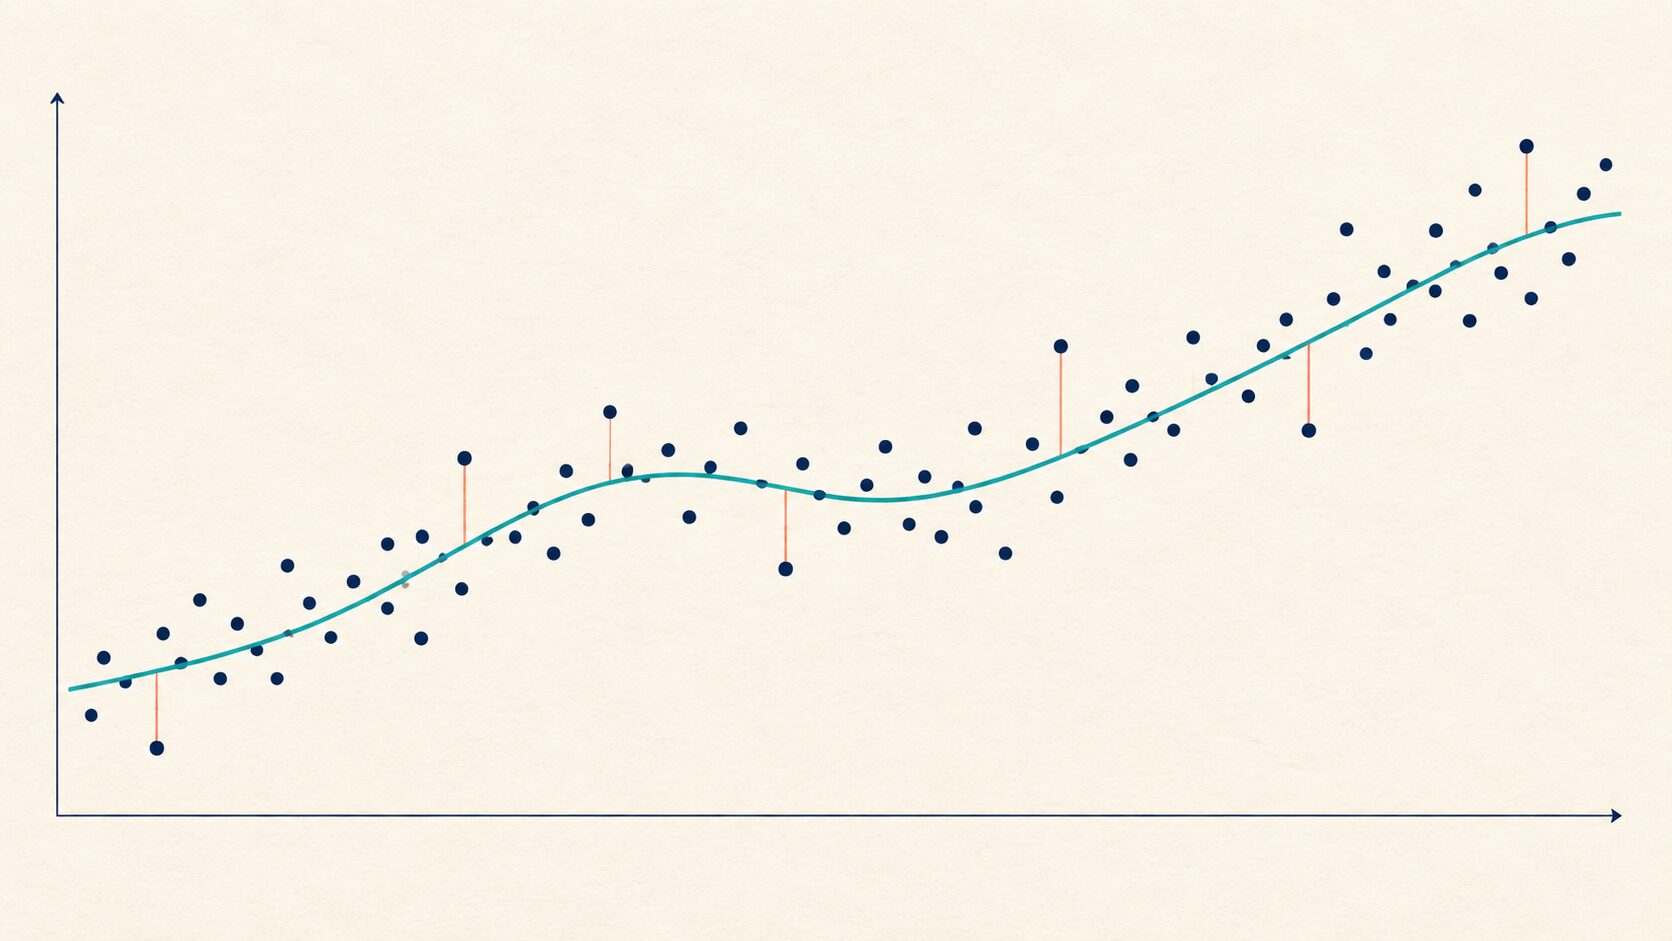
気温から売上を予測するモデルでは、実際の売上と予測した売上に差が生じます。この「実測値から予測値を引いた差」が残差です。分散説明率は、元の売上のばらつきと、この残差のばらつきを比べます。予測によって残差のばらつきが小さくなっていれば、売上の変動をモデルが捉えたと考えられます。
例えば分散説明率が0.8なら、残差の分散は実測値の分散の20%です。「ばらつきの80%を説明した」と表現されることもありますが、80%の予測が的中した、誤差が20%以内に収まった、という意味ではありません。また、残りのばらつきには測定上の雑音だけでなく、モデルに入れていない要因や、モデルが捉えきれない関係も含まれます。
ここでいう「説明」は、予測とデータの対応を評価する言葉です。気温を使ったモデルの分散説明率が高くても、それだけで気温が売上変化の原因だと証明できるわけではありません。回帰モデルとは、こうした売上数量、気温、価格などの数値を予測するモデルを指します。
分散説明率の計算方法を具体例で確認
\(\mathrm{EV}=1-\frac{\operatorname{Var}(y-\hat{y})}{\operatorname{Var}(y)}\)分散説明率を\(\mathrm{EV}\)、実測値を\(y\)、予測値を\(\hat{y}\)と書くと、上の式で計算できます。\(\operatorname{Var}\)は分散を表します。つまり「1から、残差の分散を実測値の分散で割った値を引く」という計算です。
以下では、1つの数値を予測する回帰を対象に、各データを同じ重みで扱います。分散は、平均からの差を二乗して足し、データ数で割る定義に統一します。実測値の分散が0の場合については、次のセクションで説明します。
3日分の売上数量を予測した、次の小さな例を考えましょう。
| 対象 | 実測値(個) | 予測値(個) | 残差(個) |
|---|---|---|---|
| 1日目 | 10 | 12 | −2 |
| 2日目 | 20 | 18 | 2 |
| 3日目 | 30 | 30 | 0 |
- 実測値から予測値を引きます。残差は−2、2、0です。
- 実測値の平均を求めます。10、20、30の平均は20なので、平均からの差は−10、0、10になります。
- その差を二乗して平均します。実測値の分散は、100、0、100の平均で約66.67です。
- 残差についても、残差の平均からの差を二乗して平均します。この例では残差の平均が0なので、残差の分散は4、4、0の平均で約2.67です。
- 丸める前の値を使い、残差の分散を実測値の分散で割って1から引きます。
この結果は、残差の分散が実測値の分散の4%になったことを表します。予測の的中率が96%という意味ではありません。
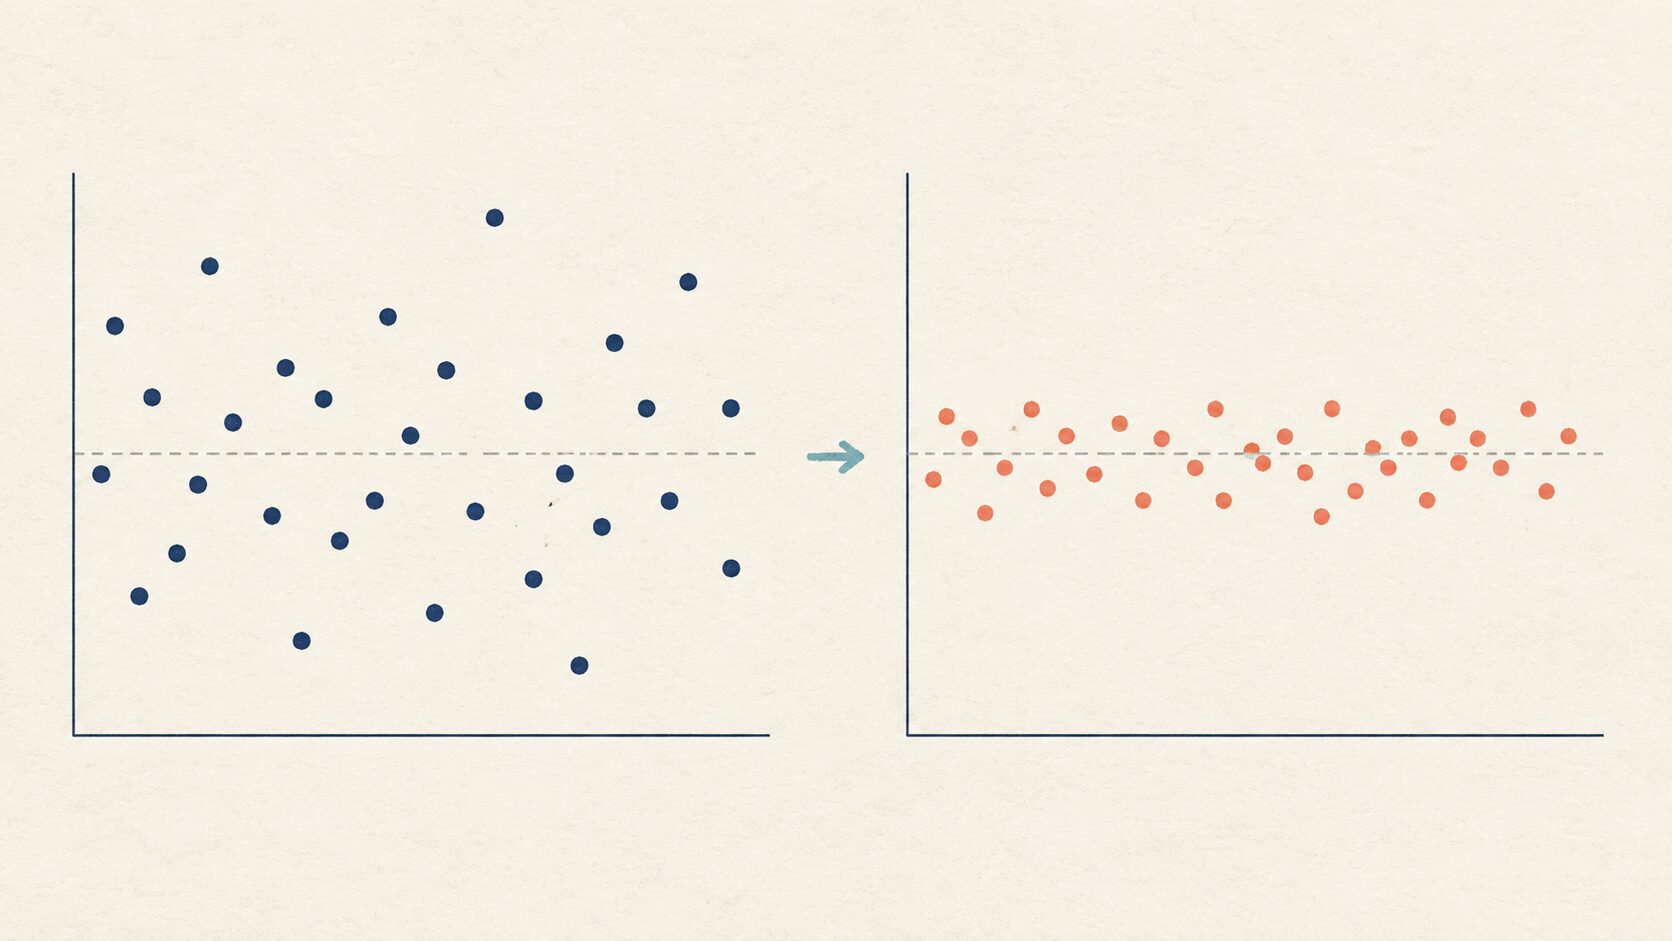
計算で間違えやすいのは、残差の分散を求める手順です。データ数を\(n\)、各残差を\(e_i=y_i-\hat{y}_i\)、残差の平均を\(\bar{e}\)とすると、次の式になります。
\(\operatorname{Var}(e)=\frac{1}{n}\sum_{i=1}^{n}(e_i-\bar{e})^2\)残差の分散は、残差から「残差の平均」を引いてから二乗します。残差そのものを二乗して平均するMSE(平均二乗誤差)とは、一般には異なります。今回の例で両者が一致したのは、残差の平均が0だったためです。この違いが、決定係数との関係を理解する鍵になります。
値の範囲と目安:1・0・負の値をどう読む?
実測値の分散が正である場合、分散説明率の上限は1で、下限はありません。残差の分散が実測値の分散より大きくなると、1から引く比率が1を超えるため、分散説明率は負になります。
| 値 | 残差の分散との関係 | 読み取り方 |
|---|---|---|
| 1 | 残差の分散が0 | 残差がすべて一定。完全一致の場合に加え、全件で同じだけずれる場合も含む |
| 0より大きく1未満 | 残差の分散が実測値の分散より小さい | 予測後に残るばらつきが小さくなっている |
| 0 | 両者の分散が等しい | 残差のばらつきが元のデータと同じ大きさ |
| 負の値 | 残差の分散が実測値の分散より大きい | 変動を捉えるという観点では、一定値を予測する場合より悪い |
例えば、実測値が10、20、30と変化しているのに、予測値が30、20、10と逆向きに動けば、残差は−20、0、20になります。残差の分散は実測値の分散の4倍なので、分散説明率は−3です。負の値は、単に計算を間違えたから生じるものではありません。
また、すべてのデータに同じ一定値を予測するモデルでは、実測値から一定値を引いても分散は変わらないため、分散説明率は0になります。予測する一定値が平均値から大きく離れていても0です。この性質からも、分散説明率だけでは予測の水準が合っているか判断できないことが分かります。
「0.8以上なら合格」といった共通の基準はありません。予測対象、期間、データのばらつき、許容できる誤差によって必要な性能は変わります。特に実測値のばらつきが小さいデータでは、誤差が小さくても分散の比率が大きくなり、スコアが低くなることがあります。
実測値がすべて同じなら分散は0になり、定義式の分母が0になるため通常の有限なスコアを定義できません。評価ツールによってはこの場合に特別な値を返すため、表示された数値だけで性能を判断せず、対象データが一定になっていないかと、使用するツールの処理方法を確認してください。
決定係数R²との違い:平均的な予測のずれに注目
\(R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}{\sum_{i=1}^{n}(y_i-\bar{y})^2}=1-\frac{\mathrm{MSE}}{\operatorname{Var}(y)}\)決定係数\(R^2\)も、回帰モデルの評価によく使われます。\(\bar{y}\)は、評価対象となる実測値の平均です。上の定義では、モデルの二乗誤差を「評価対象の平均値を毎回予測した場合」の二乗誤差と比較しています。0なら両者は等しく、負ならモデルの二乗誤差のほうが大きいという意味です。
分散説明率との違いは、分子が残差の分散ではなくMSEである点です。残差の二乗平均は「残差の分散+残差の平均の二乗」に分けられるので、同じデータを同じ重みで評価し、実測値の分散が正なら、次の関係が成り立ちます。
\(\mathrm{MSE}=\operatorname{Var}(e)+\bar{e}^{\,2}\) \(R^2=\mathrm{EV}-\frac{\bar{e}^{\,2}}{\operatorname{Var}(y)}\)残差の平均が0なら分散説明率とR²は一致し、残差の平均が0でなければR²のほうが低くなります。ここでいう平均的なずれは、評価データ全体で過大予測や過小予測がどの程度残っているかという意味です。統計学における推定量のバイアスという概念とは区別して考えます。
実測値が10、20、30のとき、予測値が20、30、40だった例で確認しましょう。
| 確認する量 | 値 | 意味 |
|---|---|---|
| 残差 | −10、−10、−10 | 毎回10ずつ過大に予測している |
| 残差の平均 | −10 | 過大予測が全体として残っている |
| 残差の分散 | 0 | 残差同士のばらつきはない |
| MSE | 100 | 各残差の二乗平均は0ではない |
| 分散説明率 | 1 | 実測値の増減の形を完全に捉えている |
| 決定係数R² | −0.5 | 二乗誤差では、平均値20を毎回予測する場合より悪い |
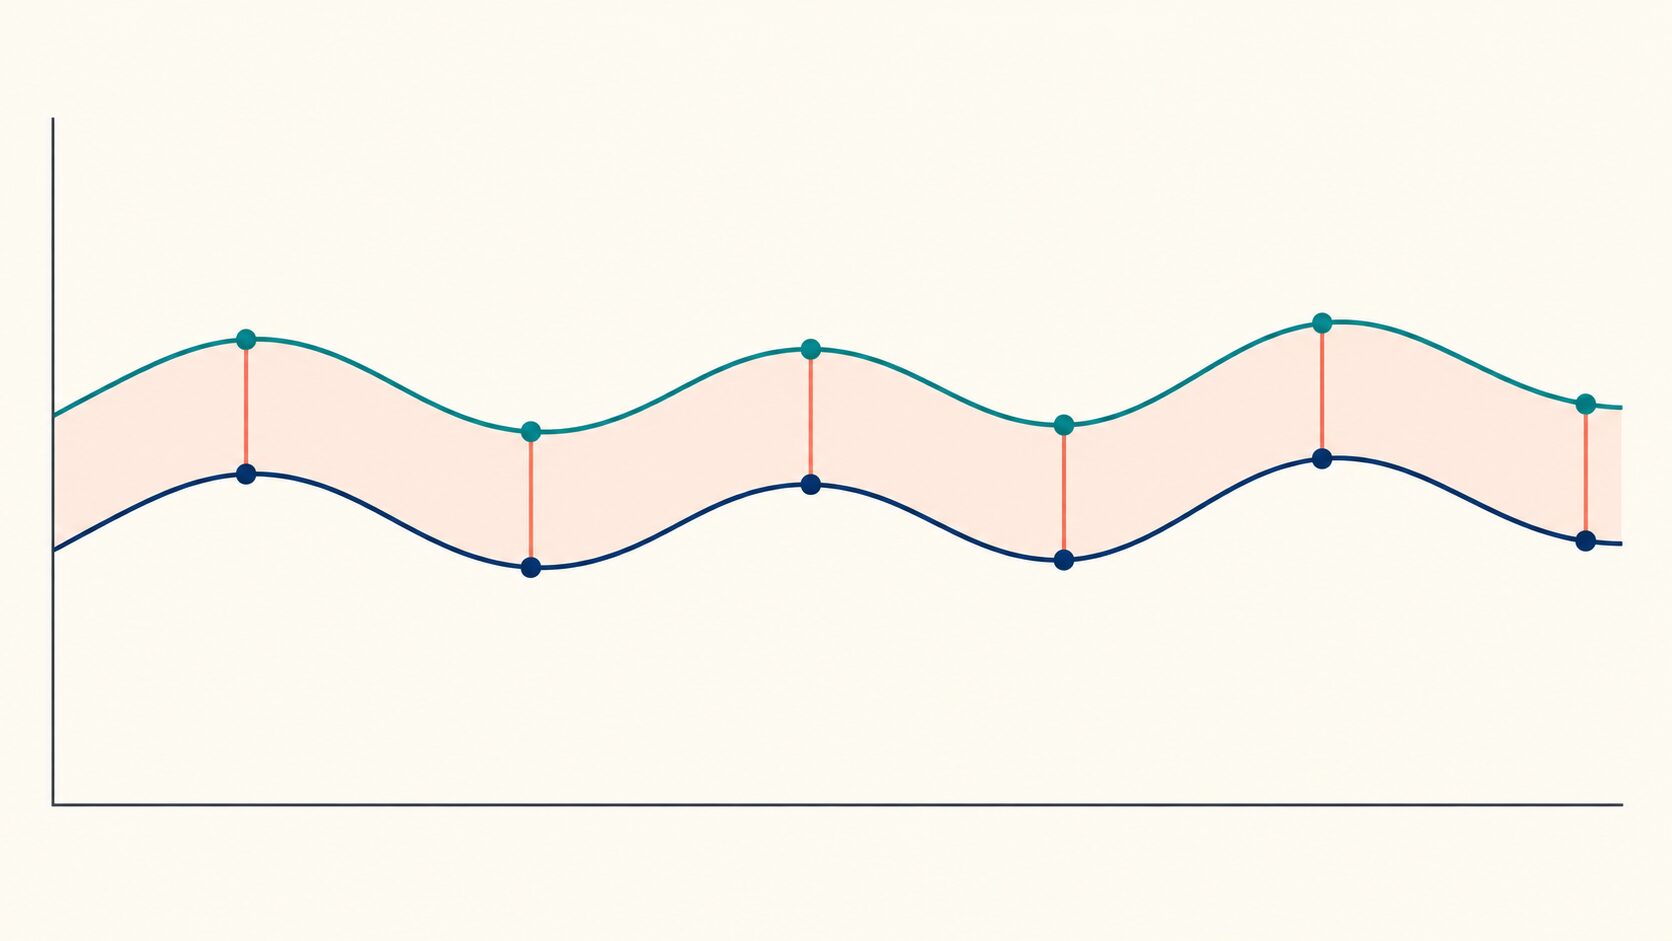
分散説明率は、すべての予測値に同じ定数を加減しても変わりません。そのため、変動の形を確認する補助指標にはなりますが、売上予測から発注数を決める場面などでは、この見落としが実務上の問題になります。「偏りの影響を受けないので、R²より優れた指標」とは言えません。
切片を含む通常の最小二乗法では、学習データ上の残差平均が理論上0になるため、両指標は一致します。ただし、未知の評価データでも残差平均が0になるとは限らず、切片を含まないモデルや別の学習方法にも同じ性質を無条件に当てはめることはできません。
MAE・RMSEと組み合わせる理由
分散説明率や決定係数は単位を持たず、データ全体のばらつきに対する相対的な性能を示します。一方、現場では「何個ずれるのか」「何度ずれるのか」が必要です。そこで、元の目的変数と同じ単位で読めるMAEやRMSEを併せて使います。
| 指標 | 確認できること | 読むときの注意 |
|---|---|---|
| 分散説明率 | 実測値の分散に対する残差分散の小ささ | 予測への一律の加減算では変わらない |
| 決定係数R² | 平均値を予測する基準に対する二乗誤差の改善 | 実測値のばらつきに左右されるため、異なるデータでの単純比較には向かない |
| MAE(平均絶対誤差) | 残差の絶対値の平均。平均でどれくらい外れるか | 過大・過小の方向は分からない |
| RMSE(二乗平均平方根誤差) | 残差を二乗した平均の平方根。大きな外れを強く反映する | 少数の大きな誤差に影響されやすい |
| 残差の平均 | 全体として過大予測か過小予測か | 正負の誤差が打ち消し合うため、0でも各予測が正確とは限らない |
先ほどの「毎回10個多く予測する」モデルなら、MAEとRMSEはいずれも10個です。分散説明率が1でも、在庫計画に使うには無視できないずれだと判断できます。また、本稿のように残差を実測値−予測値と定義した場合、残差平均が負なら全体として過大予測、正なら過小予測です。
平均値だけでなく、誤差が大きい日や対象も確認しましょう。例えば、通常日は正確でも繁忙日に大きく外れるモデルは、全体の指標だけでは問題を見つけにくい場合があります。実測値と予測値の散布図や、残差を時系列に並べた図が、原因を探る手がかりになります。
モデル比較に使う手順と過学習への注意
分散説明率でモデルを比べるときは、同じ未学習データと同じ評価条件を使うことが基本です。あるモデルの0.7と別のモデルの0.5を比べても、評価した期間や対象が違えば、モデル自体の優劣とは限りません。
- 予測対象と基準モデルを決める。売上数量などの連続値を対象にし、平均値や前日の値を使う単純な予測も比較対象にします。基準モデルの予測を作るときも、利用可能な過去の情報だけを使います。
- 学習用・検証用・最終評価用にデータを分ける。検証用データで特徴量やモデル設定を選び、最終評価用データは選択が終わってから使います。データが少ない場合には交差検証も選択肢です。
- 同じ条件で指標を計算する。評価データ、目的変数の単位、欠損値の扱い、重み付けをそろえ、分散説明率、R²、MAEやRMSEを比較します。
- 学習時と評価時の差を調べる。学習データでは高いのに未学習データで大きく下がる場合は、過学習やデータ分布の変化を疑います。
- 利用目的に照らして誤差を確認する。残差平均や期間別・店舗別の誤差を見て、実際の判断に許容できる範囲かを確かめます。
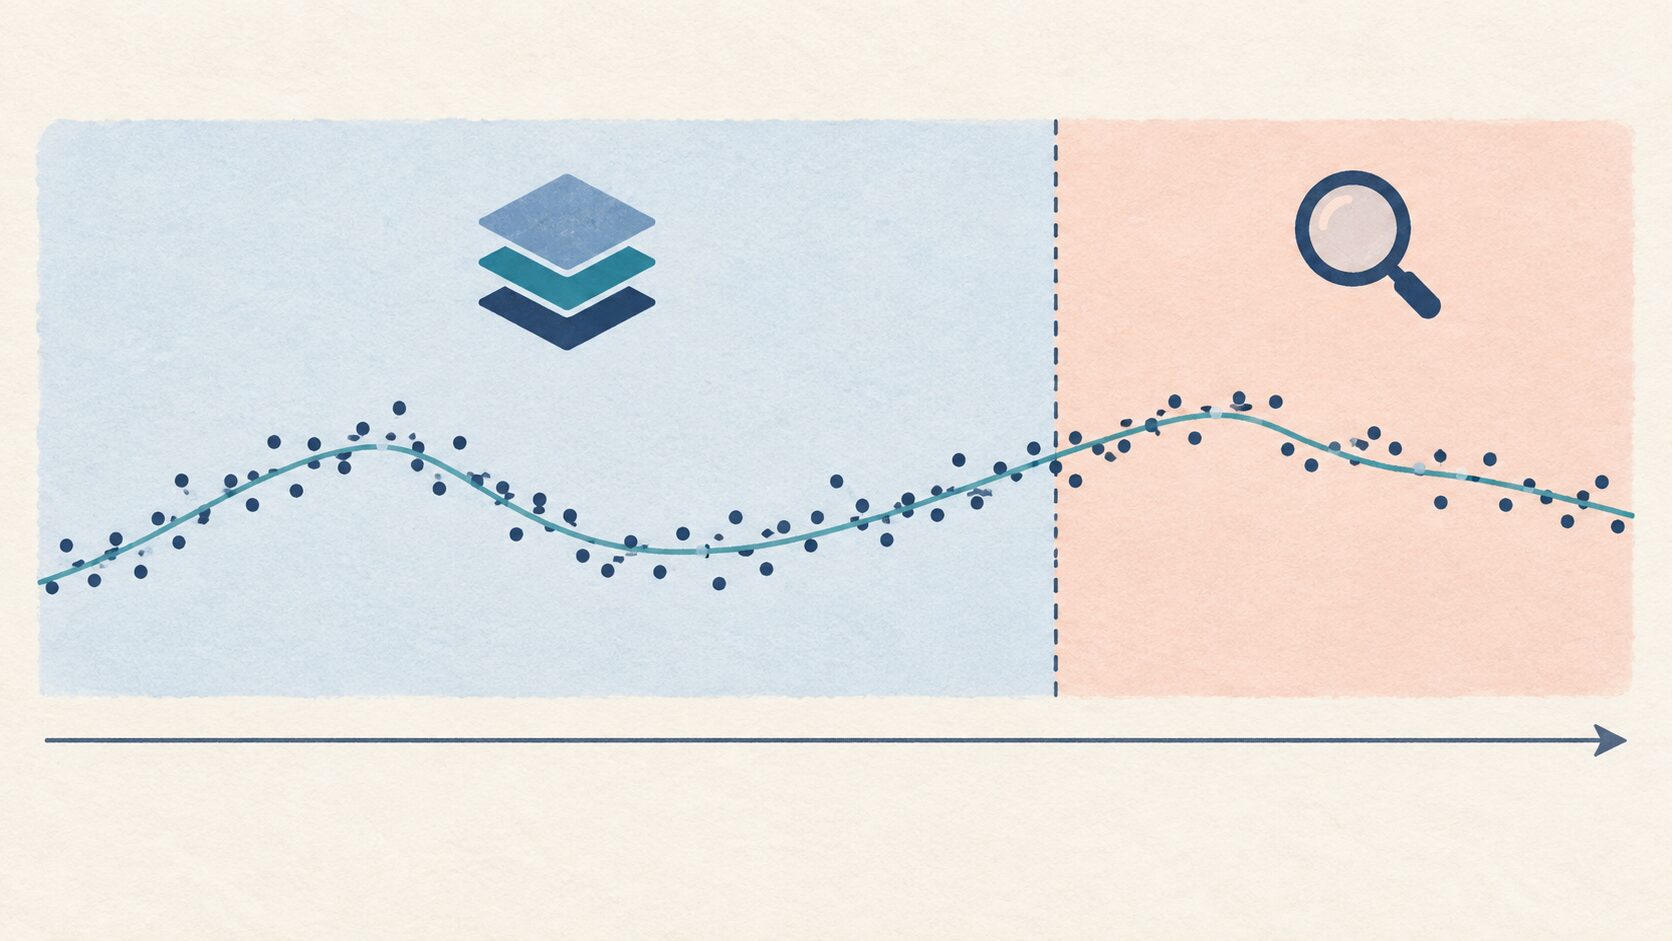
売上や価格などの時系列データでは、過去で学習して後の期間で評価するなど、実際の予測時点を再現する分割が必要です。ランダムに混ぜると、未来の情報や隣接時点の似た情報が学習側に入り、評価が実力以上によく見えることがあります。
前処理にも注意が必要です。標準化の平均や欠損値を埋める値を評価データまで含めて求めると、データ漏洩につながります。学習データで前処理の設定を決め、それを評価データへ適用します。複雑なモデルほど高スコアになるとは限らないため、精度に加えて処理時間や運用のしやすさも比べると判断しやすくなります。
売上・金融・医療での活用例
分散説明率が役立つのは、数値の変動を予測する回帰の場面です。元のデータが何を表すかによって、併せて確認すべき誤差や評価条件は変わります。
| 分野 | 回帰としての活用例 | 併せて確認すること |
|---|---|---|
| 販売・需要予測 | 気温、曜日、過去の販売実績から翌日の売上数量を予測 | 発注に影響する個数の誤差、過大・過小予測、店舗別や繁忙期の性能 |
| 金融・経済分析 | 将来の価格、収益率、経済指標などの数値を予測 | 時系列の検証、単純な予測との比較、時期による関係の変化 |
| 医療データの研究 | 検査値などの連続した数値を予測 | 元の単位での誤差、対象集団の違い、用途に応じた別途の検証 |
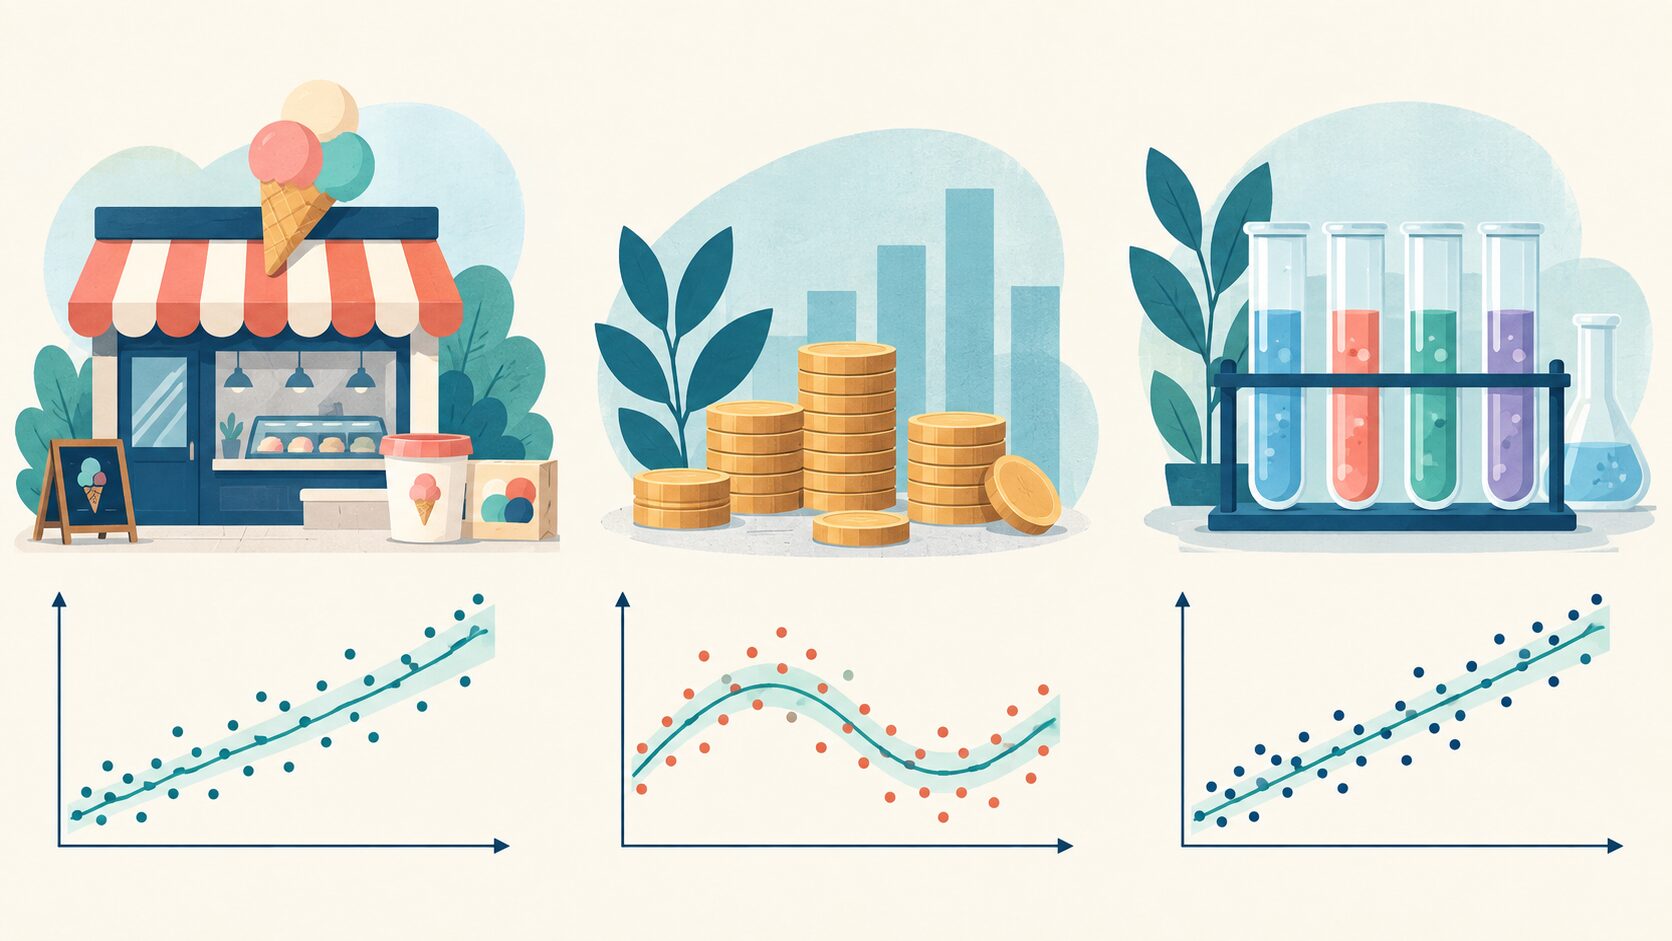
例えばアイスクリームの需要予測では、気温だけのモデルと、曜日や店舗情報も加えたモデルを同じ評価期間で比べられます。分散説明率の改善に加え、MAEが何個減ったかを確かめれば、増減を捉える性能と発注への影響の両方を検討できます。
金融の例では、高い分散説明率から利益が出るとは判断できません。医療の例でも、検査値の予測性能と、病気の有無を判定する能力は別です。指標が評価しているのは、あくまで対象データ上の数値予測の一側面です。
「購入する・しない」「病気がある・ない」のような分類には、適合率や再現率など、課題に合った分類指標を使います。商品推薦でも、購入金額を予測する回帰と、おすすめ商品の順位を決める評価は区別が必要です。分散説明率を、AIモデル全般に使える正解率として扱わないようにしましょう。
主成分分析の寄与率との違い
「Explained variance」や「説明分散」という言葉は、主成分分析(PCA)でも登場します。ただし、この記事で扱った回帰モデルの分散説明率とは、何を評価しているかが異なります。
回帰の分散説明率は、目的変数の実測値と予測値を比べ、残差の分散から予測を評価します。一方、PCAの寄与率は、入力データの全体の分散のうち、ある主成分がどれだけを受け持つかを表します。複数の主成分の寄与率を足した値が累積寄与率です。
例えば、第1主成分の寄与率が0.6、第2主成分が0.3なら、2成分の累積寄与率は0.9です。これは次元を減らした際に、入力データの分散をどの程度保持しているかという話であり、売上予測の精度が90%という意味ではありません。
通常のPCAでは寄与率は0から1の範囲で考えますが、回帰の分散説明率には負の値もあります。用語を読むときは、「予測値と実測値の比較なのか」「主成分によるデータの圧縮なのか」を確かめると混同を防げます。
まとめ
分散説明率は、実測値に対して残差のばらつきがどれだけ小さいかを確認する指標です。計算には残差の平均を引いた分散を使い、値は1以下で、負になる場合もあります。
特に覚えておきたいのは、一定の予測のずれを見落とす点です。残差平均が0なら決定係数R²と一致しますが、平均的なずれがあればR²のほうが低くなります。未学習データで両指標を確認し、MAEやRMSEで実際の誤差も読むことで、モデルの変動への対応と実用上の精度を合わせて判断できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月26日 | 負の値と残差分散の説明を修正し、決定係数との違いを計算例で補足 |