

AIの初心者
「モーメンタム」とは何ですか?機械学習で、学習を速くする方法だと聞きました。

AI専門家
モーメンタムは、過去の更新方向を今の更新に生かす工夫だよ。坂を下るボールが勢いを保つように、同じ方向への更新を積み重ねて、損失が小さくなる場所を目指すんだ。
AIの初心者
今いる場所の傾きだけでなく、これまでの動きも使うのですね。傾きが小さい場所でも進めるのでしょうか?
AI専門家
それまでの勢いが残っていれば、傾きが小さくても進めることがあるよ。ただし、必ず停滞を抜け出せるわけではないんだ。勢いが強すぎると行き過ぎるので、学習率とモーメンタム係数の調整が大切になるよ。
モーメンタム(Momentum)とは、過去のパラメータ更新の勢いを現在の更新に加える、機械学習の最適化の手法です。勾配降下法に組み合わせることで、同じ方向への移動を後押しし、細長い谷での往復を抑えられる場合があります。
「学習率を大きくすることと何が違うのか」「SGDやAdamとどう関係するのか」を理解するには、現在の勾配と過去の更新を分けて考えることが大切です。この記事では、坂を転がるボールの例から更新式、具体的な計算、係数の調整まで順に説明します。
モーメンタムとは?過去の更新を生かす最適化の工夫
機械学習では、モデルの予測と正解のずれを表す「損失」が小さくなるように、重みやバイアスなどのパラメータを調整します。この調整を繰り返して、目的に合ったパラメータを探す処理が最適化です。
損失を地形の高さ、パラメータを地形上の位置に見立てると、学習は低い場所を探して坂を下る作業に相当します。位置を少し変えたときに損失がどの方向へどれだけ増えるかを示すのが「勾配」で、勾配降下法はその逆向きへ移動します。一度に進む大きさを調節する値が「学習率」です。
基本的な勾配降下法が現在の傾きから次の一歩を決めるのに対し、モーメンタムは前回までの移動の情報も残します。ボールが緩やかな坂に入ってもしばらく転がるように、直前の傾きが小さくなっても、それまでの勢いを使って進めます。
ここで記憶するのは、過去に得た正解や認識結果そのものではありません。保存するのは、どちらへ、どれくらいパラメータを動かしてきたかを要約した量です。また、ボールの比喩は理解を助けるためのもので、実際の学習では多数のパラメータについて数値計算を行います。
勾配降下法・SGDとの違い
モーメンタムは、勾配降下法と無関係な別の学習方式ではなく、勾配を使う更新に履歴を加える仕組みです。一方、SGD(確率的勾配降下法)は、データの一部を使って勾配を推定する方法です。実務では複数のデータをまとめたミニバッチで更新する方法も、広くSGDと呼ばれます。
つまり、「どのデータから勾配を計算するか」と「その勾配を使ってどう更新するか」は別の話です。SGDにモーメンタムを組み合わせたものが、SGD with Momentum、あるいはMomentum SGDです。SGDの設定にモーメンタム係数が用意されているのは、このためです。
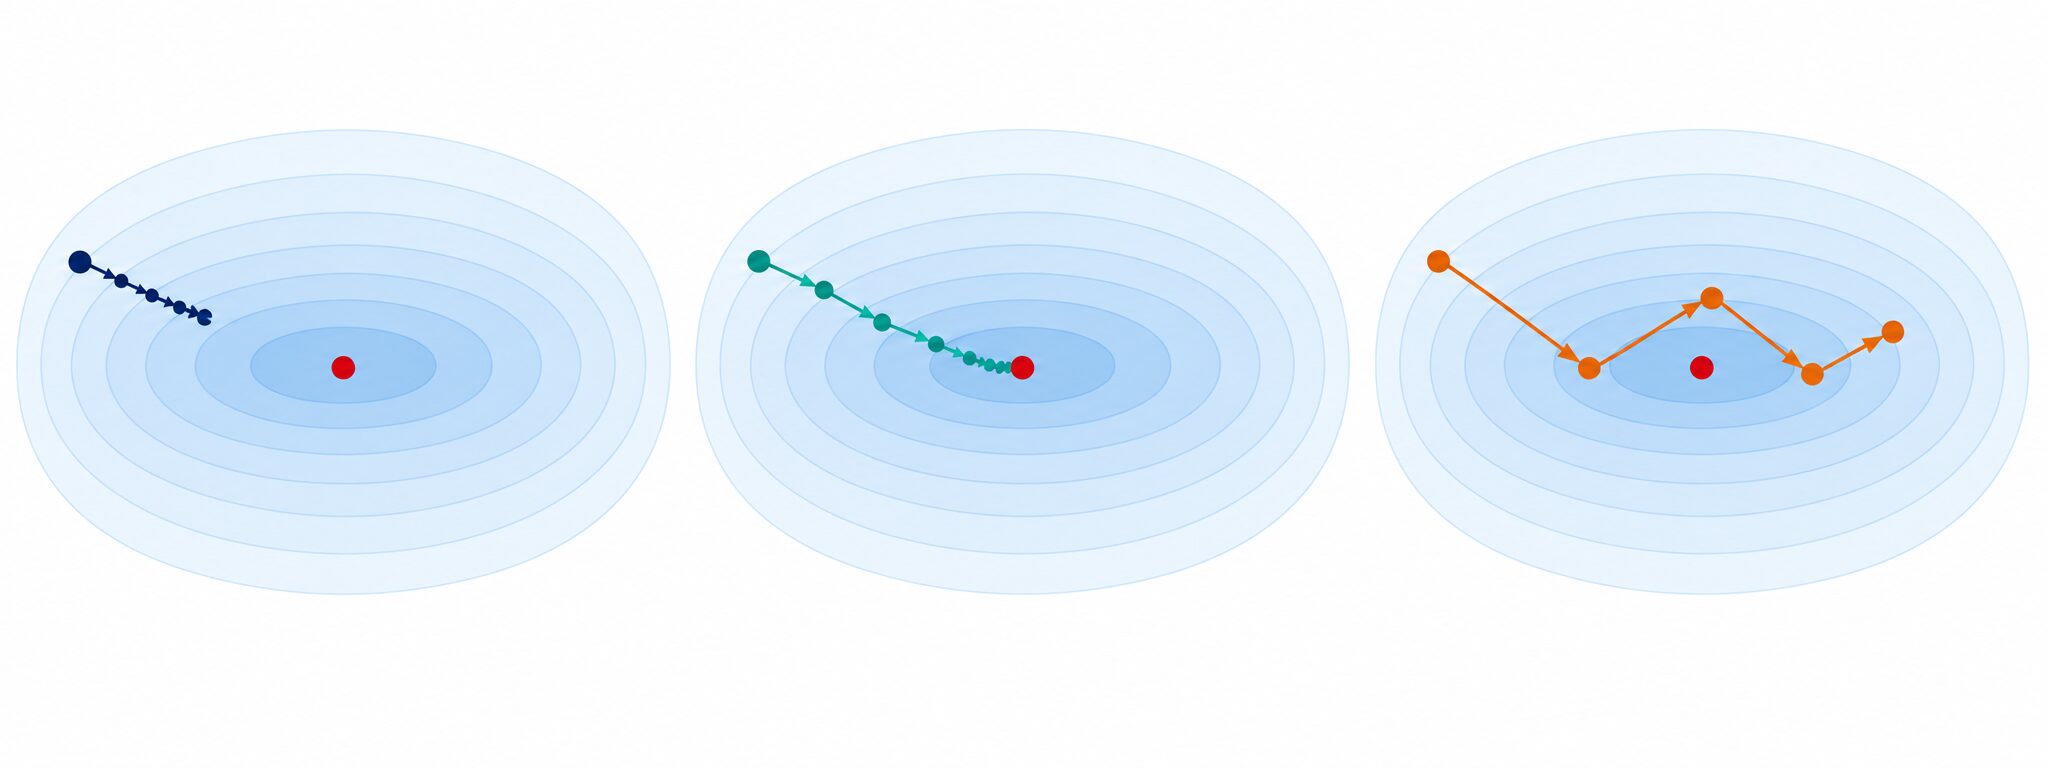
効果をイメージしやすいのが、片方の方向は急で、もう片方は緩やかな細長い谷です。現在の勾配だけを使うと、急な方向では谷の両側を行き来し、緩やかな方向への移動は遅くなりがちです。モーメンタムでは、交互に向きが変わる成分は打ち消し合いやすく、同じ向きが続く成分は積み重なります。その結果、適切な設定では谷に沿った移動が進みやすくなります。
| 比較する点 | モーメンタムなしの勾配更新 | モーメンタムありの勾配更新 |
|---|---|---|
| 更新の材料 | 現在の勾配 | 現在の勾配と、過去から引き継いだ更新量 |
| 同じ向きの勾配が続く場合 | その時点の勾配に応じて進む | 過去の勢いが加わり、移動が大きくなりやすい |
| 勾配の向きが交互に変わる場合 | 更新方向も変わりやすい | 過去と現在の成分が相殺され、往復が減る場合がある |
| 主な調整項目 | 学習率 | 学習率とモーメンタム係数 |
| 追加で保持する情報 | 基本形では履歴を保持しない | パラメータと同じ大きさの更新履歴 |

図の左は往復の多い経路、右は往復を抑えながら谷に沿って進む経路のイメージです。実際の更新経路や収束速度は、損失の形や設定によって変わります。
更新式とモーメンタム係数の意味
\(v_t = \beta v_{t-1} – \eta g_t,\qquad \theta_{t+1} = \theta_t + v_t\)この式は、更新量を表す「速度」を保持する書き方です。まず前回の速度を一定の割合で残し、現在の勾配に基づく更新を加えます。次に、その合計だけパラメータを動かします。
- \(\theta_t\):更新前のパラメータ。重みやバイアスをまとめたものです。
- \(g_t\):現在のパラメータで求めた損失の勾配。SGDではミニバッチなどから推定します。
- \(\eta\):学習率。現在の勾配による更新の大きさを調節します。
- \(v_t\):今回パラメータへ加える速度、つまり更新量です。
- \(\beta\):モーメンタム係数。前回の速度をどれだけ残すかを決めます。
一般的な基本形では、係数を \(0 \leq \beta < 1\) の範囲で選び、最初の速度は \(v_0=0\) とします。以下では最初の更新を1回目として扱います。マイナス符号は、損失が増える勾配の向きと逆方向に進むことを表します。
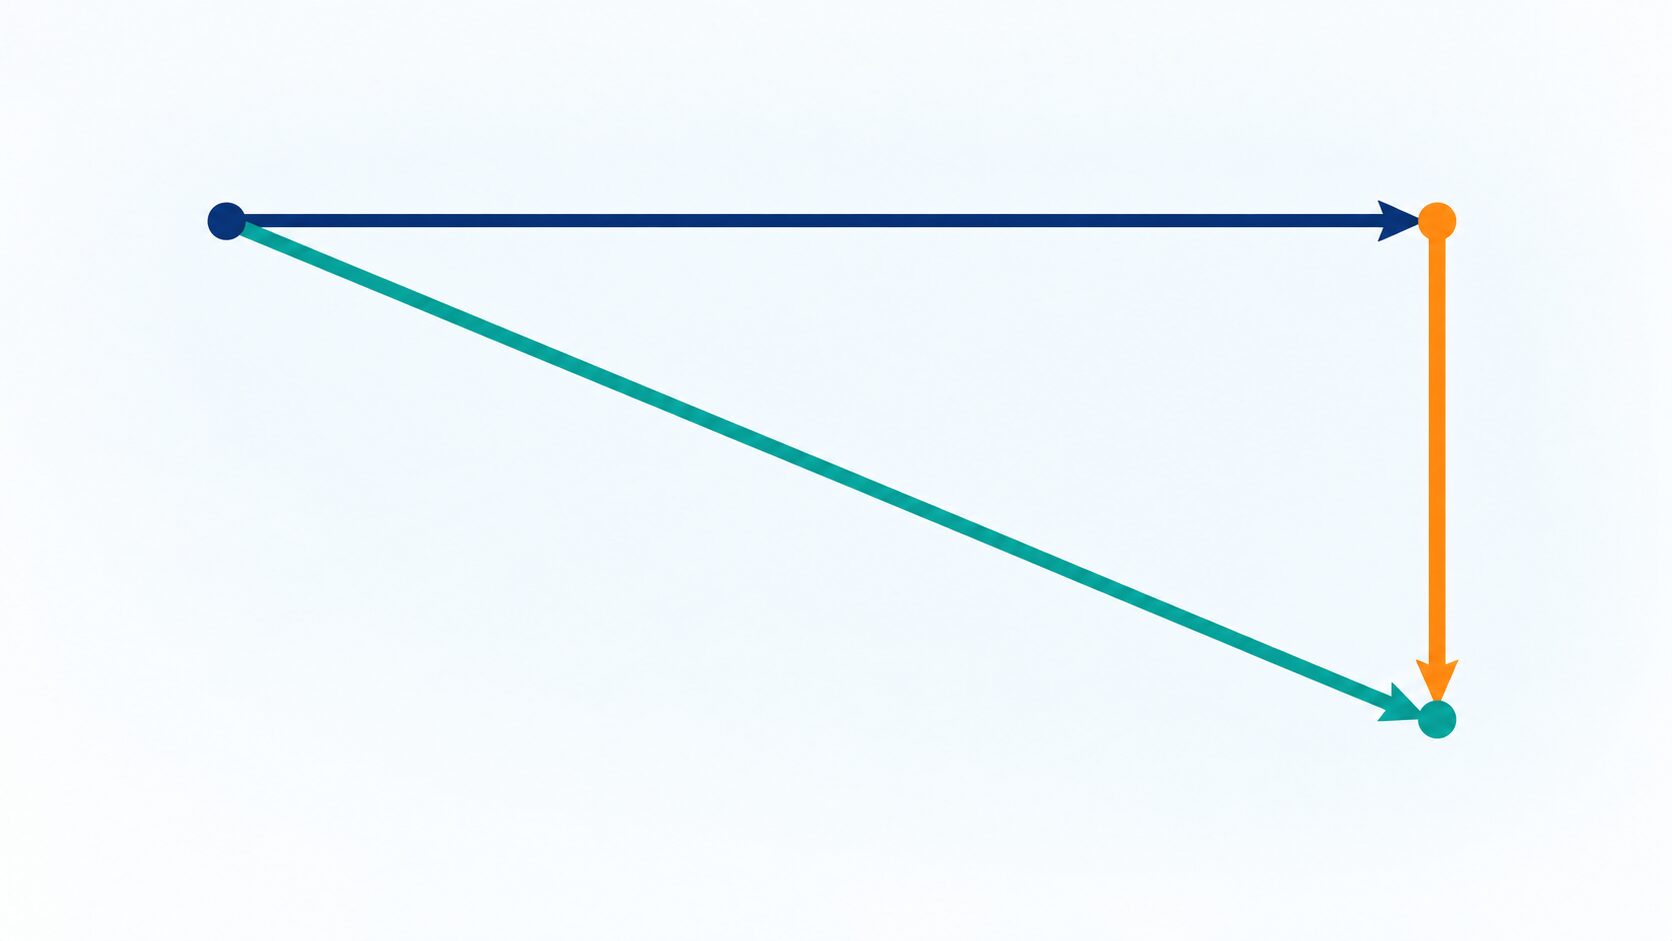
図では、紺の矢印の先へ橙の矢印をつなぐと、始点から終点までの青緑の矢印が得られます。これは、過去の勢いと現在の更新を足し合わせる考え方です。実際の二つの成分が常に直角になるわけではありません。
係数が0.9なら、直前の速度を90%残して新しい更新を足します。さらに古い情報も速度の中に含まれていますが、時間がたつほど繰り返し係数が掛かり、影響は小さくなります。したがって、過去の全ステップを同じ重さで足す方法ではありません。
資料によっては、速度ではなく勾配の移動平均を保持し、新しい勾配に \(1-\beta\) を掛ける表記もあります。履歴を使う考え方は共通ですが、正規化や学習率の置き場所が違うと、同じ数値設定でも更新の大きさが変わります。式を比較するときは、何を履歴として保存し、どこで学習率を掛けるかを確かめましょう。
数値例で確認するモーメンタムの動き
\(\eta=0.1,\qquad \beta=0.9,\qquad v_0=0\)1個のパラメータについて、3回続けて勾配が \(g_t=1\) になったと仮定します。モーメンタムなしでは、毎回の更新量はマイナス0.1です。先ほどの速度の式を使うと、次のように変わります。
| 更新回数 | 速度の計算 | パラメータの更新量 |
|---|---|---|
| 1回目 | \(v_1=0.9\times0-0.1\times1=-0.1\) | マイナス0.1 |
| 2回目 | \(v_2=0.9\times(-0.1)-0.1\times1=-0.19\) | マイナス0.19 |
| 3回目 | \(v_3=0.9\times(-0.19)-0.1\times1=-0.271\) | マイナス0.271 |
同じ向きの勾配が続くため、更新量の絶対値が大きくなっています。3回分の移動を合計すると、モーメンタムなしではマイナス0.3、ありではマイナス0.561です。この例から、学習率を変えなくても履歴によって移動量が変わることが分かります。
次の勾配だけがゼロになっても、速度は \(v_4=0.9\times(-0.271)=-0.2439\) となり、更新が続きます。ただし、ゼロ勾配が続く間は速度も徐々に小さくなります。
これは計算を理解するために勾配を一定にした例です。実際には移動先によって勾配が変わるため、移動量が増えるほど良いとは限りません。最小値に近づいたところで勢いが強く残ると、通り過ぎてしまうことがあります。
鞍点・プラトー・局所最小値で何が起こるか
学習の停滞を考えるときは、鞍点、プラトー、局所最小値を区別する必要があります。どれも学習が進みにくい場面に関係しますが、地形の性質は同じではありません。
| 用語 | 地形としての意味 | モーメンタムとの関係 |
|---|---|---|
| 鞍点(あんてん) | 典型的には勾配がゼロで、ある方向には上り、別の方向には下りになる地点 | 残った速度などでその近傍を進める場合はあるが、脱出を保証しない |
| プラトー | ここでは、広い範囲で勾配が小さい平坦な領域 | 過去の速度で進みやすくなる場合があるが、勢いは減衰する |
| 局所最小値 | 近くと比べると損失が小さいが、全体で最も小さいとは限らない地点 | 勢いで小さな障壁を越える場合はあっても、必ず抜け出せるわけではない |
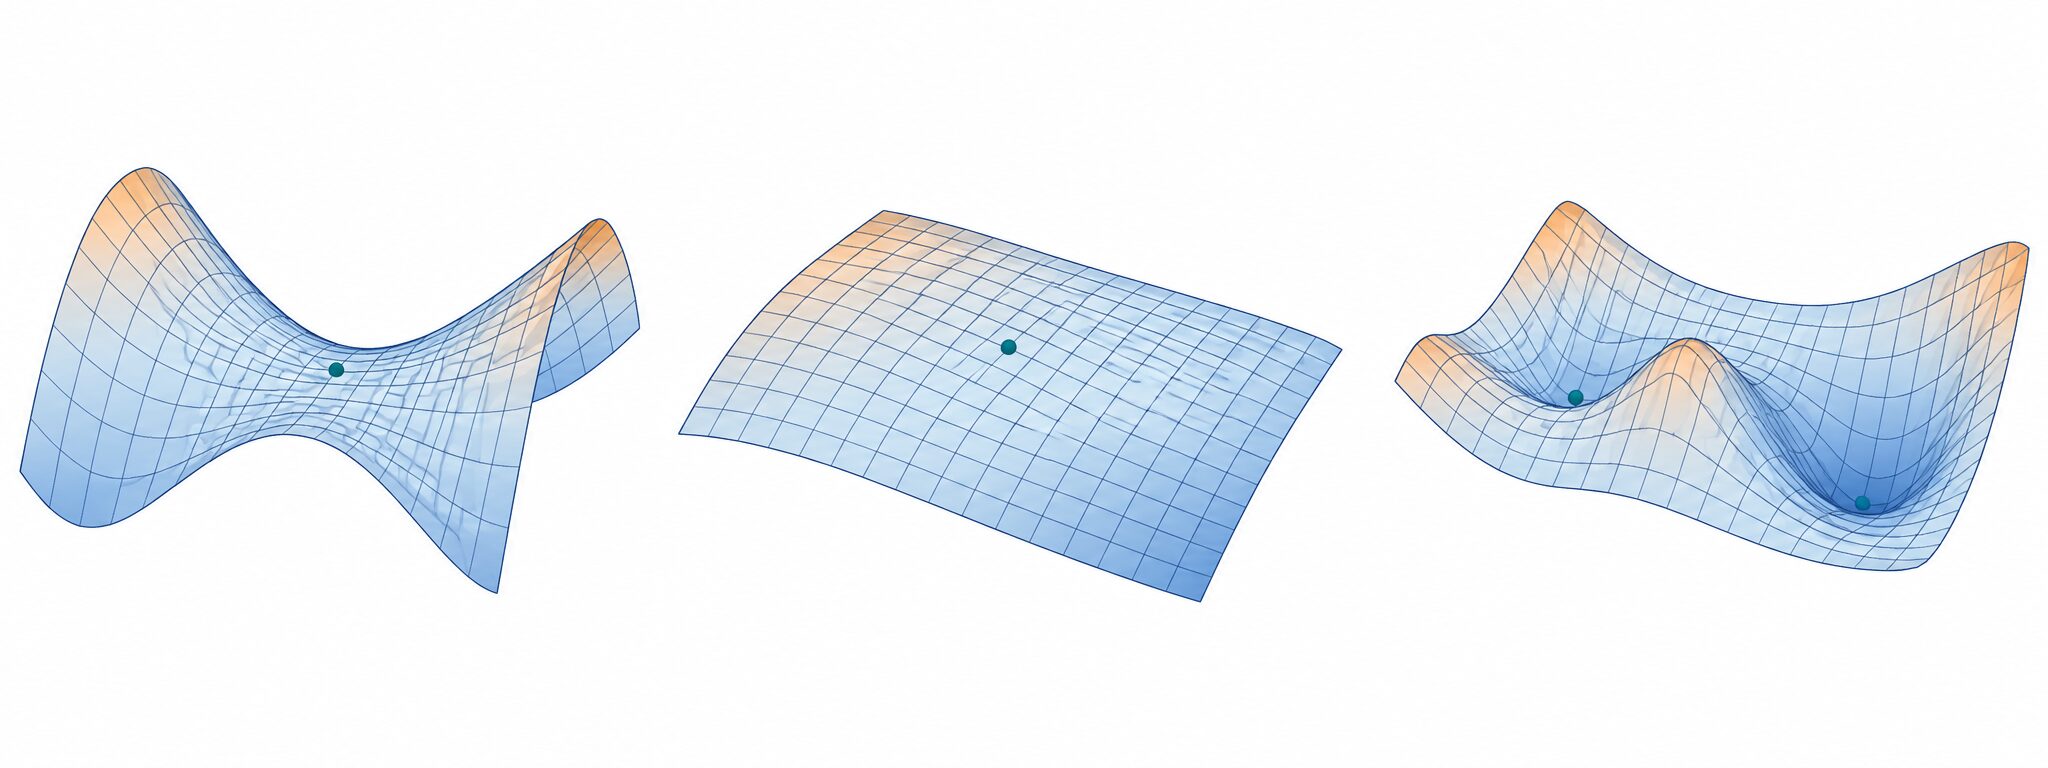
鞍点は「平らな場所なら何でも」という意味ではありません。馬の鞍のように、方向によって曲がり方が異なることが特徴です。また、プラトーという言葉は、損失や精度の改善が止まった状態を指すこともあり、学習曲線の停滞だけで地形を断定することはできません。
勾配も残っている速度もゼロなら、基本的なモーメンタムだけではその位置から動けません。SGDではミニバッチによる勾配のばらつきも更新に影響しますが、その効果と過去の勢いの効果は分けて考えます。モーメンタムを「どんな局所解からも脱出し、大域的な最適解へ進む方法」と捉えるのは誤りです。
メリットとデメリット
主なメリットは、同じ方向へ続く更新を後押しし、適した条件では目標の損失に達するまでの更新回数を減らせることです。ミニバッチごとに勾配が多少ばらつく場合も、履歴を使うことで更新方向の急な変化を和らげる効果が期待できます。
ただし、「学習が速くなる」とは、1回の計算そのものが必ず短くなるという意味ではありません。モーメンタムには速度の計算が追加されます。実際の短縮効果は、収束までの回数、1回の処理時間、データやモデルによって決まります。
デメリットは、学習率に加えて係数の調整が必要になることです。強い勢いが残ると最小値を行き過ぎたり、勾配が変わってから方向転換するまでに時間がかかったりします。急激な更新で損失が増える場合もあるため、係数を大きくすれば常に安定するわけではありません。
さらに、基本的にはパラメータと同じ要素数の速度を保持する追加メモリが必要です。モデルが大きい場合は、この保存量も無視できません。また、学習用データの損失が早く下がっても、未知のデータへの精度が必ず上がるとは限らず、検証データでの確認が必要です。
学習率とモーメンタム係数の調整方法
モーメンタム係数と学習率は、組み合わせて調整します。係数0.9は試し始める値の一例ですが、どのモデルにも最適な値ではありません。係数を大きくすると過去の影響が長く残るため、同じ学習率でも実際の移動量が増えることがあります。
学習率だけを大きくすると、その時点の勾配に基づく更新が一律に大きくなります。モーメンタムは履歴に応じて成分ごとの更新方向や大きさを変えるため、単純な学習率の増加とは異なります。それでも両方を強めすぎれば、行き過ぎや発散を起こしやすくなります。
- まず、比較するモデル、データの分割、バッチサイズ、学習に使える時間をそろえます。モーメンタムなしの結果も残すと、変更の効果を判断しやすくなります。
- 係数を一つに固定して学習率を試します。損失が大きく振動したり増え続けたりする場合は、学習率を下げて挙動を確かめます。
- 更新が安定したら係数を調整します。進みが遅い理由は学習率だけでなく、データやモデルにもあるため、係数だけで解決しようとしないことが大切です。
- 終盤で行き過ぎが続く場合は、学習率を徐々に小さくするスケジュールも検討します。各設定について損失と検証指標を記録します。
- 有望な設定は乱数の初期値を変えて確認します。1回だけの良い結果より、繰り返しても安定するかを見ると判断しやすくなります。
図は設定による挙動の違いを示す概念図です。進みが遅い、安定して近づく、行き過ぎるといった様子を、実際には学習曲線や更新量から確認します。ミニバッチ学習では損失が一時的に増えることもあるので、1ステップだけでなく一定期間の傾向を見ましょう。
学習率と係数の両方を一度に大きく変えず、比較条件をそろえて記録することが、調整の近道です。検証データの成績が悪化している場合は、最適化の速さだけでなく過学習の可能性も検討します。
Nesterov・AdaGrad・RMSprop・Adamとの違い
最適化手法を比較するときは、過去の「方向」を使うのか、勾配の大きさに応じて「更新の尺度」を変えるのかに注目すると整理しやすくなります。モーメンタムは前者が中心です。
| 手法 | 主な仕組み | モーメンタムとの関係 |
|---|---|---|
| 基本的なモーメンタム | 過去の速度を残し、現在の勾配による更新を加える | 更新方向の履歴を使う基本形 |
| Nesterovの加速勾配法 | 勢いで進む先を見越し、その位置の勾配を使って修正する考え方 | 先読みを取り入れた関連手法。実装では等価な形へ変形されることもある |
| AdaGrad | 過去の勾配の二乗を累積し、パラメータごとに更新の尺度を調節する | 過去の方向を残すことより、勾配の大きさに応じた調整が中心 |
| RMSprop | 勾配の二乗の指数移動平均で更新の尺度を調節する | AdaGradの全期間の累積と異なり、古い二乗勾配の影響を減衰させる |
| Adam | 勾配の一次モーメントと二次モーメントの推定を使い、初期の偏りも補正する | 方向の履歴を使う要素と、パラメータごとの尺度調整を組み合わせる |
一次モーメントは勾配の平均的な向き、二次モーメントは勾配の二乗の平均に対応します。Adamはモーメンタムと共通する考え方を含みますが、SGDにモーメンタムを加えたものと同一ではありません。なお、Adamの二次モーメントは、そのまま勾配の分散を意味するわけではありません。
比較する際は、それぞれの手法に合う学習率を調整し、同じ計算予算で検証します。同じ学習率をそのまま流用した結果だけでは、手法の適性を判断しにくいためです。収束の速さ、検証精度、追加メモリを見て選びましょう。
画像認識・自然言語処理・音声認識での活用
モーメンタムが働くのは、学習中にモデルのパラメータを更新する段階です。画像、文章、音声といった入力の種類を問わず、勾配に基づいて学習するモデルで利用できます。ただし、どの分野でも常に同じ最適化手法が最適とは限りません。
例えば犬と猫の画像分類では、ミニバッチごとに画像の特徴や難しさが異なり、勾配にもばらつきが生まれます。SGDにモーメンタムを加えると、直近の一群だけに更新方向が左右される程度を和らげ、継続的な改善方向を保つ助けになる場合があります。犬や猫の特徴を直接抽出するのはモデルであり、モーメンタム自体が画像を判別するわけではありません。
| 分野 | 学習タスクの例 | 最適化で確認すること |
|---|---|---|
| 画像認識 | 犬猫分類、物体認識 | 損失の下がり方、検証画像での分類精度、学習時間 |
| 自然言語処理 | 感情分析、機械翻訳 | 学習の安定性と、タスクに合った検証指標 |
| 音声認識 | 音声の文字起こし | 認識誤りの割合や、条件の異なる音声への対応 |
文章や音声でも、過去の勾配を生かす仕組みは同じです。ただし、自然な翻訳や雑音への強さは、モデル構造、学習データ、前処理などにも左右されます。モーメンタムの導入だけで認識精度が上がる、雑音を除去できる、推論が速くなるといった効果は保証されません。何を改善したいのかを定め、学習の効率と最終的な性能を分けて評価することが大切です。
よくある疑問
モーメンタム係数を0にするとどうなりますか?
この記事の基本式では、過去の速度を引き継がず、現在の勾配だけで更新する形になります。したがって、同じ学習率と同じ勾配を使うなら、モーメンタムなしの勾配降下法やSGDに相当します。
過去の勾配をすべて保存する必要がありますか?
必要ありません。直前までの情報をまとめた速度を一つ保持し、新しい勾配を使って更新します。学習ステップ数に比例して履歴の保存量が増えるわけではありませんが、パラメータ数に応じた追加メモリは必要です。
勾配消失も解決できますか?
根本的な解決策にはなりません。過去の速度が残っていれば一時的に動ける場合はありますが、必要な勾配がほとんど伝わらない状態が続けば、学習に必要な情報は得にくいままです。勾配消失では、モデル構造、活性化関数、初期化なども見直します。
まとめ
モーメンタムは、現在の勾配と過去の更新の勢いを組み合わせ、パラメータを調整する手法です。同じ方向への更新を積み重ね、谷を横切る往復を和らげることで、条件が合えば収束を早められます。SGDと組み合わせられること、Adamにも履歴を利用する関連の考え方があることを押さえると、最適化手法の違いが見えてきます。
一方、停滞や局所最小値からの脱出、最終精度の向上を保証するものではありません。更新式で「過去の速度」と「今の勾配」を分けて理解し、学習率と係数を調整しながら、損失・検証指標・学習時間を確かめて使いましょう。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年9月27日 | 鞍点と停滞の説明を修正し、更新式・計算例・SGDとの比較を追記 |