
RNNの学習とは?BPTTの仕組み・課題・対策を解説

AIの初心者
RNNの学習に使う「BPTT」って、どんな方法ですか?

AI専門家
BPTTは、RNNが出した予測のずれを手がかりに、時間を遡って重みの調整に必要な量を計算する方法だよ。文章なら、前に読んだ単語の情報が、後の単語の予測にどう影響したかをたどるんだ。
AIの初心者
前に読んだ単語とのつながりまで学習するんですね。長い文章でも、最初まで遡るのですか?
AI専門家
対象の文章全体を遡る方法も、一定の長さで区切る方法もあるよ。長く遡るほど計算や記憶に必要な負担が増え、学習の手がかりも弱まったり大きくなりすぎたりする。仕組みと、区切って学習する方法を順に見ていこう。
BPTT(Backpropagation Through Time、時間方向誤差逆伝播法)は、RNNを時間に沿って展開し、損失を小さくするために必要な勾配を求める方法です。勾配とは、重みなどの値を少し変えたとき、予測のずれを表す損失がどちらの方向へ、どれくらい変化するかを示す量です。
RNNが過去の情報を次の時刻へ渡す一方、BPTTは学習時にその計算を逆向きにたどります。この記事では、次の単語を予測する例から学習の流れを確認し、勾配消失・勾配爆発、打ち切りBPTT、LSTMやGRUの役割まで説明します。
時系列データを学ぶRNNとBPTTの役割
時系列データは、気温、株価、機械のセンサー値、音声のように、時間の順序を持つデータです。同じ数値が並んでいても、上昇しているのか下降しているのかで意味が変わります。文章も単語の順序によって意味が変わるため、時間間隔を持つ測定値とは異なるものの、順番が重要な系列データとして扱えます。
こうしたデータからは、過去の気温をもとにした将来の予測、工場の振動や温度の変化を利用した異常検知、音の連なりを文字へ変換する音声認識などが考えられます。一つの値だけで判断するよりも、その前に何が起きていたかを利用することで、変化のパターンを捉えやすくなります。
RNN(Recurrent Neural Network、再帰型ニューラルネットワーク)は、現在の入力と、一つ前の時刻の隠れ状態から、新しい隠れ状態を作る構造です。隠れ状態は、これまでの入力から得た情報を数値のまとまりとして保持し、次の計算へ受け渡します。文章なら、「今日は」を読んだ状態を引き継ぎながら「雨」を処理する、といった動きです。
ただし、隠れ状態は過去の情報の要約であり、入力をすべて正確に保存した記録ではありません。どの情報を残せるかは、モデルの構造、状態の大きさ、学習で得た重みに左右されます。長い文章の冒頭を、いつまでも同じ精度で覚えているとは限りません。
ここで区別したいのが、RNN、BPTT、最適化手法の役割です。RNNは予測を行うモデルの構造、BPTTはそのモデルの勾配を計算する方法です。求めた勾配を使って実際に重みを更新するのは、SGD(確率的勾配降下法)やAdamなどの最適化手法です。BPTTだけで更新幅まで決まるわけではなく、学習率などの設定も更新に関わります。
時間に展開して理解するBPTTの仕組み
RNNの内部には、前の隠れ状態を次の計算に戻すつながりがあります。この繰り返しを時刻ごとに横へ並べて考えることを「時間に展開する」といいます。展開すると、最初の入力から後の出力まで、情報がどの計算を通って進んだかを追えるようになります。
時刻ごとに並べたRNNは、すべて同じ重みを使います。時刻ごとに別々のモデルを学習させるのではなく、一組の重みを何度も使った計算として扱う点が大切です。時間の展開は、同じ処理の繰り返しを見える形にしたものです。
- 順伝播で、入力と前の隠れ状態から次の隠れ状態を作り、そこから出力を計算します。この処理を対象の系列の終わりまで進めます。
- 出力を正解と比べ、損失を求めます。次の単語の予測では各時刻に正解を置けますが、文章全体の分類では最後の出力だけに正解を与える設計もあります。
- 損失から逆向きに計算をたどり、各隠れ状態や重みが損失に与えた影響を、勾配として求めます。これが時間方向の逆伝播です。
- 共有重みが各時刻で使われたことによる勾配を合計し、最適化手法へ渡して重みを更新します。
逆伝播の途中にある隠れ状態には、主に二つの経路から学習の手がかりが届きます。一つはその時刻の出力と損失を通る経路、もう一つは次の隠れ状態へ進み、後の時刻の損失につながる経路です。その時刻に損失を置かない設計では、前者の寄与はありません。
これらを合わせるときは、それぞれの経路で「値の変化が次の計算へどう影響するか」を反映させた勾配を足し合わせます。この計算は、合成された関数を微分する連鎖律に基づきます。たとえば「予測値と正解の差が3」と「次の時刻の差が2」だから単純に5にする、という計算ではありません。出力に至る変換や、隠れ状態を受け渡す変換の影響を考慮する必要があります。

「時間を遡る」とは、すでに行った計算のつながりを逆向きにたどることです。通常の誤差逆伝播法が層を遡るのと同じ考え方を、時間に展開した計算グラフへ適用しています。過去の時刻だけに専用の重みを用意して修正するのではなく、今後のすべての時刻で使う共有重みを学習します。
短い文章で追うBPTTの学習
「今日は/雨/なので/傘」という単語列で、次の単語を予測する場面を考えます。ここでは仕組みに注目するため、これらを一つずつの単語として扱います。入力は「今日は/雨/なので」、それぞれに対応する正解は一つ先の「雨/なので/傘」です。
| 時刻 | 入力 | 予測時に使う文脈 | 正解の単語 | 損失の計算 |
|---|---|---|---|---|
| 1 | 今日は | 「今日は」を処理した隠れ状態 | 雨 | 「雨」に割り当てた予測確率から計算 |
| 2 | 雨 | 前の状態と「雨」から作った隠れ状態 | なので | 「なので」に割り当てた予測確率から計算 |
| 3 | なので | 前の状態と「なので」から作った隠れ状態 | 傘 | 「傘」に割り当てた予測確率から計算 |
モデルは通常、候補となる単語それぞれに確率を割り当てます。損失には、正解の単語に割り当てた確率が低いほど大きくなる交差エントロピーなどを使います。「傘」より別の単語を高い確率で予測した場合には、「傘」の確率を高めるための学習信号が生まれます。各時刻の損失を合計または平均して、学習に使います。
「傘」の予測に使った隠れ状態は、その前に「雨」を処理した隠れ状態からも影響を受けています。そのため、「傘」の予測に対する損失を逆伝播すると、「なので」を処理した計算を経て、「雨」を処理した計算にも勾配が届きます。これによって、雨という情報を後の予測に役立つ形で保持するよう、共有重みを調整できます。
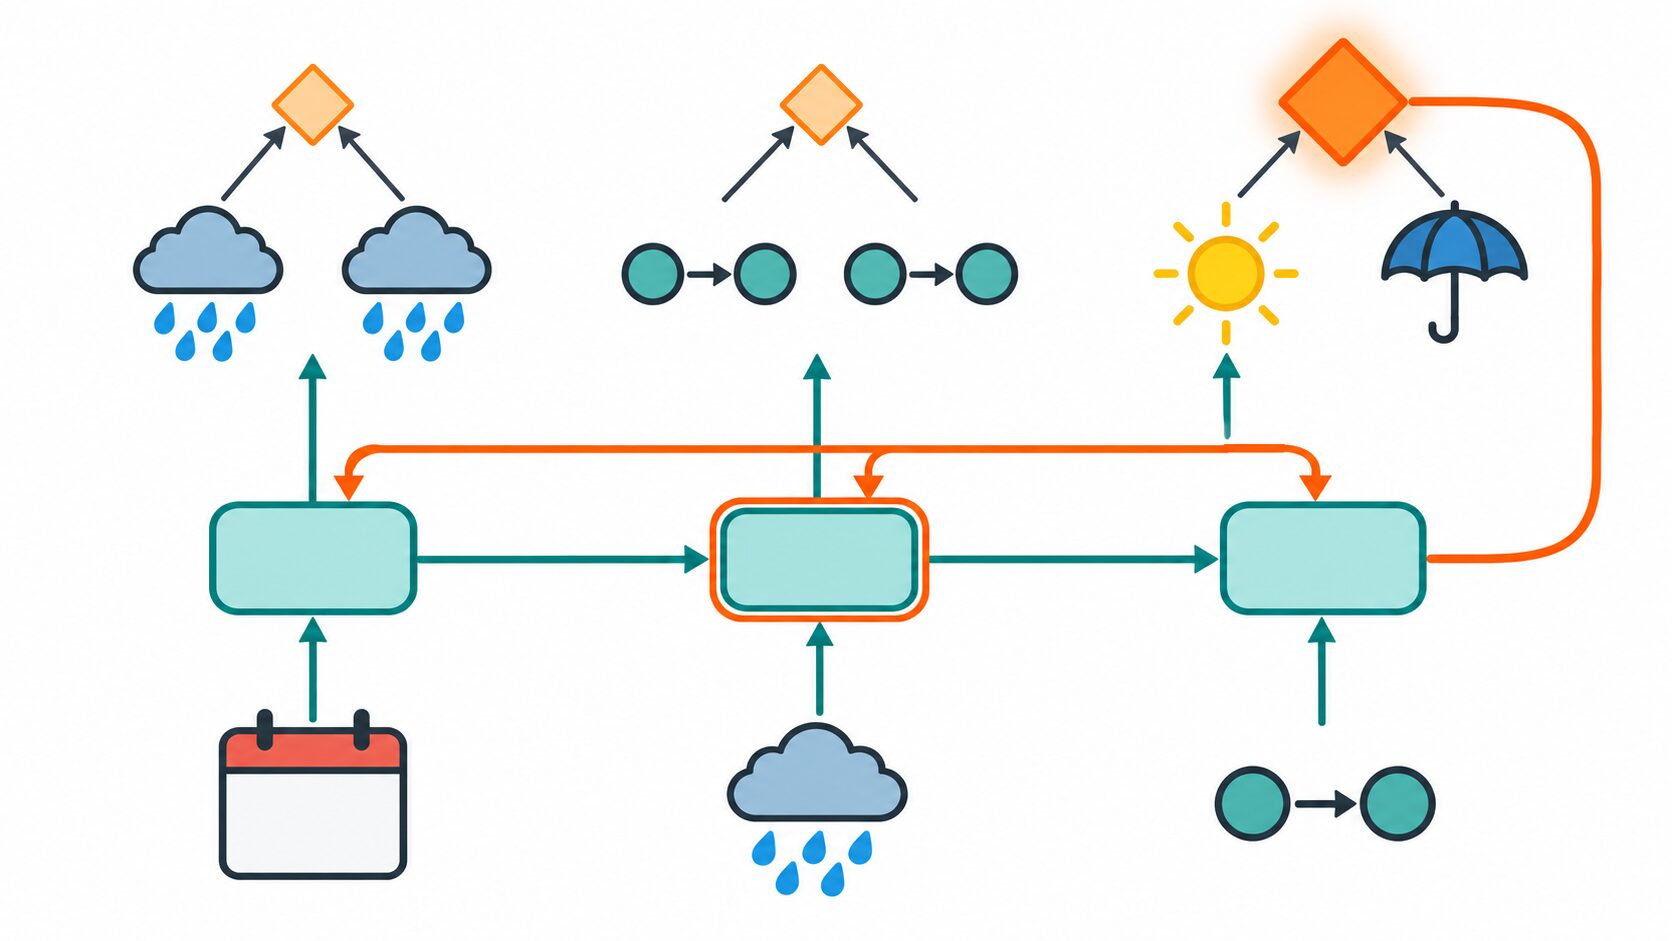
この学習で書き換えるのはモデルの重みです。過去に入力した「雨」という単語自体を変更したり、一度出した予測を過去に戻って取り消したりするわけではありません。また、一つの例から規則が確定するのではなく、多くの系列で重みを更新することで、単語のつながりを学んでいきます。
学習時に後の時刻の損失を利用することと、予測時に未来の入力を読むことは別です。ここで扱う一方向のRNNは、学習後には入力を順に受け取り、隠れ状態を更新しながら予測できます。「なので」を読んだ時点で「傘」を予測するために、まだ入力されていない正解の「傘」を見る必要はありません。逆伝播は重みを学ぶための処理であり、通常の推論では行いません。
長期依存性を難しくする勾配消失と勾配爆発
長期依存性とは、離れた位置にある情報同士の関係です。たとえば、文章の冒頭に「今日は雨だ」とあり、その後に予定の説明が長く続いたあとで「出かける前に傘を持った」と続く場合、「傘」の予測には遠くにある雨の情報が役立ちます。間に多くの単語が入っても、その手がかりを保ち、学習できるかが課題になります。
逆伝播では、隠れ状態をつなぐ重み行列や活性化関数の微分が繰り返し掛け合わされます。大きさの変化だけを単純化すると、毎回半分になる場合は \(0.5^{10} \approx 0.00098\)、毎回2倍になる場合は \(2^{10}=1024\) です。実際のRNNでは行列を含む計算なので、この例の数値で決まるわけではありませんが、繰り返しによって影響が急速に変わることが分かります。
勾配消失は、遠くへ伝わる勾配が非常に小さくなり、離れた時刻の関係を学ぶ信号が弱くなる現象です。予測が外れて損失が大きくても、その原因に関わる過去の計算へ十分な勾配が届かなければ、重みを効果的に調整しにくくなります。「誤差が小さくなったから学習が成功した」という意味ではありません。
反対に、勾配爆発は勾配が過度に大きくなる現象です。大きすぎる勾配をそのまま更新に使うと、重みが急激に動いて損失が跳ね上がったり、数値が計算可能な範囲を超えたりすることがあります。学習中の損失の変化に加えて、勾配の大きさも確認すると、こうした不安定さを調べる手がかりになります。
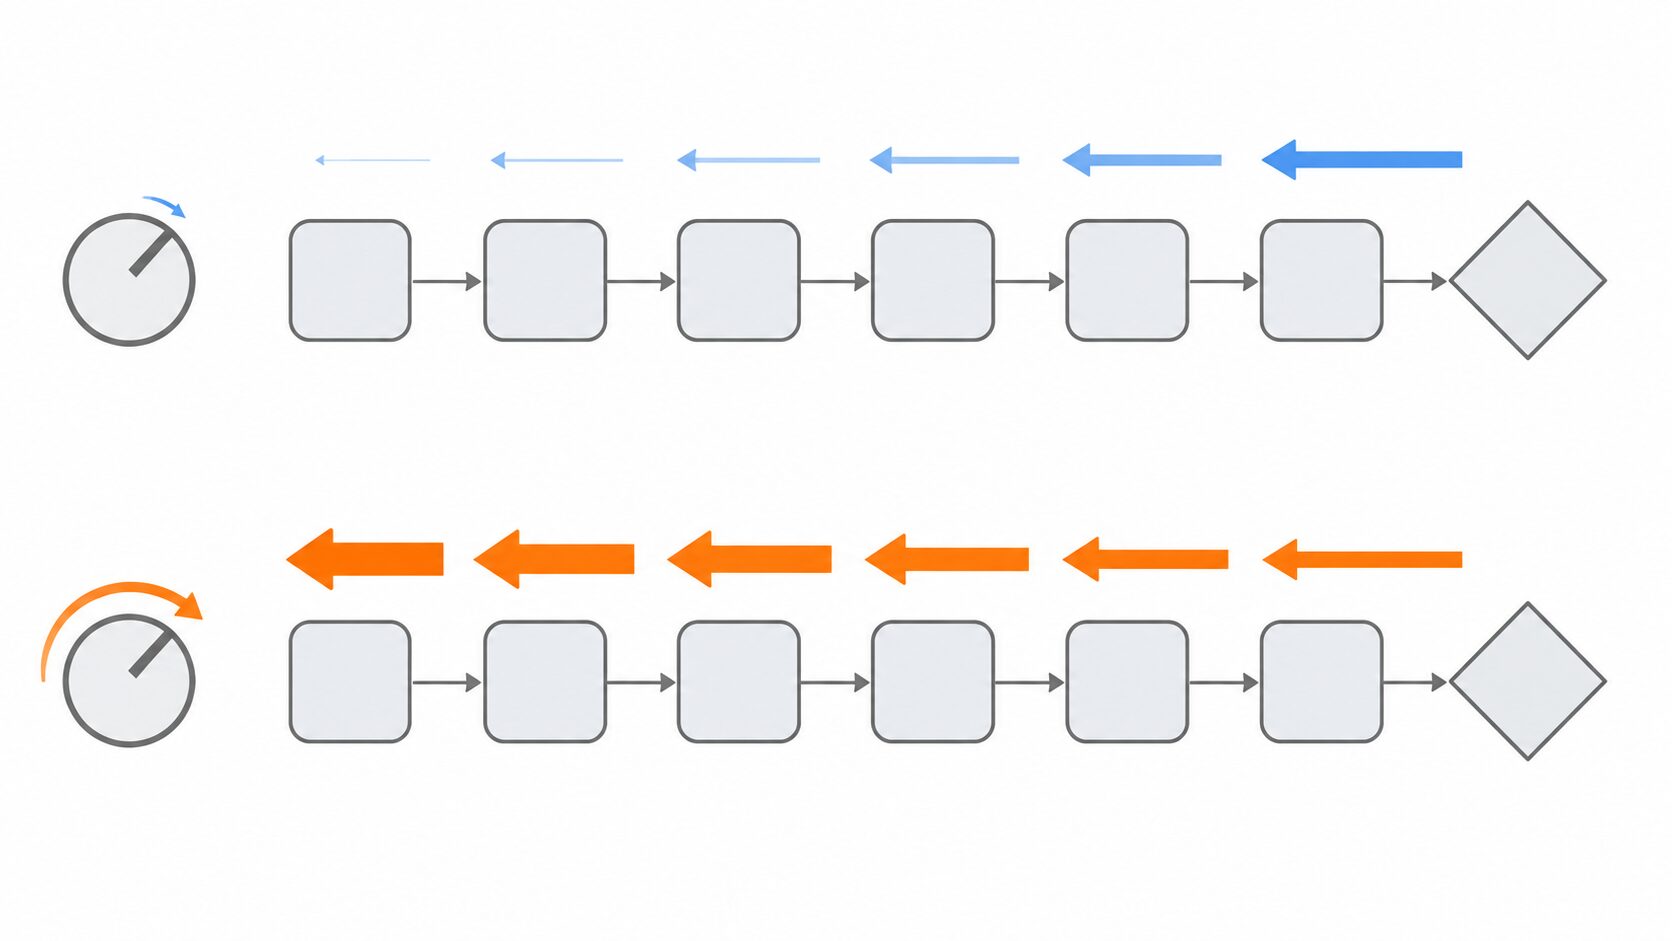
勾配消失と勾配爆発は、どちらも長い逆伝播経路で問題になりやすいものの、起き方は重みや活性化関数などに左右されます。すべての長い系列で同じように起こるわけではなく、対策もそれぞれ異なります。
さらに、長い系列には計算資源の問題もあります。通常のBPTTでは逆伝播に必要な隠れ状態などの中間値を保存するため、系列が長いほどメモリ使用量が増え、処理する時刻が増える分だけ計算時間もかかります。勾配の問題を緩和しても、この保存や計算の負担は別に考える必要があります。
全系列BPTTと打ち切りBPTTの違い
全系列BPTTは、学習対象として選んだ有限の系列について順伝播を終え、その系列全体を逆伝播する方法です。たとえば一つの文章を対象にするなら、その文章の損失を計算したあと、文章内の計算を遡ります。
ここで必要になるのは、今回の逆伝播に使う範囲の入力と教師信号であり、全データセットや将来の観測すべてではありません。文章を一つ、あるいは複数まとめて学習し、その後に別の文章へ進めます。終わりなく届くセンサーデータも、学習に使う区間を決めれば順次扱えます。入力の順伝播は、データが届くたびに進めることもできます。
打ち切りBPTT(truncated BPTT、TBPTT)は、逆伝播で遡る範囲を一定の長さに制限します。代表的な実装では、連続する区間を処理し、区間の終端で得た隠れ状態の値を次の区間へ渡します。その際、境界より前へ勾配が伝わる計算上のつながりを切ります。この切り離しは、実装で「detach」と呼ばれる操作に相当します。
状態の値を引き継ぐことと、勾配のつながりを保つことは別です。隠れ状態を引き継げば、前の区間の情報は次の予測にも影響し得ます。しかし、後の区間の損失から境界を越えて直接遡り、前の区間での計算に対する勾配を求めることはできません。これは、区間ごとに隠れ状態をゼロへ戻す処理とも異なります。
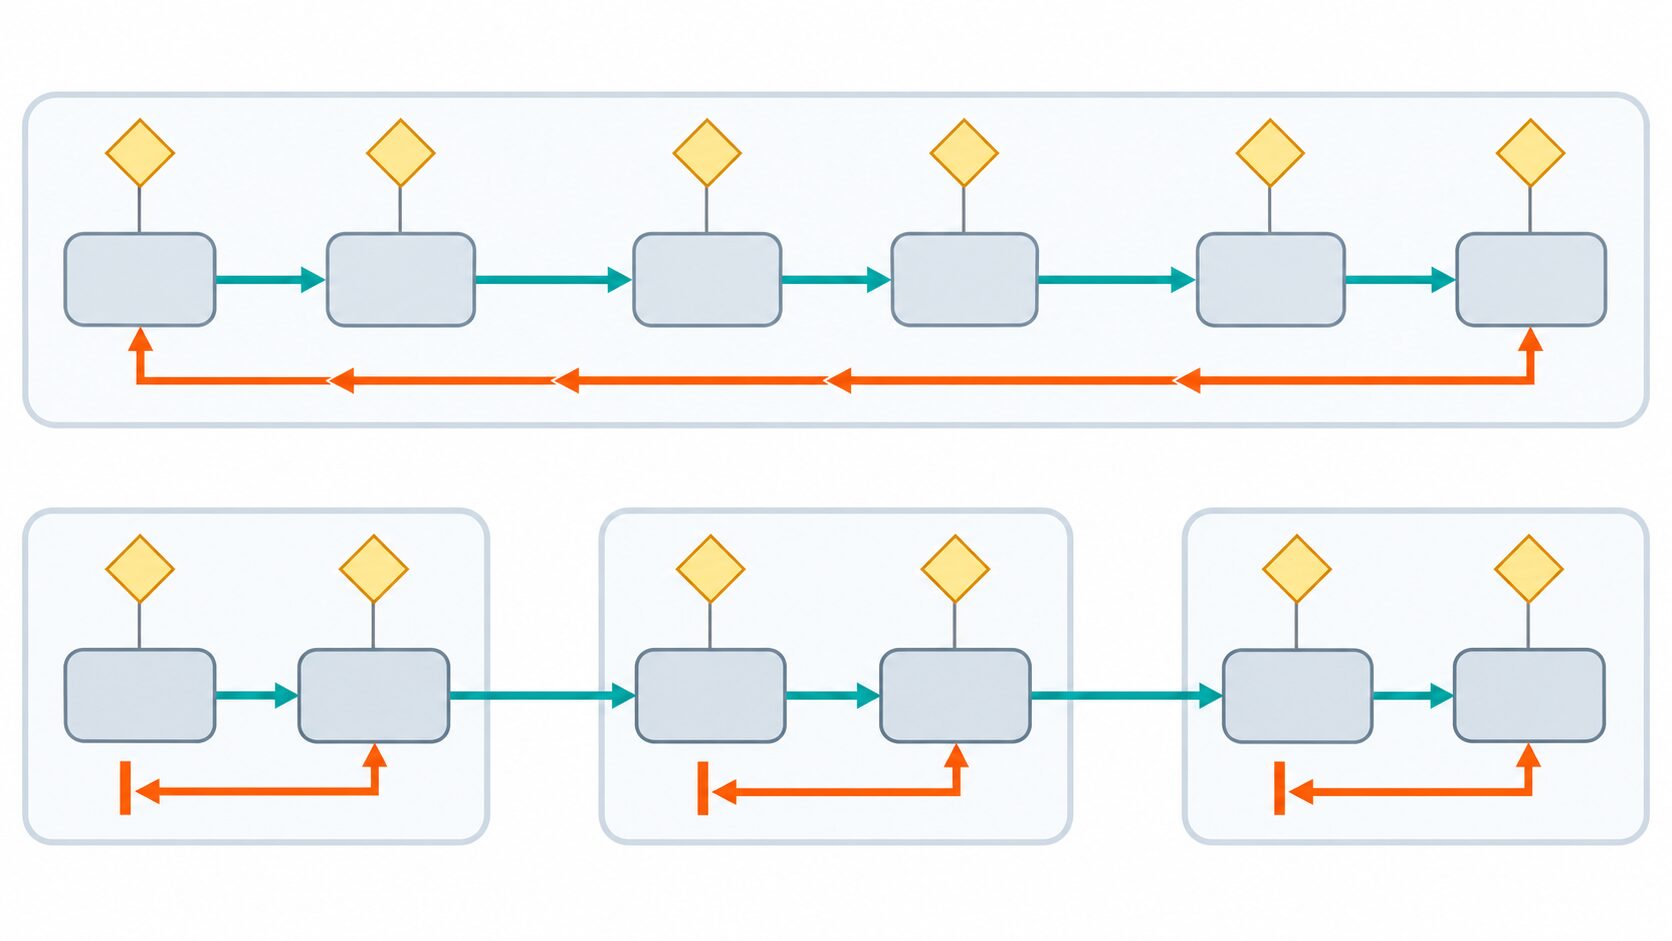
次の表は、全系列BPTTと、重なりのない区間ごとに更新する打ち切りBPTTの基本的な構成を比べたものです。
| 比較項目 | 全系列BPTT | 打ち切りBPTT |
|---|---|---|
| 逆伝播の範囲 | 対象に選んだ有限系列の全体 | 設定した区間内に制限 |
| 保存する中間状態 | 通常は系列全体の逆伝播に必要な状態 | 主に現在の区間の逆伝播に必要な状態。境界の状態の値は次へ渡せる |
| 重みの更新時点 | 対象系列の順伝播と逆伝播を終えた後 | 区間の入力と教師信号が揃い、その区間の逆伝播を終えた後 |
| 長期依存性の制約 | 系列内に勾配の経路はあるが、長いと消失・爆発が問題になる | 打ち切った境界を越える直接の勾配を計算しない |
| 計算資源への影響 | 系列が長いほど保存量と計算時間が増える | 一度に保持する計算グラフを小さくできる。総演算量の削減は構成による |
たとえば、1秒ごとに得られる機械のセンサー値を60ステップずつ区切り、次の値を予測するモデルを学習するとします。次の区間へ隠れ状態を渡しながら更新すれば、観測が続く状況でも一定の範囲ごとに学習を進められます。ただし、区間末尾の予測に対する正解は、次の観測が届いてから得られます。異常の有無を後日の点検で確定する課題なら、教師信号が得られるまでさらに待つ必要があります。
区間を短くすると一度の保存量を抑えやすく、この構成では更新の間隔も短くなります。一方、学びたい関係が区間をまたぐと、その関係を直接の勾配で学ぶ機会を失います。区間を長くすれば遡れる範囲は広がりますが、メモリや処理時間の負担も増えます。用途に応じて、情報がどれくらい前まで必要か、正解がいつ得られるかを踏まえて長さを決めます。
打ち切りBPTTでも、すべての入力を処理する順伝播は必要です。また、区間の重ね方や更新回数によっては追加の計算が生じます。そのため「打ち切れば総演算量が必ず減る」とは限りません。主な利点は、逆伝播の範囲と一度に保持する計算グラフを制御し、長い系列でも学習を進めやすくする点にあります。逆伝播の長さと更新間隔を別々に設定する構成もあります。
LSTM・GRUと勾配クリッピングの使い分け
BPTTの課題への対策は、何を改善するかによって分かれます。過去の情報を保持しやすい構造にする方法、勾配が大きくなりすぎるのを抑える方法、逆伝播の範囲を制限する方法は、それぞれ役割が異なります。
LSTM(Long Short-Term Memory、長短期記憶)とGRU(Gated Recurrent Unit)は、ゲートによって情報の保持や更新を制御するRNNの構造です。LSTMはセル状態と複数のゲートを使い、情報をどれだけ残すか、新たに何を取り込むかなどを調整します。GRUもゲートを使って、前の状態を残す割合と新しい情報を反映する割合を調整します。
これらは単純なRNNより情報や勾配を長く伝えやすくし、勾配消失を緩和するために用いられます。ただし、任意の長さの情報を必ず保持できるわけではありません。LSTMやGRUはBPTTを置き換える学習アルゴリズムではなく、通常はBPTTで学習するモデルの構造です。打ち切りBPTTで境界の勾配を切れば、LSTMやGRUでもその境界を越えた直接の逆伝播は行われません。
勾配クリッピングは、計算した勾配が設定した大きさを超えたときに、その大きさを制限する方法です。代表的なノルムによるクリッピングでは、勾配全体の大きさが上限を超えた場合に、方向を保ったまま縮小します。最適化手法による更新の前に適用し、勾配爆発による過大な更新を抑えるために使います。
一方、すでに小さくなった勾配を回復させたり、長期記憶の経路を作ったりする機能はありません。上限を低くしすぎると有用な更新まで弱めるため、学習率や損失の推移、クリッピングが頻繁に起きているかも合わせて確認します。
| 主な課題 | 代表的な対策 | 狙いと限界 |
|---|---|---|
| 勾配消失と長期依存性 | LSTM・GRU | 情報の保持や更新を制御し、長い依存関係を学びやすくする。勾配消失を完全に防ぐものではない |
| 勾配爆発による学習の不安定さ | 勾配クリッピング | 過度に大きな勾配を制限する。勾配消失や長期記憶の問題を直接解決するものではない |
| 長い逆伝播と中間状態の保存負荷 | 打ち切りBPTT | 一度に遡る範囲と保持する計算グラフを制限する。区間境界を越える直接の勾配は失われる |
目的が異なるため、これらの対策は併用できます。たとえば、LSTMで情報の保持を調整し、打ち切りBPTTで長い系列を区切り、必要に応じて勾配クリッピングで更新の不安定さを抑える構成が考えられます。実務では、予測に必要な過去の長さと利用できるメモリを見ながら構成を選び、学習に使っていないデータで予測性能を確かめます。
BPTTを理解する要点は、過去から現在へ進む予測の計算を、学習時に逆向きにたどって共有重みの勾配を求めることです。RNNの構造、逆伝播する範囲、重みを更新する方法を分けて考えると、学習が進まない理由や、選ぶべき対策を判断しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月3日 | 全データが必要との説明を修正し、共有重みと打ち切りBPTTの関係を追記 |