
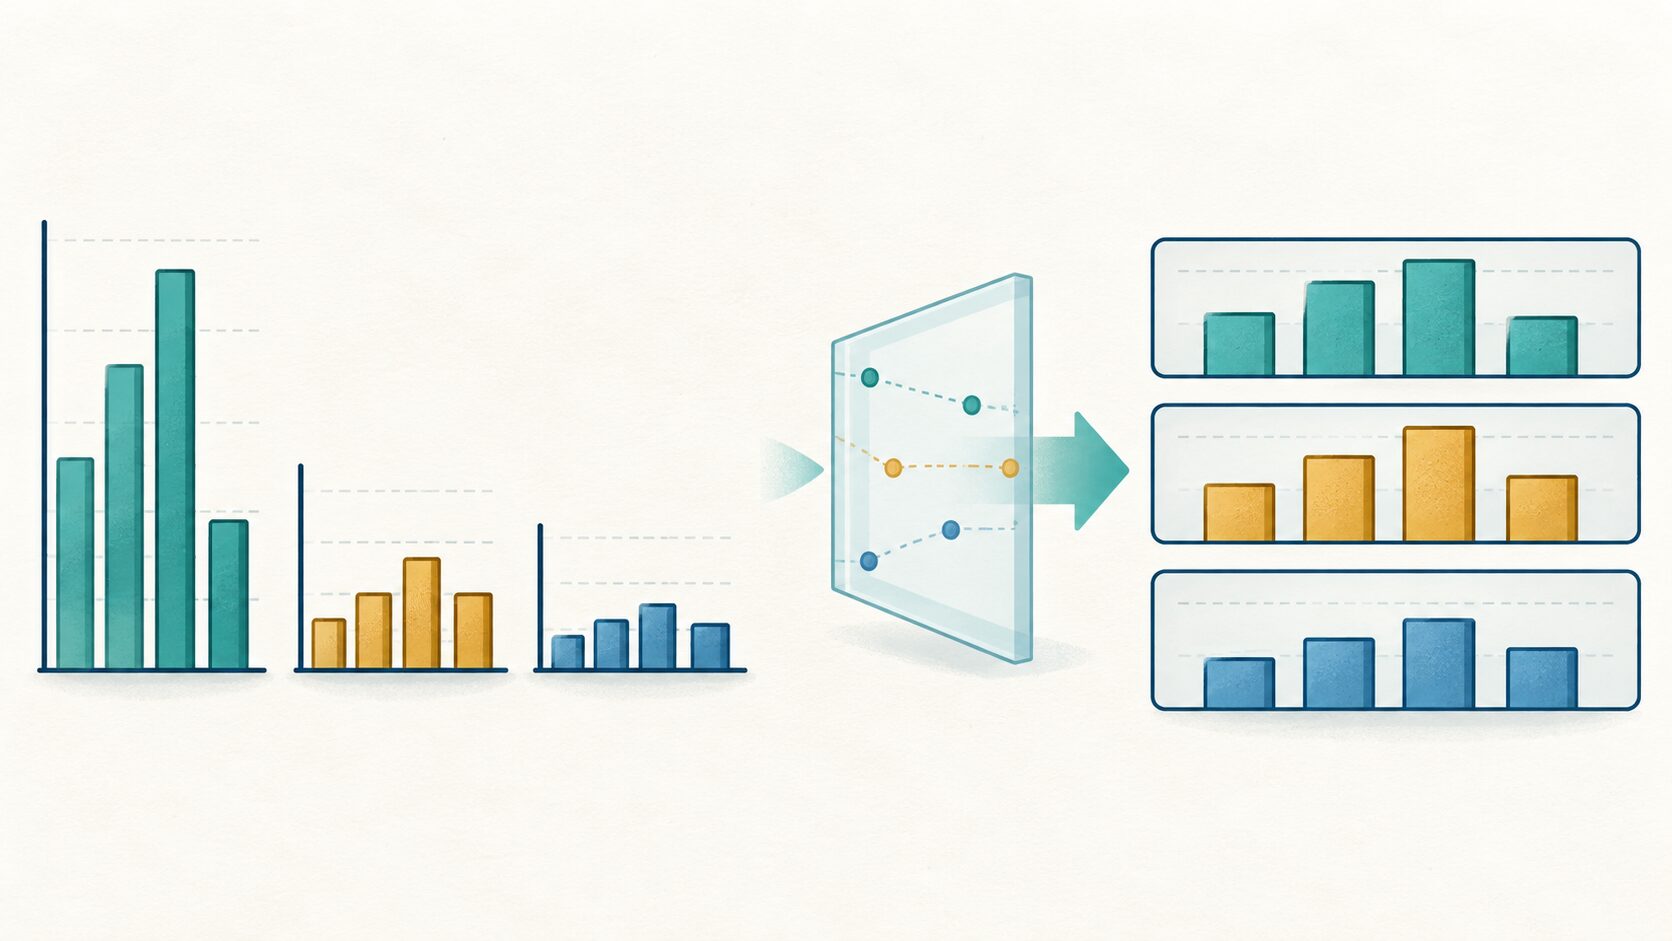
正規化とは、数値データを一定の基準で変換し、尺度をそろえる前処理です。機械学習では、データを0〜1などの範囲へ変換するMin-Max法が代表的な方法として使われます。面積と部屋数のように単位や桁が異なる項目を扱うとき、数値の大きさが計算に与える影響を調整できます。
ただし、正規化すれば必ず予測精度が上がるわけではありません。また、似た用語である「標準化」とは変換の基準が異なります。この記事では、正規化の意味と計算方法から、標準化との違い、外れ値への注意、画像や文章を扱う場面での活用まで、具体例を使って解説します。

AIの初心者
「正規化」って、どのような処理ですか?数字を小さくするだけなのでしょうか?

AI専門家
大切なのは、数値の尺度をそろえることです。例えば、100点満点の80点と50点満点の30点は、満点で割ると0.8と0.6になります。満点に対してどれだけ取れたかを、共通の基準で見られますね。
AIの初心者
なるほど。では、必ず0から1の範囲に変換するのですか?
AI専門家
0〜1はよく使われますが、−1〜1など別の範囲にすることもあります。ここでは、最小値と最大値を使うMin-Max法を中心に学びましょう。平均と標準偏差を使う標準化との違いも押さえると、目的に合う方法を選びやすくなります。
正規化とは?データの尺度をそろえる前処理
正規化は、データを扱いやすい基準に変換する操作の総称です。数値データの前処理では、値の大きさや範囲を調整する「スケーリング」を指すことが多くあります。この記事では、最小値を0、最大値を1にするMin-Max法を「正規化」、平均を0、標準偏差を1にする方法を「標準化」として区別します。文献によっては、標準化も広い意味で正規化に含めるため、用語だけでなく計算方法を確認することが大切です。
身近な例は、満点の異なるテストの得点を比べる場面です。国語が100点満点で80点、数学が50点満点で30点なら、それぞれ満点で割ると0.8と0.6になります。これは、最低点を0、最高点を各試験の満点と定めて変換した例です。得点率としては80%と60%ですが、問題の難易度までそろうわけではないため、学力の優劣をこの値だけで判断することはできません。
ここで区別したいのが、「取り得る範囲」と「実際に観測した範囲」です。100点満点の試験でも、受験者の得点が60〜90点なら、観測した最小値・最大値を使うMin-Max法では60点が0、90点が1になります。満点で割る方法とは結果も意味も異なります。何を基準に変換した値なのかを必ず確認しましょう。
また、正規化は数値の単位や範囲をそろえる処理であり、項目の意味を同じにするものではありません。会社ごとの売上と従業員数をそれぞれ正規化すれば、各項目の観測範囲内での位置は見やすくなります。ただし、売上の0.8と人数の0.6を比べて「売上のほうが大きい」とは判断できません。従業員当たりの売上を知りたいなら、売上を人数で割るなど、目的に合う指標を作る必要があります。
正規化の計算方法:Min-Max法を手計算する
\(x’ = \frac{x – x_{\min}}{x_{\max} – x_{\min}}\)Min-Max法は、元の値から最小値を引き、最大値と最小値の差で割ります。式の\(x\)は元の値、\(x’\)は変換後の値、\(x_{\min}\)と\(x_{\max}\)は基準となるデータの最小値と最大値です。最小値と最大値が異なる場合に、この式をそのまま使えます。
- 変換する項目の最小値と最大値を調べる。面積なら面積の列だけを使い、部屋数など別の項目と混ぜないようにします。
- 各値から最小値を引く。これによって、基準データの最小値が0になります。
- 最大値と最小値の差で割る。基準データの範囲が0〜1になります。
10、20、30、40の4つの値なら、最小値は10、最大値は40、両者の差は30です。各値に同じ計算を適用すると、次の結果になります。
| 元の値 | 計算 | 正規化後 |
|---|---|---|
| 10 | \((10-10)/(40-10)\) | 0 |
| 20 | \((20-10)/(40-10)\) | 約0.333 |
| 30 | \((30-10)/(40-10)\) | 約0.667 |
| 40 | \((40-10)/(40-10)\) | 1 |
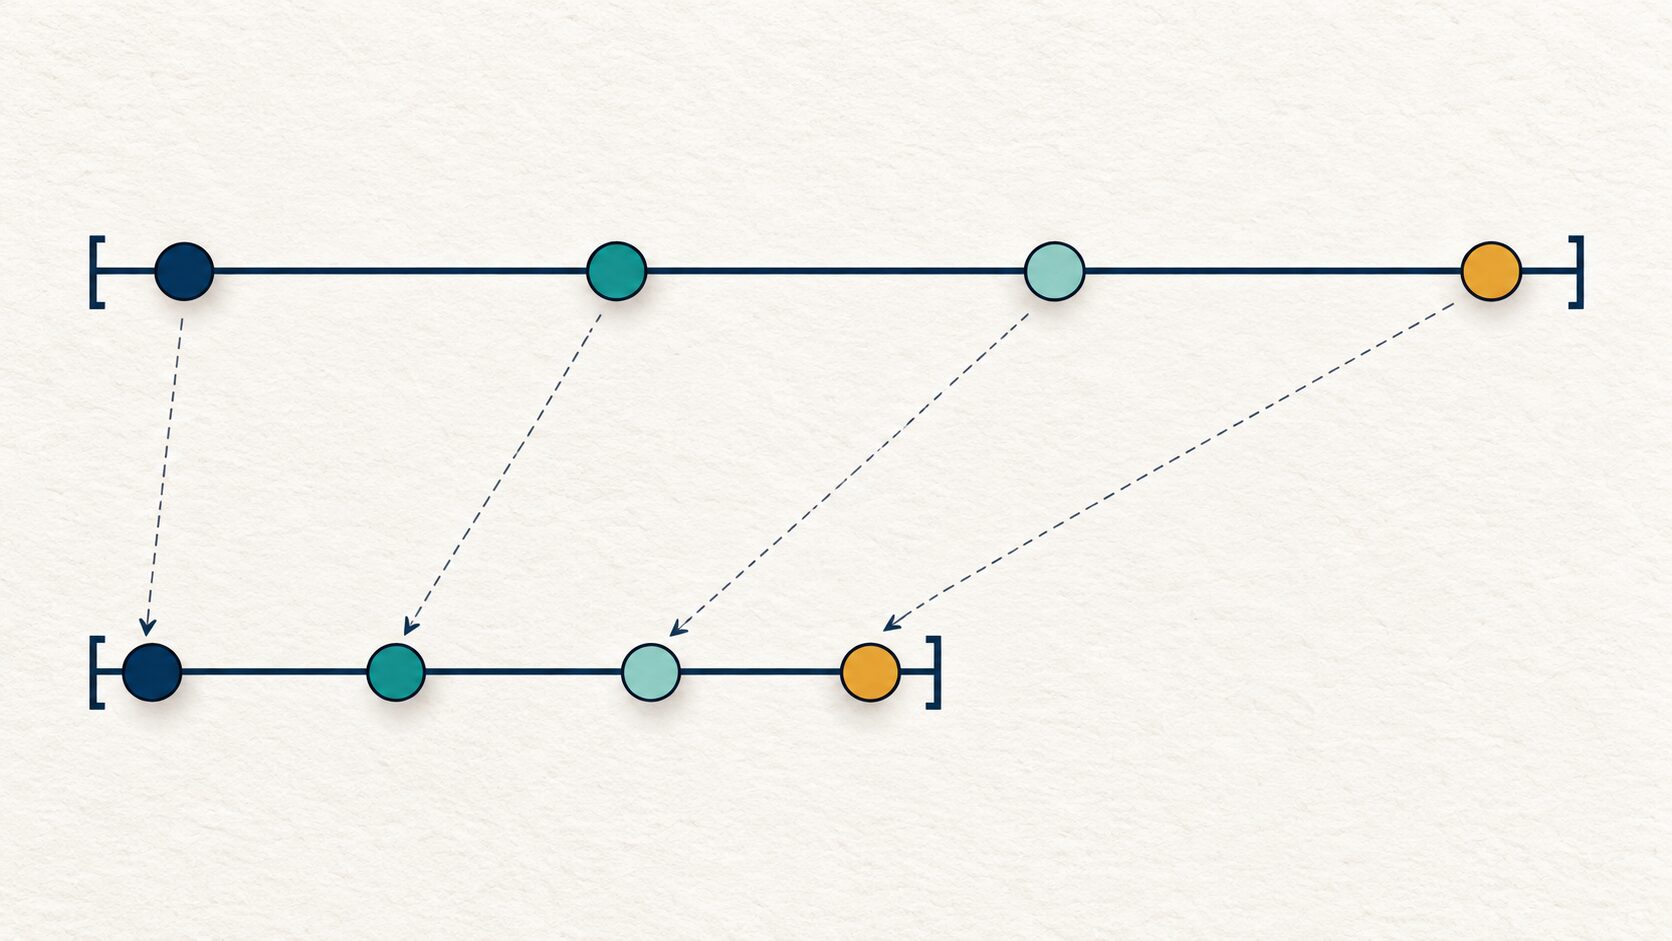
元の値の順序は変わらず、等間隔の値は変換後も等間隔です。値が負であっても、最小値を引いてから割るので同じ式が使えます。例えば、−10、0、10は0、0.5、1になります。正規化のために、事前にすべての値を正に直す必要はありません。
0〜1以外の範囲にしたい場合は、下限を\(a\)、上限を\(b\)として、次の式を使います。ただし、\(a < b\)とします。
\(x’ = a + (b-a)\frac{x-x_{\min}}{x_{\max}-x_{\min}}\)例えば、0〜1へ変換した値を2倍して1を引くと、−1〜1の範囲になります。0〜1がよく使われるのは範囲が把握しやすいためであり、どの範囲が適切かはモデルや入力の仕様によって決まります。
正規化のメリットと効果が出やすいモデル
正規化の主なメリットは、単位や桁の違いが計算結果に与える影響を調整できることです。例えば、住宅価格を予測するために面積と部屋数を使うとします。面積の差が50、部屋数の差が2なら、数値をそのまま距離の計算に使うと、面積の差が大きく影響しやすくなります。面積を平方メートルから別の単位に変えただけで、計算上の重みが変わる可能性もあります。
このような影響は、データ同士の距離を使うk近傍法やk-meansで特に意識する必要があります。各特徴量、つまりモデルに入力する項目の尺度をそろえると、単に数値が大きい項目が距離を支配する状況を抑えられます。ただし、そろえた後の各項目をどの程度重視するかは、分析目的に照らして考える必要があります。
勾配を使ってパラメータを更新するモデルでも、尺度の違いが大きいと、項目ごとに適した更新の大きさが異なり、学習が進みにくくなることがあります。正規化や標準化は、学習を安定させる助けになります。また、係数の大きさにペナルティを課す正則化を使うモデルでは、入力の尺度が係数の大きさに関わるため、スケーリングの選択が結果に影響します。
一方、決定木やそれを組み合わせたモデルは、主に値の大小関係による分岐を使います。そのため、通常の数値特徴量では、正規化の必要性は距離を使うモデルほど高くありません。すべてのモデルに一律に正規化を適用するのではなく、モデルの仕組みと検証結果で判断することが大切です。
正規化は、すべての特徴量を同じ重要度にする処理でも、データの情報を増やす処理でもありません。予測に役立つ特徴量かどうか、欠損や測定ミスがないかといった問題は、別に確認する必要があります。
正規化と標準化の違い:目的別の選び方
\(z = \frac{x-\mu}{\sigma}\)標準化では、元の値\(x\)から平均\(\mu\)を引き、標準偏差\(\sigma\)で割ります。\(z\)は変換後の値です。標準偏差が0でない場合、基準データの平均が0、標準偏差が1になるよう調整します。平均より低い値は負、高い値は正になり、平均から標準偏差の何倍離れているかを表せます。
Min-Max法が「最小値から最大値までのどこにあるか」を表すのに対し、標準化は「平均からどの程度離れているか」を表します。比較する基準の違いを押さえると、使い分けを理解しやすくなります。
| 比較項目 | 正規化(Min-Max法) | 標準化 |
|---|---|---|
| 計算の基準 | 最小値と最大値 | 平均と標準偏差 |
| 変換後の特徴 | 基準データが0〜1などの指定範囲に収まる | 基準データの平均が0、標準偏差が1になる |
| 値の範囲 | 基準範囲内の値は指定範囲内。新しい値は範囲外になる場合がある | 上下限は固定されず、負の値も取る |
| 外れ値への影響 | 極端な最小値・最大値で、多くの値が狭い範囲に集まりやすい | 平均と標準偏差が外れ値の影響を受ける |
| 検討しやすい目的 | 入力範囲をそろえたい、既知の上下限を基準にしたい | 平均とばらつきを基準に尺度をそろえたい |
| 分布の形 | 軸の平行移動・伸縮であり、歪みそのものは解消しない | 軸の平行移動・伸縮であり、正規分布に変える操作ではない |
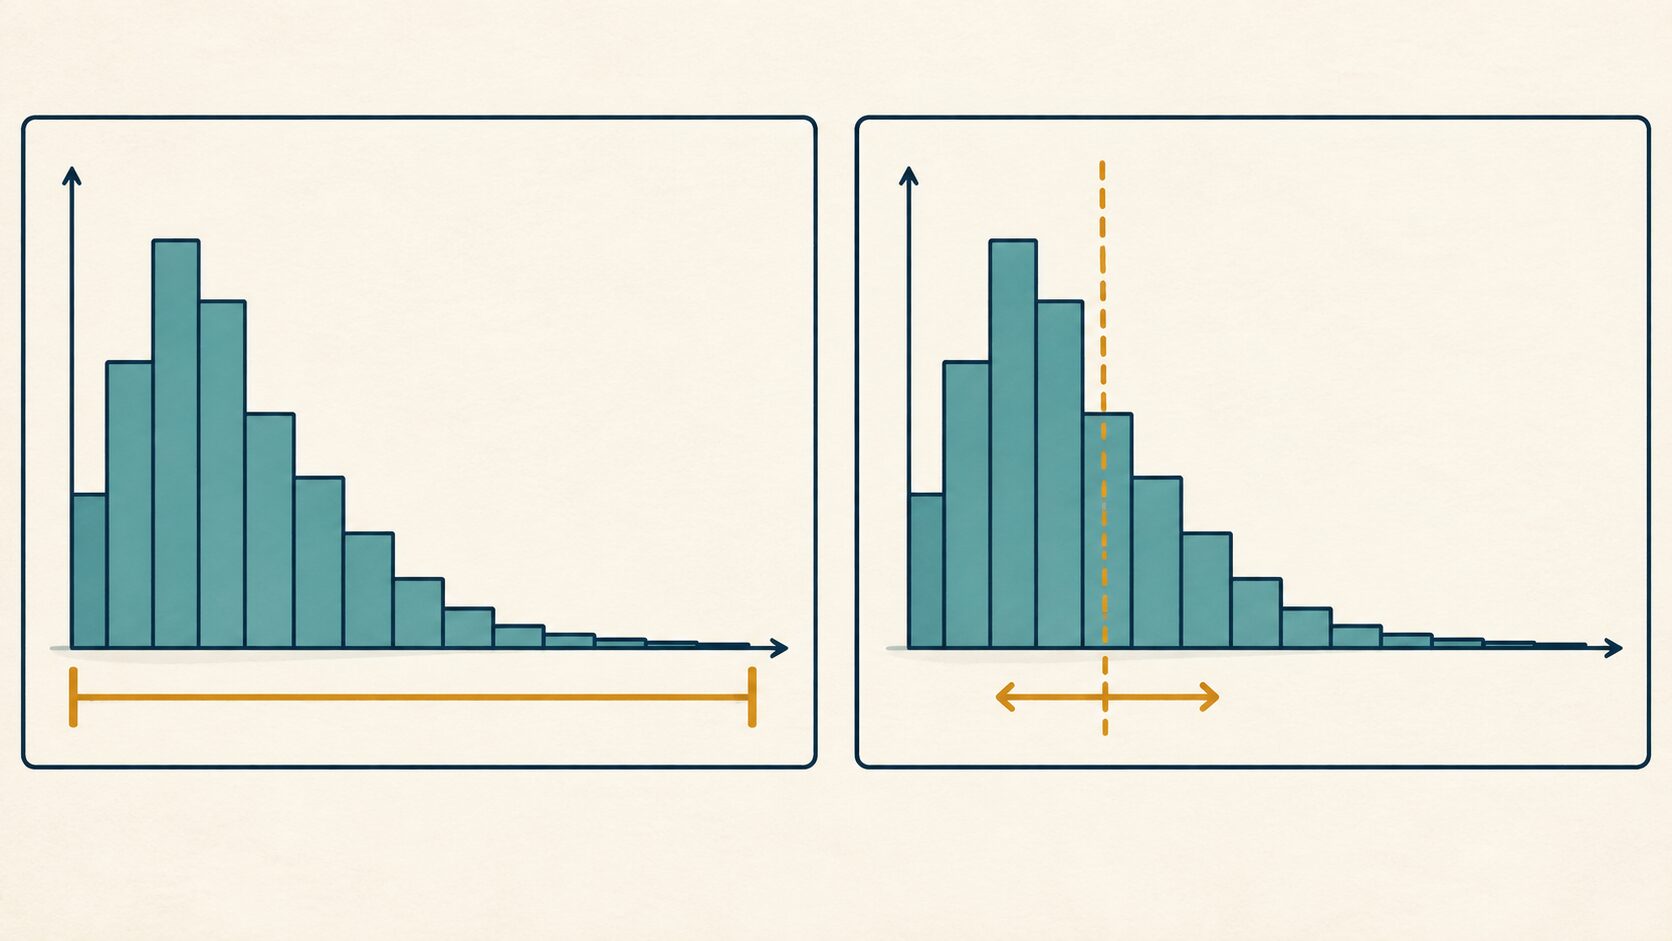
標準化しても、データが正規分布になるわけではありません。例えば、片側に長い裾を持つ分布は、標準化した後もその特徴を保ちます。Min-Max法と標準化はいずれも、同じ項目の値を一定のルールで平行移動・伸縮する操作です。外れ値を通常の値に置き換える処理ではありません。
また、「外れ値があれば標準化を選べばよい」ともいえません。平均と標準偏差も極端な値で変わるためです。入力範囲を指定する必要があるならMin-Max法を、平均とばらつきをそろえることが目的なら標準化を候補にし、外れ値が強い場合は別の方法も検討します。モデルの前提やデータの分布を確認し、同じ検証条件で比較しましょう。
正規化の欠点:外れ値で多くの値が狭い範囲に集まる
\(\frac{40-10}{1000-10} \approx 0.0303\)Min-Max法の注意点は、極端な値が最小値や最大値になると、それ以外の値が変換後の狭い範囲に集まりやすいことです。例えば、先ほどの10、20、30、40だけなら、40は1になります。ところが、同じ項目に1000が加わると最大値が1000になり、40は約0.0303に変わります。
| 元の値 | 10〜40を基準に変換 | 1000を加え、10〜1000を基準に変換 |
|---|---|---|
| 10 | 0 | 0 |
| 20 | 約0.333 | 約0.0101 |
| 30 | 約0.667 | 約0.0202 |
| 40 | 1 | 約0.0303 |
| 1000 | 基準データに含まない | 1 |
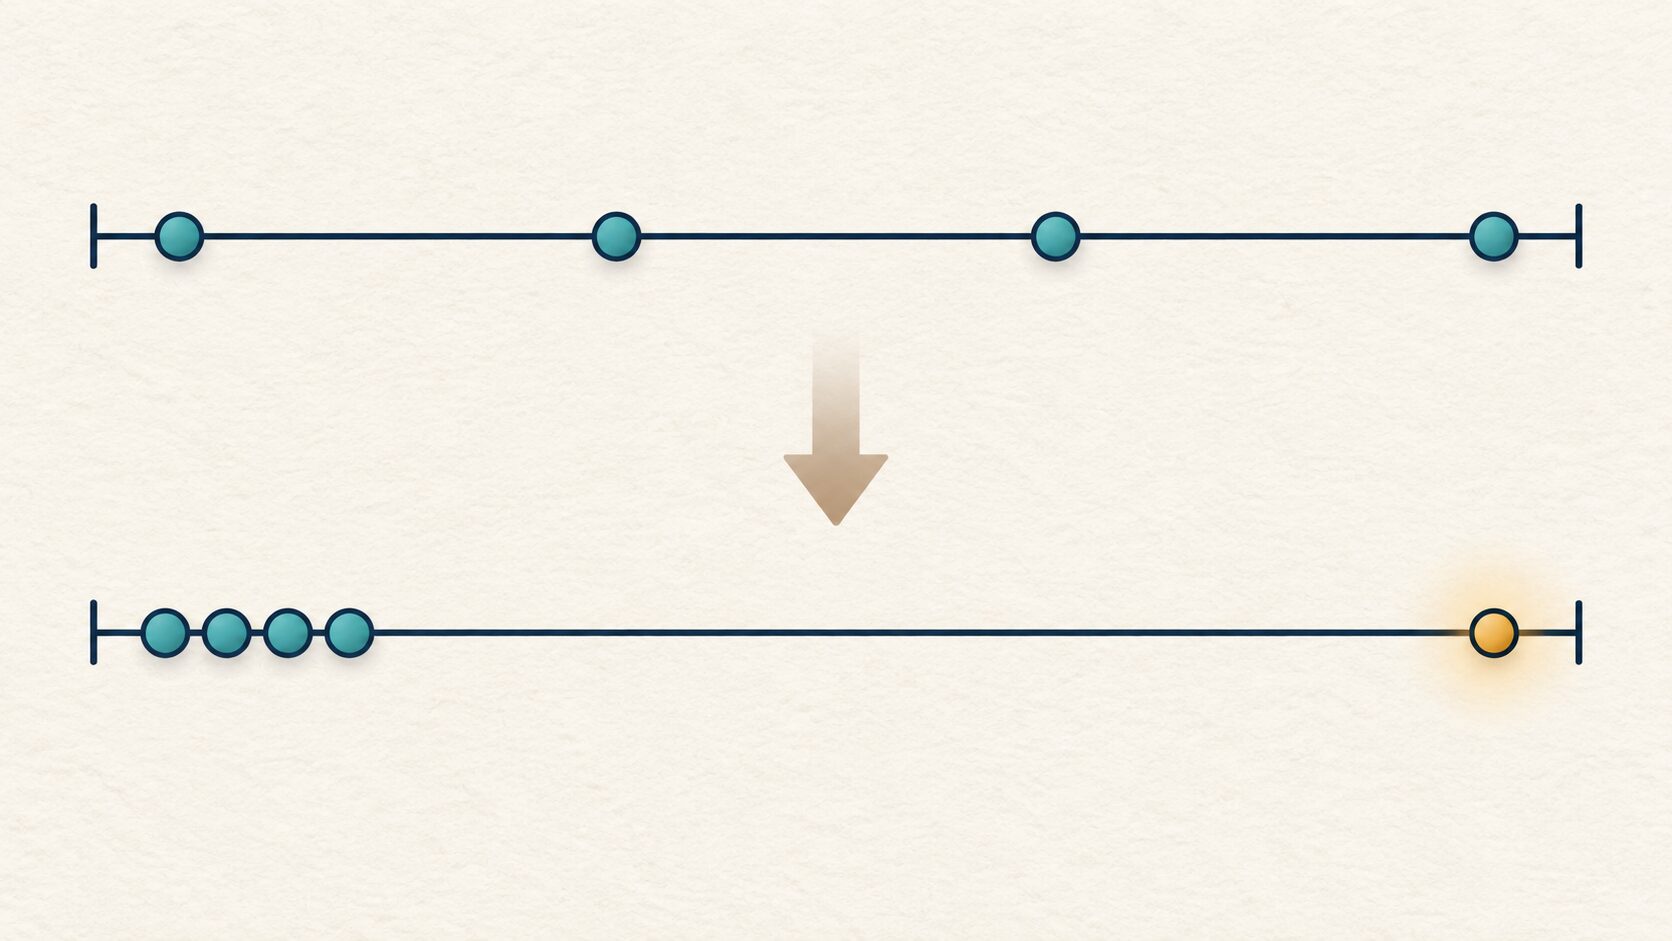
この場合、10〜40の4つの値は0〜約0.03に集中します。順序や相対的な間隔の関係が壊れたわけではありませんが、共通の0〜1の軸では細かな違いが見えにくくなり、複数の特徴量を使う距離の計算などにも影響します。図は仕組みを示す概念図であり、正確な変換値は表のとおりです。
対処の第一歩は、極端な値が入力ミスなのか、実際に起こり得る重要な観測なのかを調べることです。大きいという理由だけで削除すると、予測したい珍しい事例を失う可能性があります。例えば、得点が60〜90点の集団に100点の人がいたとしても、最高点だから直ちに外れ値とは判断できません。値が生じた背景と、ほかの値からの離れ方を合わせて確認します。
外れ値の影響を抑えたい場合は、中央値と四分位範囲を使うロバストなスケーリングが候補になります。四分位範囲は、データの中央50%が入る区間の幅です。これらの基準は平均・標準偏差や最小値・最大値に比べ、少数の極端な値の影響を受けにくい性質があります。ただし、変換後に外れ値自体が消えるわけではありません。
データの性質に応じて対数変換や上限・下限で値を抑えるクリッピングを検討する場合もあります。対数変換は通常、正の値など適用条件の確認が必要です。クリッピングは範囲外の値の差を失うため、目的と情報の損失を考えたうえで採用しましょう。
正規化の活用例:画像・住宅価格予測・自然言語処理
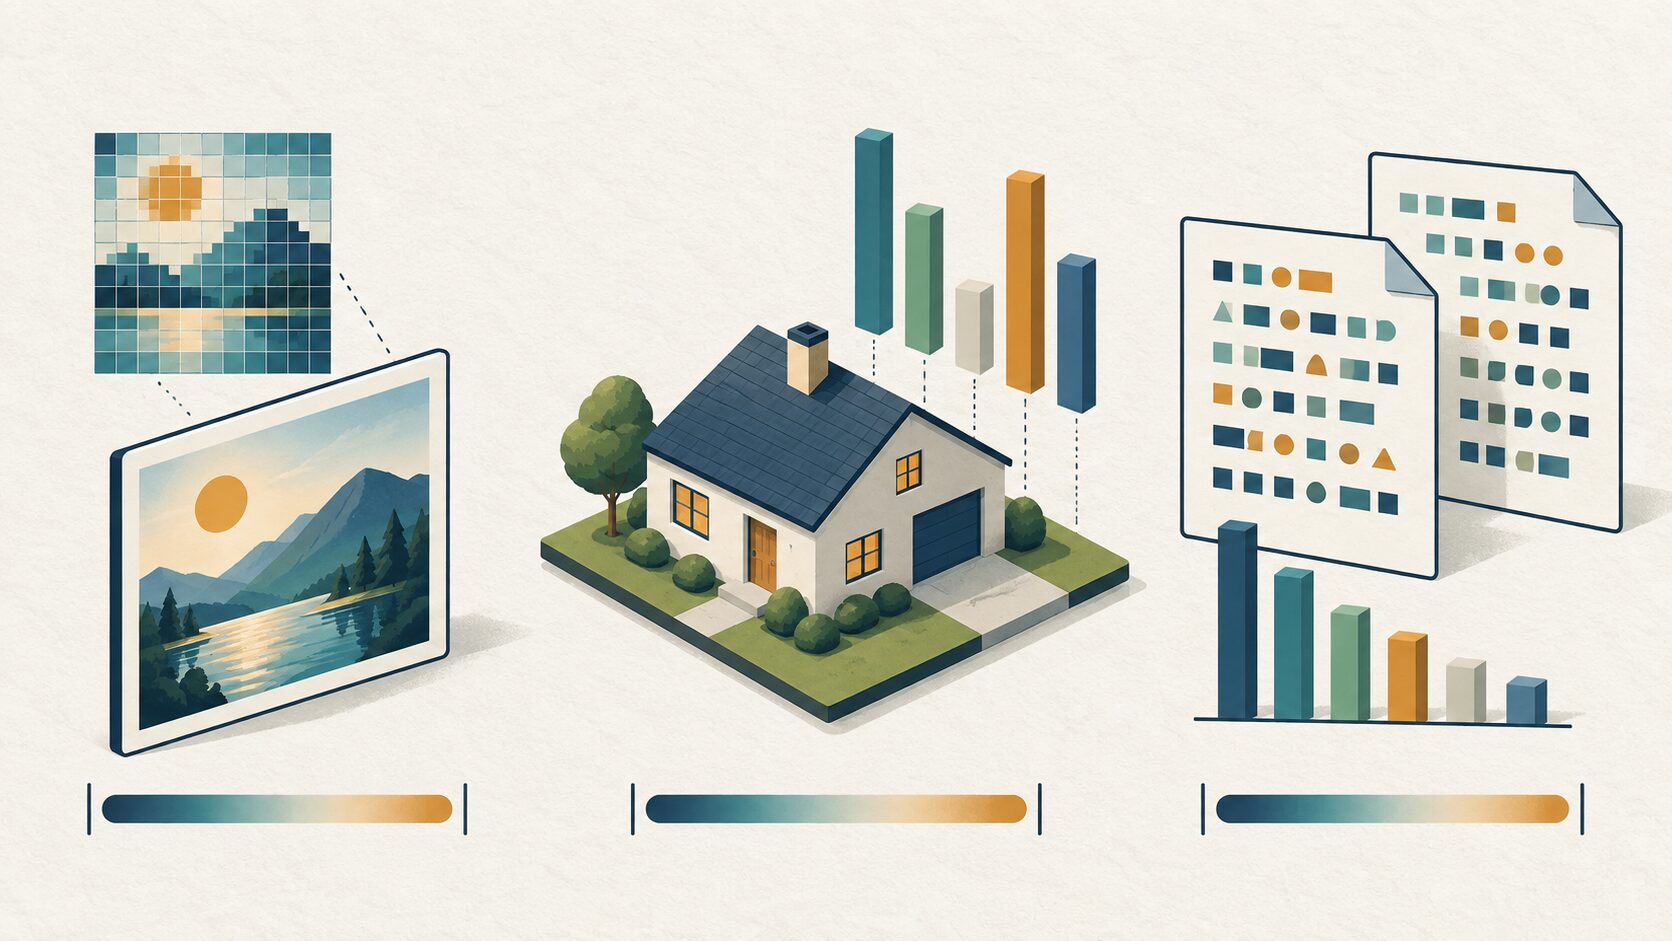
正規化はさまざまな分野で使われますが、何を基準に何を調整するかは用途ごとに異なります。元のデータの意味と、モデルへ渡す値の意味を分けて考えると、変換の目的が明確になります。
画像処理では、画素値の尺度をそろえます。8ビット画像の画素値は0〜255で表されるため、各値を255で割ると0〜1へ変換できます。この処理は、各画像の実際の最小値と最大値を求める方法とは異なり、既知の範囲を使う変換です。単に255で割っても、明るい画像と暗い画像の違いや、撮影条件によるコントラストの差までなくなるわけではありません。
画像ごとの最小値・最大値で変換すると、画像間の明るさの関係が変わることもあります。照明差を補正したい場合は、そのための処理を別に検討します。また、学習済みの画像モデルを使うときは、そのモデルが想定する前処理に合わせる必要があります。
住宅価格予測では、項目ごとに異なる単位や桁を調整します。面積、築年数、駅からの距離、部屋数をそのまま使うと、距離や勾配を使うモデルでは数値の尺度が影響することがあります。面積は面積の基準、築年数は築年数の基準で変換します。これによって尺度の影響を調整できますが、立地や築年数の重要度が同じになるわけではなく、精度が上がるかどうかは検証が必要です。
自然言語処理では、文章の長さによる単語数の差を補正します。同じ単語が、100語の文章に5回、1000語の文章に50回出てきた場合、回数は異なっても全体に占める割合はどちらも0.05です。このように単語の出現回数を総語数で割ると、文章の長さを考慮した相対頻度を求められます。これは、最小値と最大値を使うMin-Max法とは別の正規化です。
ただし、相対頻度だけでは、多くの文章に現れる一般的な単語の重要度を下げることはできません。文章集合の中での単語の珍しさも考慮するTF-IDFとは、目的を区別して理解しましょう。文章を表すベクトルの長さをそろえる正規化が、さらに使われる場合もあります。
実務で失敗しない正規化の手順と注意点
機械学習で正規化を使うときは、式を適用する順序が重要です。データから最小値・最大値などを求める場合は、学習データだけで基準を決め、検証・テスト・予測時にも同じ基準を使います。未知のデータを評価する前に、そのデータの情報を基準作りへ混ぜないようにするためです。
- 各項目の単位、分布、欠損値、極端な値を確認し、どの列を変換するか決めます。識別番号のように数値の大小に意味がない列は、数値だからという理由で正規化しません。
- 学習用・検証用・テスト用にデータを分けます。時系列データなら、将来の情報が過去の学習に混ざらないよう、時間の順序を考慮します。
- 学習データの各列から最小値・最大値を求めて保存し、学習データを変換します。標準化なら平均と標準偏差を保存します。
- 保存した基準で検証・テストデータを変換し、モデルの性能を評価します。比較する手法には同じ分割と評価指標を使います。
- 実際に予測するときも、学習したモデルと対応する変換基準をセットで使います。モデルを更新する場合は、前処理との組み合わせも管理します。
分割前の全データで最小値・最大値を求めると、評価対象の情報が学習側へ入り込む「データ漏洩」につながります。検証データ側で別に基準を作る方法も、同じ元の値が異なる値へ変換されるため適切ではありません。なお、画素値の0〜255のように、観測データに依存しない既知の範囲を使う変換とは区別します。
交差検証で複数の分割を試す場合も、各回の学習部分だけで変換基準を求めます。前処理とモデルを一連の処理として管理するパイプラインを使うと、基準の使い回しによる漏洩や、予測時の変換漏れを防ぎやすくなります。
| 注意点 | 起こること・対応 |
|---|---|
| 新しい値が学習時の範囲を超える | 学習時の最小値が10、最大値が40なら、新しい値50は約1.333になる。0〜1の外に出ること自体は計算ミスではない。 |
| すべて同じ値の列がある | 最小値と最大値の差が0になり、通常の式では割れない。列を除くか一定値へ変換するかなど、意味と利用する実装の仕様を確認する。 |
| 欠損値がある | 正規化だけで欠損は埋まらない。補完方法と処理順を決め、平均などの補完基準も学習データだけで求める。 |
| 値を0〜1に切り詰めたい | クリッピングすると範囲外の値が同じ端点に集まり、差が失われる。モデルの入力条件と情報損失を確認する。 |
新しい値がたびたび学習時の範囲を超える場合は、運用中のデータの性質が変わっていないかも確認します。目先の値を0〜1に収めるためだけに、その都度最小値・最大値を更新すると、学習時との対応が崩れてしまいます。
正則化・ベクトルの正規化・データベースの正規化との違い
「正規化」という語は分野によって意味が異なり、名前が似た「正則化」もあります。混同を避けるには、何を変換し、何のために行う処理かを確認しましょう。
| 用語 | 主な対象と目的 |
|---|---|
| 数値特徴量の正規化 | 面積や年数などの列ごとに、値の範囲や尺度を調整する。この記事で中心に扱うMin-Max法はこの例。 |
| ベクトルの正規化 | 1件のデータを表すベクトル全体の長さなどを基準に変換する。L2正規化では通常、ゼロでないベクトルの長さを1にそろえる。 |
| 正則化 | モデルの係数などに制約やペナルティを加え、過学習を抑える。入力値を0〜1にする処理ではない。 |
| データベースの正規化 | テーブルの構造を整理し、重複や更新時の不整合を減らす。数値のスケーリングとは目的が異なる。 |
特に、特徴量ごとのMin-Max法と、1件のデータ全体に行うベクトルの正規化は、変換する方向が異なります。表形式のデータなら、列を基準にするのか、各行を基準にするのかを意識すると理解しやすくなります。また、正規化と正則化は目的が異なるため、同じ機械学習の処理の中で両方を使うこともあります。
まとめ
数値データの正規化は、異なる単位や桁を持つ値の尺度をそろえる前処理です。代表的なMin-Max法では、最小値を引いて値の範囲で割ることで、基準データを0〜1へ変換します。標準化は平均と標準偏差を基準にする方法であり、正規分布に変える処理ではありません。
使い分けでは、入力に必要な範囲、モデルの仕組み、外れ値の有無を確認します。実務では、学習データで決めた基準を検証時や予測時にも使うことが基本です。「何を基準に、何のために尺度をそろえるのか」を明確にし、効果を検証することが、正規化を適切に活用する第一歩になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月26日 | 標準化と外れ値の説明を修正し、計算例と学習時の適用手順を補足 |