
Mixup(ミックスアップ)とは?画像とラベルを混ぜる仕組み・活用例を解説

AIの初心者
「Mixup」というデータ拡張の方法がよく分かりません。犬と猫の画像を混ぜたら、何の画像として学習するのでしょうか?

AI専門家
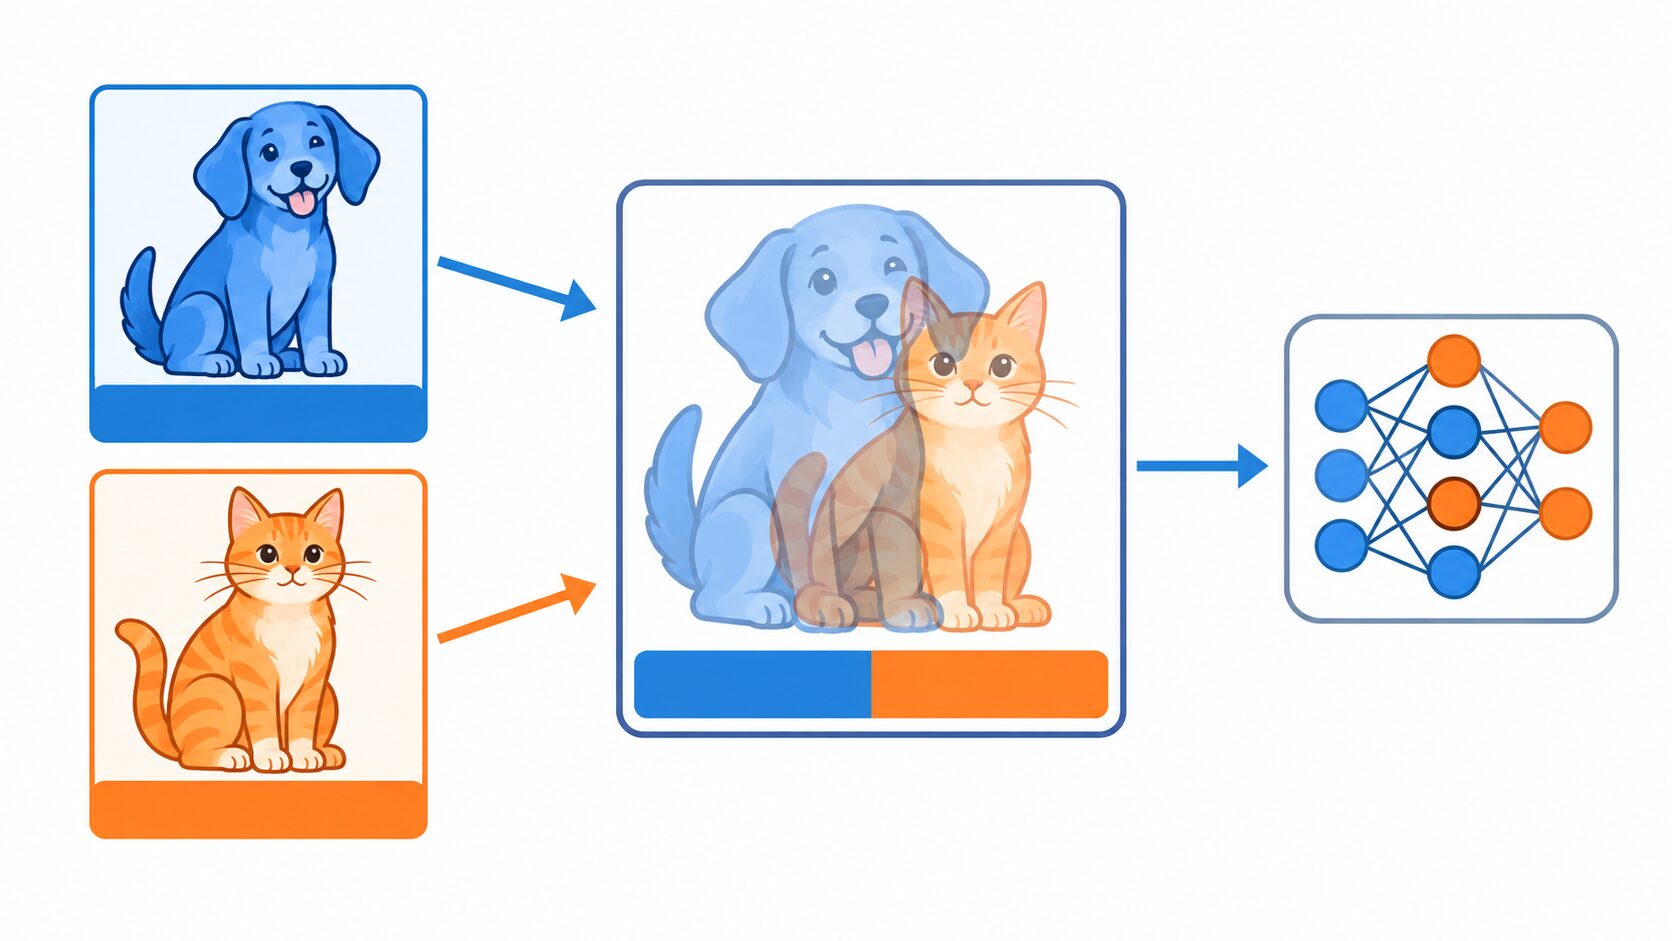
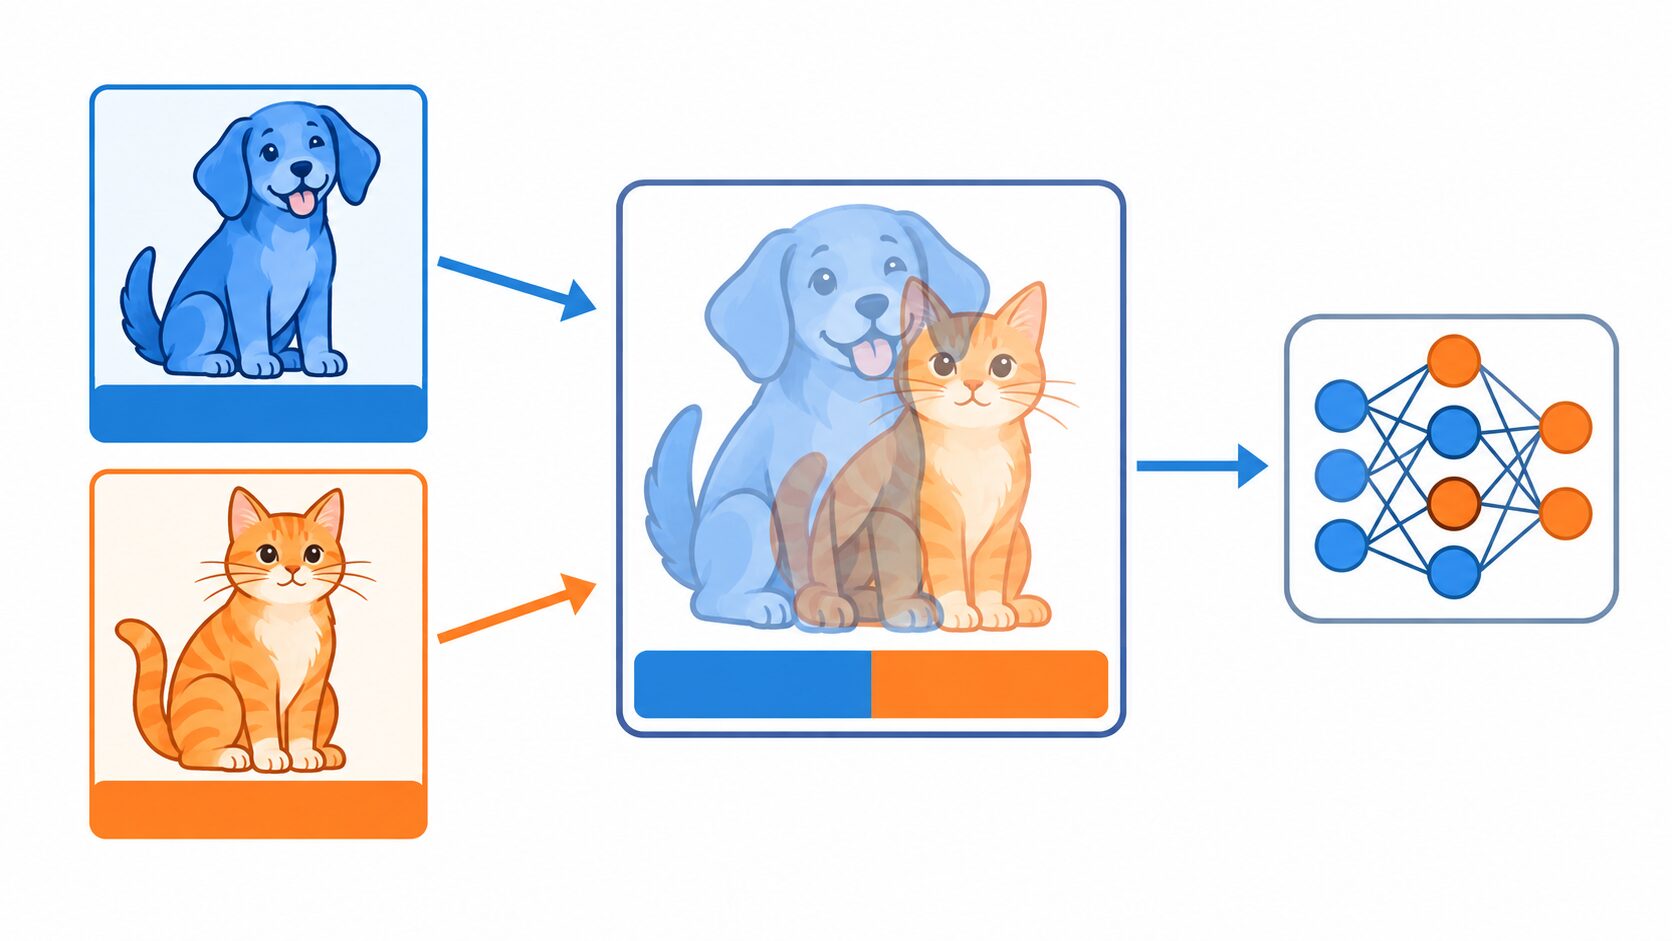
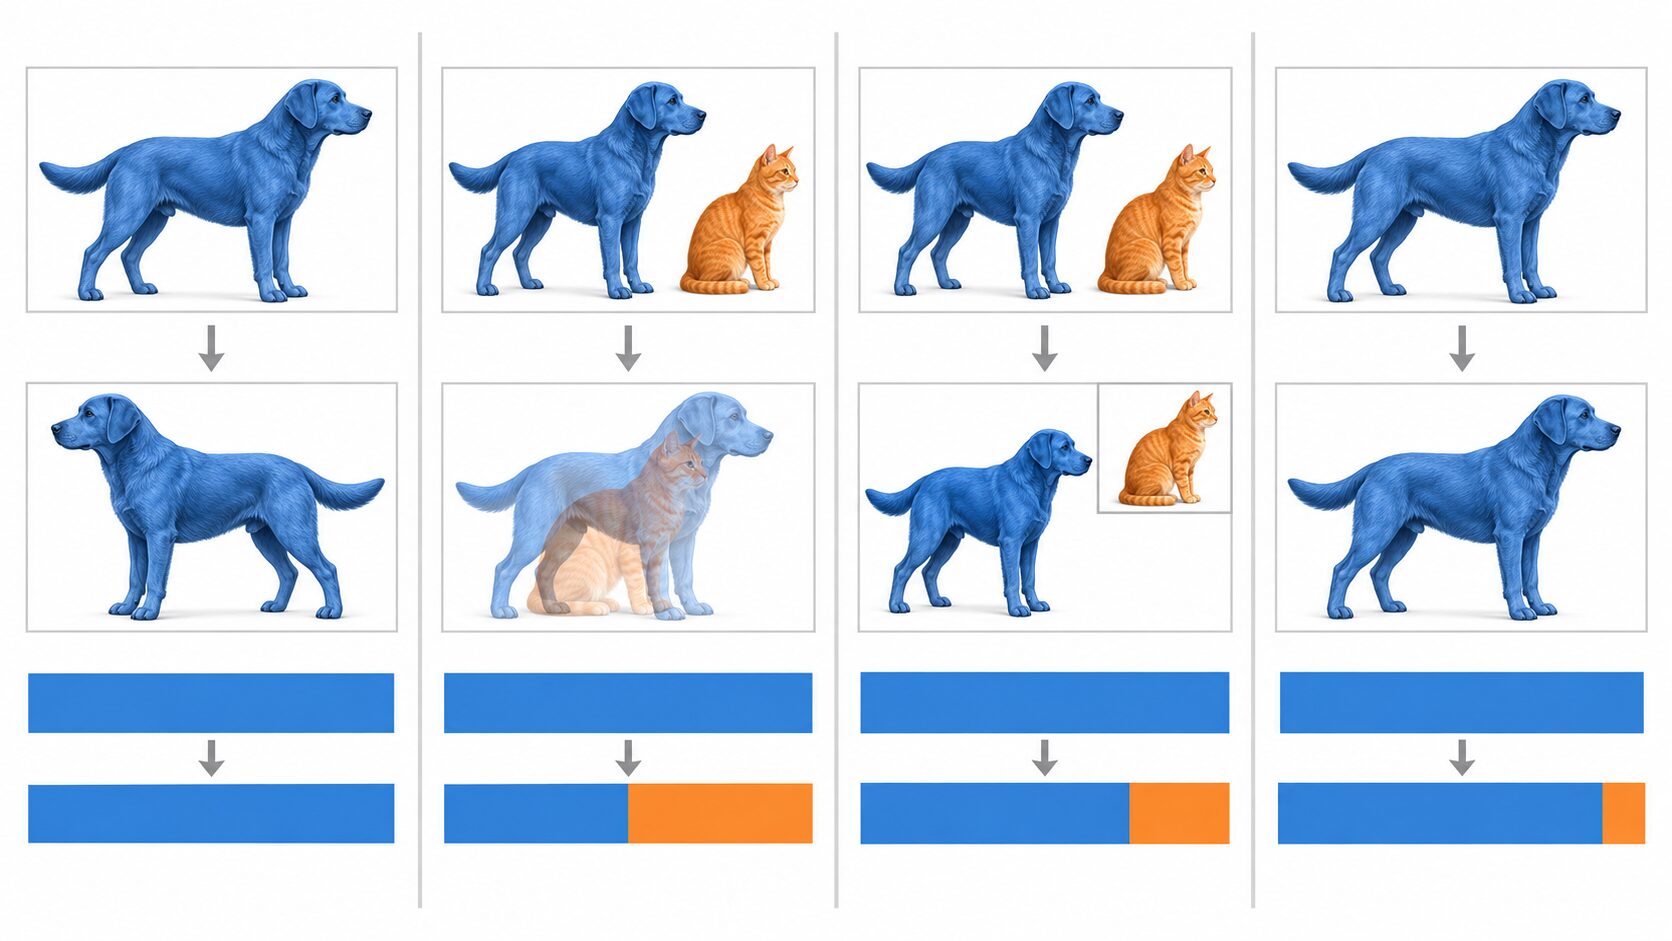
Mixupでは、画像だけでなく、正解を示すラベルも同じ割合で混ぜるんだ。例えば、犬の画像を0.7、猫の画像を0.3の割合で重ねたら、学習の目標も「犬0.7、猫0.3」にするんだよ。
AIの初心者
犬か猫のどちらか一方を正解にするわけではないのですね。でも、そのような合成画像で学習するのはなぜですか?
AI専門家
元の画像の組合せや混ぜる割合を変え、混合比に応じた出力を学ばせるためだよ。訓練画像だけへの過度な当てはまりを抑え、見たことのない画像への予測に役立つ場合があるんだ。実際に効果があるかは、混ぜていない検証画像で確かめる必要があるよ。
Mixupとは
Mixup(ミックスアップ)は、2つの訓練データの入力と正解ラベルを、同じ割合で混ぜて学習するデータ拡張の手法です。画像分類では、2枚の画像の対応する画素を重み付きで足し合わせ、ラベルも同じ重みで合成します。過学習を抑える方法の一つとして使われます。
仕組みを理解する鍵は、「画像を混ぜること」と「学習の目標も混ぜること」が一組になっている点です。犬と猫の例を使って計算の流れを確認し、CutMixなどとの違い、使いどころ、効果を確かめる方法まで見ていきましょう。
Mixupとは何か
画像分類は、画像に写っている対象を「犬」「猫」などのクラスに分ける課題です。通常は、入力画像と、その画像の正解を表すラベルの組を使ってモデルを学習させます。Mixupは、この訓練例を2つ選び、画像とラベルの両方について中間の値を作ります。この操作を線形補間と呼びます。
データ拡張とは、手元のデータを変換して、学習に使う入力のバリエーションを増やす工夫です。Mixupでは、同じ犬の画像でも、組み合わせる猫の画像や混合比を変えることで異なる入力を作れます。学習中に合成すれば、あらかじめ大量の画像ファイルを保存しておく必要もありません。
ただし、合成によって新しい実測データや未知の情報そのものが手に入るわけではありません。例えば、晴天の画像しかない訓練データを混ぜても、夜間や雨天の撮影データを集めたことにはなりません。Mixupは、既存のデータを使ってモデルの学び方に制約を加える方法と捉えると理解しやすくなります。
このように、訓練データへの過度な当てはまりを抑える工夫を正則化といいます。Mixupはデータ拡張であると同時に、正則化の役割も持ちます。合成画像はあくまで学習用の入力であり、犬と猫の中間の生物や、新しい分類クラスを作るものではありません。分類先は元の「犬」「猫」のままで、各クラスに割り当てる教師信号を変えます。
画像とラベルを同じ割合で混ぜる仕組み
Mixupの基本的な計算は、次の2つの式で表せます。
\(\tilde{x}=\lambda x_1+(1-\lambda)x_2\) \(\tilde{y}=\lambda y_1+(1-\lambda)y_2\)\(x_1\)と\(x_2\)は元の入力画像、\(y_1\)と\(y_2\)は対応するラベルです。\(\tilde{x}\)と\(\tilde{y}\)が合成後の入力とラベルを表します。\(\lambda\)(ラムダ)は0から1の範囲の混合係数で、もう一方の重みは\(1-\lambda\)です。2つの重みの合計は1になります。
まず、訓練データから画像のペアを選びます。実装では、複数の訓練例をまとめた「ミニバッチ」の順番をランダムに並べ替え、元の並びと組み合わせる方法が使えます。画像とラベルには同じ並べ替えを適用し、ペアの対応を保ちます。
次に、画像の高さ・幅・チャンネル数をそろえ、同じ位置の画素同士を混ぜます。犬を0.7、猫を0.3とした場合、画像全体の各画素について、犬側の値を0.7倍、猫側の値を0.3倍して足します。例えば、ある位置の赤色成分が犬側で200、猫側で100なら、合成後は170になります。画像の一部分を切り貼りするのではなく、対応する画素を全体にわたって重ねる操作です。
ラベルにも同じ重みを使います。犬・猫の順に数値を並べるなら、犬だけが正解のラベルは\([1,0]\)、猫だけが正解のラベルは\([0,1]\)です。正解クラスだけを1、ほかを0にした表現を「ワンホットラベル」と呼びます。これらを犬0.7・猫0.3で混ぜると、混合ラベルは\([0.7,0.3]\)になります。
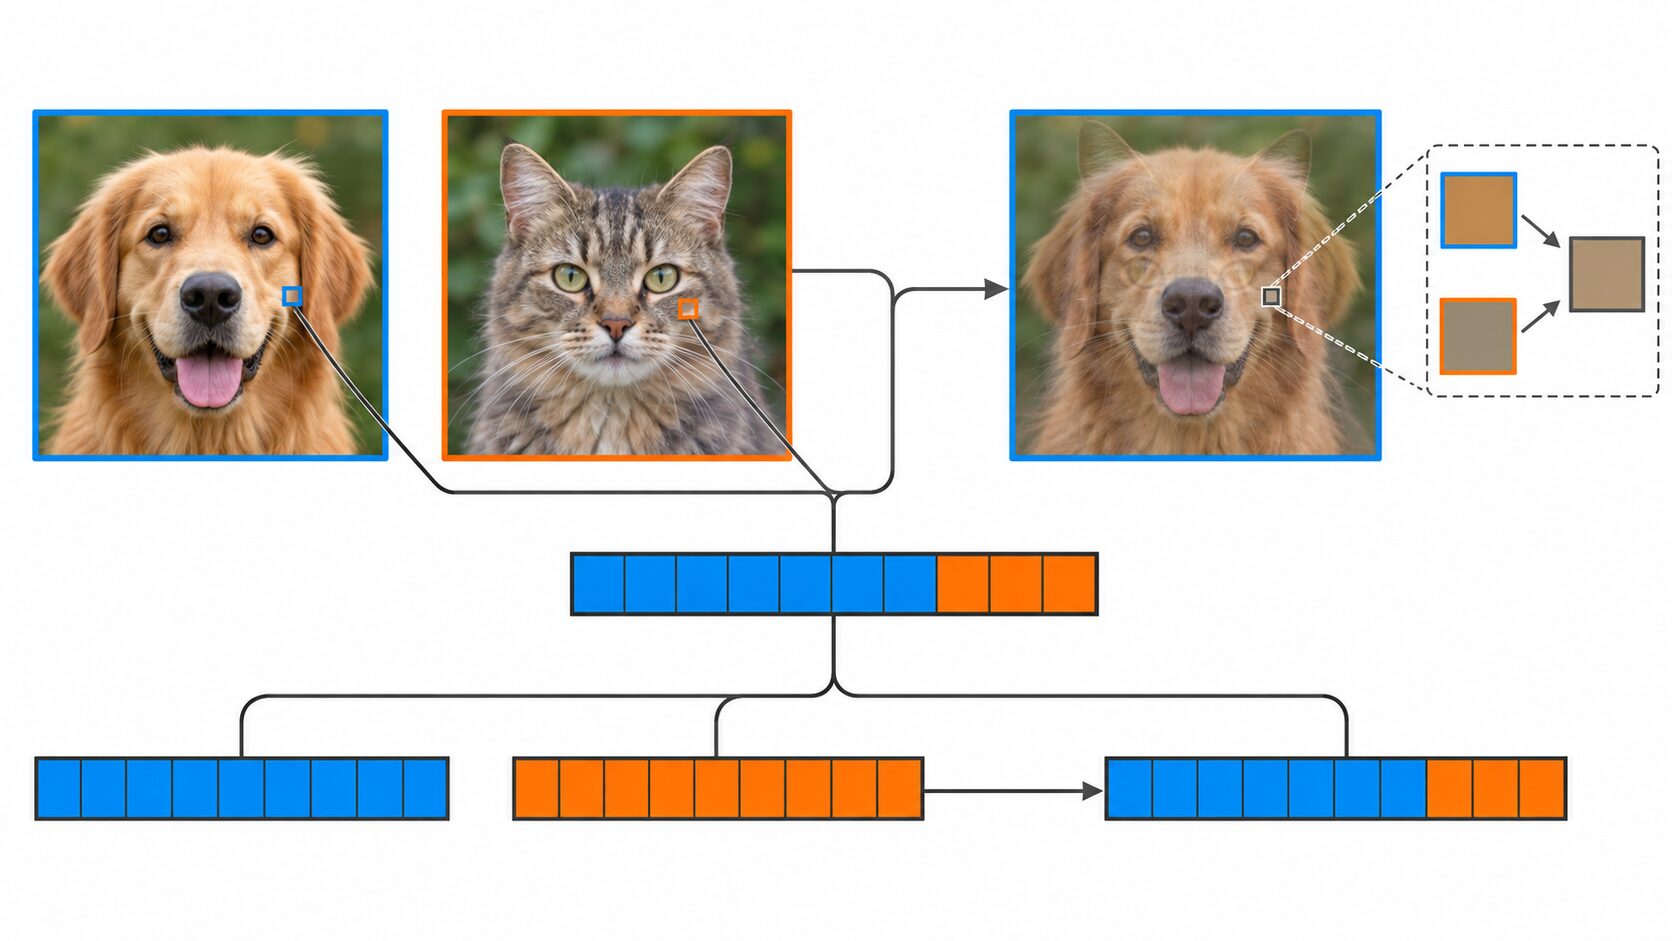
この0.7と0.3は、モデルに学習させたい目標値であり、画像内の犬と猫の面積比でも、モデルが出した予測結果でもありません。教師信号を複数のクラスへ分配した「ソフトラベル」です。モデルは合成画像を入力され、この教師信号に近い出力になるようにパラメータを更新します。
混合比は毎回0.7と0.3に固定する必要はありません。一般的には、\(\lambda\sim\mathrm{Beta}(\alpha,\alpha)\)のように、ベータ分布から混合係数を抽出します。ベータ分布は0から1の値を生成する確率分布で、正の設定値\(\alpha\)(アルファ)が混ざり方の傾向を決めます。
\(0<\alpha<1\)では0や1に近い値が出やすく、片方の画像が強く残る合成が多くなります。\(\alpha=1\)では区間内で一様に値を取り、\(\alpha>1\)では0.5付近が出やすくなります。値を大きくすれば必ず精度が上がるわけではなく、両画像を強く混ぜることが課題に合うかを確認します。
学習には、混合ラベルに対応した損失関数を使います。損失は、予測と教師信号のずれを数値にしたものです。分類で用いるクロスエントロピーなら、ソフトラベルを直接扱う方法のほか、同じ合成画像への予測について、犬を正解とした損失と猫を正解とした損失を0.7と0.3で重み付けする方法でも表せます。犬を0、猫を1としたクラス番号そのものを混ぜて0.3という番号を作ったり、混合ラベルを再び一つのクラスへ丸めたりしないことが大切です。
過学習を抑えて汎化を助ける理由
過学習とは、モデルが訓練データに適合しすぎて、見たことのないデータでは十分な性能を出せなくなる状態です。例えば、訓練用の犬が芝生の上にいる写真ばかりだと、犬の形だけでなく背景の緑色にも強く依存する可能性があります。訓練画像を高い精度で分類できても、室内の犬をうまく分類できるとは限りません。
未知のデータにも対応する能力を汎化性能と呼びます。Mixupは、元の訓練例を正しく分類することに加え、その間に作った入力に対しても混合比に沿った出力を求めます。これにより、一部の訓練例だけに都合よく合わせた、過度に複雑な振る舞いを取りにくくすることが狙いです。
犬の画像から猫の画像へ混合比を少しずつ変える場面を考えると、教師信号も犬寄りから猫寄りへ連続的に変わります。モデルは、その中間の入力についても学習するため、元の画像の周辺だけを覚える場合より広い範囲で出力を制約されます。ただし、実際のモデルの出力が完全な直線になることや、あらゆるクラスの境界が単純になることを保証するものではありません。
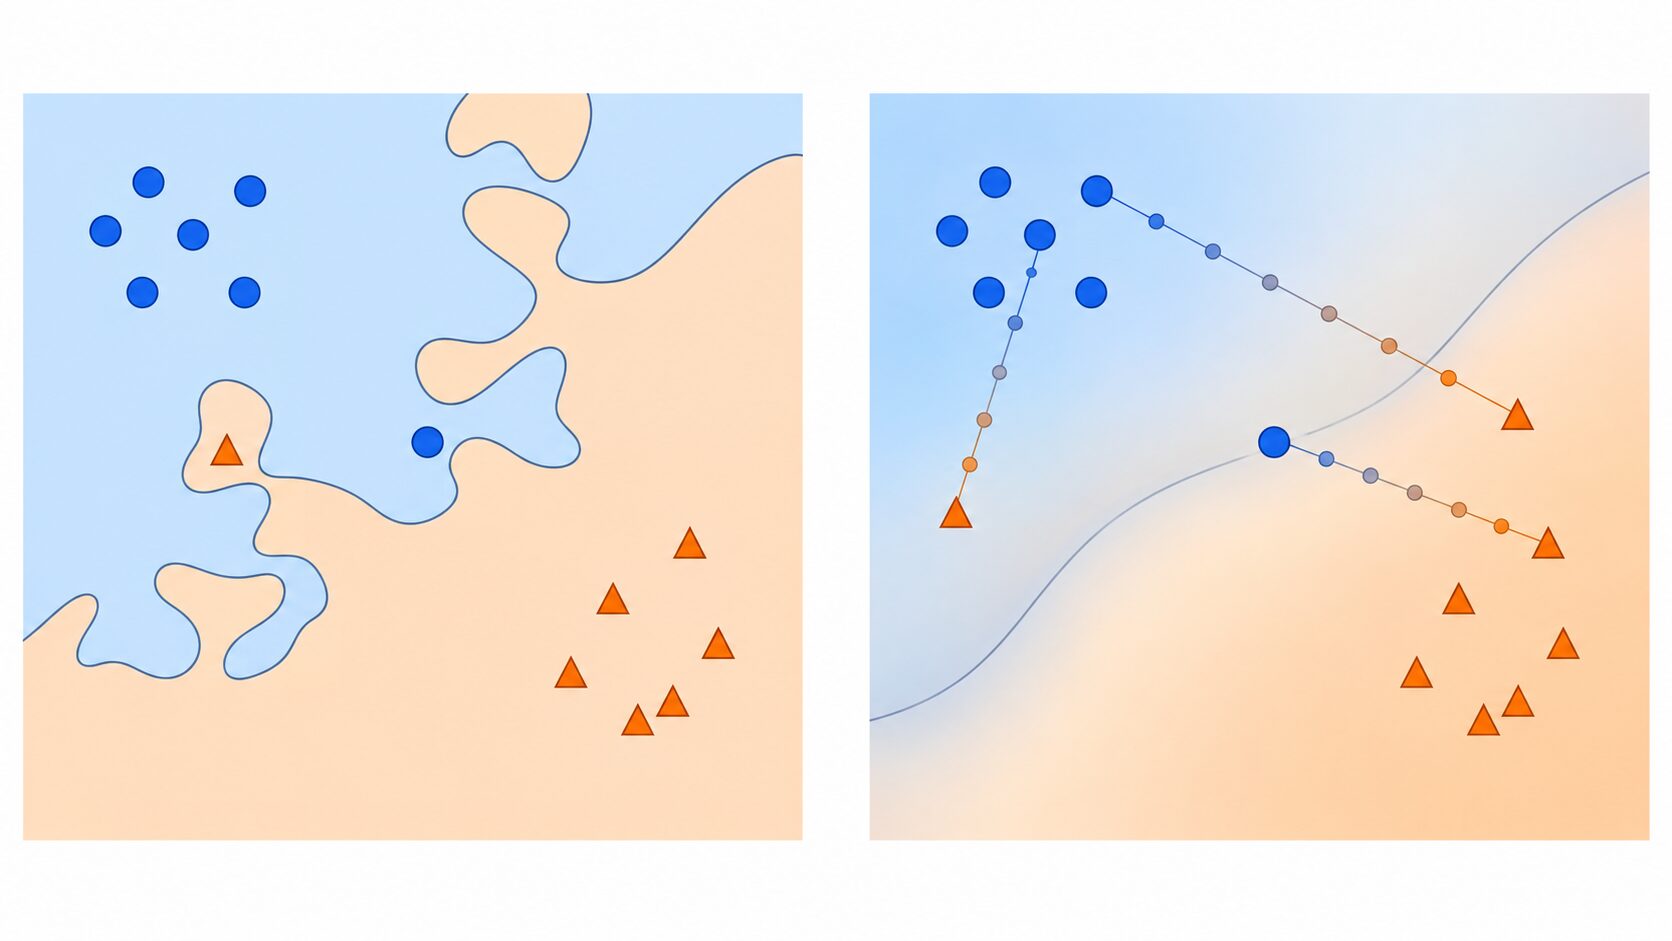
この図は、クラスを分ける決定境界と正則化の関係を説明する概念図です。特定のモデルの実測結果や、性能改善の大きさを示したものではありません。
Mixupで画像が重なって見えても、単なるぼかし処理やノイズ除去とは異なります。画像と教師信号を一緒に補間する点が中心であり、画像中の不要な情報を判別して消すわけではありません。元データの偏りや誤ったラベルを自動的に解消するものでもなく、曖昧な画像を必ず正しく識別できるとはいえません。
精度の変化は、データの量と内容、モデル、混合の強さ、ほかの学習設定に左右されます。Mixupを加えて未知データへの予測が改善する場合もあれば、すでに十分な正則化が働いている場合などには効果が小さく、性能が下がる場合もあります。導入の判断には、訓練中の数値だけでなく検証データでの比較が必要です。
ほかのデータ拡張・正則化との違い
画像分類では、反転や切り抜き、CutMix、ラベルスムージングも使われます。Mixupとの違いは、入力をどのように変えるか、教師信号をどう扱うかの2点で比較すると明確になります。
| 手法 | 入力の変化 | ラベルの扱い | 使い分けの視点 |
|---|---|---|---|
| 反転・切り抜き | 通常は1枚の画像の向きや切り取る範囲を変える | 分類では通常、元のラベルを保つ | 変換後も正解が変わらない範囲で、見え方の変化を学ばせる |
| Mixup | 2枚の画像全体を、対応する画素ごとに重ね合わせる | 画像の混合係数と同じ割合で混ぜる | 訓練例の中間の入力と出力の関係も学ばせる |
| CutMix | 画像の一部を、別の画像から切り出した領域で置き換える | 通常は置き換えた面積の比率に応じて混ぜる | 局所的な見た目を保ちながら、対象の一部が隠れる状況などを作る |
| ラベルスムージング | この手法自体では画像を合成・変形しない | 正解クラスへの重みを少し下げ、ほかのクラスにも配分する | 教師信号を調整し、一つのクラスへ極端に確信する学習を抑える |
反転や切り抜きは、変換後も分類ラベルが妥当であることが前提です。例えば、切り抜きによって犬が完全に消えた画像を、元のまま犬として学習させるのは適切とは限りません。Mixupと組み合わせることもできますが、まず個々の変換が課題に合っているかを確認します。
CutMixとMixupはどちらも2つの訓練例を組み合わせますが、画素の扱いが異なります。Mixupでは両方の画像が全体で重なり、CutMixでは切り貼りした各領域に元の画像の見た目が残ります。また、CutMixでラベルに使う面積比は、通常は貼り付け領域の面積に基づき、実際に写っている犬や猫の面積を測った値ではありません。
ラベルスムージングとMixupは、どちらも教師信号を一つのクラスだけに集中させない場合がある点で似ています。ただし、Mixupの配分は具体的な別の訓練例と入力の混合比に結び付いています。似た役割を持つ方法でも操作は異なるため、複数を併用する際は、一つずつ追加して効果を比べると判断しやすくなります。
使いどころと画像以外への応用
Mixupは、画像分類で訓練精度に比べて検証精度が伸びないなど、過学習が疑われるときに検討できる方法です。訓練データが少ない場合も候補になりますが、混ぜる元の画像に必要なバリエーションがなければ限界があります。データの収集、ラベルの確認、撮影条件やクラスの偏りの改善と併せて考えることが大切です。
医療画像や自動運転関連の画像認識も、応用を検討する分野の例です。ただし、画像全体の分類、異常な箇所の検出、道路上の対象の位置推定では、学習させたい内容が違います。分類精度が上がることと、診断性能やシステム全体の安全性が高まることは同じではありません。対象の課題と利用条件に合った評価が必要です。
物体検出では「何が写っているか」に加えて、物体の位置を囲む枠などを教師情報として使います。領域分割では、画像の各画素が何に属するかを示すマスクを使います。こうした課題に混合を取り入れる際は、重なった物体の位置や画素ごとの正解をどう扱うかを設計する必要があり、画像分類用のラベル混合をそのまま流用することはできません。
画像以外にも、音声の波形や、音の周波数成分を時間に沿って表すスペクトログラムを混ぜる応用が考えられます。ただし、音の種類を分類する課題と、発話内容を文字に変換する課題とでは、必要な教師信号が異なります。音を重ねたことだけで、雑音に強い音声認識が実現するわけではありません。
文章の場合は、文字列や単語の識別番号をそのまま足し合わせても、意味の通る文章にはなりません。そこで、単語や文章を数値ベクトルにした「埋め込み」や、モデル内部の特徴表現を混ぜる方法があります。いずれも、どの表現を混ぜ、どの目標に向けて学習するかが要点です。Mixupの考え方を使うだけで、自然な文章を生成する能力が高まると断定することはできません。
応用先が変わっても、合成した入力に対して、混ぜた教師信号が学習目標として妥当かを確かめるという基本は共通しています。
導入時の注意点と効果の確かめ方
Mixupの効果を確かめるには、最初に訓練・検証・テストの役割を分けます。訓練データはモデルの学習、検証データは設定の比較、テストデータは設定を決めた後の最終評価に使います。データを分割してから、訓練データの中だけで混ぜることが基本です。
先に全画像を混ぜてから分割すると、検証やテストに使う画像の情報が訓練用の合成画像に入り込むおそれがあります。このような情報漏洩があると、未知データへの性能を適切に測れません。同じ対象を連続撮影した画像など、よく似たデータがある場合は、元データの分け方にも注意します。
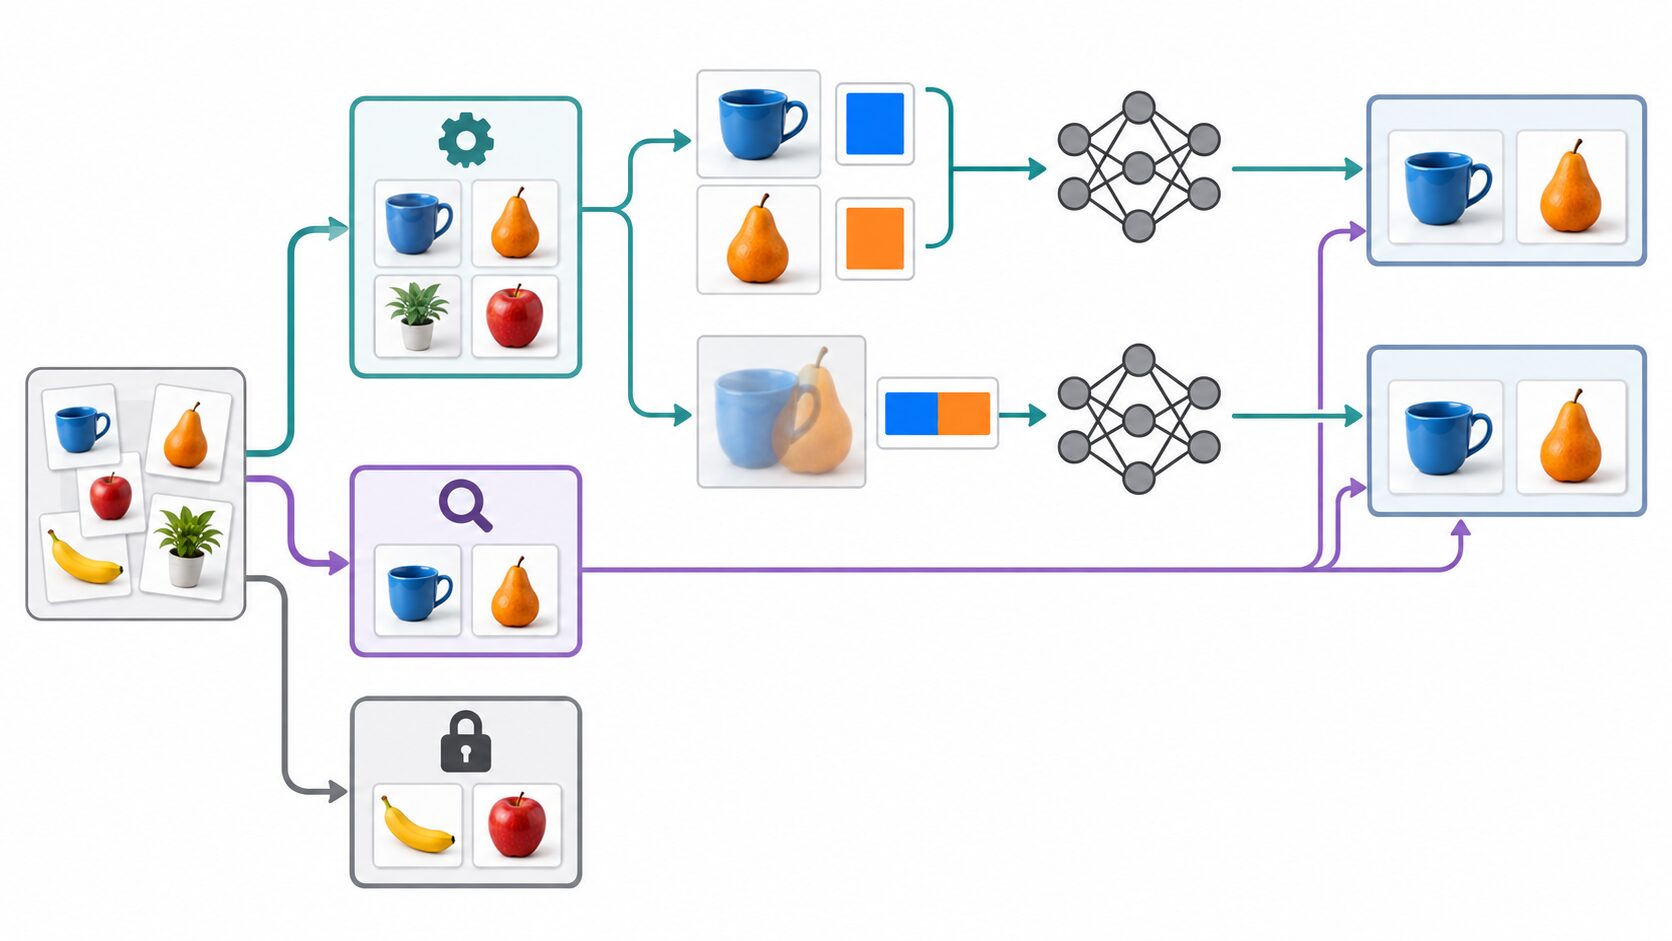
- 比較の基準を作る。Mixupを使わず、採用するモデルと通常の前処理で学習します。データ分割、学習回数、評価指標を記録し、比較できる条件をそろえます。
- 訓練処理にMixupを加える。画像のペアとラベルのペアが対応し、両方に同じ混合比が使われていることを確認します。ソフトラベルを使う場合は、損失関数がその形式に対応している必要があります。
- 元の検証画像で比べる。モデルや学習条件をそろえ、Mixupの有無による分類精度とクラス別の誤りを確認します。全体の精度だけでなく、特定のクラスの見落としが増えていないかも調べます。
- 検証結果で設定を調整する。混ざり方を決めるアルファや適用頻度を変え、効果が安定する条件を探します。差が小さい場合は、乱数によるばらつきも考慮して判断します。
- 条件を固定して最終評価する。選んだ設定をテストデータで評価します。テスト結果を見ながら設定を選び直すと、最終評価としての独立性が失われます。
検証・テストでは、サイズ調整や正規化など必要な前処理を行いつつ、通常は画像を混ぜずに評価します。利用時の推論も同様に、一つの入力画像から予測します。Mixupで訓練したからといって、分類したい画像に別の画像を重ねる必要はありません。
混合が強すぎると、学習に必要な手掛かりが捉えにくくなる場合があります。細かな模様や小さな対象が判断に重要な課題では、重ね合わせによってそれらが見えにくくならないかを考えます。検証性能が悪化したら、混合の強さや適用頻度を下げる、ほかの拡張との組合せを見直す、といった調整を行います。
また、Mixupでは教師信号そのものが変わるため、合成画像に対する訓練精度を、通常の画像に対する訓練精度と単純に比較することはできません。訓練中の数字が下がったという理由だけで失敗と判断せず、混ぜていない検証画像で目的の性能が改善したかを基準にします。
Mixupを使ううえで押さえたいのは、画像とラベルを同じ割合で混ぜること、訓練例の間にも学習上の制約を与えること、そして効果を独立したデータで確かめることです。この3点を意識すると、単に合成画像を増やす手法としてではなく、自分の分類課題に合った過学習対策として検討できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月18日 | 画像とラベルの混合計算、関連手法との違い、訓練内での適用と検証手順を追記 |