
AdaDeltaとは?仕組み・学習率・AdaGradとの違いを解説

AIの初心者
『アダデルタ』って、機械学習でどんな役割を持つものですか?

AI専門家
AdaDeltaは、モデルの予測の誤差を減らすために、パラメータをどう動かすか決める最適化手法の一つだよ。過去の勾配と更新量を使って、パラメータごとに学習の歩幅を調整するんだ。
AIの初心者
『アダグラッド』と名前が似ていますが、仕組みはどう違うんですか?
AI専門家
AdaGradは勾配の二乗をため続けるため、学習の歩幅が小さくなりすぎることがあるんだ。AdaDeltaは古い情報の影響を徐々に弱め、過去にどれくらい更新したかも使うよ。RMSPropとの共通点もあるけれど、更新量の履歴まで使うところが理解のポイントだね。
AdaDelta(アダデルタ/エイダデルタ)は、勾配とパラメータ更新量の履歴を組み合わせて、更新の大きさを自動調整する最適化アルゴリズムです。AdaGradで学習が進むにつれて更新幅が小さくなりすぎる問題を緩和し、学習率を調整する負担を減らすことを目指しています。
ただし、自動調整があるからといって、どのモデルでも速く学習できたり、高い精度が得られたりするわけではありません。この記事では、AdaDeltaの定義から指数移動平均と更新式の意味、AdaGrad・RMSProp・Adamとの違い、使う際の注意点まで順に説明します。
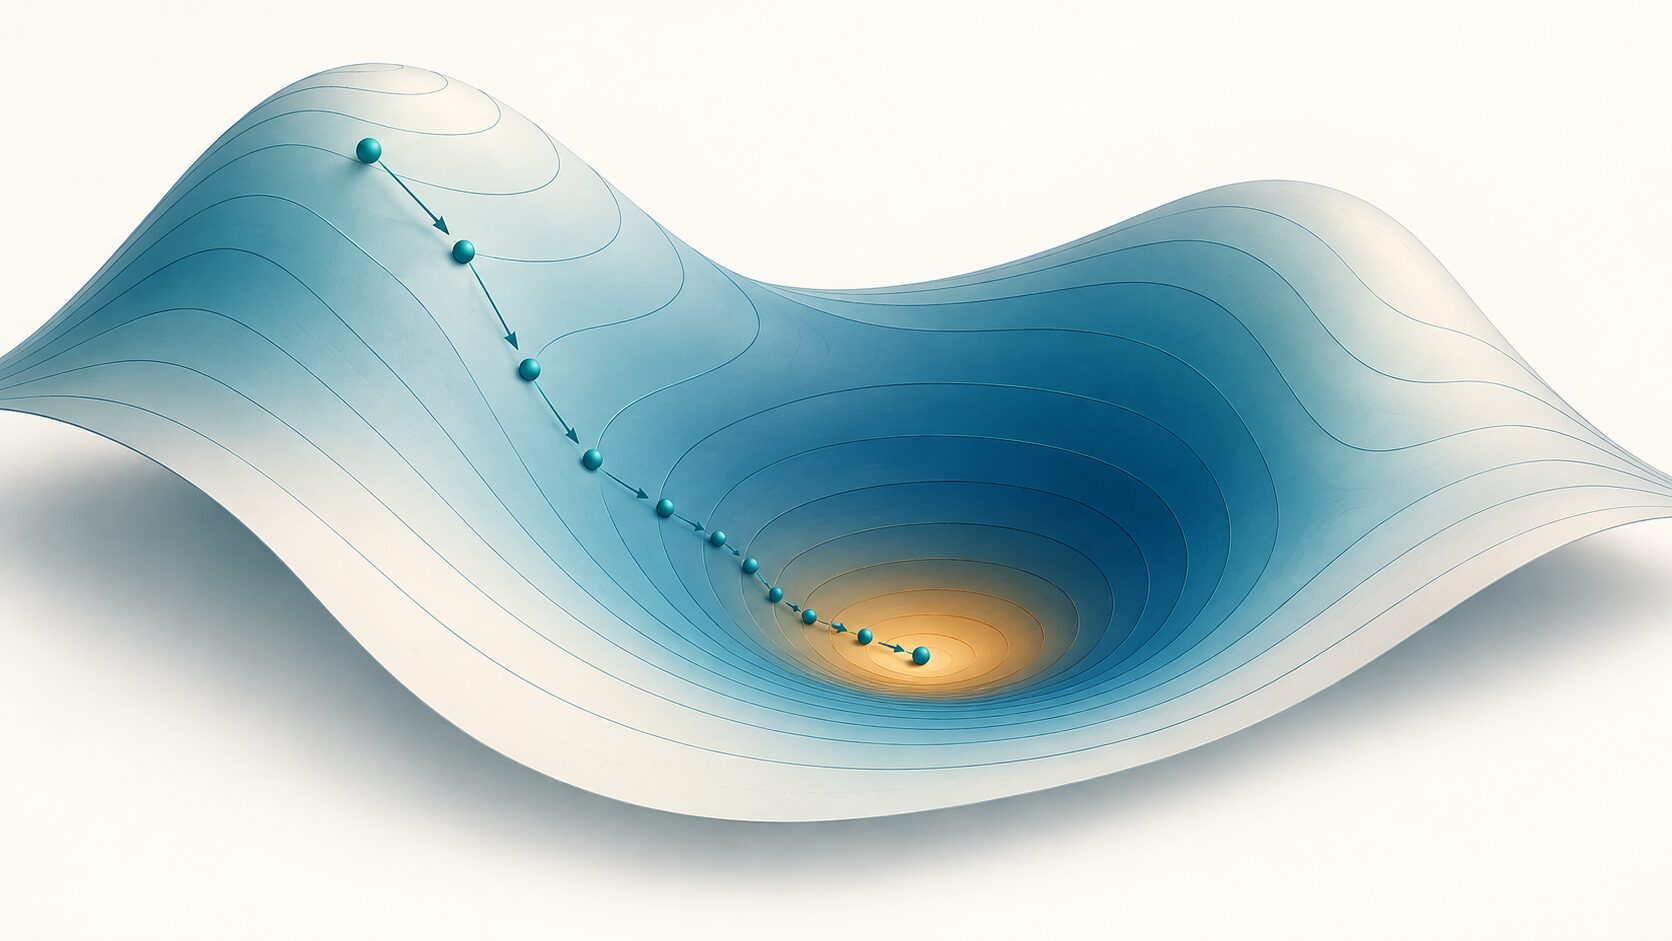
図は更新幅を調整するイメージです。実際の学習経路や、必ず最小値へ到達することを示すものではありません。
AdaDeltaとは?パラメータごとの更新幅を調整する最適化手法
機械学習モデルは、重みやバイアスといったパラメータを変えながら、予測と正解のずれを小さくしていきます。このずれを数値で表すのが損失関数です。最適化手法は、損失を減らすために「どの方向へ、どれくらいパラメータを動かすか」を決めます。
方向を判断する手掛かりが勾配です。勾配は、パラメータを少し変えたときに損失がどちらへ、どの程度変わるかを示します。基本的な勾配降下法では、損失が増える方向を示す勾配の反対方向へ更新します。地形にたとえるなら、山頂を目指すのではなく、損失の低い谷へ下りていく操作です。
このとき、勾配にどれくらいの係数を掛けるかを決めるのが学習率です。大きすぎると谷を飛び越えて損失が増えることがあり、小さすぎると改善に多くの更新が必要になります。また、多数のパラメータには、それぞれ勾配の大きさや変動の違いがあります。
AdaDeltaは、一つの歩幅をすべてに同じように当てはめる代わりに、パラメータごとの履歴から更新の尺度を計算します。画像を分類するモデルでも文章を扱うモデルでも、勾配を計算して学習する場面で利用できる考え方です。データの種類を識別する手法ではなく、モデルの学習を進めるための更新規則だと捉えると役割が明確になります。
AdaGradの課題:過去の勾配をため続けると何が起きるか
まず、AdaGradが使う勾配二乗の累積を確認しましょう。以下では、\(g_t\)を更新時点\(t\)の勾配、\(\eta\)を学習率、\(\epsilon\)を数値計算を安定させる小さな正の値とします。式は一つのパラメータについて書いています。
\(G_t=\sum_{\tau=1}^{t}g_\tau^2,\qquad \Delta\theta_t=-\frac{\eta}{\sqrt{G_t+\epsilon}}g_t\)AdaGradは、過去に大きな勾配が何度も現れたパラメータでは、分母が大きくなるため更新の係数を抑えます。勾配の二乗を使うので、正負の勾配が打ち消し合わず、大きさの履歴を蓄積できます。一方、勾配が現れる頻度の低いパラメータでは累積が小さく、相対的に大きな係数を保ちやすくなります。
問題は、二乗した値が非負なので、累積値\(G_t\)が減らないことです。学習の序盤に大きな勾配が続くと、その影響が後半にも残り、まだ損失を改善できるのに更新幅が小さくなりすぎる場合があります。
単純な例として、毎回の勾配が1で、微小定数の影響を無視できるとします。累積値は更新回数とともに1、2、3と増え、100回目の勾配に掛かる係数は1回目の約10分の1になります。これは仕組みを確かめるための例であり、実際の勾配が一定とは限りません。
「AdaGradの学習率が必ず途中でゼロになる」という意味ではありません。一定の学習率を与えていても、累積値で割ることによって実効的な係数が小さくなり続ける、という点が課題です。AdaDeltaはこの累積方法を見直します。
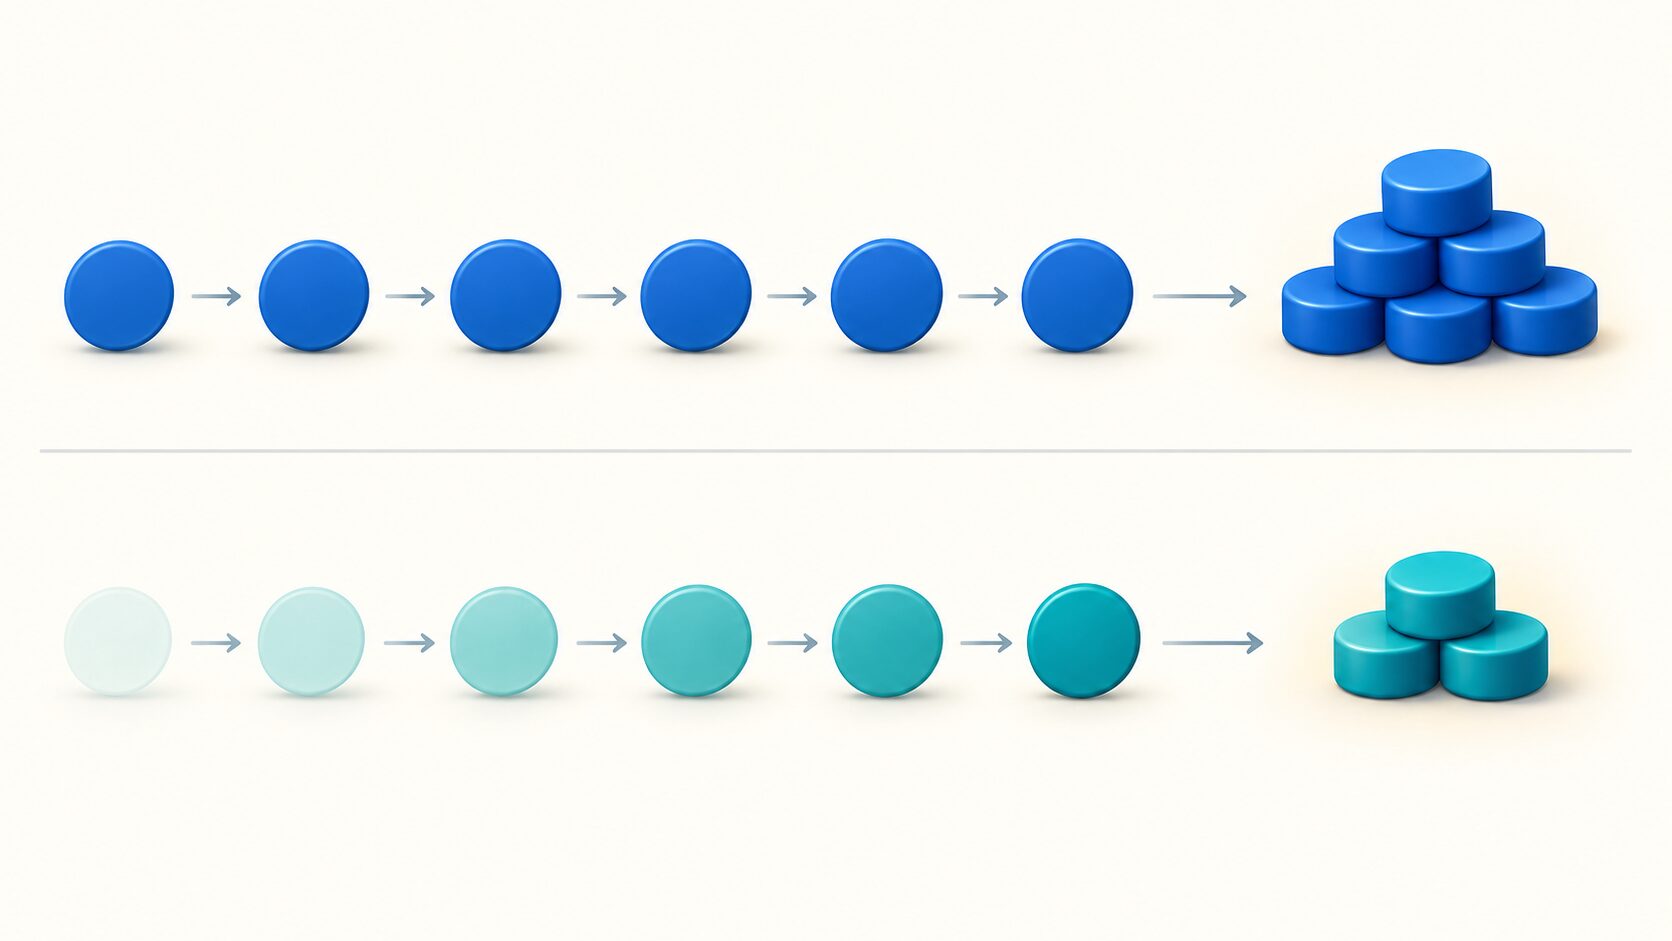
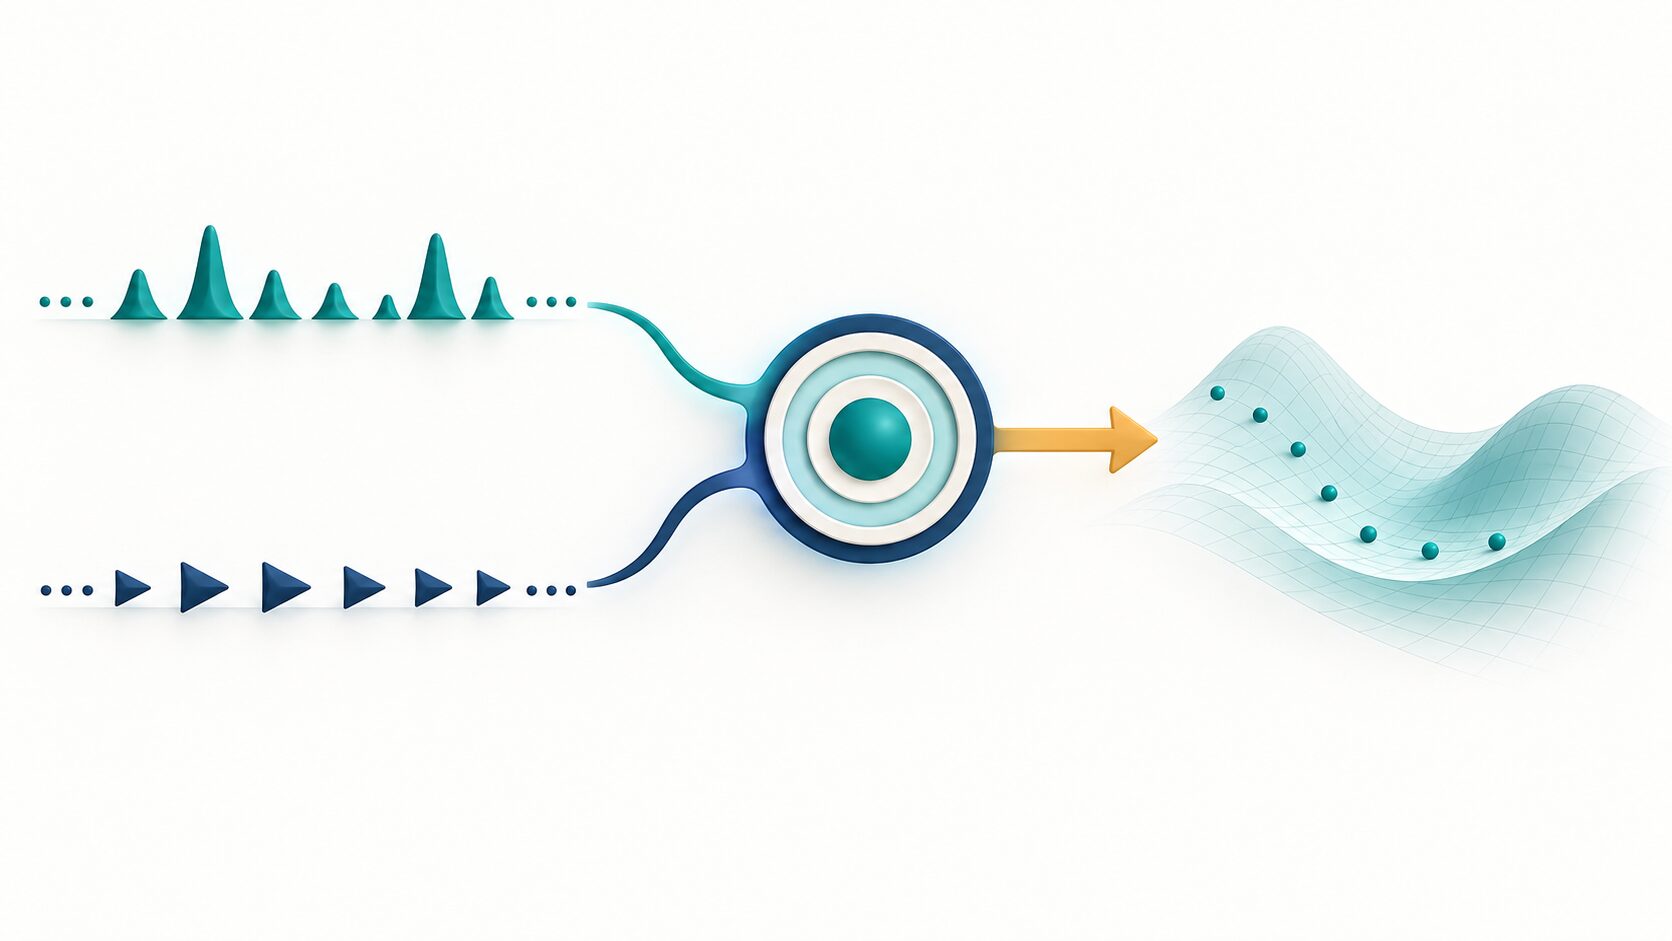
上段は履歴を累積する考え方、下段は古い履歴の影響を薄める考え方を表しています。図形の大きさは実測値ではありません。
AdaDeltaの仕組み①:指数移動平均で古い情報の影響を弱める
AdaDeltaでは、勾配二乗の累積和の代わりに、指数移動平均\(s_t\)を使います。過去の平均と今回の値を重み付きで混ぜる、次の計算です。
\(s_t=\rho s_{t-1}+(1-\rho)g_t^2,\qquad 0<\rho<1\)\(\rho\)は、過去の情報をどれだけ残すかを決める減衰率です。1に近いほど長い履歴を重視してなめらかに変化し、小さくするほど最近の勾配に反応しやすくなります。古い情報の影響は更新のたびに減衰率が掛かることで徐々に弱まります。
例えば、説明用に減衰率を0.9とすると、新しい平均は「これまでの平均の90%と、今回の勾配二乗の10%」で計算します。さらに次の更新では、今回加えた情報にも0.9が掛かります。このため、過去の情報は突然捨てられるのではなく、時間がたつほど小さな重みで残ります。
ここで平均しているのは、学習データそのものではなくパラメータごとの勾配の二乗です。「重要な経験だけを選んで記憶する」というより、「新しい情報を重く、古い情報を軽く扱う」と考えるほうが正確です。
一定の大きさの勾配が続く場合、この平均はその勾配の二乗に近づきます。AdaGradの累積和のように、更新回数だけを理由に増え続けるわけではありません。ただし、勾配自体が大きくなれば平均も大きくなり得るので、常に一定の歩幅を保つ仕組みでもありません。
AdaDeltaの仕組み②:過去の更新量も使って歩幅を決める
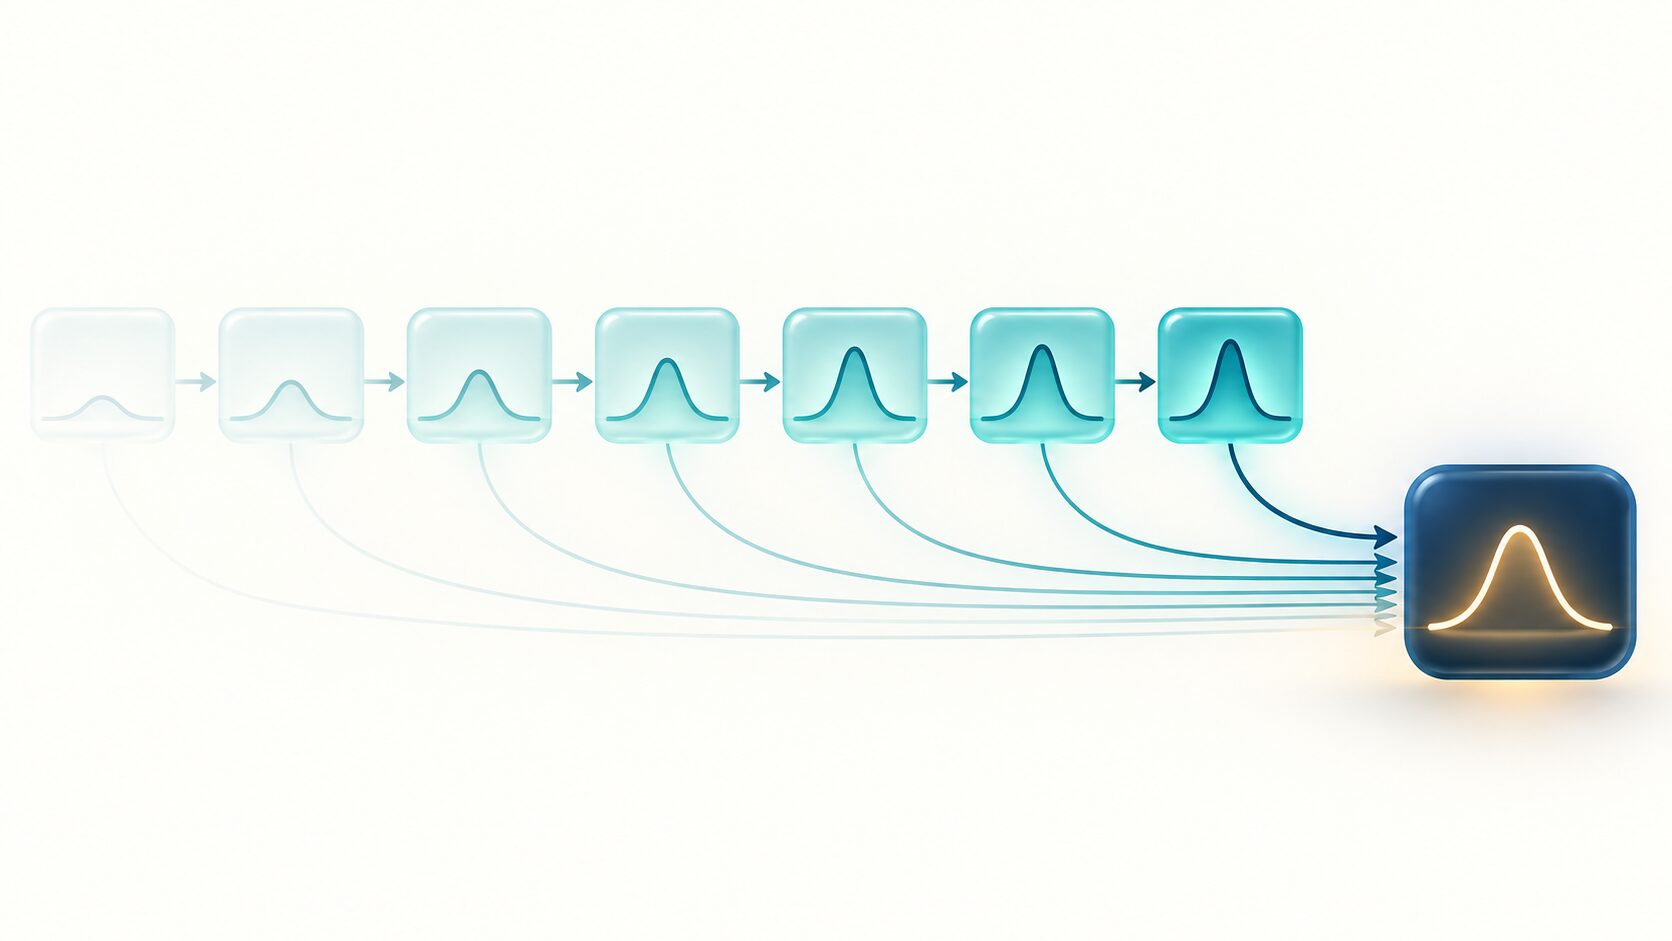
AdaDeltaのもう一つの特徴は、勾配二乗の平均\(s_t\)に加えて、実際の更新量の二乗平均\(v_t\)も保持することです。ここでは、外部の学習率係数を付けない基本形を示します。
\(s_t=\rho s_{t-1}+(1-\rho)g_t^2\) \(\Delta\theta_t=-\frac{\sqrt{v_{t-1}+\epsilon}}{\sqrt{s_t+\epsilon}}g_t\) \(v_t=\rho v_{t-1}+(1-\rho)(\Delta\theta_t)^2\) \(\theta_t=\theta_{t-1}+\Delta\theta_t\)この式で\(\theta_t\)は更新後のパラメータ、\(\Delta\theta_t\)は今回加える変更量です。\(g_t\)は更新前のパラメータで計算した勾配を表します。複数のパラメータがある場合、二乗・平方根・割り算は各要素について行います。
- 今回の勾配から、勾配二乗の移動平均を更新する。
- 前回までの更新量の履歴と、今回までの勾配の履歴の比から、今回の更新量を計算する。
- 求めた更新量の二乗を、その履歴に取り込む。
- パラメータに更新量を加え、次の学習へ進む。
順序が重要なのは、今回の更新量を計算するときには、その値がまだ更新量の履歴へ入っていないためです。分子には前回までの平均\(v_{t-1}\)、分母には今回の勾配を取り込んだ平均\(s_t\)を使います。最初は二つの平均をゼロで初期化でき、微小定数\(\epsilon\)がゼロ除算を防ぐとともに、最初の更新を可能にします。
一つのパラメータで計算してみる
説明用に、\(\rho=0.9\)、\(\epsilon=10^{-6}\)、\(s_0=v_0=0\)、最初の勾配を\(g_1=2\)とします。すると\(s_1=0.4\)となり、更新量は次のようになります。
\(\Delta\theta_1=-\frac{\sqrt{10^{-6}}}{\sqrt{0.4+10^{-6}}}\times 2\approx-0.00316\)最初のパラメータが1なら、更新後は約0.99684です。その後、この更新量の二乗を平均に取り込みます。実際の更新幅は勾配と二つの履歴によって変わるので、この数値を推奨設定や標準的な歩幅と考える必要はありません。
「次元のずれを補う」とは何か
元記事でいう次元は、データの列数や配列の軸数ではなく、更新する量の単位・尺度を指します。勾配を勾配の二乗平均の平方根で割ると、勾配の尺度が相殺されます。AdaDeltaは、そこに過去の更新量の二乗平均の平方根を掛け、パラメータの変更量に対応する尺度を与える発想です。
この説明は、微小定数の影響を除いた尺度の考え方です。入力データの単位や特徴量のスケールを自動でそろえる前処理ではないため、データの正規化や標準化が不要になるわけではありません。
AdaGrad・RMSProp・Adamとの違い
AdaDeltaを理解するには、「どの履歴を保持し、何に使うか」を比べると整理しやすくなります。以下は各手法の基本的な形を比較したものです。実装には派生形や追加機能があります。
| 手法 | 利用する主な情報 | 更新の特徴と確認点 |
|---|---|---|
| SGD | 現在の勾配 | 基本形では共通の学習率で更新する。学習率の設定や途中での変更が結果に影響する。 |
| AdaGrad | 勾配二乗の累積和 | パラメータごとに係数を調整する。まれに勾配が現れる特徴を扱いやすい一方、係数が小さくなりすぎる場合がある。 |
| RMSProp | 勾配二乗の指数移動平均 | 古い勾配の影響を弱め、最近の勾配の尺度で更新を調整する。基本形では別に学習率を与える。 |
| AdaDelta | 勾配二乗と更新量二乗の指数移動平均 | 過去の更新量の尺度も使って次の更新幅を計算する。原型と実装上の学習率係数の違いを確認する。 |
| Adam | 勾配の一次・二次モーメントの指数移動平均 | 勾配の方向の傾向と大きさを利用し、初期値による偏りも補正する。学習率などの設定は必要。 |
RMSPropとの共通点は、勾配二乗に指数移動平均を使うことです。AdaDeltaではさらに過去の更新量の二乗平均が更新式の分子に入ります。「RMSPropより常に高性能」という関係ではなく、更新幅を決めるために参照する情報が違います。
また、Adamで使う勾配の一次モーメントは、勾配の向きの傾向を平均するものです。AdaDeltaの更新量二乗の平均は、向きではなく更新の大きさを捉えます。どちらも履歴を使いますが、同じ情報を記憶しているわけではありません。
最適化手法は名前や複雑さだけでは選べません。同じモデルでも、データの性質、前処理、バッチサイズ、学習に使える時間によって結果が変わります。比較表は選択肢を理解する入口として使い、最終的には検証データで判断します。
AdaDeltaは学習率の設定が不要なのか
AdaDeltaは、原型の更新式において外部から一つの学習率を与えず、勾配と更新量の履歴から係数を作ります。この意味で、一律の学習率を手作業で決める負担を減らす手法と説明できます。
ただし、ライブラリの実装では、求めた更新量に追加で掛ける係数をlrやlearning_rateという名前で指定できる場合があります。「AdaDeltaなのに学習率の項目がある」のは、この追加係数を持たせているためです。原型の説明と、使用する実装の設定項目を区別しましょう。
| 設定項目 | 役割 | 確認すること |
|---|---|---|
| 減衰率(rho) | 過去の平均をどれだけ残すかを決める。 | 大きいほど履歴を長く残す。最近の変化への反応との兼ね合いを見る。 |
| 微小定数(epsilon / eps) | 分母などの計算を安定させ、初期の更新にも影響する。 | 値の変更は更新幅にも影響するため、単なる飾りの定数と考えない。 |
| 学習率係数(lr / learning_rate) | 実装によっては、算出した更新量の大きさをさらに調整する。 | 有無・既定値・適用方法を、利用するバージョンの仕様で確認する。 |
自動調整されるのは更新規則の一部です。モデル構造、バッチサイズ、正則化、学習回数などの選択は残ります。別の最適化手法で使った学習率をそのまま移すより、実装の推奨設定を出発点に、損失の推移を見ながら調整するほうが比較の意味をつかみやすくなります。
AdaDeltaの使いどころと学習での試し方
AdaDeltaは、画像分類、音声認識、自然言語処理など、勾配を使ってパラメータを学習するモデルで検討できます。例えば画像分類であれば、入力画像から予測を計算し、正解との損失を求め、その勾配をAdaDeltaへ渡して重みを更新します。入力が音声や文章でも、最適化手法が担当する部分は同じです。
特に学習上は、AdaGradからAdaDeltaへ変更して履歴の扱いを比較すると、適応的な最適化への理解が深まります。実務では、更新の停滞が見られる場合に比較候補へ入れられますが、原因がデータやモデルにあるときは、最適化手法だけ変えても解消しません。
小さな画像分類モデルで試すなら、次の手順で条件をそろえます。
- 学習用・検証用・テスト用にデータを分ける。設定の比較には検証用を使い、最終評価用のテストデータを繰り返し調整に使わないようにします。
- モデルとデータ処理を固定する。初期化条件、分割、前処理、バッチサイズをそろえ、まずは最適化手法の違いを見ます。
- 各手法の設定を適切な範囲で試す。SGD・RMSProp・AdaDeltaなどに、同じ数値の学習率を機械的に当てはめると不公平な比較になり得ます。
- 損失と評価指標を記録する。学習用の損失、検証用の損失や正解率、経過時間を並べて確認します。余裕があれば初期化を変えて再試行します。
- 目的に合う結果を選ぶ。少ない更新回数で改善したか、同じ時間でどこまで学習できたか、未知のデータへの性能はどうかを分けて判断します。
「速い」という言葉にも、必要な更新回数が少ないことと、実時間が短いことの違いがあります。AdaDeltaが一回ごとに履歴を更新する計算も含めて評価すると、実際の利用条件に合った選択ができます。
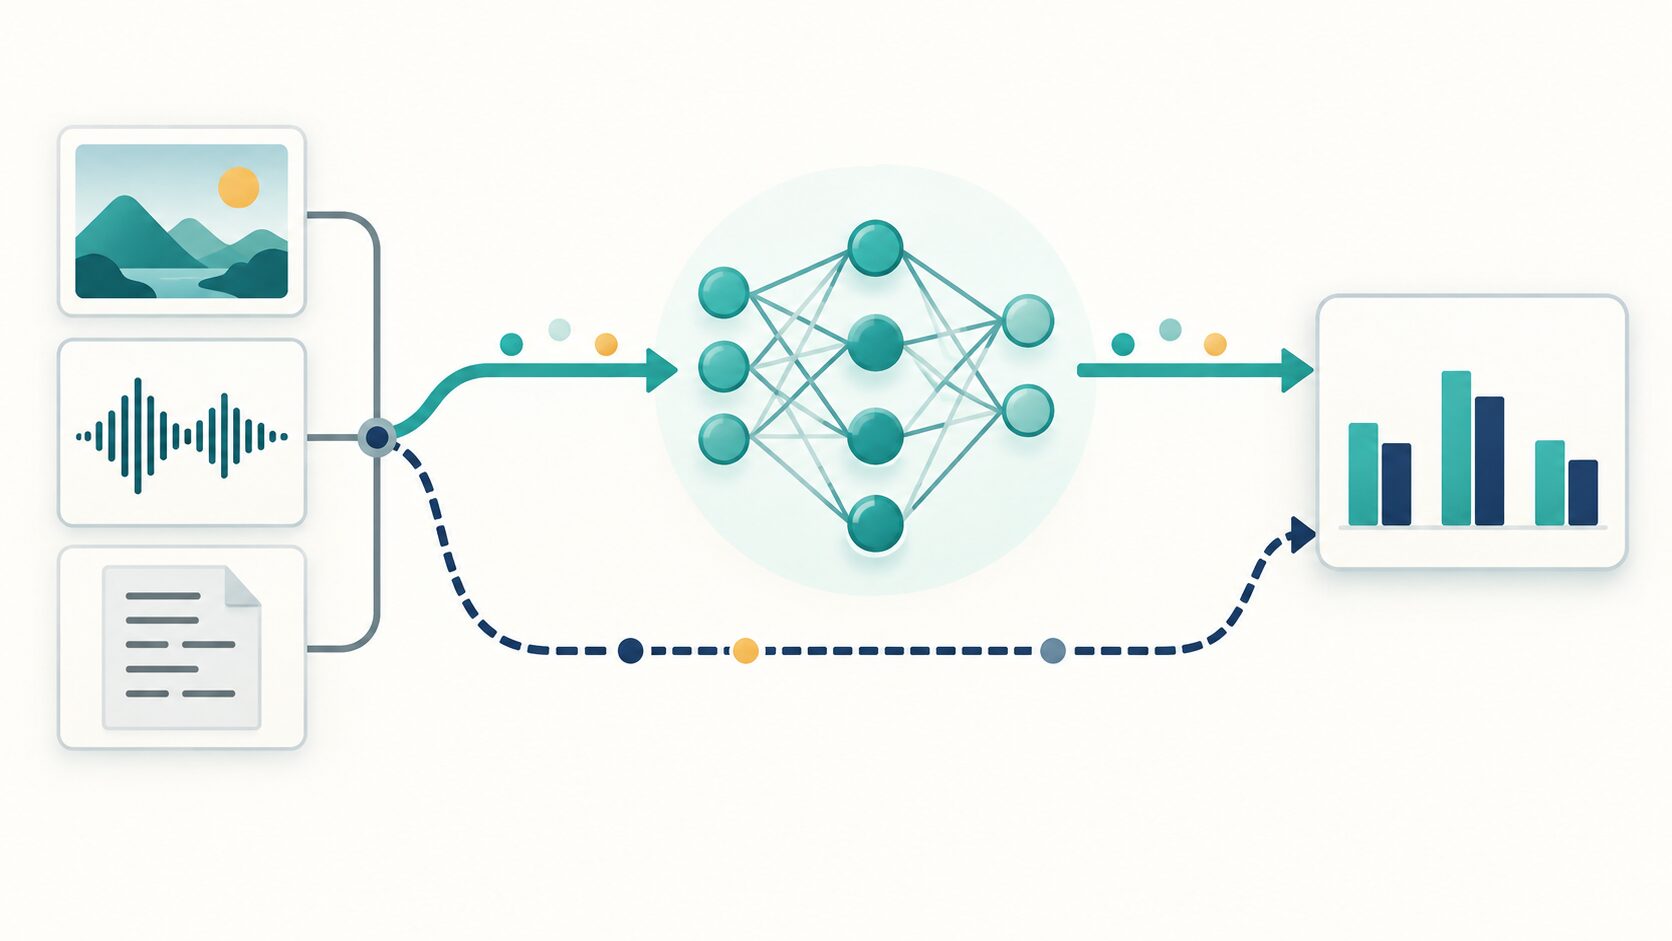
図は学習と検証を分ける考え方を表す概念図です。右側の図形は特定の手法の性能を示す数値ではありません。
AdaDeltaを使うときの注意点
安定した更新と、高い予測精度は別の問題です。AdaDeltaは勾配の尺度に応じて更新を調整しますが、損失が毎回下がることや、大域的な最適解に達することを保証しません。学習用データの損失が下がっても、検証用データで悪化していれば過学習の可能性があります。正則化や学習を止める時点も確認が必要です。
学習が進まないときは、最適化手法以外も点検します。入力のスケール、ラベルの誤り、損失関数と出力の組み合わせ、勾配が計算されているかを確認しましょう。途中で非数値の値が出る場合は、演算の不安定さも候補です。更新が小さいことだけを理由に、学習率係数を大きくすると原因を見失うことがあります。
履歴の保存にはメモリが必要です。基本的なAdaDeltaは、各パラメータに対応する勾配二乗と更新量二乗の平均を保持します。追加の状態を持たない基本形のSGDと比べると、その分の保存領域が増えます。大きなモデルでは、パラメータや勾配以外に必要なメモリも含めて見積もります。
学習を再開するときは、最適化手法の状態も引き継ぎます。重みだけを読み込み、二つの平均をゼロから始めると、続きの学習で使われる更新幅が変わります。再現性を重視する場合は、設定値、乱数の条件、データの分割とともに、オプティマイザーの状態を保存することが大切です。
これらを踏まえると、AdaDeltaの利点は「何も設定しなくても正解へ導いてくれる」ことではなく、最近の勾配と過去の更新の尺度を使い、歩幅の調整を更新規則に組み込めることにあります。
まとめ:勾配と更新量の履歴を組み合わせるのがAdaDelta
AdaDeltaは、AdaGradの勾配二乗の累積を指数移動平均へ置き換え、さらに過去の更新量の二乗平均を使って、パラメータごとの更新幅を調整します。古い勾配がいつまでも同じ重みで残ることを避けながら、更新量に対応する尺度を利用するのが仕組みの中心です。
RMSPropとは勾配二乗の移動平均を使う点が共通し、更新量の履歴まで参照する点が異なります。原型では外部の学習率を必要としませんが、実装には追加の学習率係数がある場合もあります。利用時には設定を確認し、学習曲線と検証結果を見ながらほかの手法と比較しましょう。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年9月26日 | 更新式と計算例を追加し、学習率の設定条件と関連手法の違いを明確化 |