
システム復旧の鍵、MTTRとは?意味・計算方法・改善策を解説

AIの初心者
「MTTR」ってどういう意味ですか?AIサービスの運用について調べていたら出てきたのですが、何を表す数値なのでしょうか?

AI専門家
ここでは「平均復旧時間」のことだよ。障害でサービスが使えなくなってから、再び使える状態に戻るまでの時間を、複数の障害について平均したものなんだ。
AIの初心者
復旧にどのくらい時間がかかるかを見るのですね。AIだけで使う言葉なのですか?
AI専門家
設備の保守やITシステムの運用全般で使う言葉だよ。AIサービスも障害で止まることがあるから、復旧までの時間を測り、対応のどこを改善すればよいか考えるのに役立つんだ。
MTTR(エムティーティーアール)は、障害から復旧するまでにかかった時間の平均を表す指標です。サービスが停止したときの対応力を把握し、利用者が使えない時間を短くするために活用します。
計算自体は時間の合計を件数で割るだけですが、「いつからいつまでを復旧時間とするか」が曖昧だと、数値を正しく比較できません。この記事では、MTTRの定義と計算例から、関連用語との違い、復旧を速める取り組み、評価するときの注意点まで順に説明します。
まずは、障害によって利用できなくなったサービスが、検知や対応を経て再び使える状態に戻る流れを押さえましょう。この一連の所要時間を障害ごとに記録することが、MTTRを求める出発点です。
MTTRとは:平均復旧時間の意味と測定範囲
MTTRは、障害が起きたときにどれだけ早く復旧できるかを把握するための指標です。同じ条件で比較するなら、値が小さいほど復旧にかかった時間が短いことを示します。ただし、故障の発生回数や操作のしやすさを直接表すものではありません。頻繁に停止するサービスでも、毎回すぐに復旧すればMTTRは小さくなります。
MTTRという略語には、Mean Time to RepairやMean Time to Recoveryなど、文脈によって異なる意味があります。機器を修理する時間に注目する場合と、サービスが利用可能になるまでの時間に注目する場合では、含める作業や待ち時間が変わります。本記事では、サービスへの影響が発生してから、事前に決めた利用可能な状態に戻るまでの「平均復旧時間」として扱います。
測定の起点はサービスに影響が出始めた時刻、終点は復旧条件を満たしたと確認できた時刻です。例えば、10時に利用できなくなり、10時5分に監視で検知、10時10分に対応を始め、10時40分に復旧を確認したなら、復旧所要時間は40分です。この定義では、担当者が作業した30分だけでなく、検知や対応開始を待った時間も含めます。
そのため、障害記録には少なくとも「影響発生」「検知」「対応開始」「復旧確認」の時刻を残します。影響の発生時刻が不明な場合は、ログなどから推定した値であることも記録すると、後から数値の意味を確認できます。復旧条件には、例えば「購入手続きが完了する」「主要な画面とAPIが所定の応答時間で動く」など、利用者の状態を確認できる基準を設けます。
また、サービスの復旧と、障害原因の恒久的な解消は別の作業です。予備機への切り替えや正常な旧版への切り戻しによって利用を再開できれば、定めた条件を満たした時点で復旧と扱えます。故障した機器の修理やプログラムの根本的な修正が後日になっても、その間ずっとサービス停止として計測するとは限りません。どちらの時間を測るかを、運用チーム内でそろえておくことが大切です。
MTTRの計算方法と具体例
\(\mathrm{MTTR}=\frac{T}{N}\)MTTRは「対象障害の復旧所要時間の合計」を「対象障害件数」で割って求めます。式の\(T\)は復旧所要時間の合計、\(N\)はその合計に含めた障害の件数です。分子と分母は必ず同じ障害を対象にし、時間の単位もそろえます。
例えば、あるサービスで1か月の間に3件の障害が発生し、それぞれの復旧に2時間、4時間、1時間かかったとします。いずれも同じ復旧条件で測定し、期間内に復旧を確認できた例です。
| 対象の障害 | 復旧所要時間 | 分に換算した時間 |
|---|---|---|
| 1件目 | 2時間 | 120分 |
| 2件目 | 4時間 | 240分 |
| 3件目 | 1時間 | 60分 |
| 合計(3件) | 7時間 | 420分 |
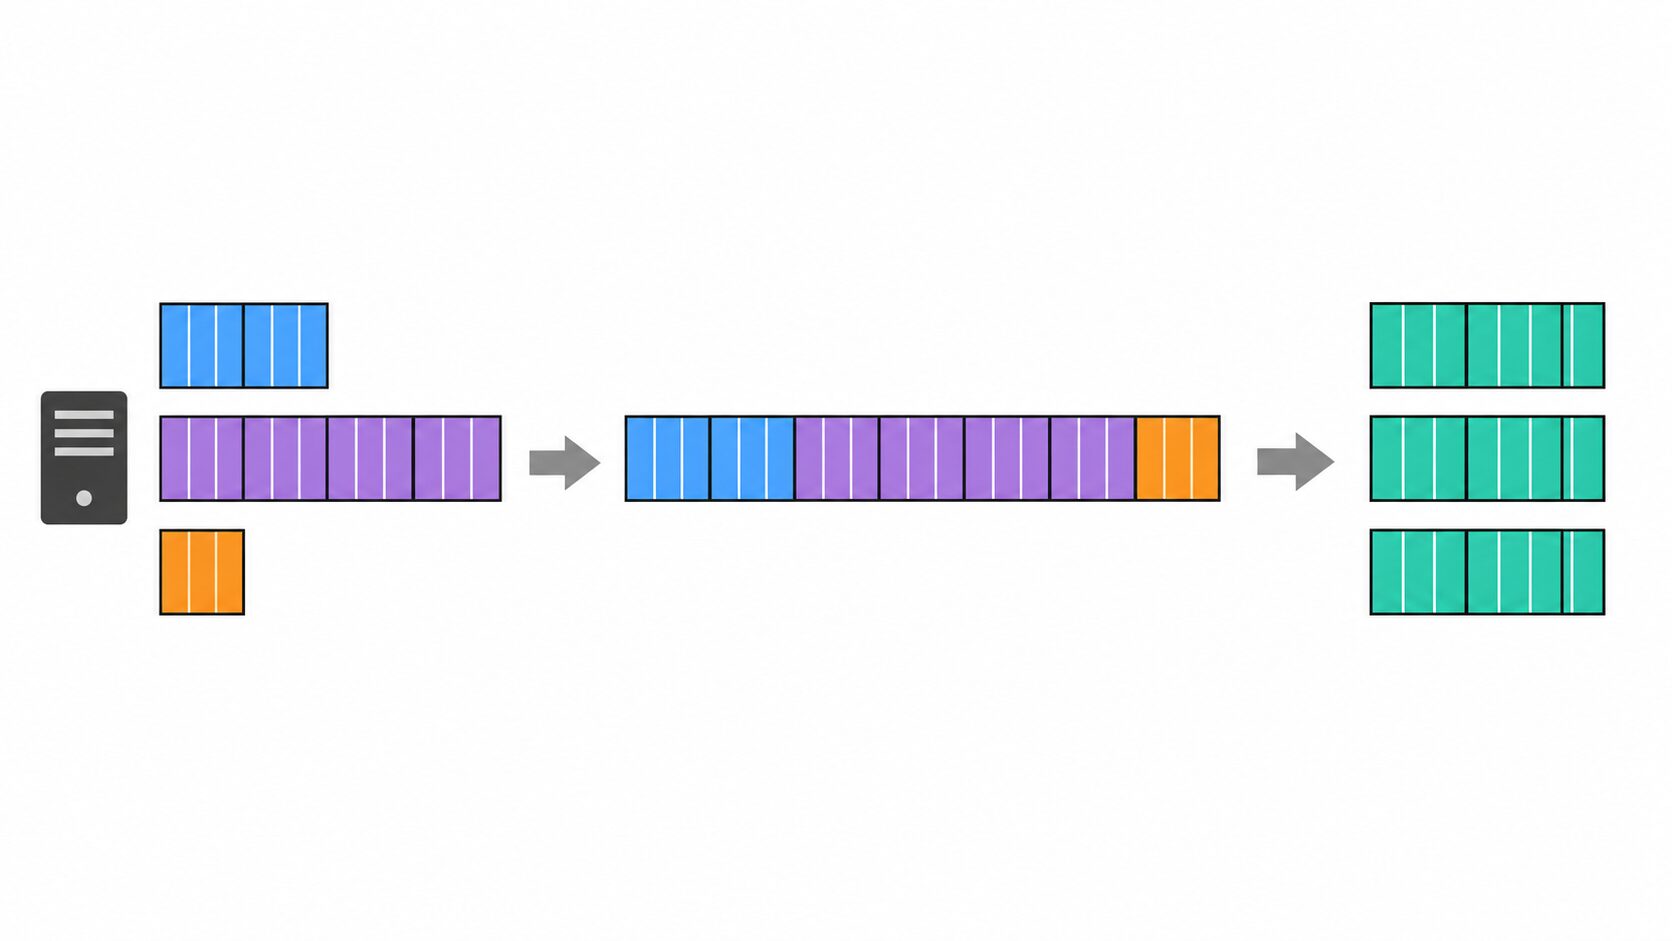
合計7時間を3件で割ると、MTTRは約2.33時間です。分で計算すれば、420分を3件で割った140分となります。したがって、この月の平均復旧時間は2時間20分です。「2.33時間」は2時間33分という意味ではないため、報告では時間と分で示すと誤解を防げます。
この計算例の要点は、3件それぞれの復旧所要時間を合計してから、同じ3件で割ることです。次の図は、その合計と平均の関係を示すものです。
実際の集計では、計算に先立って次の条件を決めておきます。単に「今月の障害」とだけ記録すると、担当者によって数える範囲が変わり、月ごとの比較が難しくなります。
- 対象サービスと集計期間:どのサービスの、どの期間の実績を測るか。
- 障害として数える条件:全停止だけでなく、一部機能の停止や性能低下も含めるか。
- 1件の数え方:一つの障害から複数の通知が出た場合や、複数機能に影響した場合をどうまとめるか。
- 復旧の判定条件:どの機能や処理を確認し、誰が復旧と判断するか。
例えば、メール機能だけが停止した場合、その機能を対象にする集計には含めます。一方、購入機能のMTTRを測るなら、購入への影響の有無に沿って判断します。一部機能の停止をすべて同じ重大度として扱うのではなく、影響するサービスや機能を記録することが必要です。
また、障害ごとの所要時間の合計と、サービス全体が停止していた時間は一致するとは限りません。別々に数える2件の障害が10時〜11時、10時30分〜11時30分に起きた場合、各障害の所要時間の合計は2時間です。ただし、サービスが使えなかった時間帯を重なりなく数えると1時間30分です。MTTR用の合計を、そのままサービスの稼働率計算に転用しないようにします。
月をまたぐ障害については、例えば「その月に復旧した案件を対象とし、前月に発生した案件も発生から復旧までの全時間を含める」と決めます。これは集計方法の一例であり、採用したルールを継続して使うことが重要です。未復旧の案件は、経過時間や事業への影響を別途報告し、完了した案件だけの平均から見落とさないようにします。対象障害が0件の期間は割り算ができないため、「対象0件・算出対象なし」と表示し、MTTRを0分とは扱いません。
復旧時間が事業継続と利用者に与える影響
復旧時間を短くする目的は、数値を小さくすることそのものではなく、利用者や事業が影響を受ける時間を減らすことです。システム停止が長引くと、売上に関わる処理ができないだけでなく、問い合わせへの対応や、復旧後の作業のやり直しも増える可能性があります。
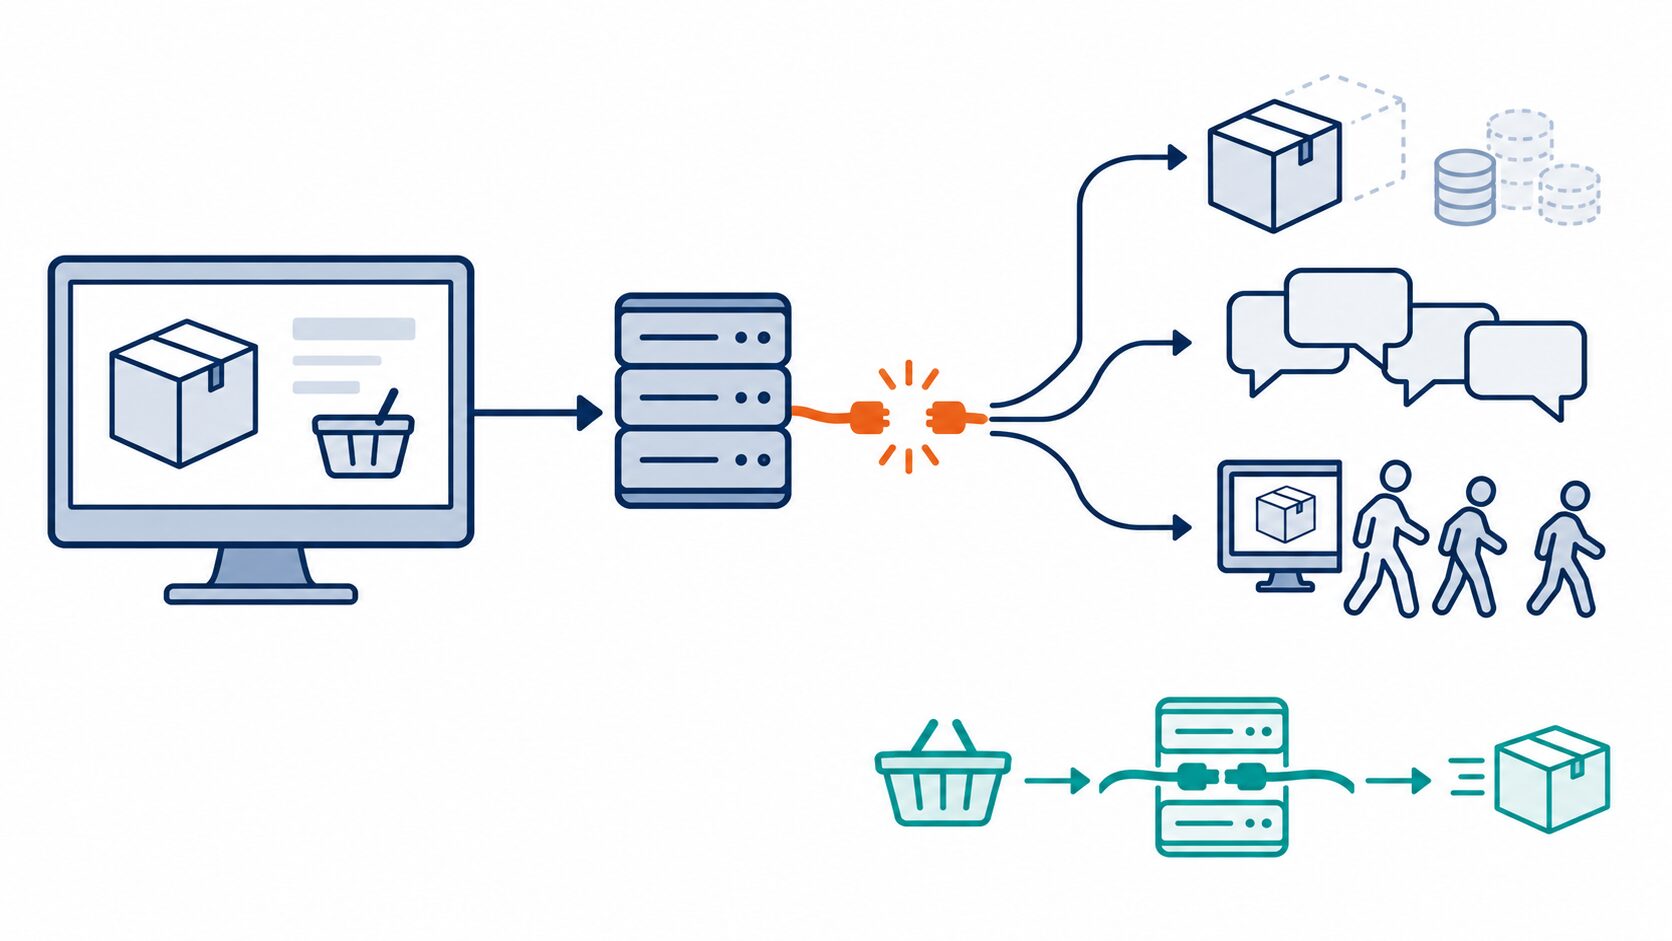
例えば、ECサイトで決済機能が停止すると、商品を選べても購入を完了できません。その場での販売機会を失うほか、購入できるか確認する問い合わせが増え、利用者が別の店へ移ることも考えられます。停止が繰り返されれば、再び利用しても大丈夫かという不安につながり、サービスへの信用にも影響します。
購入停止から販売機会の損失や利用者の不満へと影響が広がる関係を捉えると、技術担当者だけでなく、販売や問い合わせ対応の担当者と復旧の優先順位を共有しやすくなります。
同じ考え方は工場や社内業務にも当てはまります。生産管理システムが使えなければ製造や出荷の判断が遅れ、社内の申請・受発注システムが停止すれば、担当者の業務が滞ります。AIサービスでも、応答が得られないことで問い合わせ対応や業務支援が止まるなど、利用形態に応じた影響が生じます。
ただし、同じ1時間の停止でも、時間帯、止まった機能、影響を受けた利用者数によって事業上の重みは異なります。繁忙時間帯の決済停止と、利用の少ない時間帯の補助機能の停止を、時間だけで同じ損失と見なすことはできません。MTTRだけから損害額を求めたり、対応順位を決めたりせず、処理できなかった取引や業務の範囲も確認します。
事業継続に向けては、重要なサービスから復旧目標、担当者、連絡経路、必要な設備を整えます。復旧を速める準備に加え、日々の点検や変更時の確認によって障害を防ぐこと、停止中に利用できる代替手段を用意することも必要です。予備システムやバックアップを準備する際も、どの業務をどの状態まで再開するためのものかを明確にすると、対策を選びやすくなります。
MTBF・RTO・SLAとの違いと関係
MTTRは復旧の速さを表しますが、それだけでシステムの信頼性全体は判断できません。障害の起こりにくさ、復旧の目標、利用者との合意を分けて考えると、数値の役割が明確になります。
| 用語 | 意味・位置付け | MTTRと併せて確認する点 |
|---|---|---|
| MTTR(平均復旧時間) | 対象障害から復旧までにかかった時間の平均。本記事ではサービス復旧の実績を扱う。 | どの範囲を測り、何件を集計したか。 |
| MTBF(平均故障間隔) | Mean Time Between Failures。修復して使い続ける対象の、故障と故障の間の平均稼働時間。 | 復旧の速さに加えて、故障の起こりにくさも見る。 |
| RTO(目標復旧時間) | Recovery Time Objective。業務やサービスを復旧させるまでの目標時間。 | 実績の平均だけでなく、個々の復旧が目標に収まったか。 |
| SLA(サービス水準合意) | Service Level Agreement。提供者と利用者が合意するサービス水準や、その測定条件など。 | 復旧に関する条件がある場合、平均の条件か、個々の障害に対する条件か。 |
MTBFは、修復可能な機器やシステムが故障の間にどれだけ稼働できたかを見る指標です。対象期間の稼働時間を故障回数で割って求める場合、復旧のために停止していた時間は稼働時間に含めません。「故障が少ないか」をMTBFで、「故障後に早く戻せるか」をMTTRで見ると、それぞれの課題を区別できます。
例えば、毎日短時間だけ止まるサービスと、めったに止まらないものの一度止まると長時間かかるサービスでは、必要な対策が異なります。前者では障害の発生原因を減らすこと、後者では復旧の手順や代替設備を整えることが重要になります。
次の図は、稼働と復旧を繰り返す時間軸で、MTBFとMTTRが着目する時間を分けるためのものです。対象と定義をそろえた上で、MTBFが長く、MTTRが短いほど、利用可能な状態を保ちやすくなります。
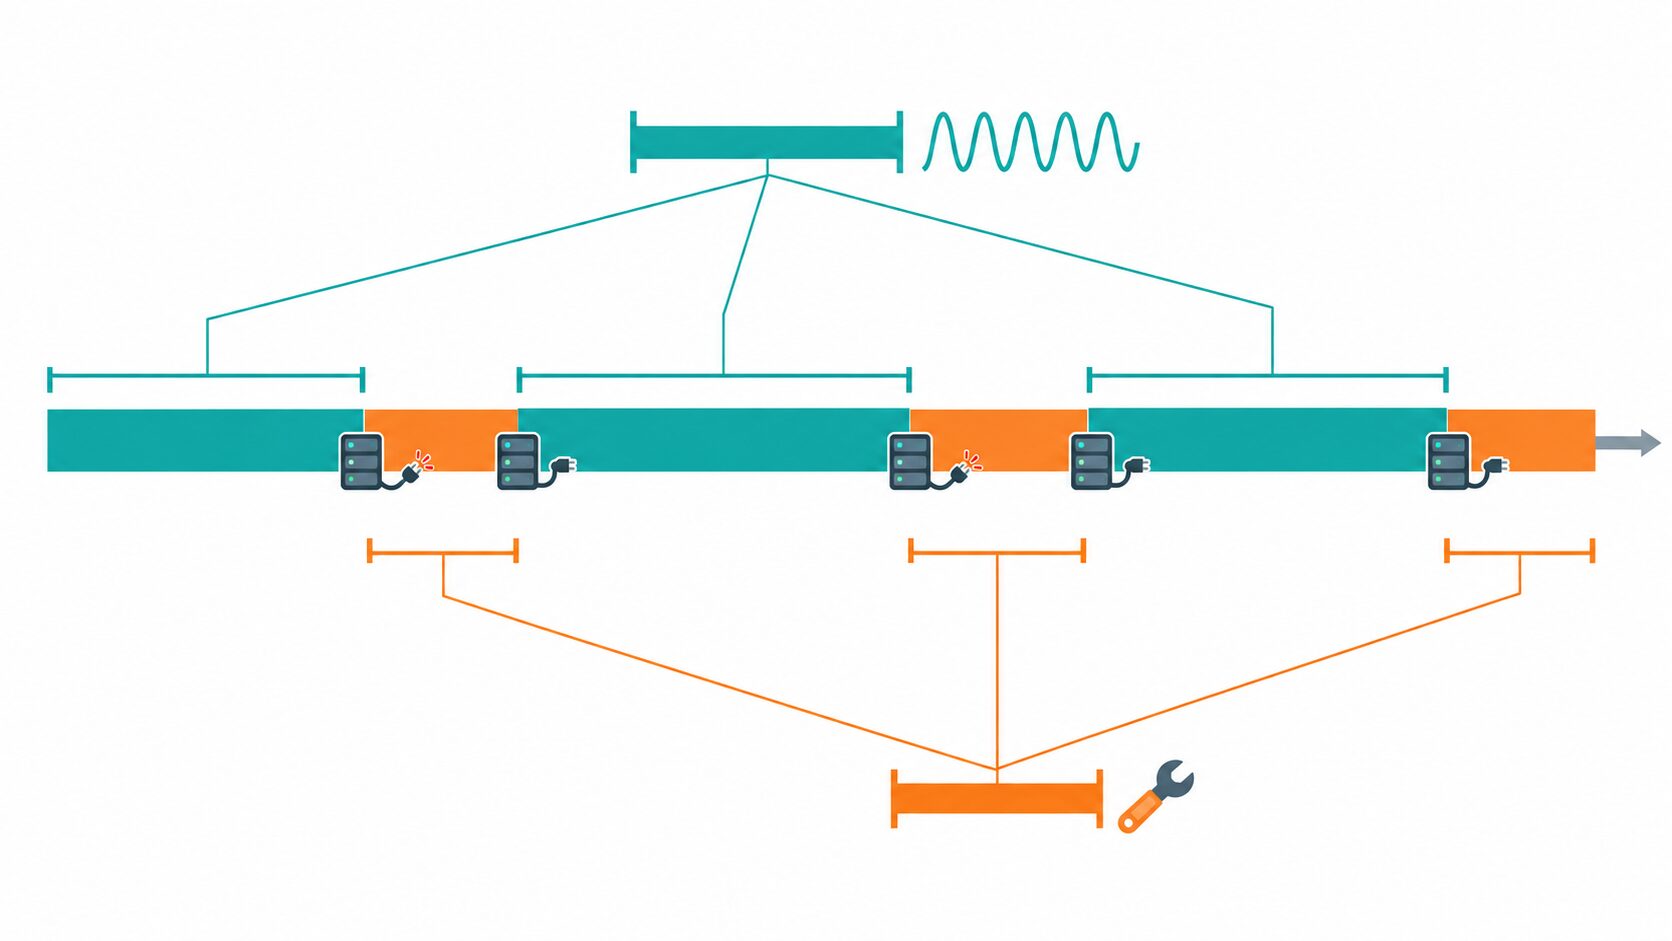
一方、RTOは目標、MTTRは実績の平均です。先ほどの3件の例では、MTTRは2時間20分でした。仮に各障害の復旧目標を3時間としていても、4時間かかった1件は目標を超えています。平均が目標内に収まったからといって、すべての障害で目標を達成したことにはなりません。比較する際は、RTOが対象とする業務や復旧状態と、実績側の測定条件も合わせます。
SLAは指標そのものではなく、サービス水準についての合意です。内容によっては、稼働率や問い合わせへの応答時間、復旧に関する条件などが定められます。「月内の平均復旧時間」と「各障害を何時間以内に復旧するか」は異なる条件なので、対象となる障害、集計期間、測定の起点と終点、対象外となる事象を確認します。MTTRが短いことだけを根拠に、SLA全体を満たしていると判断しないことが大切です。
MTTRを短縮する具体的な取り組み
MTTRを改善するには、障害対応をひとまとまりにせず、検知、調査・判断、復旧作業、復旧確認の各段階に分けます。どこで時間がかかっているかによって、効果のある対策は変わります。作業手順が速くても通知が担当者に届くまでに時間がかかるなら、まず連絡経路を見直す必要があります。
| 段階 | 具体的な取り組み | 確認したいこと |
|---|---|---|
| 検知・通知 | エラー、応答時間、主要機能の利用可否を監視し、当番や代替担当者へ通知する。 | 実際の異常を検知でき、必要な担当者が通知を受け取れるか。 |
| 調査・判断 | ログ、構成情報、直前の変更履歴を参照できるようにし、連絡先と判断する担当者を決める。 | 情報の収集や切り替え判断の待ち時間が長くなっていないか。 |
| 復旧作業 | 手順書、予備部品、冗長構成、切り戻しやバックアップからの復元手順を準備する。 | 必要な権限と資材があり、手順どおりに作業できるか。 |
| 復旧確認 | 主要な利用操作と監視値を確認し、定めた復旧条件を満たすか判定する。 | 機器の起動だけでなく、利用者が必要な処理を完了できるか。 |
監視はツールを導入するだけでは十分ではありません。通知が多すぎて重要な異常が埋もれていないか、夜間や担当者不在時に誰が対応するかも確認します。調査の段階では、ログの保存場所やアクセス方法が共有されていると、情報を探す時間を減らせます。障害の最中に初めて権限を申請することがないよう、必要な準備をしておきます。
復旧手順書には操作だけでなく、その手順を使う条件、実行前の確認事項、失敗時の連絡先も記載します。担当者への教育と定期的な訓練を通じて、特定の人だけが復旧できる状態を減らすことが重要です。訓練で見つかった古い記述や不足情報は、その都度更新します。
予備部品や冗長化も、交換や切り替えの方法が機能して初めて役立ちます。バックアップについても、保存に成功しているかだけでなく、実際に復元できることと、復元に必要な時間を確認する必要があります。データ量や手順によっては、復元だけで目標時間を使い切ってしまうため、訓練の中で所要時間を測っておきます。
各工程と対策を対応付けると、監視の改善が必要なのか、情報の参照環境や切り戻しの準備が足りないのかを具体的に検討できます。
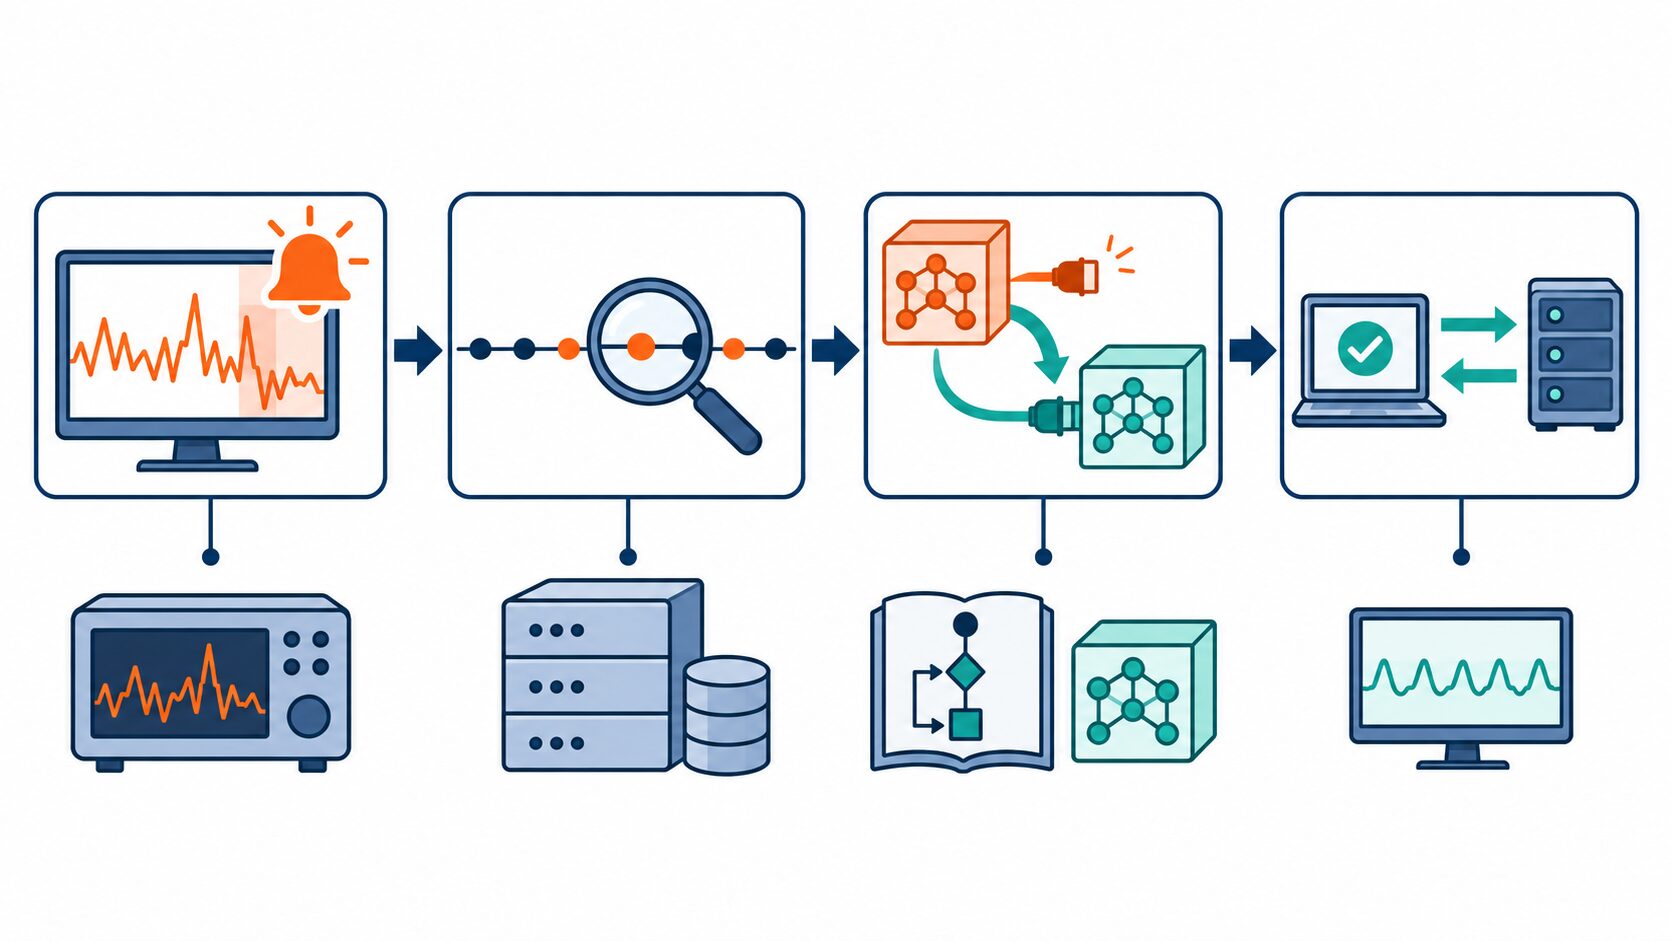
AIサービスなら、モデルを更新した直後に応答エラーが増えた場面を考えると、対応の流れをつかみやすくなります。
- 監視でエラー率の上昇や応答不能を検知し、影響が始まった時刻を記録する。
- ログと変更履歴を調べ、更新したモデルや設定に関連する問題か、ほかの要因かを切り分ける。
- 事前に決めた判断基準に沿って、動作確認済みの旧版へ切り戻す。関連する設定や接続先との整合性も確認する。
- 代表的な入力で応答を確かめ、エラー率や応答時間などが復旧条件を満たすことを確認する。
切り戻しによってサービスを再開した後も、更新したモデルで問題が起きた原因の調査と修正は続きます。復旧を急ぐ段階と恒久対策を行う段階を分けることで、利用者への影響を抑えながら再発防止に取り組めます。
対応後は工程別の時間を振り返り、長くかかった箇所に絞って改善します。例えば、影響発生から検知までが長ければ監視、切り替えの判断待ちが長ければ権限や連絡体制を見直します。原因分析や設計・運用の修正は、復旧時間の短縮に加えて、同じ障害の発生頻度を減らすことにもつながります。
平均値に隠れる問題と継続的な見直し
MTTRは全体の傾向を見るのに便利ですが、平均値だけでは障害ごとのばらつきが分かりません。少数の長時間障害が平均を押し上げることもあれば、短時間の障害が多数あることで、深刻な1件が平均の中に埋もれることもあります。
例えば、9件が10分で復旧し、1件だけ310分かかった場合、MTTRは40分です。平均だけを見ると1時間未満でも、実際には5時間以上影響が続いた障害があります。反対に、短い障害が多いことで平均が下がった場合、頻繁に使えなくなるという利用者の困りごとが改善したとは限りません。
MTTRは障害件数、中央値、最大値、個別事例と併せて確認します。中央値は所要時間を順に並べたときの中央の値で、普段の復旧に近い傾向を知る手掛かりになります。最大値と個別の記録からは、長引いた障害で何が起きたかを追えます。どの値も一つだけで判断せず、事業への影響や目標を超えた件数と結び付けて読むことが重要です。
継続的な比較では、対象サービスや重大度ごとに分け、同じ定義と条件で推移を見ます。重大な障害を集計から外したり、軽微な障害を新たに含めたりすると、対応力が変わっていなくても平均値は変化します。監視や復旧判定の基準を変えた場合も、その変更を記録し、数値の変化をすべて改善効果と取り違えないようにします。未復旧案件の件数と経過時間も、別に追い続けます。
MTTRに、すべてのサービスへ当てはまる一律の理想値はありません。事業への影響、求められる復旧状態、現在の所要時間を踏まえ、実現に必要な体制や費用も考えて目標を決めます。平均の目標とは別に、重大な障害の復旧目標や、長時間化した際の連絡・判断の基準を設けると、実務で行動に結び付けやすくなります。
数値を下げるために、データの整合性確認や主要機能の動作確認を省くと、復旧直後の再停止につながりかねません。必要な確認を保ちながら、探す時間や待つ時間、手順の迷いを減らすことが改善の基本です。測定、振り返り、訓練、手順の更新を繰り返し、障害が起きても着実に利用を再開できる体制を育てていきましょう。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月4日 | 復旧時間の測定範囲と計算例を補い、RTOとの違いや平均値の注意点を追記 |