
ゼロショット学習とは?仕組み・活用例・few-shotとの違いを解説

AIの初心者
「Zero-shot」って、どういう意味ですか?AIは何も学習しなくても答えられるのでしょうか?

AI専門家
何も学んでいないわけではないよ。たとえば学習済みの言語モデルに、完成例を見せずに「この文章を要約して」と頼む使い方がゼロショットに当たるんだ。すでに学んだ知識を使い、今の課題の見本なしで取り組むということだね。
AIの初心者
ゼロなのはAIの学習経験ではなく、その課題の見本なんですね。見本をいくつか見せる使い方とは違うのですか?
AI専門家
そうだよ。言語モデルへの指示に少数の見本を入れる使い方はfew-shotと呼ぶんだ。また、画像分類では未知の分類先を説明や特徴から見分ける意味でもゼロショットという言葉を使うよ。どの場合も、追加学習なしで必ず正解できるわけではないので、結果の確認が大切なんだ。
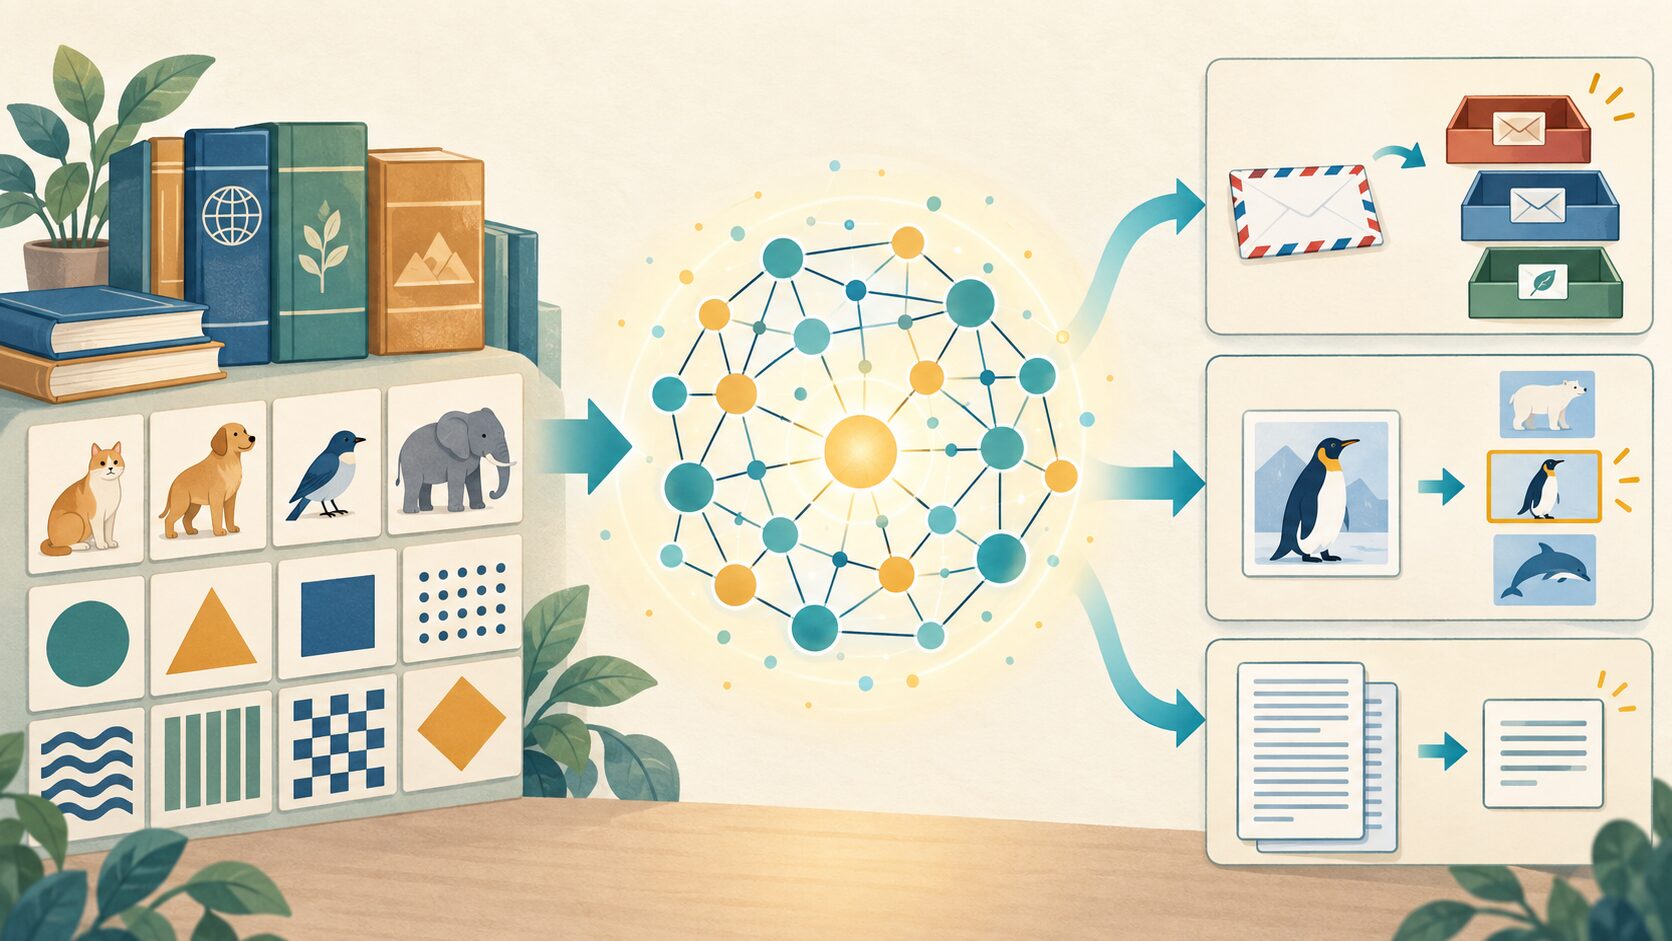
生成AIに「この文章を要約して」「問い合わせを種類ごとに分けて」と頼むと、正解の見本を見せなくても結果が返ってくることがあります。このように、学習済みの知識を使い、対象の課題の見本を与えずに取り組ませる考え方が、ゼロショット(zero-shot)です。
ただし、「ゼロショット学習」という名前は、AIが何も学ばずに動くことを意味しません。この記事では、何が「ゼロ」なのかを起点に、仕組み、few-shotや追加学習との違い、プロンプトの具体例、業務で試す際の評価方法まで解説します。
ゼロショット学習とは?「ゼロ」が指すもの
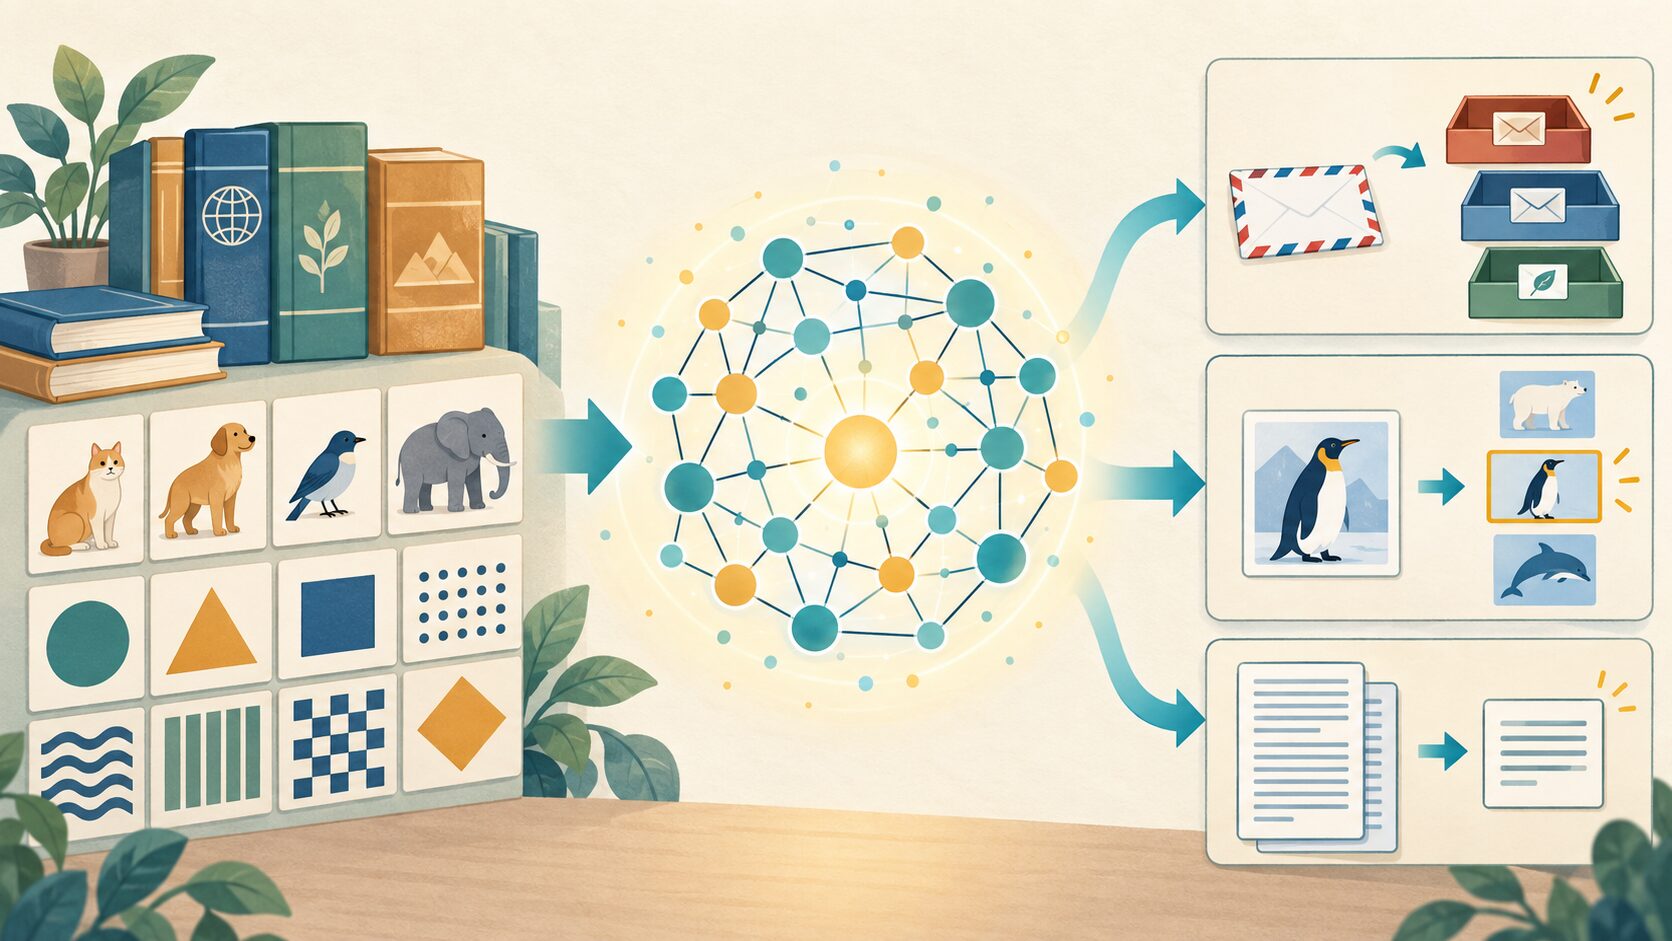
ゼロショット学習は、対象の課題やクラスについて、正解付きの見本を使わずに予測・処理を行うための考え方です。ここでいうクラスとは、「犬」「猫」といった分類先のことです。ゼロにする見本が何を指すかは、言語モデルと画像分類などで少し異なります。
大規模言語モデル(LLM)の利用では、一般に、プロンプトにその課題の「入力と正解の組」を入れず、指示と処理対象だけを渡す方法をゼロショットプロンプティングと呼びます。たとえば、完成した要約の見本を載せずに、記事本文を渡して「要点を3つにまとめて」と依頼する使い方です。文章を理解し、要約を組み立てる土台には、モデルが事前学習などで得た能力があります。
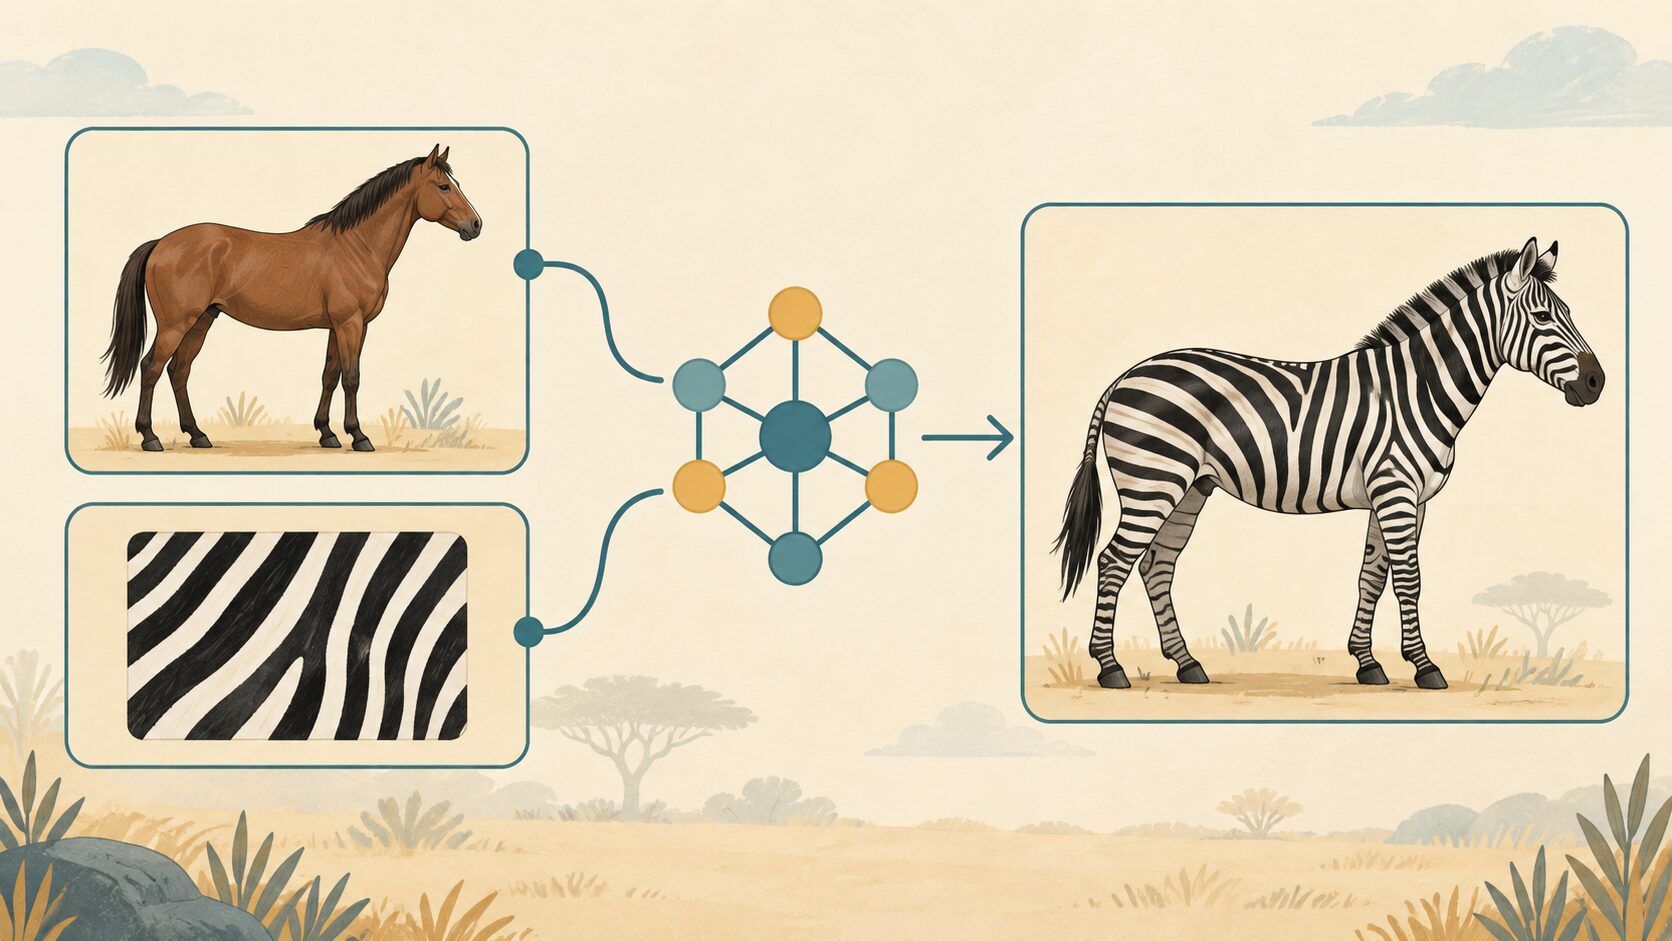
一方、画像分類などでのゼロショット学習は、学習時に正解付きの画像例を使っていないクラスを、属性や説明文を手掛かりに識別する設定を指します。シマウマの画像と「シマウマ」という正解の組を学習に使わなくても、「馬に似た体形で、白黒の縞模様がある」という情報を、画像の特徴と結び付ける考え方です。
共通するのは、すでに得た知識を、対象に固有の見本がない状況へ応用する点です。AIを作る段階の学習データや計算が不要になるわけではありません。また、犬の写真で学習したモデルが別の犬の写真を当てることは、未見の入力への予測ではあっても、それだけで未知のクラスへのゼロショット分類にはなりません。
ゼロショット学習の仕組み:既存知識と説明を結び付ける
ゼロショットで処理するには、学習済みの知識と新しい対象を結び付ける手掛かりが必要です。その手掛かりには、言葉による指示、分類先の名前、対象の特徴を表した属性や説明文などがあります。未知の対象を、何の情報もないまま見抜く仕組みではありません。
画像分類を例にすると、あらかじめ「馬に似た形」「縞模様」といった特徴を扱えるモデルを用意し、新しい分類先にそれらの属性を対応付けます。入力画像から読み取った特徴と、シマウマの属性がよく一致すれば、シマウマを候補として選べます。ただし、縞模様だけでは他の動物と区別できないため、複数の特徴を組み合わせることが大切です。
画像と言語の関係を学習したモデルでは、画像と候補の説明文をそれぞれ数値的な特徴に変換し、対応の強さを比べる方法もあります。「シマウマの写真」「茶色い馬の写真」などの候補と照合し、入力画像に合うものを選ぶイメージです。候補名だけで意味が伝わりにくい場合、具体的な説明を添えることで判断材料を増やせます。
LLMでは、指示と対象の文章を読み、事前学習や指示に従うための学習で得た能力を使って応答を生成します。問い合わせの分類なら、文章の意味とラベルの定義を対応付けます。通常、この応答のたびにモデルの内部パラメーターである「重み」を学習し直すわけではありません。
したがって、犬と猫の2種類だけを出力するよう作った分類器に「馬を見分けて」と書けば、そのまま対応できるとは限りません。指示を理解する機能や、特徴と新しい分類先をつなぐ仕組みが必要です。人間が経験を応用する様子は理解の助けになりますが、それだけでAIが人間と同じように理解・思考していると判断することはできません。
zero-shot・one-shot・few-shot・追加学習の違い
LLMを使うときは、「プロンプトに見本を何件入れるか」と「モデル自体を学習で変更するか」を分けて考えると、関連用語を理解しやすくなります。zero-shot、one-shot、few-shotは、プロンプティングの文脈では主に見本の数の違いを表します。
| 方法 | 問い合わせ分類での使い方 | モデルの重みの更新 | 主な検討場面 |
|---|---|---|---|
| zero-shot | 分類基準と分類したい文章を渡す。正解付きの見本は入れない | 通常は行わない | 指示で伝わる課題をまず試したい |
| one-shot | 問い合わせ文と正解ラベルの組を1件示す | 通常は行わない | 出力形式や判断の一例を示したい |
| few-shot | 問い合わせ文と正解ラベルの組を少数示す | 通常は行わない | 紛らわしい分類先の境界を例で伝えたい |
| ファインチューニング(追加学習・微調整) | 用意した学習データで、分類などの課題に合わせてモデルを調整する | 行う | 繰り返し使う課題にモデルの振る舞いを適応させたい |
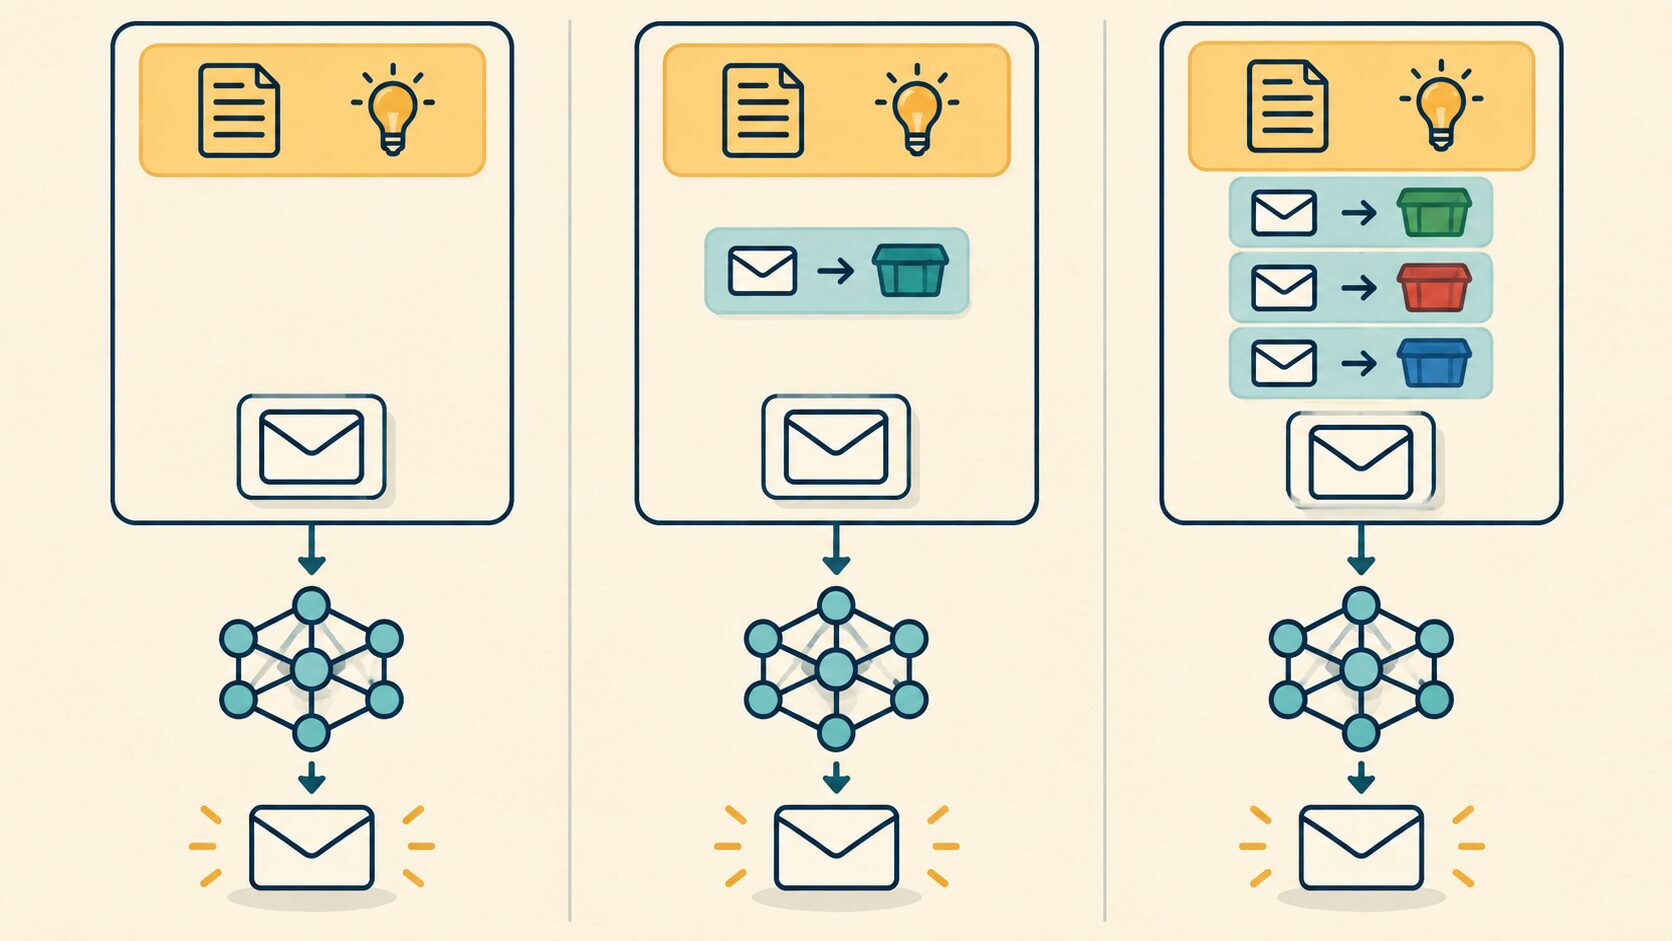
たとえば、「電源が入らない」という問い合わせと「故障」という正解の組を1件だけ指示文に添えると、one-shotの例になります。配送、料金、故障の見本をいくつか示せばfew-shotです。見本はその場の判断材料として使われ、通常のチャット入力だけでモデルの重みが更新されるわけではありません。
なお、研究分野のfew-shot learningは、少数の学習例から新しい課題へ適応する方法全般を指す場合があり、必ずしもプロンプトへの例示だけに限定されません。「few-shot」という語を見たら、入力に例を添える話か、学習方法の話かを確認しましょう。
関連する「転移学習」は、ある課題などで得た知識を別の課題へ利用する広い考え方です。ファインチューニングはその代表的な方法の一つで、ゼロショットでも知識の転用が重要になります。ただし、これらの用語は単純な同義語ではありません。また、追加学習済みのモデルを見本なしで使うこともできるので、モデルの学習履歴と、利用時の例示数は別の軸として捉えます。
ゼロショットプロンプトの具体例と書き方
ゼロショットで依頼するときは、短く命令することよりも、何を基準にどう答えてほしいかを明確にすることが大切です。目的、判断基準、処理対象、出力形式をそろえると、モデルが推測で補わなければならない部分を減らせます。
次は、問い合わせ文を分類するためのプロンプト例です。分類先の定義は書いていますが、正解付きの見本は示していません。
次の問い合わせを、指定した分類基準に従って分類してください。

分類基準:
・配送:発送状況、配送日時、届かない荷物に関する問い合わせ
・料金:価格、請求、支払いに関する問い合わせ
・故障:製品が動かない、正常に機能しないことに関する問い合わせ
・その他:上記に当てはまらない問い合わせ
・要確認:情報が不足している、または複数の分類に当てはまり一つに絞れない問い合わせ

出力形式:
1行目に分類名、2行目に判断理由を短く書いてください。
問い合わせ文にない事情は補わないでください。

問い合わせ文:
「説明書どおりに充電しましたが、購入した機器の電源が入りません。」
この対象文なら、「故障」を選び、機器が動かないことを理由に挙げるのが想定される回答です。分類基準を渡すことと、入力・正解の見本を渡すことは違います。また、記事本文や問い合わせ文を渡すのは処理対象の提示であり、それだけでfew-shotになるわけではありません。
一方、「商品が届かず、請求額にも心当たりがない」という文章には複数の論点があります。こうした場合に一つだけ選ぶのか、複数選択を認めるのか、担当者へ回すのかを決めておくと、出力の揺れを減らせます。上の例では、そのような文章を「要確認」とする基準を設けています。
要約なら「誰が読むのか」「何を残すか」「長さ」、翻訳なら「対象言語」「文体」「固有名詞の扱い」も指定します。ただし、指示を細かくすれば必ず正しくなるわけではありません。少数の実例で結果を確認し、失敗の原因に合わせて指示を直すことまで含めて取り組みましょう。
ゼロショット学習の活用例:文章・画像・音声から業務まで
ゼロショットが役立つのは、専用の正解データをまだ用意できていない課題や、分類基準を変えながら試したい場面です。ただし、扱える入力の種類や分野はモデルによって違います。文章を扱うモデルに画像や音声もそのまま処理させられるとは限らないため、課題に合う機能を備えたモデルを選びます。
| 分野 | 考えられる活用 | 実際に試すときの確認点 |
|---|---|---|
| 自然言語処理・ビジネス | 問い合わせやレビューの分類、議事録の要約、翻訳、文書に関する質問への回答 | 社内用語、分類基準、原文にない内容の混入、重要事項の抜け |
| 画像認識 | 写真と候補の説明文を照合し、物体の分類や画像の検索を行う | 候補の説明の適切さ、類似物体、背景や撮影条件の影響 |
| 音声処理 | 対象業務の追加学習をせず、対応モデルで音声の文字起こしや翻訳を試す | 対応言語、方言、雑音、話者の違い、専門用語 |
| 教育 | 教材の言い換え、理解度に合わせた説明、練習問題の案の作成 | 内容の正確さ、学習段階との適合、問題と解答の整合性 |
| 製造・品質管理 | 製品画像と正常・異常の説明を照合し、点検を支援する方法を検討する | 微細な欠陥の見逃し、現場固有の製品や照明への適合 |
| 医療・研究支援 | 研究文献の要約や情報整理、画像と言語を結び付ける手法の検討 | 専門家による確認と用途ごとの検証。診断能力が保証されるわけではない |
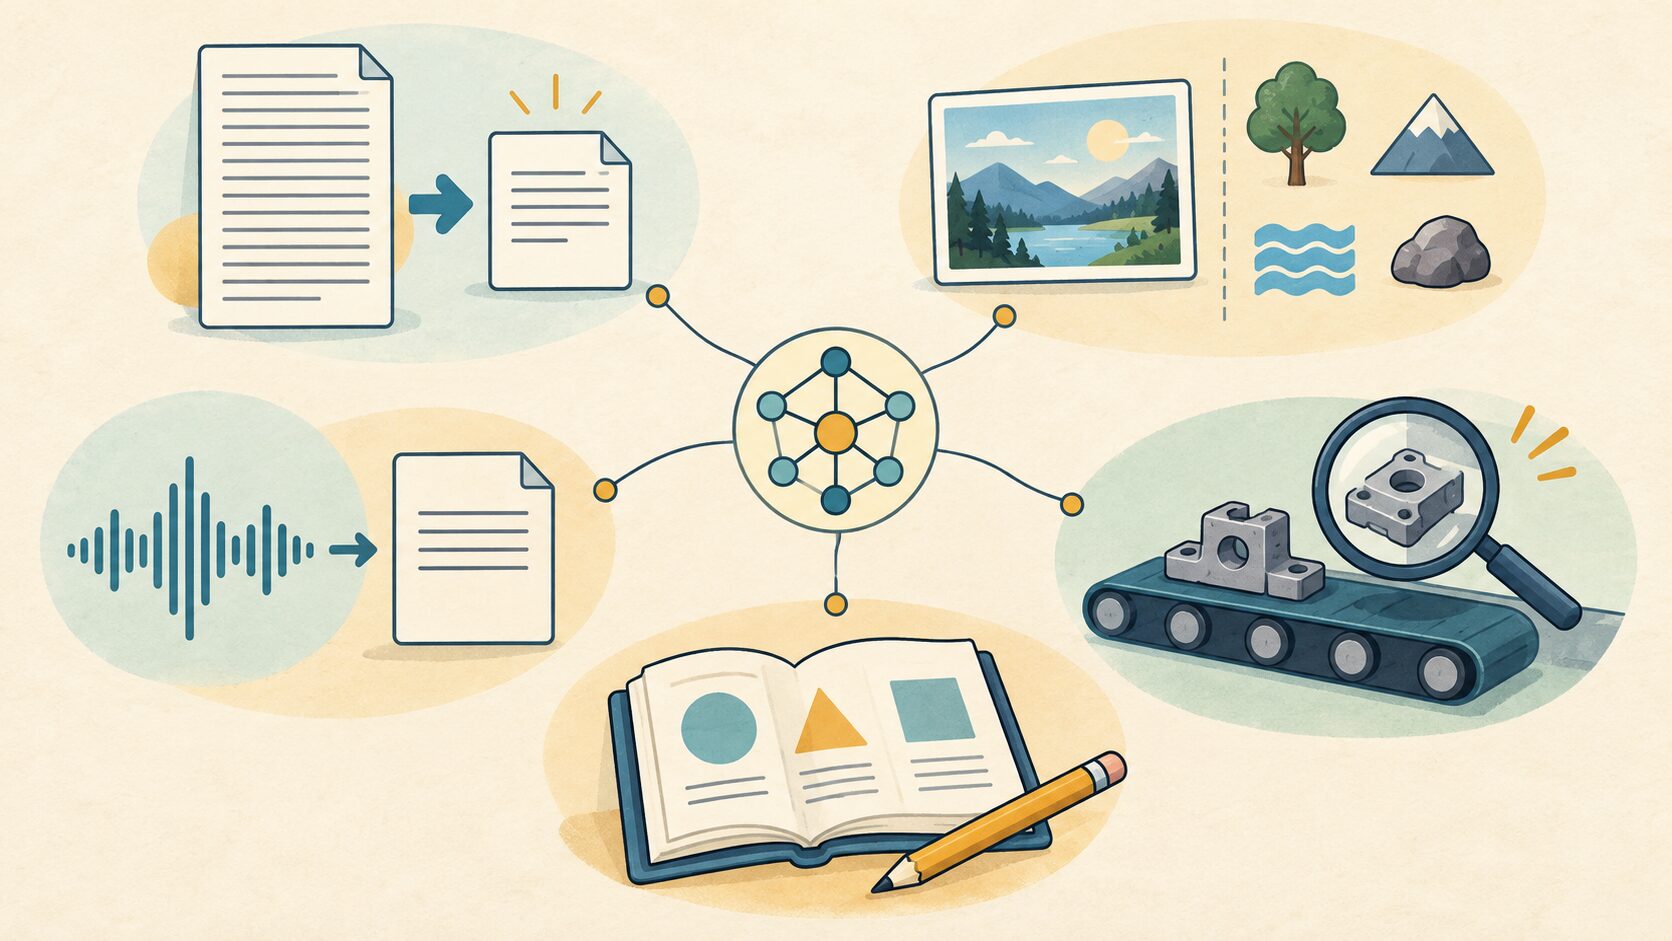
たとえば、新商品のレビューを「使いやすさ」「外観」「価格」などの観点に分けたいとき、まず各観点を説明して分類を試せます。大量のレビューに人手で正解を付ける前に、分類先の設計が実用的かを検討できる点が利点です。教育でも、教材本文と想定する学年を渡せば、説明文の案を作る入口になります。
画像から説明文を作ることや、多言語の音声を扱うことも関連する応用ですが、できたという事実だけで厳密なゼロショット評価を示すわけではありません。対象の課題・言語・分類先が、どの学習や例示から除かれているのかという条件が必要です。
医療の診断や自動運転などへの応用は、用途ごとの能力を検証する前提で考える必要があります。ある分類課題で良い結果が出ても、別の専門領域での判断能力まで裏付けるものではありません。
メリット:データ準備と試行の負担を減らせる
ゼロショットの大きな利点は、対象課題に合わせた学習データの収集や正解付けを、試作の前提にしなくてよいことです。すでに適切なモデルが利用できれば、指示と入力を用意して結果を確かめられます。新しい業務でAIが役立ちそうかを、早い段階で検討しやすくなります。
分類先の変更にも対応しやすい場合があります。問い合わせの「配送」を「発送前」と「発送後」に分けたいなら、まず分類基準を書き換えて試せます。新しい基準で大量のデータを作り直す前に、区分が明確か、利用者の文章から判断できるかを確認できます。ただし、出力先が固定された分類器では同じやり方は使えず、モデルの仕組みに依存します。
また、共通の学習済みモデルを要約・分類・質問応答などに活用できれば、課題ごとに専用モデルを準備する負担を抑えられます。ここで省きやすいのは、対象課題向けの追加学習の手間です。元のモデルの学習コストや、実行時の利用料金、応答の待ち時間、評価と運用の作業までなくなるわけではありません。
継続運用では、一回の実行費用だけでなく、人が結果を確認・修正する時間も含めて比較しましょう。準備が軽い方法でも誤りの確認に時間がかかるなら、見本を追加する方法や専用の仕組みを検討する余地があります。
注意点:追加学習なしでも正しさは保証されない
ゼロショットは、あらゆる未知の課題に成功する保証ではありません。モデルが扱える知識や入力形式に依存し、事前学習で十分に扱われていない分野、専門的な表現、曖昧な依頼などでは結果が不安定になることがあります。説明の自然さと内容の正しさも分けて見る必要があります。
- 必要な情報が入力にもモデルにもない:社内だけで使う商品コードを、その意味を教えずに分類させても、正しい判断材料がありません。コード表や用語の説明を渡す必要があります。
- 分類先が重なっている:「不満」と「返品希望」のように同時に当てはまりやすい区分では、優先順位や複数選択のルールがないと判断が揺れます。
- 指示や候補の表現に影響される:ラベル名、説明の詳しさ、候補の並べ方などが結果に影響する場合があります。一つの言い方での成功だけでは安定性を判断できません。
- 候補の中に正解がない:実際にはどの分類にも当てはまらない入力でも、最も近い候補へ無理に振り分けることがあります。「その他」「要確認」の扱いも設計します。
- 自信のある回答でも間違う:LLMが示す理由や自己申告の確信度だけで、正解を保証できるわけではありません。原文や正解データとの照合が必要です。
さらに、LLMへの指示に見本を入れていなくても、そのモデルが事前学習で類似した問題や文章に触れた可能性はあります。利用者から学習データの全体が分からない場合、「一度も見たことのない課題を解いた」とまでは断言できません。「この評価ではプロンプト内の例示がゼロだった」と、確かめられる条件を明示するのが適切です。
実務では、成功例を一つ見つけた段階から、間違いやすい入力を集める段階へ進むことが大切です。否定を含む文章、複数の要望が混じる問い合わせ、短すぎる説明なども確認すると、任せられる範囲と人が見るべき範囲が具体的になります。
ゼロショット性能の評価方法:正解率だけで判断しない
ゼロショット性能とは、定めたゼロショット条件で、課題をどの程度うまく処理できるかを表すものです。あらゆる用途に共通する一つの点数ではなく、分類、要約、翻訳などの課題に合わせて測ります。学習した知識を未知のデータへ適用する「汎化性能」に関係しますが、ゼロショット性能は汎化性能そのものの別名ではありません。
問い合わせ分類なら、次の順で評価の条件をそろえます。正解付きのデータを評価者が用意することは、モデルへ見本を渡すこととは別なので、ゼロショットの評価でも必要です。
- 実際の用途に近い問い合わせを集め、分類基準に沿って正解を付ける。曖昧なケースは担当者間で基準を確認する。
- モデル、指示文、候補ラベル、生成の設定を記録し、評価する問い合わせの正解をプロンプトへ入れずに実行する。
- 全体の正解率に加えて、分類先ごとの誤り、重要な問い合わせの見逃し、出力形式の違反、保留件数を確認する。
- 指示の改善に使うデータと、最後の性能確認に使うデータを分ける。few-shotと比べるときも、見本は最終評価用のデータから選ばない。
- 必要に応じて同じ条件で複数回試し、判定の揺れ、応答時間、費用、人による修正の負担も記録する。
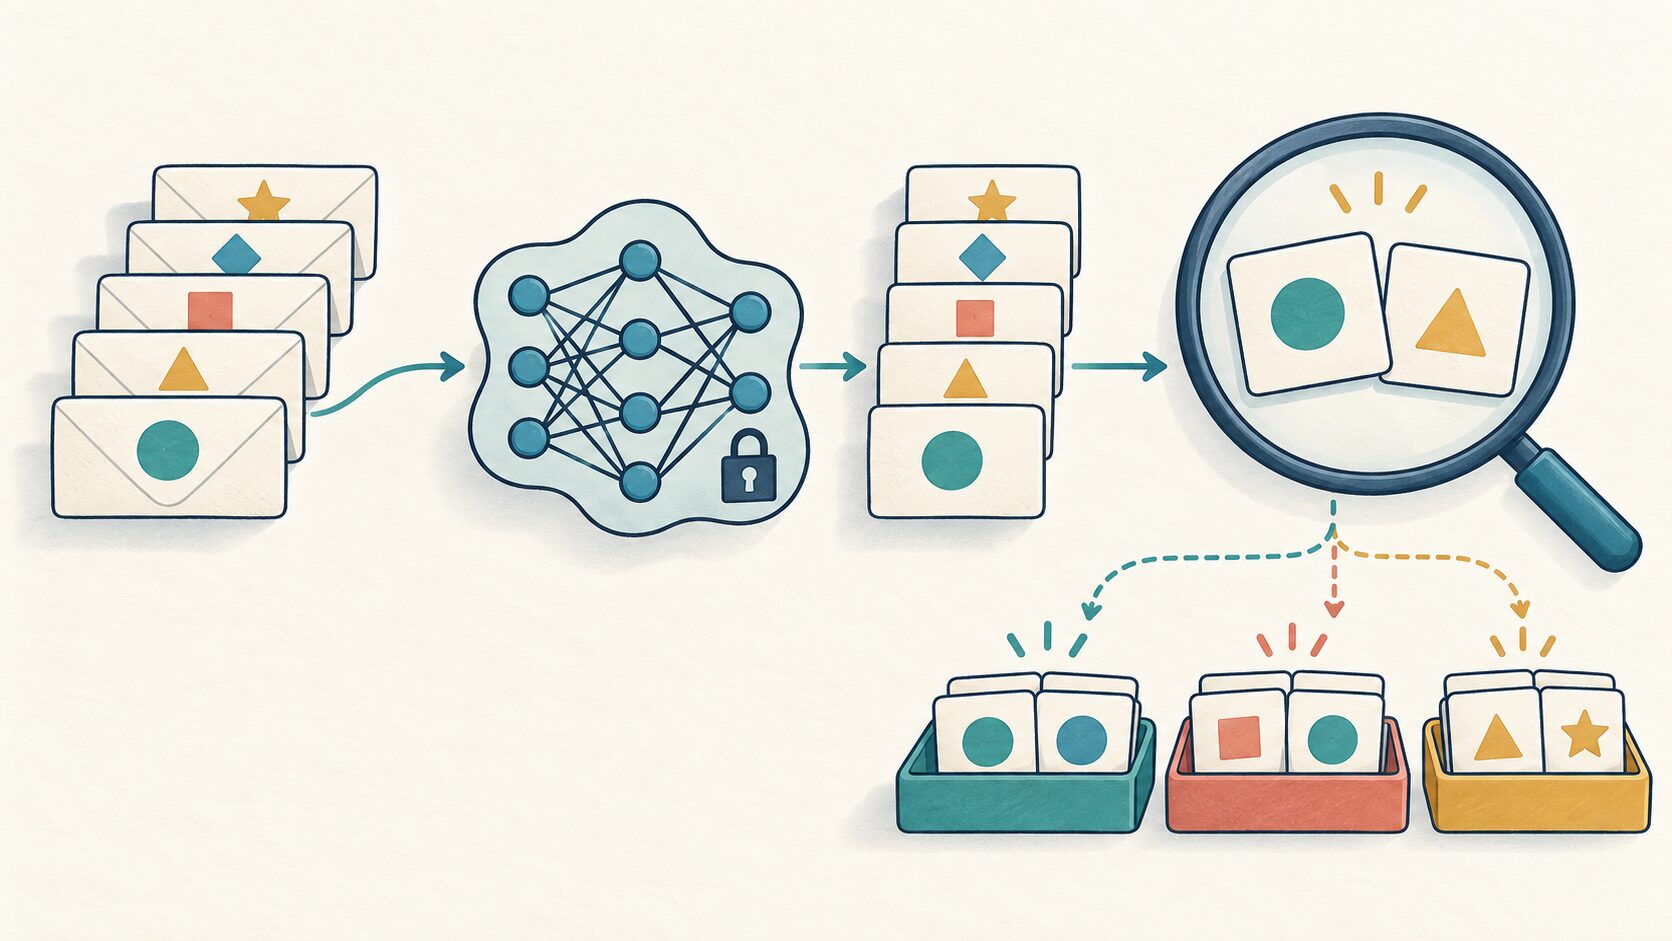
正解率だけでは、重要な失敗が隠れることがあります。たとえば、仮に100件中90件が通常の問い合わせ、10件が緊急対応を要する問い合わせだとします。すべてを「通常」と答えるだけでも正解率は90%になりますが、緊急の10件はすべて見逃しています。
このような用途では、緊急と判断したものが実際に緊急だった割合を表す「適合率」と、実際の緊急案件を拾えた割合を表す「再現率」なども確認します。保留を許す場合は、保留以外の回答の正確さと、全体のうち何割を自動処理できたかを併記すると、実務上の価値を判断しやすくなります。
要約では、必要な事実が残っているか、元の文章にないことを足していないか、読み手に適した長さかを評価します。画像のゼロショット分類では、対象クラスの学習例を除外した条件を明らかにし、未知のクラスだけを候補にするのか、既知のクラスも混ぜるのかをそろえて比較します。評価条件が違う数値を、そのままモデルの優劣として扱わないことが大切です。
導入の進め方と今後の展望
導入では、まず目的を一つに絞ってゼロショットで試し、失敗の原因を整理します。「AIで問い合わせ対応を全部行う」よりも、「問い合わせを5種類に仮分類する」のように範囲を決めると、入力、正解、必要な品質を具体化できます。初めから完全自動化を目標にせず、人が確認できる小さな工程で有用性を測る方法もあります。
次の手段は、失敗の種類に合わせて選びます。分類基準が曖昧なら説明を直し、判断の境界や出力の形が伝わりにくいならfew-shotで見本を添えます。社内規程などの情報が不足しているなら、必要な資料を入力へ追加したり、検索した資料を参照させるRAG(検索拡張生成)を検討したりします。RAGは参照情報を補う方法で、見本の件数を表すzero-shot・few-shotとは別の軸です。
多くの入力で一貫した振る舞いが必要で、適切な学習データも準備できる場合は、ファインチューニングが候補になります。ただし、追加学習すれば必ず改善するとは限りません。同じ評価用データで品質と運用負担を比較し、実際に効果があった方法を採用します。
今後の応用を考えるうえでは、文章・画像・音声などを関連付ける能力が重要です。新しい商品の特徴を説明して画像を探す、設備の説明書と点検画像を照合する、といった用途では、専用の正解データが少なくても試せる範囲が広がる可能性があります。一方、モデルの対応範囲、説明の質、現場のデータでの検証は引き続き欠かせません。
ゼロショットの価値は、データがそろうまで何もできなかった課題に、まず試し、必要な改善を見極める入口を作れることにもあります。精度だけでなく、導入までの時間と継続的な確認の負担を含めて、使いどころを選びましょう。
まとめ:ゼロショットは学習済みの知識を生かす方法
ゼロショット学習は、対象課題の見本がない条件で、学習済みの知識を応用する考え方です。LLMでは正解付きの入出力例をプロンプトに入れない使い方、画像分類では対象クラスのラベル付き学習例を使わない設定などを指します。「例示がゼロ」と「AIの学習経験がゼロ」は区別して理解しましょう。
使うときは、課題に対応できるモデルを選び、目的・判断基準・入力・出力形式を明確にします。そのうえで実際のデータを評価し、必要ならfew-shot、参照資料の追加、追加学習を検討します。ゼロショットだけで十分かどうかは、任せたい仕事と許容できる誤りに照らして判断することが大切です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月26日 | 事前学習と例示の違いを明確にし、分類の指示例と性能評価の手順を追記 |