
DQNとは?Q学習との違い・仕組み・活用例を初心者向けに解説

AIの初心者
「DQN」って難しそうですが、簡単に言うとどんなものですか?

AI専門家
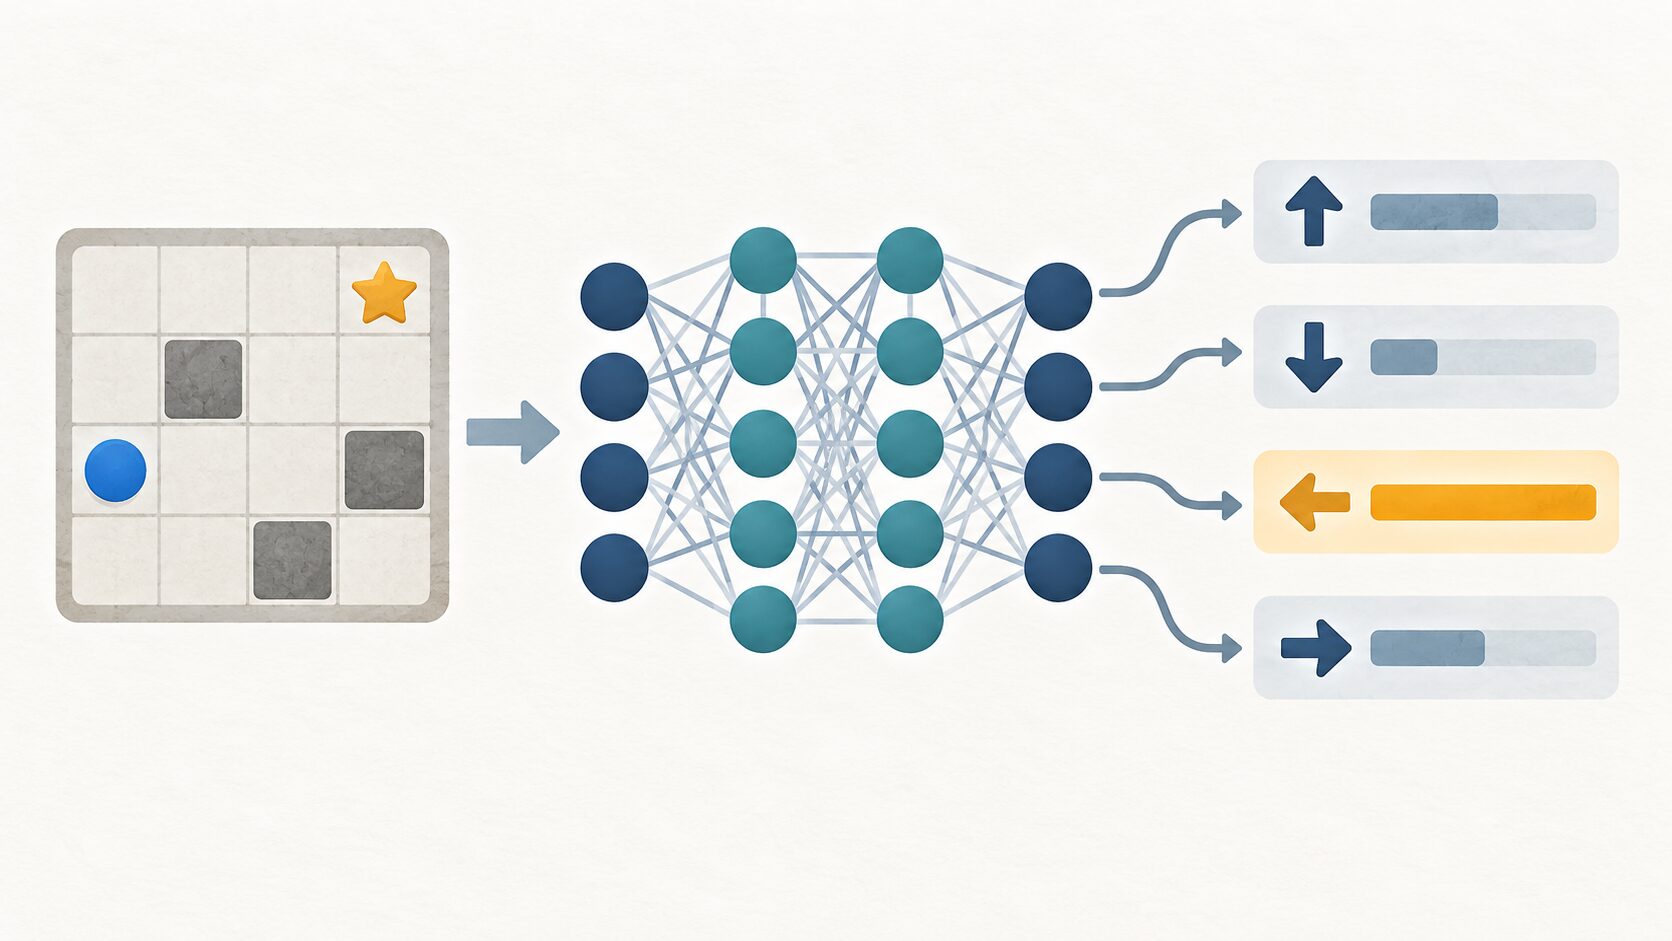
試行錯誤から「この状況では、どの行動が将来の得点につながるか」を学ぶ方法です。行動の価値をニューラルネットワークで予測するので、ゲーム画面のような複雑な情報も扱えます。
AIの初心者
ゲームの攻略なら、今すぐ点数がもらえる行動を選べばよいのでしょうか?
AI専門家
目先の点数だけでは決まりません。少し遠回りしても、その先で大きな得点につながる行動があります。DQNは経験を繰り返し使って、将来も含めた行動の価値を学びます。経路探索を例に、Q学習との違いから見ていきましょう。
DQN(Deep Q-Network)は、Q学習の行動価値を深層ニューラルネットワークで近似する、深層強化学習の代表的な手法です。「上へ進む」「右へ進む」といった行動を実際に試し、その結果から、より多くの報酬につながる選択を学びます。
この記事では、経路探索の例を使って、Q値と報酬の違い、DQNの更新、割引率の役割を順に説明します。さらに、学習を支える経験再生とターゲットネットワーク、使いどころ、学習がうまく進まない原因まで確認します。
DQNとは?深層学習で行動の価値を推定する強化学習
強化学習は、行動する主体である「エージェント」が「環境」とやり取りし、受け取った報酬を手掛かりに行動の選び方を学ぶ方法です。ゲームならエージェントが操作を選び、環境から次の画面と得点の変化が返ってきます。各場面の正解操作を人がすべて教えるのではなく、試した結果から改善していく点が特徴です。
DQNが予測するのは、ある状態で各行動を選んだときの「Q値(行動価値)」です。Q値は、その行動の直後だけでなく、その先で受け取る報酬も含めて見積もった価値を表します。同じ「右へ進む」という行動でも、目の前が通路か壁かによって価値は変わります。
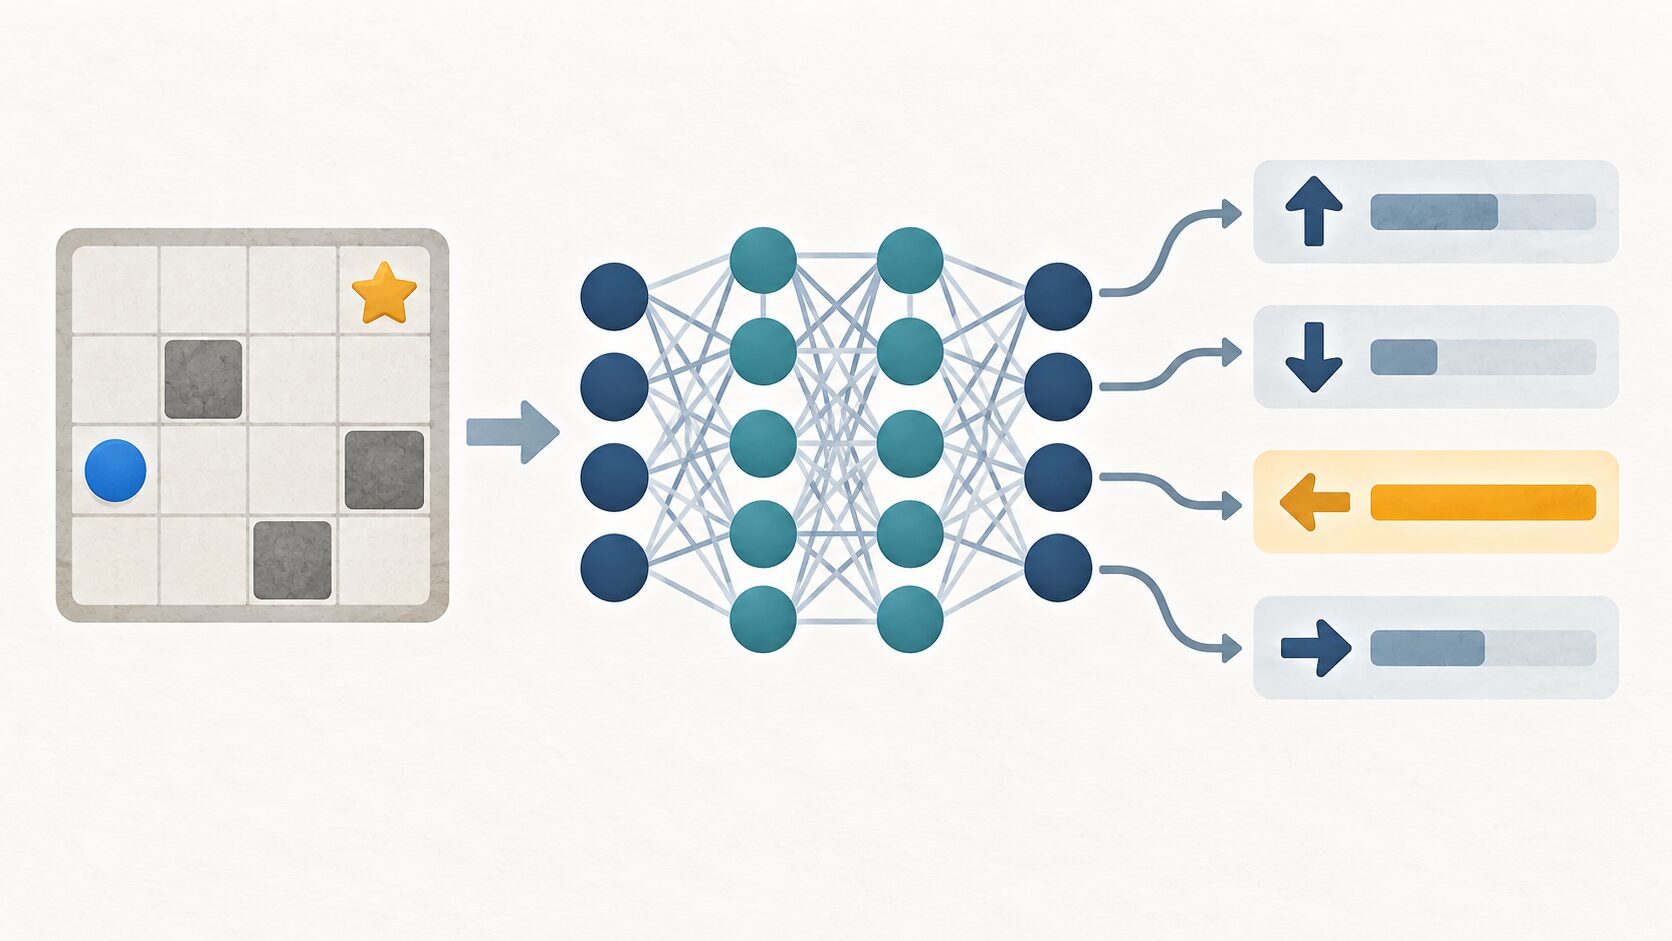
深層学習は、この価値を予測するために使います。基本的なDQNでは、状態をネットワークに入力すると、選択可能な行動それぞれのQ値が出力されます。たとえば「上・下・左・右」の4種類なら出力も4つになり、その値を比較して行動を選べます。Q値は予測値なので、学習前から正しい評価ができるわけではありません。
つまり、強化学習が「何を目指して学ぶか」を定め、深層学習が「複雑な状態から価値をどう計算するか」を担います。DQNはDeepMindによって発表され、ゲーム画面から行動価値を学習する手法として知られるようになりました。深層強化学習にはほかにも多くの方法があり、DQNはその中の価値ベースの手法に位置づけられます。
経路探索で理解する状態・行動・報酬・Q値
出発地点Aから目的地Iへ、上下左右に移動する課題を考えます。地図と障害物が固定されている単純な設定なら、現在いるマスを状態として表せます。エージェントは移動を繰り返し、目的地に到着すると1回の試行が終わります。この開始から終了までのひとまとまりを「エピソード」と呼びます。
| 用語 | 意味 | 経路探索の例 |
|---|---|---|
| エージェント | 行動を選ぶ主体 | 地図上を移動するAI |
| 環境 | 行動に応じて状態と報酬を返す仕組み | 地図、壁、移動の規則、目的地 |
| 状態 | 行動を判断するための状況 | 現在位置。条件によっては障害物や残り時間も含む |
| 行動 | その場面で選べる操作 | 上・下・左・右への移動 |
| 報酬 | 行動した結果として受け取る評価 | 目的地への到着で+100 |
| Q値 | ある状態である行動を選んだ場合の、将来を含めた報酬の見積もり | 今の位置から右へ進むことの価値 |
報酬の例として、目的地に近づく移動に+1、遠ざかる移動に−1、目的地への到着に+100を与えるとします。ここでは到着した移動には+100だけを与え、+1は重ねて加算しないルールにします。このような細部も、学習で何を目指すかに影響するため、最初に決めておく必要があります。
ただし、直後の報酬がプラスだから、その行動が長期的にも良いとは限りません。目的地に近づく方向に壁があるなら、いったん離れて迂回した方が到着できる場合があります。DQNが学ぶのは、このような「今は損に見えても、その先につながる行動」の価値です。
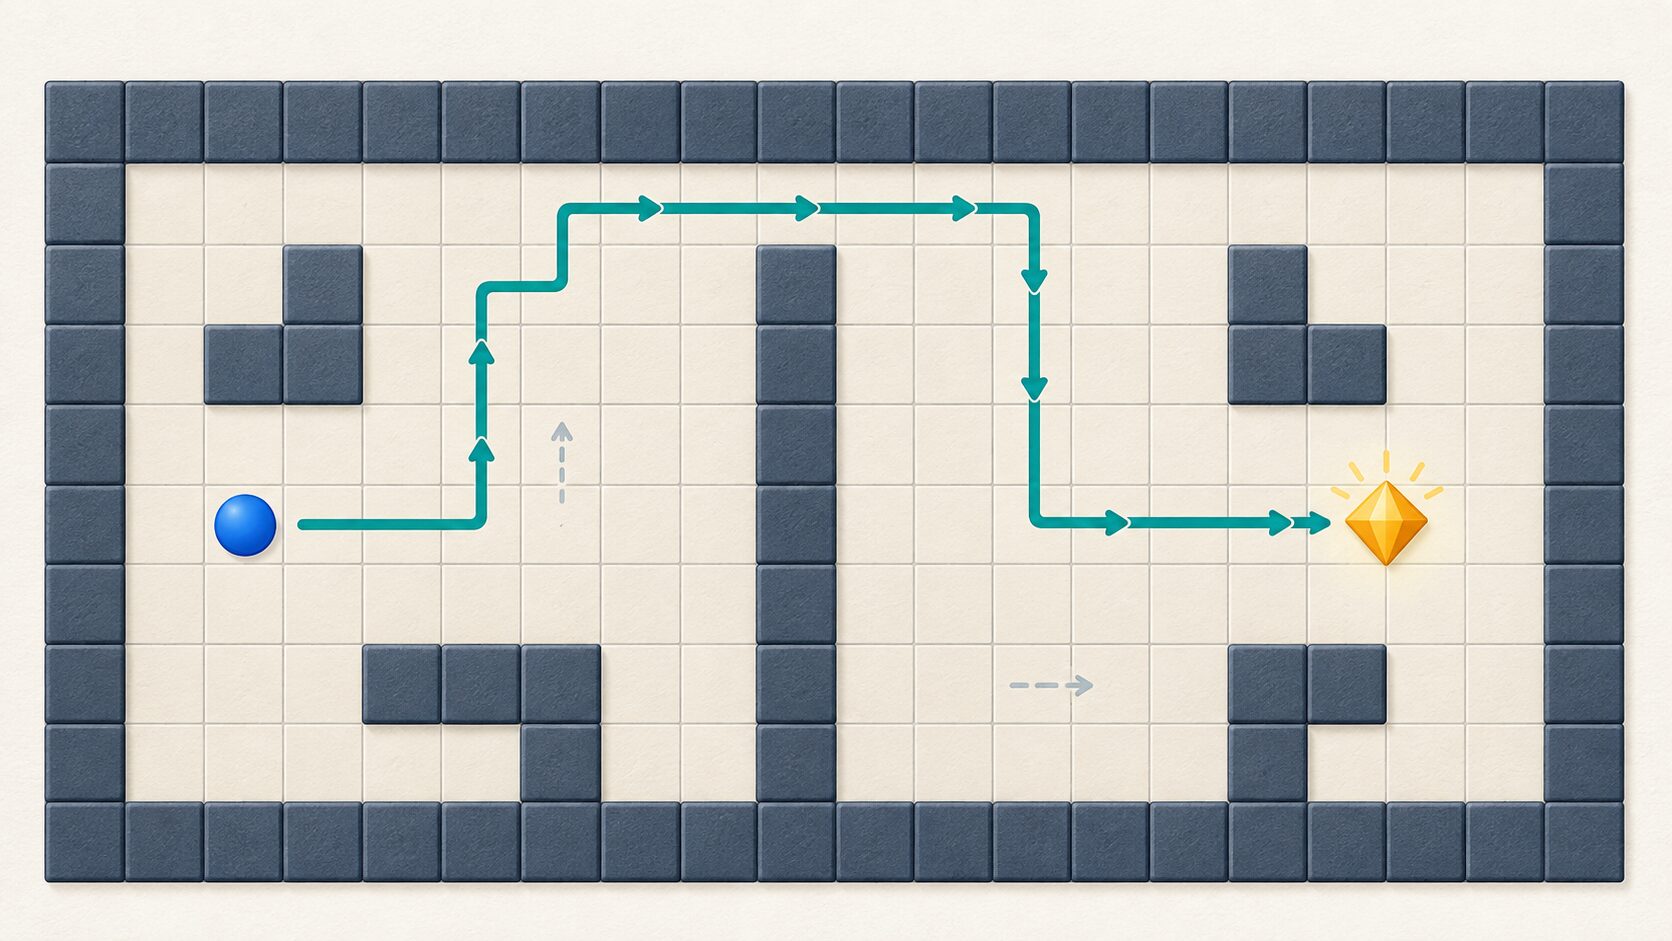
図では、青い地点から進み、いったん上側へ迂回して壁を回り込み、黄色の目的地へ向かいます。目的地との直線距離だけでは、通れる道を判断できません。また、近づくたびに小さな報酬を与える設計が、常に最短経路を生むわけでもありません。学習結果は、途中の報酬、終了条件、将来の報酬をどう評価するかの組み合わせで変わります。
Q学習とDQNの違いは、Q値を表で持つかネットワークで推定するか
表形式のQ学習では、状態を行、行動を列にしたQテーブルを用意します。各セルにその状態と行動のQ値を保存し、経験するたびに値を更新します。小さな迷路なら、初期値をすべて0にして始める方法でも仕組みを追いやすく、どの場所でどの行動の価値が高くなったかを確認できます。
ところが、ゲーム画面のように状態の種類が膨大になると、すべてを表に並べる方法は現実的ではなくなります。似た画面であっても別の状態として扱うと、必要な記憶量や学習経験が増えてしまうからです。
DQNでは、状態と行動の全組み合わせを表に保存する代わりに、Q値を計算するネットワークのパラメータを学習します。これにより、学習した状態の特徴を別の似た状態にも生かせます。ただし、その一般化が常に正しいとは限らず、表形式にはなかった近似の誤差も生じます。
| 比較項目 | 表形式のQ学習 | DQN |
|---|---|---|
| Q値の表し方 | 状態と行動ごとの表 | 深層ニューラルネットワークによる推定 |
| 学習で更新するもの | 経験した状態・行動に対応する表の値 | ネットワークの重みなどのパラメータ |
| 扱いやすい状態 | 数が少なく、区別しやすい状態 | 多数の特徴量や画像など、高次元の状態 |
| 基本的な行動の形 | 候補を列挙できる離散的な行動 | 候補を列挙できる離散的な行動 |
| 主な注意点 | 状態と行動が増えると表が大きくなる | 近似誤差があり、学習を安定させる工夫が必要 |
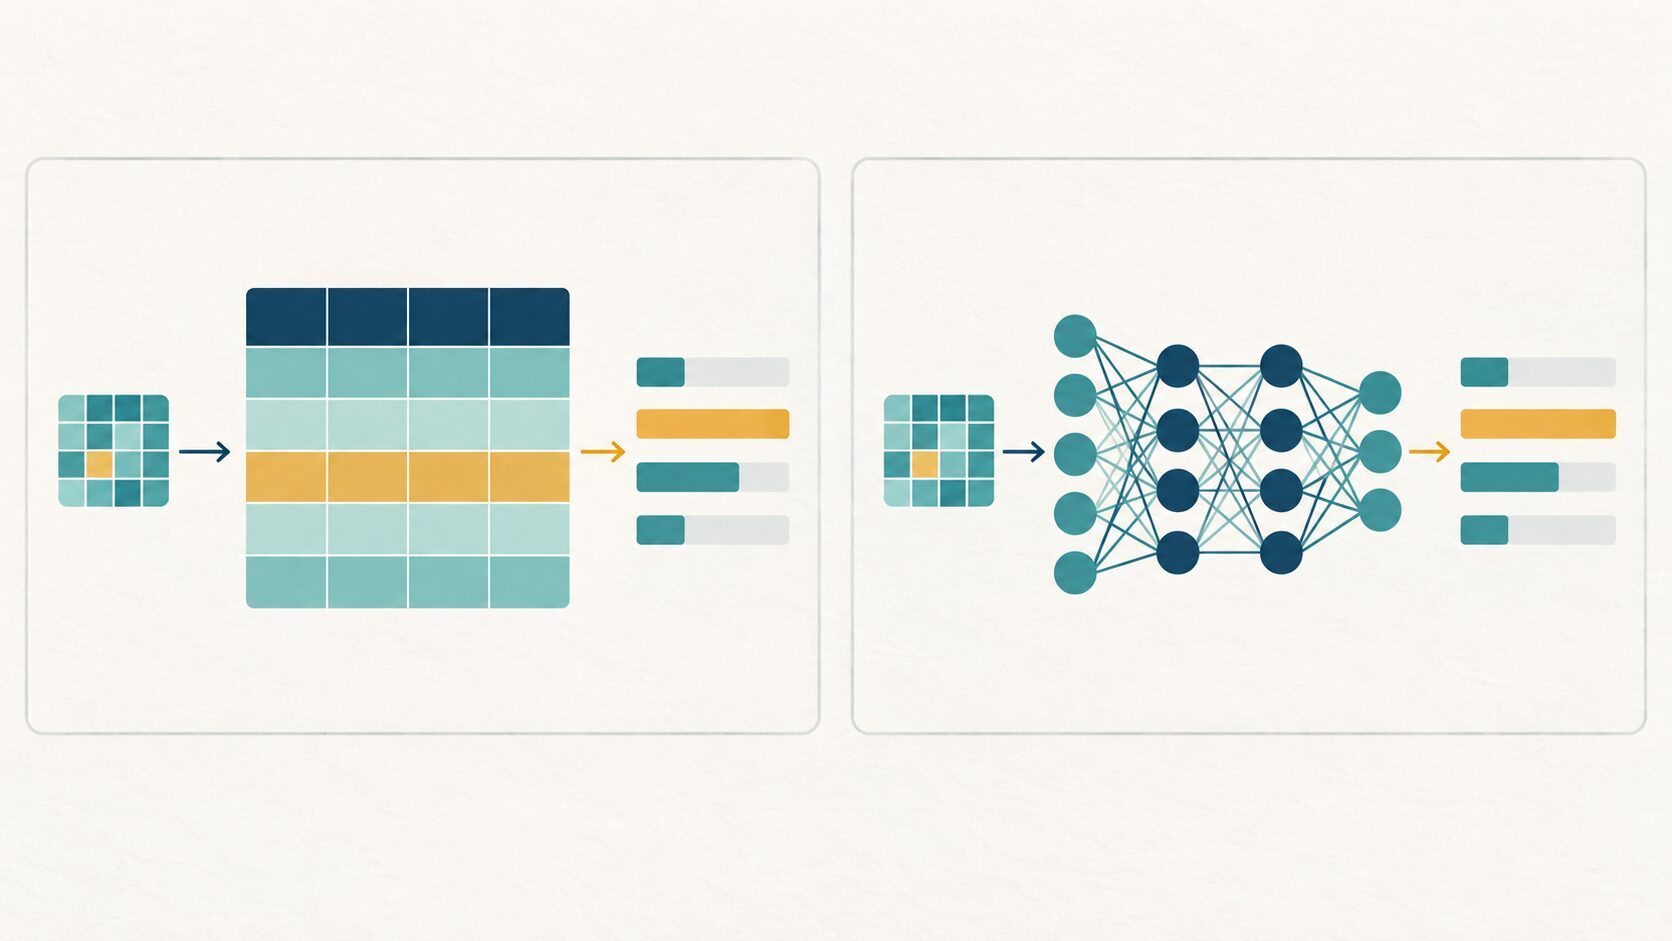
画像を扱う場合は、畳み込みニューラルネットワークなどで画面の特徴を抽出できます。一方、座標や速度を入力する課題なら、数値ベクトルを受け取るネットワークを使えます。DQNは画像専用の手法ではありません。また、画像1枚だけでは移動方向や速度が分からないこともあるため、複数時点の画面をまとめて入力するなど、必要な情報を与える工夫が重要です。
ベルマン方程式から理解するDQNの更新
DQNの学習は、「直後の報酬」と「次の状態で得られる価値」をつなぐベルマン最適方程式の考え方に基づきます。状態\(s\)で行動\(a\)を選び、報酬\(r\)と次の状態\(s’\)を得たとき、基本的なDQNでは次の値を学習目標にします。
\(y=r+\gamma(1-d)\max_{a’}Q(s’,a’;\theta^{-})\)- \(y\)はTD目標です。直後の報酬に、次の状態の価値の見積もりを足した学習用の目標値を表します。
- \(\gamma\)は割引率です。将来の報酬を現在から見てどの程度重視するかを決めます。
- \(\max_{a’}Q(s’,a’;\theta^{-})\)は、次の状態で選べる行動のQ値のうち最大の値です。
- \(\theta^{-}\)は、後述するターゲットネットワークのパラメータです。上付きのマイナスは逆数や負数ではなく、学習用とは別のパラメータであることを示す記号です。
- \(d\)は終端を表し、課題が終了した遷移では1、それ以外では0とします。終端では、この先の価値を加えずに報酬だけを目標にします。
たとえば、直後の報酬が1、割引率が0.9、次の状態の最大Q値が6で、まだ終端ではないとします。目標値は\(y=1+0.9\times6=6.4\)です。現在の予測が4なら、その予測を6.4へ近づける方向に学習します。ここで次の状態の6も推定値なので、目標の6.4が真の価値だと確定したわけではありません。
表形式のQ学習なら、対応するセルの値を目標へ少しずつ近づけます。表形式では、目標を計算するときも別のネットワークではなく、次の状態に対応する表の値を使います。目標が同じ6.4で、現在の値が4、学習率が0.1なら、更新後の値は\(4+0.1\times(6.4-4)=4.24\)です。目標へ一度に置き換えるのではなく、差の一部を反映しています。
DQNでは、複数の経験をまとめたミニバッチを使い、目標とネットワークの予測のずれを小さくするようにパラメータを更新します。上の表のセルに対する計算を、そのままネットワークの出力へ代入するわけではありません。二乗誤差を使う場合の損失は、次の形で表せます。
\(L(\theta)=\frac{1}{B}\sum_{i=1}^{B}\bigl(y_i-Q(s_i,a_i;\theta)\bigr)^2\)\(B\)はミニバッチ内の経験数、\(i\)は各経験の番号、\(\theta\)は学習用ネットワークのパラメータです。計算した目標\(y_i\)はこの更新では固定し、予測側のパラメータを勾配法で調整します。実装では、大きな誤差の影響を抑えるHuber損失が用いられることもあります。
大切なのは、DQNはQテーブルを書き換えるのではなく、Q値を出力する関数を学習するという点です。パラメータが変わると、今回学習に使った状態以外の予測にも影響が及ぶため、次に説明する割引率や学習を安定させる仕組みが重要になります。
割引率は将来の報酬をどこまで重視するかを決める
割引率\(\gamma\)は、将来受け取る報酬の重みを調整する係数です。現在から先の報酬を割り引いて足した「収益」は、次のように表せます。
\(G_t=r_{t+1}+\gamma r_{t+2}+\gamma^2r_{t+3}+\cdots\)\(G_t\)は時刻\(t\)から先の収益、\(r_{t+1}\)は直後に受け取る報酬です。直後の報酬には割引をかけず、それより先の報酬ほど割引率を多く掛けます。Q値は、ある状態である行動を選び、その後は一定の行動の選び方に従った場合に、この収益が平均的にどれほどになるかを表します。DQNは、その中でも最適な行動選択につながるQ値を近似することを目指します。
一般には\(\gamma\in[0,1)\)、つまり0以上1未満の範囲を使います。0なら直後の報酬だけを考え、1に近いほど遠い将来の報酬も重視します。適切な終了条件のある有限の課題では1を使うこともありますが、無限に続く課題で同じように扱えるとは限りません。
途中の報酬は0で、ゴールに着いた移動だけ100を得る課題を考えます。割引率を0.9とすると、今から3手目に到着する場合の収益は\(0.9^2\times100=81\)、5手目に到着する場合は\(0.9^4\times100=65.61\)です。この条件では、同じ報酬をより早く受け取る経路の方が高く評価されます。
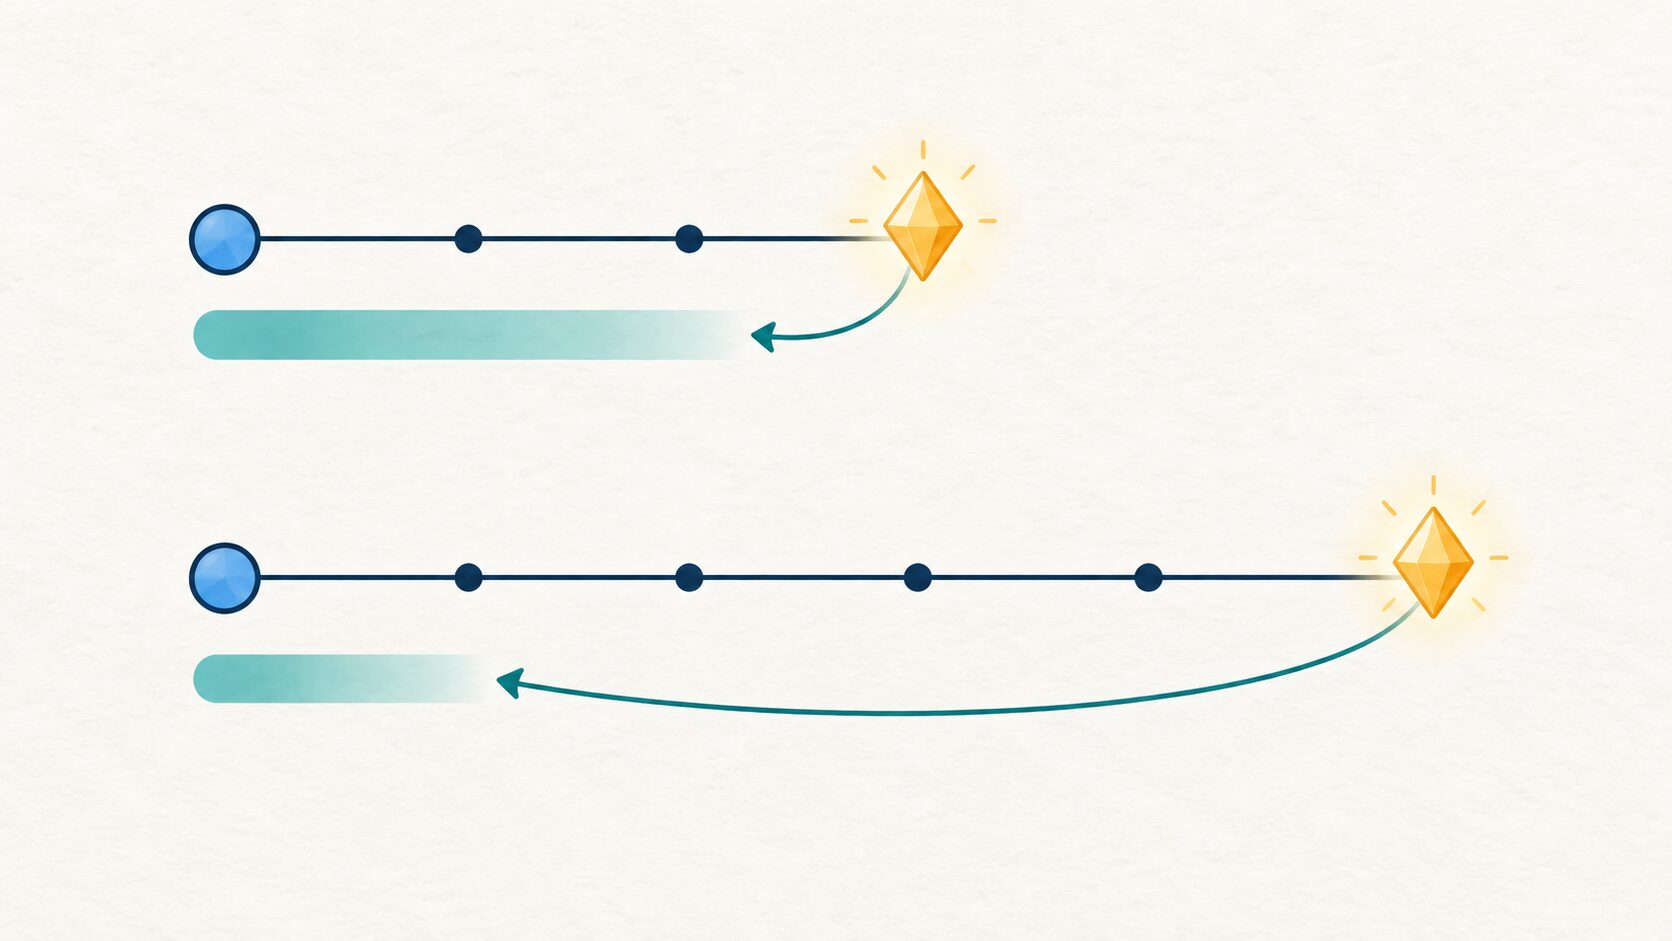
図の黄色い報酬は同じ大きさですが、青緑の棒で表した現在からの評価は異なります。割引率は、環境から実際にもらう点数を減らす設定ではなく、将来の報酬を学習の目的にどう反映するかの設定です。
また、割引率を大きくすれば、必ず最短経路を見つけられるわけではありません。途中でも報酬がもらえるなら、長い経路の方が高い収益になることがあります。最短到着を目指すなら、1手ごとのコストや終端報酬なども含めて目的に合う設計にします。割引率を小さくしすぎると、遠くにあるゴールの報酬がほとんど評価されず、そこへ向かう行動を学びにくくなる場合もあります。
なお、割引率と学習率は別の設定です。割引率は「どんな将来の結果を重視するか」、学習率は「1回の更新でパラメータをどれだけ動かすか」に関わります。
DQNの学習を支える経験再生とターゲットネットワーク
Q値をニューラルネットワークで表すだけでは、学習が不安定になりやすいという問題があります。連続したゲーム画面は互いによく似ているうえ、現在の予測を更新すると、次の状態の価値に基づく学習目標まで変わり得るためです。DQNでは、この問題を和らげるために2つの仕組みを使います。
経験再生(Experience Replay)は、過去の経験を保存し、そこから無作為に取り出して学び直す仕組みです。保存先をリプレイバッファと呼び、「状態・行動・報酬・次の状態・終端かどうか」をひと組として蓄えます。
たとえば、直近に右へ進む操作を続けたからといって、その連続した経験だけで学習する必要はありません。以前に上へ進んだ経験や、ゴールに着いた経験なども含むバッファから、ミニバッチを抽出します。こうすることで、連続する経験同士の相関を弱め、一度得た経験を複数回利用できます。ただし、保存内容そのものに偏りがあれば、それが完全に解消されるわけではありません。
ターゲットネットワークは、目標値の計算に使う、学習用とは別のネットワークです。学習用ネットワークのパラメータは頻繁に更新し、目標値を計算する側のパラメータは一定期間固定します。基本的な構成では、所定の間隔で学習用のパラメータを目標用へコピーします。
これは、予測を直すたびに目標も同時に大きく変わる状況を抑えるためです。教師あり学習の固定された正解ラベルとは異なり、DQNの目標は別の状態の推定値を含みます。固定するのは目標を計算するネットワークのパラメータであり、すべての経験に同じ目標値を与えるわけではありません。同じ経験に対する目標値が、学習用の更新のたびに変わることを防ぎます。
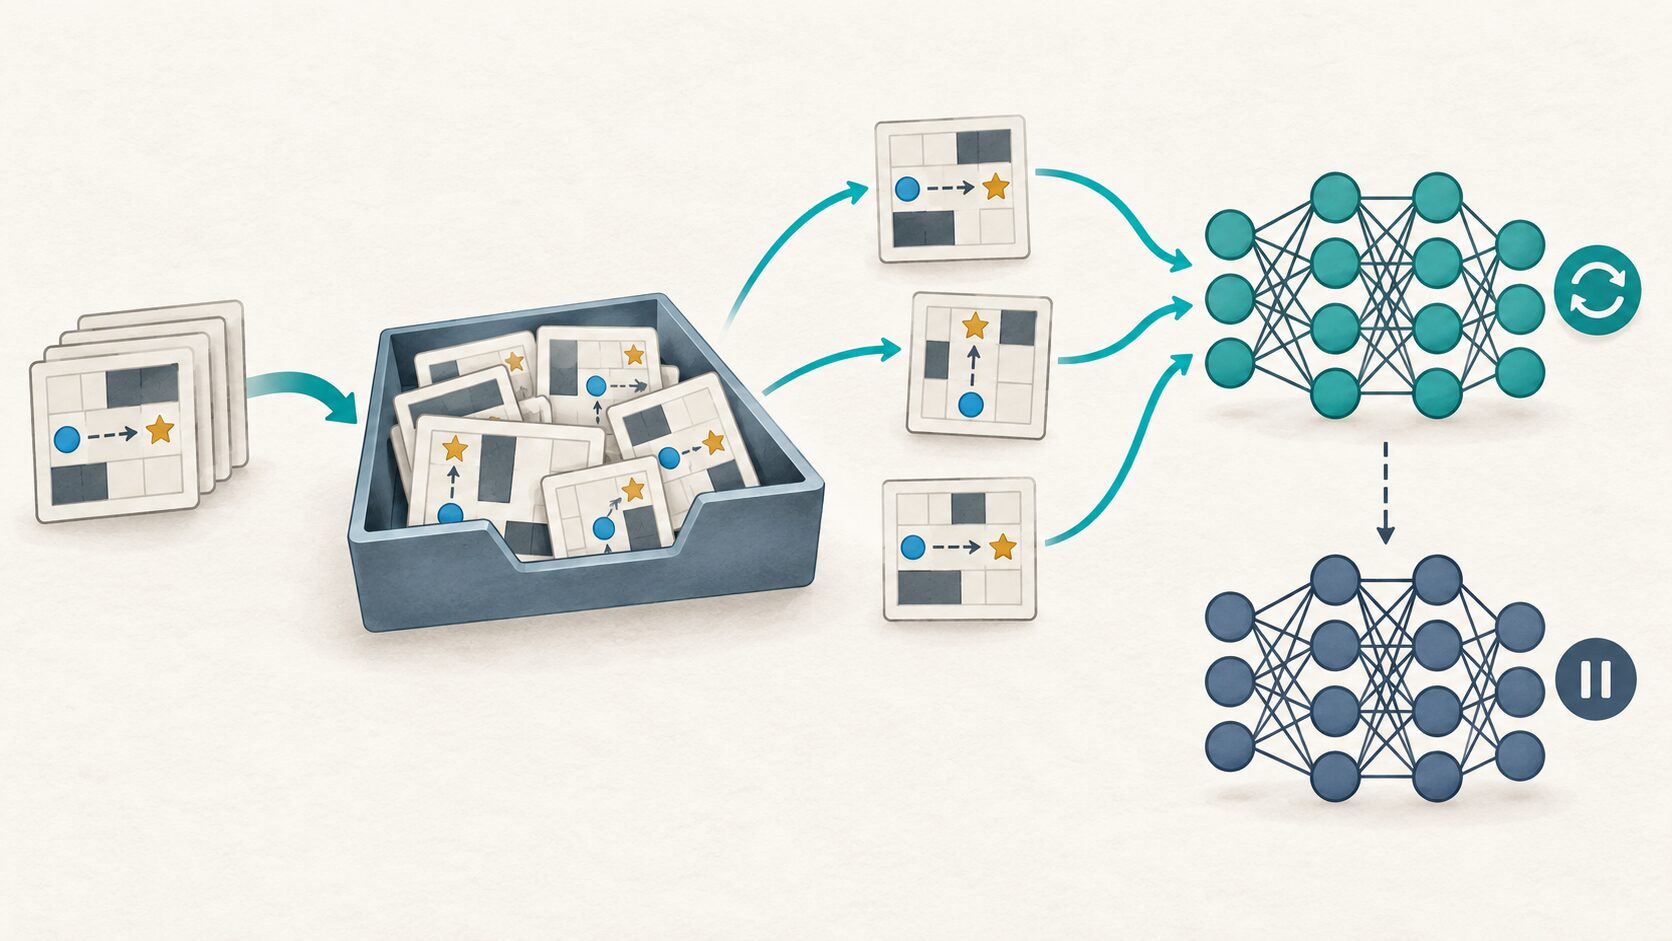
図では、経験の保管場所から取り出したサンプルで右上のネットワークを学習し、右下のネットワークへ一定間隔でパラメータをコピーしています。下側の一時停止マークは、永久に停止するという意味ではなく、コピーとコピーの間はパラメータを固定することを表します。図では省略していますが、学習時の目標値は下側のネットワークを使って計算します。これらは安定化の工夫であり、どんな設定でも学習成功を保証するものではありません。
行動選択と学習の流れ:探索と活用を両立する
学習を始めたばかりのQ値には、大きな誤差があります。最初から予測値が最大の行動ばかり選ぶと、偶然よく見えた行動に偏り、ほかの有望な選択肢を試せません。そこで、基本的なDQNでは\(\epsilon\)-greedy(イプシロン・グリーディ)法などを使い、探索と活用を両立させます。
この方法では、確率\(\epsilon\)でランダムに行動を選び、残りの確率\(1-\epsilon\)で予測Q値が最大の行動を選びます。たとえば\(\epsilon=0.1\)なら、約10%の機会にランダムな選択を行います。そのランダム選択でも最大Q値の行動が選ばれる場合があるため、「必ず10%は別の行動をする」という意味ではありません。
- 学習用ネットワークを初期化し、そのパラメータをターゲットネットワークへコピーする。リプレイバッファも用意する。
- 環境の状態を観測し、探索またはQ値に基づく活用によって行動を選ぶ。
- 行動を実行し、報酬・次の状態・終端情報とともに経験を保存する。
- 学習に必要な経験が集まったら、バッファからミニバッチを抽出する。
- ターゲットネットワークでTD目標を計算し、学習用ネットワークの予測とのずれを小さくする。
- 設定した間隔でターゲットネットワークを更新する。エピソードが終わったら環境をリセットし、試行を続ける。
探索の割合は、初めは大きくして徐々に下げる方法がよく使われます。しかし、早く下げすぎると、まだ見つけていない経路や成功体験を得にくくなります。一方、探索が多すぎるままだと、学んだ良い行動を十分に使えません。課題の難しさや得られる報酬の頻度に合わせて調整します。
性能を測るときは、学習用の更新を止め、探索率などの評価条件をそろえた別の試行を行います。探索中の失敗を含む学習時の得点だけで、完成した方策の良し悪しを決めないことが大切です。
DQNの使いどころ:ゲーム・経路探索・離散的な制御
DQNを検討しやすいのは、状況が変化する中で、有限個の行動候補から選び、結果を報酬として評価できる課題です。行動の結果を繰り返し試せる環境も必要になります。状態が画像や連続的な数値であっても、行動が離散的なら基本的なDQNの枠組みで扱えます。
| 課題の例 | 状態と行動の例 | 適用時に確認すること |
|---|---|---|
| ゲームの操作 | 画面を観測し、左右移動やジャンプなどの操作を選ぶ | 得点だけで目的を表せるか。必要な画面情報が入力に含まれるか |
| 経路探索の学習 | 現在位置や周囲の情報から、上下左右への移動を選ぶ | 到着、移動時間、衝突をどう評価するか。学習を使う必要があるか |
| 離散的な制御 | センサー値から、停止・低速・高速などの運転モードを選ぶ | 候補の細かさが十分か。試行を行えるシミュレーションがあるか |
経路探索は説明に便利な例ですが、既知の地図で最短経路を求めるだけなら、ダイクストラ法やA*のような探索アルゴリズムで直接解く方が適する場合があります。DQNは、使えば必ず既存の探索法よりよくなる方法ではありません。環境とのやり取りから行動を学ぶ必要があるかを先に考えます。
ロボットへの応用でも、モーターの力や関節角度を滑らかに指定したい課題では、そのまま基本的なDQNを使うのは難しくなります。行動を粗い候補に分けると制御が不十分になり、細かく分けすぎると出力数が増えます。また、現実での試行には時間や故障のコストがあるため、まずシミュレーションで学び、現実との差を評価する設計が必要です。
DQNの注意点とDouble DQN・方策勾配法との違い
DQNが伸び悩む原因は、ネットワークの大きさだけではありません。報酬の与え方、入力情報、探索の量、学習率、バッファの内容、ターゲットの更新間隔などが互いに影響します。学習が進まないときは、次の点を確認します。
- 報酬が目的と一致しているか:途中の得点を稼ぐことが有利になり、ゴールへの到着を後回しにしていないかを調べます。逆に、成功時だけ報酬を与えると、最初の成功を経験できず学びにくい場合があります。
- 判断に必要な情報があるか:同じ位置でも速度や進行方向によって適切な操作が変わるなら、位置だけでは不十分です。必要な情報を含む状態表現や観測の履歴を検討します。
- 値の大きさだけで判断していないか:予測Q値が高くなっても、実際の収益や成功率が改善したとは限りません。Q値は確率ではなく、報酬の尺度や割引率によって大きさが変わります。
- 十分な試行と評価ができているか:1回の成功や1つの乱数条件で結論を出さず、複数の試行で成績のばらつきを見ます。DQNでは常に最適な行動が得られる保証はありません。
基本的なDQNには、誤差を含む推定値から最大値を選ぶことで、行動価値を過大に評価しやすい問題もあります。Double DQNは、次の行動を選ぶ役割と、その行動を評価する役割を分けることで、この偏りを抑える改良です。学習用ネットワークで次の行動を選び、その行動の価値をターゲットネットワークで評価します。
通常のDQNにも学習用とターゲット用の2つのネットワークがあります。そのため、「ネットワークが2つならDouble DQN」とは判断できません。違いは、TD目標を作るときの行動の選択と評価の分担にあります。
一方、方策勾配法は、行動の選び方である「方策」を直接改善する手法です。DQNが各行動の価値を推定して比較するのに対し、方策を表すモデルは行動の確率分布などを出力します。Actor-Critic系は、方策を学ぶ部分と価値を評価する部分を組み合わせます。これらには離散行動を扱うものも連続行動を扱うものもあり、連続制御ではSACなどが比較対象になります。
初めて手法を選ぶときは、「状態が画像かどうか」だけでなく、「行動候補を列挙できるか」「どれほど試行できるか」「何を成果として測るか」を確認すると、DQNが課題に合うかを判断しやすくなります。
初心者がDQNを学ぶときの進め方
最初から複雑なゲーム画像を使うと、報酬設計、画像処理、ネットワークの学習のどこで問題が起きたのか分かりにくくなります。小さな課題で仕組みを確かめてから、扱う状態を増やすと理解しやすくなります。
- 小さな迷路でQテーブルを確認する:状態と行動を明示し、経験によってどのセルの値が変わるかを追います。ゴール直前の報酬が、その前の行動の価値にも伝わることを確認します。
- 同じ課題のQ値をネットワークで推定する:入力する状態と出力する行動の対応を固定します。小規模課題では、DQNの方が必ず速く学べると期待する必要はありません。
- 経験再生とターゲットネットワークを含むDQNを動かす:学習用だけが更新されること、終端後の価値を足していないこと、経験から選んだ行動のQ値を更新対象にしていることを確認します。
- 成績を複数の指標で見る:収益に加え、到着成功率、到着までの手数、失敗の種類などを記録します。学習損失だけでは、課題が解けるようになったか判断できません。
- 条件を一つずつ変えて比較する:探索率、学習率、報酬設計などを一度に変えず、同じ評価条件で複数の乱数による試行を比べます。
実装では、ゴール到着などの「課題そのものの終了」と、学習の都合で打ち切る「時間制限」を区別することも重要です。時間切れの後も課題が本来続く設定なら、そこで将来価値を一律に0としてよいとは限りません。終了信号の意味を確認し、TD目標で終端として扱う条件を決めます。時間制限自体が課題のルールなら、残り時間を状態に含めることも検討します。
この順序で学ぶと、DQNを単なる「深層学習でゲームを解く方法」として覚えるだけでなく、どの経験から何を予測し、どの目標へ向かって更新しているのかを説明できるようになります。
まとめ:DQNを理解するために押さえたいこと
DQNは、Q学習の行動価値を深層ニューラルネットワークで近似し、試行錯誤から報酬につながる行動を学ぶ方法です。Qテーブルとの違いは価値の表し方と更新対象にあり、経験再生とターゲットネットワークが学習の安定化を支えます。
経路探索の例では、目先の得点だけでなく、将来の到着報酬も考えることが重要です。割引率はその将来報酬の重みを調整しますが、最短経路や学習成功を保証する設定ではありません。離散的な行動を選ぶ課題から始め、報酬・状態・探索・評価を合わせて設計することが、DQNを理解し活用する第一歩になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月27日 | Q学習の更新例と学習目標の扱いを補い、仕組みを示す図版5点を刷新 |