
生成モデルとは?データ生成の仕組み・活用例をわかりやすく解説

AIの初心者
「生成モデル」って、どういうものなんですか?画像や文章を作れる仕組みがよくわかりません。

AI専門家
たくさんのデータから、形や言葉の並びなどの特徴を学ぶモデルだよ。たとえば猫の写真を学習すると、耳や目、体の模様に見られるパターンをもとに、新しい猫の画像を作れるんだ。
AIの初心者
なるほど。保存してある写真をそのまま取り出すのではなく、学んだ特徴から画像を作るんですね?
AI専門家
そうだよ。ただし、学習した写真にとても似たものが出る場合もあるし、作った内容が正しいとも限らない。仕組みと一緒に、使うときの確認点も押さえていこう。
生成モデルとは。
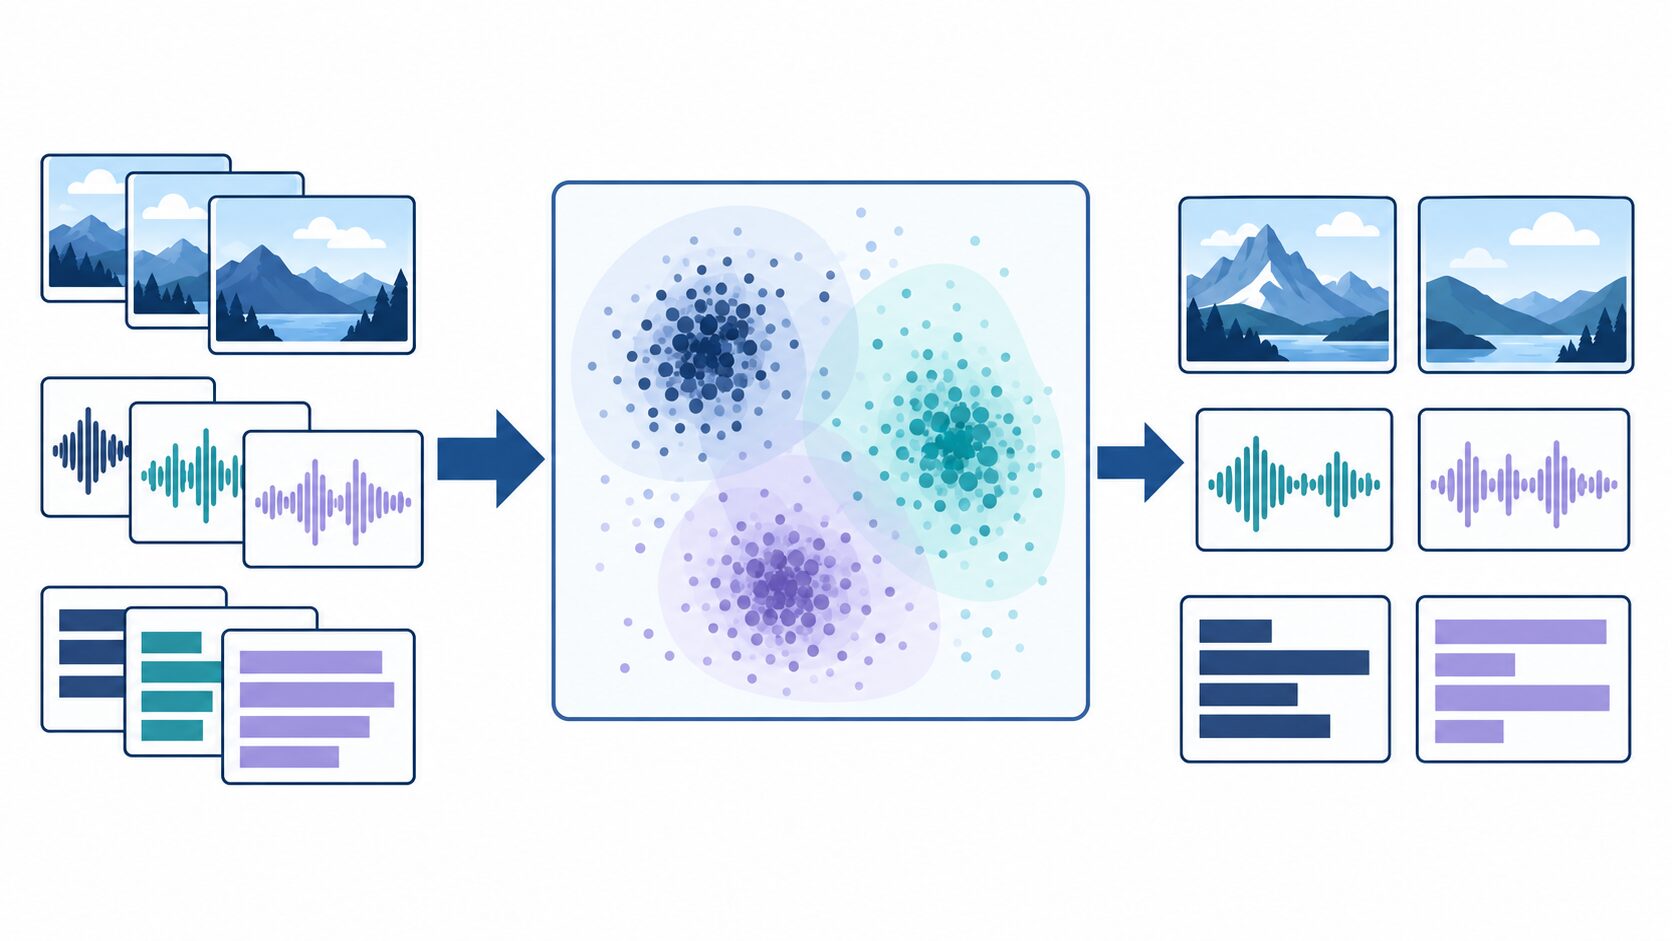
生成モデルとは、データの値やパターンがどのように現れるかを確率的にモデル化し、学んだ特徴を持つデータを作り出すために使えるモデルです。画像、音声、文章などの生成に加え、モデルの設計によっては異常なデータの検出や欠損部分の推定にも利用できます。
「猫の画像を作って」と指示して画像を得るとき、その背景には、データから特徴を学ぶ段階と、学習済みのモデルで出力を作る段階があります。この記事では手書き数字を例にこの流れを説明し、識別モデルとの違い、生成AIとの関係、代表的な手法と活用上の注意点まで見ていきます。
生成モデルとは:データの分布を学ぶ考え方
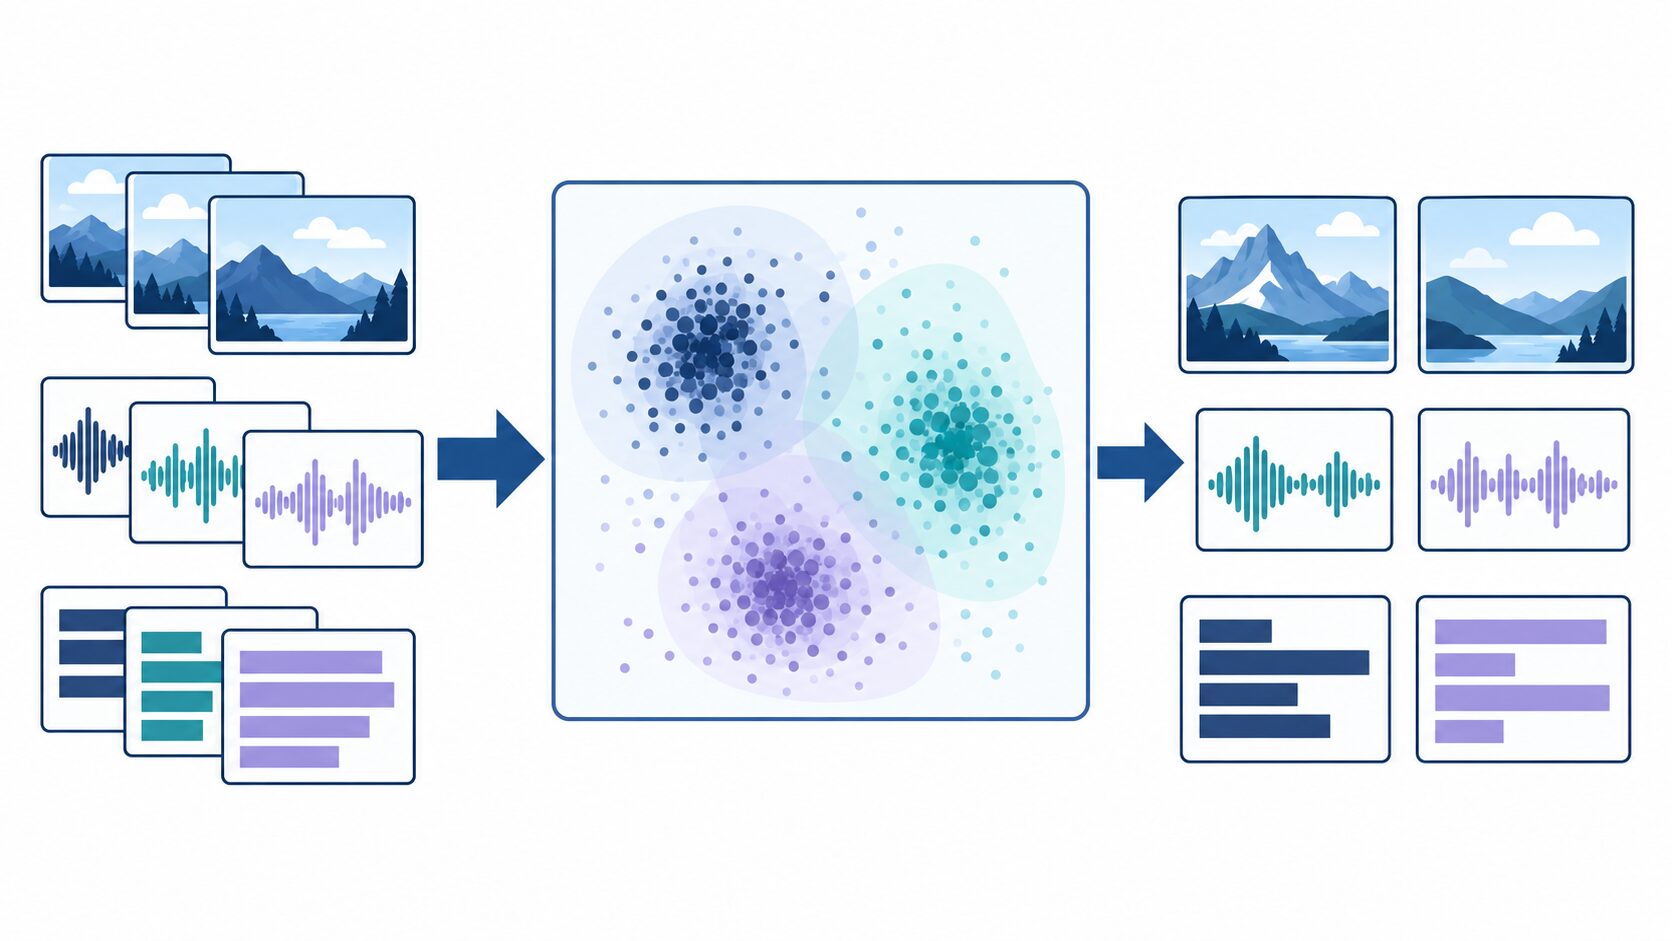
生成モデルを理解する鍵は、確率分布を「値やパターンの現れやすさ」と捉えることです。公平なサイコロなら、1から6までの目が出る確率はそれぞれ6分の1です。このように、起こり得る結果とその起こりやすさをまとめたものが確率分布です。
画像では、サイコロよりはるかに多くのパターンを扱います。たとえば同じ手書きの「3」でも、線が太いもの、傾いているもの、上下の丸みが違うものがあります。それでも、多くの「3」には共通する形があります。生成モデルは、こうした共通点とばらつきの両方を学び、数字らしい画像が現れやすいようにデータの分布を近似します。
大切なのは、一つ一つの特徴だけでなく、その組み合わせも捉えることです。線や曲線が含まれていても、位置関係がばらばらなら数字には見えません。画像なら各部分の形や配置、文章なら単語の並びや文脈のつながりなど、要素どうしの関係が生成結果を左右します。
ただし、統計的な規則性を学ぶことと、現実の原因や制作工程を解明することは別です。数字の画像を生成できても、書き手がどんな意図で筆を動かしたかまで理解したとはいえません。「データがどう作られるかを学ぶ」という説明は、観測したデータを再現できる確率的な仕組みを組み立てる、という意味で捉えると正確です。
生成モデルは深層学習だけを指す言葉でもありません。比較的単純な確率分布を組み合わせた統計モデルも含まれます。扱うデータの複雑さや目的に応じて、シンプルなモデルから大規模なニューラルネットワークまで、異なる方法が使われます。
学習からデータ生成までの仕組み
生成モデルの処理は、モデルを調整する「学習」と、学習済みモデルを使う「生成」に分けて考えると理解しやすくなります。手書き数字の画像を作る場合、基本的な流れは次のとおりです。
- データを集め、整える。さまざまな人が書いた数字の画像を集め、大きさや画素値の扱いをそろえます。数字を指定して作りたい場合は、画像と「0〜9」のラベルを対応させる方法があります。書き方が偏ったデータばかりだと、生成する数字にもその偏りが表れます。
- 分布や特徴を学習する。集めた画像を使い、線の形、太さ、傾きなどの関係を表せるようにモデル内部の値を繰り返し調整します。何を誤差として減らすか、どのように調整するかは手法によって異なります。
- 学習した分布からサンプリングする。学んだ現れやすさに従って候補を取り出す操作を、サンプリングと呼びます。手法に応じて、ランダムな数値を出発点に画像へ変換したり、少しずつ出力を作ったりします。
- 生成結果を確認する。新しく得た画像について、数字として読めるか、形に偏りがないか、学習画像を再現していないかなどを確かめます。一枚だけよくできていても、安定して使えるモデルとは限りません。
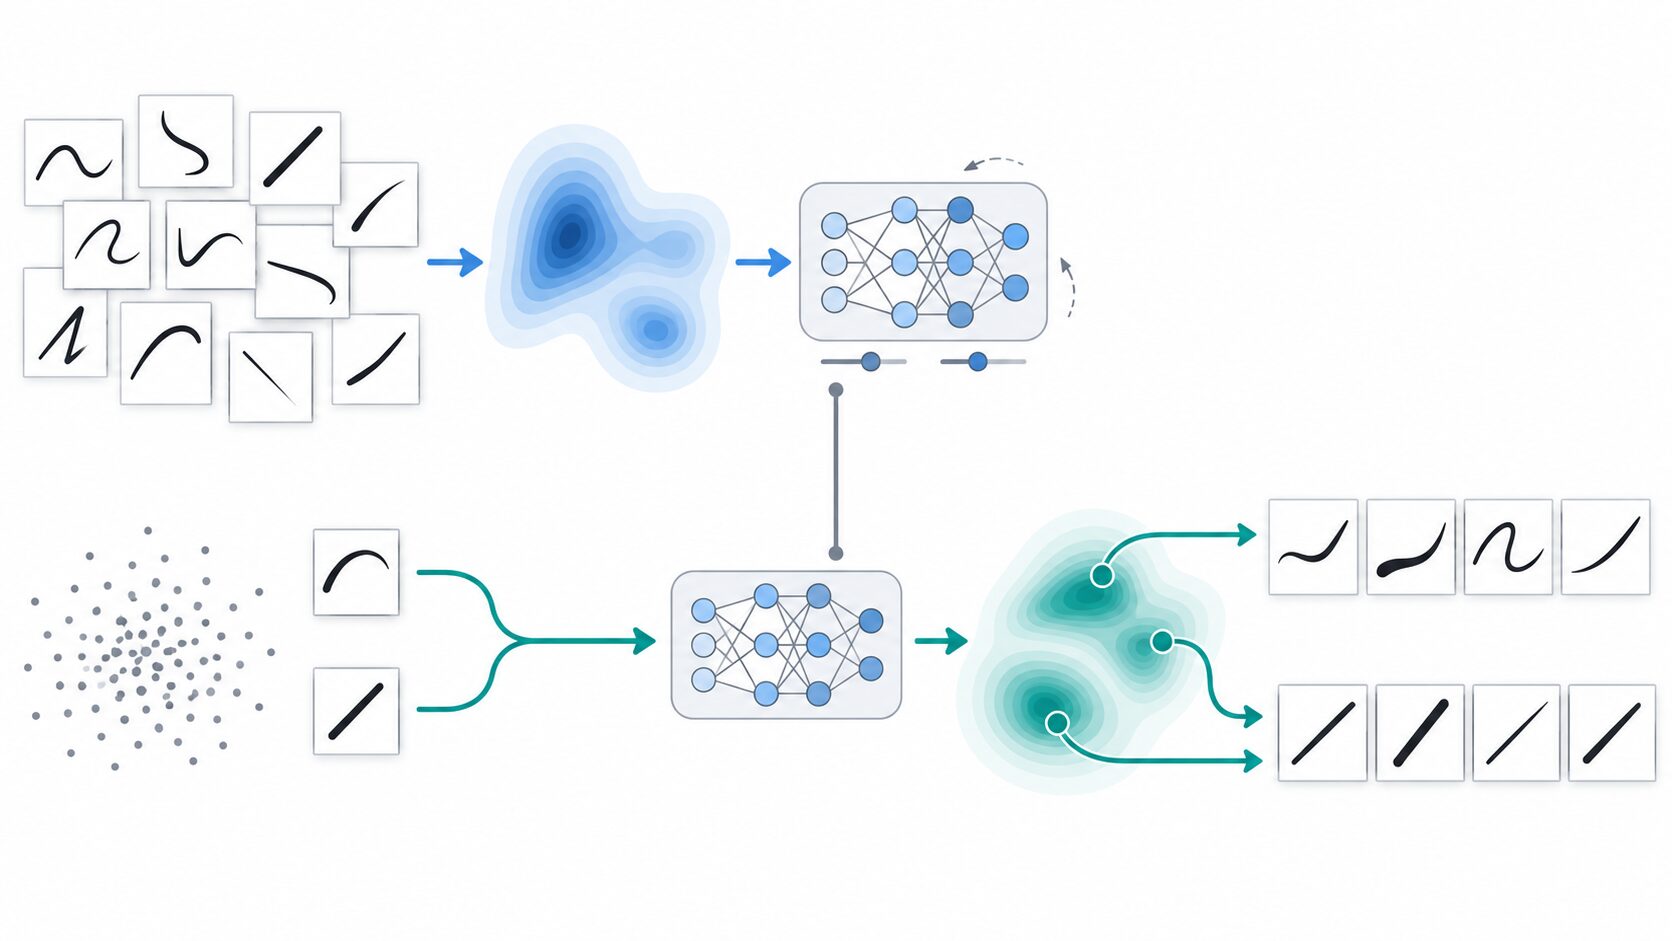
たとえば学習済みモデルに「数字の3」という条件を与えると、その条件に合う画像を作るように生成を絞り込めます。これが条件付き生成です。文章による「太い線で書いた3」という指示や、画像の一部を入力する方法も、対応したモデルなら生成の条件として使えます。条件を受け取れるかどうかは、モデルの構造や学習方法に依存します。
同じ条件でも、乱数を変えると丸みや傾きの違う「3」が得られる場合があります。乱数はでたらめな出力を作るためだけのものではなく、学習した分布の中から異なる候補を選ぶ役割を持ちます。モデルや設定によっては、乱数の初期値であるシードを固定して出力を再現しやすくすることもできます。
生成するたびに最初から学習し直す必要はありません。通常は学習済みのモデルに条件などを入力して利用します。一方、出力の傾向を変えるために追加学習を行う場合は、生成とは別にモデルを調整する工程が必要です。
この仕組みは、保存画像の単純な貼り合わせや検索とは異なります。ただし、学習例を強く記憶して、非常によく似た出力を作ることはあります。生成されたものが、必ず独創的で、既存のデータと重ならないとは限りません。
識別モデルとの違いと生成AIとの関係
基本形を確率で表すと、識別モデルは入力から答えを予測する \(P(y\mid x)\)、生成モデルはデータの分布 \(P(x)\) やデータとラベルの同時分布 \(P(x,y)\) を扱う、と説明できます。ここで \(x\) は画像などのデータ、\(y\) は数字の種類などのラベル、\(P\) は確率分布を表します。縦線は、その右側の情報が与えられていることを意味します。
数式に慣れていなくても、手書き数字で比べると違いが見えてきます。数字の画像を見せて「これは3」と答えるのが識別の例です。一方、「3らしい画像を作る」のが生成の例です。迷惑メールかどうかを判定する処理も、入力から分類結果を予測する識別に当たります。
| 比較項目 | 識別モデル | 生成モデル |
|---|---|---|
| 主に学ぶ対象 | 入力と答えの対応関係や、クラスを分ける境界 | データの現れ方や、構成要素の組み合わせに関する分布 |
| 入力と出力の例 | 手書き数字の画像を入力し、「3」というラベルや各数字の確率を出す | 乱数や「3」という条件から、手書き数字の画像を作る |
| 典型的な用途 | 画像分類、迷惑メール判定、入力からの数値予測 | 画像や文章の生成、設計に応じた欠損補完や異常検知 |
| 確かめる点の例 | 分類の正解率、見逃しや誤判定の割合、予測誤差 | 生成物の品質、多様性、条件への適合、用途ごとの有用性 |
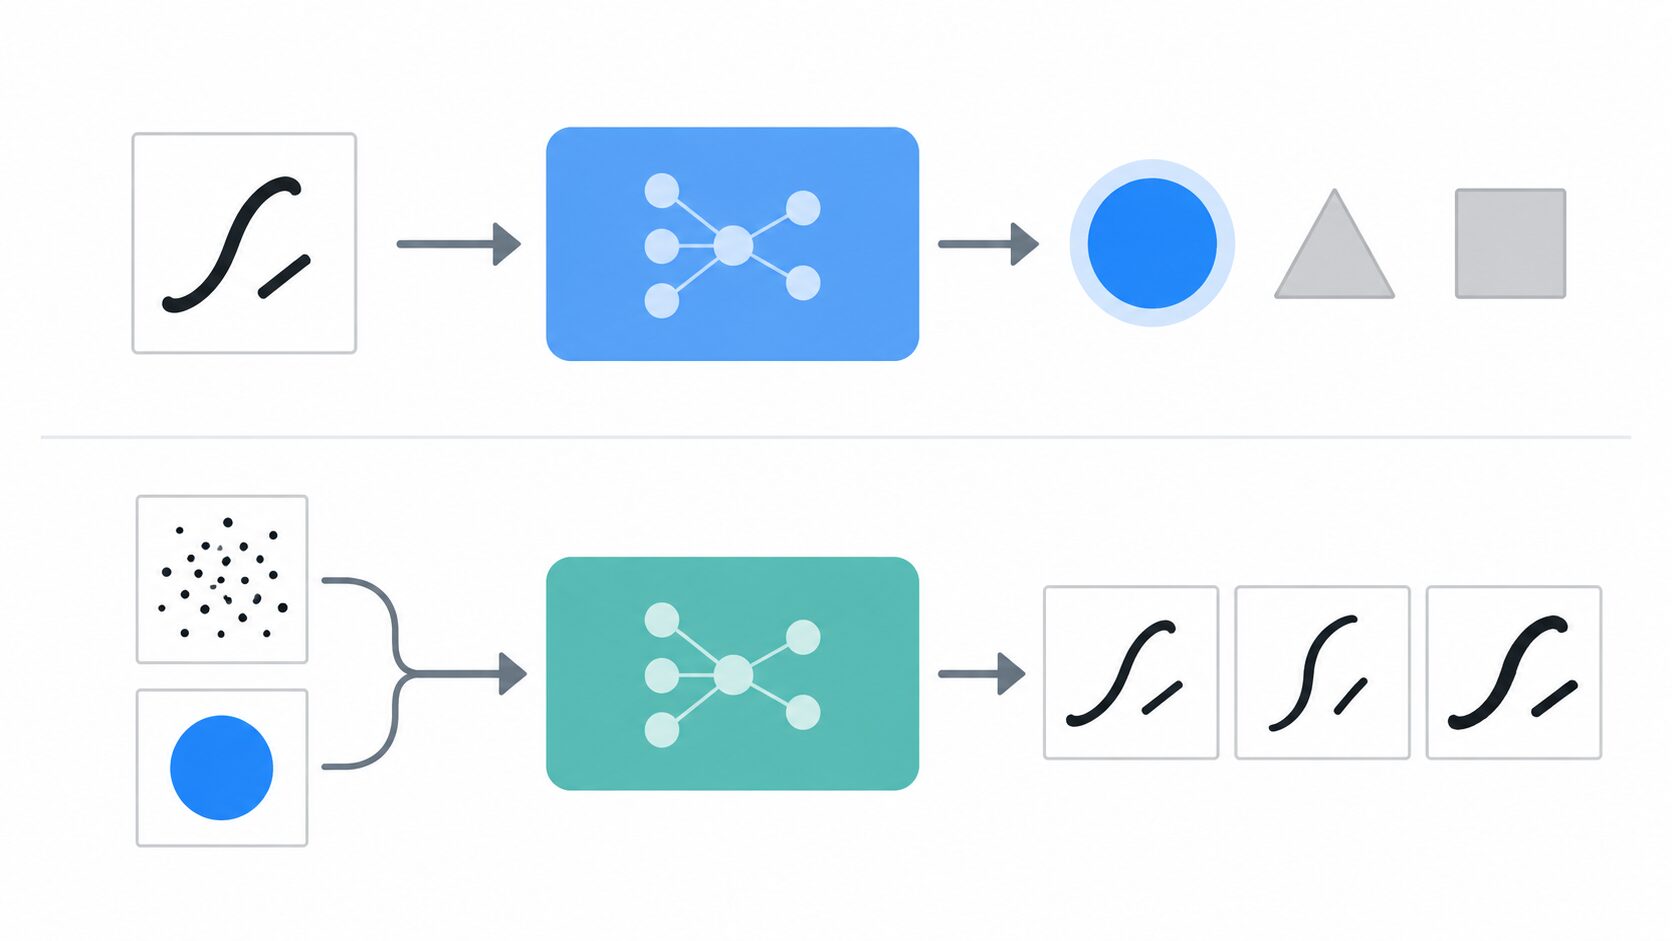
ただし、確率の式だけで機械的に二分できるわけではありません。条件付き生成モデルでは、条件 \(c\) のもとでデータ \(x\) が現れる分布を \(P(x\mid c)\) と表します。これは条件付き確率ですが、画像や文章そのものを出力する生成モデルです。また、数字ごとの画像の分布を学び、入力画像がどの数字の分布に合うかを比べれば、生成モデルを分類に利用することもできます。
生成AIは、文章や画像などを生成するAI技術やサービスを指す言葉で、生成モデルはその基盤となるモデルです。たとえば文章作成サービスでは、生成モデルに加えて、入力画面、資料の検索、出力の制御などが組み合わされることがあります。モデルそのものと、それを使う製品全体を分けて考えると、両者の関係を理解できます。
識別と生成に一律の優劣はありません。迷惑メールを判定したいのか、返信の下書きを作りたいのかで必要な機能は変わります。精度や費用も、モデルの種類だけで決まるものではなく、データ、設計、評価する課題によって変わります。
代表的な生成モデルの種類
生成モデルには、新しいデータを作るための異なる方法があります。共通するのはデータの規則性を学ぶ点ですが、どのような表現を学び、どの手順で出力を取り出すかが違います。最初は細かな数式よりも、それぞれの生成の考え方を押さえると学習を進めやすくなります。
| 手法 | 生成の考え方 | 典型的な用途の例 |
|---|---|---|
| 混合ガウスモデル(GMM) | 釣り鐘型の分布を複数組み合わせ、いずれかの分布を選んで値を取り出す | 数値データの分布の推定、模擬データの生成 |
| 変分オートエンコーダ(VAE) | データの特徴を潜在変数で表し、その空間から取り出した値をデータへ変換する | 画像生成、特徴表現の学習、再構成を使う分析 |
| 敵対的生成ネットワーク(GAN) | データを作る生成器と、学習データか生成物かを見分ける識別器を競わせて学習する | 画像生成、画像変換 |
| 拡散モデル | ノイズを加える過程に対応して、そのノイズを段階的に取り除く方法を学ぶ | 画像生成、画像編集、音声生成 |
| 自己回帰モデル | それまでの要素を条件に、次の要素を順番に生成する | 文章生成、音声や時系列データの生成 |
混合ガウスモデルは、深層学習を使わない生成モデルの例です。たとえば測定値が一つの範囲に集中せず、二つの山に分かれている場合、それぞれの山に対応する分布を組み合わせて全体を表します。生成時は、混合比率に従って分布を選び、その分布から値を取り出します。
VAEの「潜在変数」は、観測データの背後にある特徴を表す内部の数値です。入力を潜在的な表現へ変換するエンコーダと、その表現からデータを再構成するデコーダを学習します。生成時は潜在空間から値を取り出し、デコーダで画像などに変換します。ただし、内部の各数値が必ず「線の太さ」「傾き」のような、人に説明しやすい特徴と一対一で対応するわけではありません。
GANでは、生成器が作った画像を識別器が評価し、その結果を学習に利用します。識別器をうまく迷わせるように生成器が改善される一方、識別器も見分ける能力を高めます。学習後に画像を作る際は通常、生成器を使います。学習のバランスが難しく、似た出力ばかりになることもあるため、見栄えだけでなく多様性も確認します。
拡散モデルでは、学習時にデータへ加えたノイズを取り除くための予測を学びます。画像生成の典型的な流れでは、ノイズを出発点に、繰り返し処理して画像を形にしていきます。文章などの条件を反映する構成なら、指示に沿うようにこの過程を制御できます。
自己回帰モデルは、前にある要素を手がかりに次を作ります。文章の場合は、単語や単語の一部などに分割した「トークン」を単位に、続きの候補の確率を求めて選択し、その結果を含めて次のトークンを予測します。こうして一つずつ出力を伸ばしていきます。
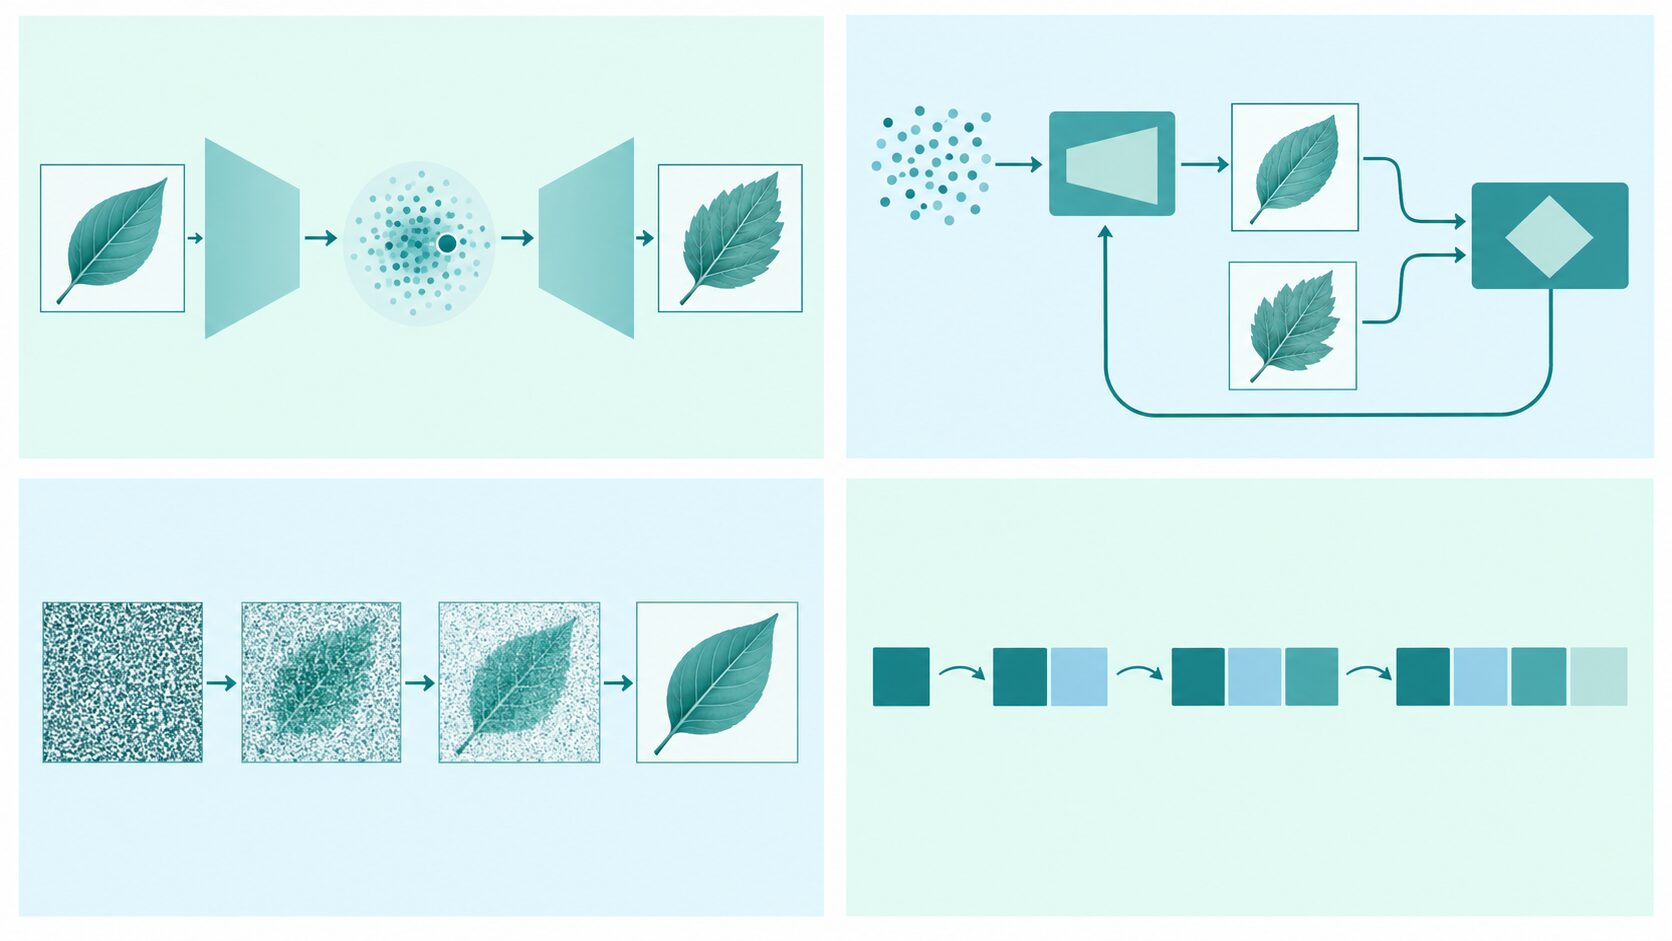
これらの用途は互いに重なり、一つのシステムで複数の考え方が組み合わされることもあります。「画像なら必ずGAN」という対応ではなく、必要な出力、条件の与え方、生成速度、学習に使えるデータや計算資源に応じて選びます。
画像・音声・文章などの活用例
生成モデルの用途を具体的に考えるには、「何を条件に入れるか」「何を生成するか」「何を確認するか」を一組にすると役立ちます。生成物が得られることと、そのまま業務や研究に使えることは分けて判断します。
| 用途 | 入力する条件の例 | 生成物の例 | 人が確認する点 |
|---|---|---|---|
| 画像制作 | 猫の姿勢、架空の人物の服装、広告の構図 | 画像やデザインの制作案 | 形の不自然さ、指定との一致、人物や既存作品との類似 |
| 超解像 | 低解像度の画像 | 細部を推定して解像度を高めた画像 | 推定された細部を元の事実と取り違えていないか |
| 音声・音楽 | 読み上げ原稿、話す速さ、曲の雰囲気 | 音声案内、ナレーション、楽曲の候補 | 読み間違い、聞き取りやすさ、声や楽曲を利用する条件 |
| 文章作成・翻訳 | 資料、目的、読者、翻訳元の文章 | 下書き、小説の展開案、翻訳文 | 事実、固有名詞、原文の意味、表現の適切さ |
| 合成データ | 学習を補いたい条件やデータの特徴 | 訓練用の画像や数値データ | 現実のデータを代表しているか、偏りや情報の漏れがないか |
| 研究・設計支援 | 分子や製品に求める性質、設計上の制約 | 分子構造や製品形状の候補 | 制約への適合、作製可能性、実験や性能評価の結果 |
画像分野では、猫や架空の人物の画像を作るほか、制作前に構図や色の案を複数比較する使い方があります。超解像も関連する用途ですが、生成モデルが補った毛並みや文字などの細部は推測です。見た目が鮮明になっても、撮影時に存在した情報を正確に復元できた証明にはなりません。
音声では、案内文の読み上げや教材のナレーションに利用できます。原稿が正しくても、人名や専門用語の読み、数字の区切り、抑揚が適切とは限らないため、実際に聞いて確認します。音楽では、曲調を変えた候補を作って作曲を支援するなど、人が選び、編集する工程と組み合わせられます。
文章生成は、説明文の下書き、小説の執筆支援、翻訳などに使えます。資料や想定読者を条件として与えると、求める内容に近づけやすくなります。ただし、自然な文章であることは、記載された事実や翻訳の正確さを保証しません。根拠となる資料や原文と照合する工程が必要です。
合成データは、実データだけでは集めにくい条件を補うために検討できます。ただし、元データにない特徴を正しく作れるとは限らず、同じ偏りを増やす場合もあります。生成に使っていない実データを評価用に確保し、合成データを加えたことで目的の性能が改善したかを確かめます。
分子構造や製品設計では、大量の候補を提案する段階を支援できます。候補の生成後には、性質の予測、シミュレーション、実験や試作による評価が別途必要です。医療や創薬でも、画像や分子を生成できることだけで、診断への有用性や薬の効果・安全性が確かめられたことにはなりません。
異常検知と欠損補完への応用
生成モデルは、新しい作品や文章を作る以外にも利用できます。データの典型的な傾向を学んだモデルなら、そこから外れた状態を探したり、観測できた部分を手がかりに欠けた部分を推定したりする方法を組み立てられます。ただし、異常検知と欠損補完は、すべての生成モデルにそのまま備わっている機能ではありません。それぞれの用途に合うモデルや評価方法が必要です。
異常検知の例として、工場設備の温度、振動、圧力の記録を考えます。正常運転のデータを学習し、新しく得た測定値が通常の傾向に合うかを調べます。単独の温度は正常範囲でも、振動や運転負荷との組み合わせが不自然なら、異常の候補になる場合があります。
判断材料には、モデルのもとでデータがどの程度生じやすいかを表す尤度や、入力を再構成したときのずれを表す再構成誤差などがあります。正常なパターンをうまく再現するモデルで、入力とのずれが大きければ、通常と異なる可能性を疑うという考え方です。
ただし、尤度が低い、あるいは誤差が大きいという理由だけで故障とは断定できません。季節変化や運転条件の変更でも値は変わります。また、異常な入力をうまく再構成してしまうことや、尤度が異常の程度と一致しないこともあります。実際のデータでしきい値を調整し、見逃しと誤検知の両方を評価したうえで、点検の優先順位づけなどに使います。
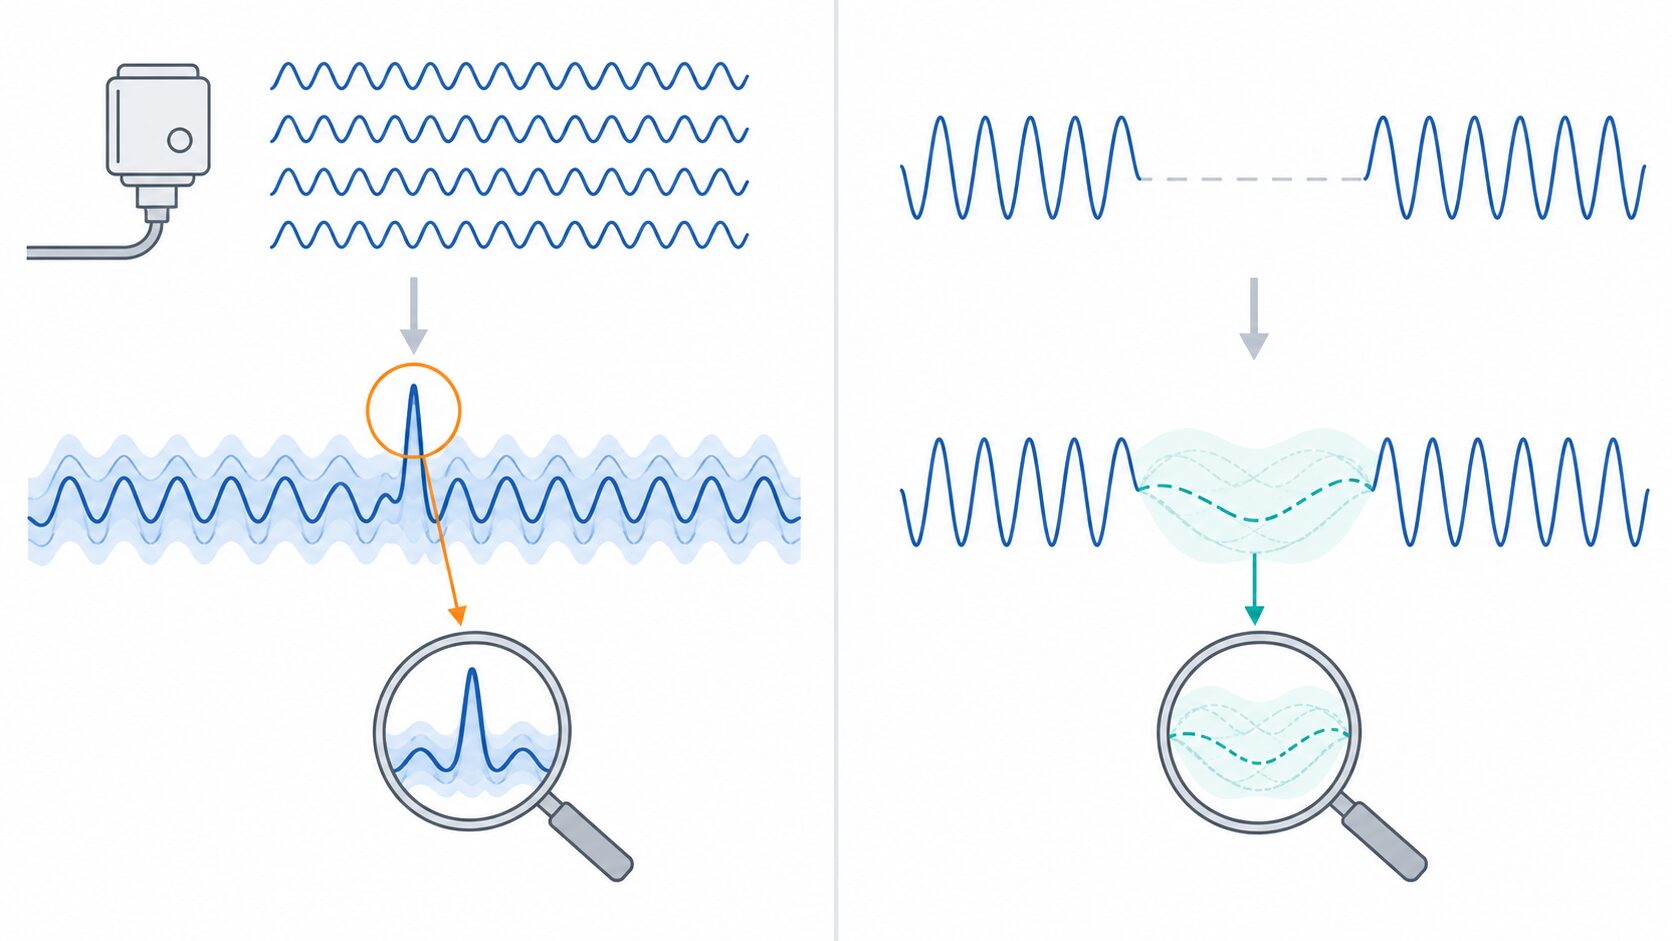
欠損補完では、観測できた情報を条件として、欠けた部分の候補を推定します。たとえばアンケートの一部の回答が空欄なら、回答済みの項目とデータ全体の関係を使って推定する方法があります。画像の欠けた領域を周囲に合うように補う処理も、条件付き生成の応用です。
補完値は、実際に観測された値ではありません。「回答を忘れた」のか、「答えたくない内容だった」のかによって、欠損が生じる仕組みは変わります。後者のように欠ける理由が回答内容と関係する場合、回答済みのデータだけをもとに補うと、結果が偏る可能性があります。
また、最もありそうな値を一つだけ埋めると、元のばらつきや推定の不確かさが見えにくくなります。目的によっては複数の補完候補で分析し、結論がどれだけ変わるかを確かめます。実測値と補完値を区別して記録し、補完によって分析の精度が必ず上がると考えないことが大切です。
利用時の注意点と今後の課題
生成モデルを使う際にまず確かめたいのは、出力のもっともらしさと、内容の正確さを分けて評価できているかです。文章では存在しない事実や根拠を含む場合があり、画像では形や位置関係に不自然さが出る場合があります。さらに、学習データに含まれる偏りが、人の描かれ方や文章の表現、生成される候補の範囲に影響することもあります。
実際の利用では、次の点を目的に合わせて確認します。
- データと出力の利用条件を確認する。学習データや入力資料をその用途で使えるか、生成物を公開・商用利用する際の条件は何かを確認します。人物の顔や声を扱う場合は利用同意を確かめ、既存作品と強く似ていないかも点検します。
- 個人情報と機密情報の扱いを決める。入力内容の保存、学習への利用、閲覧できる人の範囲などを確認し、業務上のデータをどこまで入力できるかを定めます。生成物にも元の情報が現れる可能性があるため、公開前の確認が必要です。
- 品質と多様性をまとめて評価する。一部の成功例だけで判断せず、異なる条件で必要な品質が出るかを調べます。同じような候補ばかりにならないか、指定した条件や制約を満たすかも評価します。
- 作業全体の費用と時間を比べる。学習や生成の計算コストに加え、人による確認、修正、再生成の時間も含めます。出力を速く作れても、修正が増えれば全体の負担が下がるとは限りません。
今後の課題は、生成物をさらに精細にすることだけではありません。指示や制約を安定して守る制御性、誤りや偏りを評価できる信頼性、必要な計算量を抑える効率の改善も重要です。モデルの性能向上と併せて、どの段階で人が確認し、どの結果を採用するかという運用も整える必要があります。
導入や学習を始めるときは、「何を作るのか」「どのデータや条件が必要か」「良い出力をどう判断するか」を先に決めると、選ぶべき手法が見えてきます。たとえば社内向けの下書きなら資料との整合性、画像の制作案なら条件への適合と候補の幅、異常検知なら見逃しと誤検知が評価の中心になります。
生成モデルは、データの分布を学ぶことで、新しい候補の作成や観測データの分析を支える技術です。学習、生成、評価の役割を分け、用途に合う確かめ方を用意することが、画像・音声・文章の制作から業務データの活用まで役立てるための基本になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月3日 | 学習と生成の違い、代表手法、異常検知・欠損補完の限界を追記 |