
AI・機械学習のデータ前処理とは?基本手順と注意点を初心者向けに解説

AIの初心者
「前処理」はAIの学習用データを準備する作業ですよね。なぜ、それほど重要なのですか?

AI専門家
学習結果は、材料となるデータの品質に大きく左右されるからだよ。欠けや誤りを放置すると、AIが間違った規則を覚えることもあるんだ。
AIの初心者
では、データをきれいにする以外に、どのような作業をするのでしょうか?
AI専門家
形式を揃え、欠損や重複を処理し、数値の尺度を整え、必要な特徴量を選ぶよ。目的とデータに合わせて組み合わせることが大切なんだ。
データ前処理とは。
収集した生データを、AI・機械学習モデルが学習できる品質と形式に整える一連の準備作業です。
機械学習では、モデル選びと同じくらいデータの準備が重要です。実際のデータには空欄、入力ミス、単位の違い、重複、極端な値などが混ざっています。本記事では、データ前処理の意味、代表的な方法、実際の進め方、失敗を防ぐ注意点を初心者向けに順番に解説します。
AI・機械学習の前処理とは
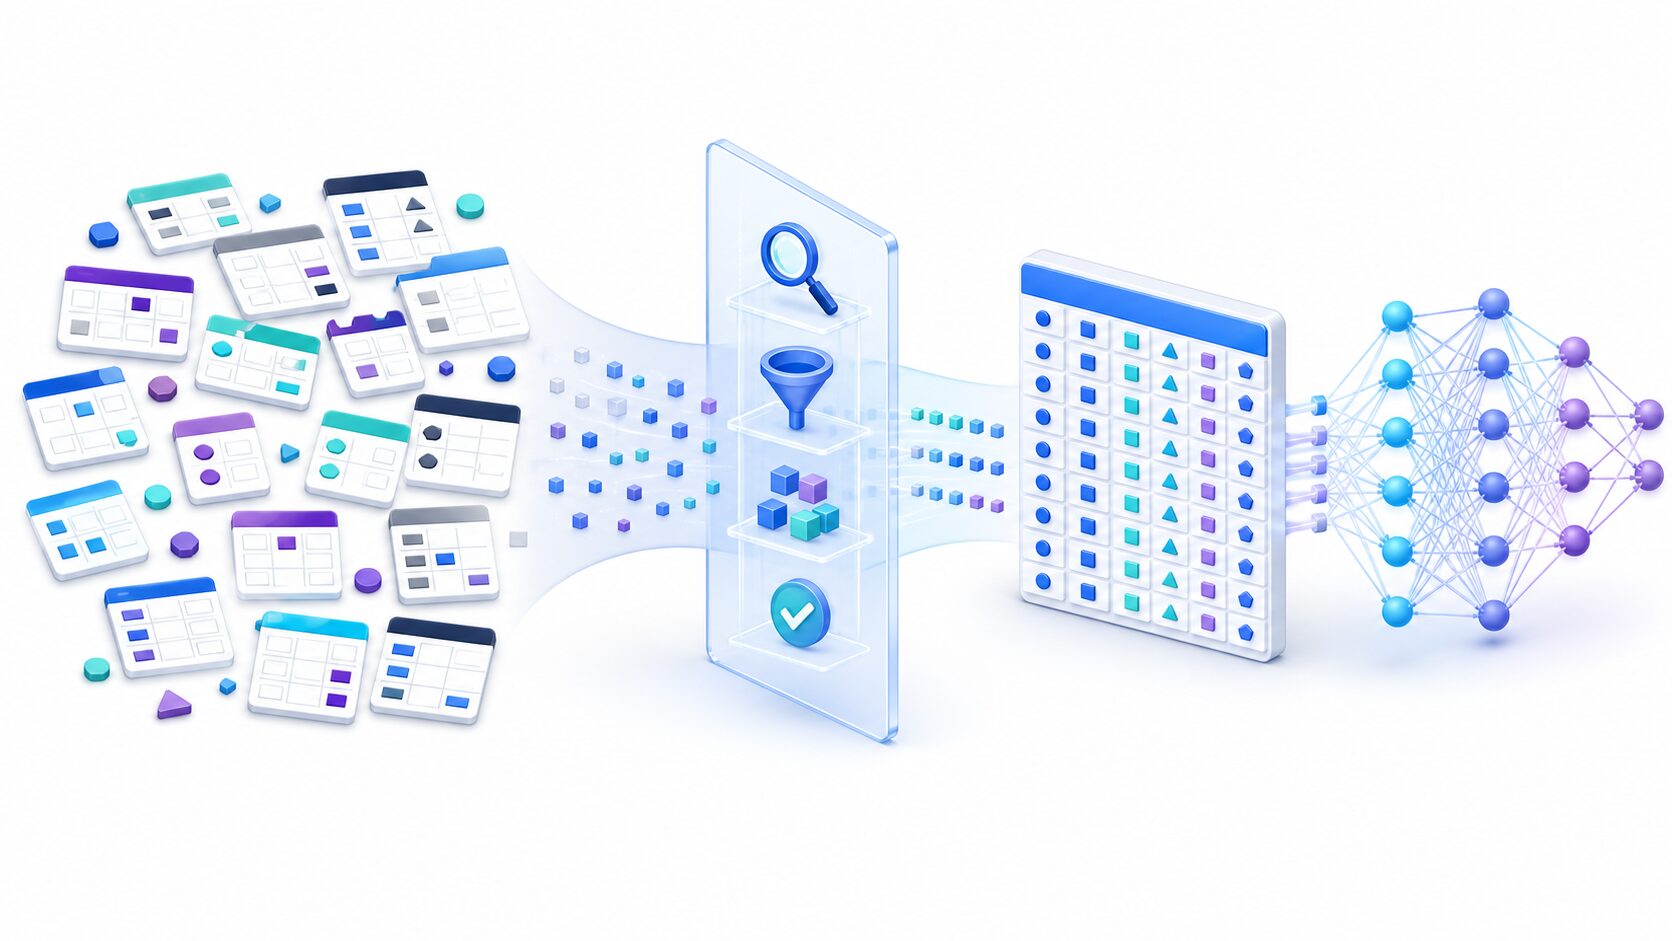
前処理とは、収集したままの生データを、モデルが扱える学習用データへ変える作業全体です。必要な列の抽出、形式の統一、誤りの修正、欠損値の処理、数値変換、特徴量作成などが含まれます。
前処理が必要なのは、モデルがデータの意味を人間のように推測できないためです。たとえば「2026/7/11」と「11-07-2026」が同じ日付だと明示されていなければ、別の形式として扱われる可能性があります。購入金額が円とドルで混在していれば、値の大小も正しく比較できません。
| 工程 | 目的 | 例 |
|---|---|---|
| 整形 | 構造や表記を揃える | 日付形式・単位・列名を統一 |
| クリーニング | 品質上の問題を処理する | 欠損、重複、誤入力を確認 |
| 変換 | モデルが扱える数値表現にする | 標準化、ワンホットエンコーディング |
| 特徴量の調整 | 予測に役立つ情報を残す・作る | 不要列の除外、購入頻度の作成 |
適切な前処理は、学習を安定させ、計算時間を抑え、未知のデータに対する予測性能を高める助けになります。ただし、前処理だけで必ず精度が上がるわけではありません。処理前後の評価を比較し、目的に合う方法を選ぶ必要があります。
データの整形:形式と構造を揃える
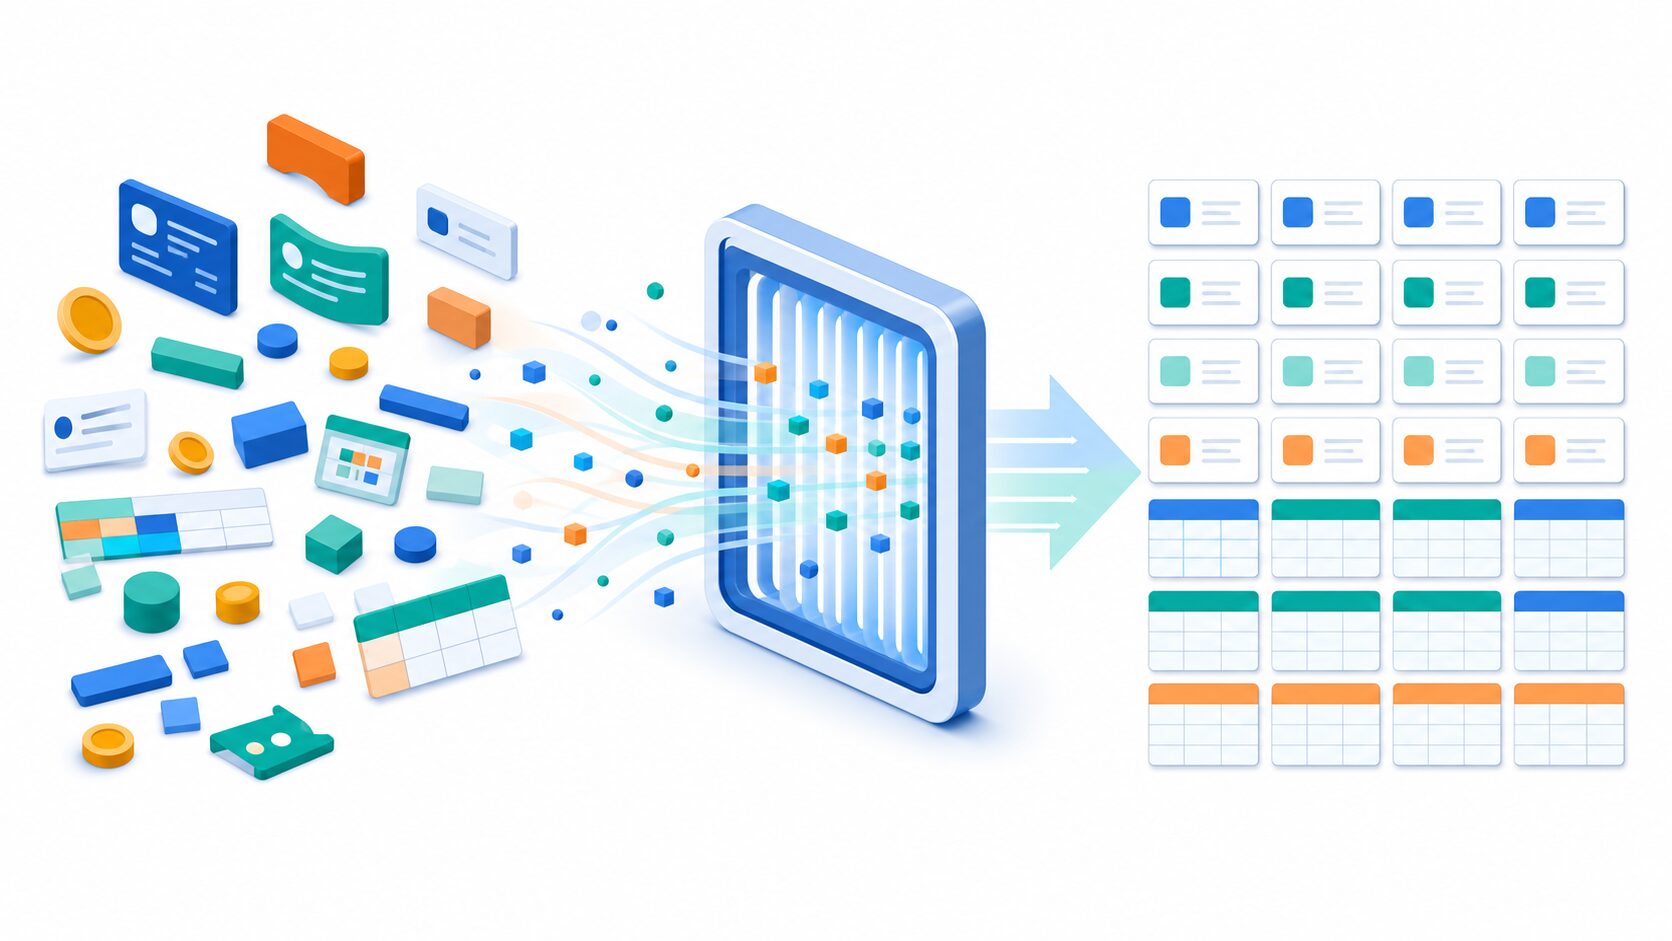
データの整形は、ばらばらな表記や構造を同じルールへ揃える工程です。日付を「YYYY-MM-DD」に統一する、金額を円へ換算する、全角・半角や大文字・小文字を揃える、表の一行を一件の記録にするといった処理が該当します。
整形の目的は、同じ意味の値を同じものとして比較できるようにすることです。「東京」「東京都」「Tokyo」が混在していると集計結果が分かれます。変換ルールを決めて統一すれば、集計や特徴量作成が安定します。
欠損値を特定の記号で表す場合も、「空欄」「なし」「N/A」「-」を一つの欠損表現へ揃えます。ただし、数値列を文字列の「不明」で埋めると計算できなくなるため、列の型と後続処理を考えて表現を選びます。
データのクリーニング:欠損・外れ値・矛盾を点検する
データクリーニングは、品質を損なう問題を見つけ、削除・修正・補完などで対処する作業です。代表例は次のとおりです。
- 欠損値:行を除外する、平均値・中央値・最頻値で補う、欠損を示す特徴量を追加する
- 外れ値:入力ミスなら修正し、実際に起きた重要な事象なら残す
- 重複:同じ記録の二重登録か、別取引なのかを識別して処理する
- 矛盾:年齢が負数、終了日が開始日より前など、業務ルールに反する値を確認する
欠損値を平均で埋めれば簡単ですが、分布が偏った年収データなどでは中央値のほうが影響を受けにくい場合があります。また、アンケートの未回答そのものに意味があることもあります。問題のある値を機械的に消すのではなく、発生理由と予測目的を確認することが重要です。
データの変換:数値の尺度とカテゴリ表現を整える
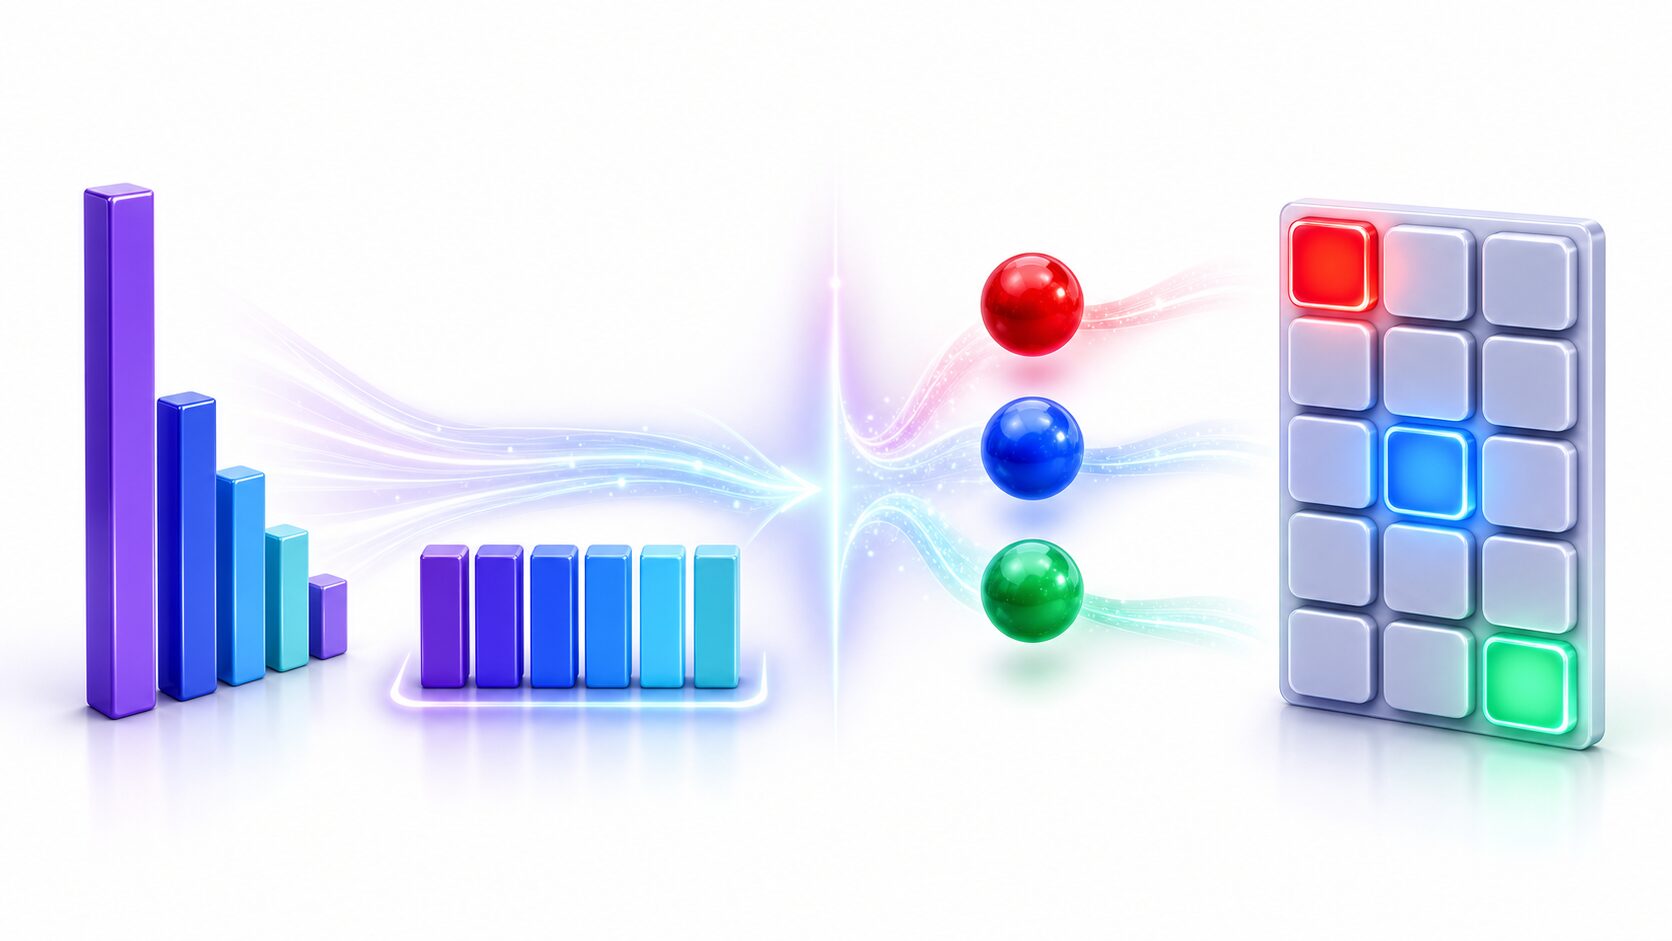
多くの機械学習モデルは数値を入力として受け取ります。そのため、値の範囲が大きく異なる数値や、「赤」「青」のようなカテゴリを適切に変換します。
| 手法 | 内容 | 使いどころ |
|---|---|---|
| 正規化 | 値を0〜1など一定範囲へ収める | 値の上下限が分かり、範囲を揃えたい場合 |
| 標準化 | 平均0、標準偏差1を基準に尺度を揃える | 距離や勾配の影響を受けるモデル |
| ワンホットエンコーディング | カテゴリごとに0・1の列を作る | カテゴリ間に順序がない場合 |
標準化は、各値から平均を引き、標準偏差で割る変換です。
\(z = \frac{x – \mu}{\sigma}\)ここで、\(x\) は元の値、\(\mu\) は平均、\(\sigma\) は標準偏差です。正規化と標準化は同じ処理ではなく、分布、外れ値、使用するモデルに合わせて選びます。決定木系のモデルのように、尺度調整の必要性が比較的小さい手法もあります。
カテゴリを単純に「赤=1、青=2、緑=3」とすると、本来ない大小関係をモデルが読み取る恐れがあります。順序のないカテゴリにはワンホットエンコーディングを使うなど、カテゴリの性質を反映させます。
特徴量の選定と特徴量エンジニアリング
特徴量とは、モデルが予測に使う入力項目です。住宅価格なら、広さ、築年数、駅からの距離などが候補になります。関係の薄い列や重複した列を大量に入れると、ノイズが増え、学習が遅くなり、過学習につながることがあります。
特徴量選定は既存の特徴量から必要なものを選ぶ作業です。相関係数、情報利得、モデルが算出する重要度、交差検証の結果などを参考にします。一方、特徴量エンジニアリングは既存データを組み合わせ、新しい特徴量を作る作業です。購入日から「前回購入からの日数」を作る例が挙げられます。
氏名や会員IDは予測に不要なことが多く、個人情報の観点でも慎重な扱いが必要です。ただし、列名だけで不要と決めず、その情報が目的変数と不自然に直結していないか、将来の予測時にも取得できるかを確認します。
購買履歴を使った前処理の具体例
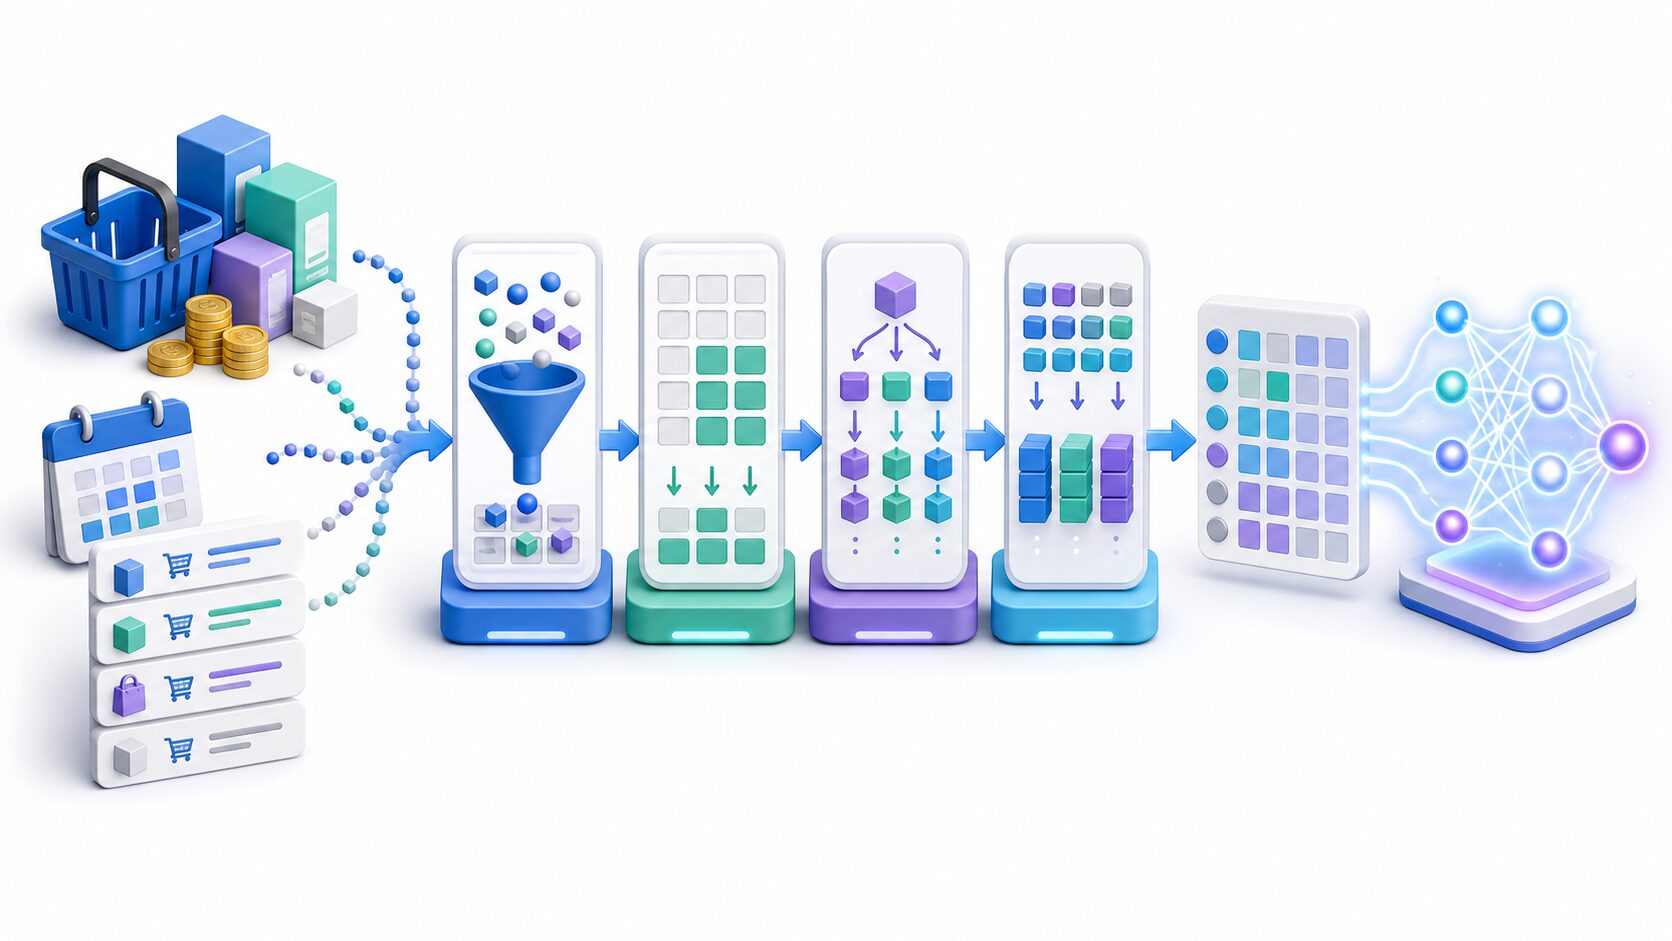
「顧客が翌月に再購入するか」を予測する例で、基本的な流れを確認しましょう。
- 目的を決める:予測対象と基準日を定義し、将来の情報が混ざらないようにする。
- 必要な列を抽出する:購入日、商品カテゴリ、購入金額などを残し、氏名や住所など直接不要な情報を除く。
- 品質を確認する:購入金額の欠損、負の金額、同一取引の重複などを調べる。
- 形式を揃える:日付、通貨、カテゴリ名を統一する。
- 特徴量を作る:購入回数、平均購入金額、最終購入からの日数などを算出する。
- 数値へ変換する:商品カテゴリを符号化し、必要な数値列を標準化する。
同じ手順がすべての課題に当てはまるわけではありません。異常購入の検知では極端な金額こそ重要ですし、顧客層の分析では年代への区分が役立つ場合があります。前処理は「きれいにする作業」だけでなく、予測したい問いに合わせてデータの意味を保つ設計です。
前処理で失敗しないための注意点
最も注意したいのはデータリークです。全データの平均を使って標準化してから学習用とテスト用へ分けると、テストデータの情報が学習側へ漏れます。先に学習用・検証用・テスト用へ分割し、補完値や平均・標準偏差は学習用データだけから求め、同じ変換器を検証用とテスト用へ適用します。
また、処理ルール、使用した列、補完値、変換器の設定を保存し、同じ入力から同じ結果を再現できるようにします。本番データにも学習時と同一の手順を適用し、カテゴリの追加や分布の変化を監視することも欠かせません。
- 前処理の前後で件数・分布・欠損率を比較する
- 削除や補完の理由を記録する
- 学習データだけで前処理の基準を決める
- 前処理を含めて交差検証し、効果を評価する
- 個人情報や差別につながる特徴量を点検する
まとめ
AI・機械学習のデータ前処理は、生データを学習に適した状態へ整える工程です。整形、クリーニング、変換、特徴量選定・作成にはそれぞれ異なる役割があります。
大切なのは、決まった処理をすべて行うことではありません。データの発生理由と予測目的を理解し、処理前後の結果を検証することです。さらに、データ分割後に変換基準を学習してリークを防ぎ、同じ手順を本番でも再現できる形にすると、信頼性の高いモデル開発につながります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年7月11日 | 前処理の工程を組み直し、データリーク対策と購買履歴の手順を追記 |