
RNN Encoder-Decoderで時系列データを扱う:仕組み・活用例・注意点

AIの初心者
「RNN Encoder-Decoder」って、どんな仕組みですか?

AI専門家
順番のあるデータを読み取り、別のデータの並びを作る仕組みだよ。入力を読み取るエンコーダと、その情報を使って出力を作るデコーダを組み合わせているんだ。文章の翻訳や、過去の気温から先の気温を予測する処理などに使えるよ。
AIの初心者
翻訳だと、日本語と英語で単語の数や順番が違っていてもよいのでしょうか?
AI専門家
その通り。エンコーダが日本語の特徴を数値で表し、デコーダはそれを手がかりに英語を順に作るんだ。入力と出力の長さをそろえる必要はないよ。ただし、内容を必ず正確に伝えられるわけではなく、学習データや文章の長さによって苦手な場面もあるんだ。
RNN Encoder-Decoderとは
RNN Encoder-Decoderは、再帰型ニューラルネットワーク(RNN)を使い、入力系列を読み取る符号化器(Encoder)と、出力系列を作る復号化器(Decoder)を組み合わせたモデルです。文章や音声、気温の記録など、順番に意味があるデータを扱います。基本構成では入力を文脈ベクトルという数値表現にまとめ、その情報を出力の生成に使います。
仕組みを理解するには、「入力をどう読み取るか」「出力をどう作るか」「その対応をどう学ぶか」を分けると見通しがよくなります。まず全体の流れを押さえ、翻訳と気温予測を例に、使いどころや長い系列を扱う際の注意点を確認しましょう。
時系列データとRNN Encoder-Decoderの基本
時系列データとは、時刻の順に並んだ観測値です。毎時の気温、日々の株価、機械のセンサー値などが当てはまります。音声も、時間とともに変化する信号として扱えます。値そのものに加え、いつ、どの順番で観測されたかが意味を持つ点が特徴です。
一方、「系列データ」は順番を持つデータを広く指します。文章の単語列にも語順がありますが、各単語が気温のような観測時刻を持つ必要はありません。文章は系列データ、気温は時系列データと区別すると、自然言語処理と数値予測の共通点と違いを理解しやすくなります。
RNNは、新しい入力を処理するときに、直前までの情報を表す「内部状態」を引き継ぐニューラルネットワークです。現在の入力だけで判断するのではなく、それまでの並びを内部状態に反映します。例えば気温なら、同じ20度でも、上昇の途中か下降の途中かという違いを学ぶための手がかりになります。
RNN Encoder-Decoderでは、入力を読むRNNと出力を作るRNNが役割を分担します。入力を読み終えてから別の系列を作れるため、短い日本語を長い英文に訳したり、24個の観測値から6個の未来値を予測したりできます。入力と出力の長さが同じでなくてもよいことが、この構成を考えるうえで大切です。
ただし、可変長の入力を処理できること自体はRNN単体にも備わっています。Encoder-Decoderの特徴は、入力系列を読み取る処理と、目的に応じた出力系列を生成する処理を組み合わせて学習できる点にあります。また、可変長だからといって、学習時より極端に長い入力でも同じ精度が得られるとは限りません。
エンコーダが入力を文脈ベクトルにまとめる仕組み
エンコーダは、入力を順に読みながら内部状態を更新します。文章なら、まず文字や単語のまとまりを「トークン」という処理単位に分け、それぞれを数値の並びに変えます。こうした数値表現を埋め込みベクトルと呼びます。RNNが実際に計算する対象は、文字そのものではなく、この数値表現です。
「今日は良い天気です」を、説明のために「今日」「は」「良い」「天気」「です」と分けて考えましょう。エンコーダは「今日」を受け取って状態を更新し、次にその状態と「は」の表現を使って更新します。これを最後まで繰り返すことで、後ろの語を処理する際にも前の語の情報を利用できます。実際のトークン分割は、使用する語彙や分割方式によって異なります。
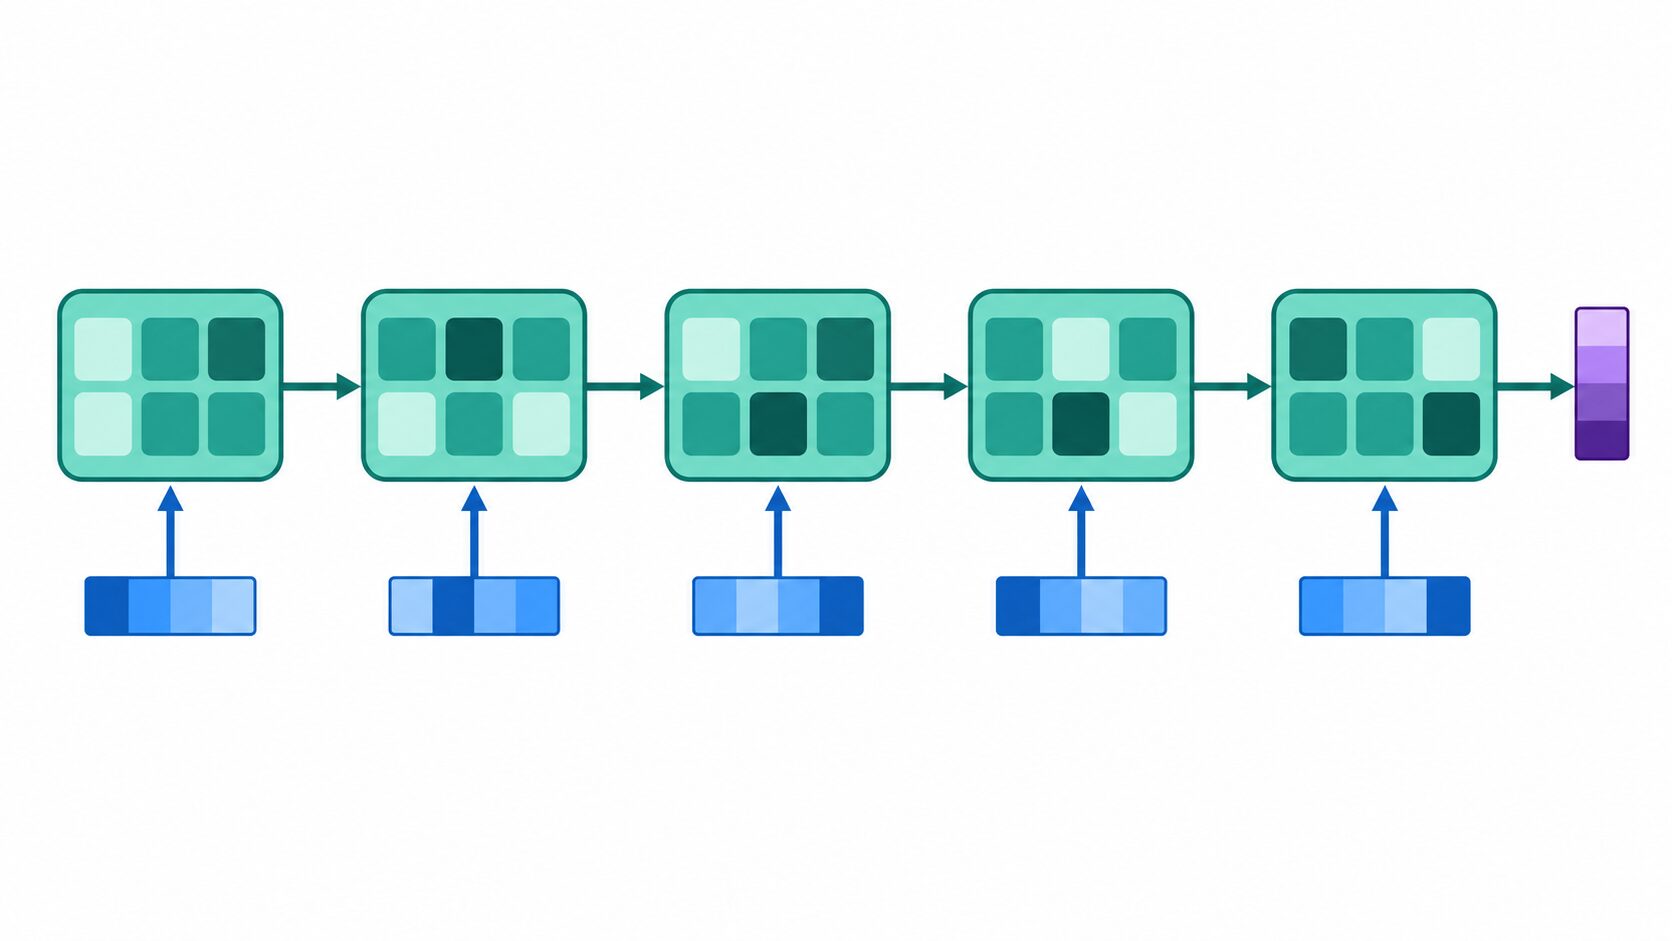
Attentionを使わない基本構成では、最後の内部状態などをもとに、デコーダへ渡す文脈ベクトルを作ります。「固定長」とは、入力が長くなっても、この表現を構成する数値の個数が一定という意味です。短文でも長文でも同じ大きさの受け渡し口を使うため、デコーダ側は入力の語数に合わせて構造を変える必要がありません。
文脈ベクトルは、文章を短い日本語で言い換えた要約ではありません。目的の出力を作るために学習された数値表現であり、入力の意味を完全に保存した圧縮データではない点に注意が必要です。どの情報が残るかは学習目的やモデルの能力に左右され、細部が十分に伝わらないこともあります。
エンコーダには、単純なRNNに加えて、LSTMやGRUというRNNの一種を利用できます。これらは、情報を残す量や新しい情報を取り込む量を調整する「ゲート」を持ち、離れた位置の情報を学習しやすくする工夫を備えています。LSTMでは内部の記憶を担うセル状態も扱います。LSTM・GRUはエンコーダ専用ではなく、デコーダにも使えます。
デコーダが出力を一つずつ生成する仕組み
デコーダは、エンコーダが作った文脈表現を手がかりに、出力系列を組み立てます。基本的な文章生成では、文脈表現をデコーダの初期状態などに反映し、生成の始まりを示す開始記号「BOS」を入力します。文脈表現が文章の内容に関する手がかりとなり、BOSが最初のトークンを生成するきっかけになります。
生成は、次の手順で進みます。
- 開始記号または直前に生成したトークンと、それまでの内部状態を使って、状態を更新します。
- 更新した状態から、語彙に含まれる各トークンが次に来る確率を計算します。
- その確率に基づいて次のトークンを選び、出力に加えます。
- 選んだトークンを次の入力に使い、終了条件に達するまで繰り返します。
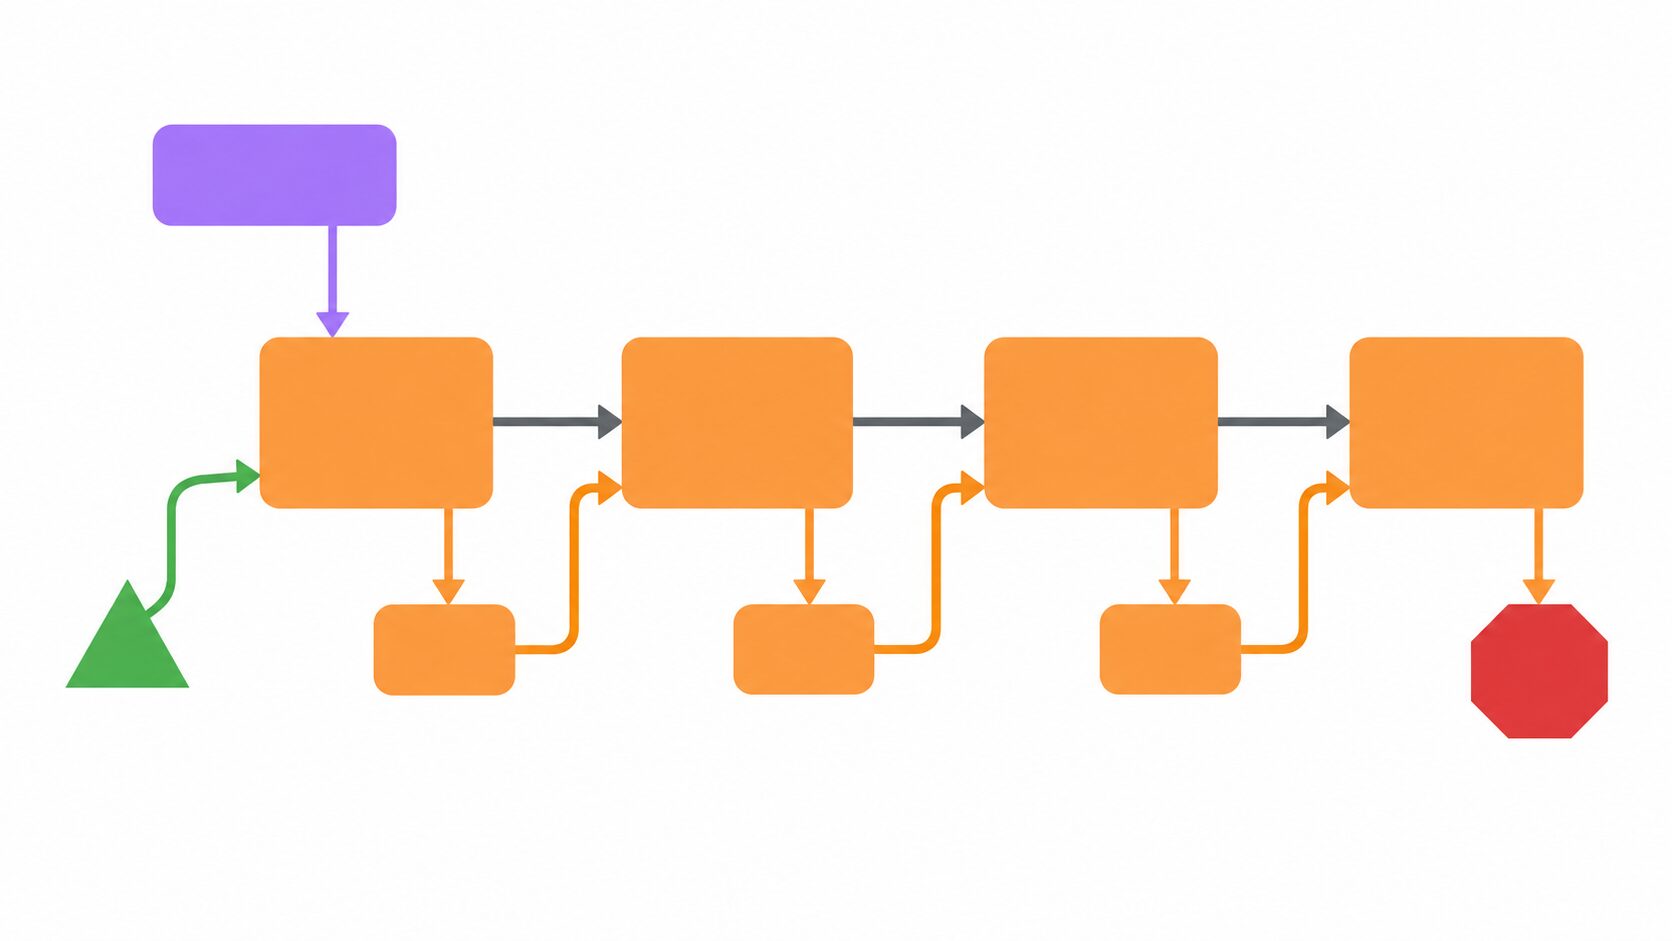
自分が生成した出力を使って次の出力を作る方法を、自己回帰的な生成と呼びます。内部状態には、それまでの出力履歴に関する情報も含まれます。したがって、直前の単語だけを見て機械的に次を選ぶわけではありません。文脈表現と生成履歴の両方が、次の候補を決める手がかりになります。
例えば、毎回最も確率が高いトークンを選ぶ方法を貪欲法と呼びます。ただし、各段階で最も確率が高い選択をしても、文章全体として最適になるとは限りません。複数の候補列を残すビームサーチなど、出力の選び方にも工夫があります。モデルが確率を出す処理と、その確率から候補を選ぶ処理は分けて考えられます。
文章では、終了記号「EOS」が出力された時点で生成を止めます。終了記号が出ない場合に備え、最大生成長も設定します。一方、数値の時系列予測では「次の6時間分」のように出力の長さをあらかじめ決められます。BOS・EOSは文章生成で使う設計であり、すべての数値予測に必須というわけではありません。
翻訳の具体例で見る学習と生成の流れ
日本語の「私は猫が好きです」を、英語の「I like cats.」へ変換する例で全体を追ってみましょう。エンコーダは日本語のトークン列を読み、その情報を文脈表現にまとめます。デコーダは文脈表現と開始記号から生成を始め、「I」「like」「cats」「.」に相当するトークンを順に出力し、最後に終了記号を出します。ここでの分割は説明用の例です。
この処理は、日本語の単語を同じ位置の英単語へ置き換える操作ではありません。日本語では「猫」が「好き」より前にありますが、英文では「like」が「cats」より前に来ます。入力側の語順を読み取り、出力先の言語に合った語順や長さを学ぶために、エンコーダとデコーダが連携します。
その対応を学習するには、日本語の文と正解の英文を組にした教師データが必要です。モデルの予測と正解のずれを損失として計算し、そのずれが小さくなるように、エンコーダとデコーダの重みを更新します。文章生成では一般に交差エントロピーという損失を使い、正解のトークンに高い確率を与えるよう学習します。
学習時によく使う方法が「Teacher Forcing」です。例えば「cats」を予測する段階では、モデルが直前に何を予測したかにかかわらず、正解の「like」を入力します。正しい出力履歴を与えることで、次のトークンの予測を学びやすくします。
実際に未知の文章を翻訳する推論時には、正解の英文を参照できません。そのため、モデル自身が選んだトークンを次の入力に使います。学習時と推論時ではこの条件が異なり、途中で誤った語を選ぶと、それが後続の生成にも影響することがあります。学習中の損失だけで判断せず、未知の入力から最後まで生成させた結果を確かめることが大切です。
翻訳・要約・音声認識と時系列予測への活用
RNN Encoder-Decoderは、入力と出力の対応を学習できるさまざまな課題に利用できます。ただし、翻訳用に学習したモデルが、そのまま音声認識や気温予測をできるわけではありません。用途に合った入力表現、出力形式、教師データを用意します。
| 用途 | 入力データ | 出力データ | 学習に必要な対応例 |
|---|---|---|---|
| 機械翻訳 | 日本語の文章 | 英語の文章 | 原文と対訳の組 |
| 文章要約 | 長い文章 | 短い要約文 | 本文と要約の組 |
| 音声認識 | 時間順に並ぶ音声特徴量 | 発話に対応する文字列 | 録音と書き起こしの組 |
| 時系列予測 | 過去24時間の気温 | 次の6時間の気温 | 過去の観測区間と、その直後の実測値の組 |
| 画像の説明文生成 | 画像から抽出した特徴 | 画像の内容を説明する文章 | 画像と説明文の組 |
文章要約では、入力の内容から必要な情報を選び、短い文章を生成するよう学びます。短くできれば正解というわけではなく、重要な内容を落としていないか、原文にない内容を加えていないかも確認が必要です。音声認識では、例えば短い時間区間ごとに抽出した音の特徴を入力し、文字列を出力します。音声の区間数と文字数を一致させる必要はありません。
数値予測の例として、1時間ごとに測った過去24時間の気温から、次の6時間の気温を予測する場合を考えます。エンコーダに渡す24時間が「観測窓」、予測対象となる未来6時間が「予測窓」です。デコーダが1時間先から6時間先まで順に値を出すよう構成すれば、複数の時点をまとめて予測する課題として扱えます。
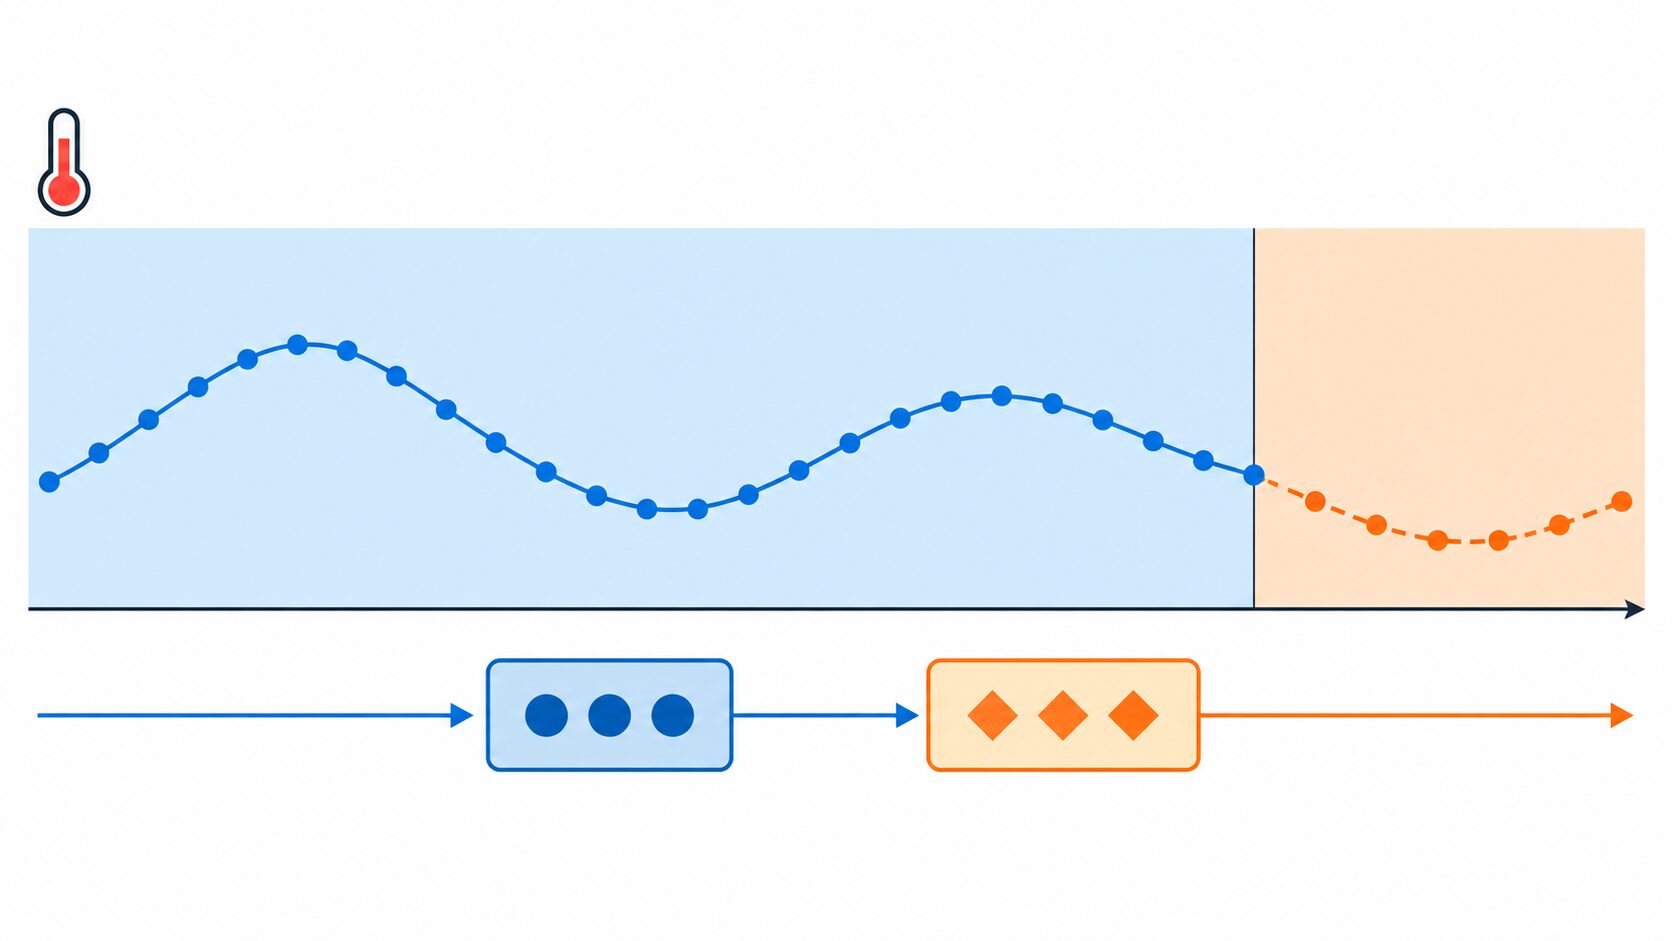
文章生成では語彙の中からトークンを選びますが、気温予測では「21.3度」のような連続値を出します。そのため、出力層や損失の設計を変え、平均二乗誤差や平均絶対誤差などで実測値とのずれを測ります。予測値を次の入力に戻す方式では、文章と同様に誤差が後続の出力へ影響するため、1時間先だけでなく6時間先までの誤差も確認します。
時系列予測の評価では、予測する時点で知り得ない未来の情報を混ぜないことが重要です。例えば、古い期間を学習用、その後の期間を検証用、さらに後の期間を最終評価用に分けます。観測窓と予測窓を作る際も、学習用の正解データが評価期間へ入り込まないようにします。値の標準化に使う平均や分散は学習期間から求め、欠損値を補う処理でも未来の観測を参照しないようにします。
性能を判断するときは、「最後に観測した気温がこの先も続く」という単純な予測や、「前日と同じ時刻の気温を使う」という基準とも比較します。複雑なモデルを導入しても、データ量や変動の性質によっては単純な方法を上回らないことがあります。誤差の大きさに加え、必要なデータ量や予測にかかる時間も導入の判断材料です。
画像から「公園で子供が遊んでいる」といった説明文を作る応用も、Encoder-Decoderの考え方で捉えられます。ただし、この場合の画像エンコーダにはCNNなどを使えます。画像を扱う側まで必ずRNNにするわけではなく、両側にRNNを使う系列変換とは区別して理解しましょう。
長い系列での課題とAttentionによる補完
長い入力を扱うときには、まず文脈表現の受け渡しが課題になります。基本構成では、入力の長さにかかわらず固定次元の表現に情報を集めます。文章が長くなり、人名、数量、条件などの情報が増えると、出力に必要な細部まで一つの表現に保持することが難しくなります。これが固定長の文脈表現による情報のボトルネックです。
これとは別に、RNNの学習には勾配消失や勾配爆発という問題があります。勾配とは、重みをどちらへどれだけ調整するかの手がかりです。多くの時点をさかのぼって学習の信号を伝える過程で、勾配が極端に小さくなると、遠い位置の情報に対応する重みを更新しにくくなります。反対に、極端に大きくなると、更新が不安定になることがあります。
LSTMやGRUは、離れた時点にまたがる関係である長期依存を学習しやすくしますが、無制限に情報を記憶できるわけではありません。また、勾配爆発には、勾配の大きさを一定の範囲に抑える勾配クリッピングなどを使います。情報を渡す表現の容量と、学習を安定させる問題は、分けて対処する必要があります。
情報の受け渡しを補う仕組みがAttention(注意機構)です。エンコーダの最後の状態だけに頼らず、デコーダが出力するたびに、入力側の各時点の状態を重み付きで参照します。現在作ろうとしている出力に関係が深い状態へ大きな重みを付け、それらを組み合わせて、その段階で使う文脈表現を作ります。
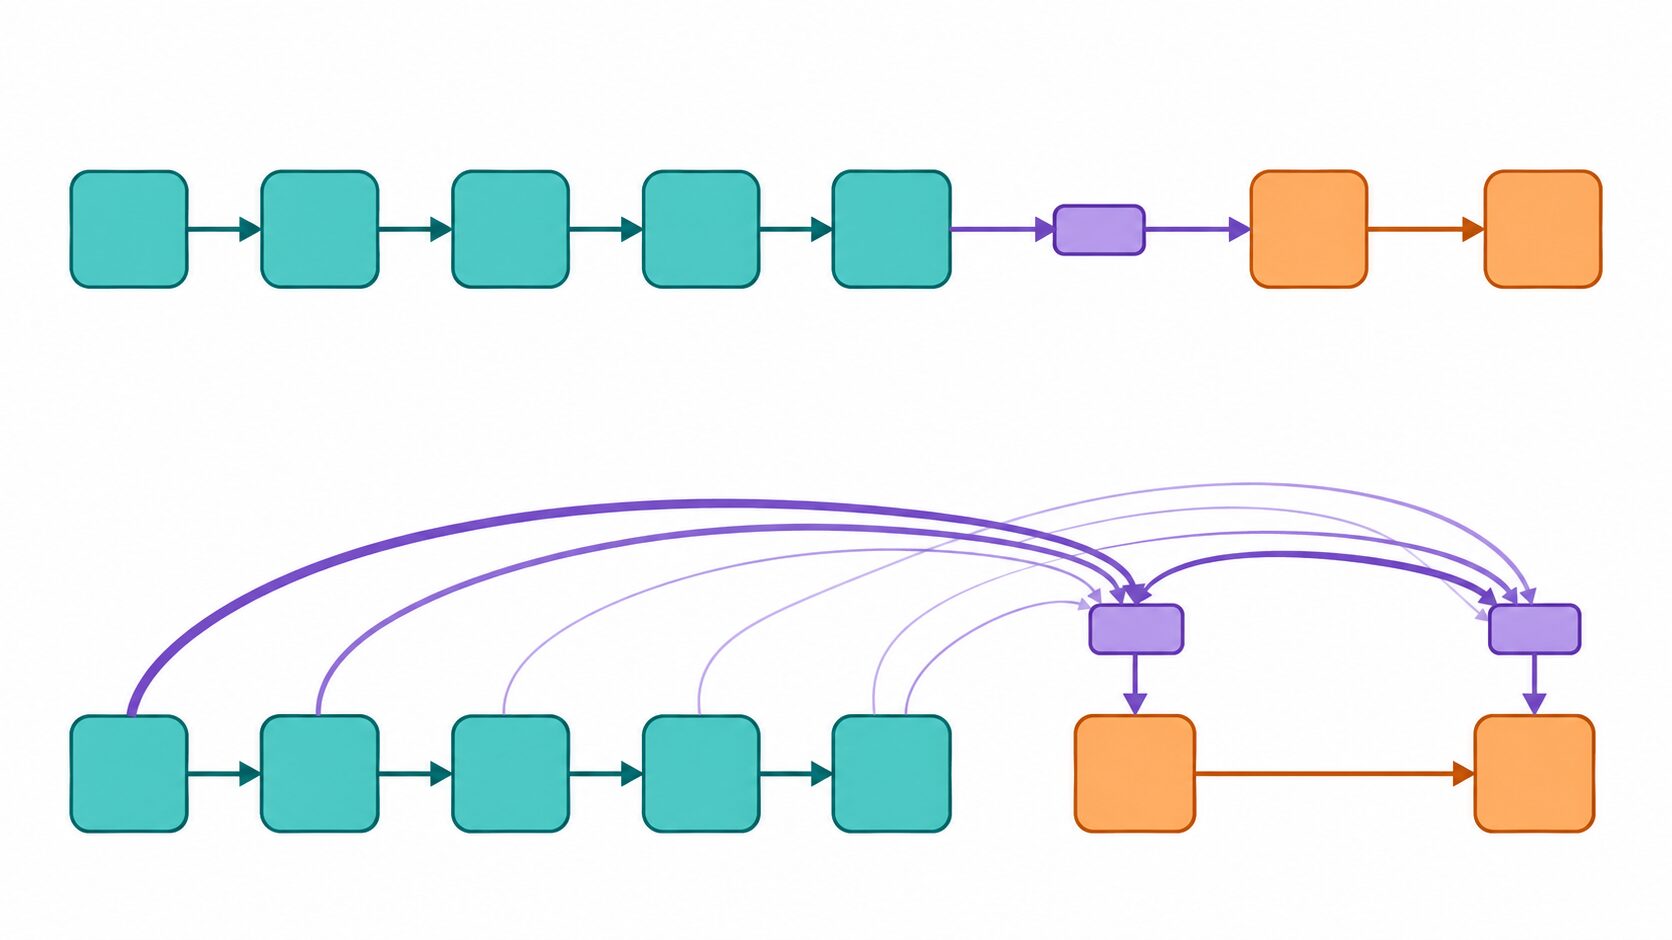
「私は猫が好きです」を訳す場合、「cats」を作る段階では「猫」に対応する入力側の状態を強く参照できる、というイメージです。参照先は出力の段階ごとに変わるため、日本語と英語で語順が違っても対応を学べます。ただし、Attentionの重みは必ず一つの単語だけに集中するものではなく、人間が考える単語の対応と常に一致するわけでもありません。
Attentionは、最終状態だけに情報を集める制約を緩めますが、RNNに追加した場合、RNN自体の順次処理は残ります。さらに、各入力状態の保存や参照にも計算資源が必要です。長い系列では、精度が改善したかだけでなく、処理時間やメモリ使用量が用途に合うかも確かめましょう。
Seq2Seq・Autoencoder・Transformerとの違い
EncoderとDecoderという名前は、ほかのモデルにも登場します。関連用語を整理するときは、「どのような課題を解く枠組みか」「何を学習するか」「どの構造で計算するか」を分けると混同を防げます。
| 用語 | 意味・役割 | RNN Encoder-Decoderとの関係 |
|---|---|---|
| Seq2Seq | 系列を受け取り、別の系列を出力する枠組み | RNN Encoder-Decoderは、その実現方法の一つ |
| RNN Encoder-Decoder | 入力の読み取りと出力の生成をRNNで行う構成 | 内部状態を引き継ぎながら系列を順に処理する |
| Autoencoder | 入力を表現に変え、入力自身を再構成することを基本とするモデル | 部品名は共通するが、翻訳などとは学習目的が異なる |
| Transformer | Attentionを中心に系列を扱うモデル構造 | RNNとは別の構造で、Encoder-Decoder型としても使える |
Seq2Seqは「Sequence to Sequence」の略です。日本語から英語、音声特徴量から文字列といった系列同士の変換を指し、その内部を必ずRNNで実装するという意味ではありません。RNN Encoder-Decoderを学ぶことは、Seq2Seqを実現する一つの具体的な方法を学ぶことになります。
Autoencoderでは、例えば画像を入力し、元の画像を再構成するよう学習します。入力を表現に変える部分をEncoder、そこから復元する部分をDecoderと呼ぶ点は共通しますが、翻訳では入力と同じ日本語を復元することが目的ではありません。部品の名前だけでなく、何を正解として学習するのかを見ることが大切です。
TransformerはRNNの一種ではなく、Attentionを中心に系列内の関係を計算する別の構造です。Encoder-Decoder型のほか、Encoderのみ、Decoderのみを使う構成もあります。したがって、「Transformer」と聞いただけでは、必ず二つの部分に分かれた翻訳モデルを意味するわけではありません。
Transformerは、RNNのように直前の内部状態の計算を待つ必要がないため、学習時には系列の各位置を並列に処理しやすい特徴があります。ただし、自己回帰的に文章を生成する場合は、生成済みのトークンを使って次を決めるため、逐次的な処理が残ります。「Attentionを使うこと」と「文章を一度にすべて生成できること」は同じではありません。
モデルを選ぶ際は、系列の長さ、利用できる学習データ、必要な精度、計算環境を合わせて比較します。RNN Encoder-Decoderを理解する出発点は、入力から特徴を読み取るエンコーダと、その情報をもとに出力を組み立てるデコーダの役割をつかむことです。そのうえで、情報の受け渡しにAttentionを加えると何が変わるかを追うと、関連するモデルの違いも理解しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月29日 | 学習と生成の違い、気温予測の評価方法、Attentionの役割を追記 |