
画像認識の進化:インスタンスセグメンテーションの意味・仕組み・活用例

AIの初心者
「インスタンスセグメンテーション」は、画像のどこに何があるかを調べる技術ですよね?セマンティックセグメンテーションとは、どう違うのですか?

AI専門家
大きな違いは、同じ種類のものを一つずつ区別するかどうかだよ。写真に人が3人写っていたら、セマンティックセグメンテーションは、それぞれの人が写る画素を「人」に分類する。インスタンスセグメンテーションは、それに加えて「人1」「人2」「人3」と分け、一人ずつの領域を取り出すんだ。
AIの初心者
同じ「人」でも別々に扱えるのですね。人が重なって写っている場合や、空のような背景も分けられるのでしょうか?
AI専門家
重なっていても、見えている部分を手掛かりに一人ずつ分けることを目指すよ。ただし、隠れた体の形まで必ず復元できるわけではないんだ。空や路面も分類したい場合は、背景を扱うセマンティックセグメンテーションや、個体の区別もできるパノプティックセグメンテーションを検討するよ。
インスタンスセグメンテーションとは
インスタンスセグメンテーションは、画像の中の対象を一つずつ区別し、それぞれが占める領域を画素単位で推定する技術です。「個体分割」や「インスタンス分割」とも呼ばれ、同じ種類の物体が複数あるときも、個体ごとに位置や形を扱えます。
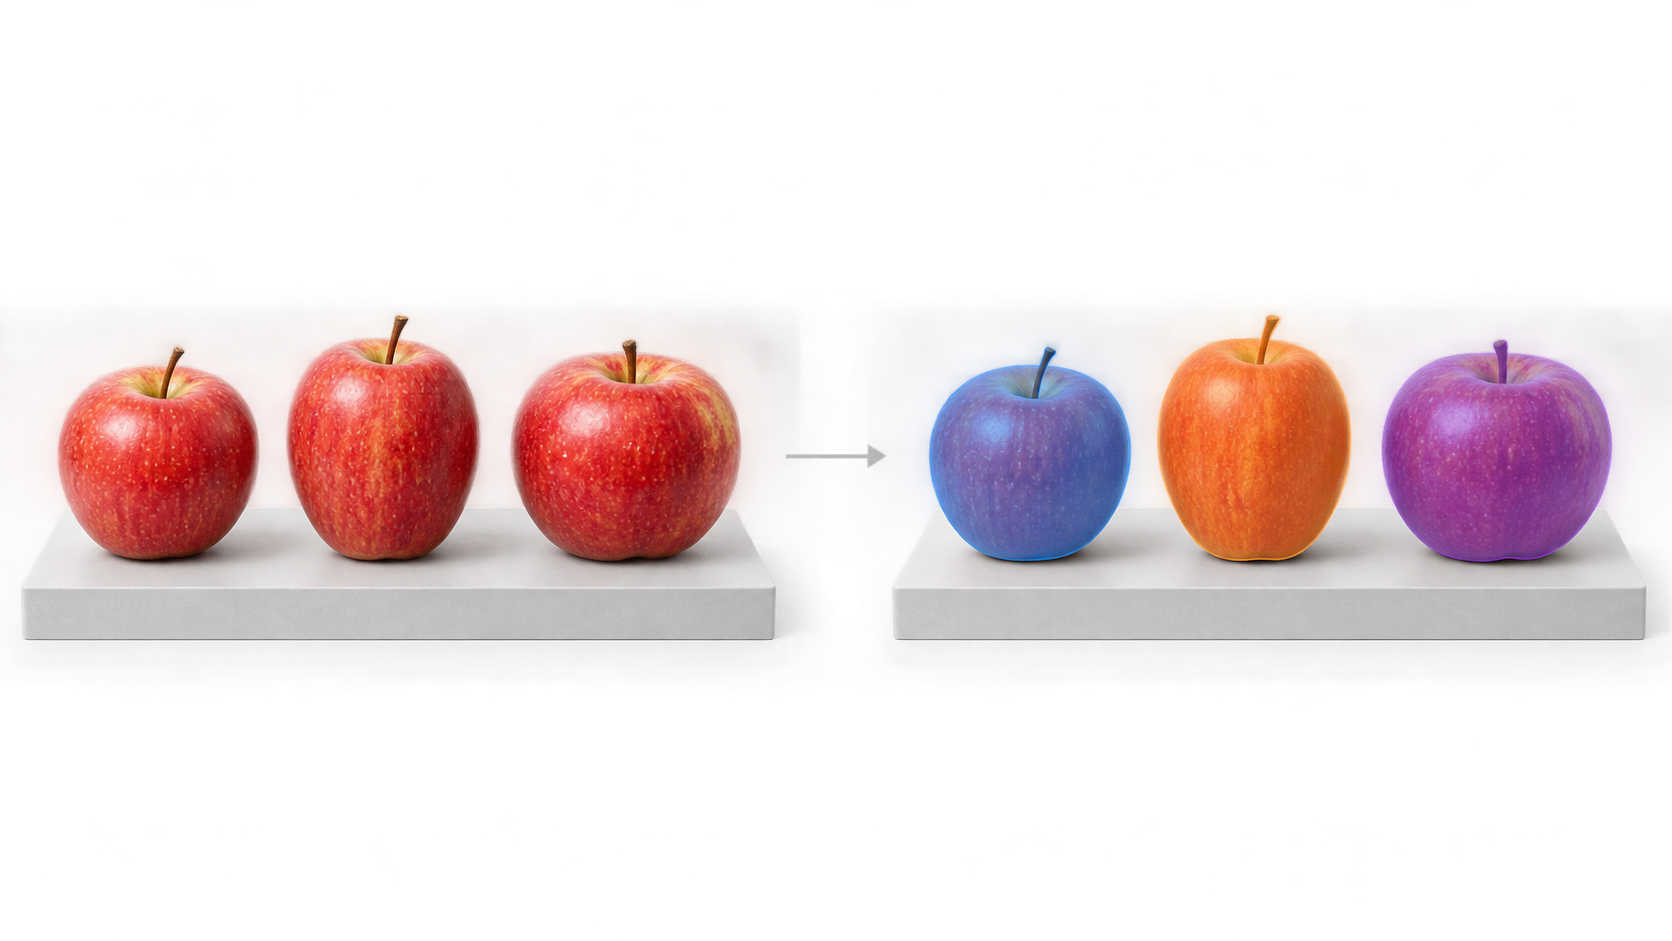
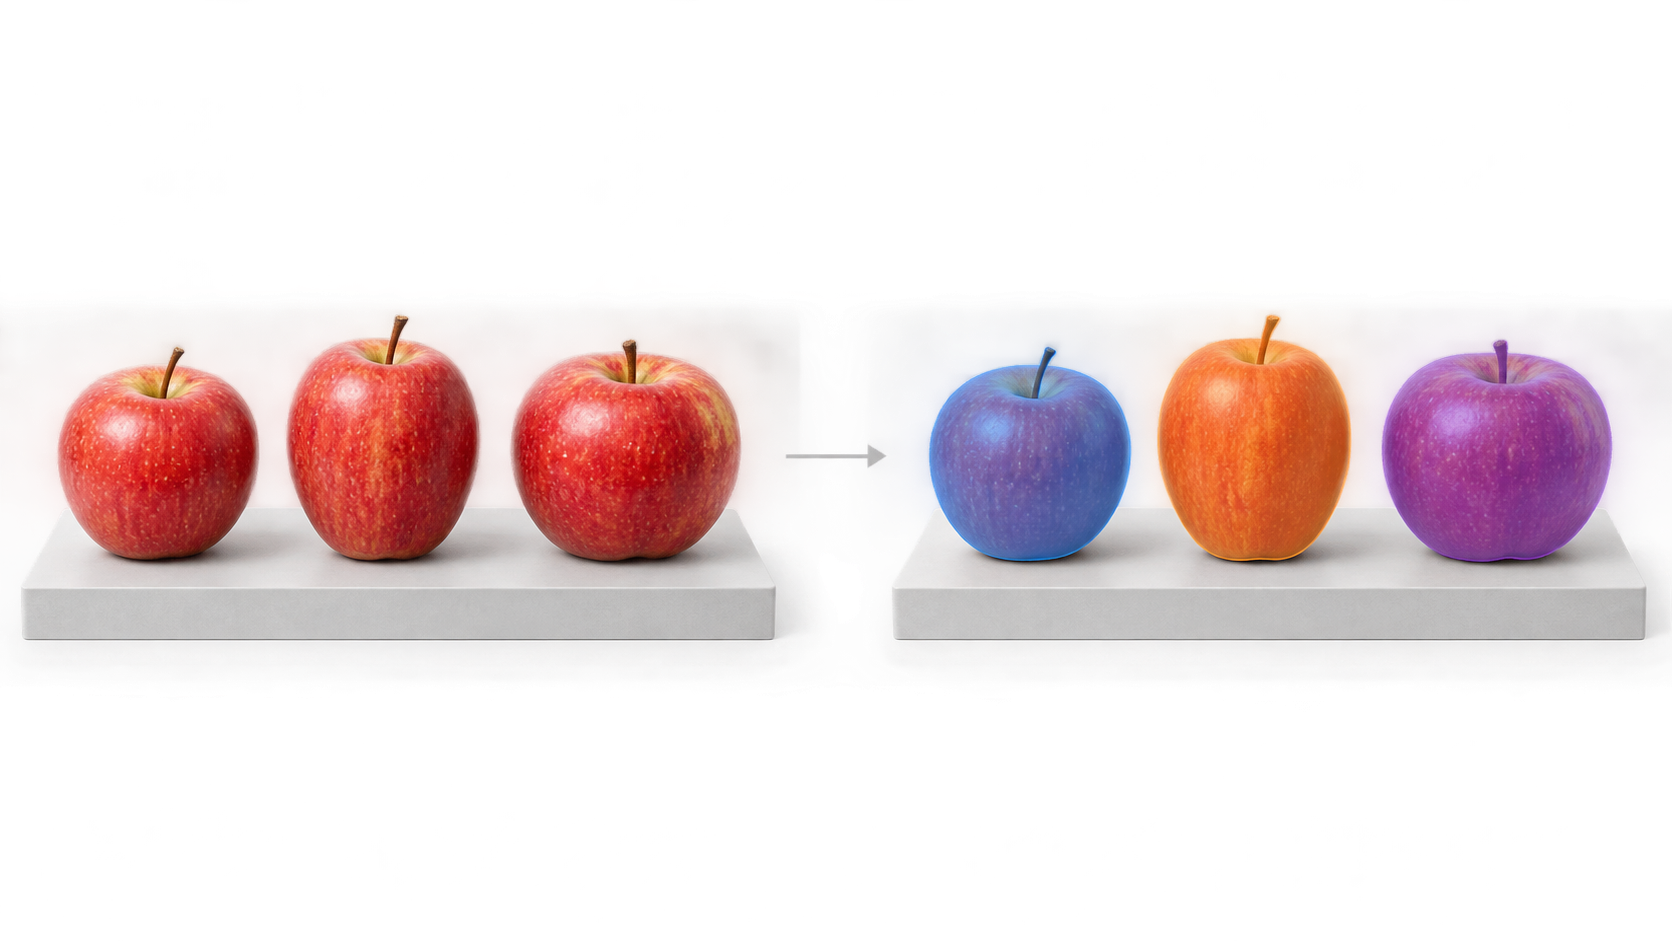
たとえば、3個のリンゴをすべて「リンゴ」と判断するだけでなく、それぞれの輪郭に沿って領域を分けます。個体別の領域を色分けすると、「何があるか」と「どれが別の物体か」の違いを捉えやすくなります。この記事では、この出力の意味から、ほかの画像認識手法との違い、仕組み、活用時の注意点まで説明します。
インスタンスセグメンテーションとは
「インスタンス」は、ここでは一つひとつの個体を意味します。一方、「セグメンテーション」は画像を領域に分けることです。画像を構成する小さな点を画素といい、そのうち対象の個体に属すると推定した画素の集合をマスクと呼びます。マスクは、写真からその物体の部分だけを選択するための型紙をイメージすると理解しやすいでしょう。
リンゴが3個写っている場合、種類を表す「クラス」は3個とも「リンゴ」です。しかし、個体としては別なので、マスクはリンゴごとに作ります。この結果から、どの位置にリンゴがあり、画像上でどのような形をしているかを調べたり、検出された個数を数えたりできます。個体を区別する番号と、物体の種類を表すクラスは、異なる情報です。
マスクの利点は、四角い枠の内側を一律に対象とみなさず、輪郭に沿って領域を取り出せることにあります。たとえば曲がったバナナでは、物体を囲む四角い枠の中に背景が多く含まれます。マスクを使えば、バナナに属する画素を選び、その範囲の色や見かけの面積を調べられます。ただし、輪郭はモデルによる推定なので、常に実物と完全に一致するとは限りません。
画像認識には、画像全体が何を表すかを判断する「画像分類」、個々の物体の位置を求める「物体検出」、画素ごとの領域を求める「セグメンテーション」などがあります。インスタンスセグメンテーションは、個体ごとの細かな領域が必要な場面を担う手法です。画像全体の分類だけで目的を達成できる場面もあり、一つの手法がほかを一律に置き換えるわけではありません。
なお、「リンゴ1」「リンゴ2」という番号は、基本的にはその画像内で区別するためのものです。動画の次のコマでも同じリンゴに同じ番号を付け続けたい場合は、フレーム間で個体を対応付ける追跡の仕組みが必要になります。
物体検出・セマンティック・パノプティックとの違い
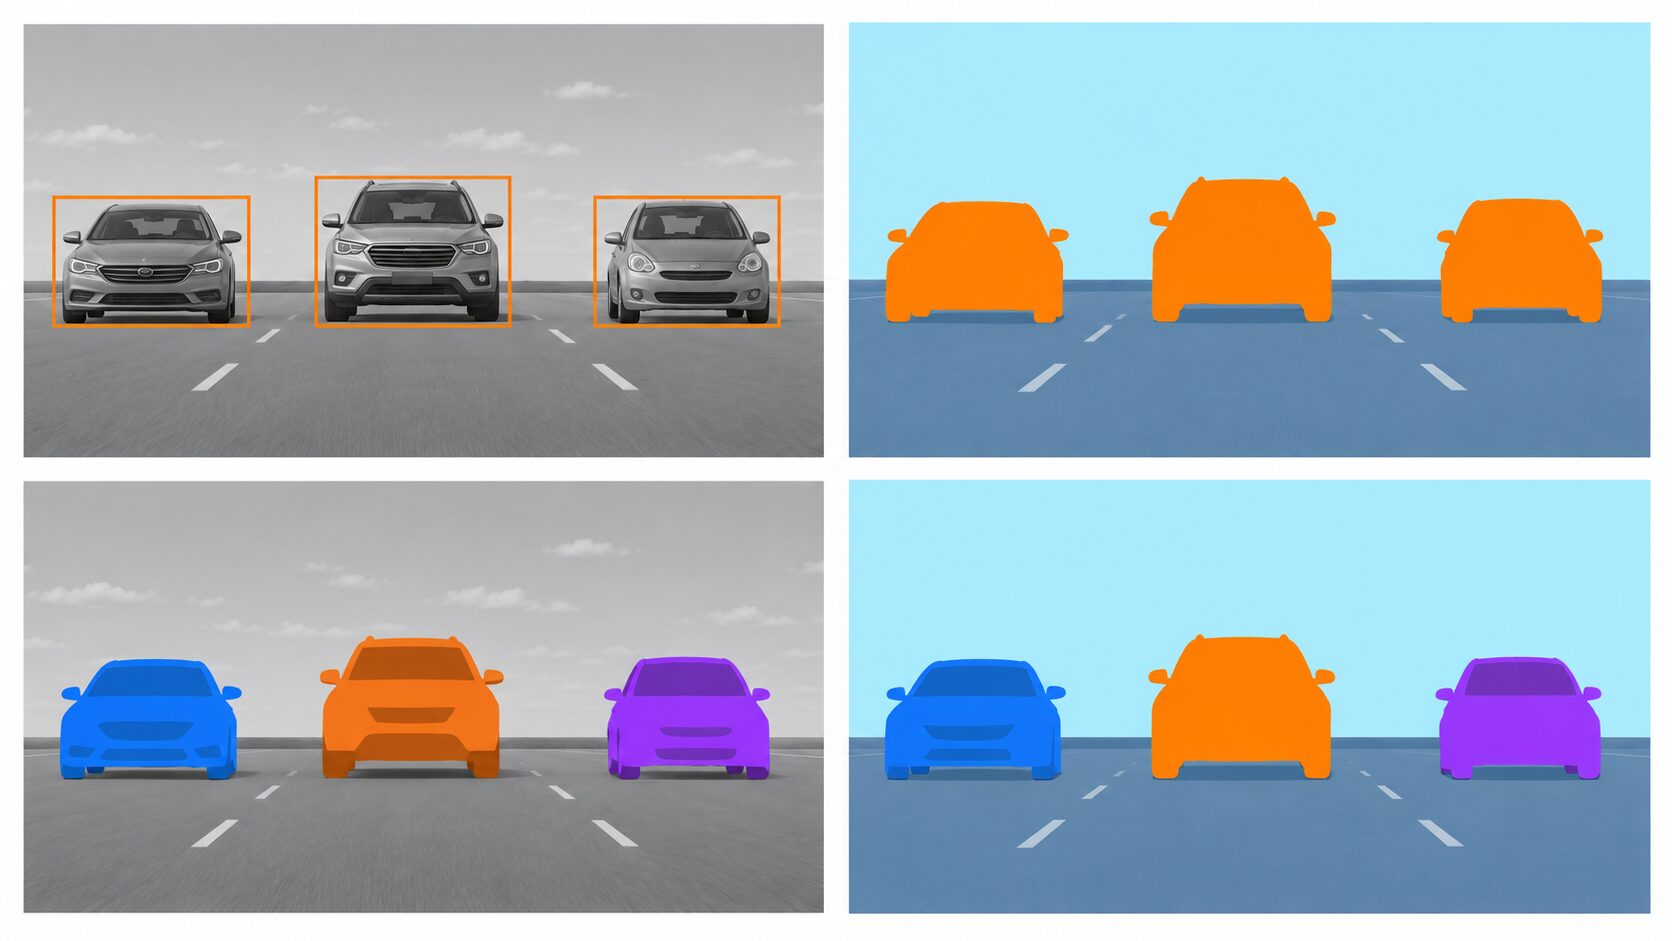
手法の違いは、同じ写真から何を出力するかで比べると明確です。3個のリンゴの写真を物体検出で処理すると、それぞれを囲む矩形、つまり四角い枠と「リンゴ」というクラスが得られます。セマンティックセグメンテーションでは、リンゴに属する画素がすべて同じクラスになります。インスタンスセグメンテーションでは、リンゴというクラスに加えて、3個それぞれのマスクが得られます。
セマンティックセグメンテーションは「意味分割」とも呼ばれます。同じクラスの領域が離れていても、それぞれに個体の番号を付ける仕組みではありません。したがって、リンゴが離れて写っている場合も、セマンティックの出力だけから各領域が何個のリンゴに対応するかを常に決められるわけではありません。特に、物体同士が接している場面では、同じクラスの中をさらに個体に分ける必要があります。
車と路面が写る場面でも、比較の軸は同じです。車を枠で示すのか、車に属する画素をまとめるのか、車一台ずつのマスクを作るのかで、利用できる情報が変わります。そこに空や路面などの分類も組み合わせるのが、パノプティックセグメンテーションです。
| 比較する項目 | 物体検出 | セマンティックセグメンテーション | インスタンスセグメンテーション | パノプティックセグメンテーション |
|---|---|---|---|---|
| 主な出力 | 物体ごとの矩形とクラス | 画素ごとのクラス | 個体ごとのマスクとクラス | 画素ごとのクラスと、数えられる物体の個体情報 |
| 同じ種類の個体の区別 | 物体ごとの枠で区別する | 個体の番号は付けない | 個体ごとのマスクで区別する | 車や人などの個体を区別する |
| 輪郭の扱い | 輪郭に沿う領域は出力しない | クラスの境界を画素単位で表す | 各個体の領域を画素単位で表す | 各個体と連続した領域の境界を画素単位で表す |
| 空・路面などの扱い | 通常は物体の検出対象に含めない | 設定したクラスとして分類できる | 通常は個体分割の対象に含めない | 個体の分割とともにクラス分けする |
| 適した用途 | 位置の把握、個数の集計 | 路面や空、臓器などの領域抽出 | 個体別の形状・面積の計測 | 個々の物体と周囲の領域を含む場面全体の理解 |
物体検出でも、検出した枠を数えて個数を求められます。インスタンス分割の意義が特に大きいのは、「何個あるか」に加えて、「一つずつの形や面積はどうか」を知りたい場合です。数え上げだけが目的なら、処理速度や誤検出の傾向も比べたうえで物体検出を選ぶ余地があります。
背景の扱いも、課題の定義に関わります。人や車、リンゴは一つ、二つと数えられる物体です。一方、空や路面は、通常は個数を数えるよりも、その領域が何に当たるかを知りたい対象です。これらをインスタンス分割で通常扱わないのは、単に境界が曖昧だからではありません。空と建物の境界がはっきり写っていても、「空1」「空2」と分ける必要がなければ、クラスごとの領域抽出が目的に合います。
パノプティックセグメンテーションは、こうした個体の区別と、空・路面などのクラス分けを統合する手法です。「空も認識したい」という要望には、学習データを追加するだけでなく、背景の領域が必要なのか、個々の物体も同時に区別したいのかを確かめ、適した課題と出力形式を選ぶことが大切です。
個体ごとのマスクを作る仕組み
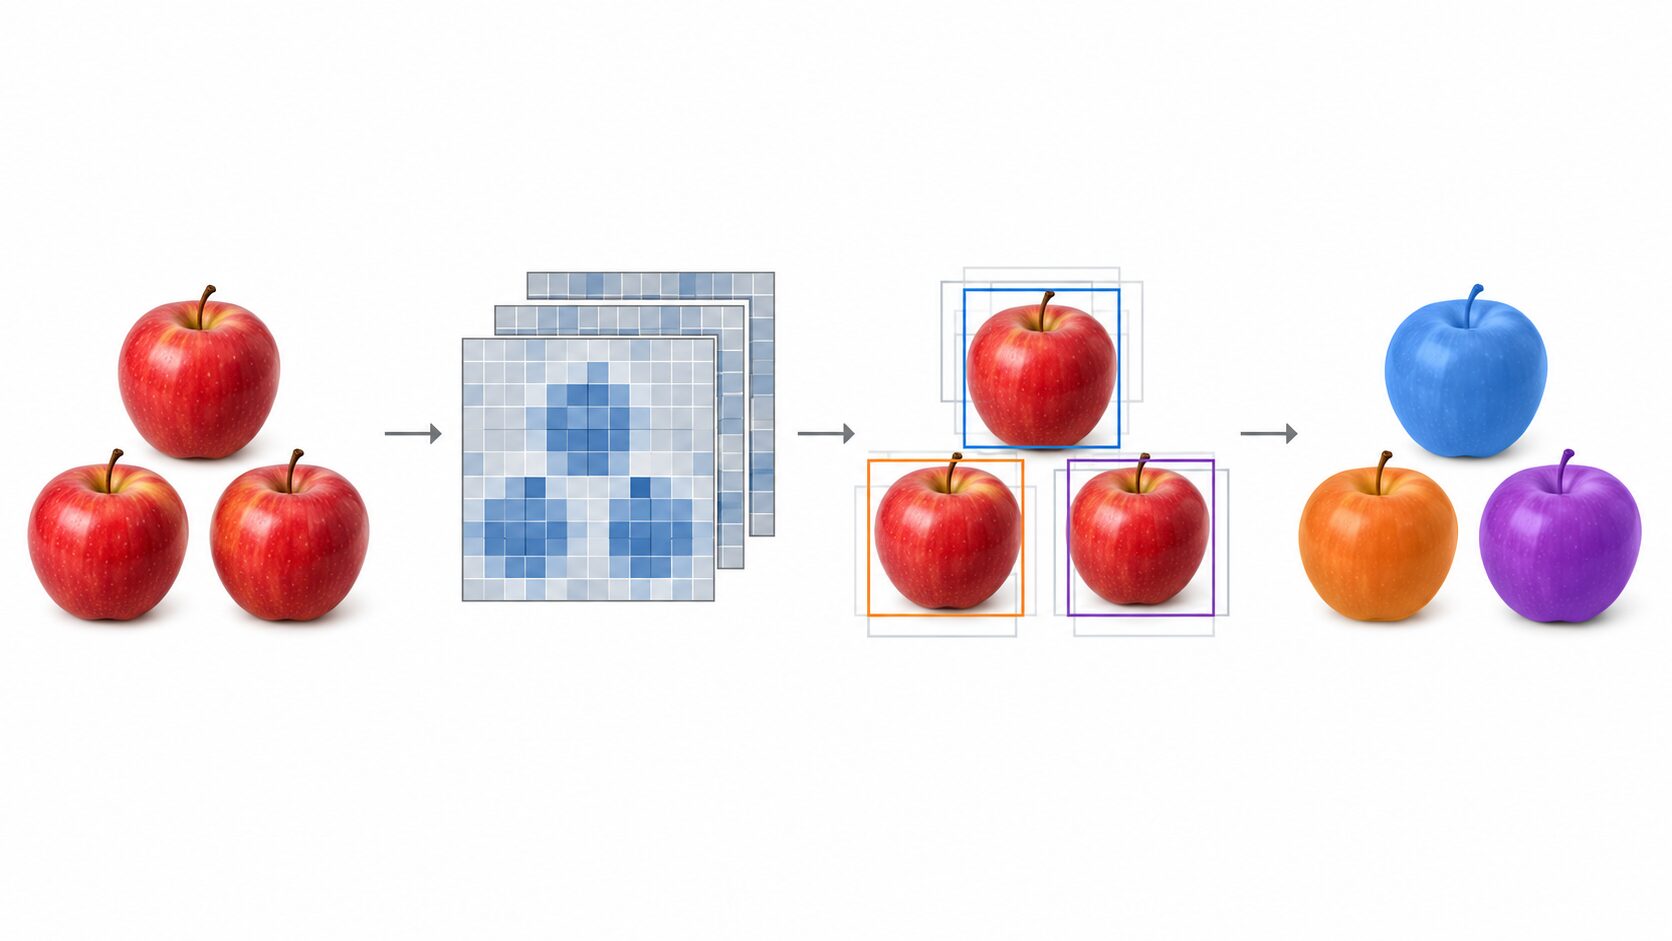
代表的なモデルであるMask R-CNNを例にすると、処理は「画像の特徴を取り出す」「物体がありそうな場所を探す」「種類・位置・マスクを予測する」という流れで理解できます。人が輪郭を一本ずつ描き込む代わりに、学習済みのモデルが画像の特徴を使って対象の範囲を推定します。
- 画像から特徴を抽出する。ニューラルネットワークが画像を処理し、輪郭や模様、形など、物体を見分ける手掛かりになる情報を取り出します。元の画像の色だけを単純に比較するわけではありません。
- 物体の候補領域を探す。取り出した特徴から、物体がありそうな場所を候補として挙げます。リンゴの写真なら、リンゴを含みそうな範囲を探す段階に当たります。
- クラス・位置・マスクを予測する。候補付近の特徴を使い、何の物体か、どこを囲む枠が適切か、どの画素がその個体に属するかを予測します。これらの結果を元画像に対応付けることで、個体別の領域を扱えるようになります。
これは一つの代表例です。マスクを直接予測する方式もあり、すべてのモデルが同じ候補抽出の手順を通るわけではありません。結果には、対象のクラス、マスク、信頼度などが含まれます。信頼度はモデルがその予測をどの程度支持しているかを示す値ですが、その値が高ければ必ず正解になるという保証ではありません。
一般的な教師あり学習では、画像とともに、個体ごとの正解マスクとクラスを用意します。リンゴが3個あるなら、一つの大きな「リンゴの領域」としてまとめず、3個それぞれの範囲を示します。モデルは予測と正解の違いをもとに調整され、未知の画像でも個体を分けられるよう学習します。この正解データを作る作業をアノテーションといいます。
学習用の写真には、実際に使う環境との近さが求められます。整列した明るいリンゴだけで学習したモデルは、葉に隠れたリンゴや暗い写真でも同じように働くとは限りません。密集の度合い、照明、撮影角度、対象の大きさなど、利用時に起こる条件を含めることが必要です。個体の境界をどう付けるかという基準がデータ内で一貫していることも、学習の土台になります。
マスクを青や赤で塗り分けるのは、結果を見やすくするための表示です。その色は実物の色でも、クラスそのものでもありません。色がきれいに分かれた表示であっても、輪郭がずれていないか、別の個体を一つにまとめていないかは、元画像と照らして確認します。
重なった物体を分けるときの限界
果物が山盛りになったかごでは、一つのリンゴの手前に別のリンゴがあり、輪郭の一部が隠れます。このような重なりは「遮蔽」と呼ばれます。インスタンスセグメンテーションは、見えている輪郭や表面の特徴、周囲との関係などを手掛かりに、同じ種類の物体を個体ごとに分けることを目指します。
ここで区別したいのは、見えている領域の分割と、隠れた形状の復元は別の課題だという点です。通常のインスタンス分割が扱うマスクは、画像上で見えている領域を表します。奥のリンゴの半分が隠れていれば、そのリンゴに対するマスクは、基本的には見えている部分の領域です。マスクが得られたからといって、隠れた半分の形まで分かったことにはなりません。
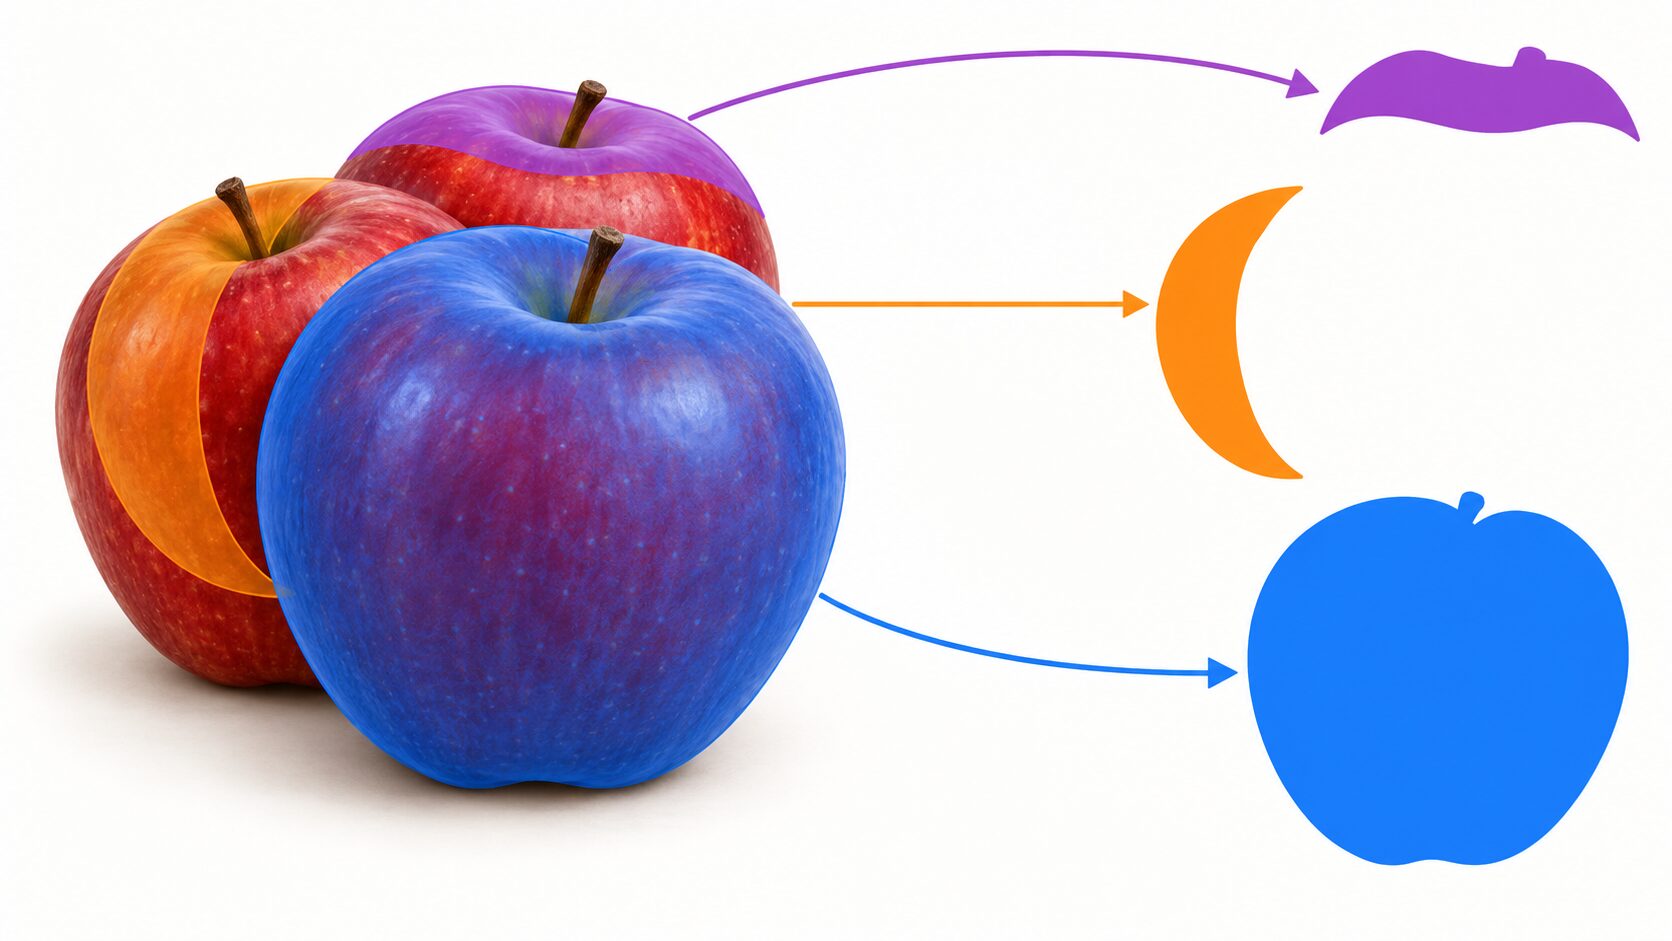
見えない部分も含めて物体全体の領域を推定する課題は、アモーダルセグメンテーションと呼ばれます。こちらも、観測できない部分は手掛かりから推定するため、不確かさが残ります。通常の分割と同様、完全に隠れて画像に手掛かりがない物体まで必ず見つけられるわけではありません。
認識が難しくなる条件と、確認したい誤りには、次のようなものがあります。
- 密集して境界が見えにくい場合は、隣り合う複数の個体を一つのマスクにまとめてしまうことがあります。
- 一つの個体の見えている部分が分断されている場合は、別々の物体として分けてしまうことがあります。
- 対象が小さい、強く隠れている、画像がぼけている場合は、物体を見逃したり、輪郭が大きくずれたりすることがあります。
- 背景と対象の色や模様が似ている場合は、背景をマスクに含めたり、対象の一部を取りこぼしたりすることがあります。
こうした誤りは、その後の数え上げや面積の計算にも影響します。3個を一つにまとめれば個数は少なくなり、一つを二つに分ければ多くなります。また、可視領域の面積が小さい理由が、物体そのものの小ささとは限らず、手前の物体に隠れたためという場合もあります。
利用時には、カメラの位置や照明、解像度を調整し、どのような画像で誤りが起きるかを確かめます。製造ラインで可能なら物体同士の間隔を空けるなど、撮影側で条件を整えることも有効です。モデルの変更だけでなく、入力画像の作り方も結果を左右します。
農業・製造・医療・自動運転での活用例
活用を考えるときは、「個体を分ける→測る・特徴を調べる→用途に応じて判断する」という流れで捉えると、技術の役割が明確になります。インスタンス分割が主に担うのは最初の段階であり、熟度、良否、病気の有無などの判断には、それぞれに適した処理や基準が必要です。
農業では、果実の数え上げや選別を支援できます。リンゴごとのマスクから、検出された数や画像上の面積を集計し、収量推定のための情報として利用できます。果実ごとに色や表面の特徴を調べれば、熟度や傷を評価する処理にもつなげられます。ただし、分割しただけで収穫時期が決まるわけではありません。色と熟度の関係、傷の特徴、葉による隠れなどを考慮した評価が必要です。
同じ果実を複数の写真で撮影する場合は、写真ごとの検出数を足すだけでは二重に数える可能性があります。収量を推定するには、撮影範囲や個体の対応付け、見えていない果実の扱いも含めた仕組みとして設計します。
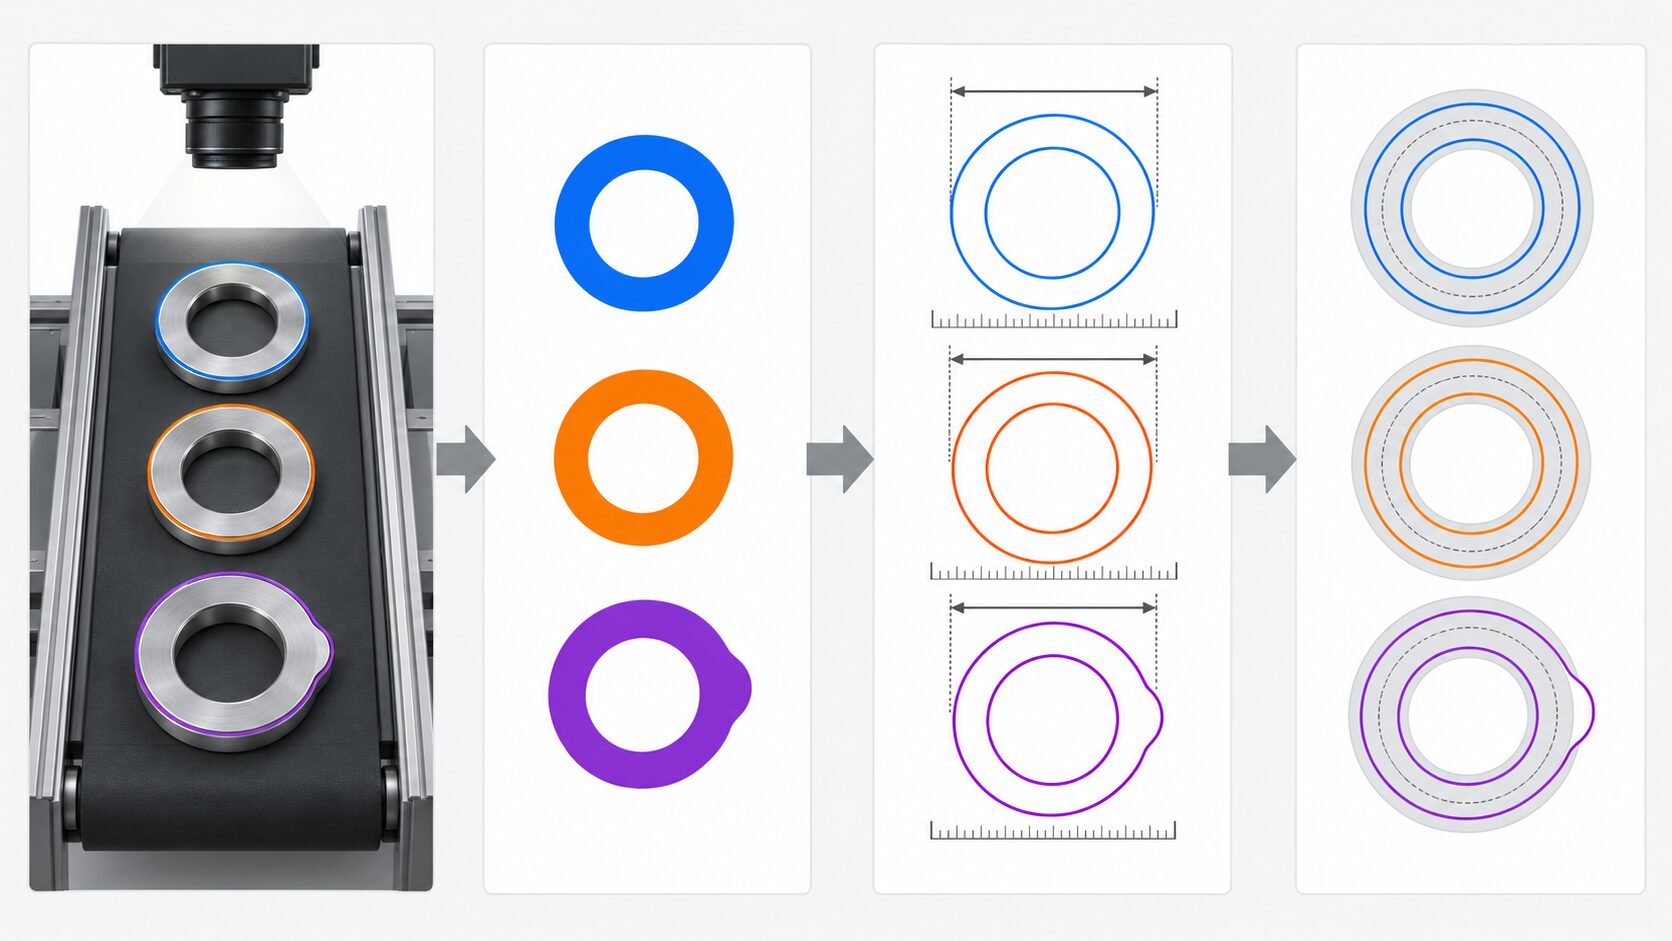
製造では、製品・部品ごとの形状検査やロボットの把持を支援できます。部品の輪郭を抽出して形の欠けや寸法の違いを調べたり、個々の部品の位置や向きを求めて、つかむ場所を検討したりできます。食品工場でも、製品を個別に分けたうえで外観を調べる、といった工程が考えられます。
ただし、異物や不良品の判定には、見つけたい異常に応じた学習や、許容する大きさ・形などの判定基準が必要です。良品の輪郭を取り出せるモデルが、そのままあらゆる異物を見つけられるわけではありません。工場の検査工程では、個体別のマスクから必要な値を計測し、その値を基準と照合するように役割を分けます。
医療では、細胞や複数の病変候補を個別に分け、計測や確認を支援する用途があります。たとえば、接している細胞を一つずつ分けられれば、細胞数や個体別の面積を集計できます。一方、CTやMRIなどで特定の臓器の領域を取り出す目的なら、セマンティックセグメンテーションで足りる場合もあります。必要なのが個体の区別なのか、領域全体の抽出なのかによって手法を選びます。分割された領域自体は診断を表すものではなく、検証された方法のもとで専門家が確認するための情報になります。
自動運転では、車や歩行者を個別に把握するための情報として利用できます。個体ごとの領域があれば、複数の車が並ぶ場面でも、それぞれの位置や画像上の広がりを扱えます。ただし、マスクだけから移動速度や正確な距離、進むべき経路が決まるわけではありません。時間をまたぐ追跡、距離推定、周囲の状況理解、経路判断などと組み合わせる必要があります。
どの分野でも、画像上の計測値と実物の値の違いに注意します。マスクの画素数を数えれば画像上の面積は求められますが、近くにある物体ほど大きく写ります。実寸を求めるには、基準となる尺度や距離、撮影条件の情報が必要です。隠れた部分がある場合も考慮し、見かけの大きさだけで実物の大小や品質を判断しない設計が求められます。
導入時の確認点と今後の進化
導入の出発点は、目的に必要な出力を決めることです。「リンゴの数と位置が知りたい」なら物体検出、「路面の範囲を取り出したい」ならセマンティックセグメンテーション、「リンゴ一つずつの輪郭を測りたい」ならインスタンスセグメンテーションが候補になります。個体と背景をまとめて扱いたい場合は、パノプティックセグメンテーションも検討します。
次に、実際の利用環境に近く、学習に使っていない画像で評価します。明るく撮れた簡単な写真だけでなく、暗さ、密集、重なり、対象の小ささなど、現場で起こる条件を含めることが大切です。確認する観点は、主に次の四つです。
- 見逃しと過検出:写っている物体を見落としていないか、背景を物体と誤認したり、同じ物体を重複して検出したりしていないか。
- 個体の分離:隣接する二つを一つにまとめていないか、一つを複数に分けていないか。
- 輪郭の一致:正解の領域と比べて、背景の混入や対象の取りこぼしがどの程度あるか。
- 用途への影響:認識の誤りによって、集計値、検査結果、ロボットの操作などにどのような違いが生じるか。
合計の個数が合っていても、見逃しと重複検出が相殺されている場合があります。また、検出自体は成功していても、輪郭のずれが大きければ精密な面積比較には使いにくくなります。単一の数値だけで判断せず、元画像とマスクを照らし、目的に必要な品質を満たしているかを確認します。
運用のしやすさも比較対象です。製造ラインや動画処理では、必要な時間内に結果を返せるか、使う機器の計算能力やメモリで処理できるかを確かめます。個体ごとの正解マスクは、四角い枠だけを付ける場合よりも作成や確認に手間がかかりやすいため、データを用意する負担と維持管理まで含めて判断します。
今後の改善の軸になるのは、処理速度と精度の両立、複雑な場面への対応、学習データの整備です。小さな対象や強い遮蔽に対応する工夫、限られた計算資源で動かす工夫、正解マスクを効率よく作る仕組みなどが、活用の幅に関わります。ただし、学習データを増やせば必ず良くなるわけではありません。現場の条件を含むか、ラベルに誤りがないか、苦手な場面を補えているかが重要です。
インスタンスセグメンテーションは、画像に何が写っているかを知るだけでなく、一つひとつの領域を使って計測や分析を進めたいときに役立ちます。必要な情報を先に決め、見えている範囲と推定の限界を理解して使うことで、数え上げや検査などの工程に組み込みやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月3日 | 手法ごとの出力と遮蔽の限界を改め、検査・計測での使い方を追記 |