
SPLADEとは?学習型の疎ベクトルで語句のずれを補う検索手法

AIの初心者
「車の保険」と検索して、「自動車保険の補償内容」という資料も見つけたいです。書かれた言葉が違っても探せますか?

AI専門家
そのための手法の一つがSPLADEです。文章から検索に役立つ語彙とその重みをモデルが求め、元の文章にない関連語も検索の手掛かりにできます。
AIの初心者
意味が近い文章を探す、密ベクトル検索と同じ仕組みでしょうか?
AI専門家
表現の作り方が違います。SPLADEは語彙に対応する数値を使い、重みが付いた語彙の重なりから順位を計算します。語句一致の検索との違いも順に見ていきましょう。
SPLADEとは。
SPLADEは、ニューラルモデルで語彙の重み付けと拡張を学び、質問や文書を疎ベクトルで表して検索する手法です。疎ベクトルとは、多くの成分がゼロになる数値の並びです。語彙に対応する少数の成分を手掛かりに、検索語と文書の言い回しのずれを補います。
「利用者が入力する言葉」と「資料に書かれた言葉」が違うと、必要な文書が見つからないことがあります。まず、そのずれを学習した語彙表現でどう扱うかを押さえます。
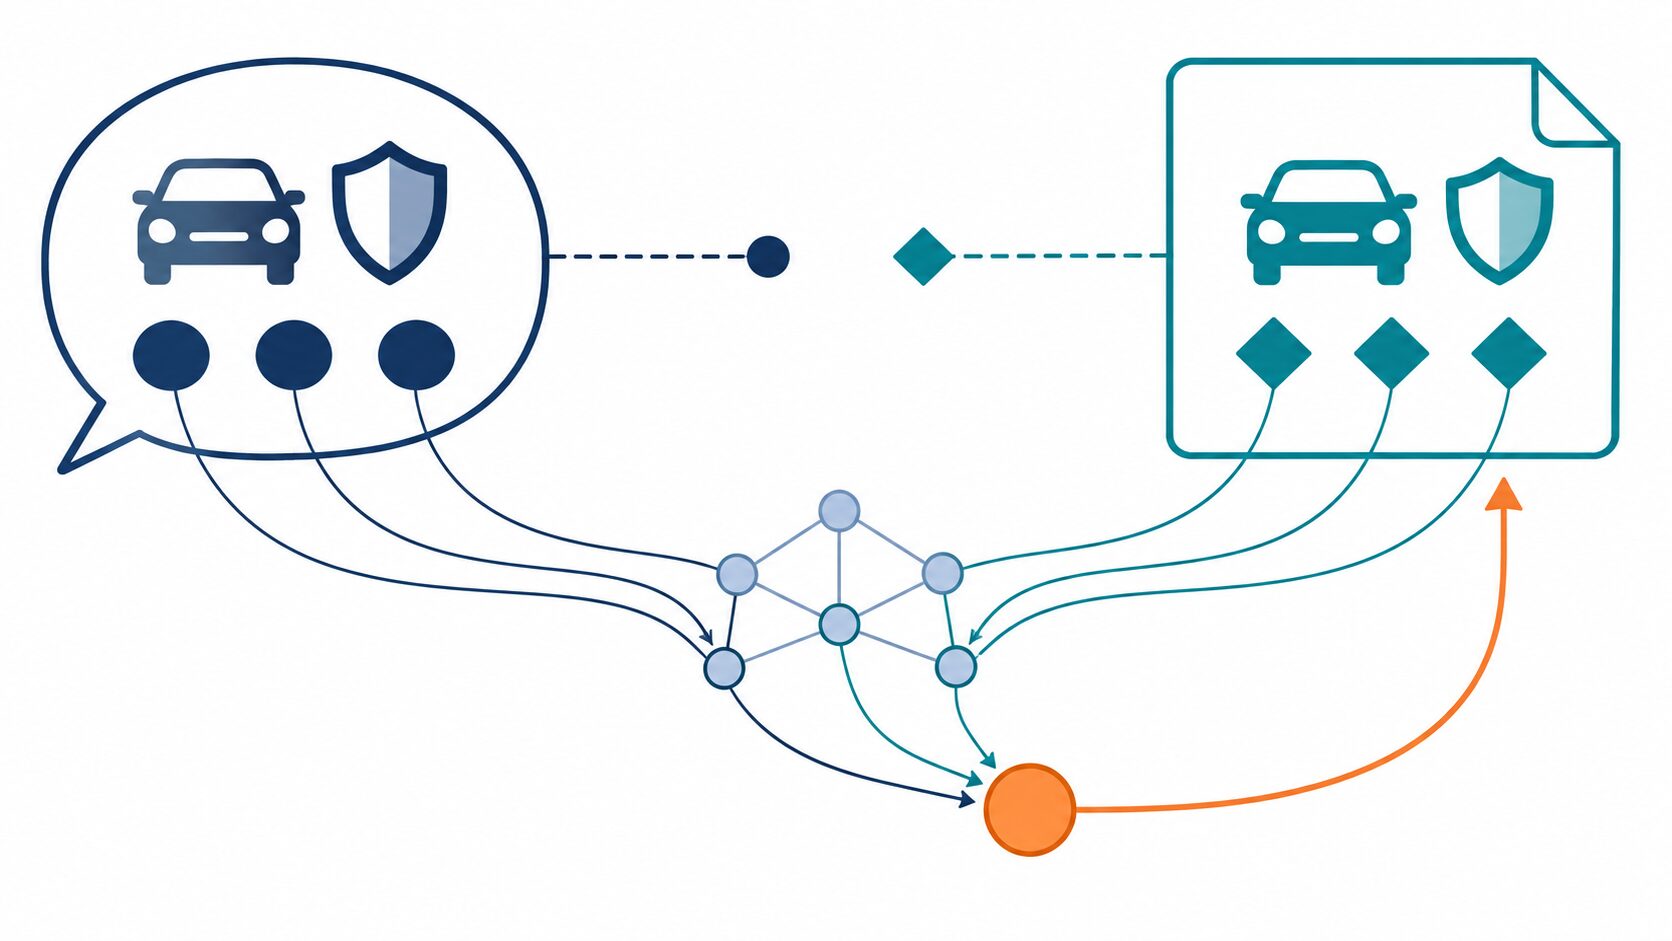
SPLADEが補う検索語と文書のずれ
SPLADEの特徴は、検索に使う語彙と重みを学習し、元の語句だけでは得られない一致を作ることです。2021年に発表された情報検索の手法で、生成AIの回答を作るモデルそのものではありません。大量の文書から、質問に関連する候補を選ぶ役割を担います。
たとえば、質問が「車の保険」、資料の題名が「自動車保険の補償内容」だったとします。人には近い話題だと分かりますが、語句一致を中心とした検索では、検索語と文書がどの単位に分割されるかによって一致の強さが変わります。「保険」が一致しても、利用者の意図に合う資料が十分上位に出るとは限りません。
語句を分割する処理や同義語辞書でも、この問題には対処できます。SPLADEは別の方法として、文脈を読むモデルから関連する語彙の重みを求めます。「車」に関係する表現と「自動車」に関係する表現が共通の語彙成分を持てば、元の文字列が異なっても照合に使えます。
ここで使う疎ベクトルは、モデルが持つ語彙をずらりと並べ、各項目に数値を付けた一覧に近いものです。多くはゼロで、一部だけが重みを持ちます。単にゼロの多いデータを作るのではなく、検索に有効な語彙表現を学ぶ点が重要です。ただし、どの言い換えも必ず拾えるわけではなく、モデルの学習内容や言語への対応に左右されます。
語彙の重みと拡張を学ぶ仕組み
ベクトルの各次元は、モデルの語彙に含まれるトークンに対応します。トークンは文章を処理する単位で、必ずしも辞書に載る一語とは一致しません。単語の一部分や文字に近い単位になる場合もあります。その値は検索の照合に使う重みであり、出現回数そのものや「正解である確率」ではありません。
SPLADEでは、BERT系モデルと、語彙に対する予測スコアを出すMLM headという出力層を利用します。MLMは、文中で隠された部分を予測する学習に由来する仕組みです。文章を入力すると各位置について語彙のスコアが得られ、それを非負の重みへ変換し、入力位置にわたって集約して文章全体の表現を作ります。集約の方法には手法の版による違いがあります。
出力の対象がモデルの語彙全体に及ぶため、入力に現れた語だけでなく、現れなかった関連語にも重みを与えられます。「重み付け」はどの語彙をどれだけ重視するかを決める処理で、「語彙拡張」は入力にない語彙も手掛かりへ加える処理です。この二つを区別すると、単なる単語の数え上げとの違いが分かります。
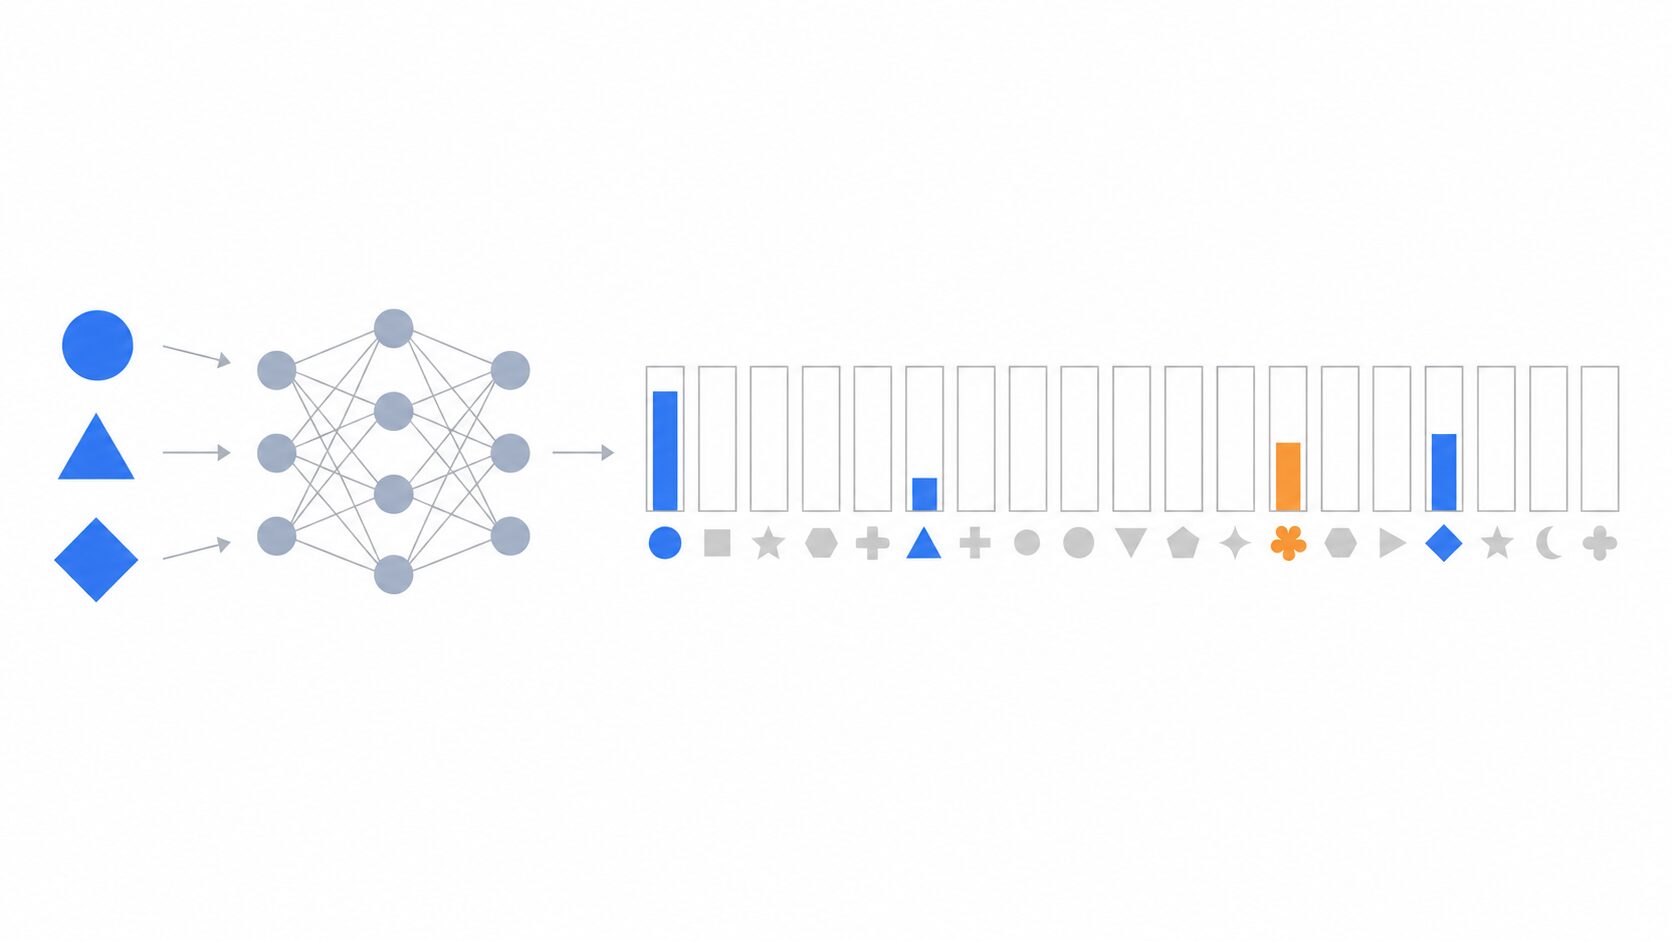
たとえば「車の保険」から「車」「保険」に重みを付け、さらに「自動車」にも重みを持たせる、と考えると分かりやすいでしょう。これは仕組みを説明するための例で、特定モデルの出力を実測した結果ではありません。実際にはトークンの分割も重みもモデルによって変わります。
学習では、関連文書を無関係な文書より高く評価する目的と、不要な成分を抑えて疎性を促す正則化を併用します。正則化とは、学習の際に望ましい性質へ誘導する制約や罰則を加えることです。検索品質だけを追って多数の語彙が有効になるのを抑え、扱いやすい表現を目指します。
同義語辞書のように、決められた語の組を一律に追加する処理ではありません。また、元の文書を書き換えたり、説明文を生成して付け足したりするものでもありません。文脈に応じた数値表現を作りますが、関連の薄い語にも重みが付く可能性があり、拡張が検索の誤りにつながる場合もあります。
文書の索引作成から検索順位までの流れ
検索システムでは、文書を登録する段階と、利用者が質問する段階を分けて考えます。大量の文書を毎回モデルで読み直すのではなく、文書の表現を事前に作り、索引へ保存しておくのが基本です。
- 検索対象の文書を、学習済みモデルで疎ベクトルへ変換します。長い資料を区切って検索する場合は、区切った単位ごとに表現を作ります。
- 重みがゼロではない語彙について、文書の識別子と重みを索引へ登録します。「この語彙を持つ文書はどれか」を引ける転置インデックスを利用できます。
- 検索時には、質問も対応するモデルで同じ語彙空間の疎ベクトルへ変換します。質問で重みを持つ語彙から、関連しそうな候補を探します。
- 質問と各文書で共通する次元の重みを掛け合わせ、その合計である内積をスコアとして、候補を順位付けします。
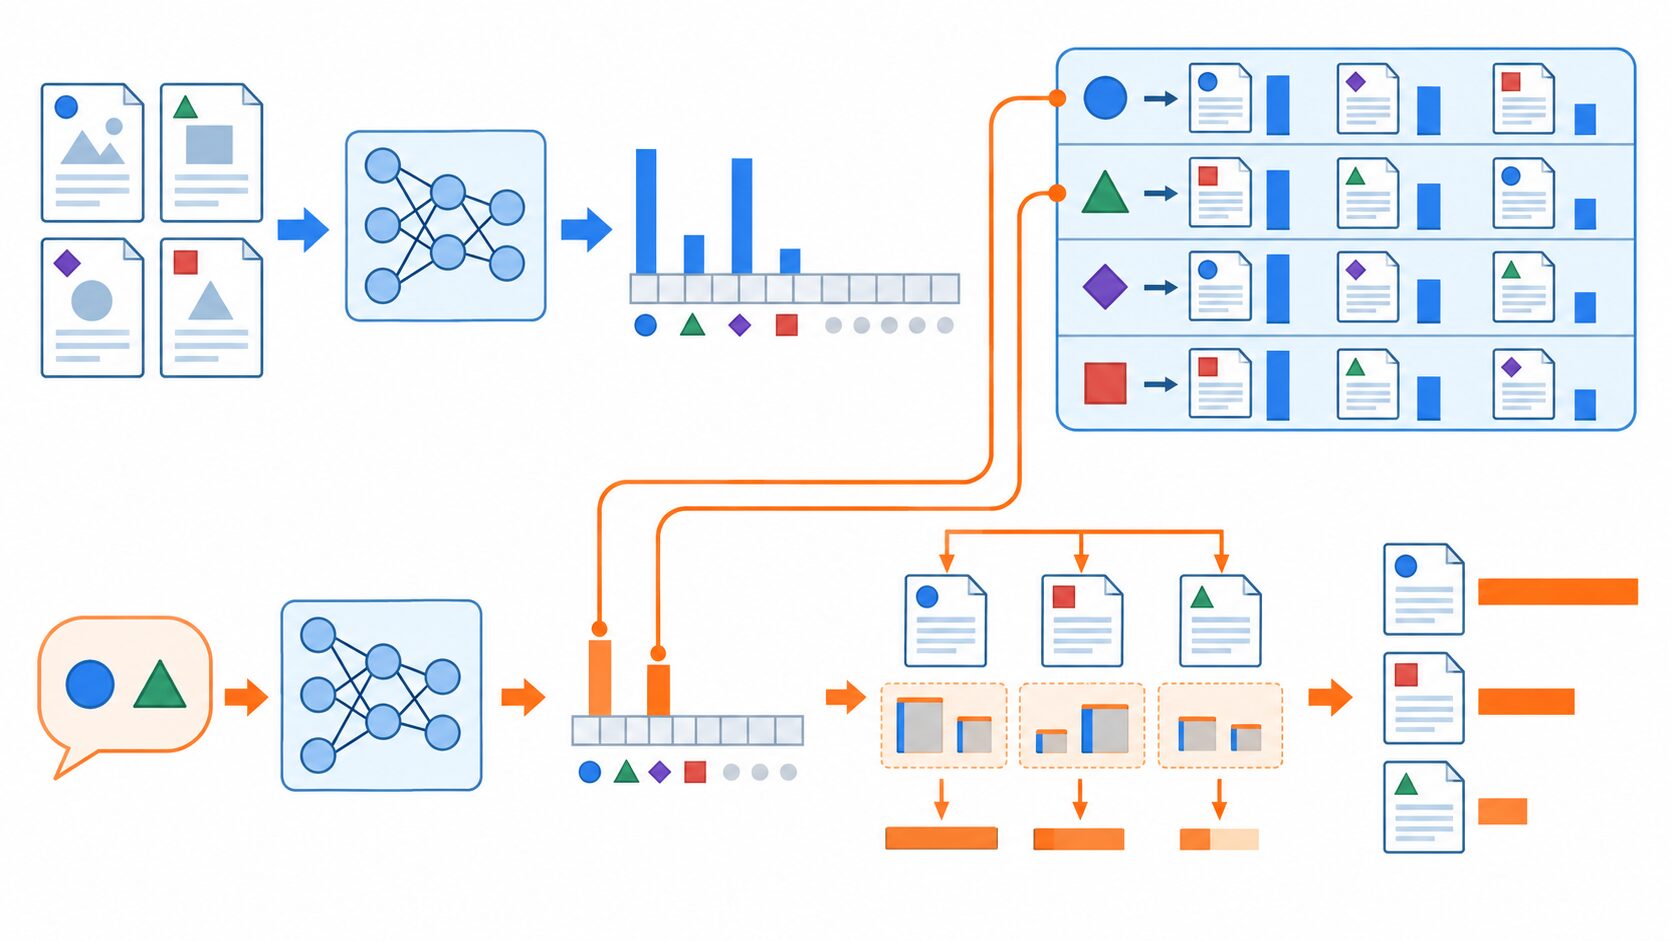
説明用に、質問側の「自動車」の重みを0.6、文書側を0.8とすると、この次元はスコアに0.48を加えます。「保険」などほかの共通次元の積も足して、全体のスコアを求めます。この数値は仮定です。一方がゼロの次元は寄与しないため、語彙拡張によって共通の次元が生まれることが、語句のずれを補う理由になります。
モデルの学習と、文書の索引作成は別の作業です。学習は重みの出し方を決めるモデルのパラメータを調整すること、索引作成はそのモデルを使って自分の文書を登録することです。学習済みモデルを利用するなら、必ずしも最初から学習する必要はありません。
転置インデックスは語彙から文書を探すためのデータ構造で、SPLADEは登録する表現を作る検索手法です。両者を同じものと捉えず、表現、索引、スコア計算を分けると構成を理解しやすくなります。
BM25・密ベクトル検索・ColBERTとの違い
検索手法を比べるときは、文章を何で表し、どの単位を照合するかに注目します。以下は各手法の基本的な構成の比較です。密ベクトル検索は、検索対象の文章を一つの密ベクトルにまとめる代表的な方式を指します。
| 手法 | 文章の表現 | 学習による語彙拡張 | 主な照合方法 | 計算・索引の特徴 |
|---|---|---|---|---|
| BM25 | 文書に現れる語句と出現統計 | 基本構成にはない | 一致語について、出現頻度や文書長などから得点を計算 | 転置インデックスを利用し、基本構成ではニューラルモデルの推論が不要 |
| SPLADE | モデルの語彙に対応する疎ベクトル | 入力にない関連語にも重みを付ける | 共通する語彙次元の重みの内積 | 重み付きの転置インデックスを利用でき、モデル推論と疎性の調整が必要 |
| 密ベクトル検索 | 意味的な特徴を数値化した密ベクトル | 語彙を明示的に追加する形では行わない | ベクトル間の内積やコサイン類似度など | 大規模な検索では近似近傍探索などの索引を使うことが多い |
| ColBERT | 各トークンに対応する複数の密ベクトル | 語彙を明示的に追加する形では行わない | 質問の各トークンと文書トークンの類似度を集約 | 複数ベクトルの保存・照合が必要で、圧縮や探索の工夫が重要 |
BM25は語句一致を重視し、珍しい語の一致などを出現統計に基づいて評価します。SPLADEは同じく語彙を照合の軸にしながら、どの語彙を有効にするかを学習します。一方、密ベクトルの各次元は通常、特定の語に直接対応しない潜在的な特徴です。意味の近さを扱う方法が異なります。
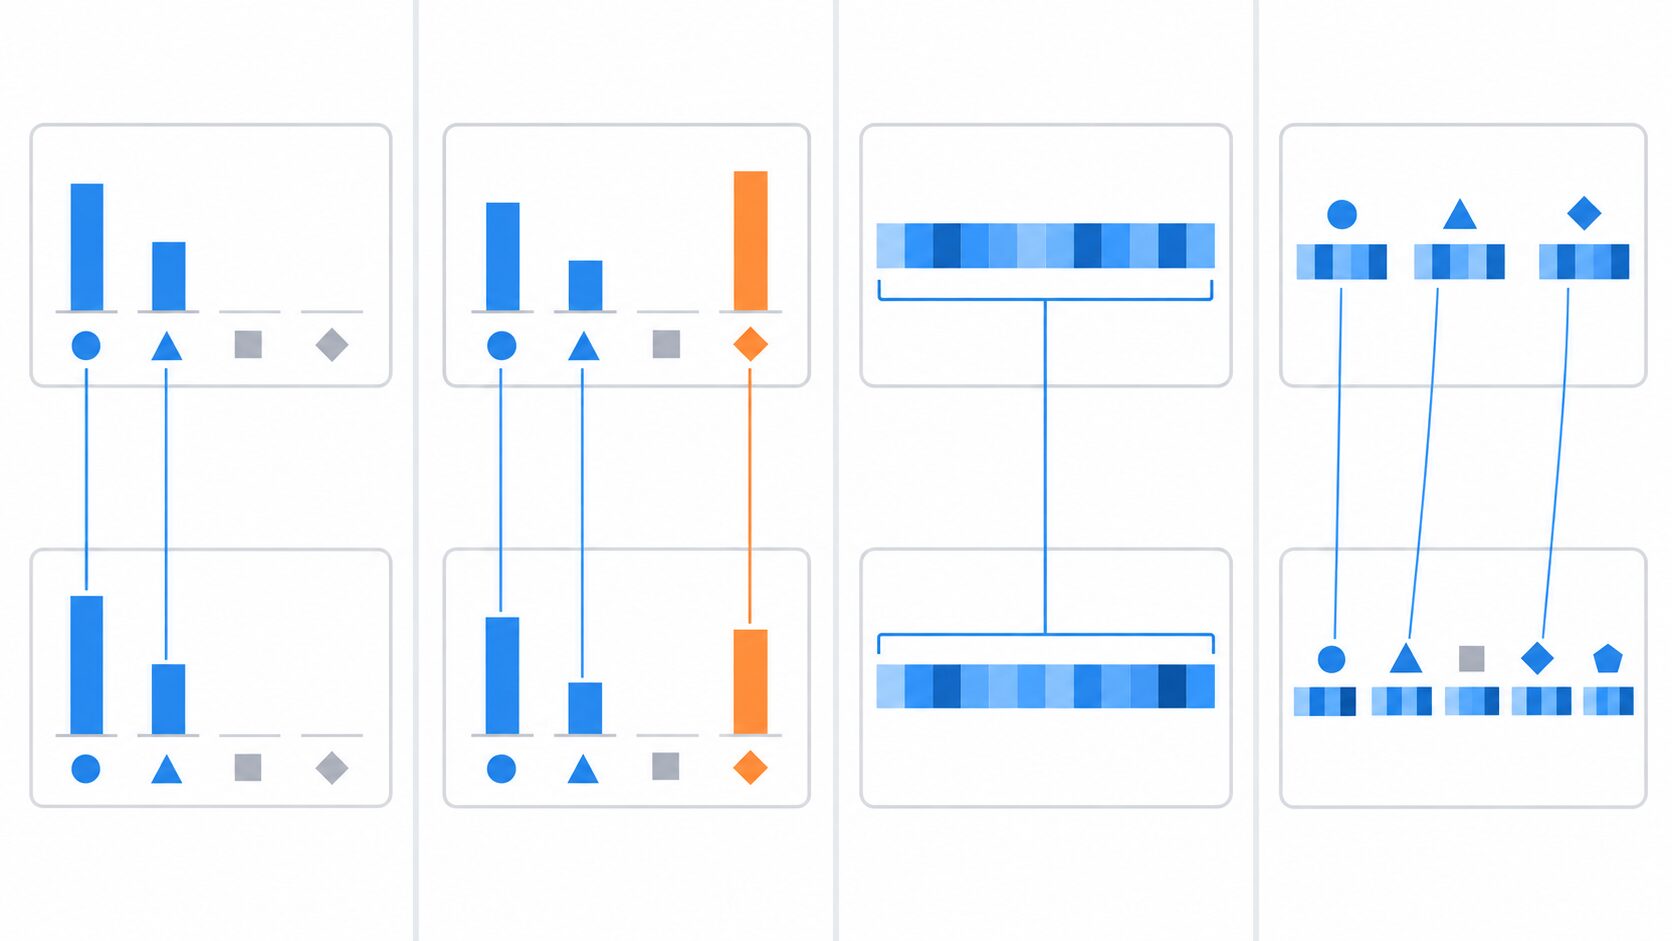
ColBERTは、質問と文書を別々にベクトル化した後、トークン同士を照合するLate Interactionを用います。基本的には、質問の各トークンに対して最も似た文書トークンのスコアを求め、それらを集約します。語彙ごとの重みにまとめて内積を取るSPLADEとは、表現も照合単位も違います。
SPLADEは重みの付いた語彙を確認できるため、検索結果を調べる手掛かりがあります。ただし、モデルがなぜその重みを出したかまで完全に説明できるとは限りません。また、ハイブリッド検索は複数方式の結果を組み合わせる設計であり、SPLADEの別名ではありません。SPLADEをBM25と密検索の単純な中間や、あらゆる検索で優れる方式と考えないことが大切です。
社内検索やRAGでの使いどころ
SPLADEが候補になるのは、問い合わせと文書の言い回しがずれやすい検索です。FAQなら「ログインできない」と「認証に失敗する」、社内規程なら「交通費を返してもらう」と「旅費の精算」のように、利用者の言葉と資料の用語が異なります。こうした表現の関係をモデルが扱えるかを、実際の質問で確かめます。
商品検索でも、「雨の日に履く靴」という質問と、防水性能を説明した商品情報を結び付ける用途が考えられます。ただし、関連語を拾うことと、価格やサイズなどの条件を満たすことは別です。明確な条件は検索フィルターなどで扱い、関連度のスコアだけに任せない設計が必要です。
RAGは、検索した情報を根拠として生成モデルが回答する構成です。SPLADEはこのうち質問に対応する根拠文書を取得する部分を担います。たとえば文書を適切な長さに区切って索引に登録し、質問に近い候補を取得した後、別のモデルで再ランキングし、選んだ本文を回答生成へ渡します。
再ランキングは、絞り込んだ候補を詳しく評価して順番を見直す処理です。最初の検索で正解文書が候補から漏れると、再ランキングでも取り戻せません。RAGでは最終回答だけでなく、必要な根拠が候補に入っているかを確認することが重要です。
型番、製品コード、人名などは、似た話題より正確な文字列が重要な場合があります。SPLADEでも元の語彙を利用できますが、正確な一致を必ず優先する保証はありません。BM25との併用、識別子の完全一致、密検索との結果の統合などを、検索対象に応じて検討します。方式を増やすと運用も複雑になるため、実データで得られる改善を見て判断します。
疎性・速度・日本語対応をどう評価するか
導入では、検索品質と処理コストを一緒に評価します。非ゼロの成分が多いほど照合の手掛かりは増えますが、索引に保存する項目や検索時の処理も増えやすくなります。逆に疎性を強めすぎると、言い換えを拾うために必要な成分まで失う可能性があります。成分数が多いことも、少ないことも、それだけでは良さを示しません。
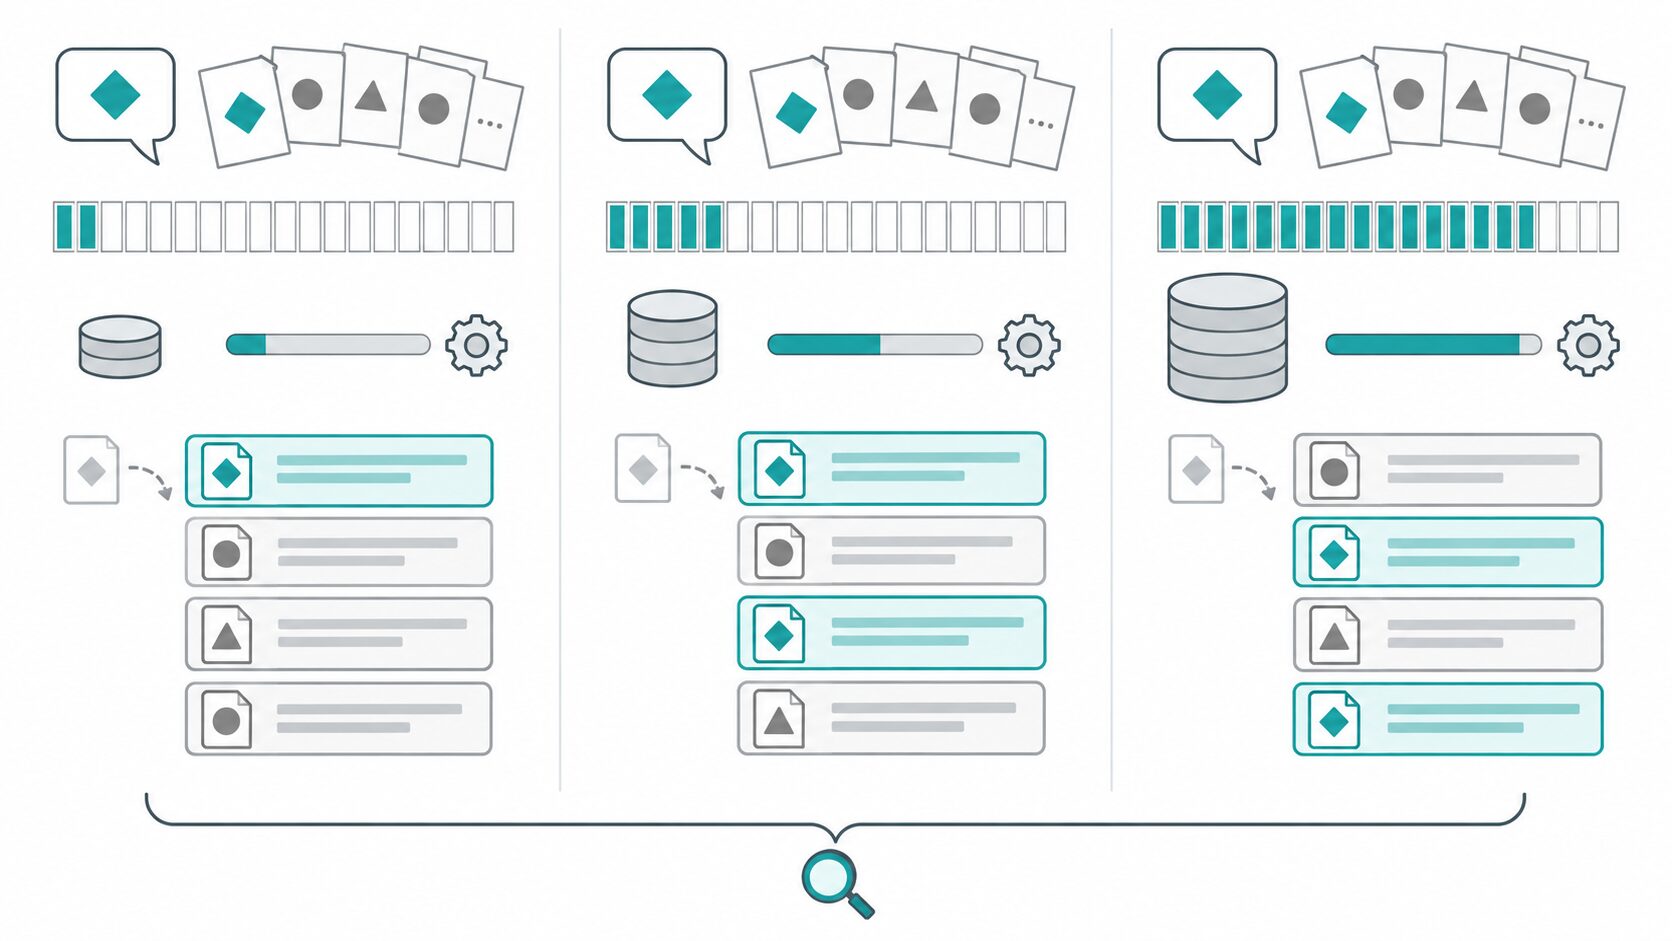
非ゼロ成分数が同じでも、多数の文書に現れる語彙へ重みが付くと、照合する候補が増える場合があります。正則化や重みを残す基準の調整では、成分数だけで速度を推定せず、実際の索引と検索処理を測ります。
時間の測定は、文書の事前処理と質問時の処理を分けます。初回の索引作成にかかる時間、文書の追加・更新にかかる時間、質問のモデル推論と候補取得にかかる時間を確認します。モデルを変更して文書表現も変わるなら、索引の再作成が必要になることもあります。文書側を事前計算しても、質問側の推論コストは残ります。
転置インデックスを使えるからといって、既存のBM25環境へそのまま置き換えられるわけではありません。学習した語彙の識別子と重みを保存し、対応するスコアを計算できる実装が必要です。実装や学習済みモデルを選ぶ段階で、一次資料から対応するモデル形式、必要な処理、利用条件を確認します。
日本語では、まずモデルの対応言語、語彙、検索向けの学習領域を確認します。日本語を入力できることと、日本語検索で十分な品質が出ることは同じではありません。英語の評価結果だけで判断せず、「自動車/クルマ」の表記揺れ、会社独自の略語、固有名詞、専門用語を含む質問を用意します。
長文資料は、分割の大きさや重なり方によって検索結果が変わります。細かく切りすぎると前後関係を失い、長すぎると入力長の制限や話題の混在が問題になります。失敗例では、必要な語彙が残っているか、無関係な語へ拡張されていないか、否定や条件の違いを取り違えていないかを調べます。
比較には、同じ質問と正解文書の組を使います。文書の分割方法や検索対象もそろえ、BM25などを基準にして、どの種類の質問で改善し、どこで悪化するかを確認します。平均値だけでなく、型番検索や言い換えを含む質問などに分けて見ると、導入の判断につながります。
- Recall@k:関連する正解文書のうち、上位k件に入った割合です。正解が一件の質問なら、それを候補に含められたかを見ることになります。
- nDCG@k:上位k件について、文書の関連度と順位を評価する指標です。より関連の強い文書が上位に並ぶほど高くなります。
- 検索遅延と索引容量:回答までの待ち時間と、保存・運用に必要な資源を確認します。比較する機器や同時リクエスト数などの条件もそろえます。
SPLADEを選ぶ基準は、語句のずれによる取りこぼしがどれだけ減り、その改善を許容できる速度と容量で実現できるかです。自分たちの文書と言語で、用途、検索品質、運用コストを照らし合わせれば、単独で使うか、他方式と組み合わせるかを判断しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月8日 | 初回公開 |