
投機的デコーディングとは?LLMの回答を高速化する仕組み

AIの初心者
AIの回答が少しずつ表示されます。まとめて文章を作れば、もっと速くなるのでしょうか?

AI専門家
通常は直前までの文章を見て、次の要素を一つずつ決めます。そこで、軽いモデルに先の候補を作らせ、本来のモデルでまとめて確かめる方法があります。
AIの初心者
候補が間違っていたら、そのまま回答に使われてしまいませんか?
AI専門家
決められた判定に通った部分だけを採用し、通らない位置から直します。速くなる理由と、効果が出にくい条件を順番に見ていきましょう。
投機的デコーディングとは。
投機的デコーディング(Speculative Decoding)は、軽い処理で複数の出力候補を先に用意し、本来使いたい大規模言語モデル(LLM)でまとめて検証する推論の高速化手法です。採用できる候補が続けば、大きなモデルを繰り返し動かす回数を減らし、回答生成の待ち時間を短縮できます。
「投機的」とは、採用されるか未確定の処理を先回りして行うという意味です。着眼点は、一つずつ生成する処理の一部を、候補の準備と一括検証に置き換えることにあります。
LLMの生成に待ち時間が生まれる理由
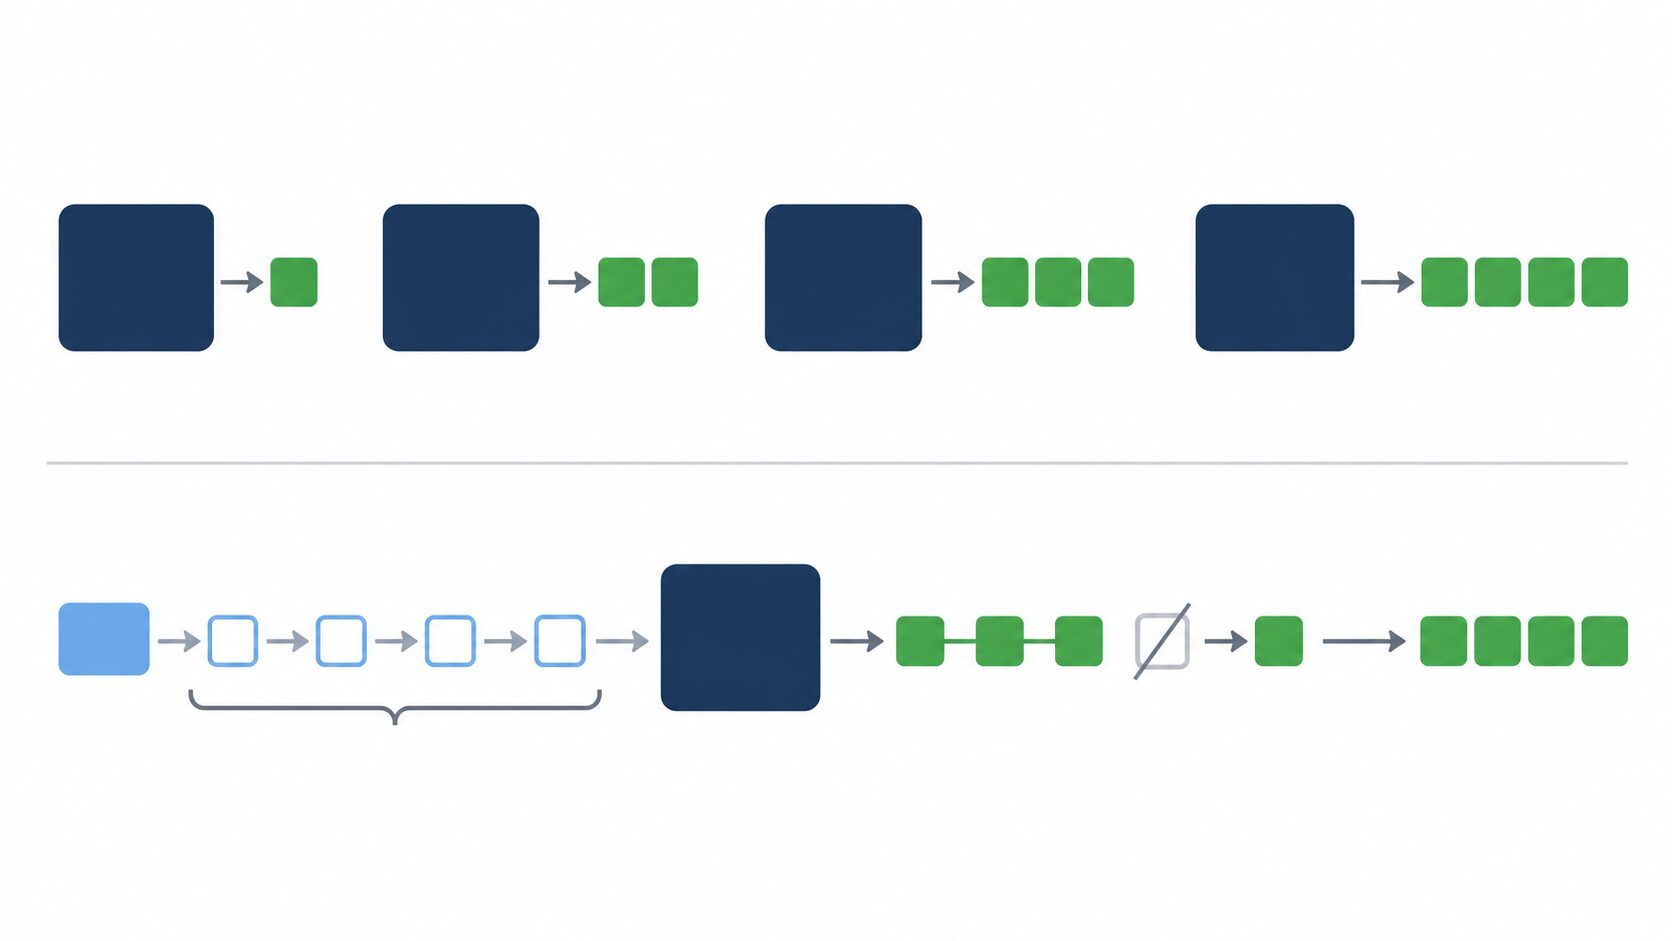
LLMは通常、文章をトークンという単位で順番に生成します。トークンはモデルが扱う文字列の区切りで、単語と必ず一致するわけではありません。一つの単語が複数に分かれる場合もあれば、記号が一つの単位になる場合もあります。
この生成方法を「自己回帰生成」と呼びます。たとえば「明日の天気は」に続く要素を決めたら、その結果も含めて次を予測します。各段階で直前までの出力が必要になるため、まだ決まっていない文章の先頭から末尾までを、独立に一斉生成することはできません。
待ち時間は、大きく入力を読み込む処理と、回答を出力する処理に分けられます。前者は「プリフィル」、後者は「デコード」と呼ばれます。長い資料を読み込ませた場合は入力処理に時間がかかり、長い回答を求めた場合は出力生成の反復回数が増えます。
デコードでは、大きなモデルを何度も実行します。特に同時に処理するリクエストが少ない条件では、計算そのものより、モデルの重みをメモリから読み出すなどのデータ転送が速度を制限することがあります。計算装置に余力があっても、必要なデータを待ってしまう状態です。
投機的デコーディングの主な対象は、この出力生成の反復です。一度の大きなモデルの実行で複数の出力を確定できれば、処理を効率化できます。ただし、入力の読み込みまで同じように短縮されるわけではありません。
ドラフト生成と並列検証の仕組み
代表的な構成では、候補を作る小さな「ドラフトモデル」と、本来の回答を決める「ターゲットモデル」を組み合わせます。ドラフトとは下書きのことで、小型モデルは最終回答を任されるのではなく、採用されそうな続きを安く準備する役割を担います。
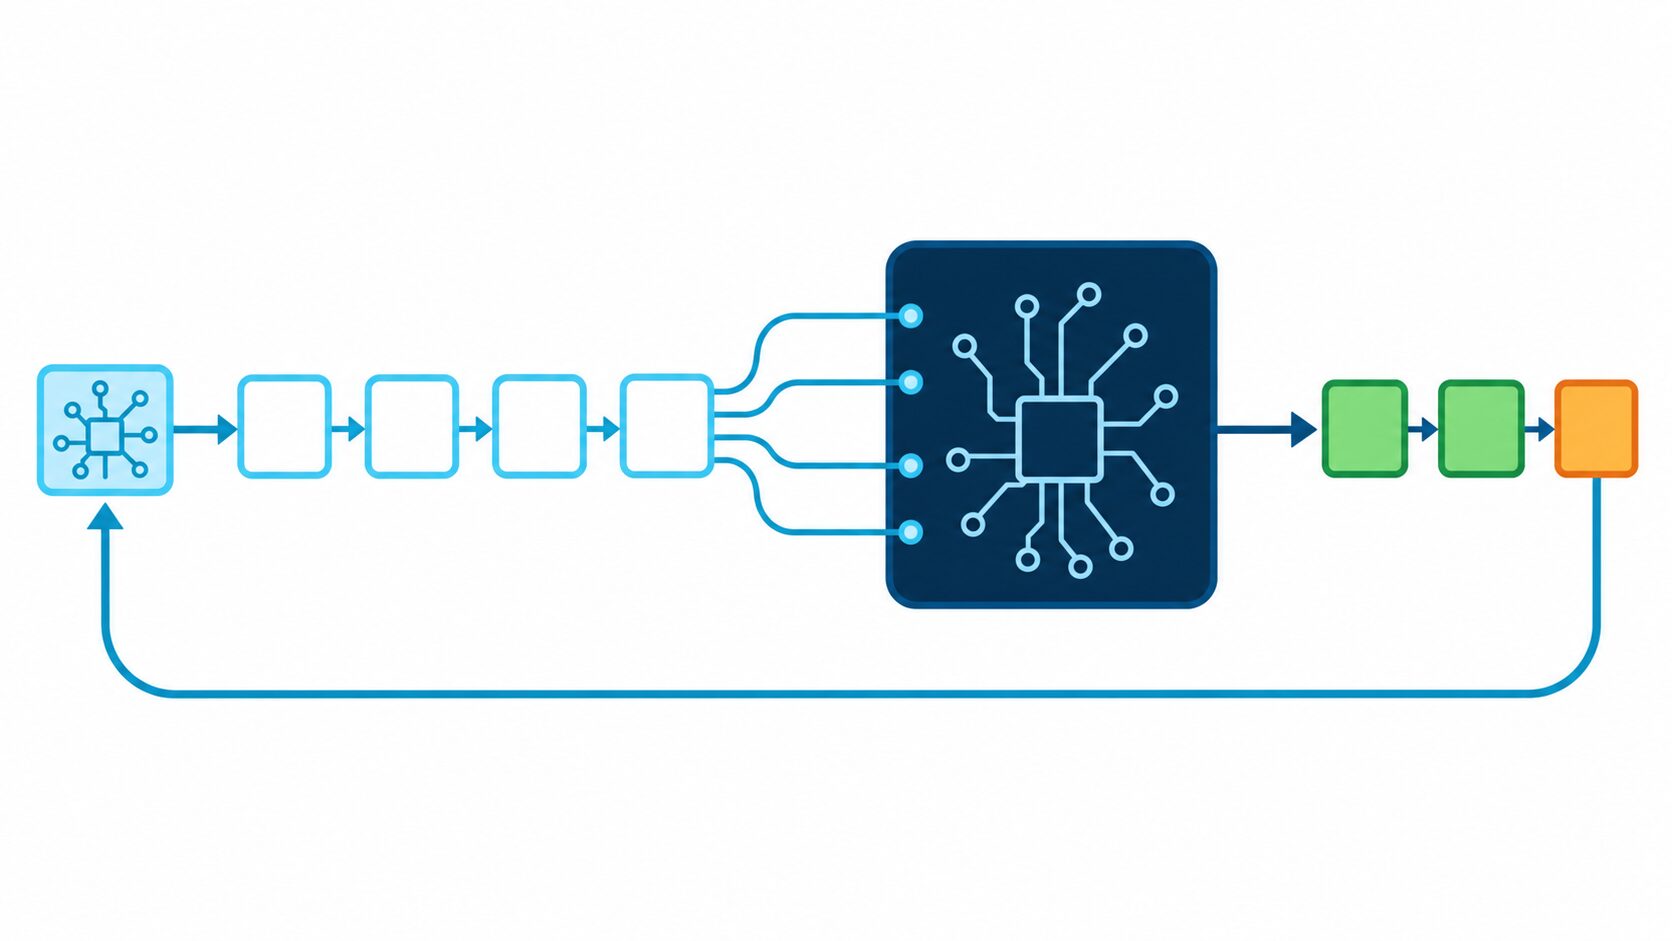
基本の流れは、次の三段階です。
- ドラフトモデルが、確定済みの文章に続く複数のトークンを先行して生成します。
- ターゲットモデルが候補列を受け取り、一度の順伝播、つまりモデルの計算で、各候補位置の予測をまとめて評価します。
- 先頭から採否を判定し、採用できた部分を確定します。棄却が起きた位置を補正し、更新した文章から候補作りを再開します。
並列に評価できるのは、検証時には候補列がすでに用意されているためです。各位置は、それより前の候補を条件として評価されます。前後関係を無視して文章全体を作るのではなく、仮の続きを入力にして、複数位置の予測を一度に計算する点が特徴です。
途中の候補を棄却したら、それより後の候補も破棄します。後続の候補は、棄却された要素が文章に入る前提で作られているからです。一方、それ以前に採用した部分は残せます。先頭から複数個を採用できるほど、ターゲットを一つずつ動かして確定する回数を減らせます。
判定方法は、出力の選び方によって異なります。最も確率の高いトークンを選ぶ「貪欲法」では、ドラフトの候補がターゲットの選択と一致するかを調べます。確率に応じて出力を選ぶ「サンプリング」では、両モデルが候補に与えた確率に基づいて採否を決め、棄却時には偏りを補正した確率分布から選び直します。
こうした採否と補正を正しく行う厳密な方式では、理論上、ターゲット単独と同じ出力の確率分布を保てます。「同じ分布」とは各出力の現れやすさが同じという意味で、ランダムに生成する文章が毎回同じになる保証ではありません。また、ここでの検証はモデルの予測との整合を確かめる処理であり、事実確認ではありません。ターゲットが持つ事実誤認まで解消するものではない点に注意が必要です。
別の小型モデルを使わず、一つのモデルに追加した予測機構などで候補を作る派生方式もあります。候補の作り方や採用方法が異なるため、すべての方式に同じ速度や分布維持の保証があるとは限りません。
候補の採用と棄却を具体例で見る
貪欲法の模式例で考えます。入力が「日本の首都は」のとき、ドラフトが「東京/です/!/次に」という四つの候補を提示したとします。ここでの区切りは説明用であり、実際のトークン分割を表していません。
ターゲットの選択が順に「東京/です/。」となる場合、処理は次のようになります。
| 位置 | ドラフトの候補 | 判定・処理 | 確定する出力 |
|---|---|---|---|
| 1 | 東京 | ターゲットの選択と一致して採用 | 東京 |
| 2 | です | ターゲットの選択と一致して採用 | です |
| 3 | ! | 不一致のため棄却し、「。」に補正 | 。 |
| 4 | 次に | 棄却位置より後なので破棄 | 未確定 |
この段階で「日本の首都は東京です。」まで確定します。「次に」は、「!」の後に続く前提の候補だったため、そのまま使えません。生成を続ける場合は、補正後の文章をもとに改めて候補を作ります。回答の終了条件を満たしていれば、そこで終了します。
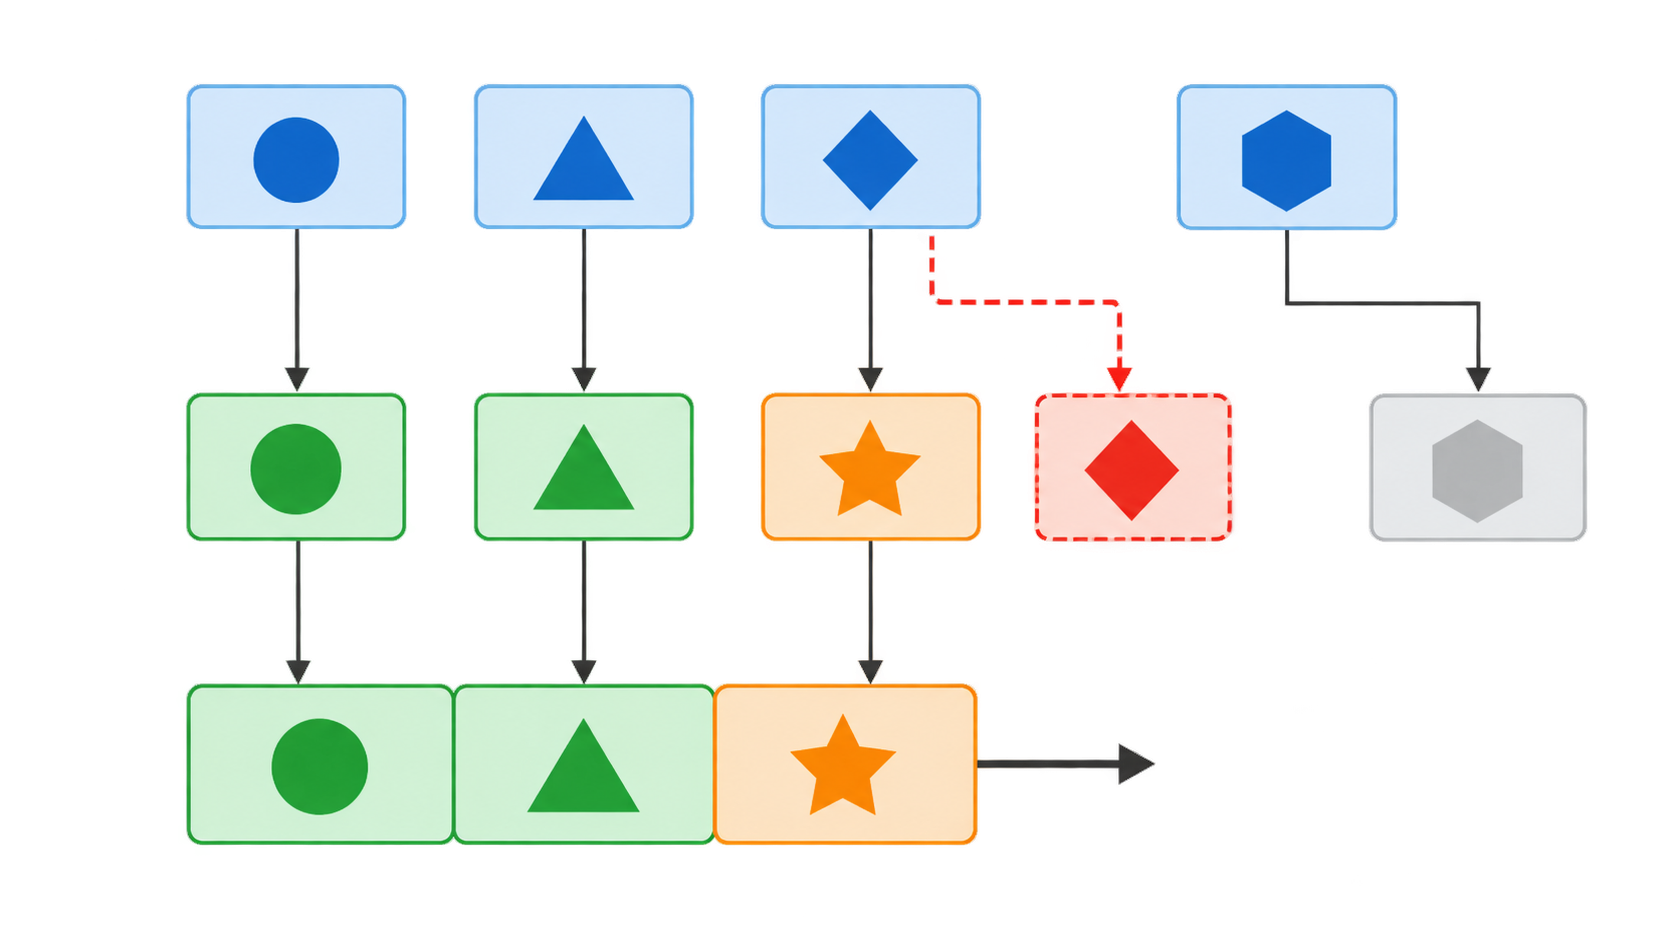
一部を棄却しても、先頭から採用できた部分は無駄になりません。ただし、候補が四つあるから四倍速になるという意味ではありません。候補を作る時間と検証する時間が加わるうえ、採用できる数も毎回変わるからです。
採用率が高くても速くならない条件
採用率とは、提示した候補のうち採用されたトークンの割合です。計測対象や集計方法は実装で異なることがあるため、比較時には定義も確認します。採用率は候補の当たりやすさを示しますが、それだけで利用者が感じる速さは決まりません。
速度を考える軸は、検証一回あたりに確定できるトークン数と、その一巡にかかる時間です。一巡には、ドラフト生成、ターゲットによる検証、棄却時の補正などが含まれます。多くの候補が採用されても、候補作り自体が重ければ、通常の生成より遅くなることがあります。
たとえば、専門用語の多い文章でドラフトの予測が合わず、毎回先頭付近で棄却されると、先に作った後半の候補が繰り返し無駄になります。逆に、予測のよく合う大きめのドラフトを選んでも、その実行時間が増えれば、採用率の改善が待ち時間の短縮につながるとは限りません。
候補数を増やすことにもトレードオフがあります。長く当たれば一度に多く確定できますが、外れれば破棄する量が増えます。また、候補の生成や検証に必要な計算と、モデルや途中の計算結果を保持するメモリも考慮が必要です。別のドラフトモデルを使う構成では、そのモデルを動かすための資源も要ります。
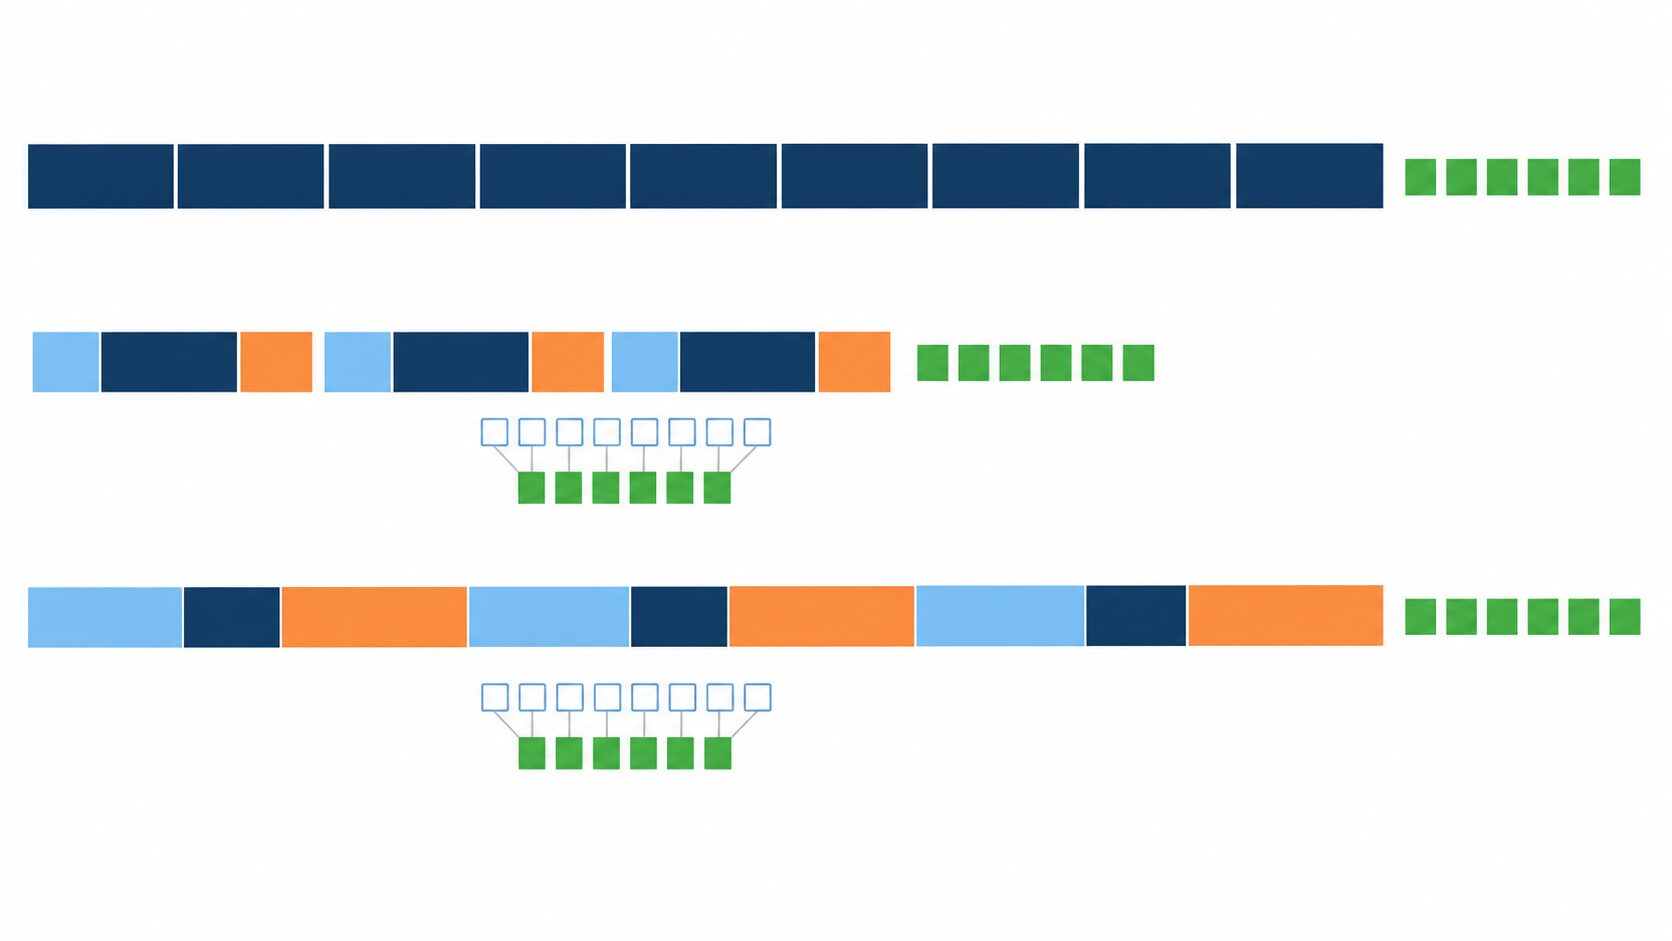
同時処理数も影響します。複数のリクエストをまとめて処理する単位をバッチと呼びますが、大きなバッチですでにGPUの計算能力を使い切っている場合、追加の検証を効率よく処理する余力が少なくなります。一人の応答が速くなる条件と、サービス全体で多くの要求を処理できる条件は、分けて評価する必要があります。
数語で終わる回答では、追加処理の負担を回収する機会が少なくなります。長い入力の読み込みが待ち時間の大半を占める場合も、出力部分だけ速くしても全体への効果は限定的です。速度倍率を一律に期待せず、実際の入力、出力長、負荷で確認しましょう。
蒸留・量子化との違い
蒸留や量子化もLLMを効率よく使うための手法ですが、変更する対象が異なります。生成の手順を変えるのか、モデルを学習するのか、計算に使う数値の表現を変えるのかで整理すると理解しやすくなります。
| 手法 | 何を変えるか | 適用段階 | 品質との関係 |
|---|---|---|---|
| 投機的デコーディング | 候補生成と検証による出力手順 | 推論時の生成処理 | 厳密な方式ではターゲットの出力分布を維持できる |
| 蒸留 | 教師モデルの振る舞いから学ぶ生徒モデル | 生徒モデルの学習時 | 教師の能力を完全に再現できるとは限らない |
| 量子化 | 重みや中間計算に使う数値の表現精度 | 学習後の変換、または学習時から考慮 | 低精度化の方法や程度によって出力に影響する |
蒸留では、教師となるモデルの出力などを使って生徒モデルを学習させます。小型の生徒モデルが必要な能力を身につければ、実行の負担を減らせます。ただし、生徒だけで回答する場合の品質は、そのモデルが学べた内容に左右されます。
量子化では、数値をより少ないビット数で表し、主にメモリ使用量やデータ転送量を減らします。対応するハードウェアや実装では計算も速くできますが、数値を粗くする影響と、実行環境での効果を確認する必要があります。
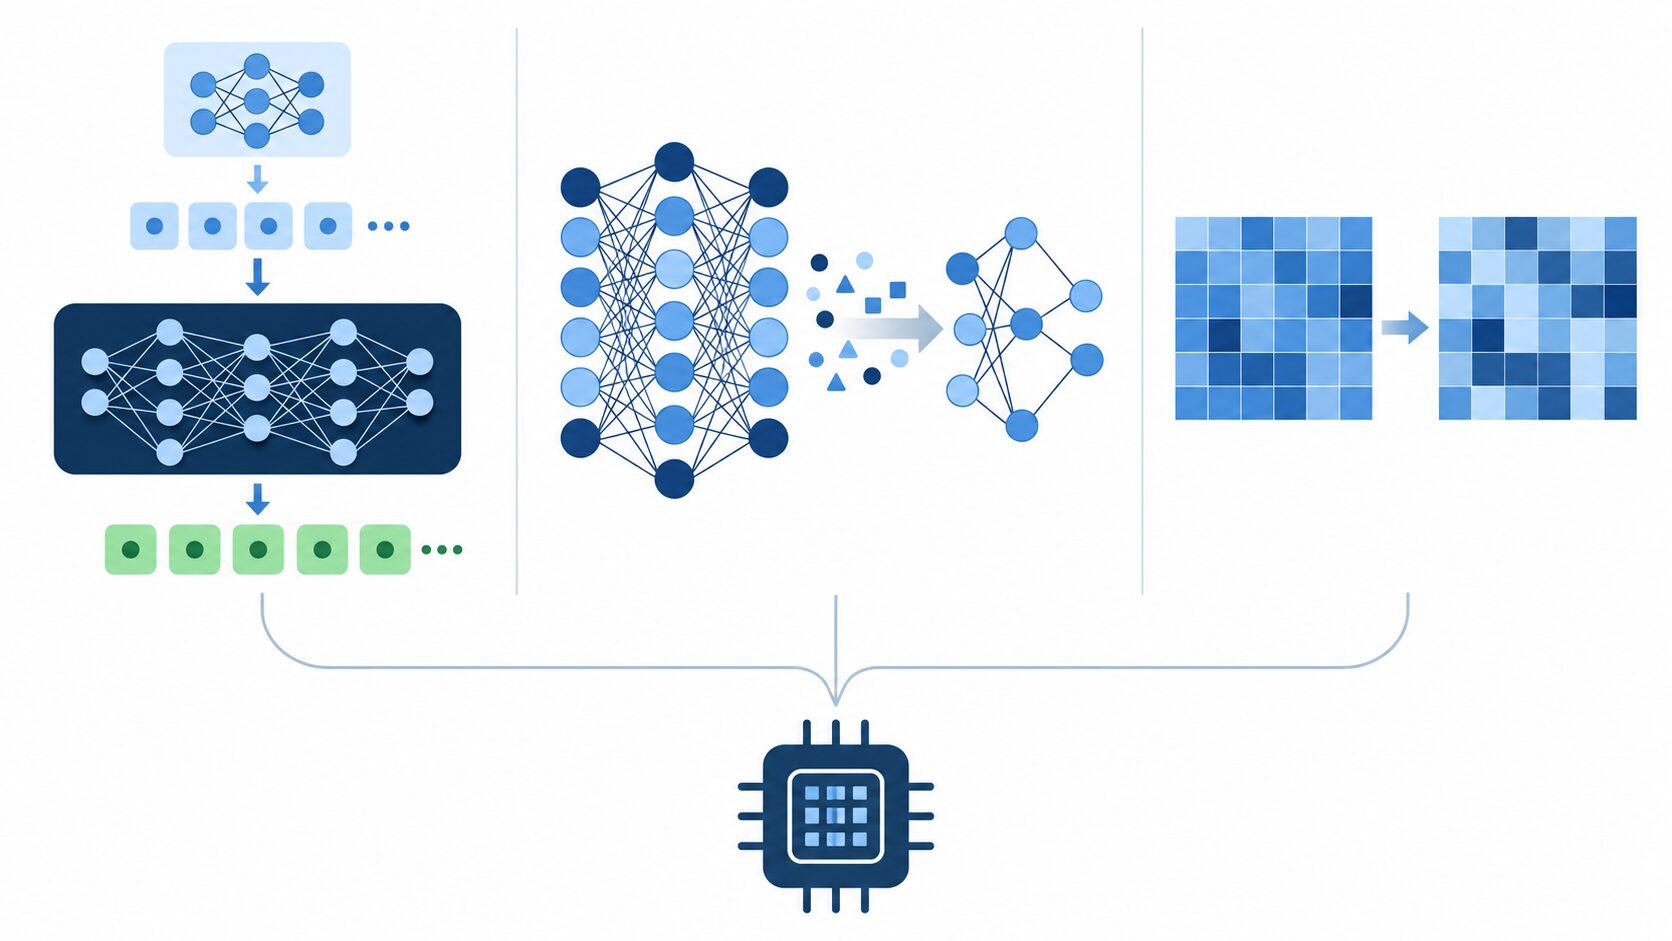
三つは併用も可能です。たとえば、蒸留でターゲットの予測に近い小型ドラフトを作り、その候補を検証する構成が考えられます。ただし、ターゲット自体を量子化した場合、分布維持の比較対象は変更後のターゲットです。投機的デコーディングが厳密でも、量子化前のモデルとの差までなくなるわけではありません。
使いどころと導入前に確認すること
文章作成支援やコード生成など、回答がある程度続き、候補が当たりやすい用途は検討対象になります。定型的な表現やよく現れる構文では、軽い処理でも続きを予測できる可能性があります。ただし、長文だから必ず有利とはいえず、題材やモデルの組み合わせによって採用率も負担も変わります。
この手法は、プロンプトに「投機的デコーディングを使って」と書くだけでは有効になりません。生成を実行する推論基盤側の機能です。提供サービスや実行エンジンが対応しているか、選べる方式やモデルの組み合わせ、必要なメモリ容量を確認します。別モデルを組み合わせる場合は、トークンの扱いを含め、基盤がその構成をサポートしていることも必要です。
導入判断では、同じターゲットモデル、同じ入力、同じ生成設定、同じ負荷で、有効時と無効時を比較します。待ち時間や処理能力は、次の指標に分けると効果を捉えやすくなります。
- 初回トークンまでの時間:要求を送ってから、最初の出力が届くまでの待ち時間。
- 生成中の速さ:出力が始まった後、単位時間あたりにどれだけ生成できるか。
- 応答完了時間:要求から回答全体が完成するまでにかかる時間。
- 全体の処理量:複数の利用者を含め、一定時間に処理できる要求数や出力トークン数。
普段使う入力を複数用意し、短い回答と長い回答、空いている時間と混雑時の条件で測ります。採用率だけでなく、検証一回あたりの確定数、メモリ消費、実際の出力品質も確認します。厳密な方式でも、実装や設定が想定どおりかを点検するために品質の比較は役立ちます。
投機的デコーディングは、候補生成と検証の負担を上回るだけの候補を採用できる条件で有効です。大きなモデルの判断を保ちながら待ち時間を減らしたいときに、実際の利用条件で効果を確かめることが導入の判断材料になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月3日 | 初回公開 |