
言語モデルとは?言葉の魔法を支える仕組みと活用例

AIの初心者
「言語モデル」って、どうして自然な文章を作れるんですか?

AI専門家
文章から言葉のつながりを学び、続きにどんな言葉が来そうかを予測するんだ。例えば「おはようござい」まで入力すると、その後に「ます」が続きそうだと予測するような仕組みだよ。
AIの初心者
決まったあいさつだけでなく、長い文章の続きも予測できるんですか?
AI専門家
できるよ。たくさんの文章から学んだ規則性を使って、入力に続く候補の現れやすさを確率で表すんだ。その予測を繰り返すと、長い文章も作れる。ただし、自然な文章になっていても、内容が正しいとは限らないんだよ。
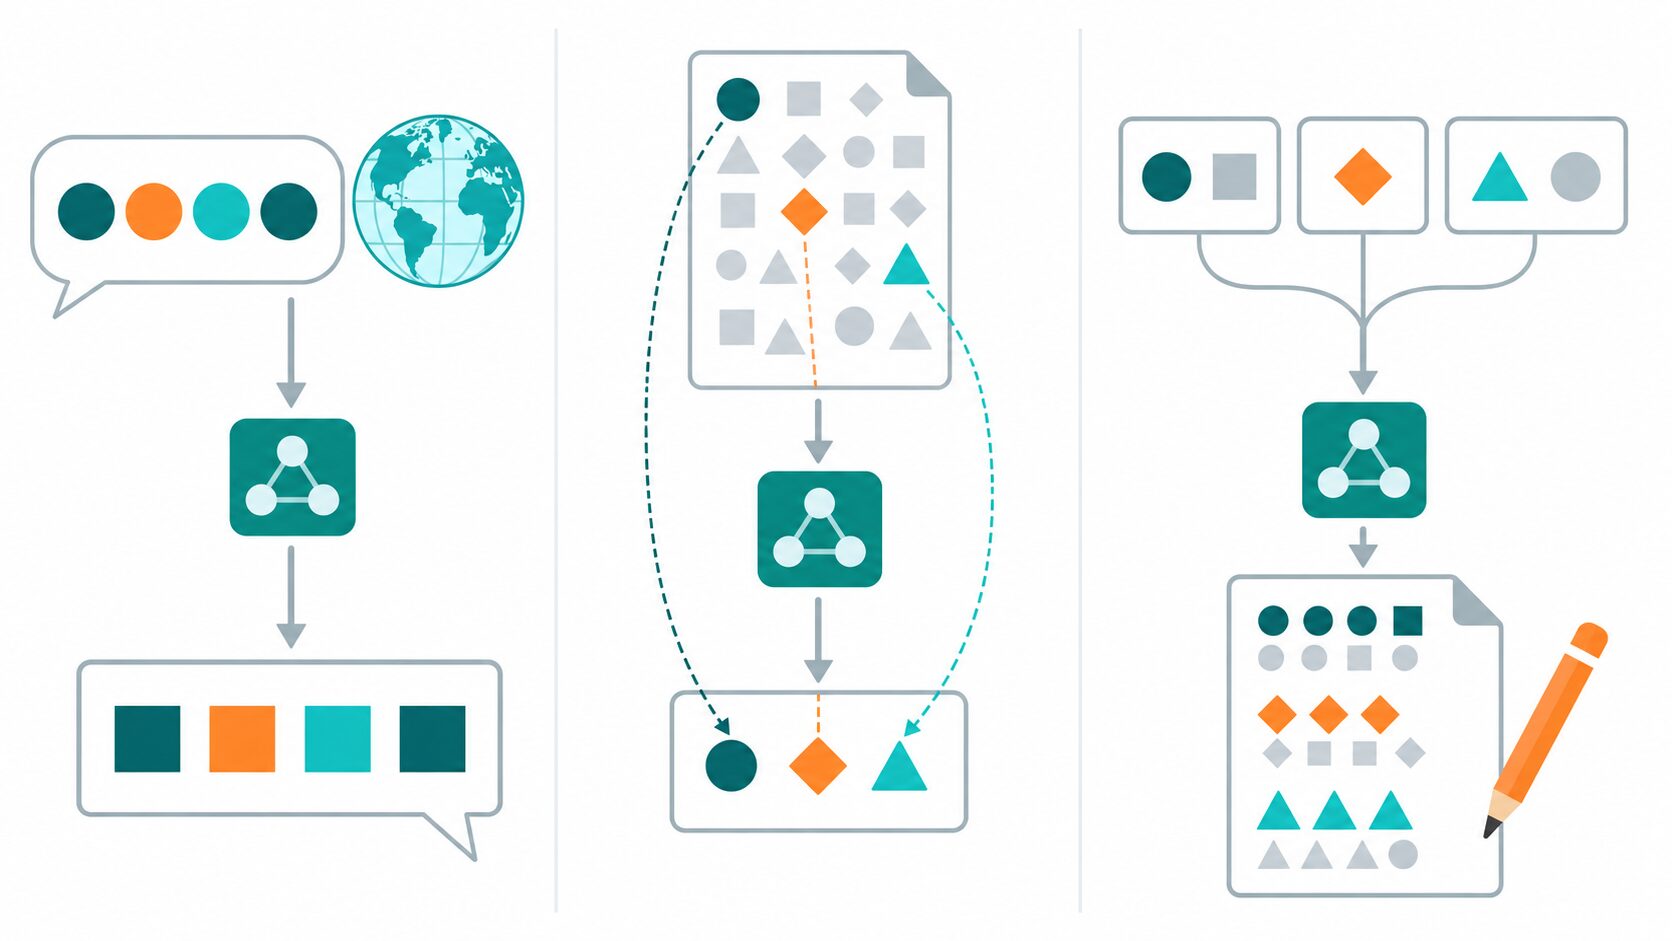
言語モデルとは、言葉の並びの現れやすさを確率で表すモデルです。「おはようござい」の後に「ます」が続きやすいという予測も、その一例です。文章を生成するタイプでは、入力された文脈をもとに続きを少しずつ選び、ひと続きの文章にしていきます。
質問に答えたり、物語を書いたりする様子は、言葉の魔法のように見えるかもしれません。その土台にあるのは、文章データから学んだ規則性と確率の計算です。言語モデルは、人間の言葉をコンピューターで扱う「自然言語処理」を支える技術の一つで、入力補完、翻訳、要約などに使われます。ここでは文章ができる仕組みから、N-gramや大規模言語モデルとの関係、利用時の確認点までを順に説明します。
言語モデルは言葉の並びを確率で表す
言語モデルが扱うのは、「この言葉の後には、どんな言葉がどれくらい続きやすいか」という関係です。続きは一つに決まるわけではありません。「今日は」だけなら、「晴れています」「会議があります」「何を食べようか」など、さまざまな候補が考えられます。
候補の現れやすさは、前後の話題によって変わります。天気の話をしていれば空模様に関する表現が、仕事の予定を相談していれば会議や作業に関する表現が続きやすくなるでしょう。言語モデルは、参照できる文脈と学習したパターンをもとに、候補ごとに異なる確率を割り当てます。これが、入力を変えると回答の内容や言い回しも変わる基本的な理由です。
ここで大切なのは、言葉が続きやすい確率と、その内容が事実である確率は別だということです。「今日は晴れています」が文章として自然でも、その計算だけで実際の天気を観測したことにはなりません。もっともらしい人名や日付が出てきた場合も、文脈に合っていることと、実在する情報であることは分けて考える必要があります。
また、言語モデルの学習は、辞書から意味を一つずつ引くだけの処理ではありません。文章の中で言葉がどう使われるかを通じて、語順、表現の似かより、話題のつながりなどを捉えます。例えば「桜」と「花見」は同じ言葉ではありませんが、同じ話題に登場しやすい関係があります。こうした関係を利用すると文脈に沿った応答を作れますが、自然に応答できることだけで、人間と同じ理解の仕方や意識を持つとはいえません。
次の言葉の予測から文章ができるまで
文章生成に使われる言語モデルの代表的な方式は、次のトークンを予測し、選んだトークンを文脈に追加する処理を繰り返すものです。トークンとは、モデルが文章を扱うための単位です。単語、単語の一部、記号などに対応し、常に一文字や一単語になるわけではありません。どこで区切るかは、使うモデルや分割方法によって異なります。
- 入力を受け取る:質問や指示、参考にする文章などを受け取ります。
- トークンに分ける:入力をモデルが処理できる単位に分割し、対応する番号で表します。
- 候補の確率を求める:それまでの文脈から、次に来るトークンの候補に確率を割り当てます。
- 一つを選ぶ:候補の中から、設定された選び方に従って次のトークンを決めます。
- 文脈に追加する:選んだトークンを入力の続きに加え、その続きの予測に使います。
- 生成を繰り返す:終了を表すトークンや出力の長さの上限など、停止条件に達するまで予測と選択を続けます。
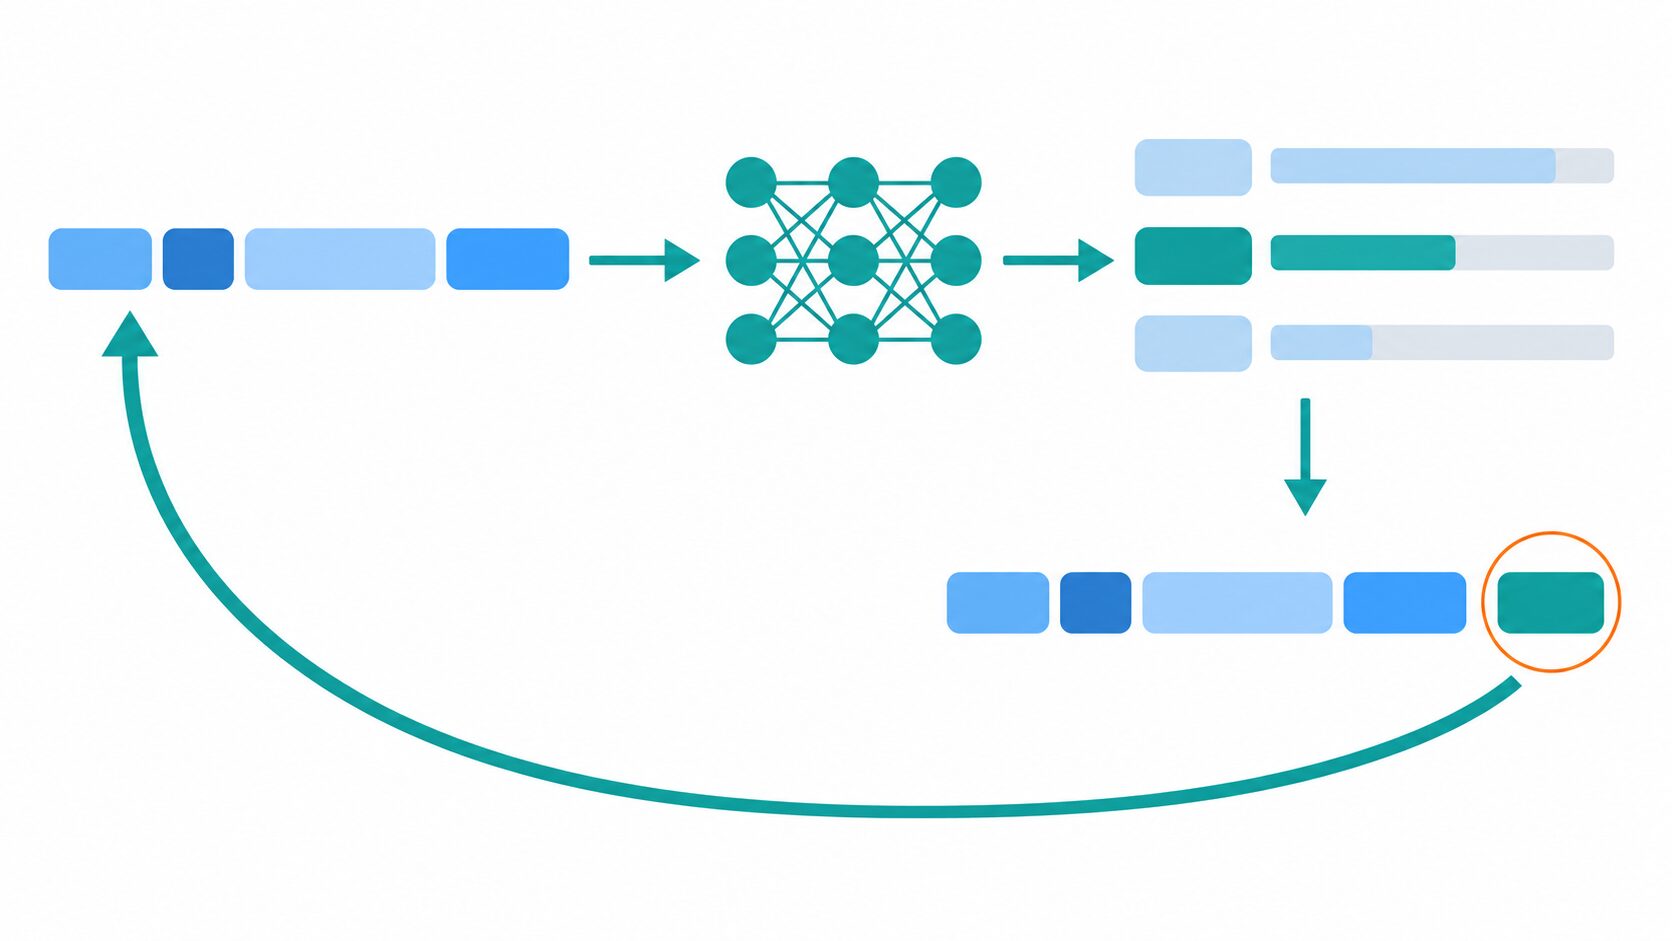
選び方をイメージするために、次のトークンの候補が三つだけあり、その確率が60%、30%、10%になったと仮定しましょう。この数値は説明用で、実際のモデルを測定した結果ではありません。確率が最大の候補を選ぶ方法なら60%の候補が選ばれます。一方、確率に応じて抽選する方法なら、30%や10%の候補が選ばれることもあります。そのため、同じ入力でも異なる文章が出る場合があります。
この予測を行えるようにする準備が「学習」です。ニューラル言語モデルでは、文章データに対する予測のずれなどを手がかりに、計算の振る舞いを決める多数の数値である「パラメータ」を調整します。これに対し、学習済みのモデルを使って入力への出力を計算する段階が「推論」です。チャットで返答を生成する処理は、この推論に当たります。
会話の続きを考慮することと、その都度モデルを学習し直すことは異なります。例えば、最初に「小学生にも伝わる説明にして」と指定し、その後の回答にもその条件が反映されるのは、会話内容を文脈として参照できるためです。入力内容を後日の学習に利用するかどうかは、サービスの運用や設定に関する別の問題です。
生成される文章は、既存の文を検索して貼り合わせるだけではありません。学んだ規則性から、学習時には見られなかった言葉の組み合わせも作れます。ただし、定型表現や学習データに含まれた文章に似た出力、場合によっては同じ文章が出る可能性もあります。新しく出力されたことだけを理由に、内容の独自性まで保証されたとは考えないことが大切です。
N-gramとニューラル言語モデルの違い
言語モデルには、確率の求め方が異なる複数の手法があります。基本を比べるうえで分かりやすいのが、言葉の短い並びの出現回数を利用する「N-gram言語モデル」と、ニューラルネットワークで確率を計算する「ニューラル言語モデル」です。どちらも文章データから学びます。
N-gram(Nグラム)は、連続するN個の単位の並びを意味します。単位を単語にするか文字にするかで、取り出される並びは変わります。例えば「今日/は/晴れ/です」と四つの単語に区切った場合、単語3-gramは「今日・は・晴れ」と「は・晴れ・です」の二つです。「今日」は漢字二文字ですが、この例では一つの単語として数えています。
基本的なN-gram言語モデルは、直前のN−1個を条件に、次の単位の確率を推定します。単語3-gramなら、直前の二単語を手がかりにします。学習データで「今日・は」の後に何が何回続いたかを数え、その割合を使う、という考え方です。実際には、一度も現れなかった並びの確率がすべてゼロにならないよう、確率を補正する工夫なども用いられます。
Nを大きくすると長い並びを扱えますが、必要な組み合わせの数も増えます。すると、十分な回数を観測できない並びが増え、確率を安定して求めにくくなります。また、参照する範囲より前にある話題は、そのままでは予測に使えません。仕組みが明快な一方で、長い文脈や見慣れない表現への対応が課題になります。
ニューラル言語モデルは、言葉を数値のまとまりとして表し、ネットワークの計算を通じて候補の確率を求めます。多くの例から共通するパターンを学ぶことで、全く同じ並びの出現回数だけに頼らずに予測できます。違いは「学習するかどうか」ではなく、データから得た情報をどう表し、確率を計算するかにあります。ニューラルネットワークは神経のつながりに着想を得た計算の仕組みですが、人間の脳そのものを再現したものではありません。
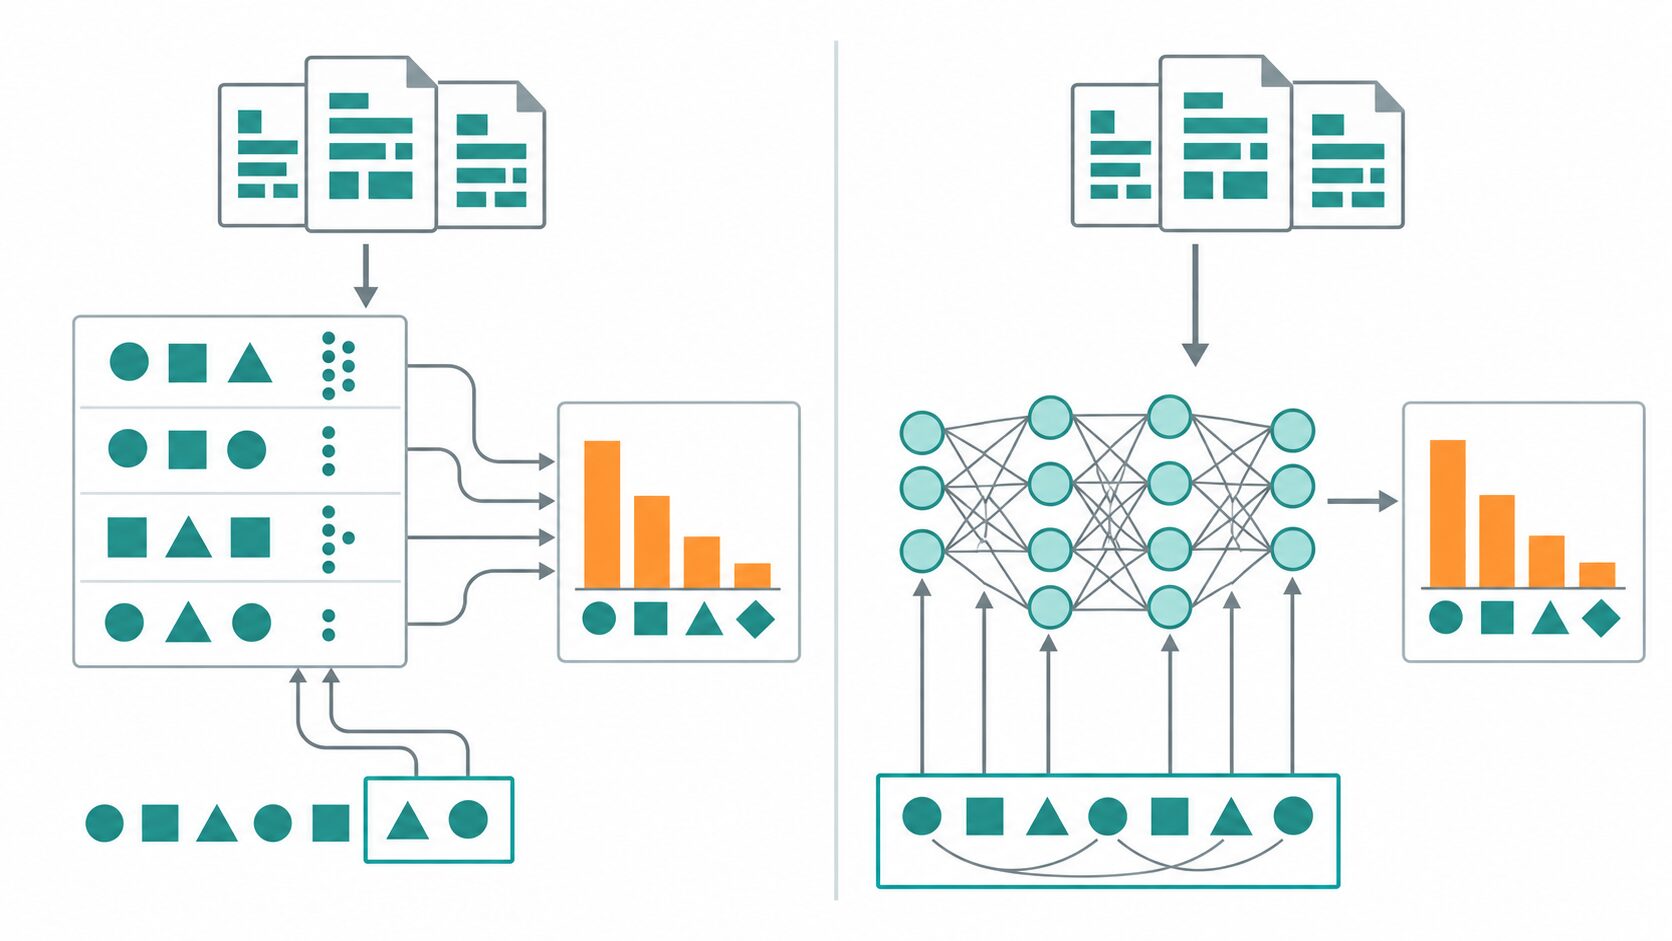
| 比較する点 | 基本的なN-gram言語モデル | ニューラル言語モデル |
|---|---|---|
| 確率の求め方 | 短い並びの出現回数や、その割合を使う | 学習で調整したパラメータを使い、ネットワークで計算する |
| 参照する文脈 | 直前のN−1個の単位 | モデルの構造に応じた範囲。より広い文脈を扱える方式もある |
| 長所 | 考え方が明快で、小さなモデルなら計算や結果を追いやすい | 言葉の関係を学び、見慣れない組み合わせにも対応しやすい |
| 制約 | 長い文脈を扱いにくく、Nを増やすと十分な出現例が集まりにくい | 規模に応じた計算資源が必要で、文脈を扱える範囲や予測精度にも限界がある |
ニューラル言語モデルで使われる代表的な方式の一つに「Transformer(トランスフォーマー)」があります。入力中のどの部分が互いに関連するかを計算に反映する「注意機構」を用いるのが特徴です。例えば「桜が満開で、公園には朝から多くの人が集まり、花見を楽しんでいます」という文では、間に別の言葉が入っていても「桜」と「花見」の関係を予測に利用できます。
ただし、Transformerを使えば文章を無制限に参照できるわけではありません。一度に扱えるトークン数には上限があり、その範囲を「コンテキストウィンドウ」と呼びます。上限内に収まっていても、細部を常に正確に反映できるとは限らないため、長い資料を扱う際には、対象箇所や目的を明確にすることが役立ちます。
言語モデル・LLM・生成AIの関係
LLMはLarge Language Modelの略で、日本語では「大規模言語モデル」と呼びます。大量のデータや多数のパラメータを用いる言語モデルを指し、言語モデルという広い分類の中に位置づけられます。N-gramのような小規模なモデルも言語モデルなので、すべての言語モデルがLLMというわけではありません。また、何個のパラメータ以上なら必ずLLMと呼ぶ、という一律の境界があるわけでもありません。
一方、「生成AI」は、文章や画像、音声などのコンテンツを生成するAIを指す、より広い呼び方です。文章を生成する仕組みには言語モデルが使われますが、画像や音声の生成にもそれぞれの技術があります。そのため、生成AIと言語モデルは同義ではありません。さらに、複数の種類の情報を扱うシステムもあるため、製品名だけで処理の仕組みを判断せず、何を入力し、何を生成できるかを見ると区別しやすくなります。
言語モデルの用途は、文章の続きを作ることだけではありません。文章の現れやすさを評価したり、「私は朝、[空欄]を飲みます」のような文の欠けた部分を予測したりする方式もあります。前の節で説明した、次のトークンを一つずつ出す流れは、文章生成に使われる代表的な方式を示したものです。
また、対話サービスは言語モデルだけで成り立っているとは限りません。利用者の指示に沿って答えるための追加学習や調整、外部資料を検索する機能、計算を行う道具などが組み合わされる場合があります。「回答できた」という結果だけで、その情報をモデルが学習済みだったのか、資料から取得したのかは分かりません。言語モデルの能力と、サービスに付加された機能を分けて見ると、できることの範囲を把握しやすくなります。
翻訳・要約・文章作成での活用例
言語モデルは、言葉の候補を示す、長い文章から要点をまとめる、目的に合う言い回しを作るといった作業に役立ちます。とくに、元になる情報や完成形の条件を示せる作業では、出力を確認しながら使いやすくなります。代表的な用途と確認点をまとめると、次のようになります。
| 用途 | 入力例 | 支援できる内容 | 確認する点 |
|---|---|---|---|
| 入力補完 | 書きかけの文「ご連絡いただき」 | 続きの表現を候補として示す | 意図や相手との関係に合うか |
| 翻訳 | 案内文と「自然な日本語に翻訳して」 | 文脈に応じた訳文を作る | 固有名詞、数値、否定や条件の意味 |
| 要約 | 会議メモと「決定事項と担当者に分けて」 | 長い記録から要点を取り出す | 決定内容や氏名の抜け、取り違え |
| 質問応答 | 製品の説明書と「設定手順を教えて」 | 資料に沿って答えを文章にする | 資料に根拠があるか、手順が正しいか |
| メールの下書き | 相手、用件、日時、希望する丁寧さ | 条件をもとに文面を作る | 宛名、日付、約束や依頼の内容 |
| 物語の創作 | 登場人物、舞台、長さ、結末の条件 | あらすじや本文の案を出す | 人物設定や出来事のつじつま |
例えば、架空の会議メモに「次回説明会は11月10日に開催。案内文は佐藤が11月3日までに作成。会場は未定」と書かれているとします。単に「要約して」と頼むよりも、「この会議メモを、決定事項・担当者・期限・未決事項に分けてまとめてください。書かれていない情報は未記載としてください」と指定すると、確認したい内容が出力に表れやすくなります。
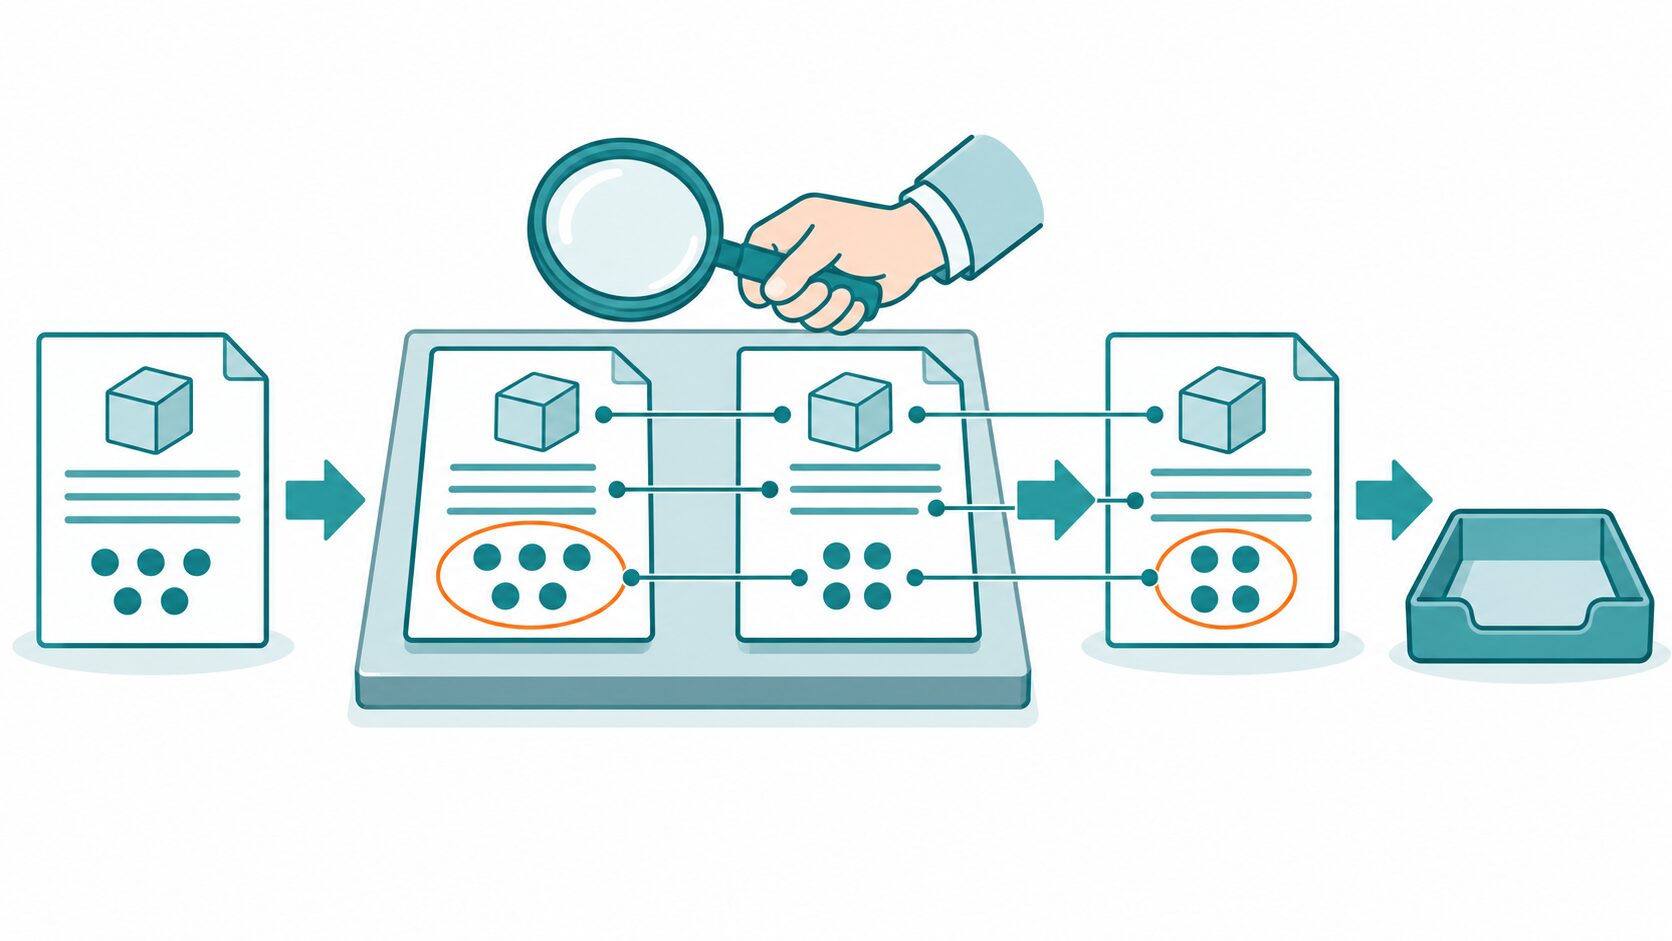
この例なら、開催日、案内文の担当者と期限、会場が未定であることを区別して確認できます。会場名をもっともらしく補っていないか、11月3日を開催日と取り違えていないかも、元のメモと照合します。元文・目的・出力形式を示すことは、作業の焦点を合わせる助けになりますが、誤りをなくす保証ではありません。
翻訳では、読みやすさに加えて、固有名詞や専門用語、否定表現が元の意味を保っているかを確認します。メールなら、入力していない納期や約束が追加されていないかが大切です。創作では自由な発想を活かしつつ、人物の設定や指定した結末と矛盾していないかを見直すと、下書きを仕上げやすくなります。
最新情報を含む質問では、モデル単体がその場でインターネットを検索しているとは限りません。検索機能があるサービスでも、取得した資料が古かったり、対象が違ったりする可能性があります。新しい情報が必要な場合は、参照された資料の日付と内容を確認するか、確認済みの資料を与えて処理してもらう方法が考えられます。
自然な文章でも確認が必要な理由
言語モデルの出力を利用するときは、文章の読みやすさと内容の正確さを別々に確認することが基本です。モデルは文脈に合う表現を生成する一方で、すべての主張を原資料と照合してから出力する仕組みとは限りません。そのため、存在しない情報や誤った説明を、確信があるような文体で出すことがあります。こうした、もっともらしい誤情報の生成は「ハルシネーション」と呼ばれます。
確認では、回答全体を漠然と読み返すより、使う予定の事実を取り出して原資料と照らすと判断しやすくなります。特に数値や日付、引用元は、文章が自然でも誤っている可能性があります。出典の名前やリンクが付いている場合も、その資料が実在するか、資料の内容が主張を裏づけているかまで確かめます。
- 事実:人名、組織名、出来事、製品の機能などが、確認できる資料と一致しているか。
- 数字:金額、日付、割合、単位、計算結果に取り違えがないか。
- 引用元:資料が実在し、引用や要約が元の記述を正しく表しているか。
- 要約の範囲:条件や例外が抜けていないか、提案を決定事項に変えていないか。
学習データに含まれる偏りが、出力に反映される可能性もあります。ある立場の情報が多ければ、別の見方が十分に示されないことがあります。特定の属性への決めつけや、根拠のない一般化がないかを確認し、比較や判断に使う場合は複数の資料に当たることが役立ちます。
また、入力する情報にも配慮が必要です。個人情報や社外秘の会議記録を扱う前には、利用環境の規約、入力データの保存・利用条件、所属先の管理ルールを確認します。必要な部分だけを抜き出す、氏名を置き換えるなど、目的に応じて入力を絞る方法もあります。会話中にモデルが学習し直さないことと、入力内容が保存されないことは別の話です。
言語モデルの研究が進むことで、より長い文脈の扱いや、異なる言語間での翻訳の改善が期待されます。ただし、そうした進歩が人間と同じ理解や完全な正確さを保証するわけではありません。言葉の候補を広げたり、資料をまとめたりする力を活かしながら、使う目的に応じて人が根拠と内容を確かめることが、実務や学習での有効な活用につながります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月3日 | N-gramの数え方を修正し、生成手順とLLMの位置づけ、出力の確認点を追記 |