
RMSpropは、最近の勾配の大きさをもとに、パラメータごとの実効的な学習率を調整する最適化アルゴリズムです。機械学習や深層学習で、モデルの予測と正解のずれを小さくするために使います。中心となる工夫は「勾配の二乗の指数移動平均」。過去の情報を利用しながら、古い情報の影響を徐々に弱めます。
この記事では、RMSpropの仕組みを直感的な説明と更新式で確認し、AdaGrad・AdaDelta・Adamとの違い、画像認識などでの使いどころ、学習率を設定するときの注意点まで解説します。

AIの初心者
「RMSprop」って、AdaDeltaとどう違うんですか?どちらも学習の進み方を調整する方法ですよね?

AI専門家
そうだね。どちらも最近の勾配の情報を使って、パラメータの更新の大きさを調整するんだ。RMSpropの基本形は勾配の二乗の移動平均を使う。一方、AdaDeltaはそれに加えて、実際にパラメータを動かした更新量の二乗の移動平均も使うよ。
AIの初心者
使う履歴の種類が違うんですね。似た仕組みなのに、別々に考えられたんですか?
AI専門家
そうなんだ。同じ時期に別々に提案され、AdaGradで実効的な学習率が小さくなりすぎる問題に対応している点が共通している。まずRMSpropの更新手順を押さえると、共通点と違いが見えてくるよ。
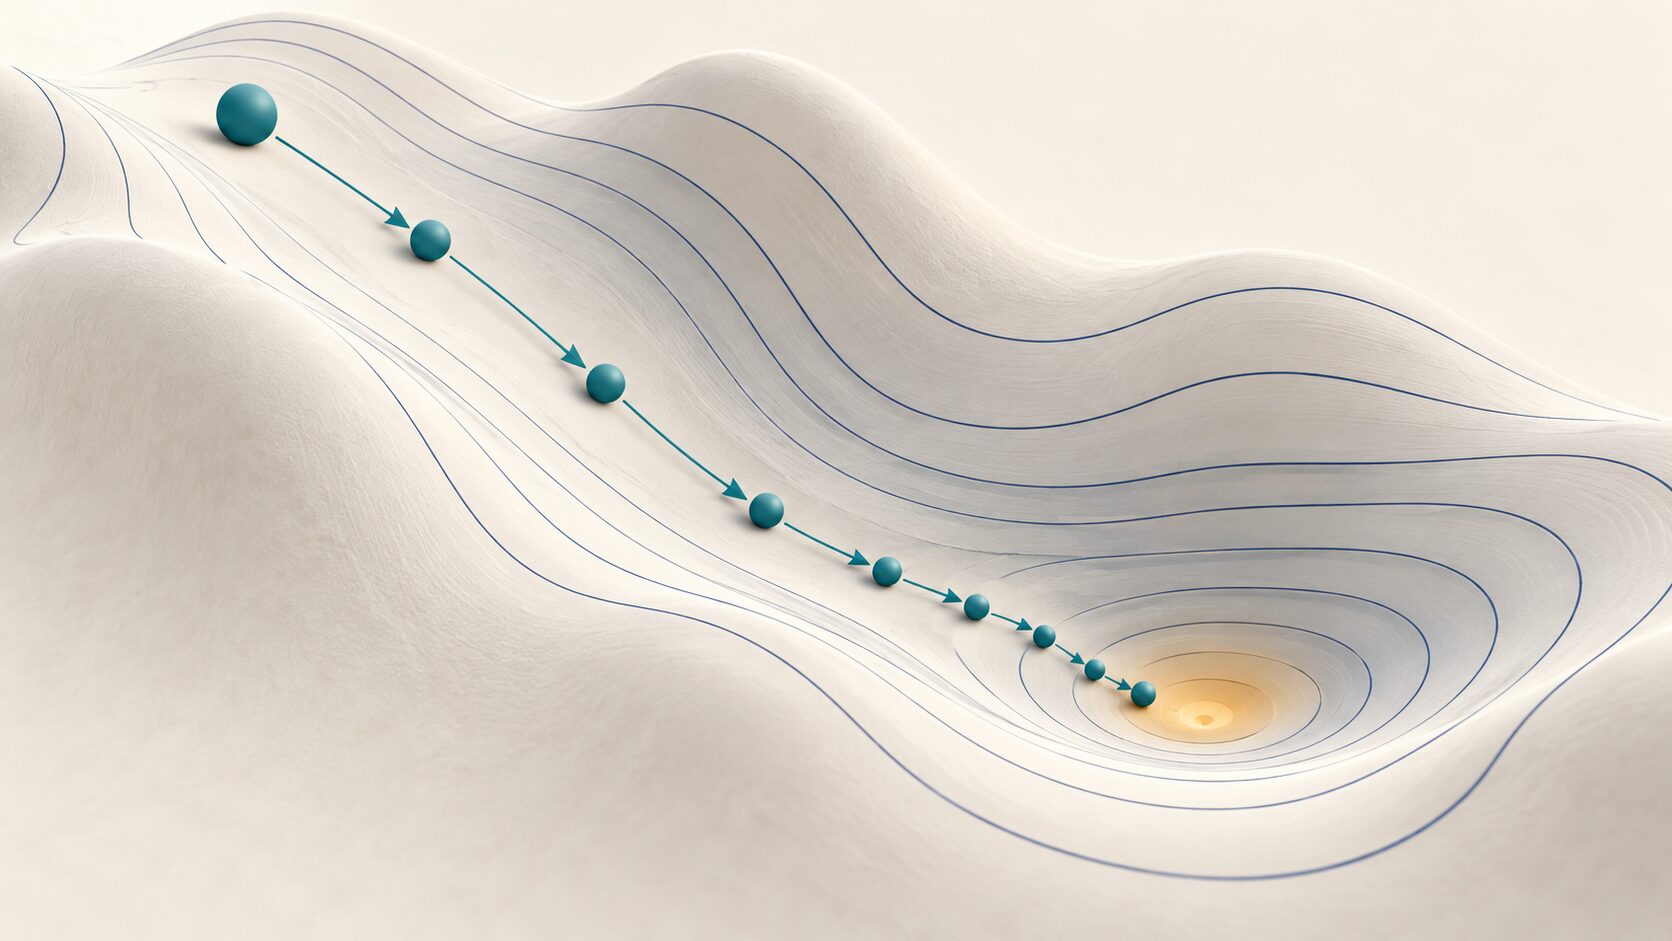
図は損失を小さくする過程のイメージです。実際の学習で、毎回損失が下がることや最適解への到達を保証するものではありません。
RMSpropとは?学習率をパラメータごとに調整する手法
RMSpropは、Root Mean Square Propagationの略で、二乗平均平方根を利用する最適化手法です。ニューラルネットワークの重みやバイアスといったパラメータを、損失が小さくなる方向へ更新する役割を担います。画像を分類する仕組みそのものではなく、そのモデルを学習させるための計算方法です。
たとえば、お菓子のレシピで材料の配合を少しずつ変えるように、機械学習ではパラメータを調整して予測を改善します。ただし「よくなったかどうか」を感覚で判断する代わりに、予測と正解のずれを損失関数で数値化します。その損失が、各パラメータを少し動かしたときにどう変化するかを表すのが勾配です。勾配は精度そのものではなく、損失の変化を微分で捉えた量です。
基本的な勾配降下法では、勾配に学習率を掛け、勾配と逆向きにパラメータを動かします。学習率は更新の大きさを決める係数です。同じ学習率でも、勾配の大きなパラメータは大きく動くため、方向によって損失の変化が激しい問題では、振動したり進みが遅くなったりします。
RMSpropは、最近の勾配が大きいパラメータの更新を相対的に抑え、勾配が小さいパラメータには相対的に大きな係数を使います。細長い谷を下る場面なら、急な横方向の動きを抑えつつ、谷に沿う方向へ進みやすくするイメージです。斜面や損失関数自体を変えるのではなく、更新の大きさを調整します。
仕組みの中心は「勾配の二乗の指数移動平均」
RMSpropを理解する鍵は、勾配を二乗し、その指数移動平均をパラメータごとに持つことです。勾配には正と負がありますが、そのまま平均すると、互いに打ち消し合うことがあります。二乗してから平均すれば、向きにかかわらず、勾配の大きさを反映した値を得られます。
指数移動平均とは、新しい値を取り込むたびに、それまでの平均の重みを少し減らす方法です。たとえば減衰率を0.9にすると、前回の平均を90%、今回の勾配の二乗を10%の割合で混ぜます。古い勾配の影響は、更新が進むたびにさらに0.9倍されるため、最近の情報ほど強く反映されます。
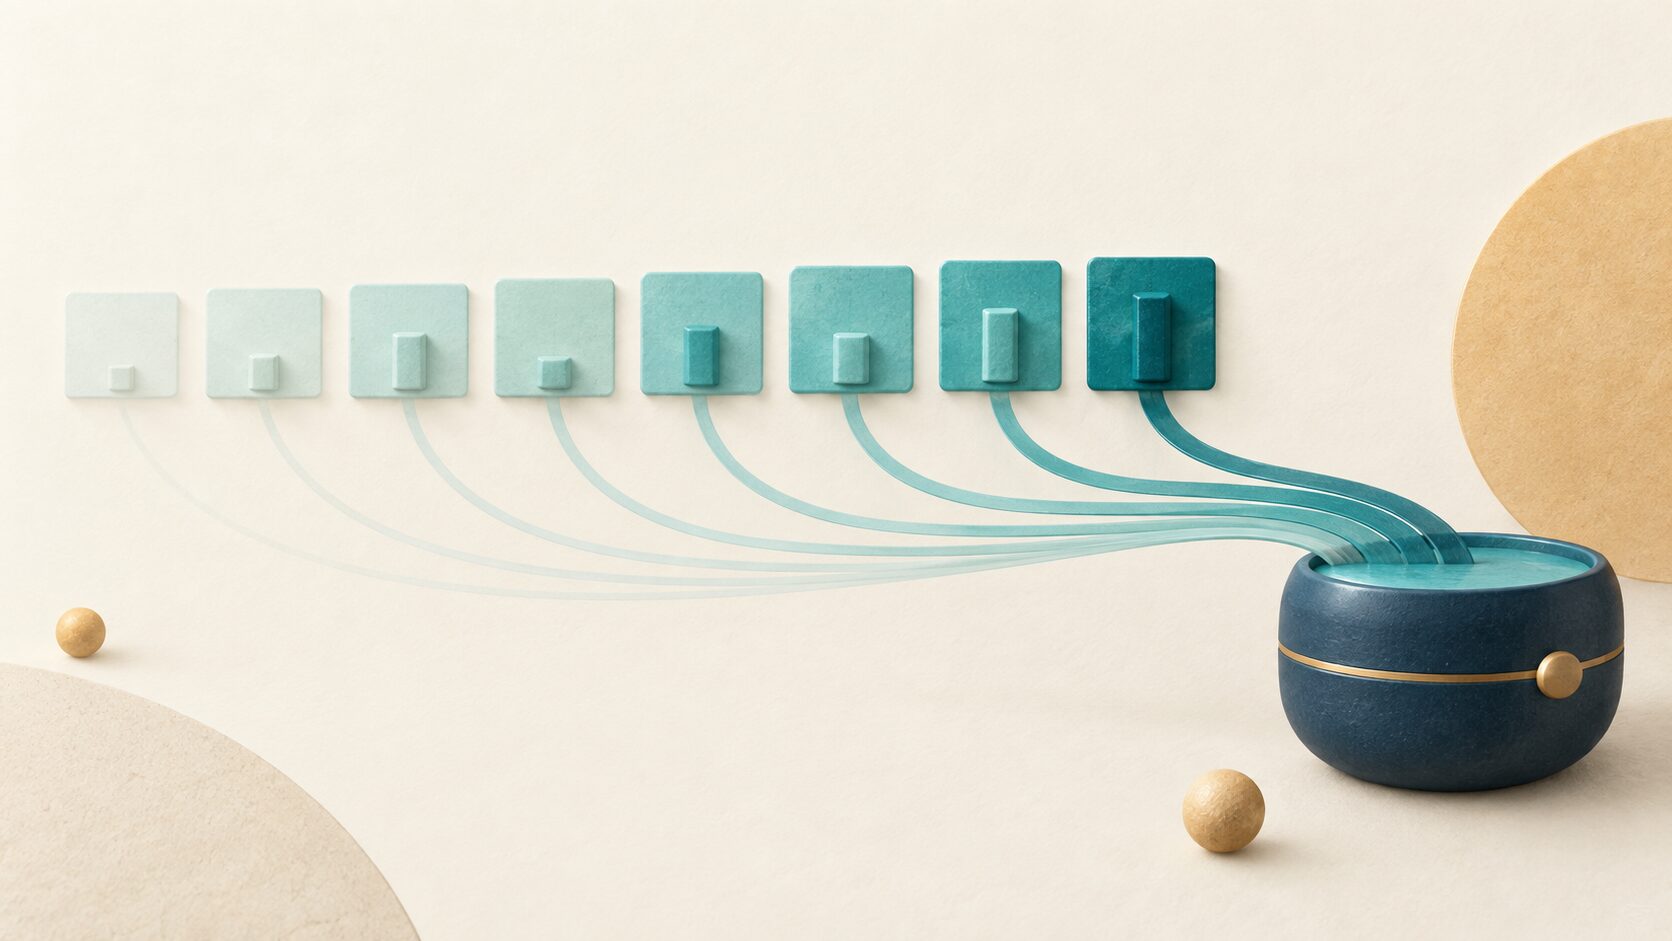
図の淡いタイルは古い情報、濃いタイルは最近の情報を表します。直近の一定回数だけを残して、それ以前を一度に捨てる仕組みではありません。過去の影響を連続的に弱めながら、平均値を更新します。
次に、この平均の平方根で現在の勾配を割り、学習率を掛けます。平均が大きいパラメータでは分母が大きくなるので、更新が抑えられます。ただし、更新量は分母だけでなく現在の勾配にも依存します。「勾配が小さければ必ず大きく動く」という意味ではなく、現在の勾配を、最近の勾配の規模に合わせて調整すると考えると正確です。
RMSpropの更新式と計算例
\(v_t = \rho v_{t-1} + (1-\rho)g_t^2\) \(\theta_t = \theta_{t-1} – \frac{\eta g_t}{\sqrt{v_t}+\epsilon}\)上の2式が、モーメンタムなどを加えないRMSpropの基本形です。1つ目で勾配の二乗の指数移動平均を更新し、2つ目でパラメータを動かします。ここでは初期値を\(v_0=0\)とし、勾配は更新前のパラメータで計算します。
| 記号 | 意味 | 読み方のポイント |
|---|---|---|
| \(t\) | 更新の回数 | ミニバッチごとの更新などを数える |
| \(\theta_t\) | 更新後のパラメータ | 重みやバイアスに相当する |
| \(g_t\) | 今回の損失の勾配 | 各パラメータに対する損失の微分 |
| \(v_t\) | 勾配の二乗の指数移動平均 | 最近の勾配の大きさを反映する。分散そのものではない |
| \(\rho\) | 減衰率 | 0以上1未満の値。1に近いほど古い情報を長く残す |
| \(\eta\) | 基準となる学習率 | 利用者が設定する、全体の更新の大きさを決める係数 |
| \(\epsilon\) | 正の小さな定数 | ゼロ除算を避け、分母が極端に小さくなる影響を抑える |
パラメータが複数ある場合、二乗・平方根・割り算はそれぞれの要素に対して行います。すべての勾配を1つの平均値にまとめるわけではありません。また、上の式では\(\epsilon\)を平方根の外に加えていますが、平方根の中に加える実装もあります。実装を読み比べる際は、その位置も確認してください。
1つのパラメータで計算してみましょう。\(\rho=0.9\)、\(\eta=0.01\)、\(v_0=0\)、最初の勾配を\(g_1=2\)とします。すると二乗平均は次の値になります。
\(v_1=0.9\times0+0.1\times2^2=0.4\)説明のため\(\epsilon\)の影響を無視できるほど小さいとすると、更新量の大きさは次のとおりです。
\(\frac{0.01\times2}{\sqrt{0.4}}\approx0.0316\)勾配が正なので、現在のパラメータから約0.0316を引きます。次の更新では、今回求めた\(v_1=0.4\)を前回の平均として使います。この例は計算手順を示すもので、学習率0.01や減衰率0.9がどの課題にも適するという意味ではありません。
同じ現在の勾配でも、直前までの履歴が異なれば更新量は変わります。また、学習初期は二乗平均がゼロから立ち上がるため、更新が予想より大きくなることがあります。RMSpropが「常に通常の勾配降下法より小さく動く手法」ではない点も押さえておきましょう。
AdaGradとの違い:過去の勾配を足し続けない
AdaGradとRMSpropは、どちらも勾配の二乗を使い、パラメータごとに更新の大きさを変える手法です。違いは、AdaGradが勾配の二乗を累積するのに対し、RMSpropは指数移動平均を使うことにあります。
AdaGradの二乗和は、学習が進んでも小さくなりません。その平方根で勾配を割るため、基準の学習率を一定にしていると、実効的な学習率は次第に小さくなりやすくなります。これは更新の頻度が異なるパラメータの調整に役立つ一方、長く学習する場面では更新が小さくなりすぎ、改善が遅くなる原因になります。
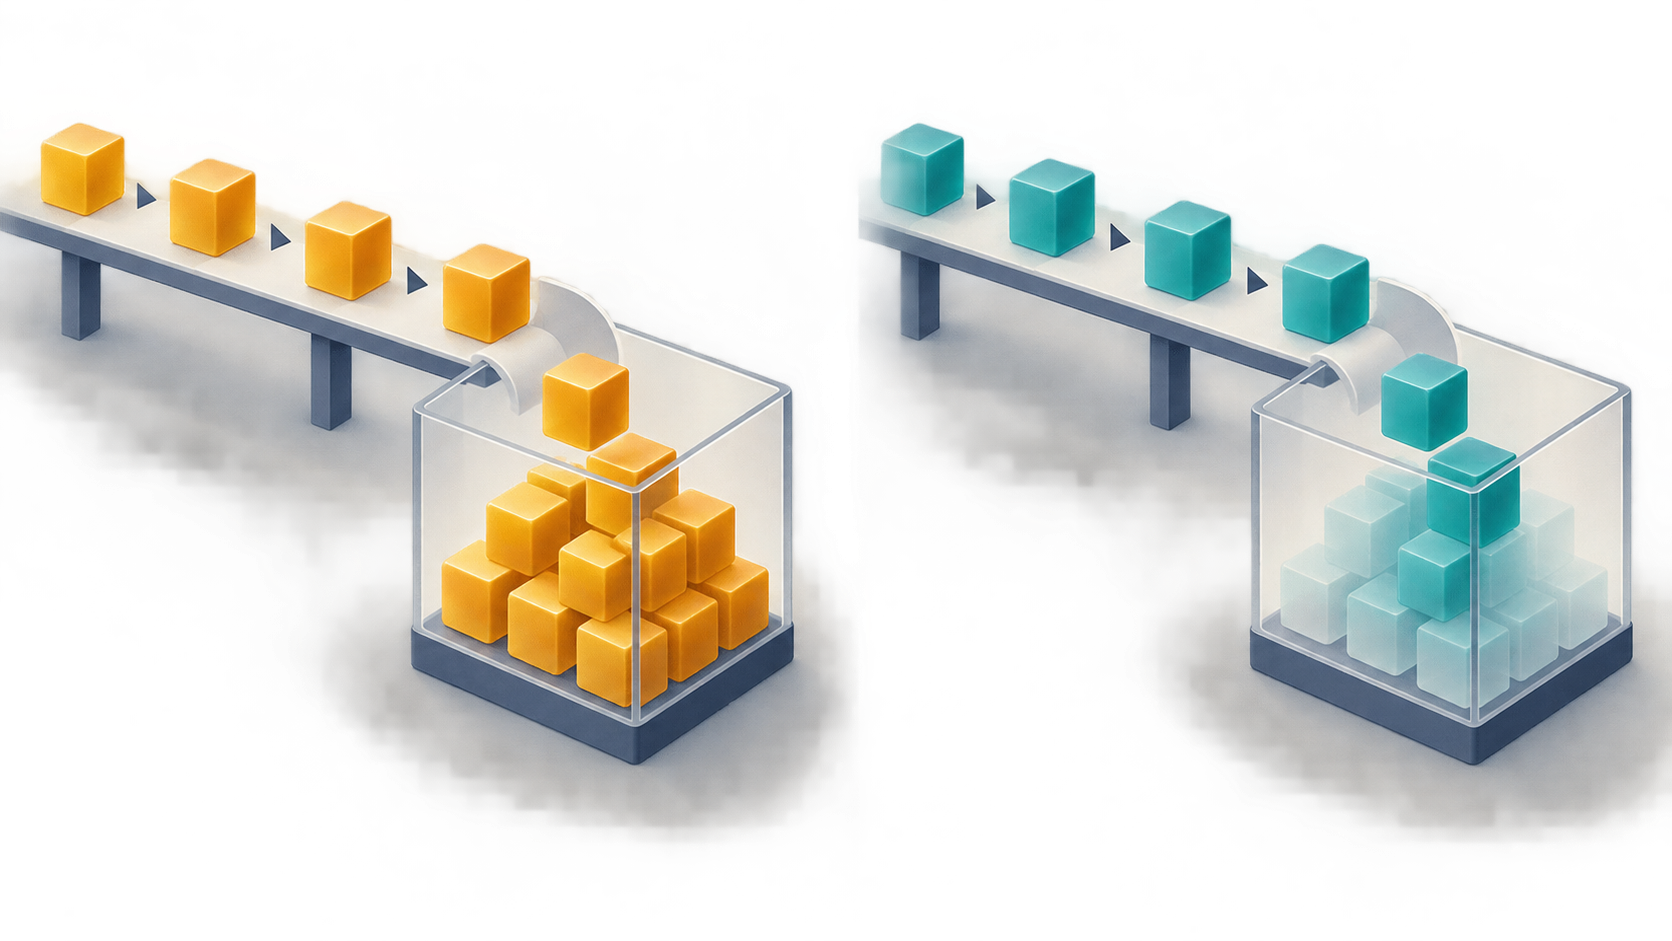
図の左はAdaGradの累積、右はRMSpropで古い情報の寄与が薄れる様子を表しています。箱の中身は考え方を示すもので、実際に過去の勾配を1件ずつ保存する必要はありません。AdaGradは累積和、RMSpropは移動平均を更新して保持すれば計算できます。
RMSpropでは、最近の勾配が小さくなると二乗平均も小さくなり得ます。このため、過去の大きな勾配が分母に残り続ける影響を抑えられます。ただし、勾配がゼロになる、学習率が小さすぎる、モデルやデータに問題があるといった状況まで解決するわけではありません。「AdaGradの累積による過度な縮小を緩和する」と理解するのが適切です。
AdaDeltaとの違い:更新量の履歴も使うか
AdaDeltaも、AdaGradで実効的な学習率が小さくなり続ける問題に対応する手法です。RMSpropと同じく勾配の二乗の指数移動平均を利用し、さらに実際にパラメータを動かした更新量の二乗の指数移動平均も使います。
RMSpropの基本形は、勾配の二乗平均の平方根で現在の勾配を割り、基準の学習率を掛けます。AdaDeltaでは、それに相当するスケール調整に、過去の更新量の二乗平均の平方根も組み込みます。勾配の大きさだけでなく、「これまでどの程度パラメータを動かしてきたか」も反映するのが特徴です。
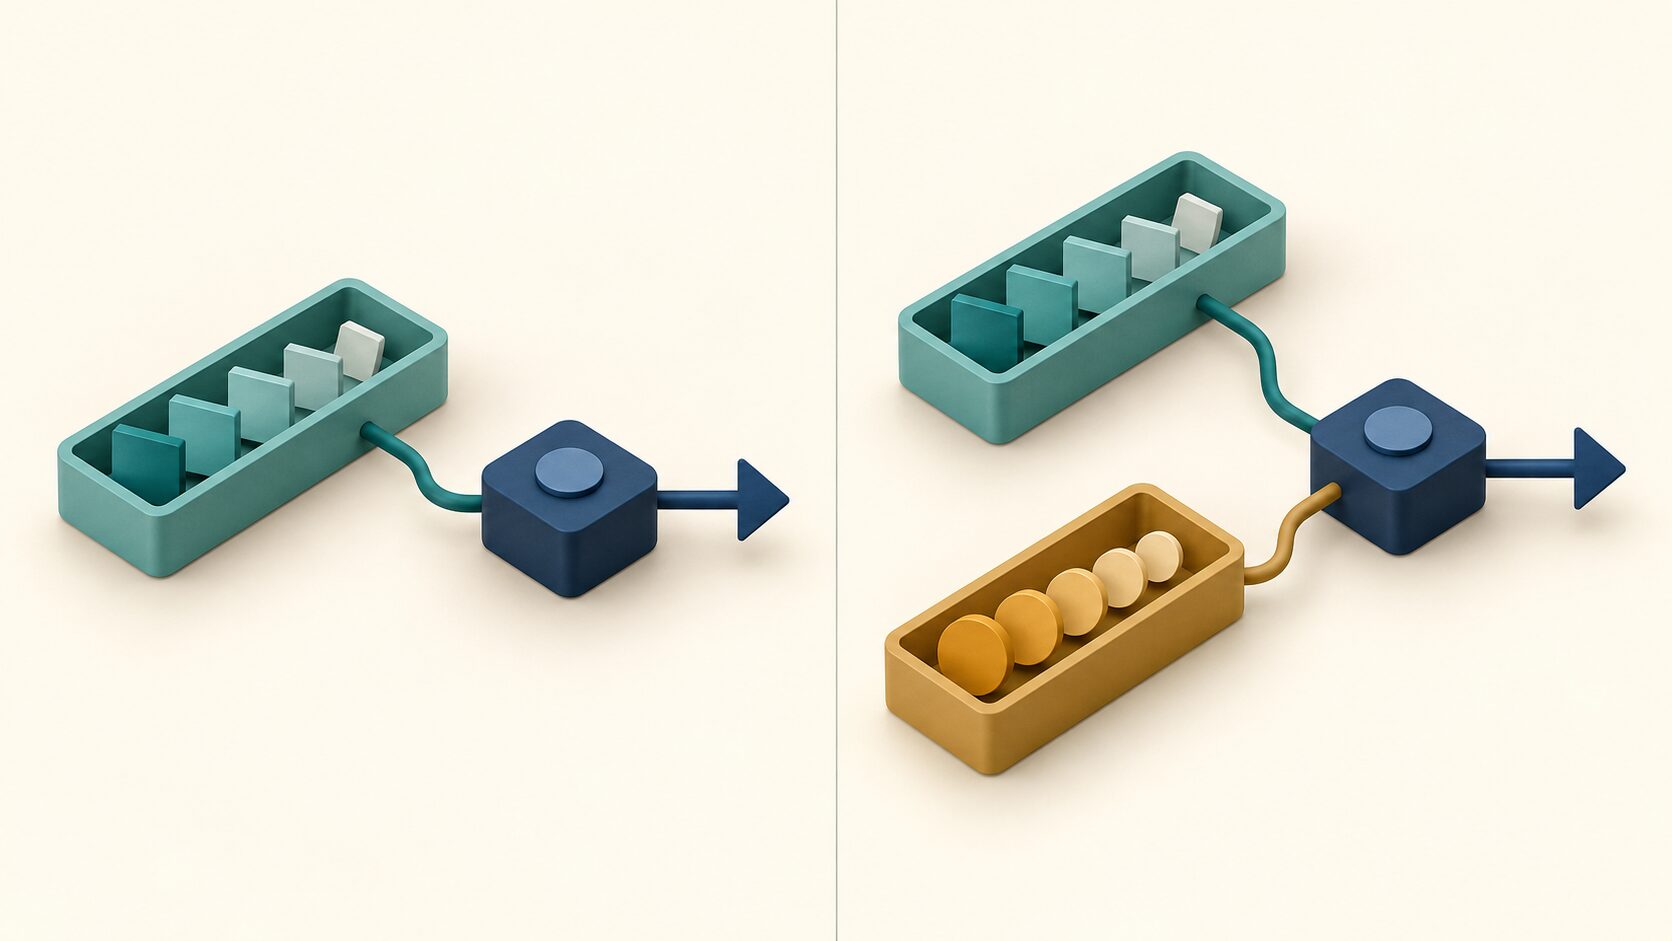
図の左はRMSpropの基本形、右はAdaDeltaが利用する履歴の種類を示しています。両方とも古い履歴の重みを弱めます。「AdaDeltaは過去をすべて同じ重みで使い、RMSpropだけが最近を重視する」という区別ではありません。
AdaDeltaは、元の考え方では大域的な学習率への依存を減らすことを狙っています。ただし、実装によっては全体の更新を調整する学習率の設定項目もあります。「AdaDeltaなら一切設定が不要」とは考えず、利用する実装の更新式と設定項目を確認します。RMSpropの基本形は保持する履歴が少なく、計算の流れを学ぶときに追いやすい点が利点です。
SGD・Momentum・Adamと比較すると何が違う?
最適化手法の違いは、「過去の何を使うか」と「何を調整するか」に分けると捉えやすくなります。RMSpropは主に更新の大きさを調整し、Momentumは過去の勾配を使って更新方向に慣性を持たせる手法です。Adamは、勾配の平均と二乗の平均の両方を利用します。
| 手法 | 利用する情報・仕組み | 特徴と確認したい点 |
|---|---|---|
| SGD | サンプルやミニバッチから求めた現在の勾配 | 基本形は履歴用の状態が少ない。学習率や、その減らし方が学習結果を左右する |
| Momentum付きSGD | 過去の勾配を反映した更新方向 | 一貫した方向に進みやすくする。パラメータごとの二乗平均による調整は行わない |
| AdaGrad | 勾配の二乗の累積和 | まれに更新される特徴の学習に役立つ場合がある。長い学習では更新が小さくなりすぎることがある |
| RMSprop | 勾配の二乗の指数移動平均 | 最近の勾配の規模に合わせて更新を調整。学習率と減衰率の設定が必要 |
| AdaDelta | 勾配の二乗と更新量の二乗の指数移動平均 | 過去の更新の大きさも考慮。学習率の扱いは実装も確認する |
| Adam | 勾配と勾配の二乗の指数移動平均、および初期値による偏りの補正 | 方向と大きさの両方に履歴を利用。RMSpropと同様に学習率などを検証する |
SGDは、データ全体から毎回勾配を計算する代わりに、一部のデータから更新方向を求めます。そのため勾配は変動しますが、変動があることだけで不適切な手法とはいえません。Momentumや学習率スケジュールと組み合わせることもできます。
Adamは「RMSpropとMomentumの考え方を組み合わせたような手法」と説明できますが、単純に2つを足したものではありません。初期値に由来する平均の偏りを補正する点など、更新式に違いがあります。RMSpropにもMomentumを追加したものや、勾配の平均も用いて分散に基づく調整を行うcentered版があります。比較するときは、手法名に加えて有効なオプションを確かめます。
RMSpropの基本形はAdamより保持する履歴が少なくなりますが、それだけで「常に速い」「初心者には必ず扱いやすい」とは決まりません。同じデータ分割や学習回数で比較しつつ、学習率は各手法に合わせて調整することが大切です。全手法に同じ学習率を与えるだけでは、それぞれの性能を十分に引き出せない場合があります。
RMSpropの使いどころ:CNN・RNNなどの学習
RMSpropは、画像認識・自然言語処理・音声認識などで使うニューラルネットワークの学習に適用できます。特に、パラメータによって勾配の規模が大きく異なる場合や、学習中に勾配の大きさが変わる場合に、更新の調整を検討する候補となります。
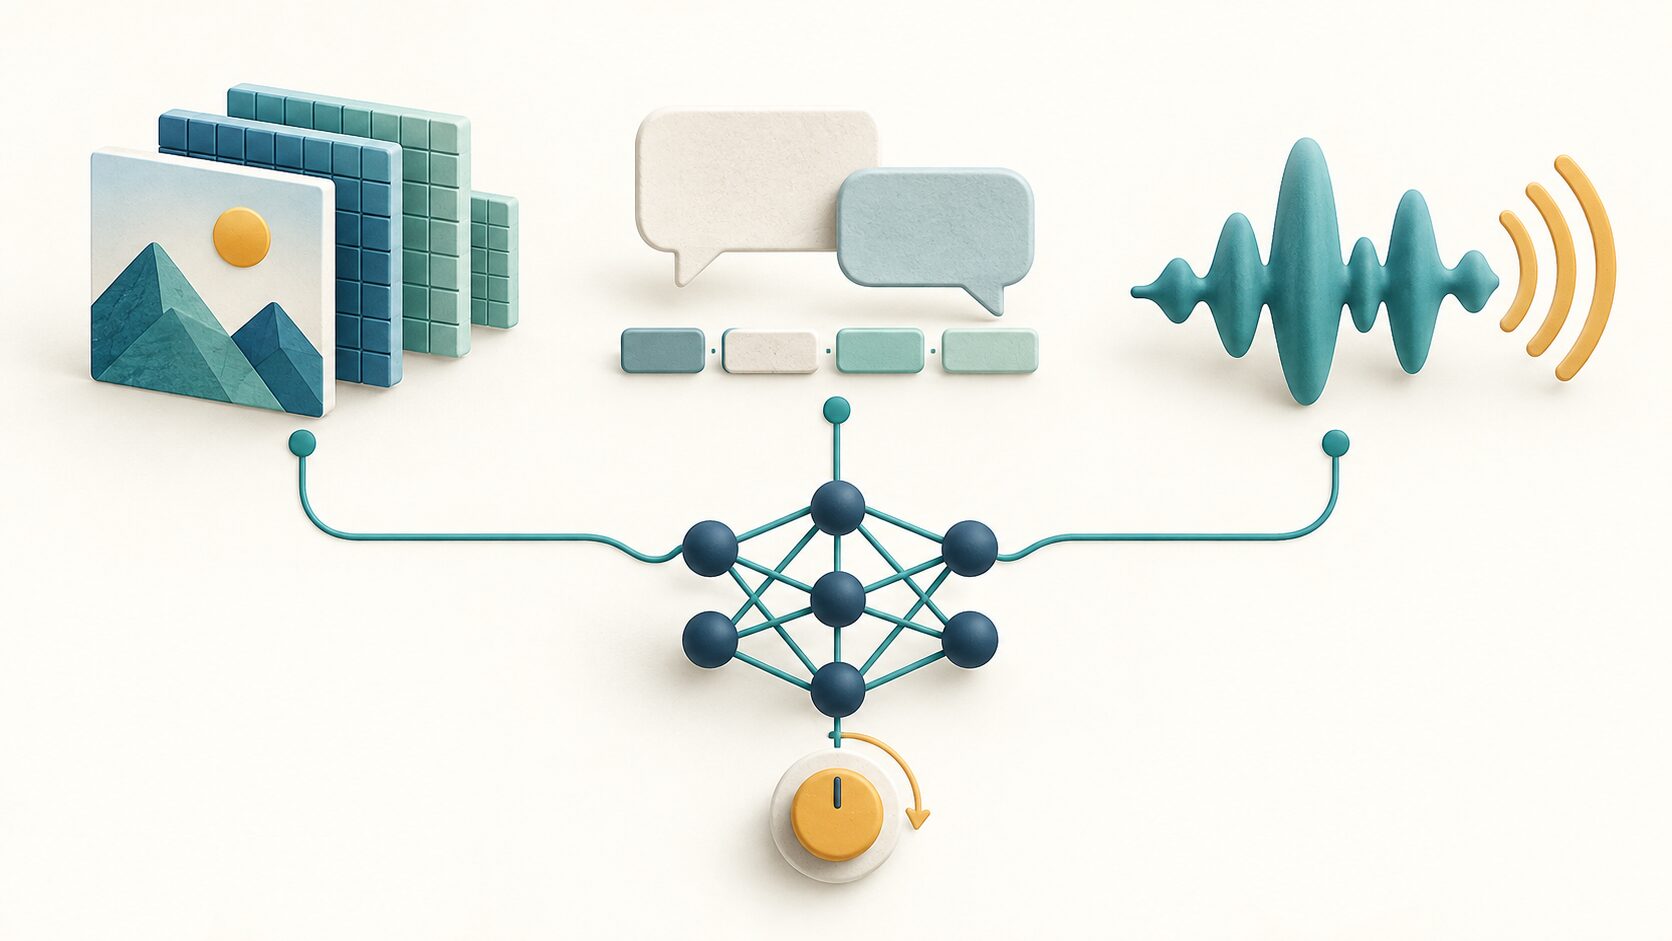
画像認識なら、畳み込みニューラルネットワーク(CNN)のフィルタや分類層を学習させる際に利用できます。たとえば画像を2つの種類に分類する課題では、予測と正解から損失を求め、誤差逆伝播で勾配を計算し、RMSpropで重みを更新します。画像の特徴を捉えるのはCNNの構造と学習された重みであり、RMSpropはその重みの調整を担当します。
文章や音声などの順序を持つデータでは、再帰型ニューラルネットワーク(RNN)などの学習にも適用できます。時刻をまたいで情報を伝えるモデルでは勾配の扱いが難しくなることがあり、勾配の規模に合わせた更新が役立つ場合があります。ただし、長い系列で起こる勾配消失や勾配爆発を、RMSpropだけで解消できるわけではありません。モデル構造や系列の長さ、勾配クリッピングなども併せて検討します。
導入効果は、モデル・データ・設定の組み合わせに依存します。学習用データの損失だけでなく、検証用データの精度や損失、必要な学習時間も見て判断してください。画像認識だから必ずRMSprop、文章だから必ず別の手法というように、入力の種類だけで最適化手法が決まるわけではありません。
学習率・減衰率の設定と注意点
基本形で確認する主な設定は、学習率\(\eta\)、減衰率\(\rho\)、数値計算を安定させる小さな定数\(\epsilon\)です。RMSpropの適応的な調整は、学習率の設定を不要にするものではありません。各項目の役割を分けて確認しましょう。
| 設定・観察項目 | 意味 | 確認のポイント |
|---|---|---|
| 学習率 | 全体の更新の大きさを決める | 大きすぎると損失が激しく変動・発散し、小さすぎると改善が遅くなる |
| 減衰率 | 勾配の履歴をどの程度長く反映するかを決める | 1に近いほど平均は滑らかになる一方、最近の変化への追従が遅くなる |
| 小さな定数 | 分母が小さいときの不安定さを抑える | 値や平方根に対する位置が違うと、小さな勾配での挙動も変わり得る |
| 学習・検証の損失 | 学習の進み方と未知のデータへの対応を確認する | 学習損失だけが下がり検証損失が悪化するなら、過学習への対策も検討する |
最初は、採用した実装の設定値を記録したうえで、学習率を中心に比較すると変化の原因を追いやすくなります。たとえば発散する場合は学習率を下げる実験を行い、改善が遅い場合は少し上げた条件と比較します。ただし、損失が変化しない理由は学習率だけではありません。勾配が正しく計算されているか、対象のパラメータが更新されているか、入力や正解ラベルに問題がないかも確認します。
学習が不安定な場合は、入力値の尺度、バッチサイズ、重みの初期化も見直します。勾配が極端に大きくなるときに使う勾配クリッピングは、勾配の大きさに上限を設ける別の工夫です。RMSpropの二乗平均による調整と目的や計算が異なり、必要に応じて組み合わせます。
計算資源にも違いがあります。RMSpropの基本形では、パラメータごとに二乗平均を1つ保持するため、履歴を持たない基本的なSGDより追加メモリが必要です。Momentumやcentered版を使うと、さらに保持する状態が増えます。大きなモデルでは、精度だけでなくこの負荷も選択材料になります。
最後に、損失が小さくなっても、大域的な最適解に到達したとは限りません。また、学習データに対する損失の改善が、そのまま未知のデータでの精度向上になるとも限りません。最適化手法は学習を支える一要素として捉え、検証用データで結果を確認することが大切です。
まとめ:RMSpropを理解するための3つのポイント
RMSpropは、過去の勾配を利用して、パラメータごとの更新の大きさを調整する手法です。仕組みと使いどころは、次の3点で押さえられます。
- 勾配の二乗の指数移動平均を使うことで、最近の勾配の規模に合わせて更新を調整する。
- AdaGradの累積和、AdaDeltaの更新量の履歴、Adamの勾配平均と偏りの補正との違いを知ると、各手法の役割が理解しやすい。
- 学習率の調整と検証は必要であり、速さ・安定性・精度は実際のモデルとデータで確かめる。
まずは1つのパラメータで二乗平均と更新量を計算し、その後に同じモデルでSGDやAdamと学習の経過を比べると、RMSpropの役割を具体的につかめます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月27日 | 更新式と計算例を追記し、AdaDeltaとの違いや学習率の説明を修正 |