

学習曲線とは?仕組み・読み方と機械学習モデルの評価方法

AIの初心者
「学習曲線」という言葉をよく見かけます。どんなグラフですか?

AI専門家
訓練に使うデータの数を変えながら、モデルの性能がどう変化するかを表すグラフだよ。訓練用と検証用の結果を比べると、学習の状態をつかみやすいんだ。
AIの初心者
データを追加するべきか、モデルを調整するべきかも判断できますか?
AI専門家
検証データでの性能が伸びているか、訓練データとの差が大きいかを見るのが手掛かりになるよ。ただし曲線だけで原因を決めつけず、データの中身や評価方法も確かめよう。
モデルの精度が伸び悩んだとき、データを集めるのか、モデルや特徴量を見直すのかは迷いやすいところです。学習曲線を使うと、訓練データの量に対する性能の変化と、訓練時・未学習データでの差を確認し、次の検討につなげられます。
学習曲線とは
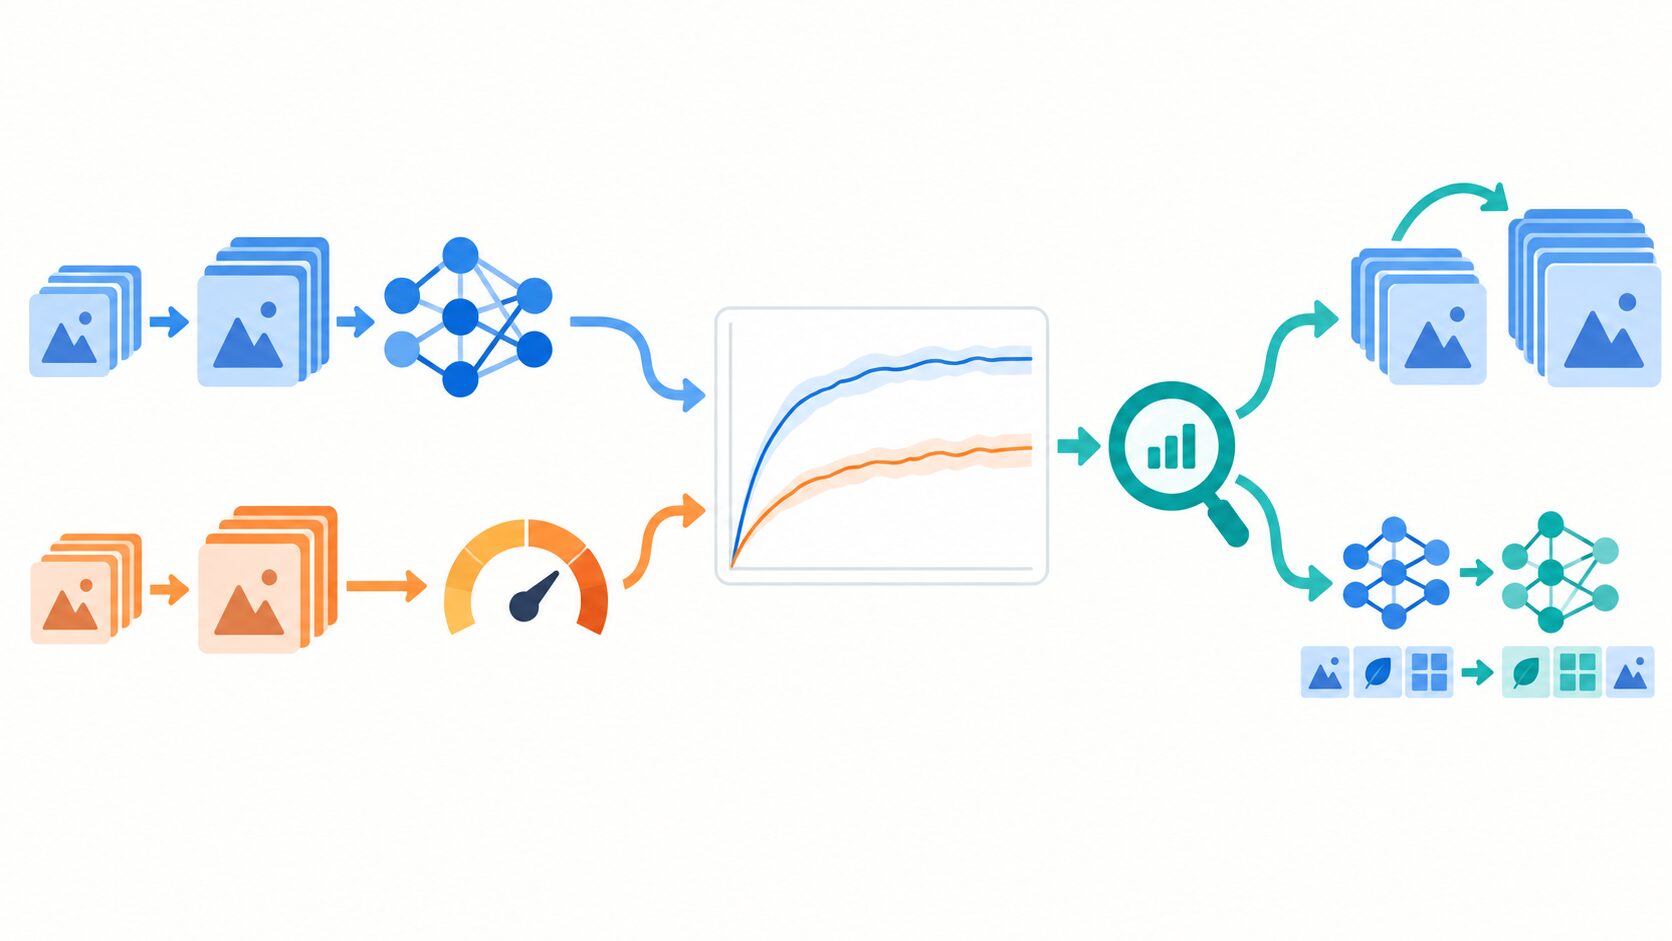
学習曲線は、訓練に使うサンプル数を増やしたとき、モデルの評価指標がどう変わるかを示すグラフです。訓練データで測った性能と、学習には使っていない検証データで測った性能を並べ、モデルが既知の例だけでなく新しい例にも対応できているかを見ます。
縦軸に置く指標は、正解率や適合率のように高いほど良いものだけではありません。誤差や損失(loss)のように低いほど望ましい指標もあります。そのため「曲線が上がったから改善」と一律には言えず、指標の定義と縦軸の向きを確認してから読みます。分類なら正解率やF1値、回帰なら平均絶対誤差など、課題に合う指標を選びます。
「学習曲線」は、epoch(訓練データ全体を何回学習したか)を横軸にしたlossの推移を指すこともあります。本記事で扱うのは、横軸が訓練サンプル数の曲線です。epochごとの学習状況を追う図とは横軸も用途も異なるため、グラフを共有するときは何を変化させた曲線なのか明記すると誤解を防げます。
学習曲線の作り方と軸の見方
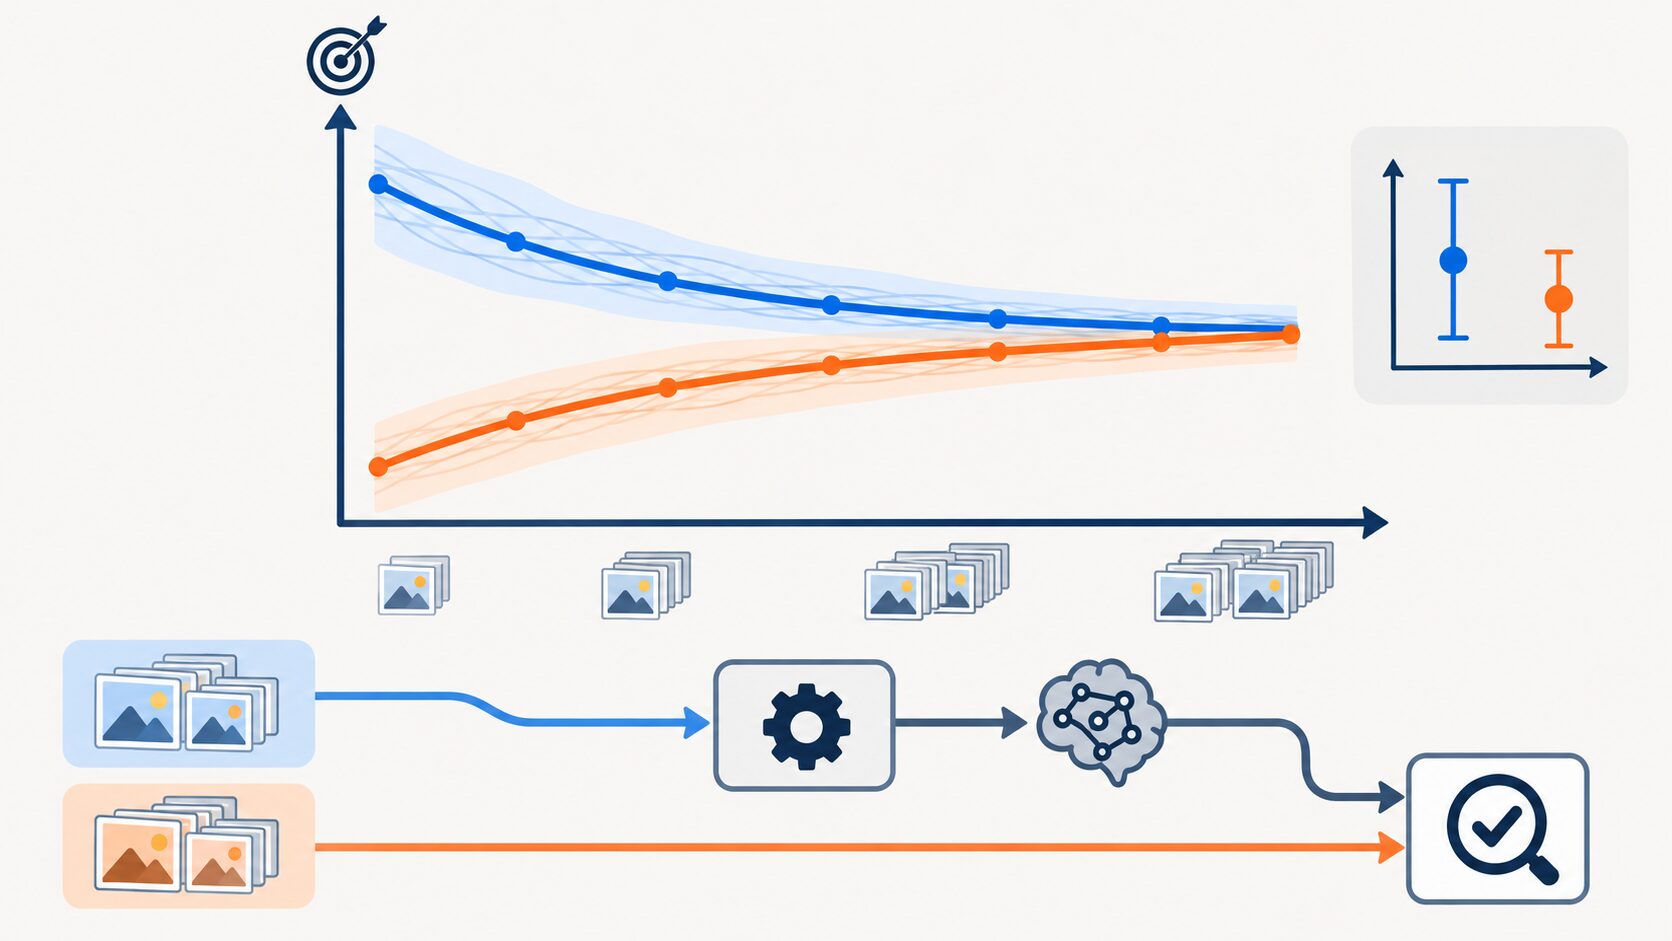
横軸に訓練サンプル数、縦軸に選んだ評価指標を取り、訓練データと検証データそれぞれの値を記録します。例えば、訓練データの一部を使った場合、半分を使った場合、全件を使った場合のように段階を設けます。各段階で同じモデル、前処理、評価指標、学習条件を使うと、データ量による変化を比べやすくなります。
検証データは訓練に混ぜず、各サンプル数で共通の検証用データを評価に使います。訓練に使う部分を変えて複数回測ると、たまたま簡単な例や難しい例が選ばれた影響を把握できます。平均値に加え、分割ごとのばらつきも見ると、少数データで結果が不安定になっていないか判断しやすくなります。
正解率のようなスコア指標では、データを増やすと訓練スコアが少し下がり、検証スコアが上がることがあります。サンプルが少ない間はモデルが訓練例に合わせやすく、例を追加すると課題全体の傾向を学ぶ必要が出るためです。lossを使う場合は、訓練lossが上がり検証lossが下がる、と同じ変化を逆向きに読むことがあります。
曲線の形から学習状態を診断する
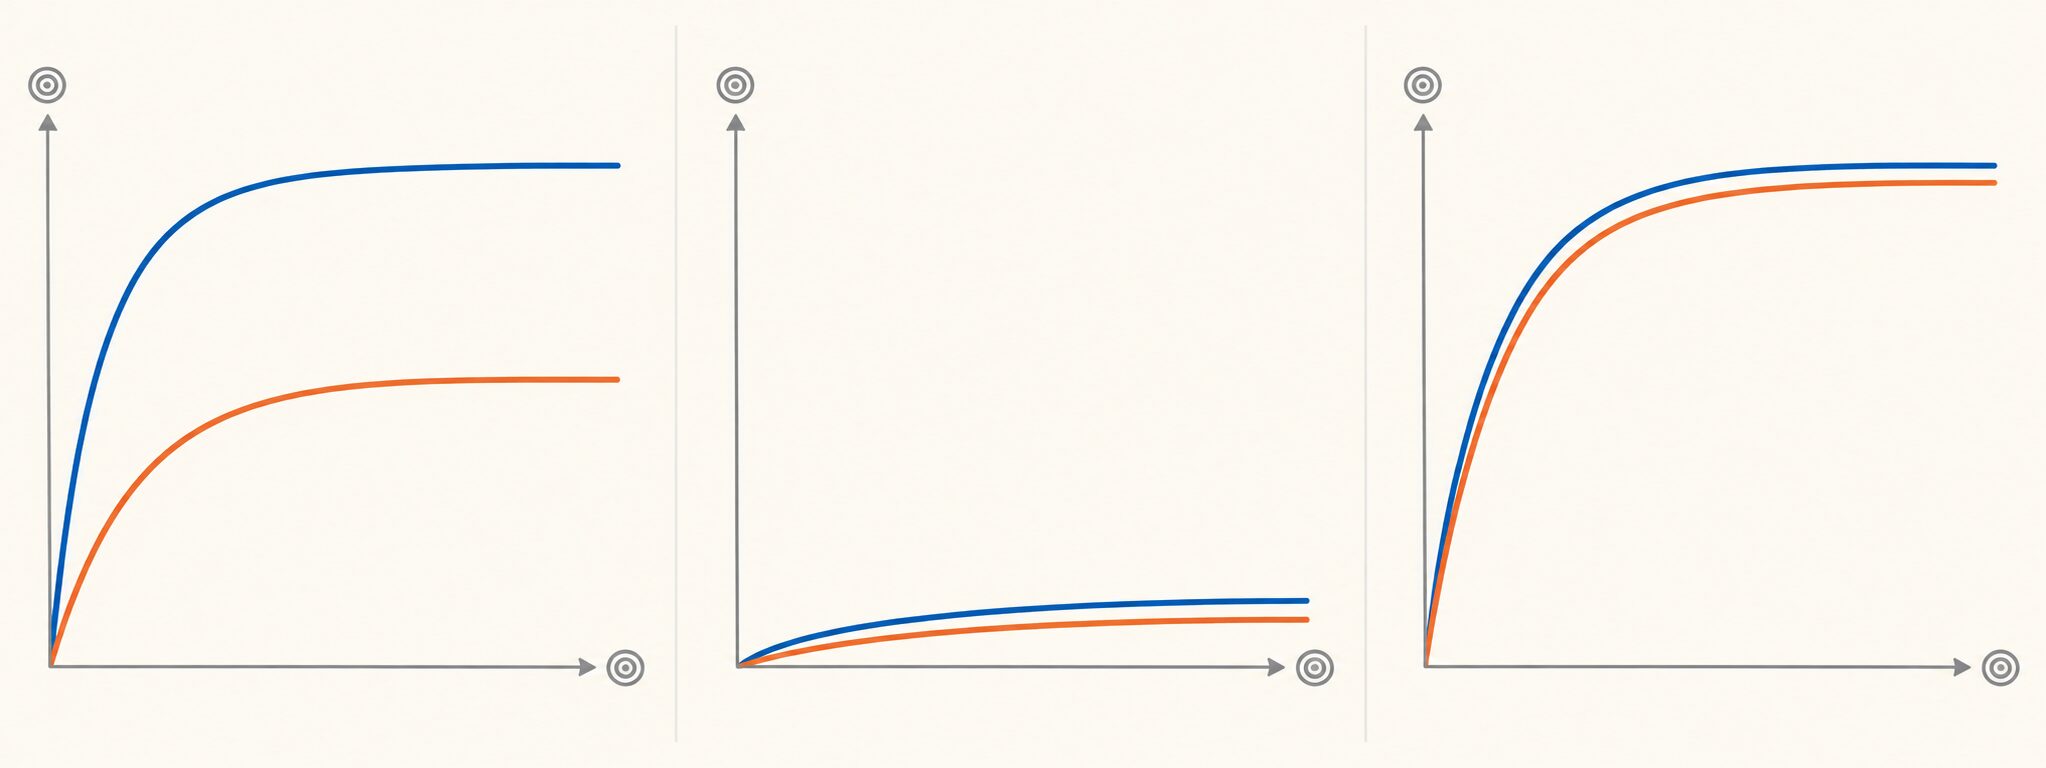
正解率など高いほど良いスコア指標で、訓練スコアが高い一方、検証スコアが低く差が開いているなら、過学習の兆候です。訓練例にはよく合っていても、未知のデータに同じ性能を出せていない可能性があります。訓練サンプルを増やしたときに差が縮まり、検証スコアが上がるかも確かめます。
訓練・検証の両方が低く、差も小さい場合は、モデルがデータの規則性を十分に捉えられていない学習不足(アンダーフィッティング)などが考えられます。ただし、訓練データ自体が少ない、データに誤りがある、指標や前処理が適切でないといった別の理由もありえます。曲線は原因の確定ではなく、次に調べる点を絞るための手掛かりです。
両方のスコアが高く、差が小さい状態は、良好な汎化の目安です。lossなど低いほど良い指標なら、訓練・検証の両方が低く、差も大きくない状態が望まれます。どの状態もデータの難しさや業務上許容できる誤りによって評価が変わるため、単純な高低ではなく、指標の意味と利用目的を合わせて判断します。
| 曲線の状態(スコア指標の場合) | 考えられる状態 | 次に確かめること |
|---|---|---|
| 訓練は高く、検証は低い | 過学習の可能性 | データ追加で差が縮むか、正則化が有効か |
| 訓練・検証ともに低く、差が小さい | 学習不足、データや設定の問題など | 特徴量、ラベル、前処理、モデルの表現力 |
| 訓練・検証ともに高く、差が小さい | 汎化できている目安 | 用途の要件を満たすか、別データでも再現するか |
データを増やす効果を読む
検証性能がサンプル数とともに改善し、まだ安定していないなら、データ追加で伸びる余地があります。例えば迷惑メール分類で、訓練に使うメールを増やすたびに検証データでの再現率が上がり、訓練と検証の差も小さくなっているとします。この場合は、代表的なメールを追加で集めることが有効かもしれません。
一方、検証性能が早い段階から横ばいなら、同じような例を大量に足しても効果は限られる可能性があります。迷惑メールの種類に偏りがないか、ラベル付けが一貫しているか、実際に判定したいメールが訓練データに含まれているかを見直します。特徴量やモデル、前処理を変えることで改善する場合もあります。
曲線が示すのは測定したサンプル数の範囲での傾向です。観測した範囲の先でも同じ割合で性能が伸びる保証はありません。データ収集にかかる費用や時間と、期待できる改善を比べる材料として使い、追加データの品質や代表性も含めて判断します。

診断に応じた改善策を選ぶ
過学習の兆候があれば、正則化を強める、ドロップアウトを使う、モデルを簡素にする、データ拡張を行うといった方法を検討します。追加データも候補ですが、量だけでなく質や対象範囲が重要です。検証性能が改善しているか、同じ評価方法で比較しながら調整します。
訓練・検証の性能がともに低い場合は、まずデータのラベルや欠損、前処理、特徴量が課題に合っているかを確かめます。学習が十分に進んでいないなら最適化設定や学習回数を見直し、モデルの表現力が不足していれば、より複雑なモデルや有効な特徴量を試します。複雑化は過学習を招くこともあるため、検証性能を見て判断します。
比較するときは評価指標と検証方法をそろえます。例えば見逃しを減らす必要がある場面では、正解率だけではなく再現率も確認します。最終的には数値上の改善だけで決めず、誤分類のコスト、応答時間、運用条件など用途の要件を満たすかを選択基準にします。
学習曲線を使うときの注意点
訓練・検証・テストデータの役割を分けます。前処理で使う平均値や語彙などは訓練データだけから求め、検証・テストの情報が訓練に混ざらないようにします。分割前に全データで前処理を学習すると、評価対象の情報が訓練側へ漏れる「データリーク」が起き、実際より良い性能に見えるおそれがあります。
モデルや設定を選ぶ間は検証データを使い、最終評価用のテストデータは調整に繰り返し使わず、最後まで取っておきます。検証結果を何度も見て細かく調整すると、その検証データに過剰適合することがあるためです。データが限られる場合は交差検証を利用し、分割ごとの性能のばらつきも確認します。
クラスの割合に偏りがある課題では、分割後も各クラスの比率を保つ方法を検討し、正解率だけでなく適合率・再現率・F1値などを使い分けます。また、学習曲線が安定していても、本番環境のデータ分布が異なれば性能は変わります。定期的に運用データを確かめ、必要に応じて評価し直しましょう。
サンプル数を横軸にする図は、epochごとのloss曲線や、ハイパーパラメータごとの検証性能を比べる図とも目的が異なります。横軸が何を表し、どのデータで値を測ったのかを明記すれば、曲線を正しく読み、改善案を比較しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月17日 | 指標の向きや曲線の診断例を見直し、データ追加とモデル調整の判断材料を追記 |