

画像説明文の自動生成とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「画像説明文の自動生成」って、写真に何が写っているかを文章にすることですよね。物の名前が分かれば、説明できるのではないですか?

AI専門家
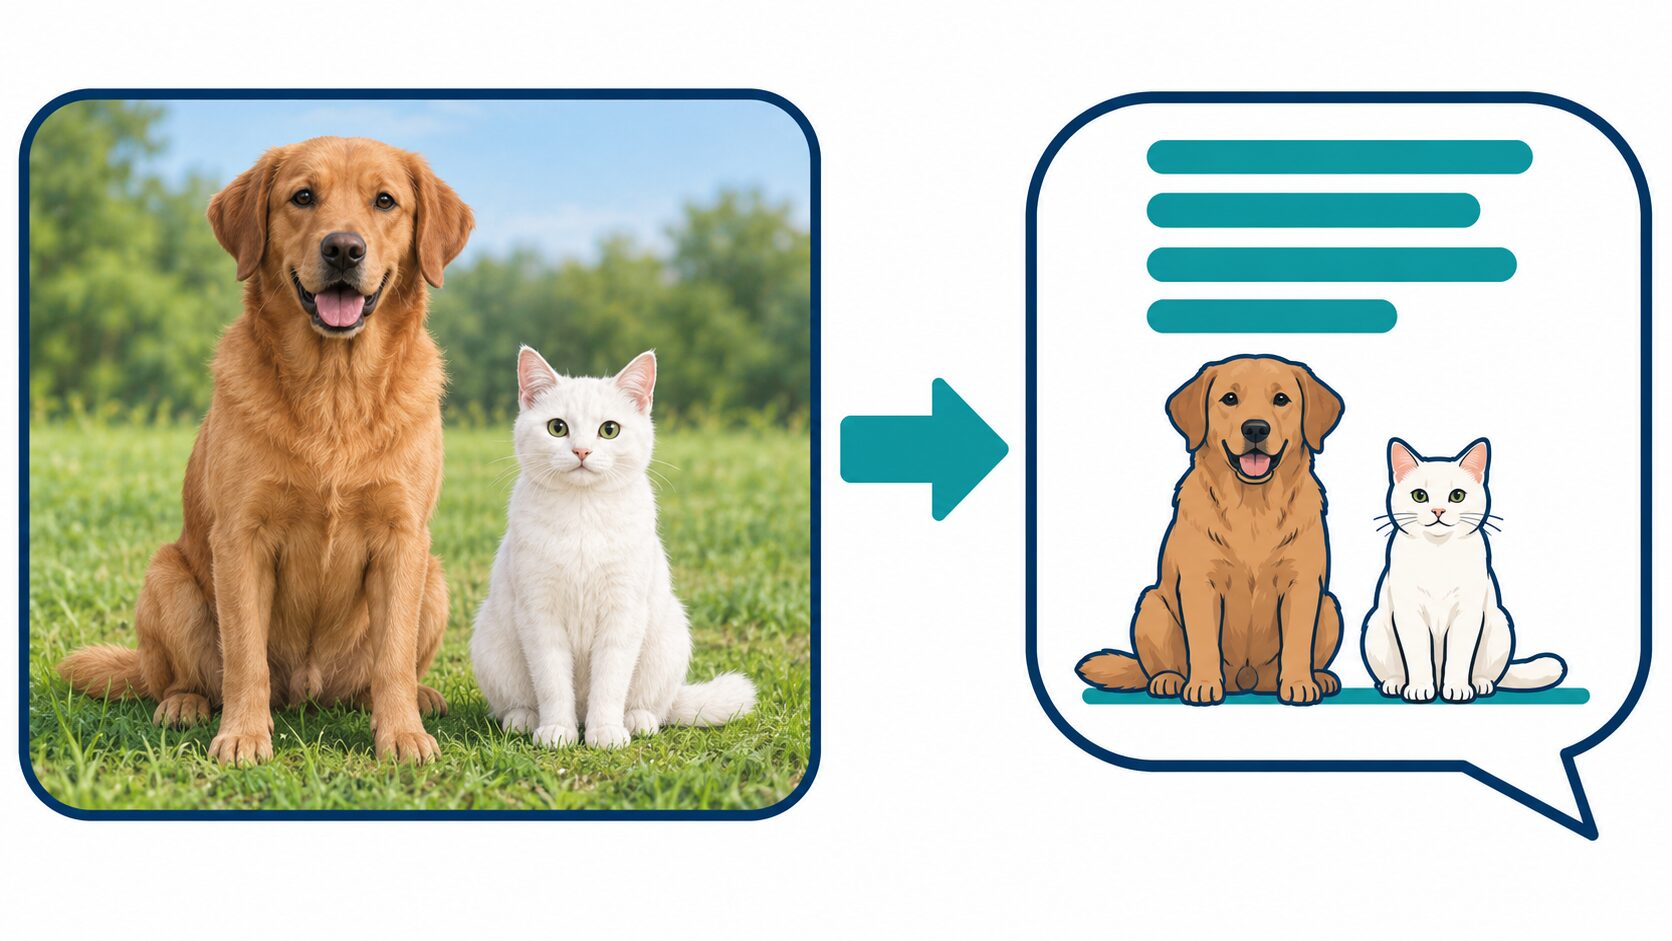
物の名前は大事だけれど、それだけでは場面を伝えきれないんだ。犬と猫の写真でも、「並んで座っている」のか「追いかけ合っている」のかで説明が変わるよね。何が写っているかに加えて、動作や位置関係を捉え、文章にまとめる必要があるんだよ。
AIの初心者
写真の中の関係まで捉えるんですね。そのために、畳み込みニューラルネットワークと再帰型ニューラルネットワークを組み合わせるのですか?
AI専門家
それは代表的な構成の一つだよ。畳み込みニューラルネットワークが画像の特徴を取り出し、再帰型ニューラルネットワークがその情報をもとに言葉をつないでいくんだ。ほかの構成もあるけれど、「画像の情報を取り出す役割」と「文章を作る役割」に分けて考えると、仕組みをつかみやすいよ。
画像説明文の自動生成とは、画像に写る物体やその特徴、動作、位置関係などを読み取り、自然な言葉で説明する技術です。「画像キャプション生成」とも呼ばれ、画像認識と自然言語処理を組み合わせて実現します。
写真の内容を音声で伝えたり、大量の画像を文章で検索できるようにしたりする用途があります。ただし、読みやすい文章が出力されても、画像の内容を正しく説明しているとは限りません。ここでは、画像から文章を作る流れ、学習方法、関連技術との違い、利用時の確認点を順に見ていきます。
画像説明文の自動生成とは
画像キャプション生成が目指すのは、画像の内容を、読者が場面を思い浮かべられる文章にすることです。たとえば「犬と猫」という出力は、写っている対象の名前を示しています。一方、「犬と猫が窓辺に並んで座っている」という説明には、場所や姿勢、対象同士の関係も含まれています。この違いが、物体名の列挙と場面の説明の違いです。
説明に使う情報は、大きく四つに分けられます。「犬」「ケーキ」などの対象、「茶色い」「丸い」などの属性、「走る」「座る」などの動作、そして「机の上」「人の隣」などの関係です。すべてを長く書く必要はなく、画像の中心となる内容と、用途に必要な情報を選んで文章にします。
たとえば、ケーキの上でろうそくが光っている写真なら、「ろうそくが灯ったケーキ」と説明できます。いちごやチョコレートがはっきり確認できれば、その特徴を加えることもできます。しかし、「誕生日を祝うためのケーキ」という用途は、写真だけでは確定できない場合があります。記念日や撮影用の飾りである可能性もあるためです。
画像から確認できる内容と、そこから推測した事情を分けることが、正確な説明文を作る基本です。同じように、人物が笑っている様子は説明できても、「プレゼントをもらって喜んでいる」とまで書くには、写真以外の情報が必要になることがあります。詳しい文章ほど優れているのではなく、根拠のある情報を適切な長さで伝えられることが大切です。
画像の特徴を文章に変える仕組み
画像から説明文を作る流れは、「画像を入力する」「画像の特徴を数値で表す」「その情報を参照して文章を生成する」という三段階で捉えられます。画像の情報を扱いやすい表現に変える部分をエンコーダ、その情報から文章を出力する部分をデコーダと呼びます。
- 画像を入力する:写真を、モデルが処理できる大きさや数値の形式に整えます。
- 視覚的な特徴を取り出す:形、色、模様、配置などに関わる情報を、数値のまとまりとして表します。
- 文章を生成する:画像の情報と、それまでに出力した言葉を手掛かりに、続く言葉を順番に選びます。
この数値表現は、必ずしも「犬」「猫」という名前の一覧ではありません。画像のさまざまな手掛かりを文章生成に利用するための内部表現です。説明文を作る前に、必ずすべての物体の名前と位置を一覧化するわけではない点に注意しましょう。
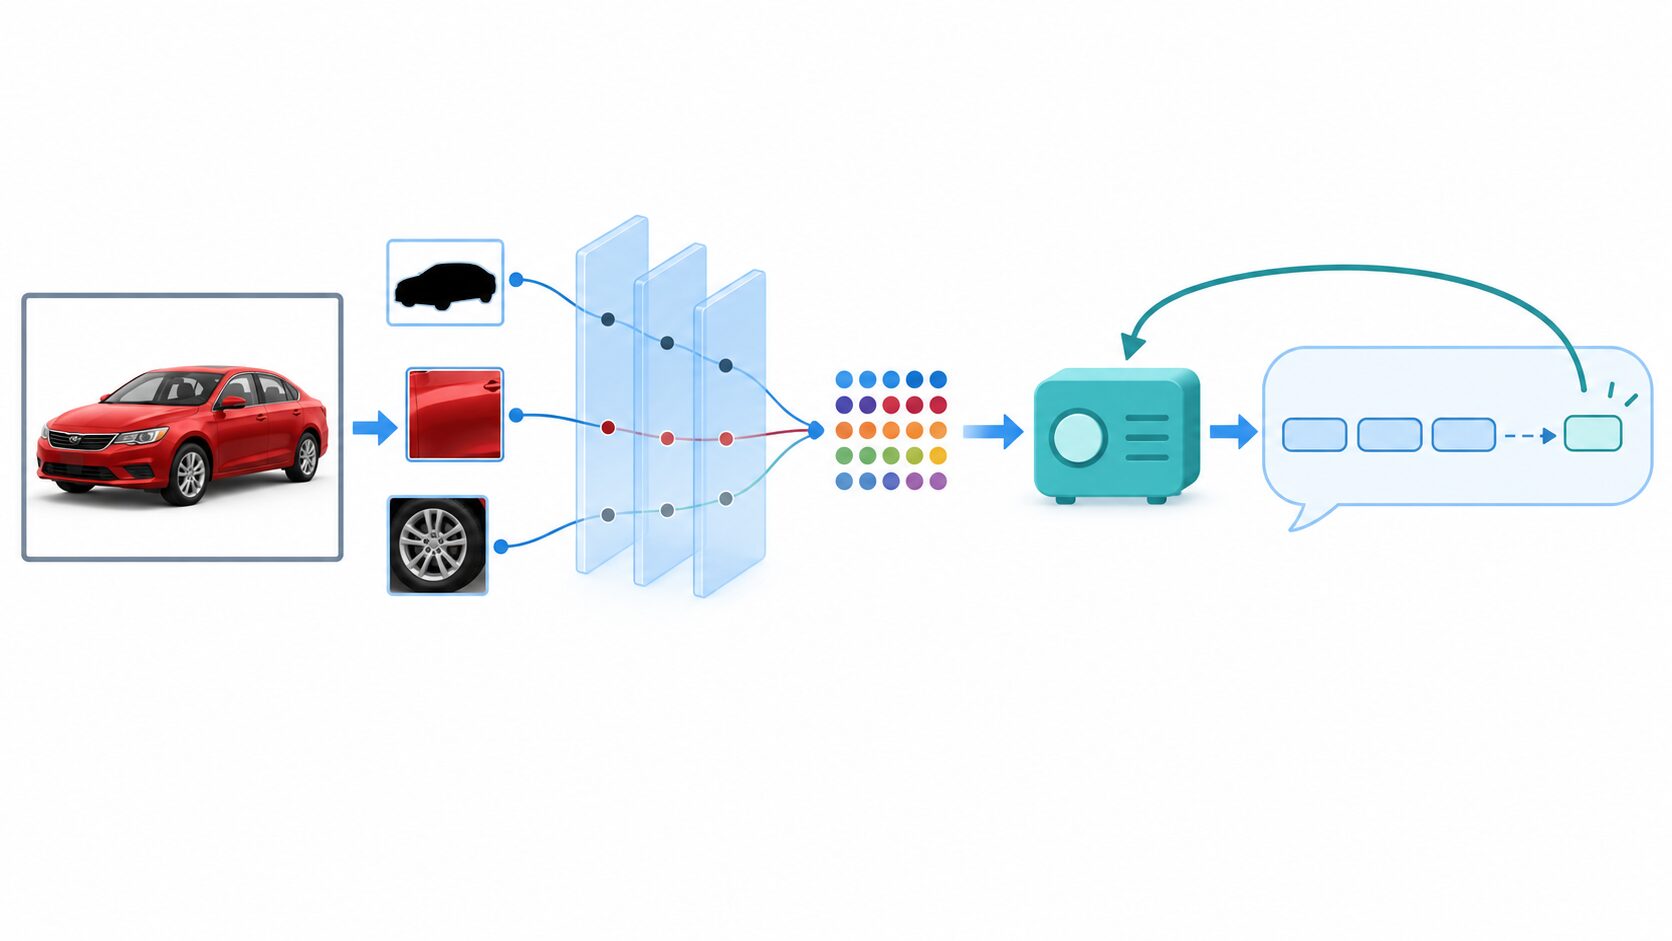
元記事で紹介しているCNNとRNNを組み合わせる方式は、この役割分担を理解するための代表的な構成です。CNNは「畳み込みニューラルネットワーク」の略で、画像の局所的な模様などを捉え、層を重ねながら文章生成に役立つ視覚的特徴を取り出します。RNNは「再帰型ニューラルネットワーク」の略で、それまでの情報を内部の状態に引き継ぎながら、言葉の並びを扱います。
この構成では、CNNが取り出した画像情報を手掛かりに、RNNが説明文を作ります。たとえば、「犬が」に続いて「芝生の上を」、さらに「走っている」と言葉をつなぐような流れです。実際の処理では、単語やその一部などに分けた「トークン」という単位を使う場合があります。
画像の特徴をRNNの初期状態に渡すのは、その具体的な実装方法の一つです。すべての画像キャプション生成がこの方法を使うわけではありません。文章を作る途中でも画像情報を参照する構成があり、どのように画像と文章を結び付けるかは設計によって異なります。
Attention(注意機構)を使う構成では、生成する言葉に応じて、画像内の各領域から得た特徴を重み付けして参照できます。また、Transformerや、画像と言葉を扱う視覚言語モデルを用いる構成もあります。これらも含め、画像キャプション生成は一つの固定されたモデル名ではなく、画像から説明文を作る課題を指します。自然な説明ができることと、人間と同じように場面を理解していることは区別して考える必要があります。
画像と説明文の組で学習する方法
画像キャプション生成の基本となるのは、画像と、その内容を表す説明文のペアから、視覚情報と言葉の対応を学ぶことです。たとえば、赤い車の写真と「赤い車が道路に止まっている」という文を組にして学習させます。さまざまな写真に触れることで、車の形や赤い色、道路との位置関係などの情報を、対応する言葉と結び付けていきます。
ただし、一枚の写真に対する適切な説明は一つとは限りません。「道路に赤い車がある」も、写真の内容に合っていれば妥当です。車種や周囲の建物まで述べる文と、主な対象だけを述べる短い文の両方が使える場合もあります。学習データでは、同じ画像に複数の説明文を用意して、こうした表現の幅を扱うことがあります。
学習でよく使われる尺度の一つが、交差エントロピー損失です。これは、完成した二つの文章について、文字列の違いを直接数えるものではありません。画像と、それまでの参照文の言葉を手掛かりにしたとき、次に来る参照文の言葉へ、モデルが高い確率を与えられているかを測るために使います。ここでいう参照文は、学習の見本として用意した説明文です。
赤い車の例なら、色を表す位置で「赤い」を、対象を表す位置で「車」を出力しやすくなるように、モデルの内部の数値を調整します。見本の言葉に低い確率しか与えられなければ損失が大きくなり、その損失を小さくする方向に学習を進めます。この積み重ねによって、画像に合う言葉を選ぶ能力を高めます。
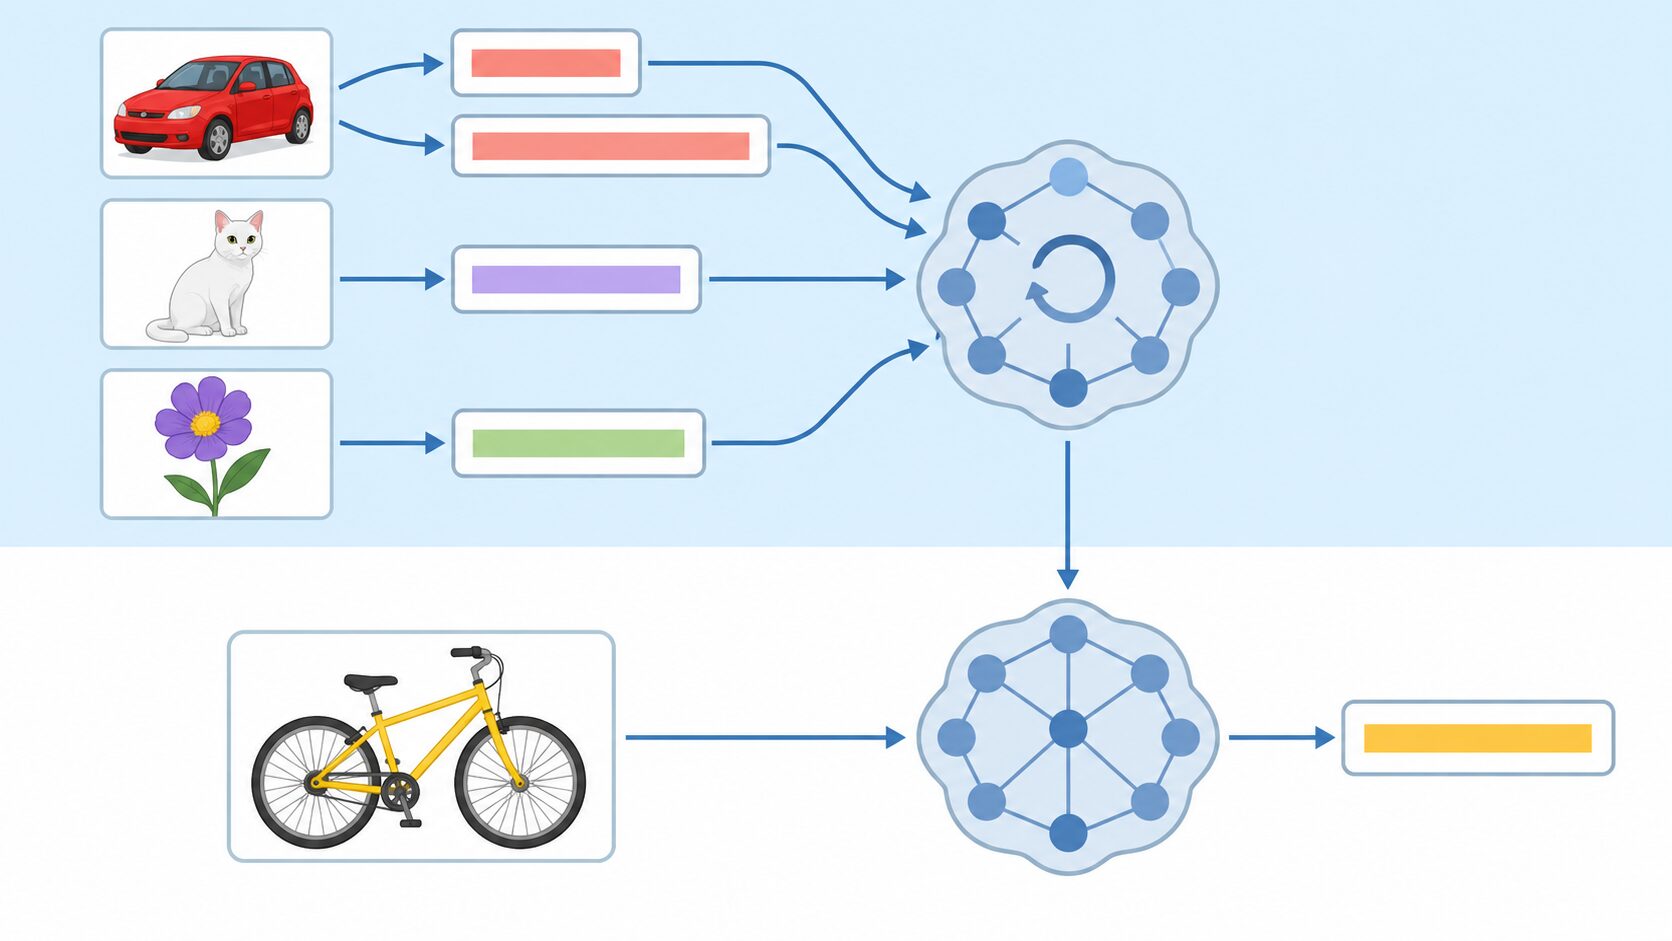
学習時には見本の説明文を使いますが、利用時には、新しい画像に対する説明文をモデル自身が作ります。学習データに含まれる写真を説明できたとしても、見慣れない物体や撮影条件の異なる画像を正しく説明できるとは限りません。性能を確認するときには、学習に使っていない画像も用意することが大切です。
画像を処理する部分と文章を作る部分を共同で調整する方法もあれば、事前学習済みの部分を固定し、一部だけを調整する方法もあります。どちらの場合も、画像と説明文の対応が正確であること、特定の対象に偏りすぎていないこと、実際の利用場面に近いデータがあることが結果に影響します。一般の風景写真でうまく説明できても、工場の部品や専門的な検査画像にそのまま対応できるとは限りません。
画像認識・OCR・代替テキストとの違い
画像を扱うAIには、目的の異なる複数の技術があります。画像認識は広い呼び方で、画像分類や物体検出などを含みます。何を入力するかだけでなく、何を出力し、何に使うのかに注目すると、画像キャプション生成との違いをつかめます。
| 技術・概念 | 主な出力や役割 | 出力例・使い方 |
|---|---|---|
| 画像分類 | 画像を種類やカテゴリに分ける | 写真に「犬」「料理」などの分類を付ける |
| 物体検出 | 画像内の対象の種類と位置を求める | 人物や車を検出し、その位置を枠などで示す |
| OCR(光学文字認識) | 画像内に写る文字を読み取り、文字データにする | 看板に書かれた「入口」を取り出す |
| 画像キャプション生成 | 対象や動作、関係を文章で説明する | 「看板の前に人が立っている」と場面を説明する |
| 代替テキスト | 画像の内容や役割を、その利用文脈に応じて言葉で伝える | Webページの画像について、周囲の文章や操作目的に合う説明を設定する |
看板のある街角の写真を例にすると、OCRは看板の文字を読む処理、画像キャプション生成は「道路沿いの看板の前に人が立っている」といった場面を説明する処理です。看板の文字を正確に転記できることと、人や道路の関係を説明できることは別の能力です。目的によっては、OCRで読み取った文字を説明文に組み込むなど、複数の機能を組み合わせます。
代替テキストは、画像キャプション生成の別名ではありません。画像を使う場所で、その画像が何を伝え、どのような役割を持つかを表すためのテキストです。たとえば、商品写真なら購入検討に必要な見た目を、リンクとして使う画像なら移動先や操作の目的を伝えることが重要になります。同じ画像でも、ページの文脈によって適切な説明は変わります。
そのため、AIの生成文を代替テキストの下書きとして使う場合は、周囲に同じ説明がすでにないか、画像の重要な情報を省いていないかを確認して編集します。見える要素をすべて書き並べると、かえって必要な情報をつかみにくくなる場合があります。
関連する課題に、画像についての質問に答える「視覚的質問応答」があります。「車は何色ですか」という質問に「赤です」と答えるように、求められた情報へ回答する点が、場面全体の説明文を作る課題との違いです。一方、「画像生成」は、文章などを手掛かりに画像を作る技術です。画像から文章を作る画像キャプション生成とは、入力と出力の方向が異なります。
視覚情報の支援・画像検索などの活用例
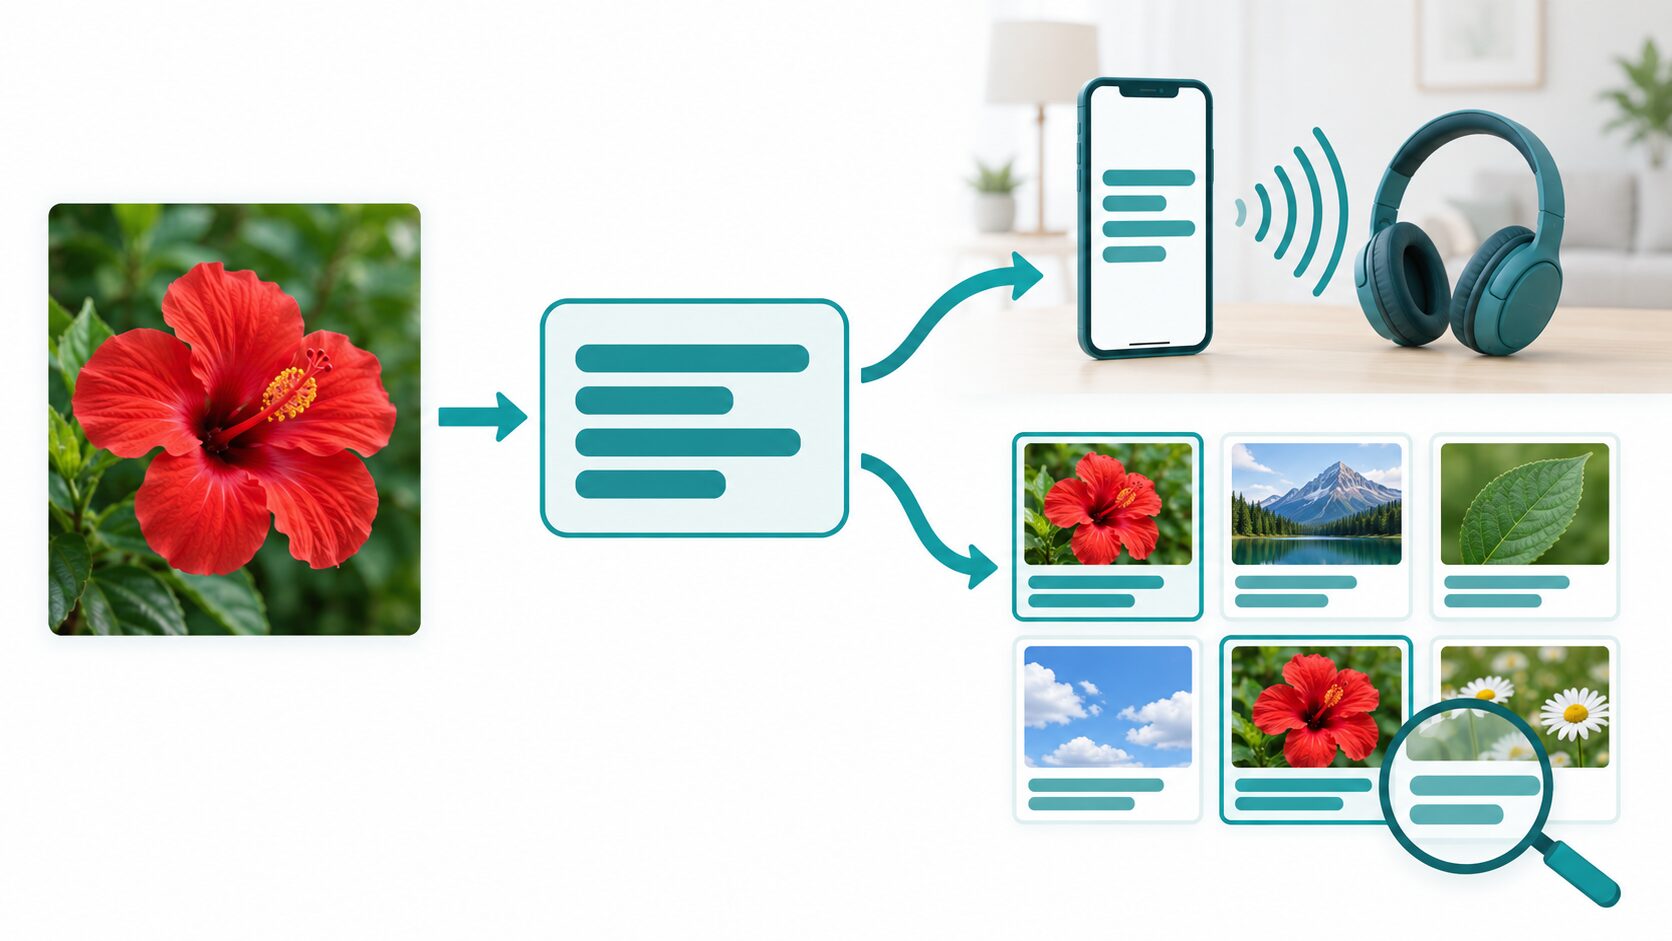
生成した説明文は、そのまま読んでもらうだけでなく、音声読み上げや検索の仕組みと組み合わせて使えます。人が一枚ずつ内容を確認して記述する手間を減らせますが、用途によって必要な詳しさや、誤りを確認する観点は変わります。
| 用途 | 使い方 | 確認する点 |
|---|---|---|
| 視覚情報の利用支援 | 写真の説明文を音声で読み上げ、写っている内容の把握を補助する | 重要な対象の見落としや誤説明がないか。歩行の安全を一般的な説明文だけで判断しない |
| 写真の整理・検索 | 説明文やキーワードを検索対象として保存する | 探したい対象が記述されているか。検索結果が実際の写真と一致するか |
| Web・SNSの文章作成 | 画像の説明文、代替テキスト、投稿文の下書きを作る | 掲載目的と文脈に合うか。事実にない情報や不要な個人情報が含まれないか |
| 医療画像の所見文生成 | 研究や専門的な環境で、画像に関する記述の作成を支援する | 対象に応じた専門的評価と医療者による確認があるか |
視覚障害のある人への情報提供では、写真の内容を文章に変え、読み上げ機能へ渡す使い方が考えられます。共有された写真の話題を把握したり、身の回りの物の様子を確認したりする補助になります。ただし、一枚の写真の説明では、撮影範囲の外や、その後に変わった状況は分かりません。一般的な画像キャプションだけを根拠に、道路の横断や障害物の回避を判断することはできません。
写真検索では、画像に付いた説明文を検索できるようにすると、「赤い花」や「芝生の上の犬」といった言葉で候補を探せます。ファイル名が撮影日時や連番だけでも、内容を手掛かりに見つけやすくなります。一方、花の写真に「庭」としか説明が付いていなければ、「赤い花」という検索では見つからない可能性があります。画像にない対象を記述した場合は、無関係な写真が検索結果に混ざります。
WebやSNSでは、生成文を出発点に、人が伝えたい内容へ整える使い方が実用的です。商品写真なら見た目の特徴を説明し、投稿文なら撮影者が確認した場所や出来事を必要に応じて加えます。AIが写真だけから作った文章には、撮影者の意図や記事の目的まで反映されているとは限らないため、掲載前の編集が必要です。
医療画像から所見文を作る取り組みもありますが、これは研究・専門用途として捉える必要があります。一般写真を説明するモデルの文章を、そのまま診断に流用するものではありません。専門分野のデータや評価が必要であり、医療者が画像と記述を照合することを前提に、文書作成を補助する位置付けになります。
誤説明を防ぐ確認点と今後の展開
画像説明文を利用するときは、文章の流暢さと、画像の事実に忠実であることを別々に確認する必要があります。言葉のつながりが自然でも、対象の数や色、人物の動作を取り違えることがあります。特に、複数の人物が重なっている写真、小さな対象が写る写真、物の一部が隠れている写真では、説明すべき情報を見誤りやすくなります。
誤りには、画像にない情報を付け加える場合と、画像にある重要な情報を落とす場合があります。前者はハルシネーションと呼ばれ、たとえば食卓に写っていないワイングラスを説明に含めるような誤りです。後者は見落としで、人物が手に持っている物を説明しないといったものです。どちらも確認が必要ですが、修正の仕方は異なります。ない情報は削り、必要なのに欠けている情報は補います。
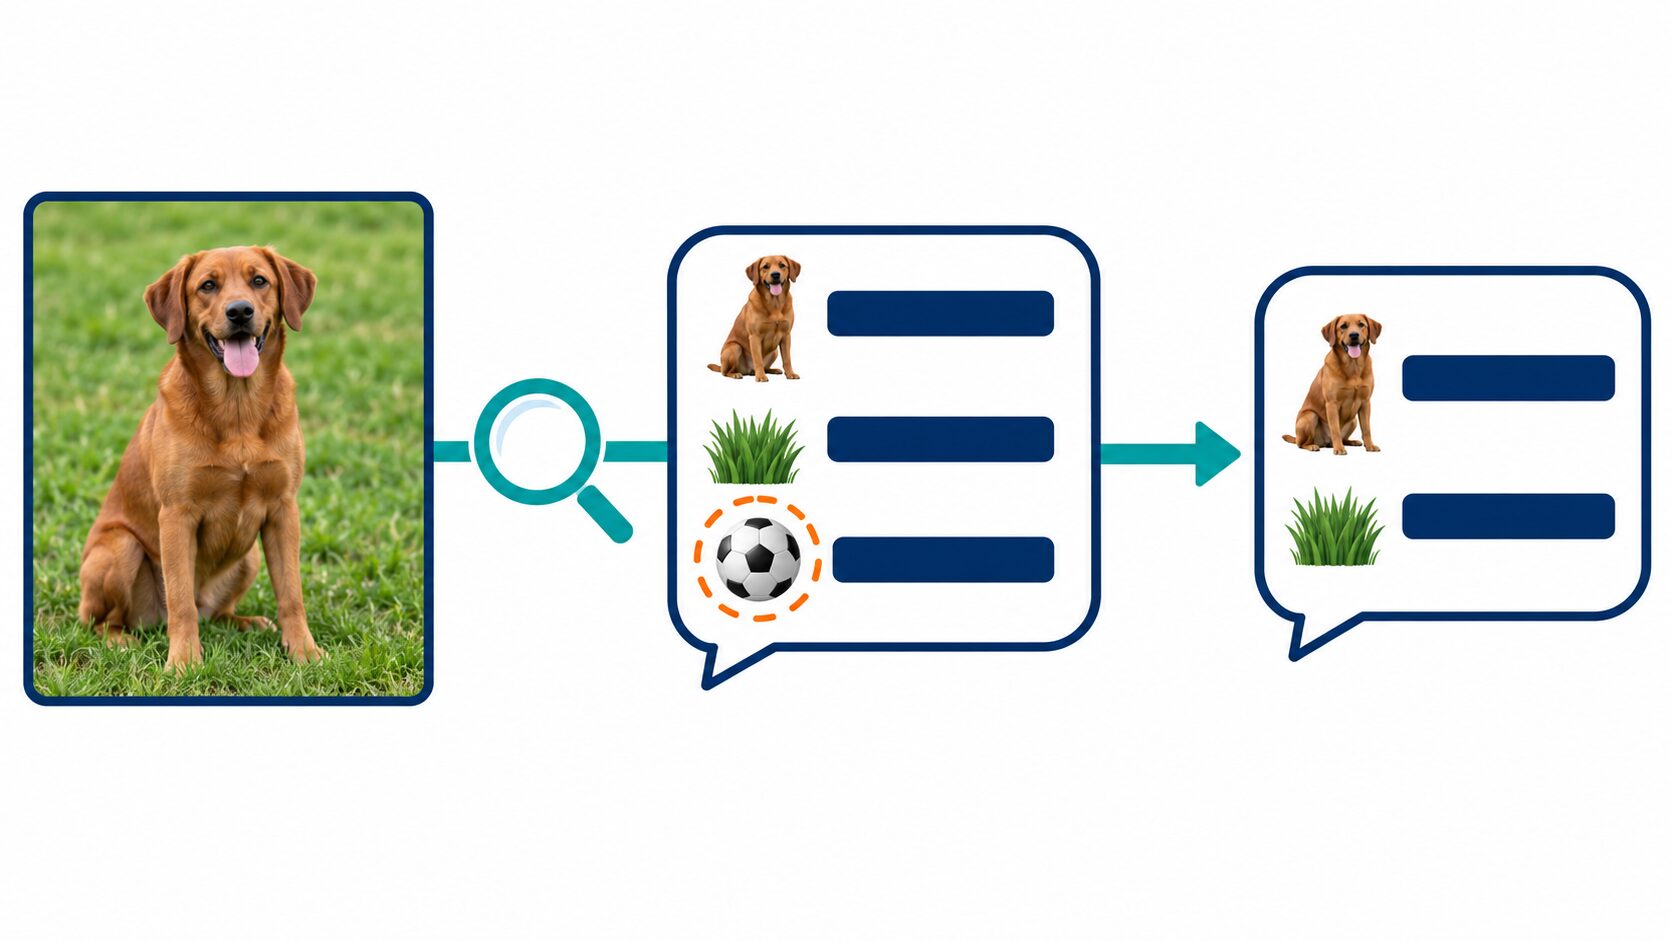
確認するときは、印象だけで文章全体を評価するより、次の観点に分けると誤りを見つけやすくなります。
- 対象:書かれている人や物は実際に写っているか。別の対象と取り違えていないか。
- 属性:色、形、数は確認できるか。ぼやけている部分や隠れた部分まで断定していないか。
- 動作・関係:誰が何をしているか、何の上や隣にあるかが画像と一致するか。
- 情報の欠落:説明の目的に必要な対象や特徴を省いていないか。
- 推測:用途、感情、意図など、画像だけでは確かめられない事情を書き足していないか。
たとえば、隠れていて個数が数えられない対象は、数を断定しない表現に変えます。確信の持てない記述は、推測の言葉を足すだけで残すのではなく、用途に照らして削除することも検討します。説明を詳しくするために、確認できない情報まで増やす必要はありません。
絵画や彫刻の説明にも注意が必要です。色や配置、描かれた対象は観察できますが、作品が象徴する意味や作者の意図には複数の解釈があります。人物写真でも、表情から受ける印象と本人の感情は同じとは限りません。客観的な記述が求められる場面では、観察した内容と主観的な解釈を分けて扱います。
実際の運用では、画像に含まれる情報にも目を向けましょう。人物の顔、住所が書かれた書類、名札などが写っている場合は、外部サービスへ送る画像の範囲や、そのサービスでのデータの扱いを確認します。公開する文章についても、読み手に必要な情報だけを残し、目的に合う長さや語彙へ編集することが大切です。
関連する展開として、動画の内容を文章にする技術があります。動画では一場面の内容だけでなく、「人が入ってきて、物を置き、立ち去る」といった時間の流れや動作の順番を扱う必要があります。また、画像を手掛かりに物語を作る使い方もありますが、物語には創作を含められるため、画像の事実を伝える説明文とは目的を分けて評価します。
誤説明を減らすには、学習データの量だけでなく、説明文の品質、対象分野への適合、評価の方法、利用時の確認まで考える必要があります。画像キャプション生成は、視覚情報を言葉として利用するための技術です。まず使う目的を決め、その目的に必要な情報が正しく記述されているかを確かめることが、活用の土台になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月3日 | 学習の説明を修正し、OCR・代替テキストとの違いと誤説明の確認点を追記 |