
エンコーダ・デコーダ注意機構とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「Encoder-Decoder Attention」では2つのRNNを使うと聞きましたが、それぞれどんな役割を持つのでしょうか?

AI専門家
エンコーダは入力を読み、単語など各位置の情報を数値ベクトルに変換する役割を持つんだ。デコーダはそれまでに作った出力を手掛かりに、次の語を順に生成するよ。
AIの初心者
入力全体を一つのベクトルにまとめるだけだと、長い文では大事な情報が抜けてしまいませんか?
AI専門家
そこで注意機構を使うんだ。デコーダが出力を一つ作るたびに、エンコーダが作った各位置の表現を参照し、その時点で必要な情報を取り込める。固定長の一つの表現だけに頼らずに済むよ。
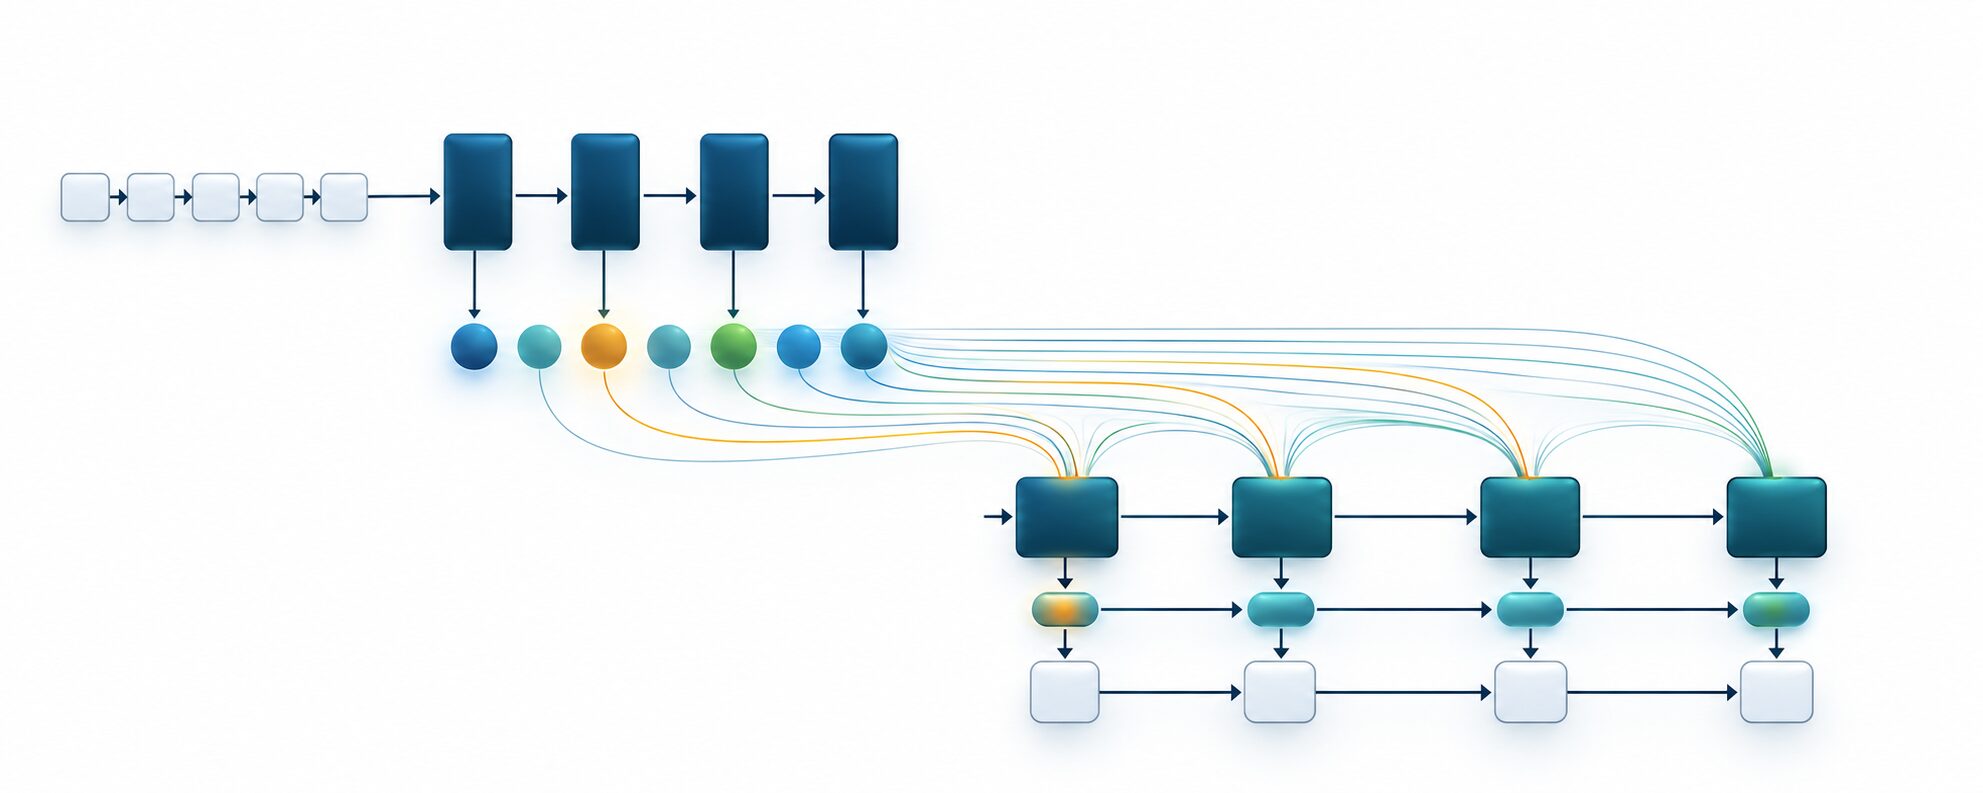
エンコーダ・デコーダ注意機構(encoder-decoder attention)は、入力系列を翻訳や要約などの別の出力系列へ変換するとき、出力を一つ生成するたびに入力側の各位置を参照する仕組みです。デコーダは入力全体を一度だけ受け取るのではなく、必要な情報に応じて参照先を変えます。
この考え方は機械翻訳をはじめ、文章要約や音声認識など、入力をもとに出力系列を作る処理で使われます。まずは、エンコーダとデコーダがどう情報を受け渡すのかを見てから、注意重みの計算や自己注意との違いを説明します。
エンコーダ・デコーダ注意機構とは
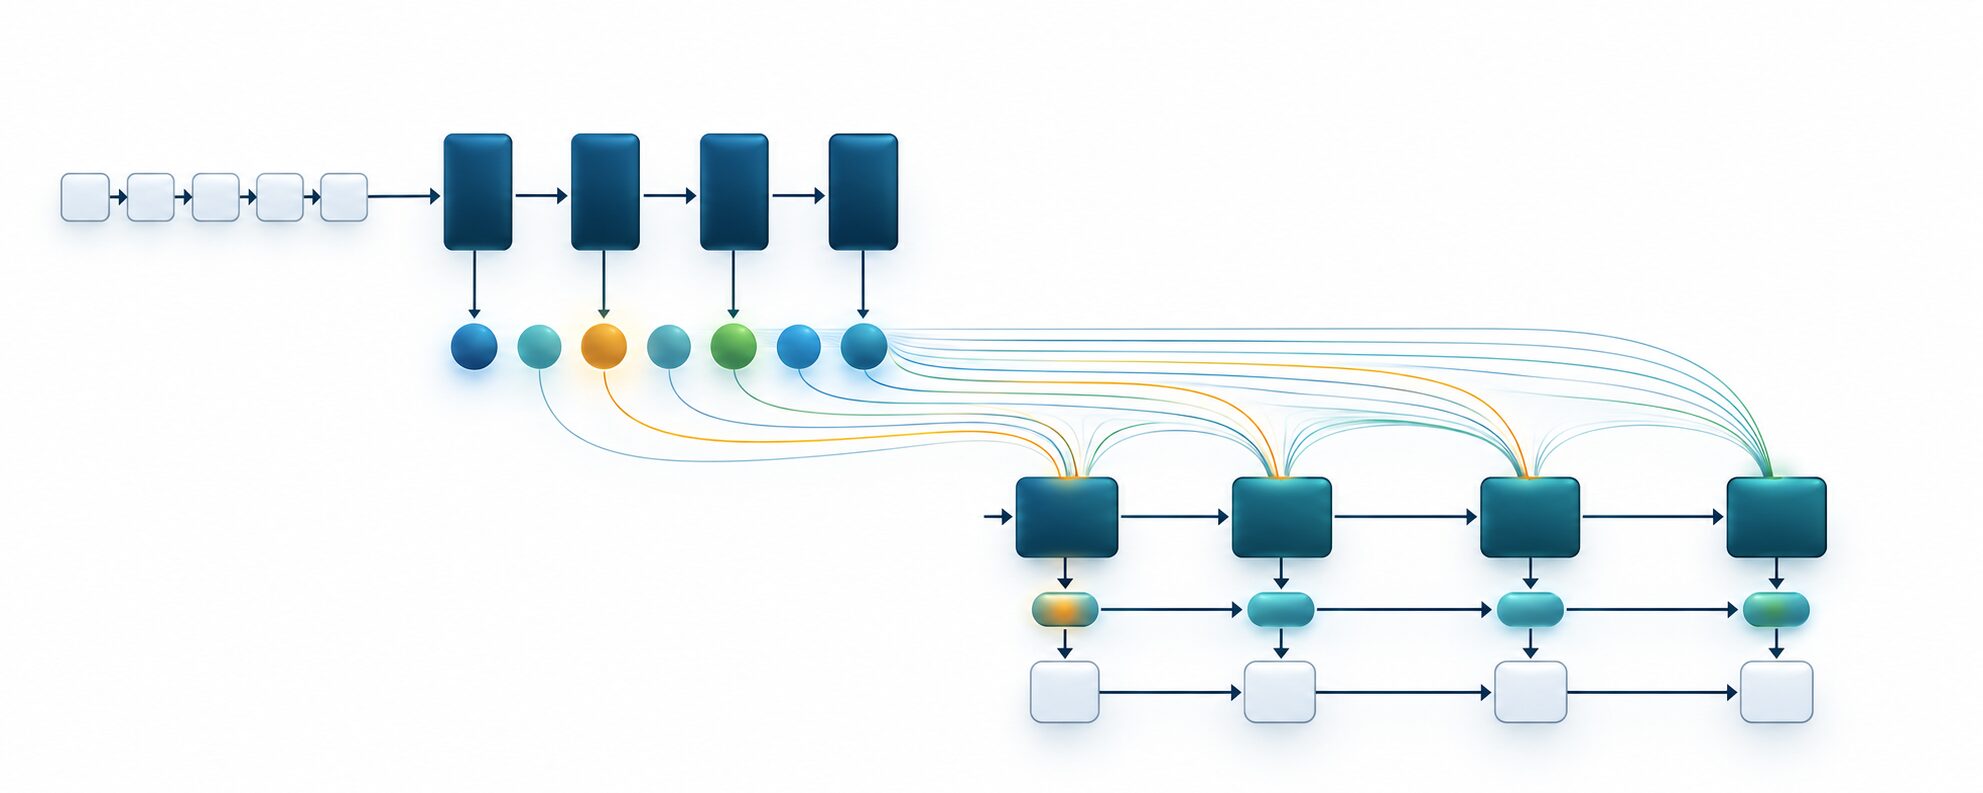
エンコーダ・デコーダ注意機構は、系列変換を行うエンコーダ・デコーダ構造に、出力の各時点で入力側の情報を選ぶ注意機構を組み合わせたものです。エンコーダは入力を位置ごとの表現に変換し、デコーダはその表現と生成済みの出力を使って、次の要素を予測します。
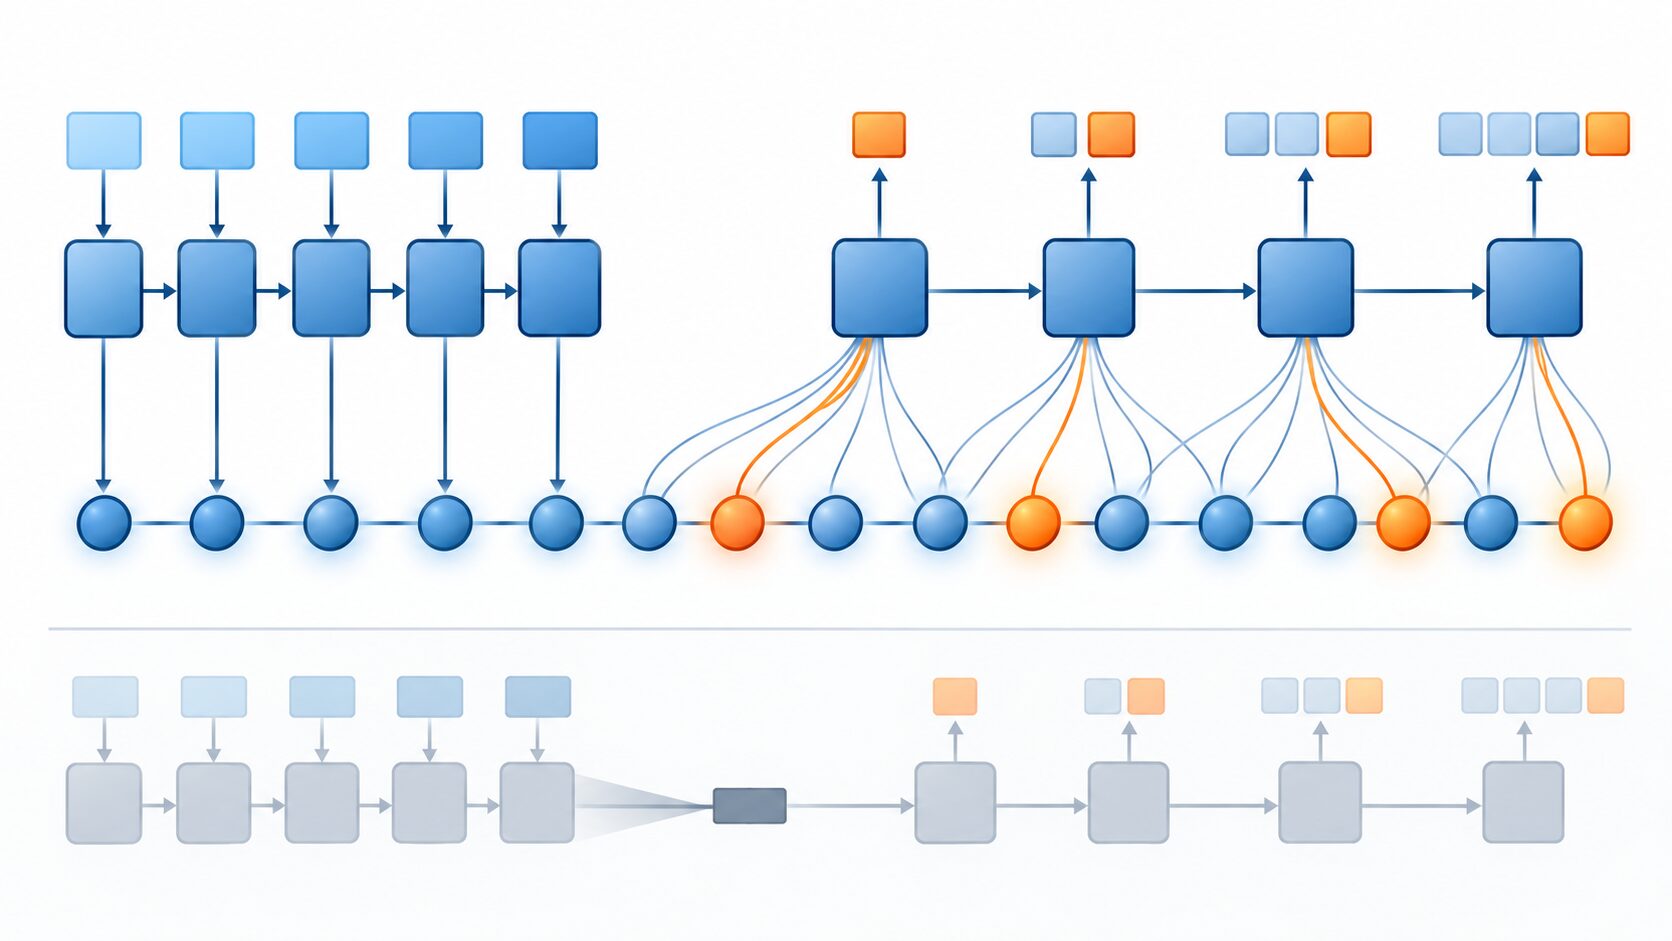
注意機構が広く使われる理由の一つは、従来型の系列変換モデルが抱えていた情報のボトルネックを和らげられることです。注意機構を使わない構成では、入力全体を最後の状態など一つの固定長ベクトルにまとめ、それをデコーダへ渡す方法がありました。入力が長くなるほど、一つの表現に細部を保つのが難しくなります。
注意機構を加えると、入力の各位置に対応する表現を残しておき、デコーダが出力ごとにそこから情報を選べます。入力のどの部分をどれだけ参照するかを、出力の時点ごとに計算することが特徴です。ただし、注意機構があれば翻訳や要約が必ず正しくなるわけではなく、モデルが学習した表現やデータの質にも結果は左右されます。
エンコーダとデコーダはRNNやLSTMで実装されてきましたが、この仕組みをRNNだけに限定する必要はありません。Transformerでもエンコーダとデコーダを組み合わせ、デコーダがエンコーダの出力を見るクロス注意を使います。
エンコーダとデコーダはどう連携するか
エンコーダは文章をトークン(単語や単語の一部など、モデルが扱う単位)に分け、入力位置ごとの特徴を表現します。RNNやLSTMの場合、系列を順に読みながら内部状態を更新し、各位置の出力を得ます。入力がn個の位置からなるとき、これらの状態を \(h_1, h_2, \ldots, h_n\) と表します。各 \(h_i\) は、その位置の情報に加えて周辺の文脈も含むベクトルです。
注意機構を使わない古典的な構成では、最後の状態などを入力全体の要約としてデコーダへ渡す場合があります。一方、注意機構を使う構成では、デコーダが参照できるように各位置の状態を保持します。デコーダは直前までに生成した語と現在の状態をもとに、出力系列の次の要素を一つずつ予測し、終了記号が出るまで生成を続けます。
出力の時点を \(t\) とすると、その時点のデコーダ状態 \(s_t\) を使って入力側の状態を調べます。たとえば翻訳では、ある出力語を作る際に、入力文のどの位置がその語の予測に関係するかを計算します。次の出力語を作る時点では、デコーダの状態も変わるため、参照先や重みも変わり得ます。
TransformerではRNNのように単語を一つずつ順番に読み込む形を取らず、位置情報を加えた表現を使います。それでも「入力を表す側」と「出力を作る側」があり、デコーダがエンコーダの出力を参照する役割は共通しています。
注意重みと文脈ベクトルの計算
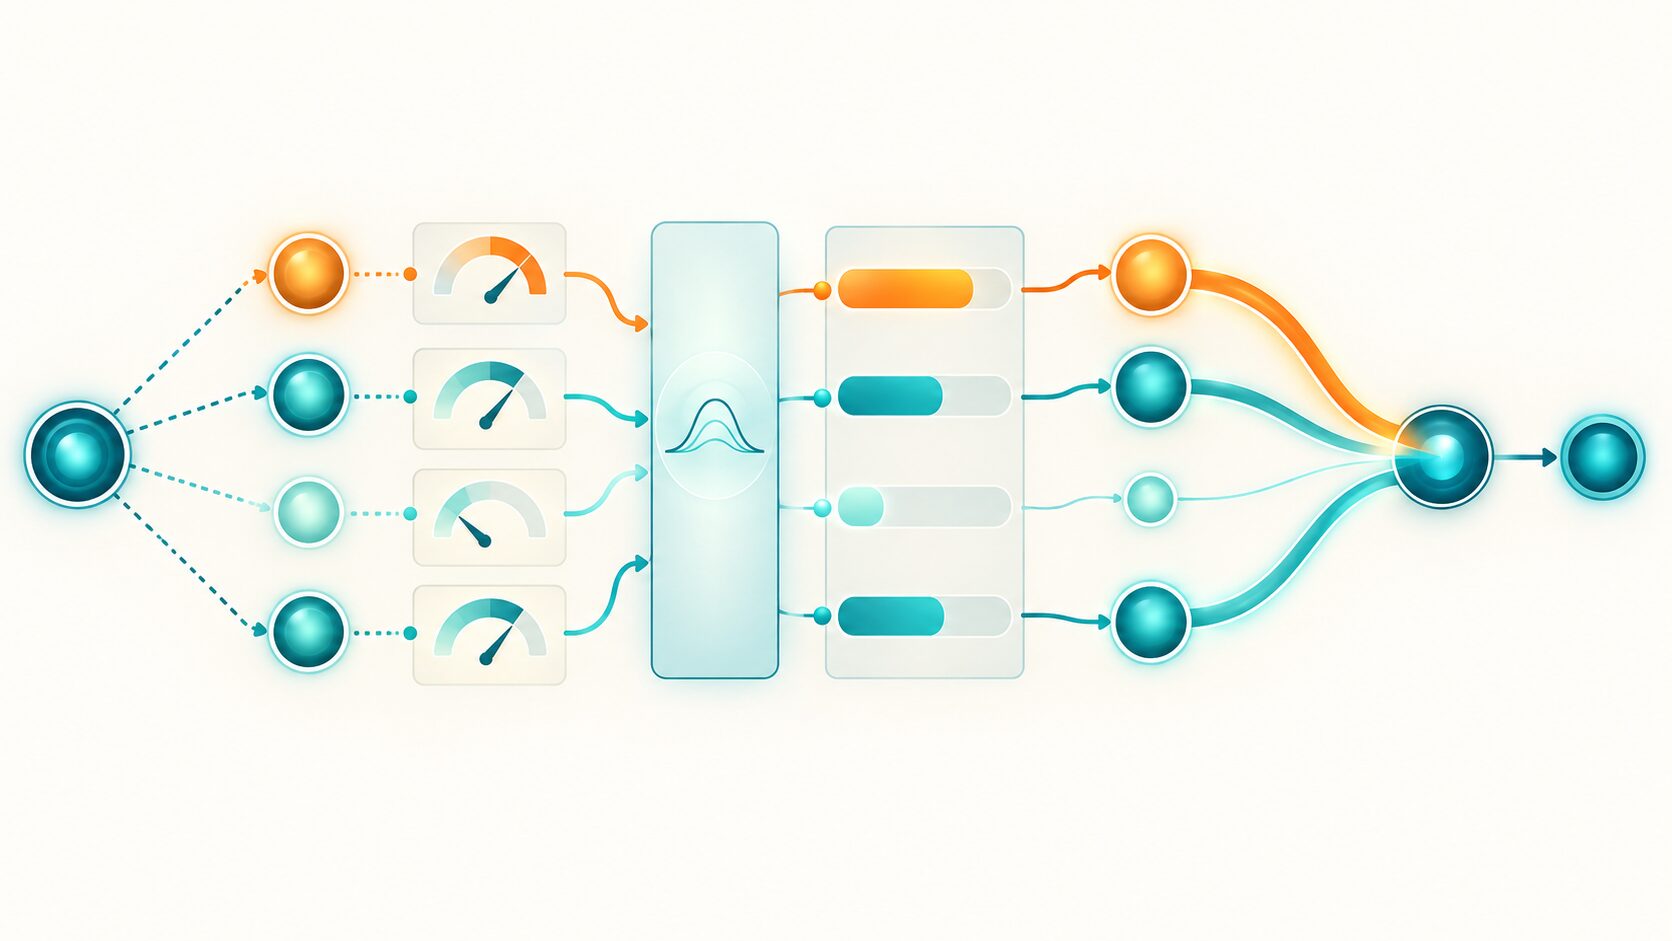
注意機構は、デコーダの状態と入力側の各状態との関連度をスコアにします。時点 \(t\) において、入力位置 \(i\) のスコアを \(e_{t,i}\) とすると、計算の形は次のように表せます。
\(e_{t,i} = \mathrm{score}(s_t, h_i)\)スコア関数には、二つのベクトルの内積を使う方法や、学習可能な変換を加えて関連度を求める加法注意などがあります。ベクトルの次元が合わない場合は、比較できる形に変換してからスコアを計算します。どの方式を使うかはモデルの設計によります。
各入力位置のスコアをsoftmax関数に通すと、注意重み \(\alpha_{t,i}\) が得られます。入力位置の数を \(n\) とすると、時点 \(t\) の重みは次の形です。
\(\alpha_{t,i} = \frac{\exp(e_{t,i})}{\sum_{j=1}^{n}\exp(e_{t,j})}\)softmaxによって重みは0以上になり、入力位置全体で合計1になります。値が大きい位置ほど、その時点で相対的に強く参照されます。これは各位置の情報を混ぜる比率であり、入力中の単語を一つだけ選び出す操作とは異なります。実装では、入力をそろえるために追加したパディング位置へ重みが付かないよう、softmaxの前にマスクします。
最後に、各入力状態を注意重みで重み付けして足し合わせます。この結果が文脈ベクトル \(c_t\) です。
\(c_t = \sum_{i=1}^{n}\alpha_{t,i}h_i\)デコーダは文脈ベクトルを自身の状態などと組み合わせ、次の語の確率を計算します。このため、出力の時点ごとに新しい文脈ベクトルが作られます。スコアを求め、重みに変換し、入力表現の重み付き和を取るのが基本的な処理の流れです。
機械翻訳で見る注目先の変化
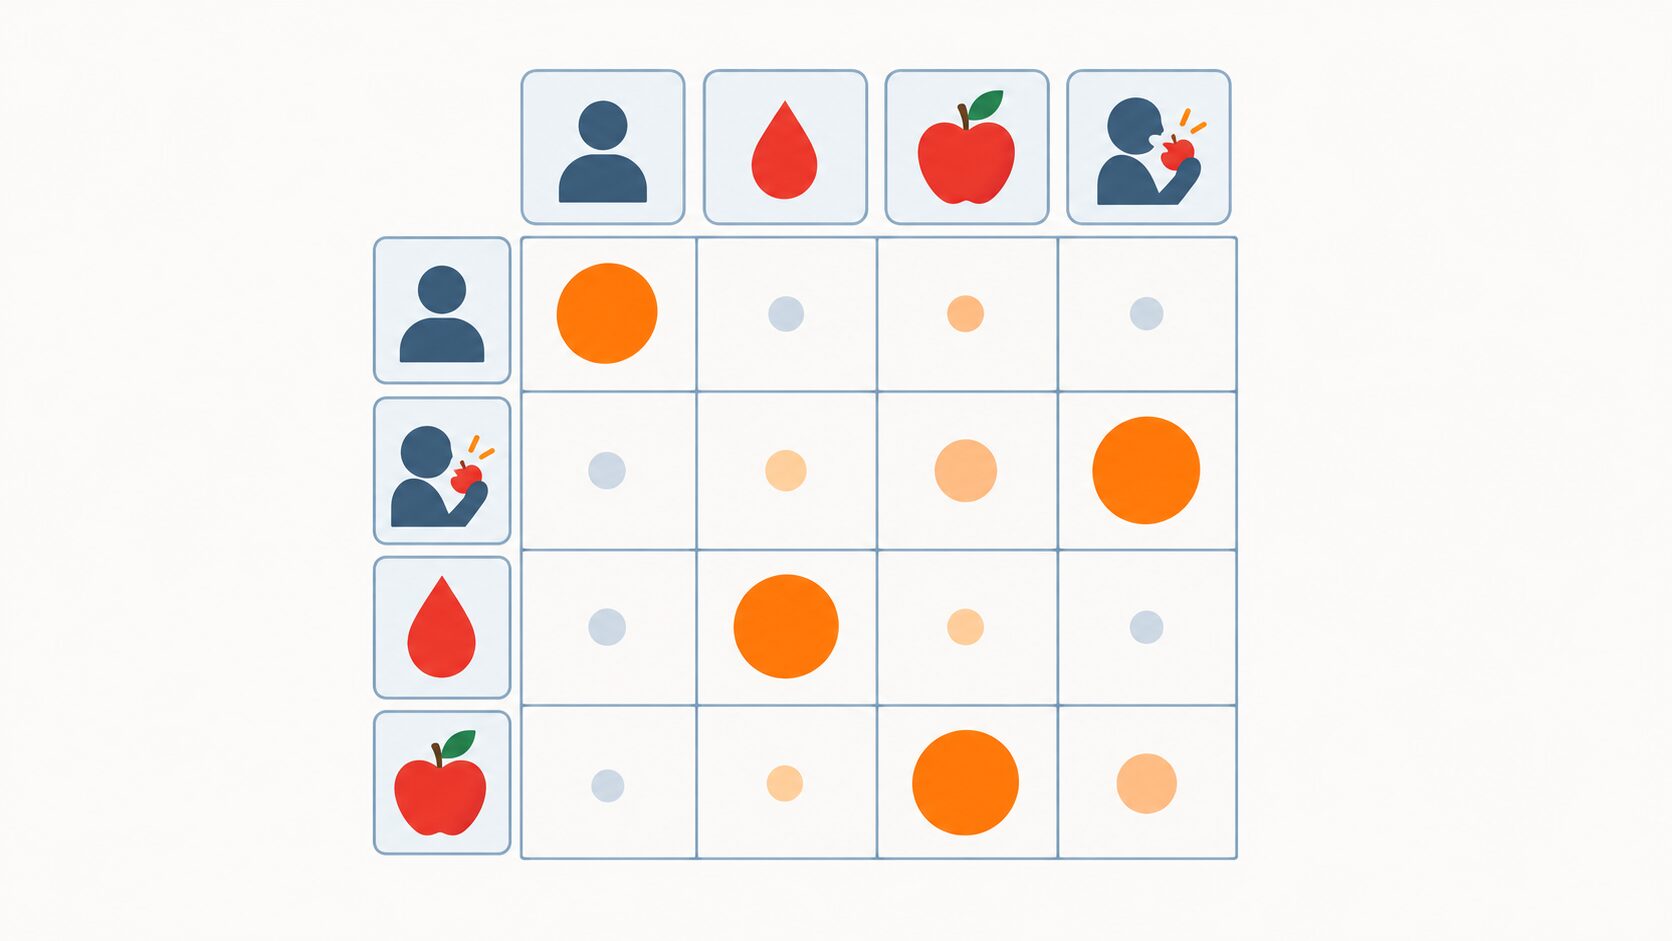
「私は赤いりんごを食べた」を “I ate a red apple” に翻訳する場面を考えてみましょう。エンコーダは日本語の各位置を文脈を含む表現にし、デコーダは英語の語を順番に生成します。そのたびに注意重みが計算され、入力文の参照先が変わります。
- “ate” を予測するときは、「食べた」の表現が強く参照されることがあります。
- “red” や “apple” を予測するときは、「赤い」や「りんご」の情報が予測に関係します。
- “I” や冠詞 “a” のように、日本語側と一対一で対応する語がない場合も、文全体の情報を使って自然な出力を選びます。
この例のような対応づけは理解の手掛かりになりますが、注意重みが常に単語間の正確な対応関係を示すとは限りません。日本語と英語では語順や文法が異なり、一つの出力語が入力の複数の位置を参照したり、逆に複数の出力語が同じ位置の情報を利用したりします。モデルは単語そのものではなく、文脈を含むベクトルを参照しています。
注意重みを行列として並べると、縦の行に出力位置、横の列に入力位置を置いて可視化できます。各行は一つの出力時点に対応し、行が変わるにつれて重みの分布も変わります。色の濃さなどで値を表せば、デコーダがどの入力位置を相対的に多く参照したかを確認できます。
自己注意・クロス注意との違い
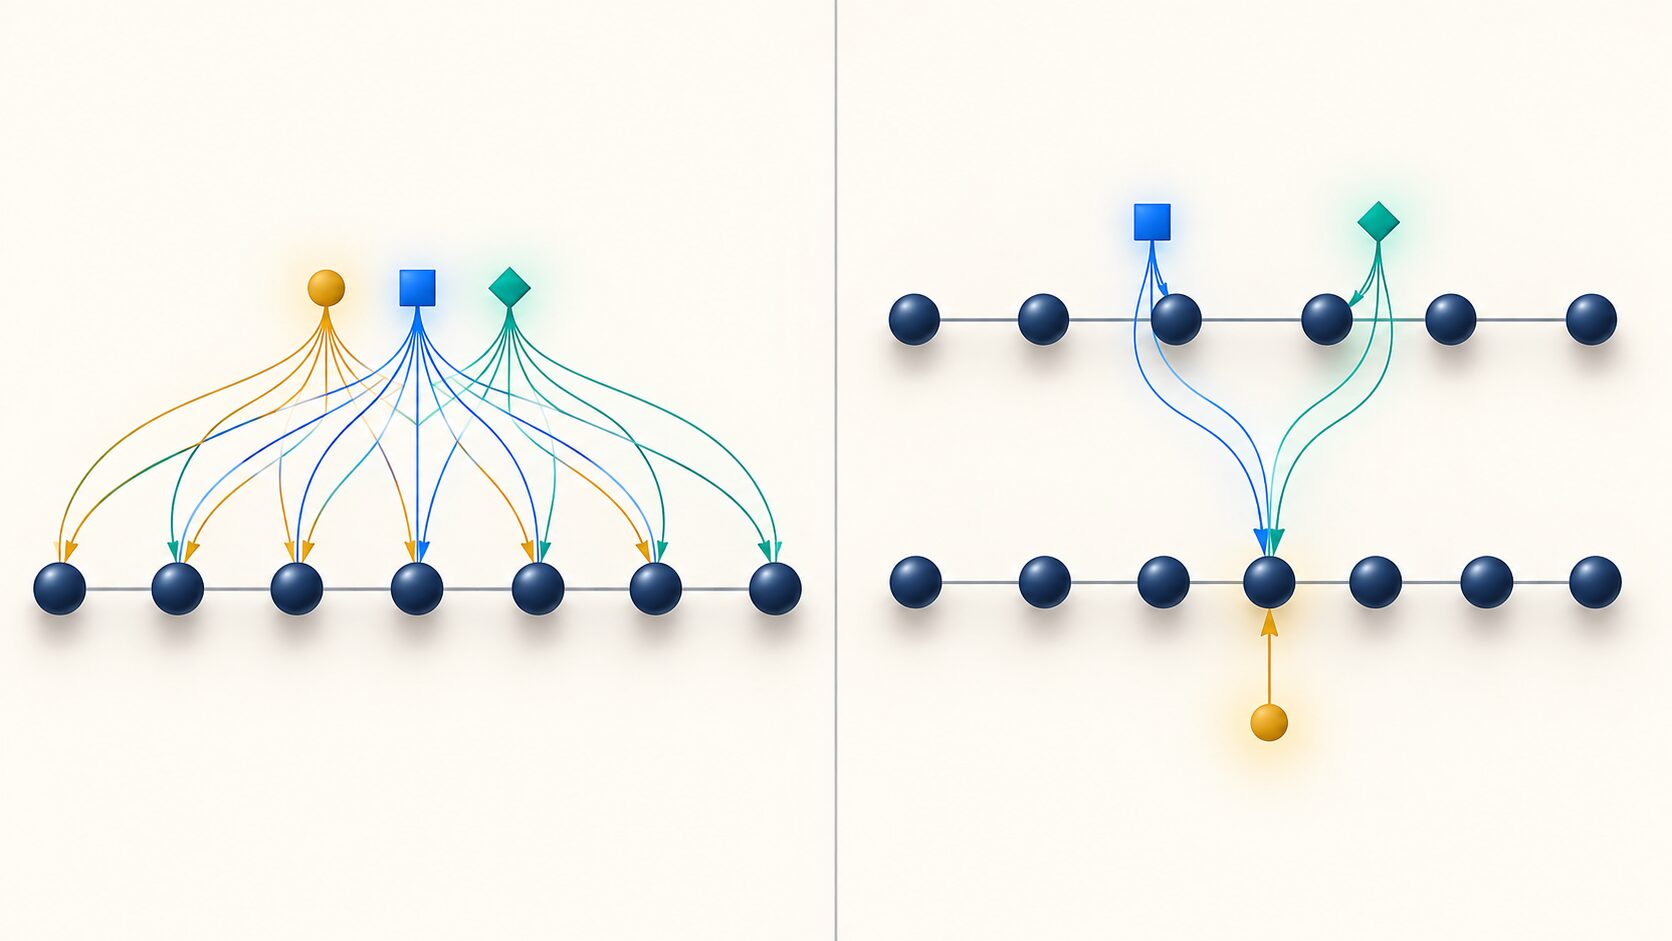
自己注意とクロス注意の違いは、主に「問い合わせる側」と「参照される側」の系列が同じかどうかです。注意計算では一般に、問い合わせを表すQuery(Q)、参照先の情報を表すKey(K)とValue(V)を使います。
- 自己注意は、同じ系列の位置どうしを参照します。Q・K・Vはいずれも同じ系列の表現から作られ、たとえば入力文内の語がほかの語の情報を取り込みます。
- クロス注意は、別の系列の情報を参照します。エンコーダ・デコーダ構造では、デコーダ側の状態からQを作り、エンコーダ出力からKとVを作るのが代表的な形です。
エンコーダ・デコーダ注意機構は、デコーダがエンコーダ出力を見るクロス注意の代表例です。RNNを使う場合も、デコーダの現在状態で入力側の表現を問い合わせるという点で同じ考え方です。注意機構という言葉は情報を重み付けして参照する計算方法を指し、エンコーダ・デコーダは入力系列から出力系列を作るモデル構成を指します。
Transformerのデコーダでは、出力系列内の情報を見るマスク付き自己注意と、エンコーダ出力を参照するクロス注意を組み合わせます。マスク付き自己注意では、ある位置の予測にまだ生成していない未来の語が混ざらないようにします。対してクロス注意では入力側の表現を参照し、出力に必要な情報を取り込みます。
活用場面と使うときの注意点
エンコーダ・デコーダ注意機構は、入力系列を参照しながら別の系列を生成する課題で役立ちます。代表例は機械翻訳ですが、入力側の表現を文章以外の特徴量に置き換えることもできます。
- 機械翻訳:原文の位置を参照しながら、訳文を語順に沿って生成します。
- 文章要約:入力文書の情報を参照し、短い文章として要点を出力します。
- 音声認識:音声から得た特徴系列を参照して、対応する文字列を生成します。
- 画像キャプション:画像の領域や特徴を表す情報を参照して、画像を説明する語列を作ります。
一方、注意重みはモデル内部の計算における相対的な参照量を示すもので、モデルがその出力を選んだ理由を完全に説明するものではありません。重みの大きい入力位置を確認することは分析の手掛かりになりますが、それだけで予測の根拠を断定するのは避けましょう。また、入力側を参照できても、曖昧な文の解釈違いや学習データ由来の誤りは起こり得ます。
計算量にも注意が必要です。入力の長さを \(n\)、出力の長さを \(m\) とすると、基本的なクロス注意では入力と出力の位置の組み合わせに対してスコアを求めるため、注意の計算や重みの保持はおおむね \(n \times m\) の規模で増えます。系列が非常に長い場合は計算時間やメモリ使用量が大きくなるため、パディング用マスクの適用や、目的に合ったモデル構成を選ぶことが大切です。
要点は、エンコーダが入力の位置ごとの表現を用意し、デコーダが出力の各時点で必要な情報を参照することです。この流れを押さえると、注意重み、文脈ベクトル、自己注意やクロス注意の役割を区別しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月17日 | 注意重みの計算と翻訳例を整理し、自己注意との違いや解釈上の注意も追記 |