
機械学習とは?主な手法・仕組み・活用例をわかりやすく解説

AIの初心者
「機械学習の手法」とはどういう意味ですか?アルゴリズムと同じものなのでしょうか?

AI専門家
「手法」は、問題を解くための方法を広く指す言葉だよ。「アルゴリズム」は、計算や処理を進める具体的な手順を指すんだ。ただし、機械学習では同じ方法を「手法」とも「アルゴリズム」とも呼ぶことがあり、はっきり分けられない場合もあるよ。
AIの初心者
では、手法の名前を覚える前に、何を学ばせたいのか、どんなデータがあるのかを考えるとよいのですね。学習してできあがるものが「モデル」ですか?
AI専門家
そうだね。データから学んだ結果を反映したものを「学習済みモデル」と呼ぶよ。正解例から予測するのか、データのまとまりを探すのか、試行錯誤で行動を学ぶのかによって、使う方法も変わるんだ。身近な例で順に見ていこう。
機械学習とは。
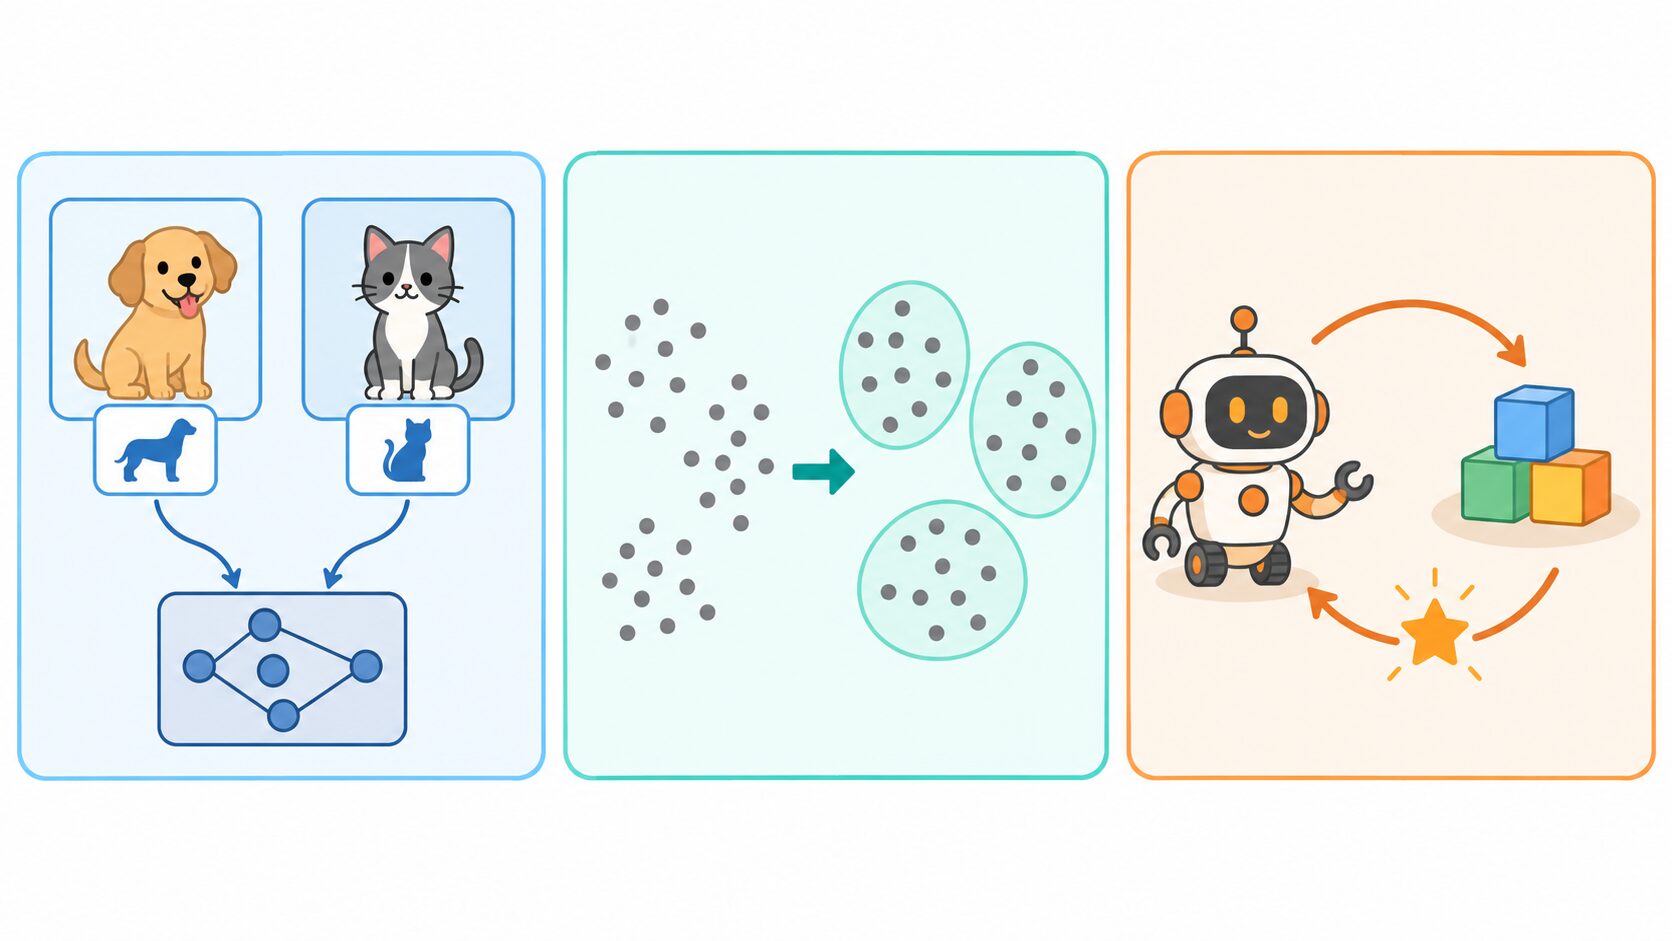
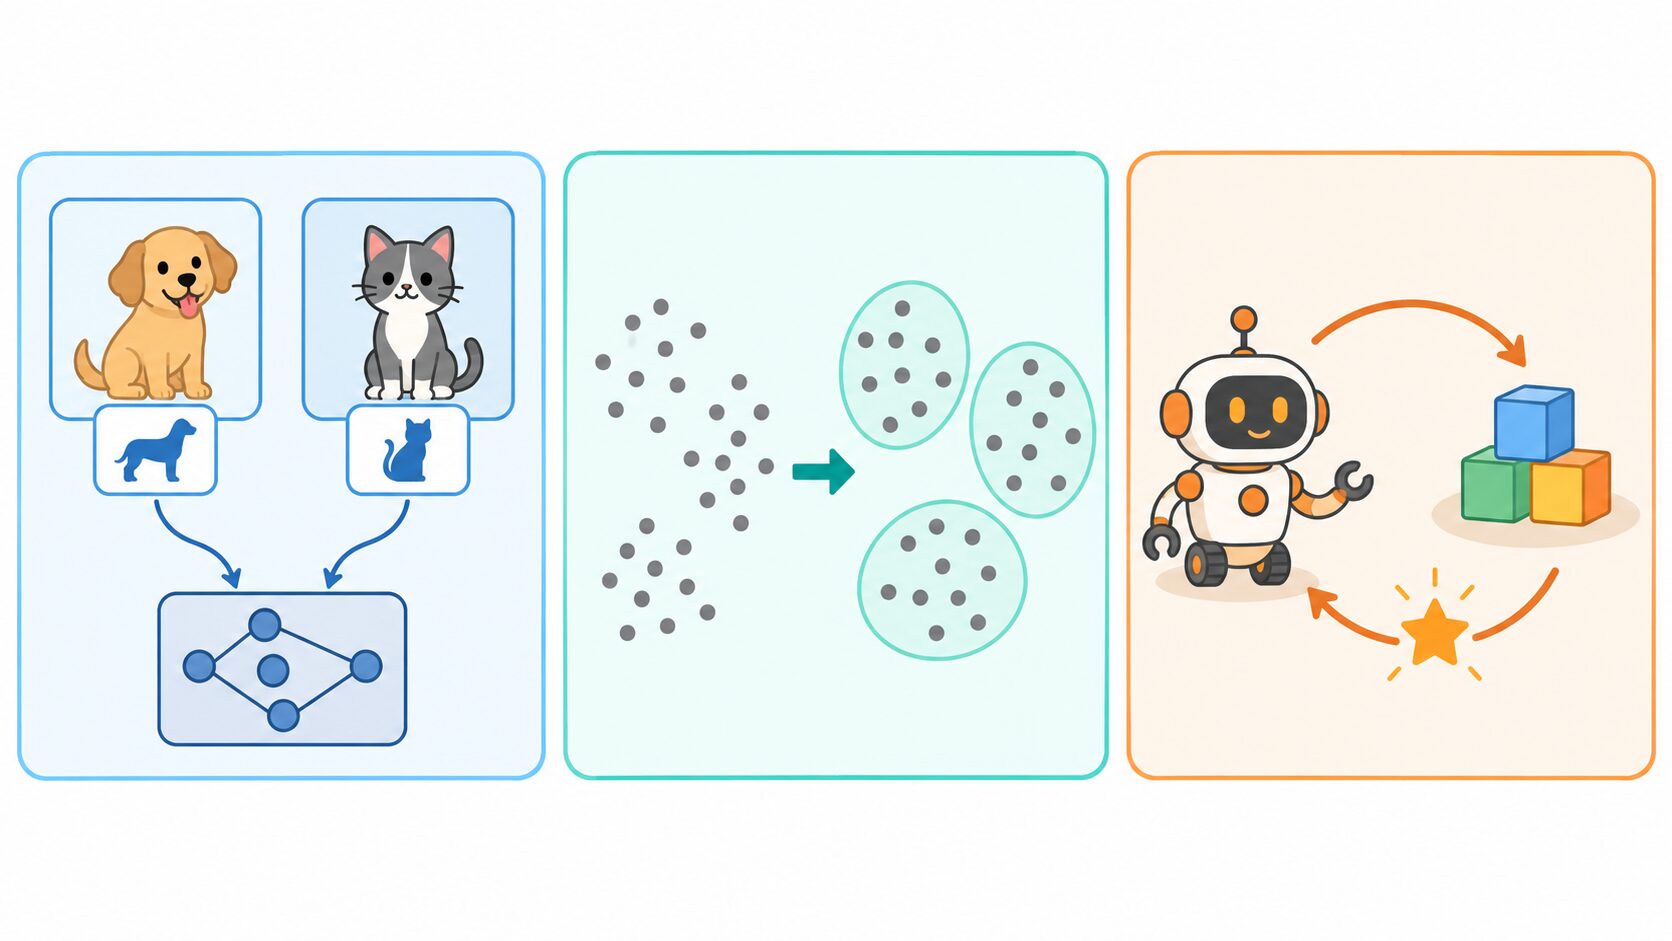
機械学習は、データから規則性や傾向を学び、新しい入力に対する予測や判断などに役立てる技術です。その実現に使う方法を広く「手法」と呼び、正解ラベルから学ぶ教師あり学習、データの構造を探る教師なし学習、報酬を手がかりに行動を学ぶ強化学習などがあります。
機械学習の手法を理解するには、名前の違いだけでなく、「何を手がかりに学ぶか」「何を出力したいか」を押さえることが大切です。この記事では、学習から予測までの流れ、主な手法の特徴と活用例、目的に合った選び方を説明します。
機械学習の手法とは?アルゴリズム・モデルとの違い
機械学習は、人工知能(AI)を実現するための技術の一つです。人が「この条件ならこの答え」と判断規則をすべて書く代わりに、データを使って規則性を見つけます。たとえば住宅価格の予測なら、過去の住宅の面積や築年数、販売価格から関係を学び、まだ価格が分からない住宅について推定します。
ただし、機械が目的を決めて何でも自動的に学ぶわけではありません。何を予測するか、どのデータを使うか、どの程度の誤りまで許容するかは、人が設計する必要があります。また、AIには人が決めた規則に従って動く仕組みもあり、AIと機械学習は同じ意味ではありません。
「手法」「アルゴリズム」「モデル」は、次のように整理すると読み分けやすくなります。
| 用語 | 意味 | 具体例 |
|---|---|---|
| 手法 | 課題を解くための方法を広く指す言葉 | 教師あり学習という学び方や、決定木を使う方法 |
| アルゴリズム | 計算や処理を進める具体的な手順。「算法」とも呼ばれる | データを分ける条件を順に選び、決定木を作る手順 |
| 学習済みモデル | データから学んだ結果を反映し、入力に応じた出力を返す仕組み | 学習によって決まった分岐条件を持ち、住宅価格を予測する決定木 |
手法とアルゴリズムには、常に成り立つ厳密な上下関係があるわけではありません。同じ決定木を「手法」と呼ぶことも「アルゴリズム」と呼ぶこともあります。一方、「モデル」は学習前の仕組みや形式を指す場合もあるため、学習結果が入った状態を明確にしたいときは「学習済みモデル」と表します。
教師あり学習・教師なし学習・強化学習は、学び方を理解するための代表的な区分です。この三つだけですべてを表せるわけではなく、少量のラベル付きデータとラベルなしデータを使う「半教師あり学習」や、文章の一部を隠して当てるようにデータ自体から学習の目標を作る「自己教師あり学習」もあります。
また、深層学習(ディープラーニング)は、多層のニューラルネットワークを使う方法です。これは正解や報酬の有無による区分とは観点が異なり、教師あり学習、自己教師あり学習、強化学習などと組み合わせて使えます。「深層学習が三つの学び方のどれか一つに限定される」と考えないことがポイントです。
データの準備から学習・評価・予測までの流れ
機械学習では、計算方法を選ぶ前後にも大切な作業があります。ここでは、面積や築年数から住宅価格を予測する教師あり学習を例に、全体の流れを見ていきましょう。
-
目的を決める:どの地域の、どの時点の住宅価格を予測するのかを明確にします。売り出し価格と実際の成約価格では意味が違うため、予測したい値を先に決めます。
-
データを集め、用途別に分ける:過去の住宅情報と対応する価格を集めます。そのうえで、学習用・検証用・テスト用に分け、モデル作成に使うデータと、性能を確認するデータを区別します。
-
前処理と特徴量の準備をする:欠けた値への対応、重複や入力ミスの確認、必要に応じた数値の尺度の調整などを行います。面積・築年数・最寄り駅までの距離といった、予測の判断材料になる項目を「特徴量」と呼びます。
-
モデルを学習させる:学習用データを使い、予測価格と正解の価格の差が小さくなるようにモデルを調整します。何をどう調整するかはアルゴリズムによって異なります。
-
評価して方法を見直す:検証用データで手法や設定を比較し、選択を終えた後に、調整に使っていないテスト用データで最終的な性能を確かめます。
-
新しい入力から予測する:学習済みモデルに新しい住宅の面積や築年数などを入力し、価格の推定値を得ます。運用後も実際の結果と照らし合わせ、必要に応じて改善します。
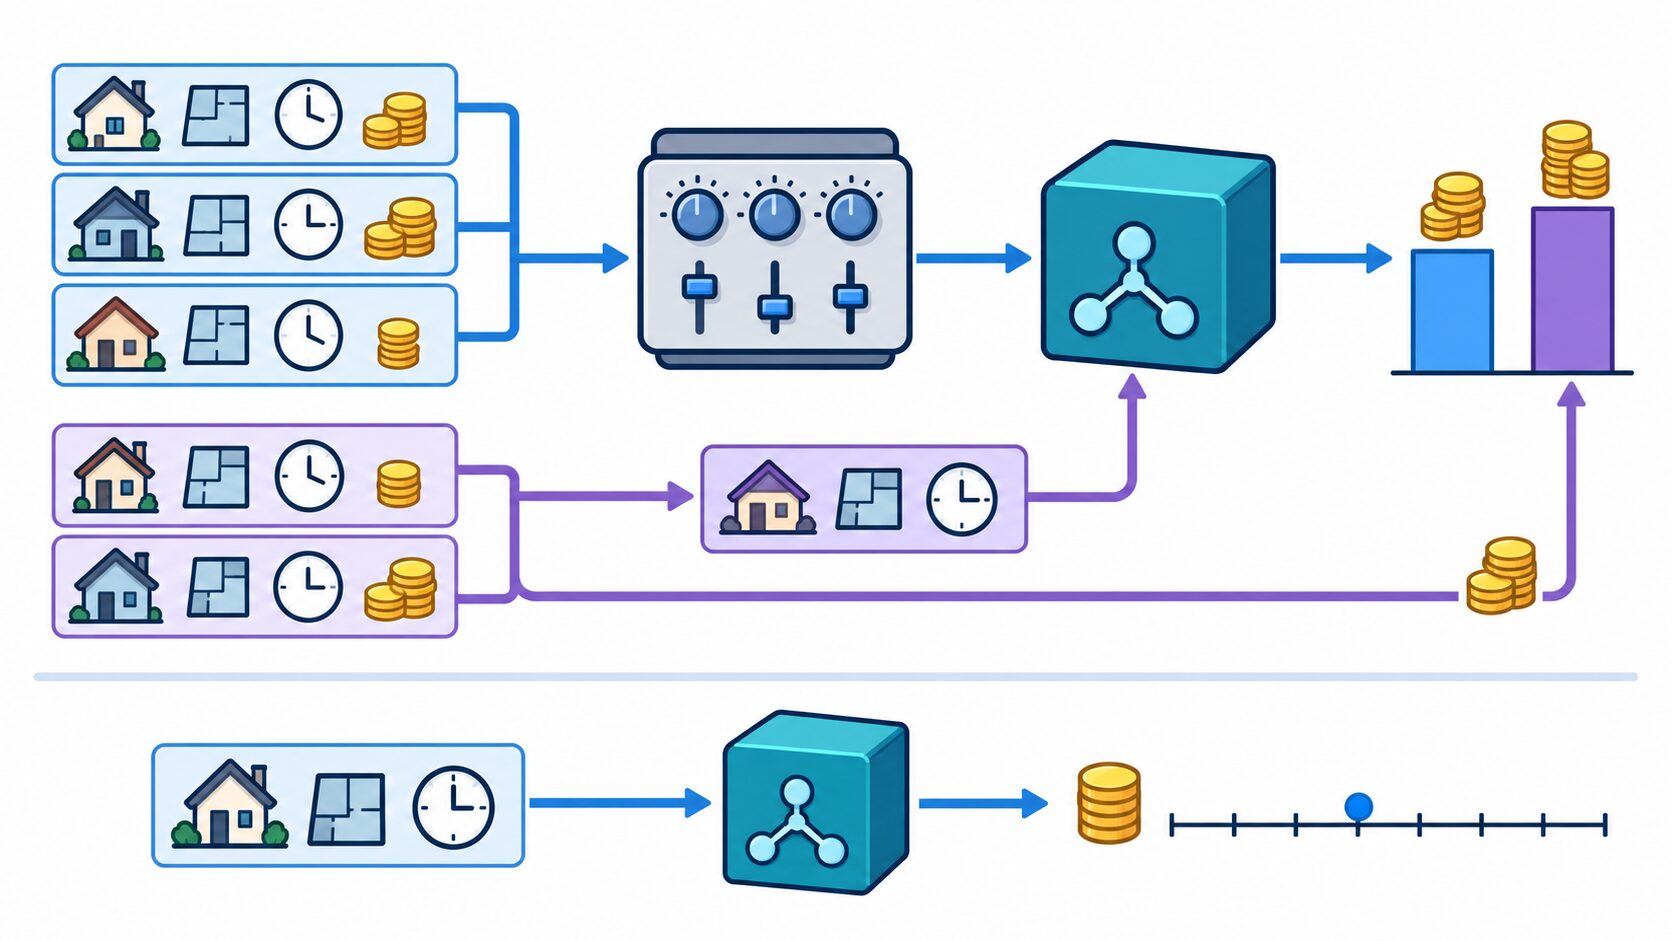
学習用データは、モデルに規則性を覚えさせるためのものです。検証用データは、どの手法や設定がよいかを選ぶために使います。テスト用データは、選んだ方法が未知のデータにも通用するかを確認するために残しておきます。テスト結果を見ながら何度も調整すると、そのデータも実質的に方法選びに使われ、最終評価の独立性が失われます。
学習はモデルを作る・調整する処理、予測は学習済みモデルを使って結果を出す処理です。一般的な運用では、予測のたびにモデルが自動で学び直すわけではありません。料理にたとえるなら、準備・調理・味の確認を経て提供する流れに近いものの、機械学習では、学習に使わなかった事例で性能を確かめる点が特に重要です。
この流れは教師あり学習の例です。教師なし学習ではデータのまとまりが役立つかを確認し、強化学習では環境とのやり取りから方策を改善するなど、学び方に応じて工程や評価方法が変わります。
教師あり学習:正解ラベルから分類と回帰を学ぶ
教師あり学習は、入力データと、それに対応する正解の組から関係を学ぶ方法です。犬と猫を見分ける場合なら、写真が入力、「犬」「猫」という種類が正解ラベルになります。多くの組を使って学習し、初めて見る写真でも種類を判別できるようにすることを目指します。
ここでいう「教師」は、人が横について毎回教えるという意味ではありません。正解ラベルが学習の手がかりになることを表しています。ラベルは人が写真を確認して付ける場合もあれば、住宅の成約価格や店舗の売上実績など、業務で残された記録から用意できる場合もあります。数値の正解は「目的変数」や「目標値」と呼ばれることもあります。
教師あり学習で代表的な課題が「分類」と「回帰」です。両者は、出力したい答えの種類で区別します。
| 課題 | 入力と正解の例 | 新しい入力に対する予測結果 |
|---|---|---|
| 分類 | 動物の写真と「犬」「猫」のラベル | どちらの種類に属するか |
| 分類 | メールの本文などと「迷惑メール」「通常メール」のラベル | メールの種類や、迷惑メールである確率 |
| 回帰 | 住宅の面積・築年数などと成約価格 | 推定価格という数値 |
| 回帰 | 曜日・来店者数などと過去の売上 | 予測される売上金額という数値 |
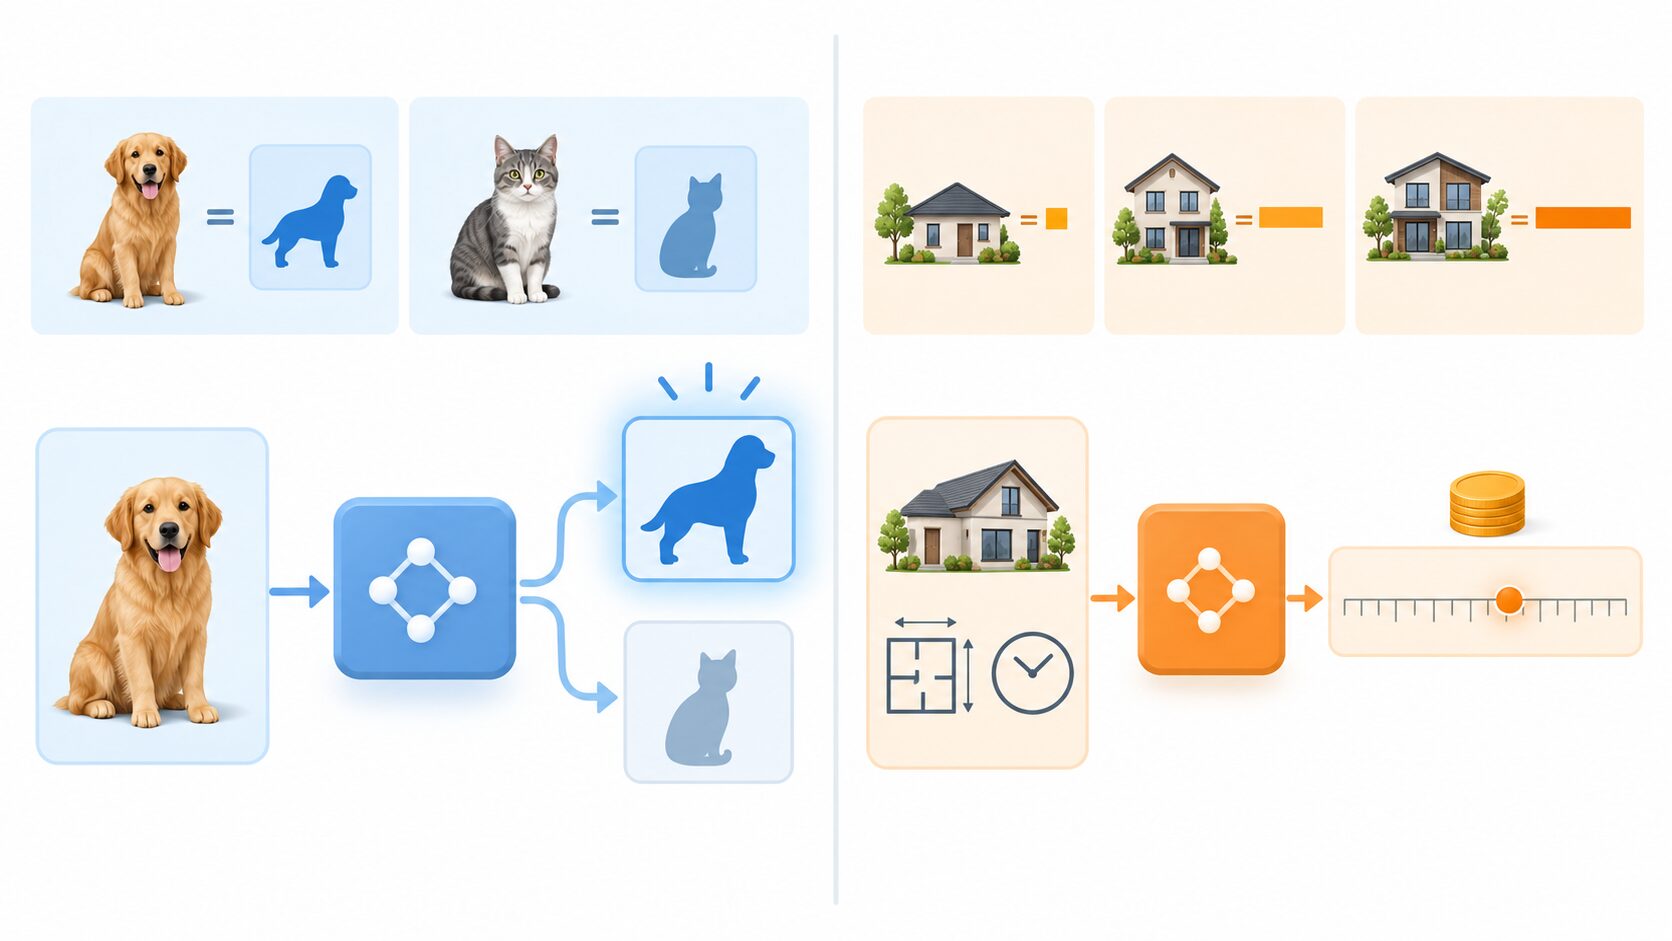
分類はカテゴリーを、回帰は数値を予測する課題と押さえると、目的から選びやすくなります。分類モデルが確率を出す場合でも、最終的に「どの種類か」を判断する目的なら分類です。逆に、住宅を「高価格帯・中価格帯・低価格帯」に分けたい場合は、価格に関する課題でも回帰ではなく分類として扱えます。
代表的な方法には、特徴量と予測したい数値の関係を直線的に表す「線形回帰」や、条件に従ってデータを枝分かれさせる「決定木」があります。決定木は、メールを種類に分ける分類にも、住宅価格を推定する回帰にも使えます。つまり、「教師あり学習」は学び方、「分類・回帰」は解きたい課題、「決定木など」は課題を解くための具体的な方法です。
正解を使えることは大きな利点ですが、ラベルに誤りがあれば、その誤りも学習に影響します。犬の写真だけが明るい背景、猫の写真だけが暗い背景に偏っていれば、動物の特徴より背景に頼ってしまう可能性もあります。データを増やす際は、量だけでなく、ラベルの正確さと実際の利用場面をどれだけ含んでいるかも確認しましょう。
教師なし学習:クラスタリングと次元削減で構造を探る
教師なし学習は、正解ラベルを付けた例から答えを当てるのではなく、データの分布や似ている関係を調べる方法です。何が起きているかを探索したいときや、まだ分類の基準が決まっていないときに役立ちます。ラベル付けの手間を抑えられる一方、分析の目的や結果の意味づけは人が考える必要があります。
代表的な課題の一つが、似た特徴を持つデータをまとめる「クラスタリング」です。たとえば顧客ごとの購入頻度、平均購入額、購入商品の種類を使えば、買い方の似た顧客をグループにできます。「k-means」はそのための代表的なアルゴリズムで、あらかじめ指定した数のグループに、特徴量の空間で近いデータをまとめます。
分類は決められた種類を当てるのに対し、クラスタリングはデータの似ている関係からまとまりを探します。クラスタリングでできたグループに「まとめ買いが多い顧客」などの意味を付けるのは分析する人です。グループ番号そのものに優劣や顧客像が備わっているわけではありません。
グループごとに購買履歴を詳しく調べれば、提案する商品やキャンペーンの仮説を立てられます。ただし、購入額が低いグループだからといって、価格に敏感だとすぐに断定することはできません。購入頻度や商品構成なども確かめ、施策の効果を検証する必要があります。Webサイトでも、閲覧したページや訪問の仕方が似た利用者をまとめることで、閲覧傾向を調べられます。
もう一つの代表的な課題が「次元削減」です。次元とは、ここではデータを表す特徴量の数に相当します。項目が多いと、そのままでは全体像を見にくく、計算負荷も増えます。そこで、データをより少ない軸で表し、散布図で傾向を見たり、後の処理を軽くしたりします。
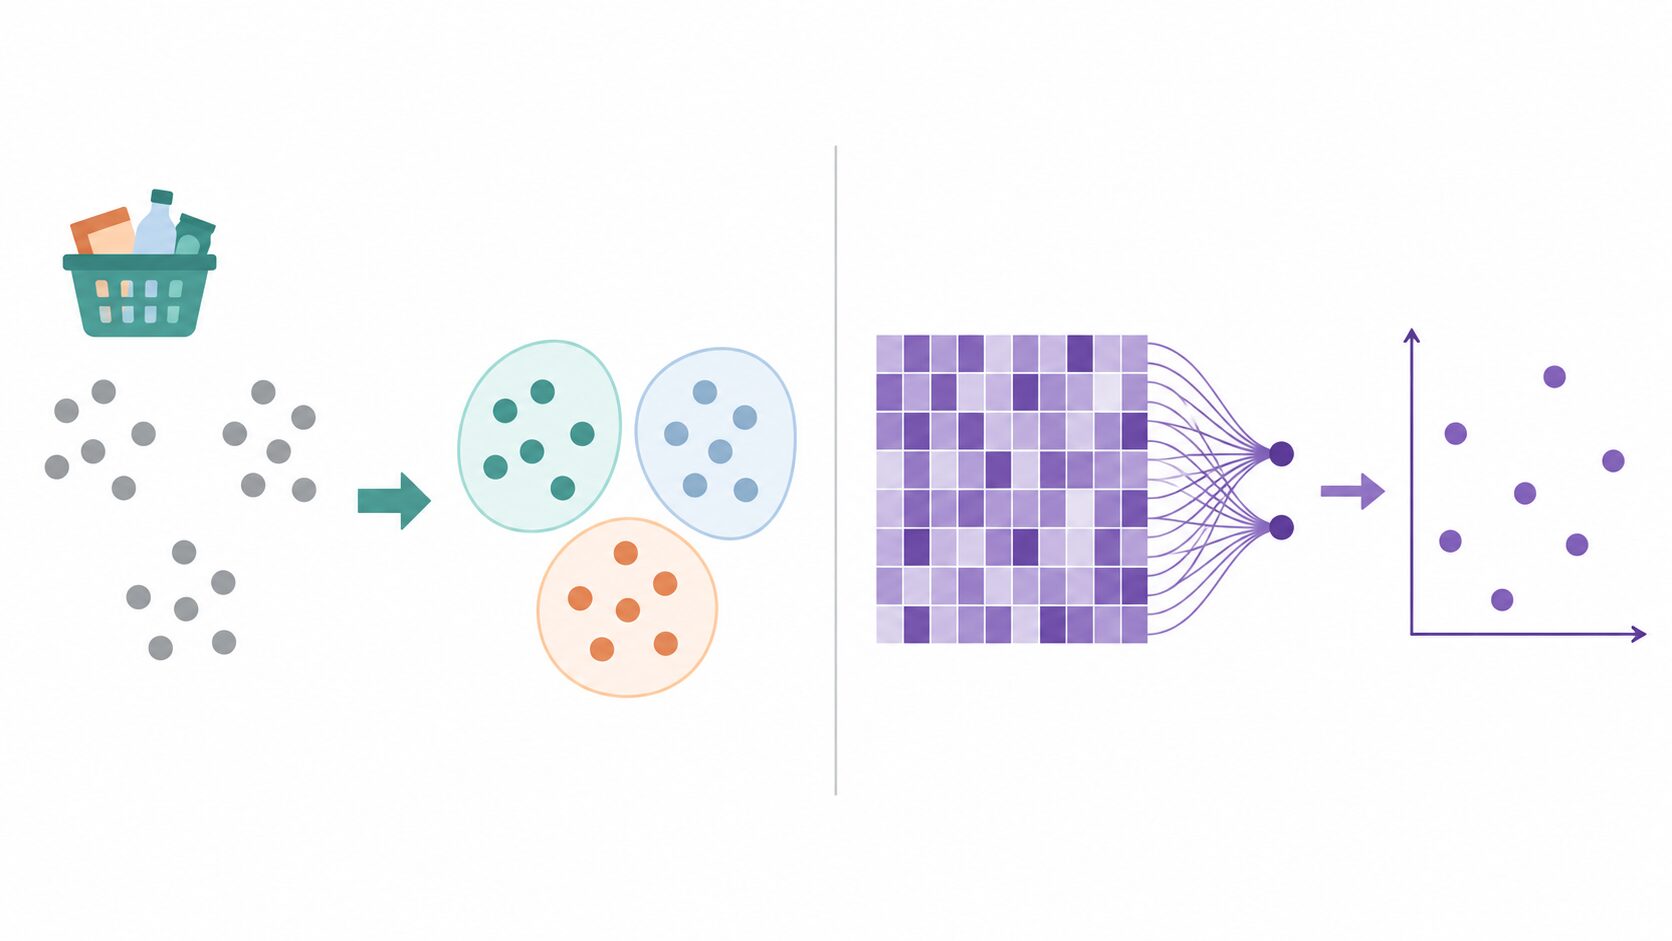
次元削減の代表例である「主成分分析(PCA)」は、複数の特徴量を組み合わせて新しい軸を作り、データのばらつきをできるだけ捉えます。元の項目から一部だけを選ぶ「特徴量選択」とは異なります。たとえば購買に関する多数の項目を少数の軸にまとめた場合、その軸は一つの商品や一つの属性にそのまま対応するとは限りません。
次元削減は、必ず予測精度を上げる処理ではありません。軸を減らすと情報が失われる場合があり、ばらつきの小さい特徴が予測には重要なこともあります。また、クラスタリングの結果は、使う特徴量、数値の尺度、グループ数などで変わります。どちらも処理結果をそのまま正解と見なさず、目的に役立つ構造が得られたかを確認します。
強化学習:報酬を手がかりに行動を学ぶ
強化学習は、行動の結果を手がかりに、よりよい行動の選び方を学ぶ方法です。行動する主体を「エージェント」、働きかける相手や周囲の状況を「環境」と呼びます。エージェントは環境を観測して行動し、その結果として報酬と次の状態に関する情報を受け取ります。このやり取りを通じて、状況に応じて行動を選ぶルールである「方策」を改善します。
たとえば、物をつかむロボットをエージェントとすると、物の位置や腕の状態を観測し、腕や指を動かします。つかめたかどうかに応じて報酬を与えれば、その経験が次の行動を選ぶ手がかりになります。ゲームなら、画面や盤面の状態を見て操作し、得点や勝敗などに基づく報酬から行動を学びます。
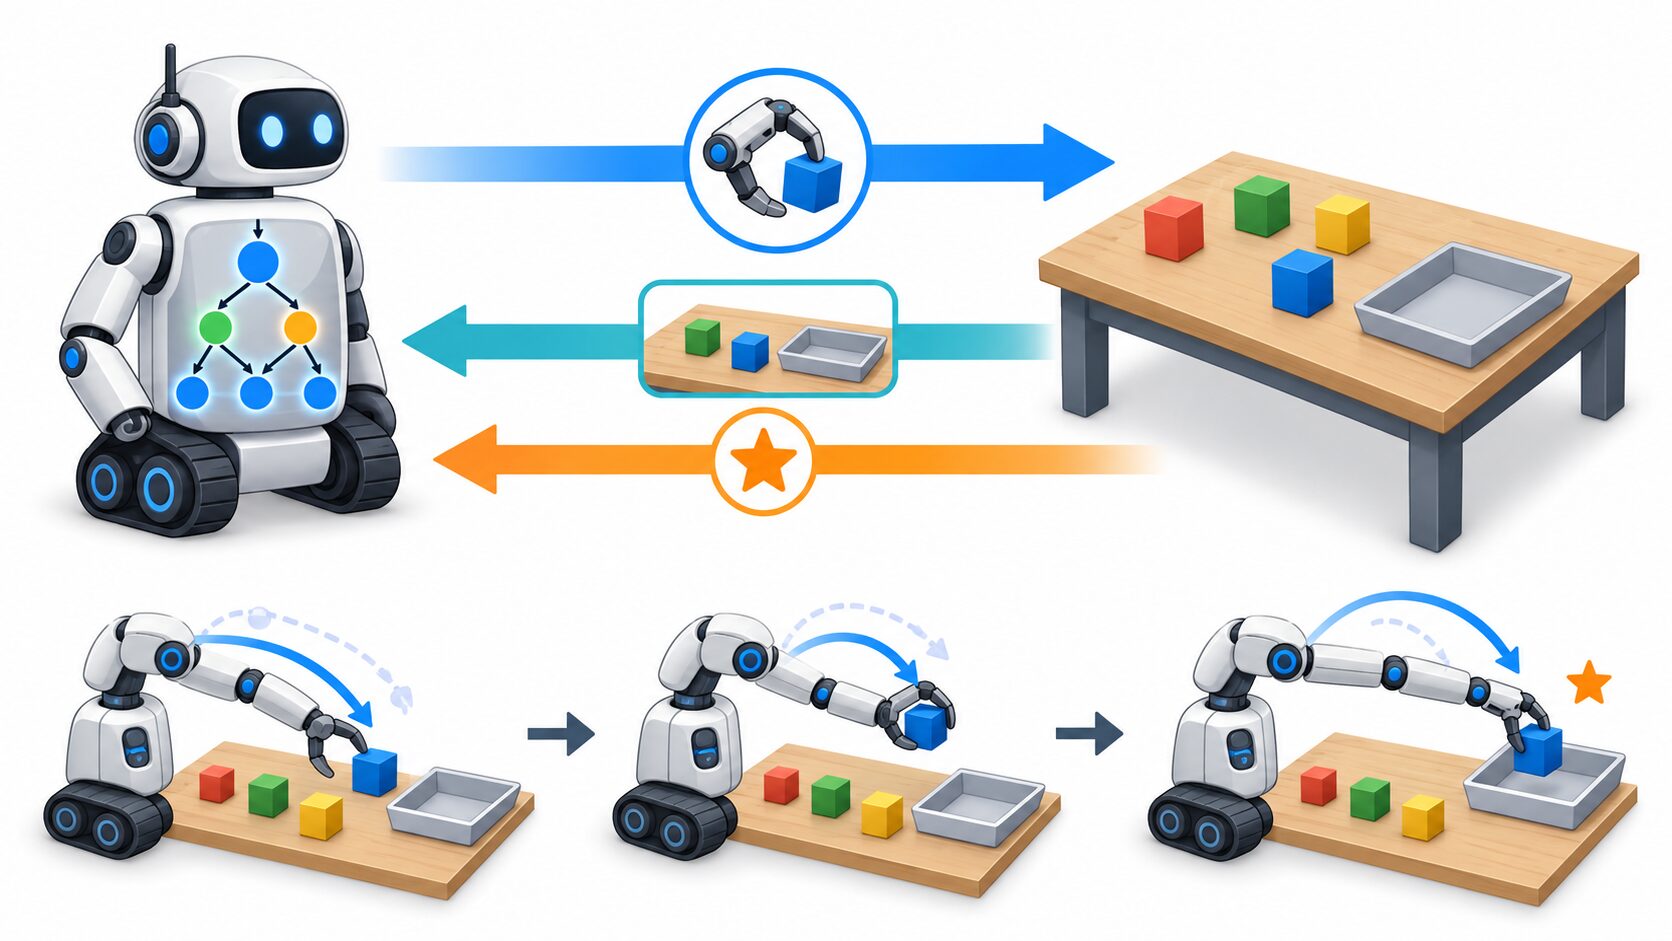
目標は、目先の報酬だけでなく、将来を含めた累積報酬を高めることです。ゲームでは、今すぐ得点できる動きよりも、数手後の勝利につながる動きのほうがよい場合があります。ロボットでも、最初に腕の位置を整える動作は、その場で成功の報酬を得られなくても、後で物をつかむために必要かもしれません。
教師あり学習では「この入力の正解はこれ」という例を使います。強化学習では、それぞれの状況で取るべき行動を正解ラベルとしてすべて与える代わりに、行動の結果を報酬で評価します。このため、行動が次の状況を変え、その影響が後から表れるような意思決定を扱えます。ただし、正解ラベルが不要でも、よい行動を学ぶための経験や報酬の設計は必要です。
学習中は、未知の行動を試す「探索」と、すでにうまくいくと分かっている行動を使うことの両立も課題になります。同じ成功パターンばかり使うと、もっとよい方法を見逃すかもしれません。一方、試すことばかりを優先すると、失敗や費用が増えるおそれがあります。
強化学習は、ロボット制御やゲームのほか、資源配分、広告配信、自動運転の制御などでも応用や研究の対象になっています。ただし、これらの分野の仕組みがすべて強化学習で作られているわけではありません。実環境で試行錯誤するには費用や安全上の制約があるため、シミュレーションや制限した環境での検証が重要になります。
さらに、報酬の数値を高める行動が、人の意図した行動と一致するとは限りません。ロボットに作業速度だけを評価させれば、丁寧な取り扱いが犠牲になる可能性があります。成功条件、失敗時の扱い、守るべき制約を決め、望ましくない行動が起きていないかも確かめる必要があります。
目的とデータに合わせた手法の選び方
手法を選ぶときは、最初に「何を得たいか」を言葉にします。新しいメールが迷惑メールかを当てたいのか、顧客の買い方を調べたいのか、ロボットの動作を改善したいのかによって、学習の手がかりも評価の仕方も変わるためです。三つの学び方の違いを、データと出力の面から比べてみましょう。
| 学び方 | 必要なデータ・経験 | 学習の手がかり | 得られる出力・仕組み | 主な用途 |
|---|---|---|---|---|
| 教師あり学習 | 入力と正解ラベル・目標値の組 | 正解と予測の対応や差 | カテゴリー、確率、数値などの予測 | 画像分類、迷惑メール判別、住宅価格や売上の予測 |
| 教師なし学習 | 正解ラベルを付けていないデータ | 類似性、分布、ばらつきなど | グループ分け、少ない次元での表現など | 顧客の傾向分析、データの可視化、前処理 |
| 強化学習 | 環境での状態・行動・報酬などの経験 | 行動が将来を含めて生む報酬 | 状況に応じて行動を選ぶ方策 | ゲーム、ロボット制御、資源配分など |
正解例から予測したいなら教師あり学習、データの構造を探りたいなら教師なし学習、行動の結果を評価して意思決定を改善したいなら強化学習が候補になります。そのうえで、分類・回帰・クラスタリングなどの課題を具体化し、適したアルゴリズムを検討します。学び方の区分と、解く課題の名前を分けて考えると、比較する対象を取り違えずに済みます。
ラベルの有無だけで手法を決めることはできません。たとえば、正解ラベルがなくても売上予測が目的なら、教師なし学習に切り替えるだけでは目的を満たせません。売上実績を集められるか、予測対象を見直す必要があるかを考えます。逆に、購入実績がそろっていても、目的が顧客の傾向探索ならクラスタリングを使う意味があります。
画像認識、音声認識、自然言語処理、商品の推薦、不正利用の検知などは、手法を利用する応用領域です。学び方と一対一に対応するわけではありません。たとえば不正検知では、過去の不正・正常の記録を使って分類する方法も、通常と異なるデータの傾向を探す方法もあります。商品の推薦でも、購入履歴や評価など、使える情報と目的に応じて複数の方法を組み合わせます。
具体的な候補を絞るときは、次の条件も確認します。
-
データの量と品質:十分な事例があるか、欠けた値やラベルの誤りはないか、利用したい場面を含んでいるか。
-
データの種類と特徴量:表形式の数値、画像、音声、文章のどれか。使う手法に適した表現へ変換できるか。
-
計算資源と応答時間:学習に使える時間や機器、予測を返すまでに許される時間はどの程度か。
-
説明の必要性:予測結果だけでよいか、なぜその判断になったのかを人が確認する必要があるか。
最初から複雑な方法だけを試すより、比較の基準となる「基準モデル(ベースライン)」を用意すると、改善の意味を判断しやすくなります。売上予測なら、過去の平均や前週の同じ曜日の売上を使う単純な予測が基準になります。同じ評価条件で機械学習モデルと比べ、誤差がどれだけ減るか、計算や運用の負担に見合うかを確認しましょう。
活用時に確認したい精度とデータの注意点
機械学習の性能は、学習に使ったデータでよい結果が出たかだけでは判断できません。大切なのは、実際に使う場面の、まだ見ていないデータに対して役立つ結果を出せるかです。これを確かめるには、データの分け方、評価指標、運用後の変化まで見る必要があります。
まず注意したいのが「過学習」です。学習データに含まれる偶然の特徴や細かな違いまで合わせすぎると、そのデータにはよく当たる一方、新しいデータで性能が落ちることがあります。決定木でごく少数の事例に合わせた分岐を増やしすぎるのは、その一例です。学習用と検証用の成績の差を確認し、モデルの複雑さを抑えるなどの対策を検討します。
「データ漏洩(データリーク)」にも気を付けましょう。ここでは、テストデータの情報や、本来の予測時点では利用できない情報が、学習や方法選びに入り込むことを指します。たとえば将来の売上を予測するのに、その日の閉店後にしか分からない来店者数を使うと、実際には再現できない条件で高い精度が出てしまいます。
前処理もデータ漏洩の原因になり得ます。欠けた値を平均で補う場合、その平均は学習用データから求め、同じ値を検証用・テスト用データに適用します。尺度をそろえるための基準も同様です。全データを使って基準を決めてから分割すると、評価用データの情報が事前に入ってしまいます。前処理とモデルを一連の処理として管理することが大切です。
データを無作為に分ければよいとは限りません。将来の売上を予測するなら、過去のデータで学び、より新しい時期のデータで評価するほうが利用条件に合います。同じ住宅や同じ利用者の記録が何度も含まれる場合も、学習側と評価側の重なりによって成績が高く見えていないかを確認します。
評価指標は、失敗したときの影響に合わせて選びます。不正取引が全体の1%なら、すべてを「正常」と答えるだけでも正解率は99%になりますが、不正を一件も見つけられません。このような場合は、正解率に加えて次の点を調べます。
-
見逃し:実際の不正を、どの程度検知できたか。「再現率」は、実際の不正のうち検知できた割合を表します。
-
誤検知:正常な取引を誤って不正扱いしていないか。「適合率」は、不正と判定したもののうち本当に不正だった割合を表します。
-
判定基準の影響:疑わしい取引を広く拾えば見逃しは減らせても、確認担当者の作業や利用者への影響が増える場合があります。
住宅価格や売上を予測する回帰では、予測と実績の差を評価します。たとえば「平均絶対誤差」は、差の大きさを平均した値で、価格予測なら円などの元の単位で解釈できます。平均だけでなく、特定の地域や高額な住宅で大きく外れていないかも見ると、実際の使いどころを判断しやすくなります。
データの偏りも性能に影響します。特定の地域、季節、顧客層に偏ったデータでは、別の条件で同じように当たるとは限りません。また、学習時には十分な性能があっても、商品の構成や利用者の行動が変われば、運用後に精度が下がる可能性があります。予測結果と実績を継続的に比べ、データやモデルを更新する必要があるかを点検します。
大量のデータや複雑な手法を使うだけで、よい結果が保証されるわけではありません。目的に合うデータをそろえ、前処理から学習までを適切に組み合わせ、未知のデータで確かめることが基本です。まず小さな基準モデルから始め、何が改善したかを確認しながら手法を選ぶと、学習にも実務での活用にもつなげやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月4日 | 三つの学び方と用語の違いを見直し、手法選択と評価時の注意点を追記 |