
次元圧縮とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「次元圧縮」ってどういう意味ですか?データの次元を下げると言われても、何を減らすのかイメージできません。

AI専門家
たとえば、りんご一つひとつを大きさ、重さ、糖度などの数値で表すとしよう。この数値の項目が「次元」だよ。次元圧縮では、多くの項目が持つ情報を、もっと少ない項目で表せるようにするんだ。
AIの初心者
りんごの数を減らすのではなく、りんごを表す項目を減らすんですね。元の項目から、必要なものを選ぶということですか?
AI専門家
項目を選ぶ方法もあるけれど、ここでは複数の項目を組み合わせて、新しい少数の軸を作る方法を中心に見ていこう。大きいりんごほど重い傾向があれば、大きさと重さを一つの軸にまとめられる。ただし、まとめると失われる違いもあるので、分析の目的に合うか確認することが大切だよ。
次元圧縮とは、データの重要な構造をなるべく残しながら、多数の特徴量を少数の特徴量で表す技術です。「次元削減」とも呼ばれ、データの可視化や機械学習の前処理に使われます。
たとえば、一つの商品を数十項目で表した表を、その商品の傾向を要約した数項目の表へ変換します。扱う数値が減れば、全体像を捉えたり、その後の計算を軽くしたりしやすくなります。この記事では、何を減らす技術なのかを確認し、代表的な手法の仕組み、活用例、導入時の判断ポイントへと進みます。
次元圧縮で減らす「次元」とは
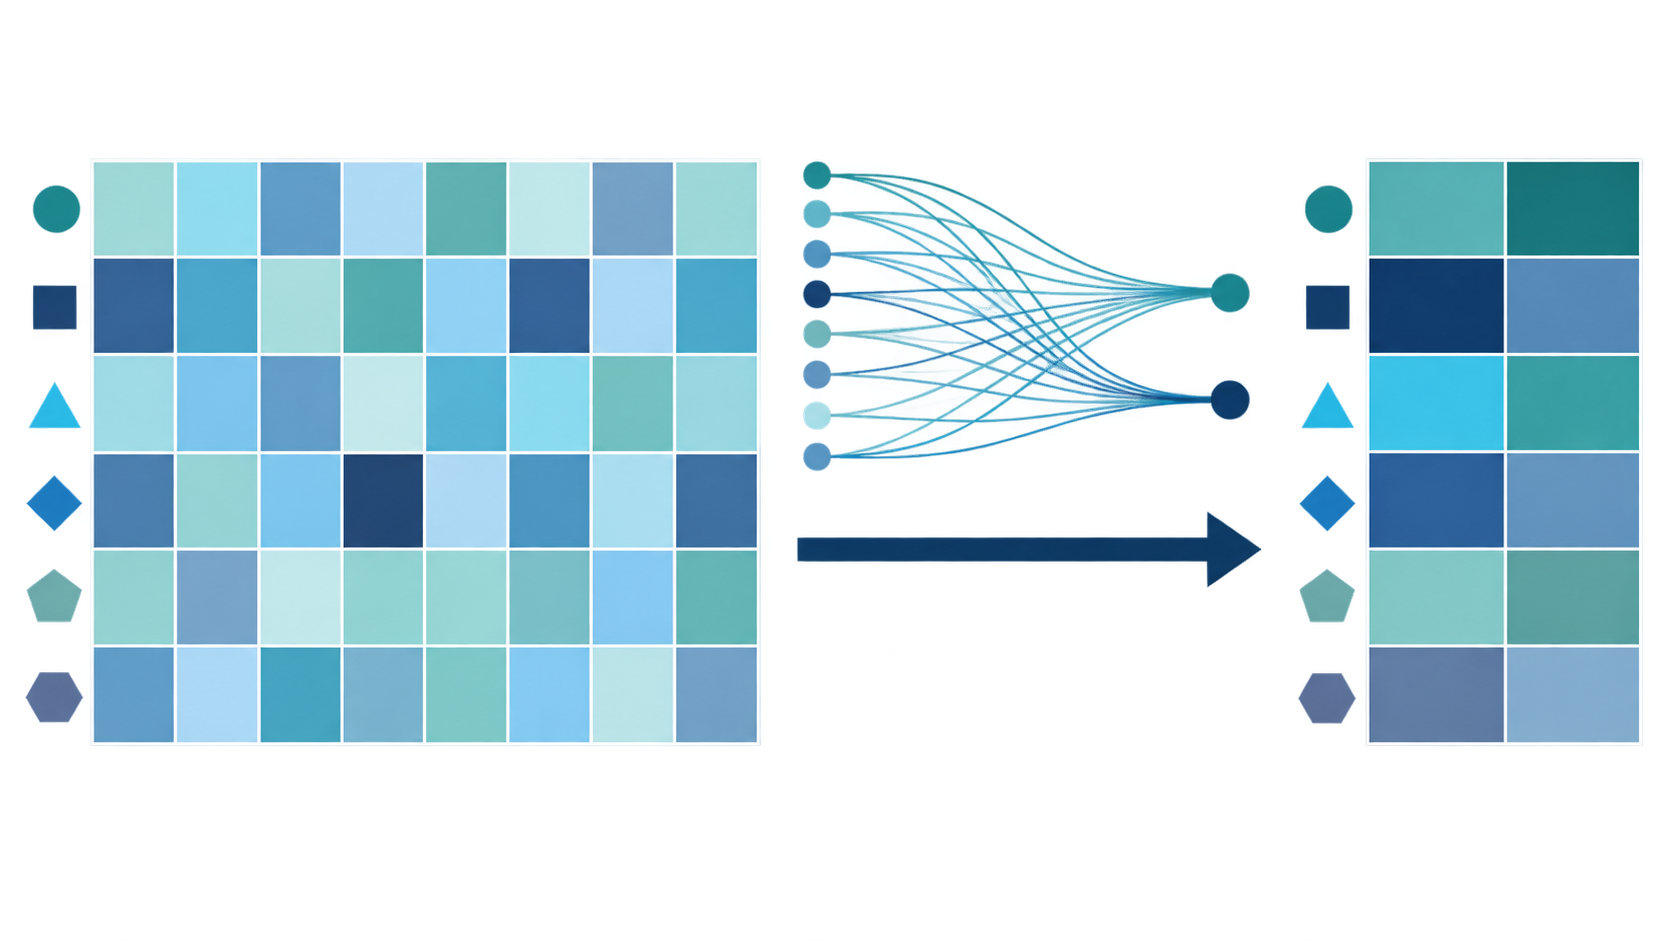
データ分析でいう次元は、基本的には一つの観測対象を表す特徴量の数を指します。表で考えると、行が観測対象、列が特徴量です。りんごを100個調べ、大きさ、重さ、糖度など8種類の数値を記録すれば、100行・8列のデータになります。
このデータを2次元へ圧縮する場合、通常は100個のりんごをそのまま残し、各りんごを2個の数値で表し直します。結果は100行・2列です。りんごを100個から20個へ間引くような、観測対象の数を減らす操作とは異なります。なお、産地のようなカテゴリ項目は、数値への変換方法によって複数の列になるため、元の表の項目数と分析時の次元数が一致しない場合もあります。
特徴量を減らす方法には、「特徴選択」と「特徴抽出」があります。大きさと重さのうち重さだけを使うのが特徴選択です。一方、大きさと重さを組み合わせ、全体的なサイズを表すような新しい軸を作るのが特徴抽出です。
| 方法 | 何をするか | りんごの例 |
|---|---|---|
| 特徴選択 | 元の特徴量の中から、使う項目を選ぶ | 大きさと重さのうち、重さだけを残す |
| 特徴抽出 | 元の特徴量を変換し、新しい特徴量を作る | 大きさと重さを組み合わせて、一つの主成分で表す |
広い意味での次元圧縮には両方を含めることがありますが、本記事では主に特徴抽出を扱います。複数の項目に共通する傾向は、単純に捨てる対象ではありません。むしろ、その傾向を少数の軸にまとめることで、重複した表現を減らします。
また、ZIPのように元の内容を完全に復元する可逆なファイル圧縮とも目的が違います。次元圧縮では、残す軸とともに捨てる情報を決めるため、一般には元の数値を完全には取り戻せません。保存容量だけでなく、「分析に必要な違いを残せるか」が重要になります。
次元圧縮が必要になる理由
特徴量が増えると、保存する数値や計算で扱う項目が増えます。たとえば、画像の画素値や多数のセンサーの測定値には、互いによく似た動きをする項目が含まれることがあります。こうした重複や測定ノイズを少数の特徴にまとめられれば、その後の学習や予測の負荷を減らせる可能性があります。ただし、計算量の増え方はモデルや処理方法によって異なり、特徴量が増えると必ず計算時間が爆発的に増えるわけではありません。
もう一つの理由が「次元の呪い」です。特徴量が増えるほど、データが取り得る組み合わせの範囲は広がります。各特徴量を五つの区間に分けて眺めるだけでも、2次元では25個だった区画が、3次元では125個になります。同じ件数のデータを配置すると、次元が高いほど観測されていない領域が増え、空間が疎になりやすいのです。
その結果、似たデータの傾向を安定して捉えるために、より多くの観測が必要になることがあります。また、データの分布や使う距離尺度によっては、近い点と遠い点の距離の差が相対的に小さくなります。近傍のデータを頼りに分類する方法などでは、どの点が本当に似ているのかを判断しにくくなる場合があります。
観測数に対して特徴量やモデルの自由度が大きすぎると、偶然の傾向まで学習する過学習にも注意が必要です。次元圧縮で余分な変動を減らせれば、未知のデータに対する予測が安定することがあります。さらに、2次元や3次元にすれば、人が散布図でデータの傾向を確かめられます。
ただし、次元を減らすこと自体が、精度の向上を保証するわけではありません。ノイズと一緒に、分類や予測に必要な手掛かりを消す可能性もあります。圧縮による利点と情報損失の両方を評価することが、導入の前提です。
主成分分析(PCA)の仕組み
主成分分析(PCA)は、データのばらつきが大きい方向を新しい軸にして、少数の軸でデータを表す手法です。りんごの大きさを横軸、重さを縦軸にした散布図を考えてみましょう。大きいりんごほど重い傾向があれば、点は右上がりの細長い範囲に集まります。
このとき、点の並ぶ方向に一本の軸を引き、各点をその軸へ投影します。投影とは、点から軸へ垂線を下ろし、その足の位置で元の点を表す操作です。大きさと重さの二つの数値が、軸に沿った一つの位置にまとまります。このように、最もばらつきが大きくなる方向に取った軸を第1主成分と呼びます。
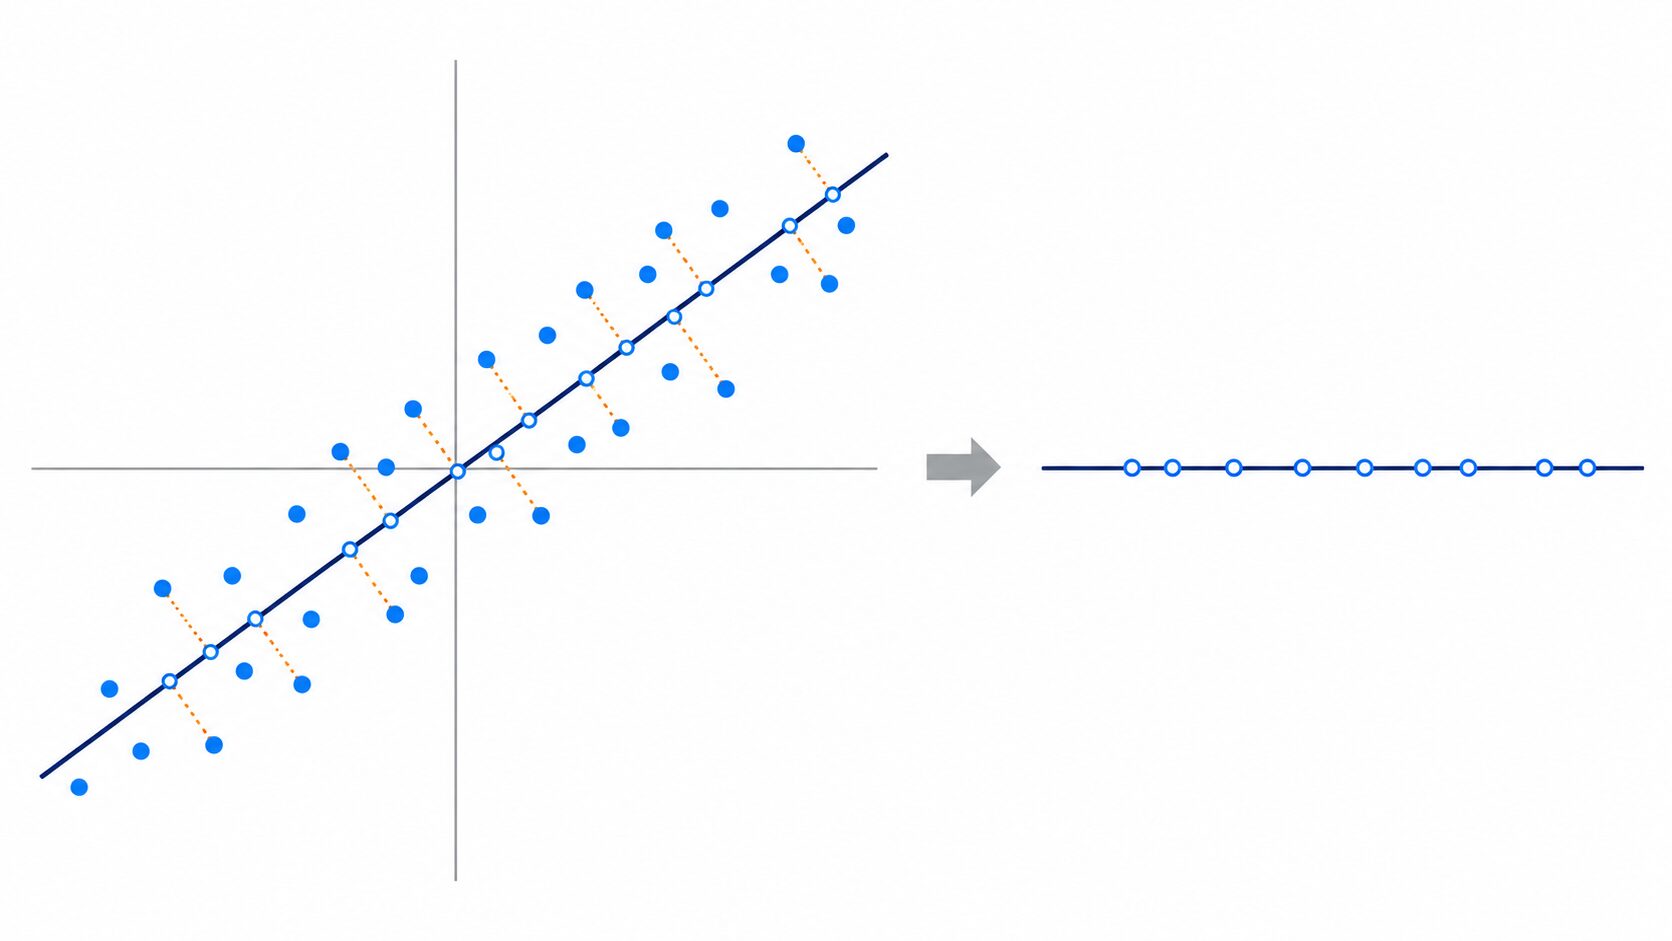
主成分は、元の特徴量にそれぞれ重みを付けて足し合わせたものです。そのため、元の項目を一つ選ぶ操作ではありません。また、同じ大きさでも少し重いりんごと軽いりんごがあるように、細長い点の集まりにも幅があります。一本の軸だけを残すと、その軸に垂直な方向の違いは表せなくなります。
第2主成分は、第1主成分と直交する方向の中から、ばらつきが最も大きい方向を選びます。第3主成分以降も、それまでに選んだ軸と直交するという条件の下で同様に求めます。先頭から必要な数の軸を残すことで、元のデータの変動を少数の成分で要約できます。ただし、新しい軸の意味は「大きさ」のように一言で説明できるとは限りません。
PCAは、予測したい値や正解ラベルを使わずに軸を決めます。りんごの甘さを当てたい場合でも、「甘さの違いがよく分かる方向」を直接探すわけではありません。全体のサイズの違いが大きければ、その方向を優先する一方、変動が小さくても甘さと関係の深い成分を捨てることがあります。分散を多く残すことと、予測に役立つ情報を残すことは同じではないのです。
前処理では、中心化と標準化を区別します。中心化は各特徴量から平均値を引き、平均をゼロにそろえる操作です。標準化は通常、さらに標準偏差で割り、特徴量ごとの数値の尺度もそろえます。一般的なPCAは中心化したデータを扱いますが、標準化まで自動で行われるとは限りません。
たとえば、大きさをセンチメートル、重さをグラムで記録すると、数値の尺度の違いが主成分の向きに影響します。単位の異なる特徴量を同程度に扱いたい場合は標準化が候補になります。一方、同じ単位で測った値のばらつきの大きさ自体に意味があるなら、標準化が適切とは限りません。何の違いを残したいのかに合わせて判断します。
残した主成分が全体の分散のどれだけを説明するかを足し合わせた指標が「累積寄与率」です。たとえば累積寄与率90%なら、分析に使ったデータの分散の90%を、選んだ主成分で表しているという意味です。これは元データの意味を90%保存したことでも、予測が90%当たることでもありません。
線形判別分析・多様体学習との使い分け
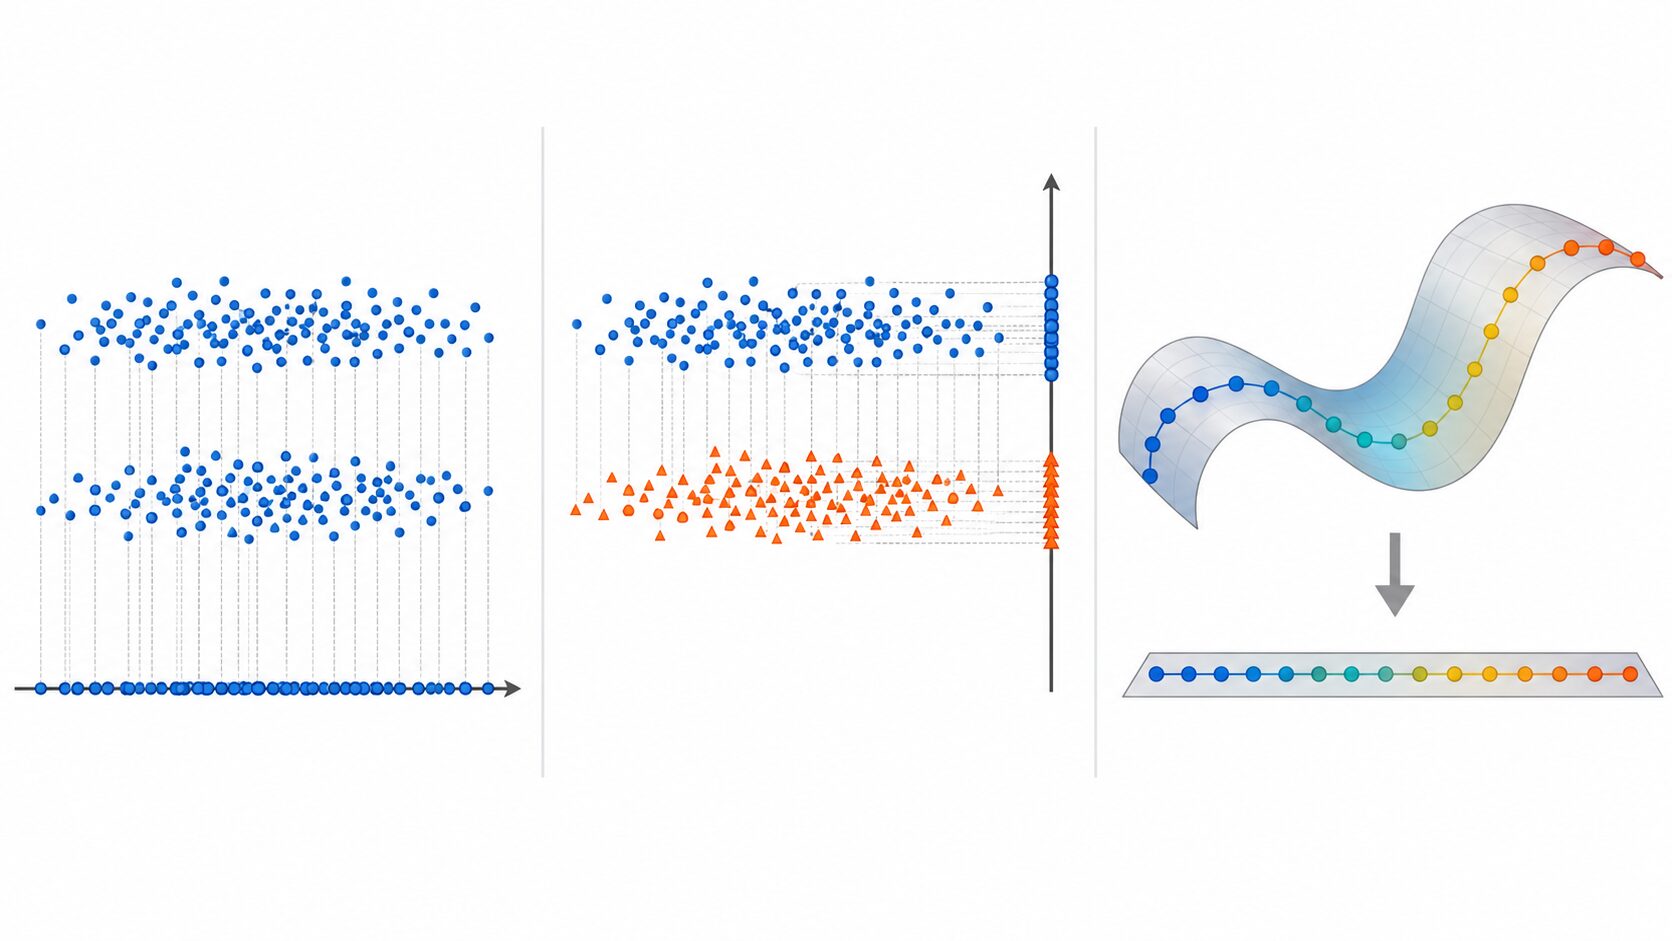
線形判別分析(LDA)は、クラスのラベルを利用する手法です。次元圧縮として使う場合は、同じクラスの中のばらつきに対して、異なるクラスの中心がよく離れるような軸を探します。りんごとみかんの測定値なら、「どの点がりんごで、どの点がみかんか」という情報を学習時に与えます。
PCAが全データの散らばりを重視するのに対し、LDAはクラスを区別する方向を重視します。たとえば、大きさの違いが目立っていても、りんごとみかんの区別には別の特徴の組み合わせが役立つかもしれません。そのようなとき、二つの手法で選ばれる軸は異なります。ただし、LDAも直線的な組み合わせを使うため、複雑なクラスの境界を必ず表せるわけではありません。次元圧縮で得られる軸の数にも制限があり、2クラスの場合は最大1次元になります。
一方、多様体学習は、高次元空間の中でデータが低次元の曲がった構造に沿って分布している場合に、その構造を捉えようとする考え方です。たとえば、丸めた紙の表面に点が並んでいる状態を想像してください。紙は3次元空間の中で曲がっていますが、表面上の位置は二つの座標で表せます。横から平面へ押しつぶすだけでは、紙の離れた部分が重なります。多様体学習では、表面に沿ったつながりなどを手掛かりに、こうした構造を低い次元で表そうとします。
| 手法 | ラベルの利用 | 残そうとする構造 | 主な用途・判断の目安 |
|---|---|---|---|
| 主成分分析(PCA) | 使わない | 分散の大きい方向に沿った変動 | 全体的な傾向の要約、可視化、予測の前処理 |
| 線形判別分析(LDA) | 使う | クラス内のばらつきに対するクラス間の分離 | 正解ラベルがある分類問題の特徴抽出 |
| 多様体学習 | 一般的には使わないが、手法による | 局所的な近傍関係や構造に沿った距離など | 曲がった構造の探索や可視化。保持する関係を確認して選ぶ |
多様体学習は単独のアルゴリズムではなく、複数の手法を含む総称です。どの範囲の距離や近傍関係を残すか、学習後に新しいデータを同じ空間へ変換できるかは、手法や実装によって異なります。見やすい散布図が得られることと、継続的な予測処理に組み込みやすいことは別の条件として確かめましょう。
可視化への応用と散布図の読み方
数百、数千の特徴量をそのまま眺めても、データ全体の傾向は捉えにくいものです。次元圧縮で2次元や3次元に変換すると、各観測対象を散布図の点として配置できます。似た対象が集まる場所や、ほかの点から外れた対象を探す手掛かりになります。
遺伝子発現量のデータを例にしましょう。ここでは、行を試料、列を遺伝子とし、各セルにその試料での遺伝子の発現量が入っている表を考えます。この表の列を2次元へ圧縮すると、散布図の一点は、一つの試料を表します。100試料を調べたなら、圧縮後も100個の点です。一点が一つの遺伝子を示すわけではありません。遺伝子同士の関係を見たい場合は、何を行に置くかを含め、分析の設計が変わります。
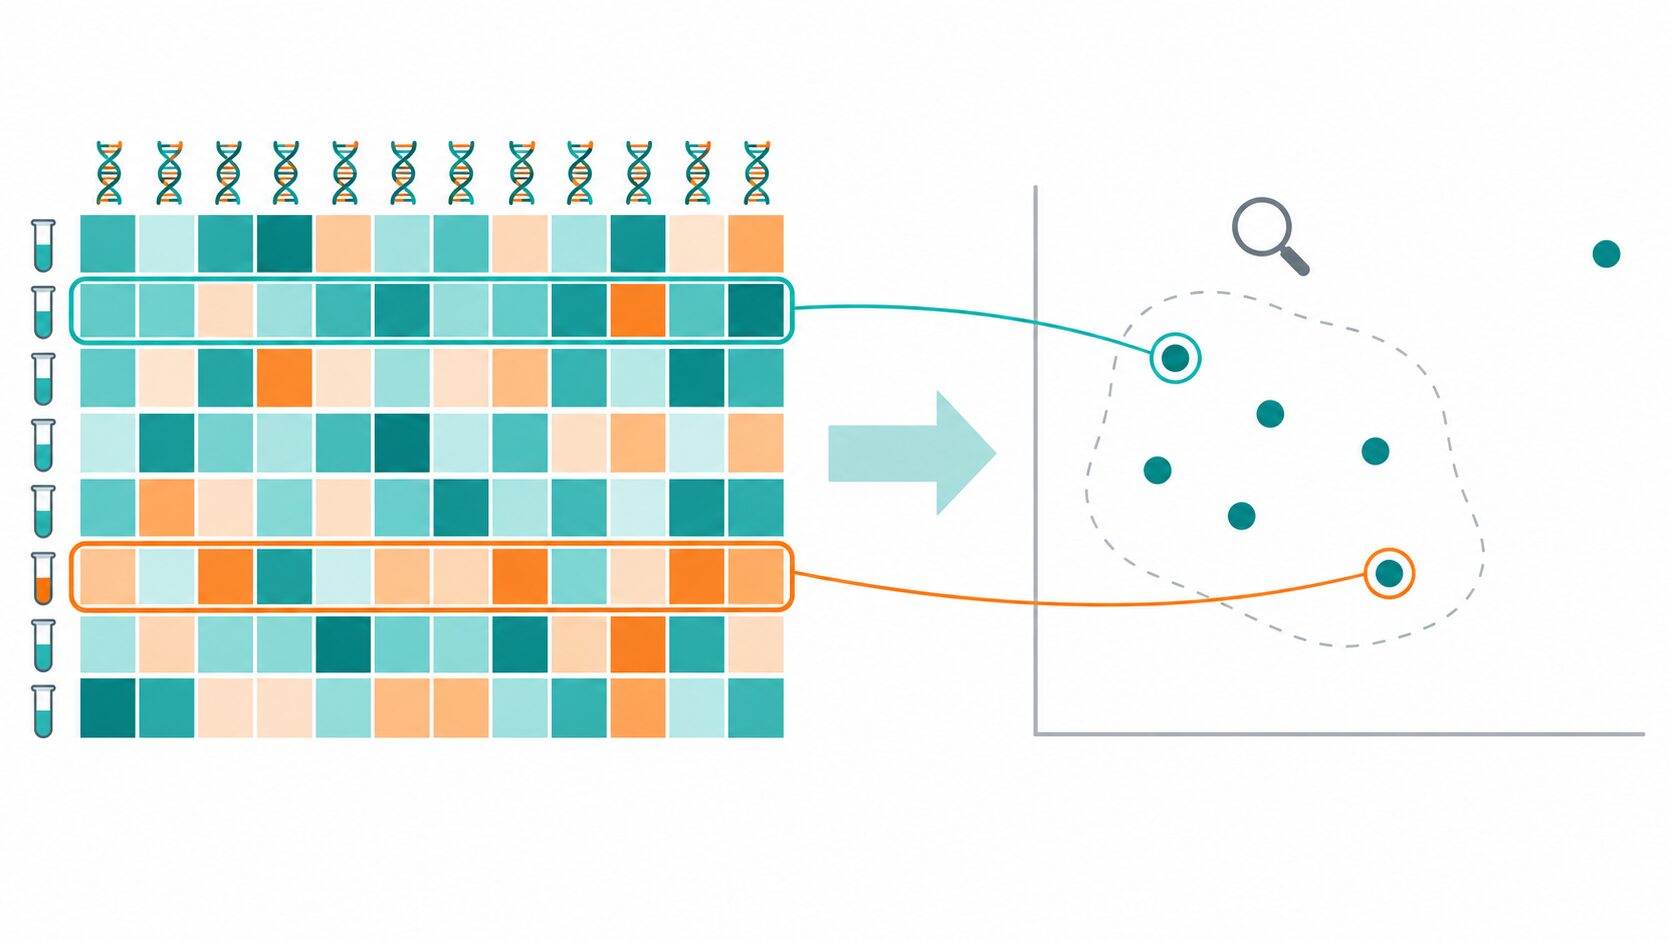
試料の点がいくつかの集まりに分かれたら、実験条件や採取条件との対応を調べます。離れた点があれば、特殊な試料なのか、測定上の問題なのかを元の記録で確認します。このように、可視化は仮説を立て、次に調べる対象を絞るために役立ちます。ただし、点の集まりだけで分類の正しさや因果関係が確定するわけではありません。
散布図の読み方には手法による違いもあります。PCAなら、表示した主成分の寄与率が低いと、図に表れていない変動が多く残っています。近い点同士の関係を重視する手法では、図で離れた群の距離や群の面積が、元データの距離やばらつきの大きさをそのまま表すとは限りません。
同じデータでも、手法、設定、場合によっては乱数の条件によって配置が変わります。見た目の印象だけで結論を出さず、元の特徴量、対象の属性、条件を変えた場合の結果を照らし合わせると、解釈の誤りを減らせます。
画像・文章・売上予測での活用
画像では、一枚の画像を多数の画素値で表せます。たとえば、縦横100画素のカラー画像を赤・緑・青の値で並べると、一枚につき3万個の数値になります。背景や照明の変化なども含むこの表現を少数の特徴へまとめ、認識モデルに渡すことで、処理するデータ量やノイズを減らすことを狙えます。
ただし、細部を落としてよいかは用途によります。大まかな形が分かればよい分類と、小さな傷を見つける検査では、必要な情報が違います。全体の見た目を保てていても、欠陥のような小さい特徴が消えれば、その圧縮は目的に合いません。画像の用途では、圧縮率だけでなく、見逃したくない違いが残るかを確認します。
文章では、単語の出現頻度などを使って文書を数値化すると、語彙の数に応じて次元が大きくなります。複数の単語が一緒に現れる傾向などを少数の特徴にまとめれば、文書分類や類似度計算に利用できます。多数の単語を個別に扱うより計算を軽くできる可能性がありますが、文章の意味や単語間の関係が必ず保存されるわけではありません。まれでも分類に重要な語や、否定に関わる情報などが十分に残るかは、利用する表現や圧縮手法に左右されます。
売上予測なら、価格、広告費、来店者数、季節に関する指標などを入力にできます。互いに似た動きをする特徴量が多い場合は、それらを圧縮してから予測モデルへ渡す方法が候補になります。ただし、PCAを使う場合は、売上との関係を見て軸を選ぶわけではありません。日々の変動が小さい指標でも売上の予測には重要なことがあり、低分散の成分を捨てた結果、予測誤差が増える可能性もあります。
こうした用途に共通する判断基準は、圧縮前後で、予測の誤差や分類性能と処理時間を比較することです。たとえば売上予測では、同じ検証期間を使って予測誤差を測り、学習時間や予測時間がどれだけ変わるかを確かめます。後段のモデルが速くなっても、圧縮に時間がかかる場合があるため、変換を含む処理全体で判断します。
次元数の決め方と実務上の注意点
残す次元数に、すべてのデータへ通用する正解はありません。可視化が目的なら通常は2次元や3次元が候補になりますが、予測用の特徴抽出なら、そこまで減らす必要はありません。最初に「何を見たいのか」「どの性能を保ちたいのか」「どの処理を軽くしたいのか」を決めると、手法と次元数の選択がしやすくなります。
予測モデルに組み込む場合は、次の順序で進めます。特に、標準化と次元圧縮も、データから変換の規則を学ぶ処理であることを意識しましょう。
-
評価に使うデータを先に分ける。訓練データと検証データを分け、最終評価用のテストデータを設ける場合は、それも確保します。将来の売上を予測するなら、過去で学習して将来で評価するなど、実際の利用場面に合った分割にします。
-
欠損値と尺度の扱いを決める。未測定の値をどう扱うか、異なる単位の特徴量を標準化するかを検討します。平均値による補完や標準化を使う場合、その平均値や標準偏差は訓練データだけから求めます。外れ値が主成分の向きに強く影響していないかも確認します。
-
訓練データで圧縮の規則を学習する。PCAなら、訓練データから主成分の軸を求めます。検証データには、訓練データで決めた補完・標準化・圧縮の変換をそのまま適用します。検証データ側で別の軸を学習すると、同じ座標の意味が変わってしまいます。
-
候補の次元数を比較する。同じ分割と評価指標で、圧縮しない場合と、いくつかの次元数へ圧縮した場合を比べます。予測性能、処理時間、必要なメモリなどを確認し、目的を満たす設定を選びます。
-
設定を決めた後に最終評価する。テストデータを用意した場合は、次元数の選択に繰り返し使わず、決めた手順の最終確認に使います。検証結果に合わせすぎることによる評価の楽観化を避けるためです。
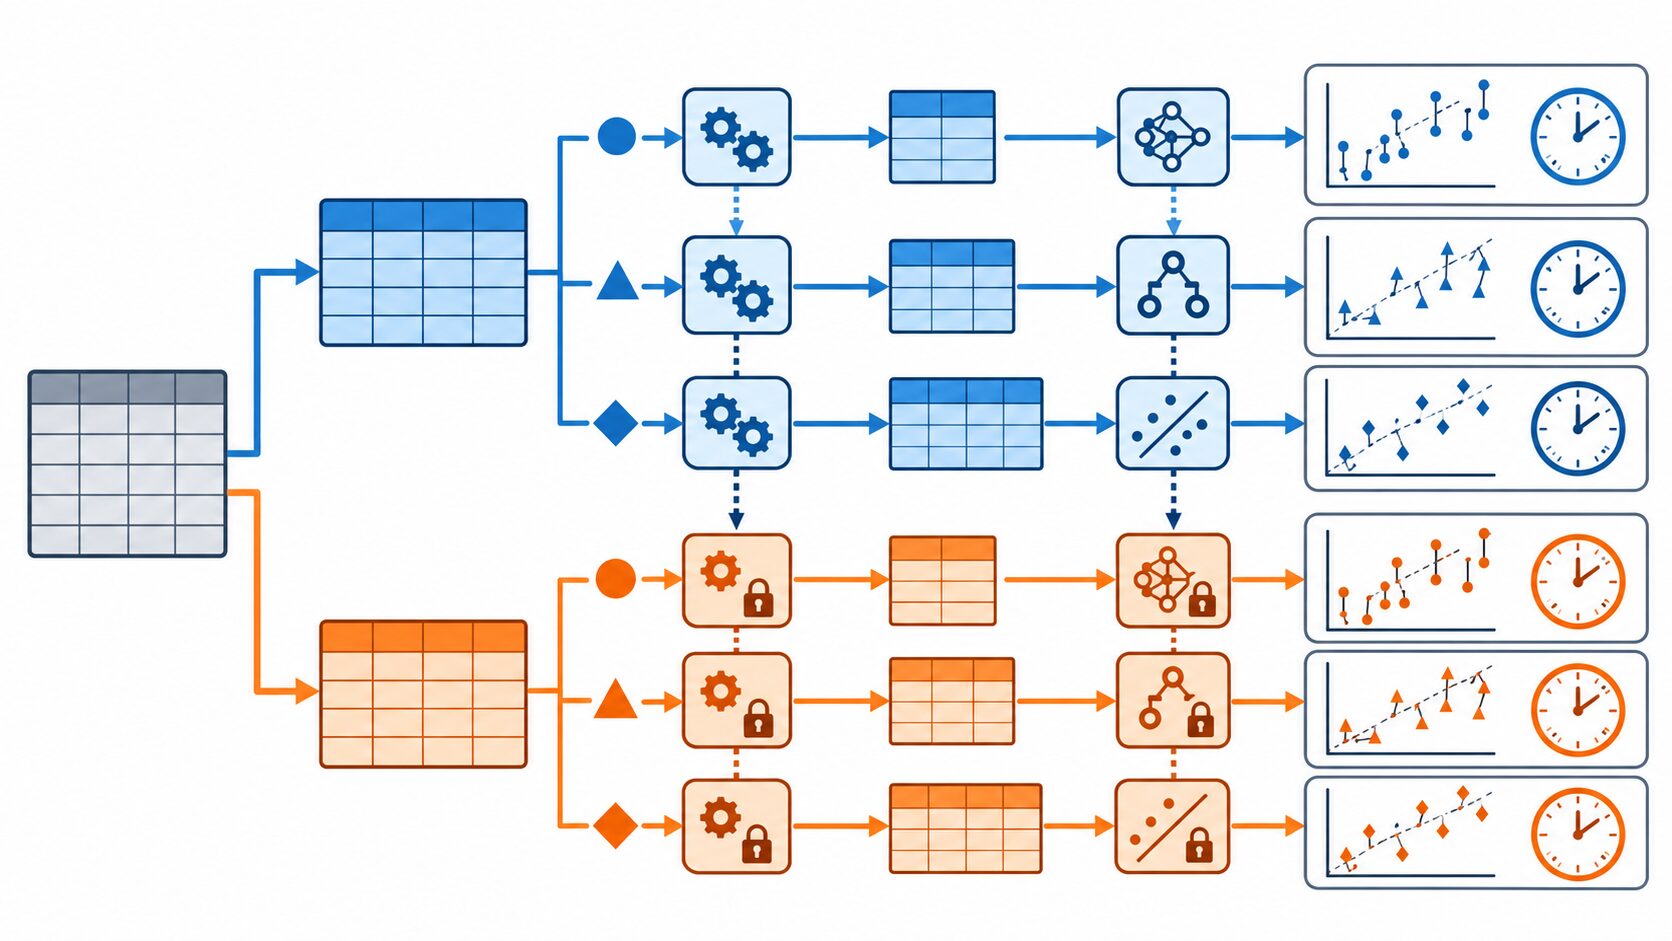
全データを標準化・圧縮してから訓練用と検証用に分けると、検証側の情報が学習に入り込むおそれがあります。正解ラベルを使わないPCAでも、データの分布を使って軸を決めるため、この情報漏洩は起こり得ます。交差検証を使う場合も、分割ごとの訓練部分で補完、標準化、圧縮を学習し直します。
PCAの累積寄与率は次元数の候補を絞る目安になりますが、「90%以上なら十分」と一律に決めるのは適切ではありません。予測が目的なら検証性能を優先し、元のデータをどの程度近似できるかが重要なら、再構成誤差も確認します。再構成誤差とは、圧縮した特徴から元の空間へ戻した近似値と、元の値との差です。これが小さくても、特定のクラスを見分ける情報まで十分に残っているとは限りません。
説明のしやすさも判断材料です。「広告費が増えた」といった元の特徴量は理解しやすい一方、複数の項目を混ぜた成分は、意味を説明するのが難しくなる場合があります。PCAなら各特徴量の重みを調べると解釈の手掛かりになりますが、説明責任が重い用途では、特徴選択や圧縮しないモデルも比較対象に入れましょう。
今後の展望としては、画像や文章などのデータ構造に合う手法の改良と、大規模なデータを効率よく扱う工夫が挙げられます。量子計算のような新しい計算方式に期待する場合も、それだけで実用的な優位性が決まるわけではありません。入力の準備や利用環境を含め、既存の方法と比較して効果を確かめる必要があります。
次元圧縮を使う際は、少ない次元で表せたかだけでなく、必要な違いが残ったかを確認してください。可視化では元データと照合し、予測では未知のデータに対する性能を測ることが、手法を適切に使い分ける基本になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月3日 | 特徴選択との違いとPCAの説明を修正し、手法比較と評価手順を追記 |