
偽陽性と偽陰性とは?違い・仕組み・活用例をわかりやすく解説

AIの初心者
「偽陽性」と「偽陰性」は、どう違うんですか?「第一種の過誤」「第二種の過誤」との関係も知りたいです。

AI専門家
検査を例にすると、対象の病気がないのに陽性と出るのが「偽陽性」、対象の病気があるのに陰性と出るのが「偽陰性」だよ。誤って検出するのか、見逃すのかという違いなんだ。
AIの初心者
なるほど。陽性や陰性という結果だけを見るのではなく、実際に対象の病気があるかどうかと比べるんですね。
AI専門家
その通り。まず「何を陽性とするか」を決め、実際の状態と判定結果を分けて考えよう。第一種・第二種の過誤は統計の用語で、仮説の置き方によって偽陽性・偽陰性に対応するよ。
偽陽性は「対象がないのに、あると判定する誤り」、偽陰性は「対象があるのに、ないと判定する誤り」です。英語ではそれぞれ false positive、false negative といい、FP、FNと略します。迷惑メールの振り分け、病気の検査、不良品の検出など、対象に該当するかどうかを二つに分ける場面で使う考え方です。
二つの違いを理解すると、AIの判定がどのように間違ったのか、その誤りで何が起こるのかを具体的に考えられます。この記事では、実際の状態と予測を整理する混同行列から始め、第一種・第二種の過誤との関係、評価指標の計算、誤りを減らす運用まで順に見ていきます。
偽陽性と偽陰性の違いを混同行列で整理
機械学習で、メールを「迷惑メール」と「通常のメール」のような二つのクラスに分けることを二値分類といいます。このとき、検出対象に該当する側を陽性、該当しない側を陰性と定義します。陽性は「正しい」、陰性は「間違い」という意味ではありません。たとえば迷惑メールを検出したいなら、迷惑メールが陽性、通常のメールが陰性です。
分類の結果は、実際の状態とモデルの予測を組み合わせて四つに分かれます。それを表にしたものが混同行列です。次の表は、行が実際の状態、列がモデルの判定を表しています。
| 実際の状態 \ モデルの判定 | 陽性と判定:迷惑メール | 陰性と判定:通常のメール |
|---|---|---|
| 実際は陽性:迷惑メール | 真陽性(TP):迷惑メールを正しく検出 | 偽陰性(FN):迷惑メールを見逃す |
| 実際は陰性:通常のメール | 偽陽性(FP):通常のメールを誤って検出 | 真陰性(TN):通常のメールを正しく通す |
真陽性の英語は true positive、真陰性は true negative です。「真・偽」は判定が実際の状態と合っているかを、「陽性・陰性」はどちらと判定したかを表します。この読み方を使えば、偽陽性は「陽性という判定が誤り」、偽陰性は「陰性という判定が誤り」と整理できます。
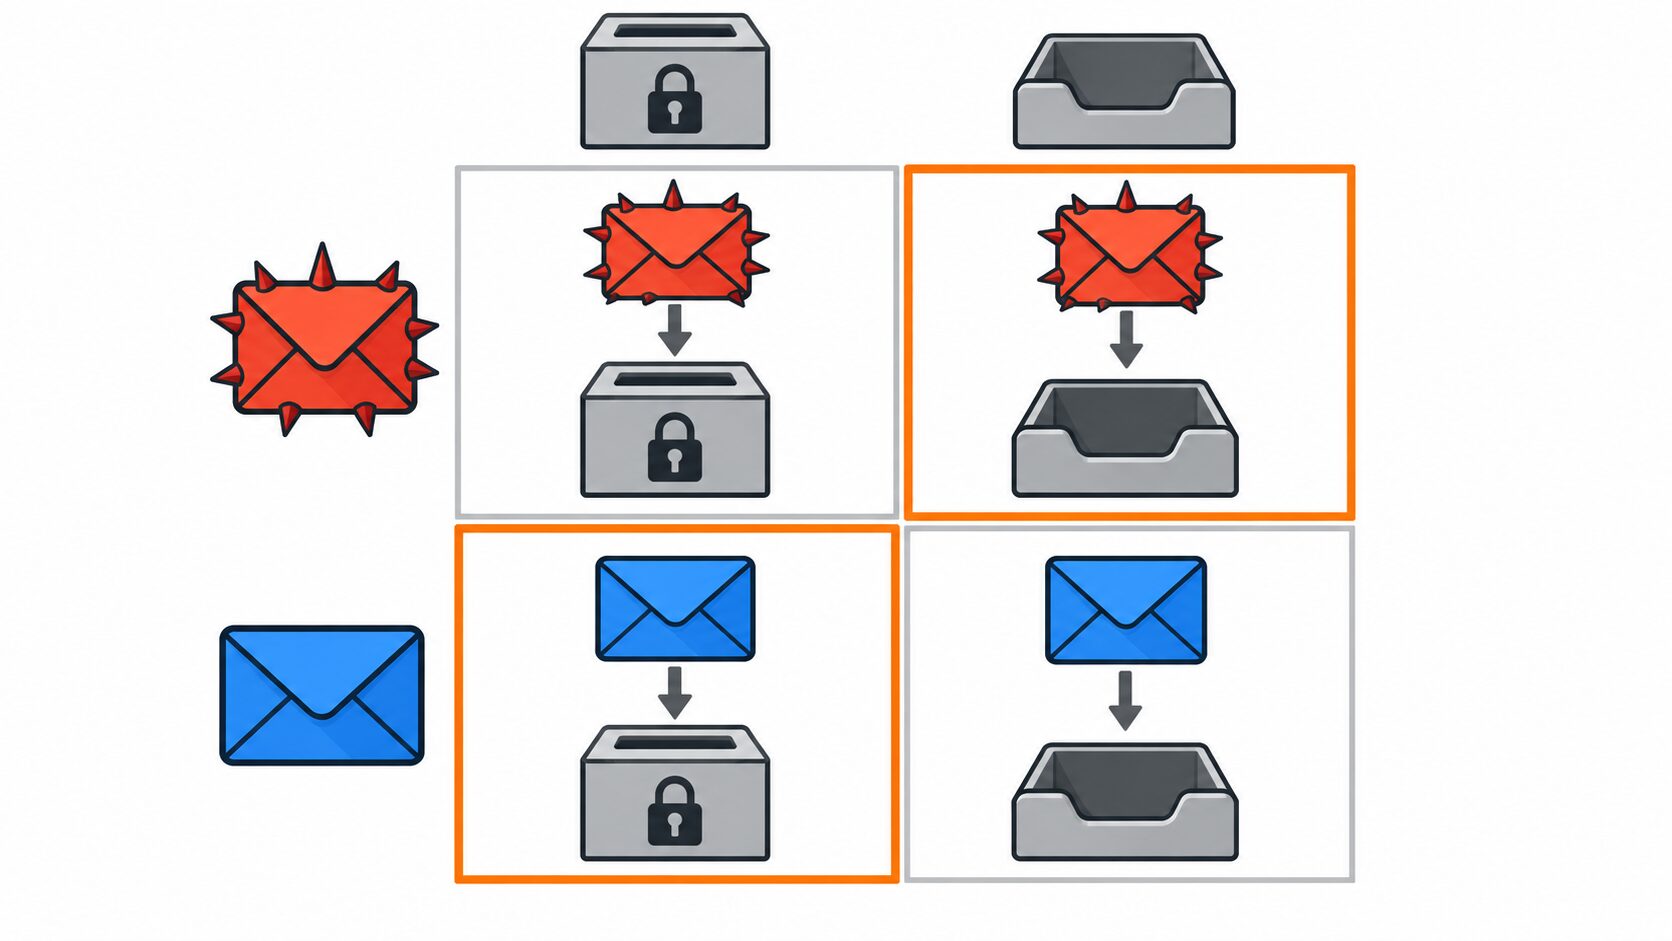
なお、混同行列は資料によって行と列の向きやクラスの並びが異なります。左上だからTPと覚えるのではなく、軸のラベルを確認してください。陽性にするクラスを入れ替えるとFPとFNの対応も変わるため、比較の前に陽性の定義をそろえることが大切です。
誤検出と見逃しがもたらす影響
偽陽性は誤検出、偽陰性は見逃しと説明できます。ただし、誤りの名前だけで影響の大きさは決まりません。何を検出するのか、判定後にどのような処理が行われるのかによって、必要な対策は変わります。
病気の検査では、対象の病気がある状態を陽性とします。病気がないのに検査で陽性と出る偽陽性は、追加検査の費用や時間、不安につながることがあります。結果の扱い方によっては、不要な治療やその負担につながる可能性もあります。一方、病気があるのに陰性と出る偽陰性は、発見や治療の開始が遅れる原因になり得ます。
ここで区別したいのが、検査結果と確定診断です。ある検査で陽性と出ることは、その病気があると確定することと同じではありません。検査の位置づけや、ほかの情報と合わせた確認の手順まで含めて考える必要があります。陰性についても、対象の病気がないことを必ず保証する結果ではありません。
迷惑メールの判定では、重要な通常メールを迷惑メールフォルダーに入れてしまうのが偽陽性です。利用者にとっては「大切な連絡を見逃す」ことになりますが、分類上は、通常メールを迷惑メールとして誤検出したためFPに当たります。日常語の「見逃し」と、分類上の偽陰性を混同しないようにしましょう。
逆に、本当の迷惑メールが受信箱を通過するのは偽陰性です。不要な広告なら削除の手間が増えますし、フィッシングメールなら認証情報の流出や金銭的な被害につながる可能性があります。
| 場面と陽性の定義 | 偽陽性(FP)の例と影響 | 偽陰性(FN)の例と影響 |
|---|---|---|
| 病気の検査:対象の病気がある | 病気がないのに陽性と出る。追加検査、不安、不要な治療などの負担につながる可能性 | 病気があるのに陰性と出る。発見・治療が遅れる可能性 |
| メールの振り分け:迷惑メールである | 通常メールを隔離する。大切な連絡に気づかず、対応が遅れる可能性 | 迷惑メールを通す。不要なメールへの対応やフィッシング被害につながる可能性 |
「医療では偽陽性の影響は小さい」「迷惑メールの偽陰性は削除すれば済む」と一律に考えることはできません。被害の大きさに加え、誤りに気づけるか、結果を取り消せるか、確認にどれだけ負担がかかるかを比べて、優先して減らす誤りを決めます。
第一種・第二種の過誤との関係
第一種の過誤と第二種の過誤は、統計の仮説検定で使う用語です。第一種の過誤が起こる確率を \(\alpha\)、第二種の過誤が起こる確率を \(\beta\) と表します。まずは、検定で何を判断しているのかを押さえましょう。
仮説検定では、たとえば「新しい機能に効果はない」という帰無仮説を置き、集めたデータからその仮説を棄却するかどうかを判断します。棄却とは、帰無仮説と両立しにくい結果が得られたとして、その仮説を退けることです。ここでも、仮説が実際に正しいかどうかと、検定の判断は分けて考えます。
| 実際の状態 | 帰無仮説を棄却する | 帰無仮説を棄却しない |
|---|---|---|
| 帰無仮説が真 | 第一種の過誤:正しい帰無仮説を退ける | 正しい判断 |
| 帰無仮説が偽 | 正しい判断 | 第二種の過誤:誤った帰無仮説を退けられない |
「効果はない」という帰無仮説を棄却したときを「効果を検出した=陽性」とすれば、効果がないのに検出する第一種の過誤は偽陽性、効果があるのに検出できない第二種の過誤は偽陰性に対応します。この対応は、帰無仮説と陽性をどう定義したかを前提とするものです。分類モデルのFP・FNと仮説検定の過誤を、条件を確認せずに同じものとして扱わないようにしましょう。
また、帰無仮説を「棄却しない」ことは、その仮説が正しいと証明したことではありません。データが少ない、ばらつきが大きい、効果が小さいといった理由で、効果を検出するだけの証拠が得られない場合もあるからです。
検定では、帰無仮説が真のときに第一種の過誤が起こる確率を一定以下に抑えるよう、事前に有意水準を設定します。たとえば有意水準5%は、その上限を5%にするという考え方です。「有意という結果が出たら、その結果が誤りである確率は5%」という意味ではありません。
第二種の過誤の確率 \(\beta\) は、想定する効果の大きさ、標本数、データのばらつき、有意水準などで変わります。効果があるときにそれを検出できる確率は \(1-\beta\) で、検出力と呼びます。有意水準を決めただけでは検出力は決まらず、どの程度の効果を検出したいかも含めて検討する必要があります。
偽陽性率・偽陰性率と適合率・再現率
誤りの件数だけでは、対象数が異なるモデルや期間を比べにくいため、割合を使って評価します。代表的な式は、偽陽性率が \(\mathrm{FPR}=\frac{\mathrm{FP}}{\mathrm{FP}+\mathrm{TN}}\)、偽陰性率が \(\mathrm{FNR}=\frac{\mathrm{FN}}{\mathrm{FN}+\mathrm{TP}}\) です。
偽陽性率の分母は「実際に陰性だったもの」、偽陰性率の分母は「実際に陽性だったもの」です。どの集団を基準にするかによって、数値の意味が変わります。関連する指標も、分母に注目すると区別しやすくなります。
| 指標 | 計算式 | 何を表すか |
|---|---|---|
| 偽陽性率(FPR) | \(\frac{\mathrm{FP}}{\mathrm{FP}+\mathrm{TN}}\) | 実際の陰性のうち、誤って陽性と判定した割合 |
| 偽陰性率(FNR) | \(\frac{\mathrm{FN}}{\mathrm{FN}+\mathrm{TP}}\) | 実際の陽性のうち、見逃した割合 |
| 再現率・感度(Recall) | \(\frac{\mathrm{TP}}{\mathrm{TP}+\mathrm{FN}}\) | 実際の陽性のうち、正しく検出した割合 |
| 特異度(Specificity) | \(\frac{\mathrm{TN}}{\mathrm{TN}+\mathrm{FP}}\) | 実際の陰性のうち、正しく陰性と判定した割合 |
| 適合率(Precision) | \(\frac{\mathrm{TP}}{\mathrm{TP}+\mathrm{FP}}\) | 陽性と判定したもののうち、実際に陽性だった割合 |
| 正解率(Accuracy) | \(\frac{\mathrm{TP}+\mathrm{TN}}{\mathrm{TP}+\mathrm{TN}+\mathrm{FP}+\mathrm{FN}}\) | 全体のうち、正しく判定した割合 |
再現率と偽陰性率は、同じ「実際の陽性」を検出と見逃しに分けたものなので、合計すると100%になります。同様に、特異度と偽陽性率も合計100%です。一方、適合率は「陽性と判定した集団」を見ているため、偽陽性率とは分母が異なります。
仮に1,000通のメールのうち、実際の迷惑メールが100通、通常メールが900通あったとします。次の混同行列は、迷惑メール90通を検出し、通常メール45通を誤って迷惑メールと判定した例です。
| 実際の状態 \ モデルの判定 | 迷惑メールと判定 | 通常メールと判定 | 合計 |
|---|---|---|---|
| 迷惑メール | TP:90通 | FN:10通 | 100通 |
| 通常メール | FP:45通 | TN:855通 | 900通 |
| 合計 | 135通 | 865通 | 1,000通 |
- 偽陽性率は、通常メール900通中の誤検出45通なので、45÷900=5%です。
- 偽陰性率は、迷惑メール100通中の見逃し10通なので、10÷100=10%です。
- 再現率は、迷惑メール100通中の検出90通なので、90÷100=90%です。
- 特異度は、通常メール900通中の正しい判定855通なので、855÷900=95%です。
- 適合率は、迷惑メールと判定した135通中の本当の迷惑メール90通なので、90÷135≒66.7%です。
- 正解率は、正しく判定した945通を全1,000通で割るため、945÷1,000=94.5%です。
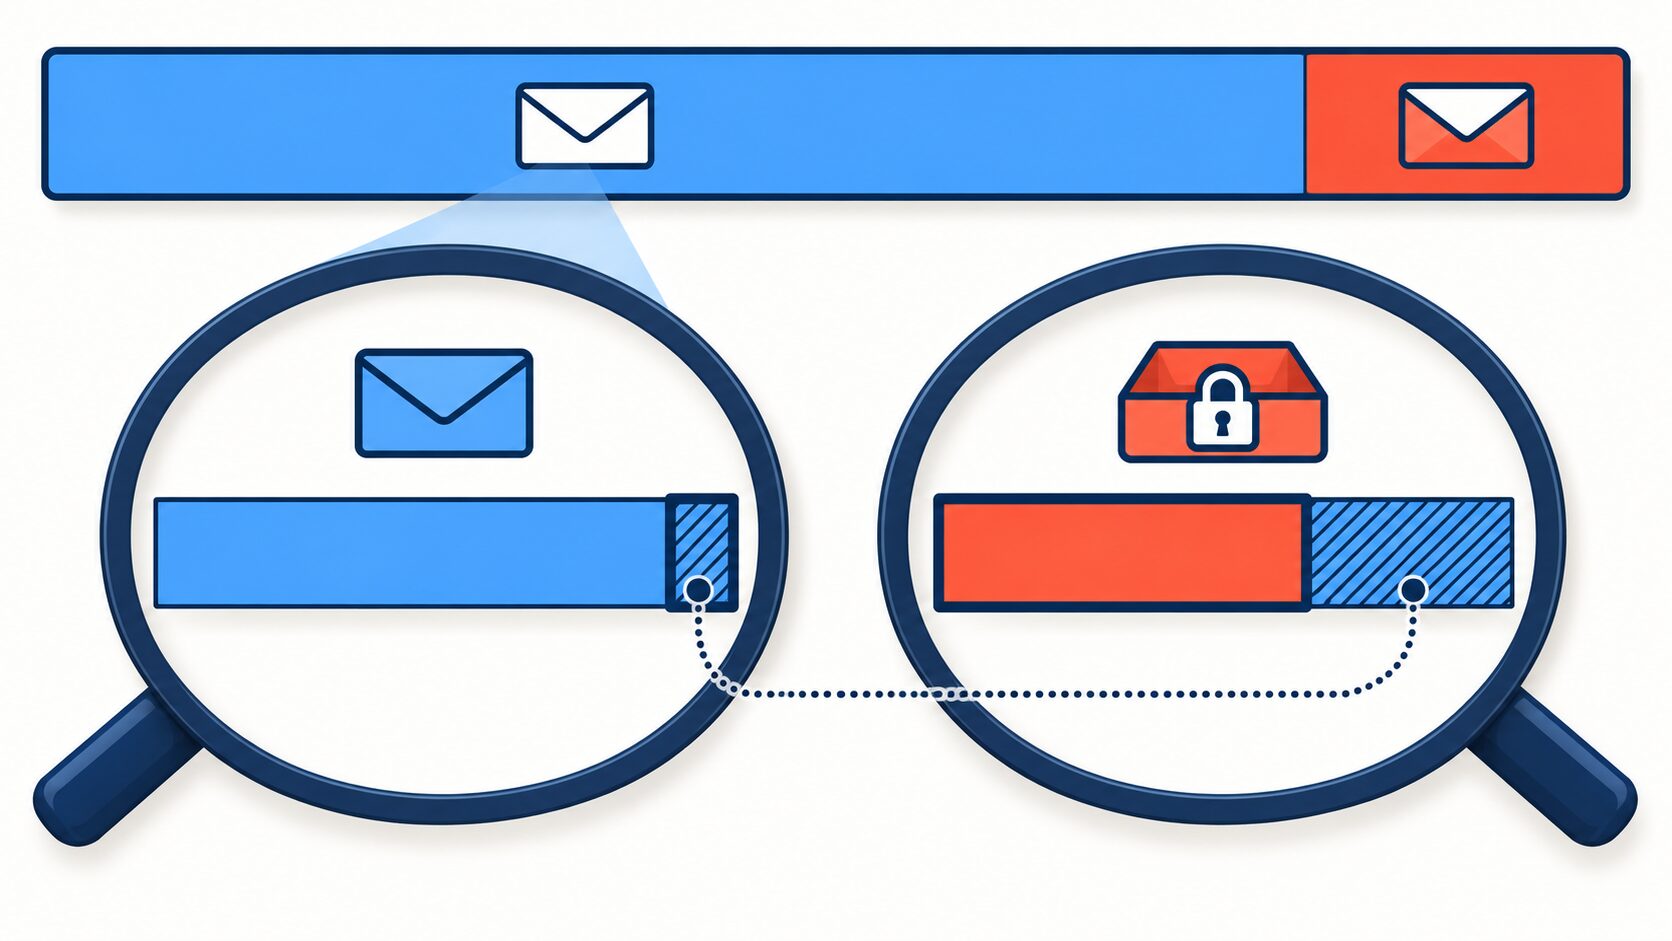
この例では偽陽性率は5%ですが、陽性判定のうち誤りだった割合は45÷135で約33.3%です。「偽陽性率5%だから、迷惑メールフォルダー内の誤判定も5%」とはいえません。適合率は対象の出現割合にも左右され、同じ再現率・偽陽性率が保たれるなら、実際の陽性が少ない集団ほど低くなります。
正解率にも注意が必要です。同じ1,000通をすべて通常メールと判定すると、正解率は90%になりますが、迷惑メール100通はすべて見逃しています。対象が少ない問題では、正解率だけでは目的を達成できているか分かりません。FP・FNの件数、再現率、適合率などを合わせて確認しましょう。なお、分母となる集団が0件の場合、その指標は通常の割り算では計算できず、評価時の扱いを明示する必要があります。
判定の閾値と二つの誤りのバランス
分類モデルの多くは、「対象らしさ」をスコアで出し、その値が閾値(しきいち)以上なら陽性と判定します。閾値は、陽性と陰性を分ける境目です。たとえば迷惑メールらしさを0〜100のスコアで表し、70以上を迷惑メールとして扱う、といった使い方です。このスコアは必ずしも確率ではなく、70だから迷惑メールである確率が70%とは限りません。
同じモデルと同じ評価データで閾値を70から50へ下げると、スコアが50以上70未満のメールも陽性になります。その中に本当の迷惑メールがあれば見逃しが減り、通常メールがあれば誤検出が増えます。追加で陽性になるものがなければ、件数は変わりません。
| 閾値の変更 | 陽性判定の変化 | 偽陽性(FP)の件数 | 偽陰性(FN)の件数 |
|---|---|---|---|
| 閾値を下げる | 増える、または変わらない | 増える、または変わらない | 減る、または変わらない |
| 閾値を上げる | 減る、または変わらない | 減る、または変わらない | 増える、または変わらない |
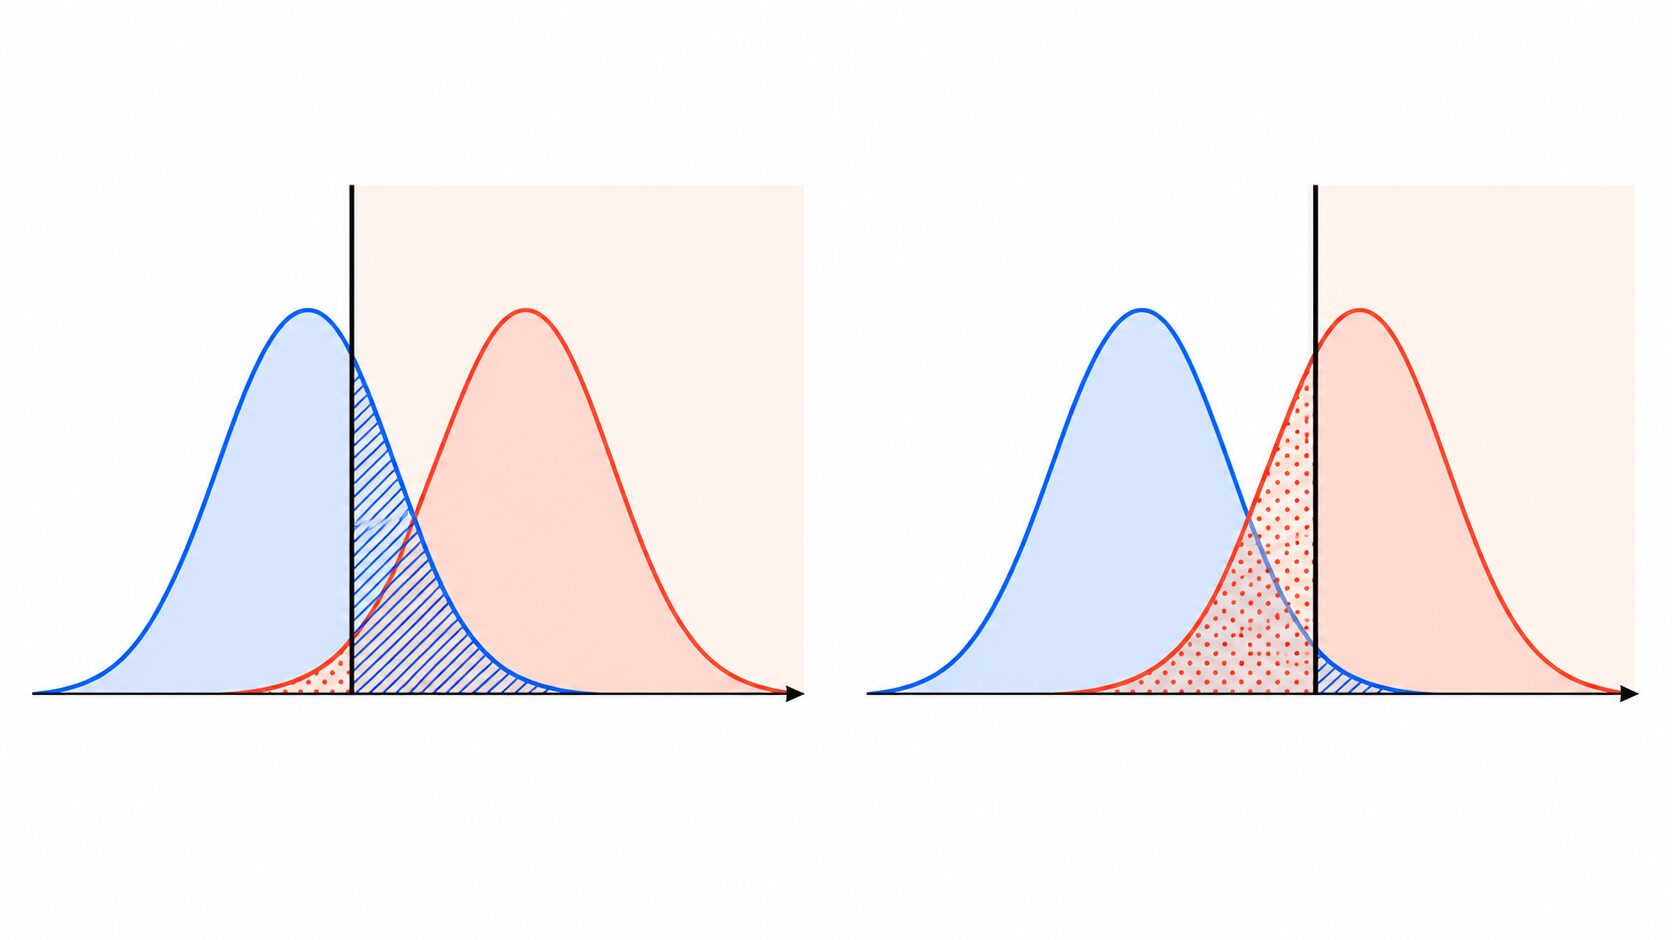
これが閾値調整における二つの誤りのトレードオフです。見逃しを重く見るなら閾値を下げる方向、誤検出を重く見るなら上げる方向で検討します。ただし、検出数が増えると確認作業も増えるため、指標だけでなく対応できる件数も考える必要があります。
閾値を動かすことと、モデルの識別能力を改善することは別です。学習データの誤りを直したり、判定に役立つ特徴量を加えたりして陽性と陰性を区別しやすくできれば、FPとFNの両方を減らせる可能性があります。「一方を減らすと必ずもう一方が増える」という説明は、モデル改善まで含む一般的な法則ではありません。改善後も同じ条件の評価データで確かめることが大切です。
製品検査・不正検知・侵入検知での使い方
偽陽性と偽陰性の考え方は、製造、取引の監視、情報セキュリティにも応用できます。どの分野でも、最初に検出対象を陽性として明示すると、誤りとその影響を取り違えずに整理できます。
| 用途 | 陽性の定義 | 偽陽性(FP)と影響 | 偽陰性(FN)と影響 |
|---|---|---|---|
| 製品検査 | 製品が不良品である | 良品を不良品と判定する。再検査や手直しの負担、廃棄による損失が生じ得る | 不良品を正常品と判定する。不良品の流出、返品や故障などにつながり得る |
| 不正取引検知 | 取引が不正である | 正常な取引を不正と判定する。取引停止や本人確認による顧客負担が生じ得る | 不正な取引を正常と判定する。不正利用による損失につながり得る |
| 侵入検知 | アクセスが不正である | 正常なアクセスを不正と判定する。誤警報への対応や、遮断による業務への支障が生じ得る | 不正アクセスを正常と判定する。侵入の発見が遅れ、情報流出やシステム被害につながり得る |
製品検査では、軽微な外観の違いを検出する場合と、安全に関わる欠陥を検出する場合では、見逃しの損失が異なります。また、不良品と判定した時点で廃棄するのか、人が再検査するのかによって、同じ偽陽性でも結果が変わります。
不正取引検知も、陽性判定後に自動停止する運用と、追加確認を挟む運用では顧客への影響が異なります。侵入検知では、誤警報が多すぎると確認担当者の時間を消費し、本当の警報への対応が遅れるおそれがあります。誤検出の削減は、確認に使える人員を適切に配分するうえでも重要です。
優先度は、1件当たりの影響、発生頻度、確認作業の量を組み合わせて判断します。影響が比較的小さくても毎日大量に発生する誤りは無視できませんし、まれでも被害が大きい見逃しには手厚い対策が必要になることがあります。現場で許容できる誤検出件数や必要な再現率を決めると、モデルや閾値の選択につなげやすくなります。
誤りを減らすための評価と運用
誤りを減らすには、モデルの性能と、判定後の対応の両方を改善します。まず確認したいのは、評価に使う正解ラベルの品質です。通常メールに迷惑メールというラベルが付いていれば、モデルが正しく判定しても評価上は誤りに見えてしまいます。判断が分かれる事例について基準をそろえ、誤ったラベルを見直すことが出発点です。
次に、実際の利用環境を反映するデータを用意します。学習に使ったデータだけで測ると、未知のデータに対する性能を見誤る可能性があります。学習とは別のデータでFP・FNを測り、閾値を調整するための検証用データと、最終的な性能を確認するテスト用データも分けておくと、調整結果を公平に評価しやすくなります。
データの量を増やすだけでなく、誤りが多い条件を調べることも有効です。たとえば特定の言語のメールや、ある照明条件の製品画像で見逃しが多いなら、その条件のデータや特徴量を改善する余地があります。全体の平均が良くても、一部の利用条件では性能が低いことがあるためです。
運用では、判定を受けてすぐに不可逆な処理を行うのか、確認や取り消しを挟めるのかを設計します。次のような手順が考えられます。
- 判断の境目に近いケースを保留し、追加情報を集めてから判定する。
- 影響の大きい陽性判定を人が確認し、処理の実行前に誤検出を減らす。
- 隔離したメールを利用者が確認・復元できるようにし、誤判定の報告を受け付ける。
- 陰性判定も一部を抜き取って確認し、自動判定を通過した見逃しを調べる。
- 確認結果と対応にかかった時間を記録し、モデルや閾値の見直しに使う。
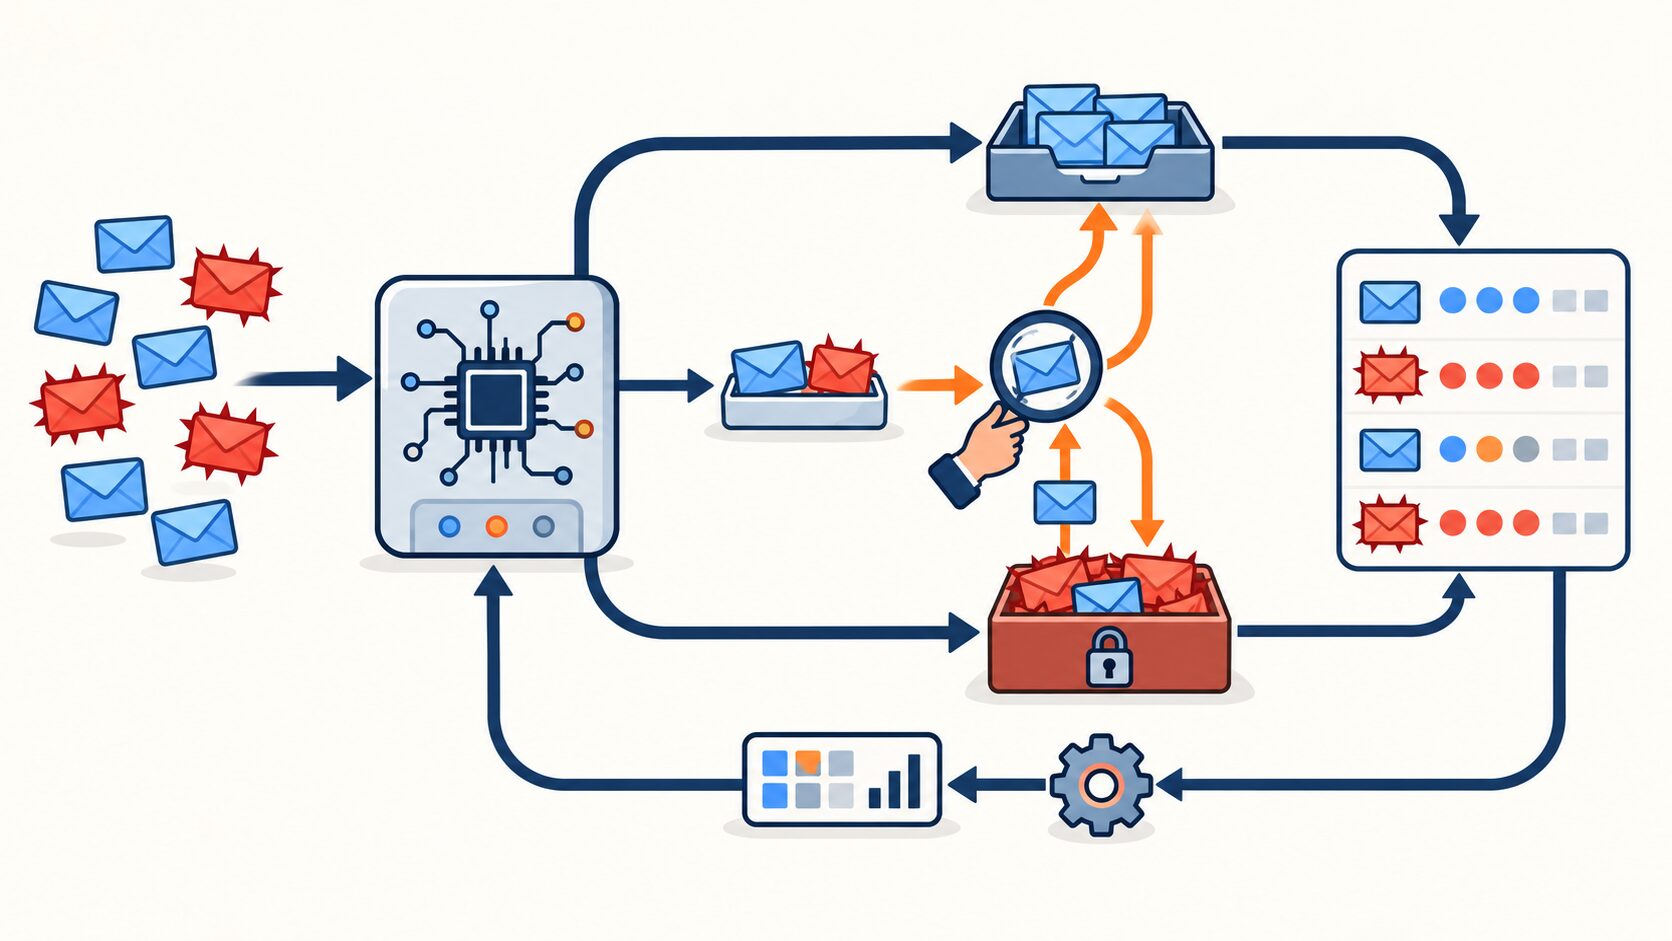
人による確認にも時間と費用がかかり、確認者が誤る可能性もあります。すべてを人手で再確認するのではなく、被害の大きさや判定の不確かさに応じて確認範囲を決めます。また、陽性判定だけを調べていては偽陰性を把握しにくいため、見逃しを発見する経路も用意する必要があります。
導入後は、新しい迷惑メールの出現、製品の仕様変更、利用者の行動の変化などによって、データの傾向や対象の割合が変わることがあります。FP・FNの件数と各指標、確認待ちの件数、実際に発生した損失を継続して確認し、変化に応じて対策を見直しましょう。
陽性の定義を固定し、実際の状態と判定を比べ、誤検出と見逃しを別々に評価することが基本です。誤りがゼロであることを前提にせず、誤りを減らす工夫と、起きた後の被害を抑える手順を組み合わせることで、目的に合った判断の仕組みを作れます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月2日 | 初回公開 |
| 2026年10月3日 | 混同行列の対応を修正し、過誤の定義と評価指標・閾値の説明を補足 |