
拡散言語モデルとは?文章を反復して生成する仕組みと自己回帰モデルの違い

AIの初心者
AIの文章は、必ず先頭から一語ずつ書かれるのですか?

AI専門家
よく使われるのは、次のトークンを順番に足す方式です。一方、拡散言語モデルには、文章の複数の空欄を段階的に埋めていく方式があります。
AIの初心者
それなら、全文を一度に完成させて、間違いも直せるのでしょうか?
AI専門家
複数の位置を扱えても、通常は何段階かの計算が必要です。また、生成途中の推定を繰り返すことと、内容の正しさを確かめることは別です。まず空欄を埋める例で考えてみましょう。
拡散言語モデルとは。
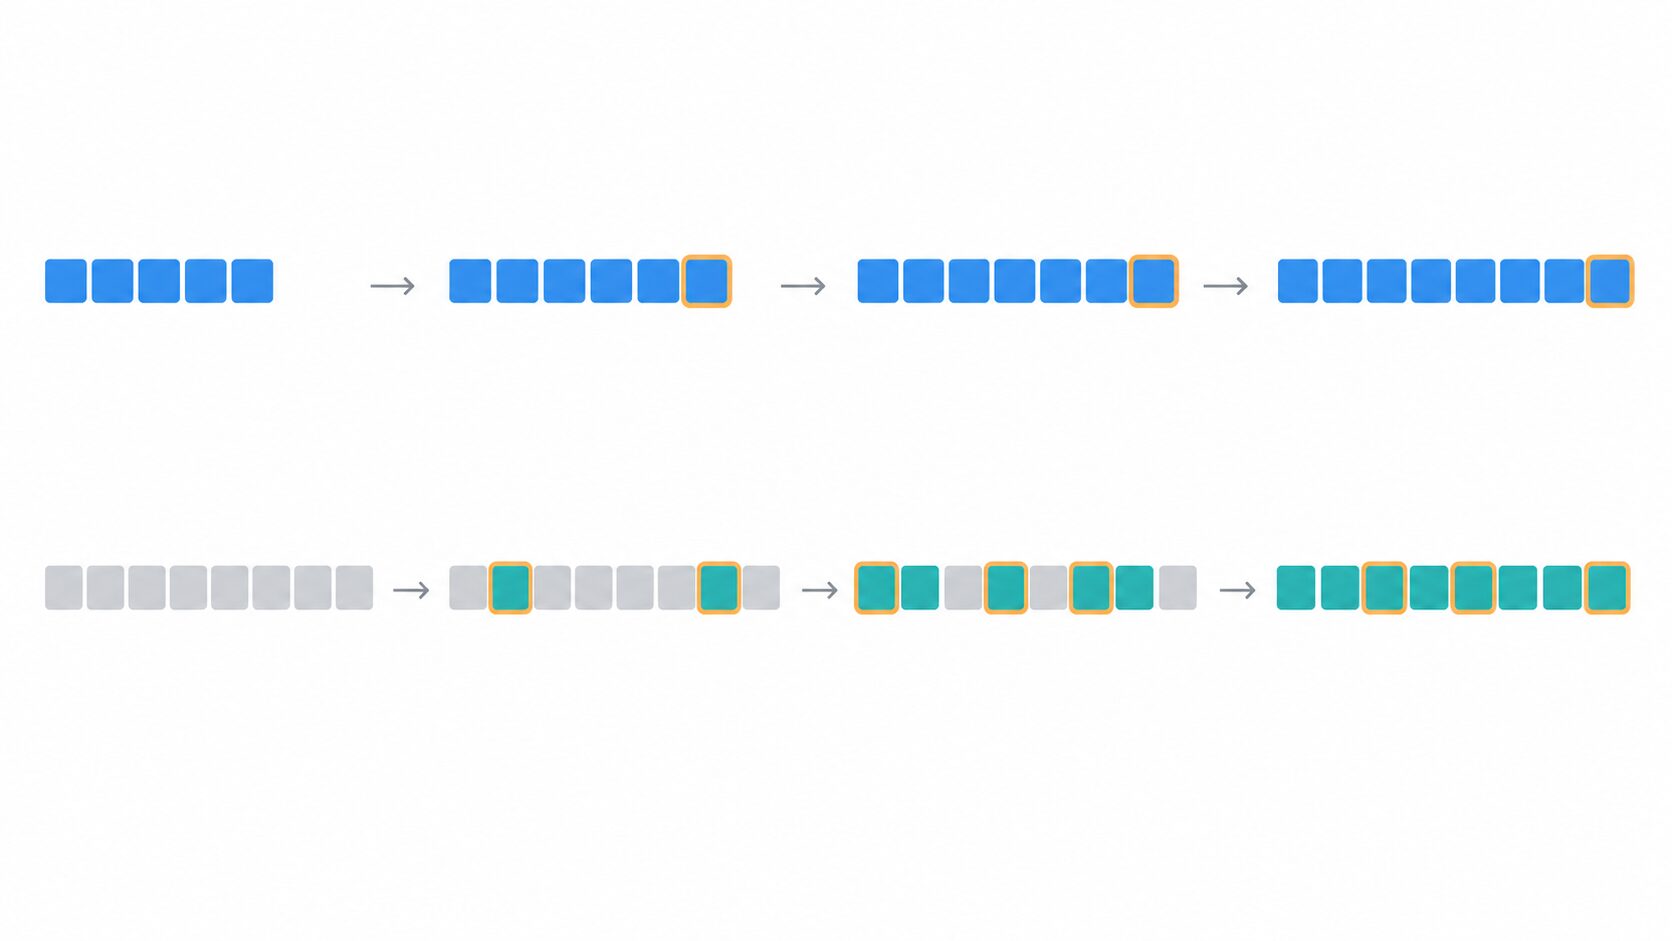
拡散言語モデルは、ノイズや欠損を含む状態から、段階的な復元によって文章を生成する言語モデルです。代表的な方式では、隠されたトークンを文脈から推定し、複数の位置を反復して埋めます。先頭から次のトークンを追加する自己回帰モデルとは、生成の進め方が異なります。
二つの方式を理解する手がかりは、「どこを生成するか」と「いつ出力を確定するか」です。文章やコードの用途だけでなく、途中の表示や完成までの待ち時間にも、この違いが関わります。
拡散言語モデルとは何か
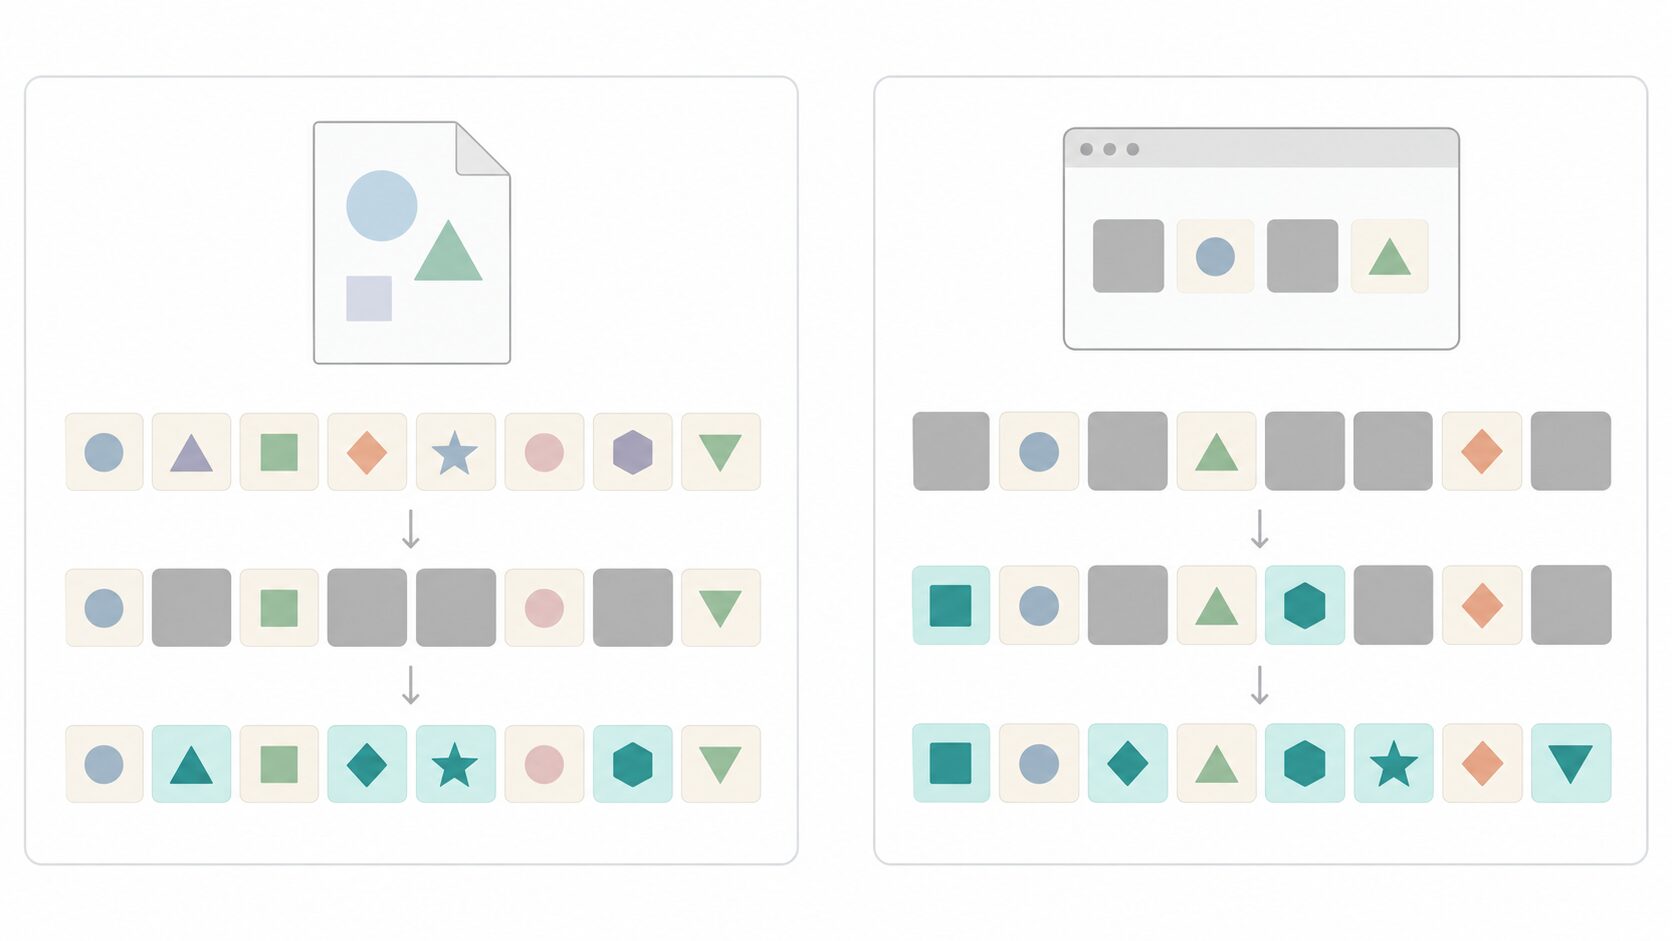
中心となる考え方は、不完全な状態から、文脈に合う文章へ近づけることです。例えば、いくつかの言葉が隠された文を見て、残っている言葉や指示を手がかりに空欄を推定します。その処理を段階的に進め、読める文章を作ります。生成する範囲が最初はすべて空欄でも、指示文などを条件に生成を始められます。
ここでいうトークンは、AIが文章を処理する単位です。一つの単語とは限らず、単語の一部分や句読点なども単位になります。日本語の一語が複数のトークンに分かれる場合もあるため、「一語ずつ書く」「空欄に一語を入れる」という説明は、厳密な内部処理を簡略化した表現です。
拡散方式では、一つの計算段階で複数の位置の候補を推定できる設計があります。ただし、候補が出た時点で全部を確定するとは限りません。確からしい位置から埋める、一定の範囲だけを処理するといった設計もあります。複数位置の並列処理は、全文が一回で完成するという意味ではありません。
画像の拡散モデルとも、不完全な状態を段階的に復元する発想を共有します。ただし、画像では画素の値などに連続的なノイズを加える方式がよく使われる一方、文章のトークンは区別された記号です。そのため、文章では記号をマスクして隠すなど、扱うデータに合った方法が必要になります。数値の表現にノイズを加える研究もあり、マスキングがすべての拡散言語モデルに共通するわけではありません。
また、Transformerとの違いは、分類の軸にあります。Transformerは文脈を処理するモデルの構造であり、自己回帰と拡散は生成の進め方です。拡散言語モデルでもTransformerを利用できます。「Transformerか拡散か」という二者択一で捉えると、この関係を見失ってしまいます。
マスクから文章を生成する仕組み
マスク方式を理解するときは、学習で隠す処理と、生成で埋める処理を分けると整理できます。学習では元の文章があり、その一部を[MASK]などの特別な記号で隠します。モデルは、残った文脈を使って元のトークンを予測し、正解との違いから調整されます。隠す位置や割合を変えることで、さまざまな欠損状態から復元するための学習ができます。
例えば「明日は公園で本を読む」の「公園」と「本」に相当する部分を隠すと、「明日は[MASK]で[MASK]を読む」になります。学習時には元の文章が正解として存在します。ただし、マスクを使う学習だけで拡散生成が決まるわけではありません。生成時に、どの状態から何段階で復元するかという手順も必要です。
生成時には、これから作る文章の正解はありません。指示文や与えられた文章を条件に、マスクされた生成範囲の候補を推定します。その結果の一部を確定し、次の段階で残りを推定するなどして文章を具体化します。前後の文章を条件として固定する場合には、その間の空欄を埋める形にもできます。
次は、文章の一部を既知の条件として与える穴埋めの模式例です。説明のために言葉のまとまりを一つの[MASK]で示しており、実際のトークン分割や特定モデルの出力を再現したものではありません。
| 段階 | 文章の状態の例 | 考え方 |
|---|---|---|
| 生成開始 | 明日は[MASK]で[MASK]を読む | 見えている文を条件に、空欄の候補を推定する |
| 途中 | 明日は公園で[MASK]を読む | 一部を確定し、その情報も使って残りを推定する |
| 完成候補 | 明日は公園で本を読む | 空欄が埋まり、一つの文が得られる |
この例では一か所ずつ確定していますが、複数の空欄を同じ段階で確定する設計もあります。「図書館」と「雑誌」のような別の組み合わせも成立し得るため、生成は唯一の元の文章を当てる作業ではありません。指示に合う候補を、学習した言葉の関係から作る処理です。
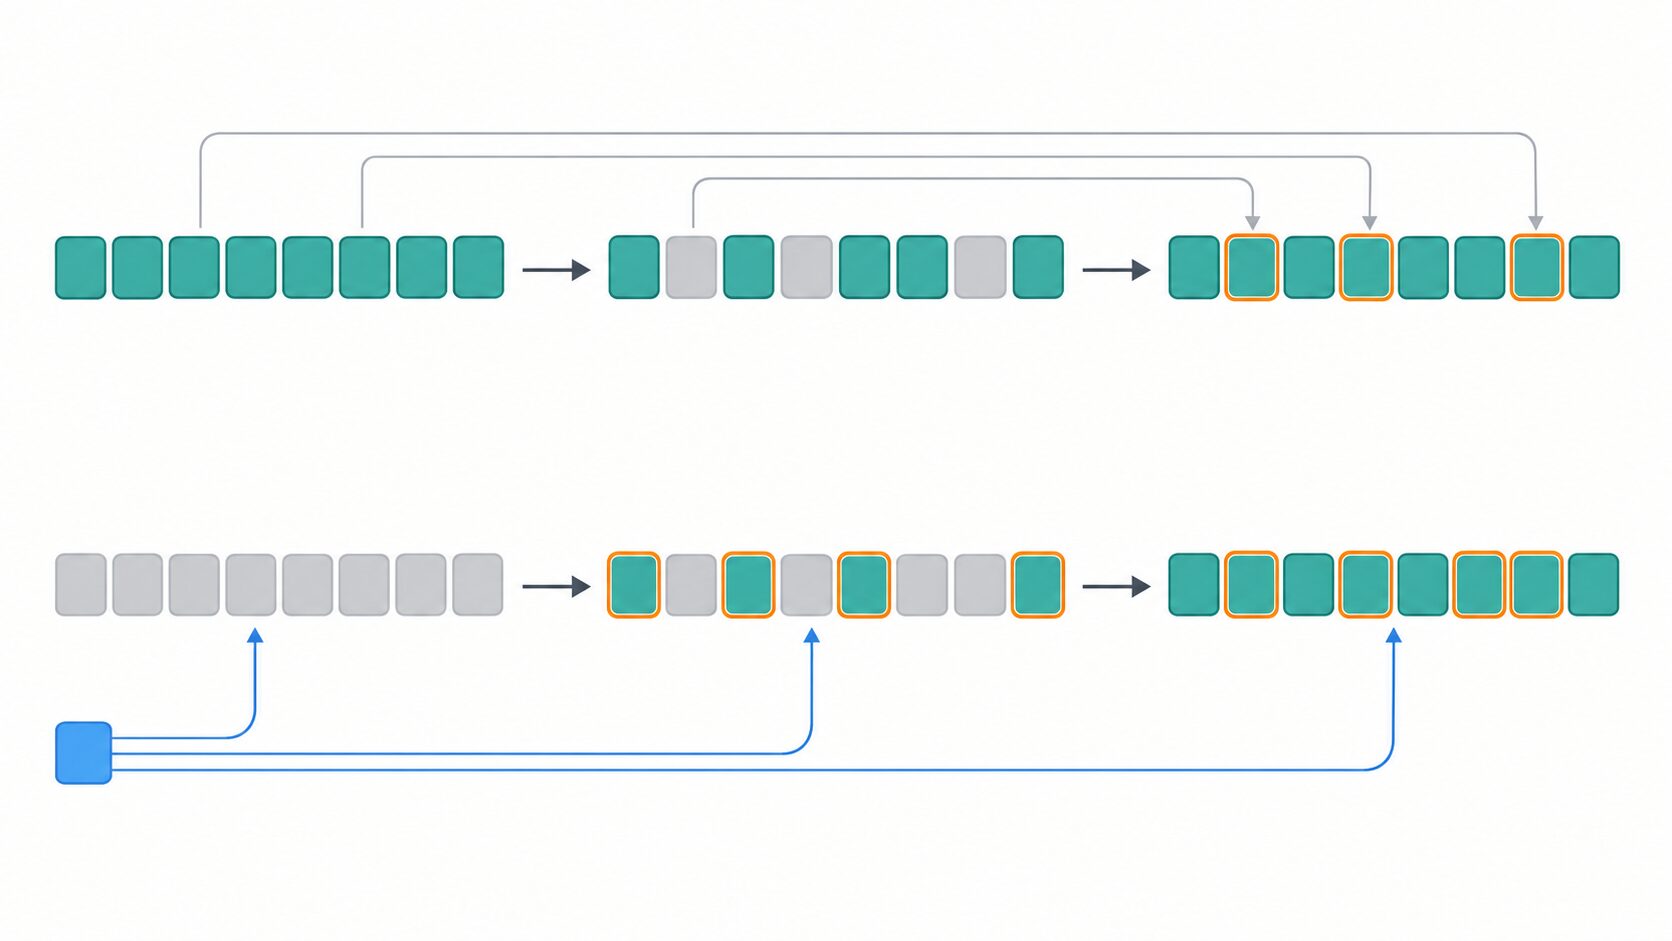
一度確定したトークンを保持する方式もあれば、候補を再びマスクして推定し直す方式もあります。したがって「反復して修正する」といっても、完成文のどこでも自由に書き換えるとは限りません。また、推定を繰り返す過程に、外部資料との照合が自動的に含まれるわけでもありません。
自己回帰モデルとの違い
自己回帰モデルは、指示や入力文と、すでに生成した部分を条件に、次のトークンを追加します。拡散言語モデルでは、生成範囲の複数の位置を段階的に復元します。違いは単に「速いか遅いか」ではなく、生成順序と途中結果の扱いにあります。
| 比較する点 | 自己回帰モデル | 拡散言語モデル |
|---|---|---|
| 生成順序 | 基本的に先頭から次のトークンを追加する | 複数の位置を段階的に復元する。ブロック単位の方式もある |
| 利用する文脈 | 指示や入力文と、すでに生成したトークン | 条件として与えた情報と、その段階で参照できる位置のトークン。参照範囲は設計による |
| 途中結果の確定 | 通常の生成では、追加したトークンを残して先へ進む | 確からしい候補を保持する、再マスクするなど方式によって異なる |
| 逐次表示 | 追加したトークンを順に表示しやすい | 確定したブロックを順に表示するなど、生成単位と確定方法に左右される |
| 計算負荷 | 生成が順序に依存する一方、過去の計算結果をキャッシュできる設計が多い | 複数位置を並列に処理できる一方、復元の反復計算が必要になる |
自己回帰方式も、後ろに続く文章を入力として与えれば、それを条件に空欄用の文章を生成できます。「未来の文章を一切参考にできない」という意味ではありません。違うのは、与えられた条件から実際に出力を組み立てる順序です。
拡散方式も、常に全文をまとめて処理するとは限りません。文章をいくつかのブロックに分け、各ブロックの内部を拡散で生成しながら、ブロック間は順に進める設計もあります。そのため、「拡散なら文章の途中を表示できない」とも断定できません。利用画面でどう表示するかは、モデルとサービスの実装の両方に関わります。
対話AIに「この文章を推敲して」と頼む操作も、拡散方式とは区別しましょう。自己回帰モデルでも、元の文章を入力にして、修正版を先頭から生成できます。利用者が何度も書き直しを依頼したからといって、内部で拡散生成を使っているとは判断できません。
文章とコードで考える使いどころ
前後の条件を見ながら空欄を補う作業は、拡散方式の特徴を考えやすい用途です。例えば案内文で、冒頭の「土曜日に読書会を開きます」と、末尾の「参加を希望する方は金曜日までにお知らせください」を固定し、その間に活動内容を入れたい場合です。前の文とのつながりと、後ろの申込案内へ自然に続くことの両方が条件になります。
こうした文章補完では、決まっている部分を保ち、必要な範囲に内容を加える使い方が考えられます。複数の空欄を扱うなら、同じ会の名称や説明の調子をそろえることも求められます。ただし、拡散方式を採用していても、利用者が任意の位置を固定できるとは限りません。穴埋めや編集への対応は、モデルの設計とAPIが受け付ける入力形式を確認する必要があります。
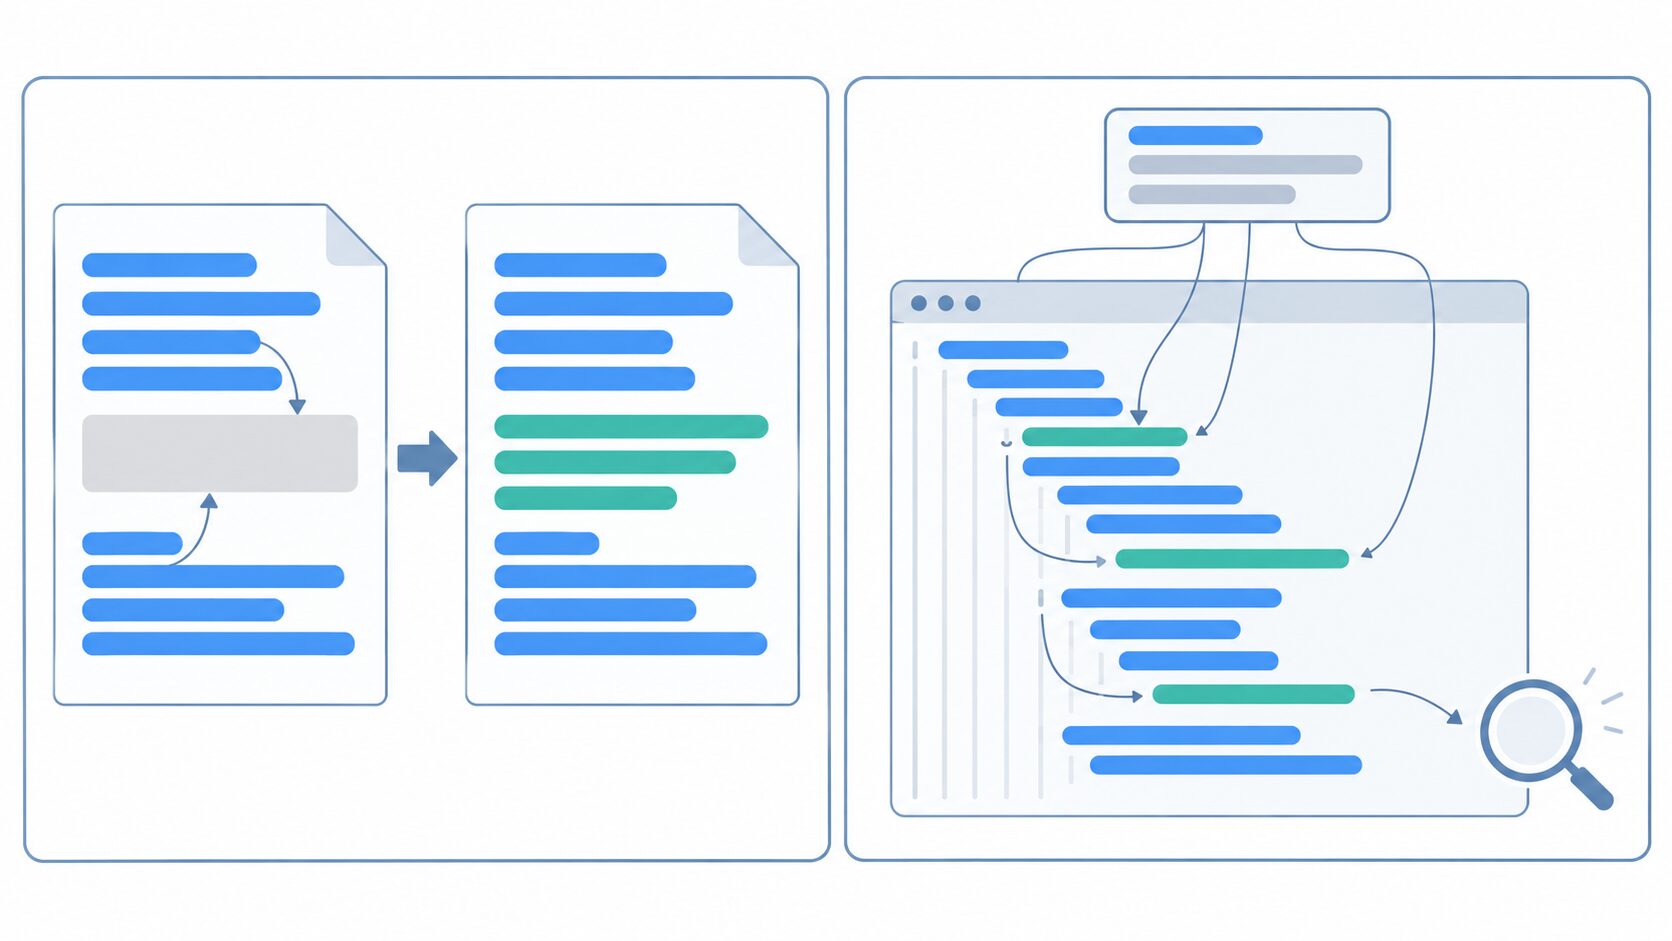
コードでも、関数の仕様や周辺コードを条件にして、未完成の部分を補う用途が考えられます。例えば「数値の一覧の平均を返す。空の一覧なら0を返す」という仕様と関数名を与え、処理の部分を埋める場合です。周辺で使う変数名や戻り値の形式も条件に含めれば、それらに合う候補を生成するための手がかりになります。
複数の位置を処理できることは、離れた箇所の候補を同じ生成段階で扱える可能性につながります。しかし、それだけで変数名の一致や正しい動作が保証されるわけではありません。この平均の例なら、通常の一覧に加え、空の一覧や小数を含む一覧でも期待どおりになるかをテストします。文法上は正しくても、条件分岐が抜けていれば仕様に反するからです。
文章編集もコード生成も、自己回帰モデルで取り組める用途です。選ぶ際には、必要な入力を渡せるか、固定したい部分を保てるか、途中経過が読みやすいか、生成後の確認を組み込めるかを見ます。方式の名称だけで、自分の作業に適しているかを決めないことが大切です。
LLaDAとGemini Diffusionの具体例
具体例として、2026年10月4日確認の資料メモでは、LLaDAの原著論文とGoogle DeepMindのGemini Diffusionの紹介が挙げられています。前者はマスクを使う学習・生成の研究例、後者は実験的なテキスト拡散モデルの公開説明として読むと、それぞれの位置づけをつかめます。
LLaDAの原著論文は、マスキングと、その逆方向に文章を生成する過程を用いた言語モデルを提示しています。文章を隠す処理から復元を学び、生成時にはマスクされた状態からトークンを決めていくという、本記事で扱った仕組みの具体例です。「次のトークンを順に予測する」以外の方法で言語生成を考える材料になります。
論文を読むときには、学習時に何を隠すのかという説明と、生成時に何をどの順番で確定するのかという説明を分けて追うと理解しやすくなります。また、論文には改訂版があり得るため、細かな設定や評価結果を引用する際は、参照した版と生成条件も記録する必要があります。
Gemini Diffusionの紹介ページでは、実験的なテキスト拡散モデルとして、ノイズのある状態を反復して改良することや、トークンのブロックを生成することが説明されています。ブロックという単位は、複数位置の生成と、文章を順に出力する設計が両立し得ることを考える手がかりになります。
ただし、この二つが同じ内部構造や同じ確定手順を使うとはいえません。公開されていない実装を名称から推測することや、一方の評価結果を拡散方式全体の性能として扱うことは避けましょう。論文の公開、研究デモの公開、一般向けサービスやAPIの提供も別の段階です。利用できる範囲や条件は変わるため、実際に試す際には公式の案内を確認してください。
速度と品質を比較するときの注意点
複数位置を並列に処理できることは高速化の可能性につながりますが、拡散方式には復元のための反復計算があります。一段階で多くの位置を扱っても、段階数が多ければ計算は増えます。並列に生成できることだけを理由に、すべての自己回帰モデルより速いとはいえません。
生成ステップ数は、速度と品質の兼ね合いを見る重要な条件です。段階を減らすと計算を短縮できる可能性がある一方、十分に復元できず出力の質が落ちる場合があります。増やしても、品質が際限なく上がるわけではありません。効果は、学習方法、候補の確定手順、出力の長さ、課題によって変わります。
速度の数値を見るときには、少なくとも次の三つを分けます。どれを重視するかで、使いやすいモデルの判断も変わります。
- 最初の表示までの時間:操作してから、読める出力が最初に現れるまでの待ち時間です。対話の反応のよさに関わります。
- 全文完成までの時間:依頼した文章やコードが、利用できる形で出そろうまでの時間です。
- 一定時間あたりの処理量:同じ計算環境で、どれだけの出力や依頼を処理できるかです。多数の依頼をまとめて扱う場合に関わります。
途中の候補が後で変わる方式では、画面に文字が出た時刻と、確定した内容を読める時刻が異なる場合もあります。逆に、表示を少し待ってまとまった文章を受け取るほうが、用途に合うこともあります。デモで文字が現れる速さと、自分の作業が終わる速さを区別して見てください。
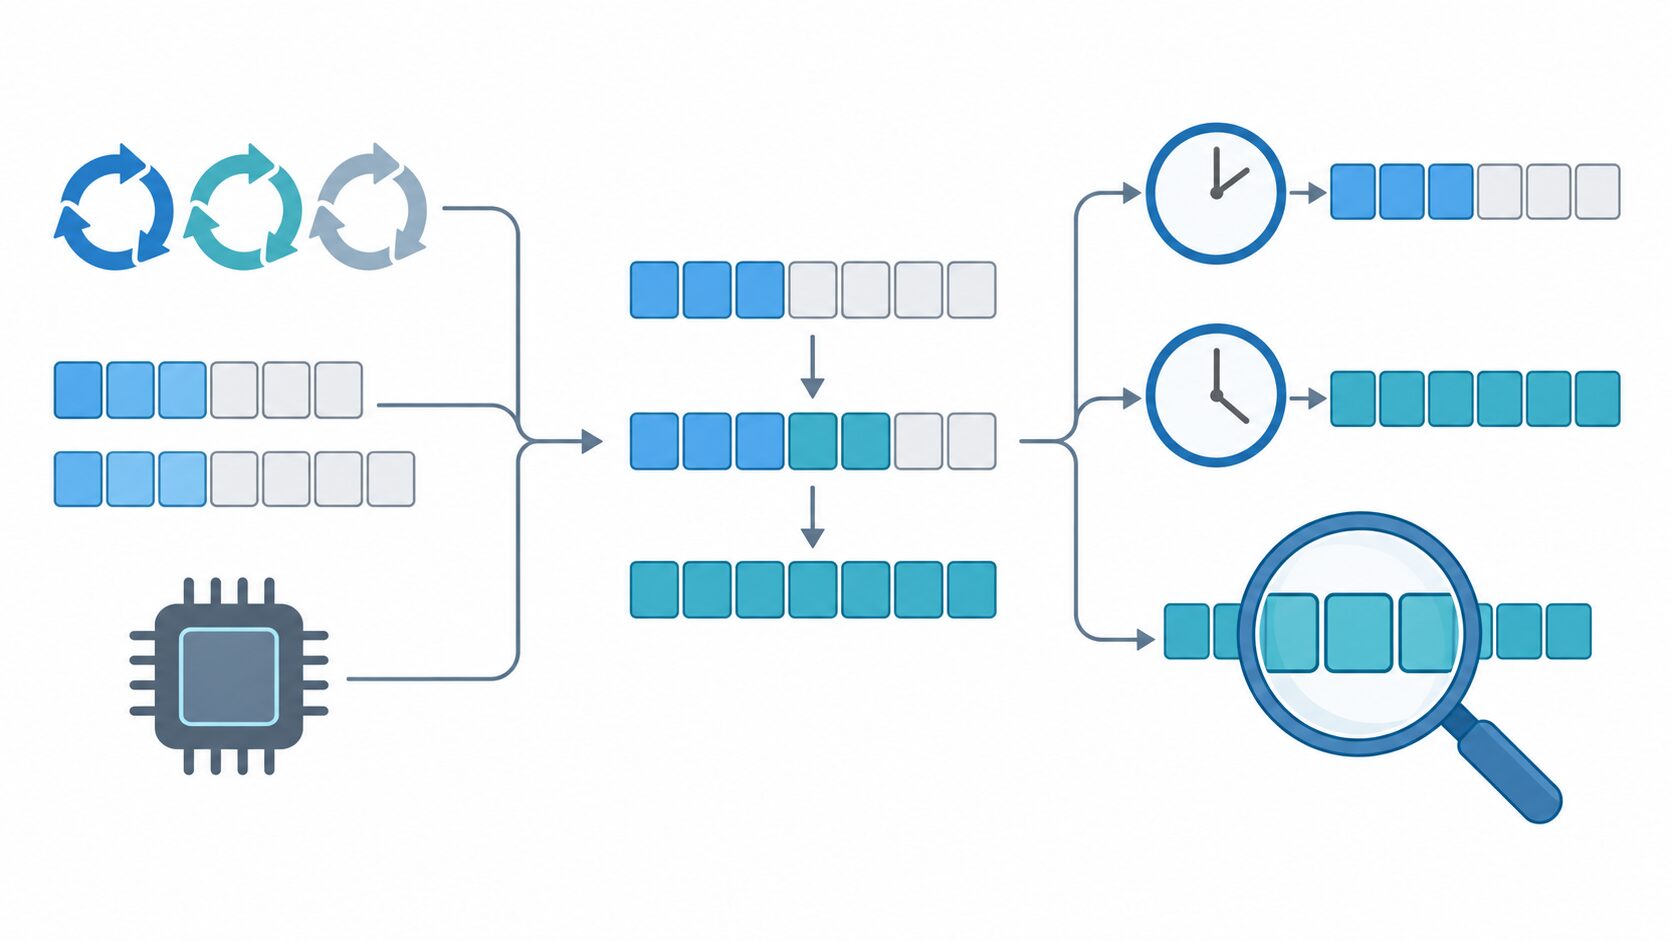
比較する際には、計算機の性能、モデルの規模、入力と出力の長さ、同時に処理する依頼数を確認します。過去の計算を再利用するキャッシュなどの実装条件も影響します。トークン数で速度を示す場合には、分割方法が違うモデル同士で同じ文章量を表すとは限りません。品質が大きく異なる出力を、速さの数字だけで比べることにも注意が必要です。
文章なら、必要な条件を満たしているか、事実に誤りがないかを確認します。コードなら、動作テストや既存の処理との整合性を確認します。公開ベンチマークは特定の条件下での比較に役立ちますが、自分の依頼で同じ結果になる保証ではありません。繰り返し生成する仕組みそのものが、正確さを保証するわけではないためです。
選定では、まず必要な品質と許容できる待ち時間を決め、利用可能な機能や入力条件を確かめましょう。そのうえで、実際に扱う文章やコードを使って比較すると、生成方式の特徴を自分の用途に結びつけて判断できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月4日 | 初回公開 |