
次元圧縮とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「次元圧縮」って、どういう意味ですか?たくさんある情報から、必要な項目だけを選ぶことなのでしょうか?

AI専門家
項目を選ぶ方法もありますが、複数の項目を組み合わせて、少ない数の新しい特徴で表す方法もあります。たとえば、果物の重さと大きさが連動しているなら、その傾向を一つの軸にまとめるイメージです。
AIの初心者
項目をまとめて表し直すこともできるのですね。でも、少ない特徴だけで、元の果物の違いは分かるのですか?
AI専門家
目的に役立つ違いを、できるだけ残すことを目指します。ただし、細かな情報が失われることもあります。見やすくしたいのか、予測に使いたいのかによって、残す特徴や圧縮の方法を選ぶことが大切です。
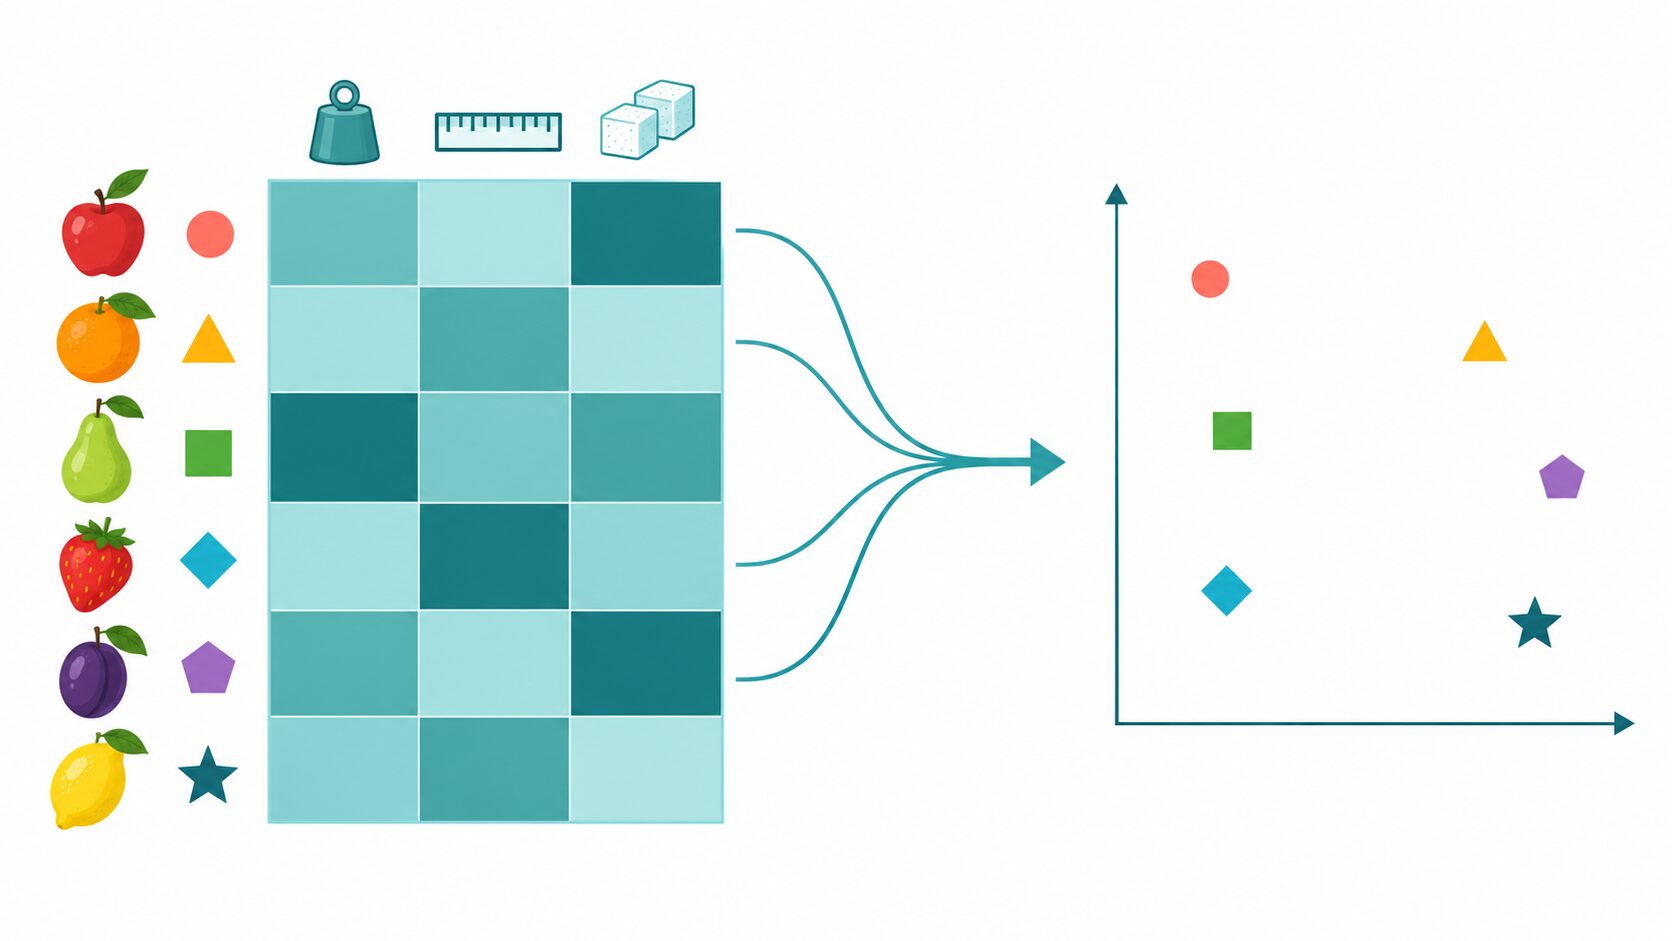
次元圧縮とは、多くの特徴量で表されたデータを、目的に役立つ性質をできるだけ保ちながら、少ない特徴量で表し直す技術です。「次元削減」とも呼ばれ、データ分析や機械学習の前処理、グラフによる可視化などに使われます。
ここで減らすのは、基本的にデータ1件を説明する項目の数です。果物100個を10個に間引くのではなく、100個それぞれの表し方を簡潔にします。まずはこの全体像を押さえ、仕組み、代表的な手法、活用例、利用時の注意点を順に見ていきましょう。
次元圧縮とは:特徴量を少ない軸で表す
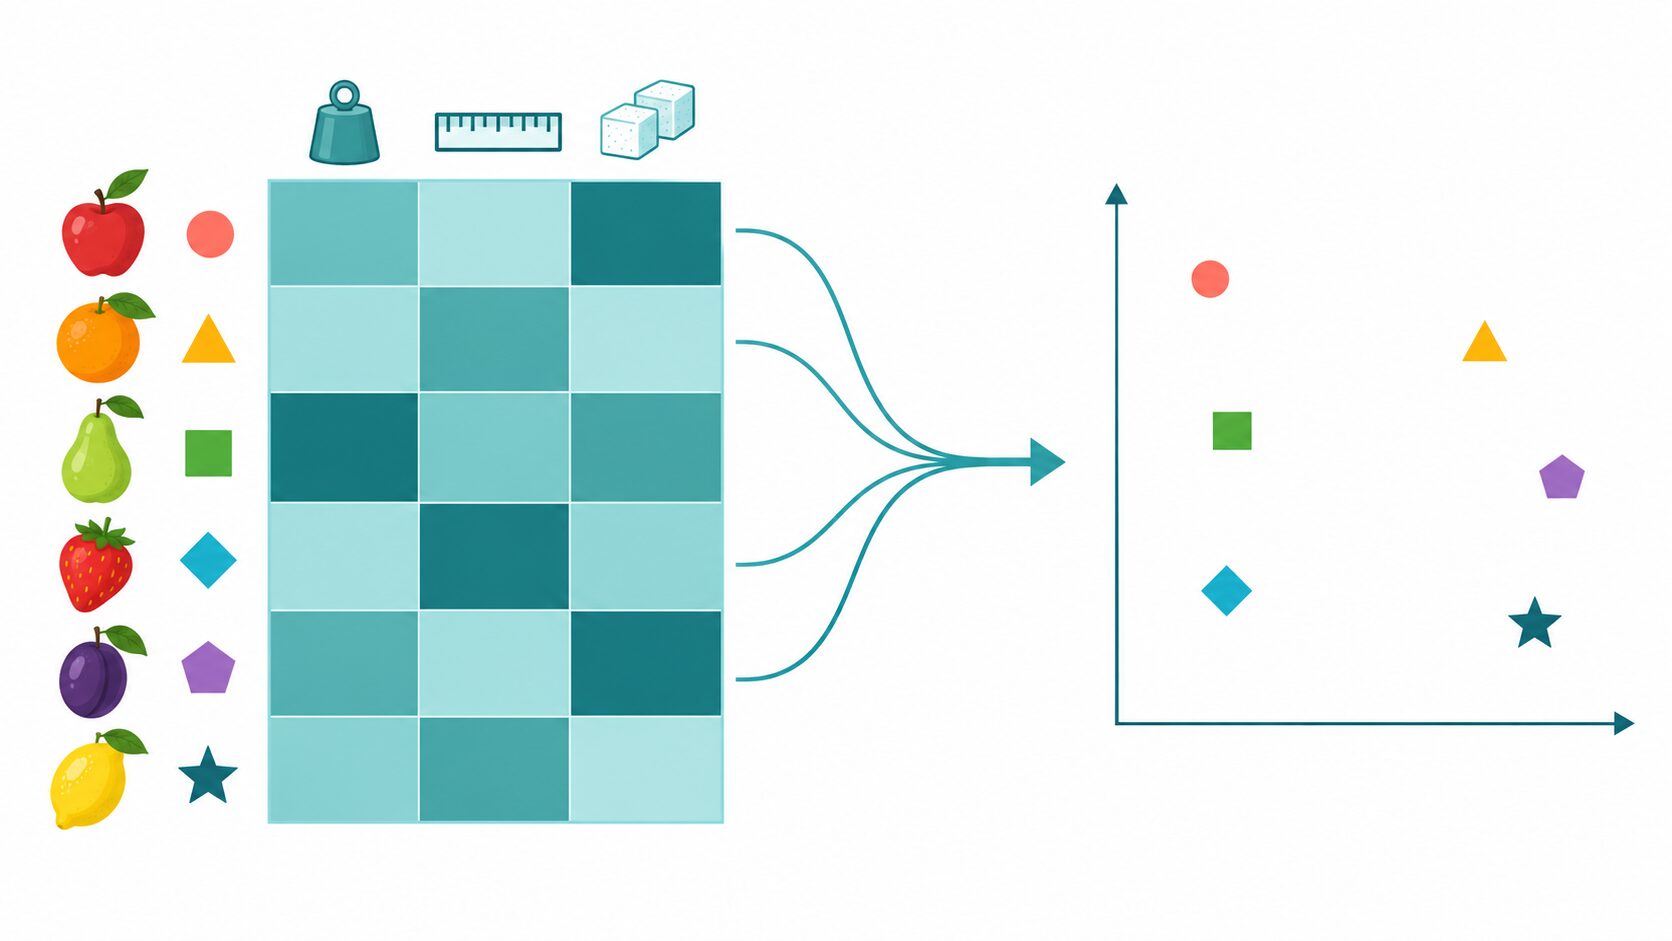
データ分析でいう「次元」は、1件のデータを表す特徴量の数を指します。特徴量とは、重さ、年齢、購入回数のように、分析に用いる性質を数値などで表したものです。たとえば、人を身長・体重・年齢・視力・靴のサイズという五つの数値で表せば、5次元のデータになります。
表では、通常は行がデータの件数、列が特徴量に対応します。100人を五つの特徴量で記録した表は100件・5次元であり、100次元ではありません。また、文字で記録したカテゴリを複数の数値の列に変換する場合などは、元の表の項目数と、分析時の次元数が一致しないこともあります。
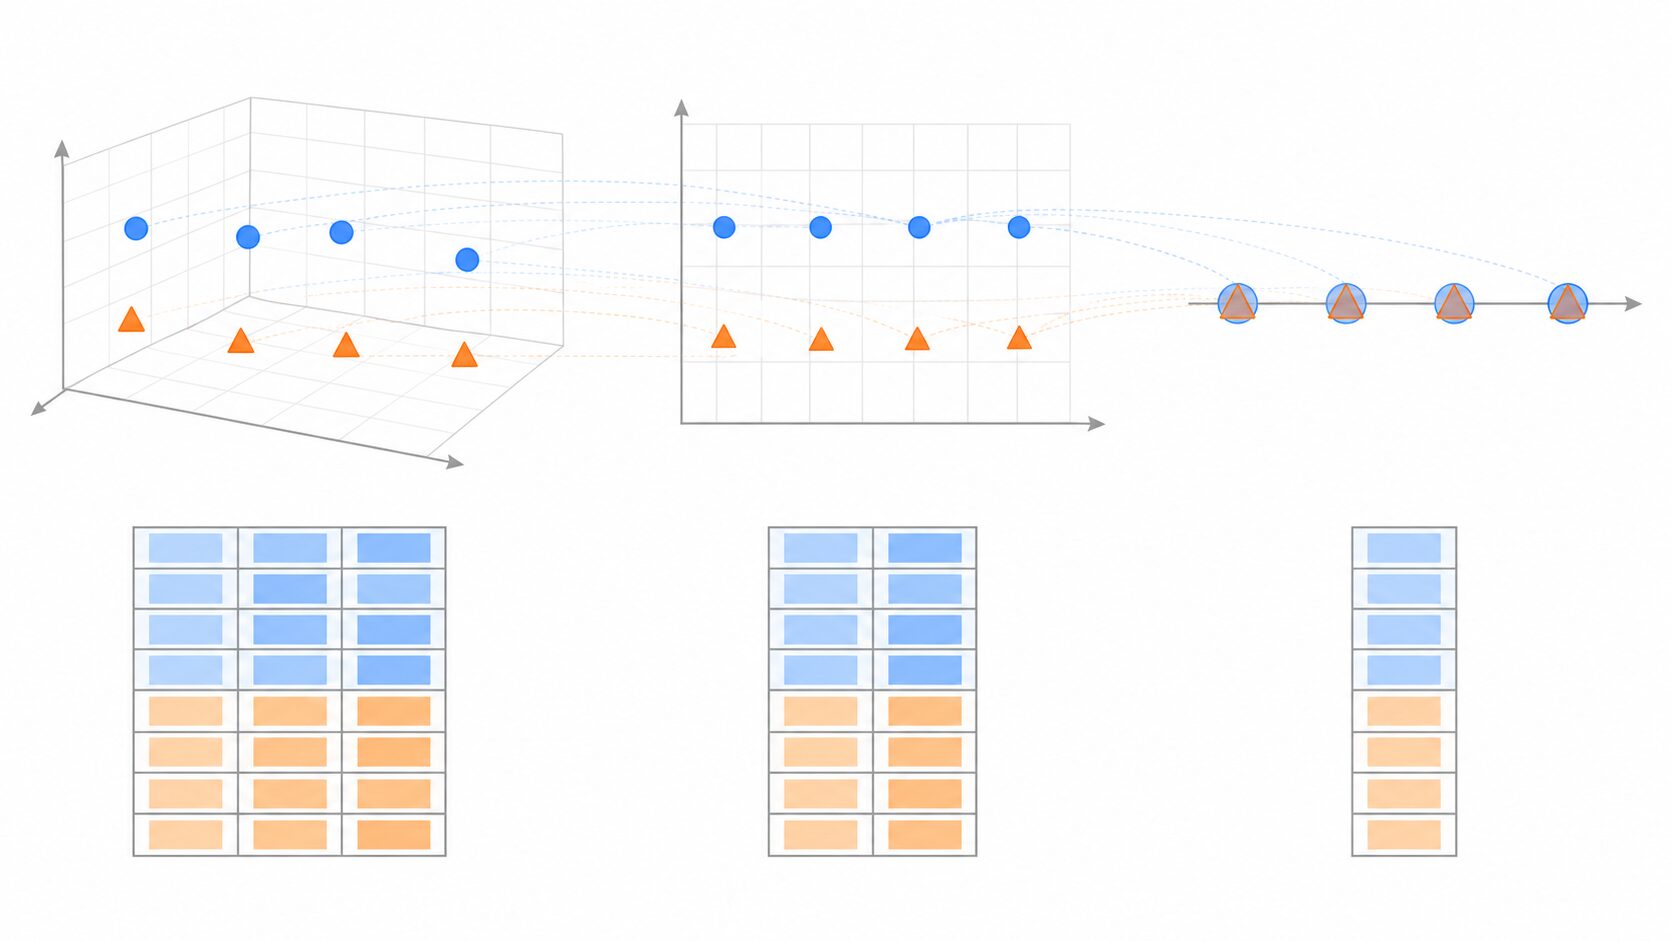
果物を重さ・大きさ・糖度の三つの数値で記録すると、1個の果物は3次元空間の一点に対応します。このうち重さと大きさに強い関係があれば、両者の変化を「大きさの傾向」を表す一つの軸にまとめ、糖度に関する軸と合わせて2次元で表せるかもしれません。各果物に二つの座標を与えれば、平面のグラフで違いを眺めやすくなります。
このとき、同じ大きさでも重さが少し異なる、といった細部は失われる可能性があります。次元圧縮は、共通点そのものを捨てる操作ではありません。複数の特徴に共通する変化を少数の軸で表し、元のデータを近似するという考え方が重要です。どのような軸が得られ、何が残るかは、使う手法と実際のデータによって変わります。
ファイル圧縮との違いも押さえておきましょう。ZIPなどの可逆圧縮は、保存の仕方を工夫して容量を減らし、元のファイルを完全に復元できます。一方、次元圧縮は分析に使う特徴の表現を変える技術で、一般に完全な復元は保証しません。圧縮画像のように情報を失うファイル形式もありますが、「保存容量を減らすこと」と「分析する軸を減らすこと」は区別して考えると理解しやすくなります。
次元圧縮が必要になる理由
顧客の購買履歴では商品やカテゴリごとの購入量、ウェブサイトのアクセス記録ではページや行動ごとの回数、遺伝子情報では多くの遺伝子の測定値が特徴量になります。項目が数百、数千と増えると、保存容量だけでなく、距離の計算やモデルの学習に必要な時間も大きくなりがちです。
さらに、高次元データには「次元の呪い」と呼ばれる問題があります。同じ件数のデータでも、次元が増えるほど、取り得る値の組み合わせに対して観測点がまばらになりやすくなります。たとえば、一つの特徴を低・中・高の三つに分けるなら区画は三つですが、二つの特徴を組み合わせれば九つ、三つなら27個になります。項目が増えるにつれて、十分なデータが集まっていない区画が増えるイメージです。
その結果、似ている事例を見つけたり、安定した傾向を学んだりするために、より多くのデータが必要になることがあります。ただし、問題の大きさは特徴同士の関係や分析方法にも左右されます。特徴量が多いという理由だけで、必ず分析に失敗するわけではありません。
次元圧縮によって期待できる効果は、主に次の四つです。
- 計算や保存の負担を減らす:少数の特徴量にまとめることで、その後の学習や検索で扱う数値を減らせます。
- 冗長な情報やノイズを抑える:似た動きをする項目をまとめ、測定誤差などの影響を小さくできる場合があります。
- 過学習を抑える:学習データだけに現れる細かな揺れまで覚えてしまうことを、軽減できる場合があります。
- 可視化しやすくする:2次元や3次元に変換すれば、データのまとまりや、他と異なる点をグラフで探索できます。
これらは保証された効果ではありません。ノイズとともに予測に必要な情報まで削れば、精度は下がります。可視化で見つけたまとまりも、そのまま実在する分類を意味するとは限りません。目的に対して何が改善したかを、圧縮前後で確かめる必要があります。
次元圧縮の仕組みと特徴量選択との違い
特徴量を減らす方法は、大きく「特徴量選択」と「特徴抽出」に分けられます。特徴量選択は元の列から使うものを選び、特徴抽出は元の特徴を変換して新しい軸を作ります。広い意味での次元削減には両方を含めますが、主成分分析などの次元圧縮を説明するときは、後者を指していることがよくあります。
| 観点 | 特徴量選択 | 特徴抽出 |
|---|---|---|
| 基本的な操作 | 元の特徴量の一部を残す | 元の特徴量を組み合わせたり変換したりする |
| 果物の例 | 重さ・大きさ・糖度から、重さと糖度を選ぶ | 重さと大きさの共通した変化を、新しい一つの軸で表す |
| 結果の読み方 | 選んだ列の意味や単位をそのまま使える | 新しい座標の意味を別途確認する必要がある |
特徴抽出の仕組みは、点を線の上に写す「投影」で考えると分かりやすくなります。身長と体重を二つの軸にした散布図で、点が右上がりの細長い帯のように並んでいるとします。この帯が伸びる方向に新しい軸を置き、それぞれの点を軸に垂直に写せば、二つの値を一つの座標にまとめられます。
新しい座標は身長そのものでも体重そのものでもなく、両者を組み合わせた値です。「体格の傾向」と解釈できる場合はありますが、同じ座標になる人でも身長と体重の組み合わせは異なり得ます。軸に写す際に取り除いた方向の違いは、一つの座標からは分からなくなるためです。
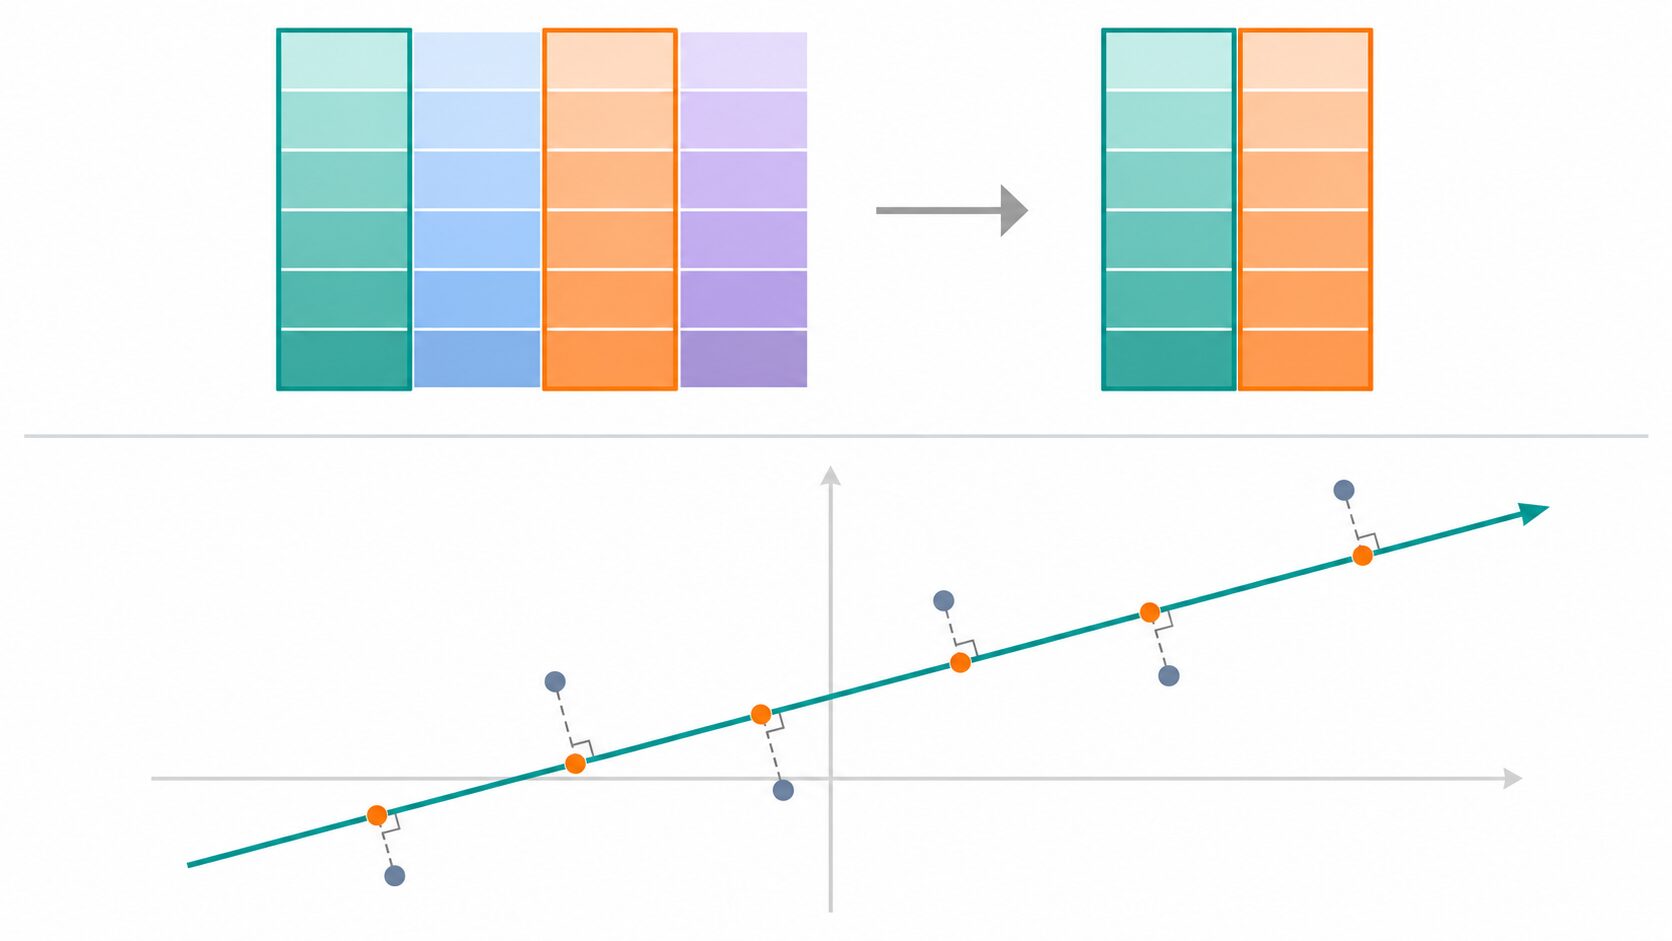
この考え方を用いる代表的な手法が、主成分分析(PCA)です。PCAは、データのばらつきである「分散」が最も大きくなる方向を第1主成分として選びます。次に、第1主成分と直交する方向の中で分散が最大になる軸を第2主成分とし、同じ考え方で軸を定めます。そのうち上位の少数の軸だけを使うことで、次元を減らします。
PCAでは、同じ次元数の線形な投影を比べたときに、分散を多く残すように軸が決まります。ただし、ばらつきが大きいことと、予測に重要であることは別です。たとえば、二つのクラスの違いが、全体としては変化の小さい特徴に現れている場合、その方向を削ると分類が難しくなります。PCAは正解ラベルを見ずに軸を選ぶため、分類に必要な差を必ず残すわけではありません。
代表的な次元圧縮手法と使い分け
手法を選ぶときは、何を残したいかを先に考えます。全体のばらつき、既知のグループの違い、足し合わせて説明できる成分、近いデータ同士の関係では、適した方法が異なります。ここでいう「正解ラベル」は、各データの既知の分類を指します。
| 手法 | 正解ラベルの要否 | 残そうとする性質 | 主な用途 | 主な制約・注意点 |
|---|---|---|---|---|
| 主成分分析(PCA) | 不要 | データ全体の分散 | 圧縮、機械学習の前処理、可視化 | 線形の変換であり、単位や外れ値の影響を受ける。予測に必要な情報を落とすこともある |
| 線形判別分析(LDA) | 必要 | クラス内の散らばりに対するクラス間の分離 | 既知のクラスを区別するための特徴抽出 | 得られる軸数は最大でクラス数から1を引いた数。元の特徴量数も上限になる |
| 非負値行列因子分解(NMF) | 不要 | 非負の成分を足し合わせる構造 | 画像や単語頻度データの要約、成分の解釈 | 入力はゼロ以上の値に限る。成分数や初期値で結果が変わり得る |
| t-SNE | 不要 | 近いデータ同士の関係 | 主に2次元・3次元での可視化 | 群間の距離や群の大きさを、そのまま元の空間の性質として読めない |
PCAは、複数の特徴を重み付きで組み合わせる線形変換です。学習した軸を新しいデータにも適用できるため、予測モデルに入力する特徴量を減らす前処理として使えます。各主成分に元の特徴がどれだけ関係するかを調べれば、軸の意味を検討できますが、元の列のように直接名前を付けられるとは限りません。
LDAは、データの分類が分かっている場合に、その違いを捉える軸を探します。同じクラスの点はまとまり、異なるクラスの点は離れるような方向を重視する点が、PCAとの違いです。2クラスなら得られる判別軸は最大1本になります。分類器としても使われる手法ですが、ここでは分類に役立つ低次元表現を作る使い方に注目しています。
NMFは、元のデータを、ゼロ以上の成分とその組み合わせの強さで近似します。ゼロも扱えるので、「正の値だけ」を対象にする手法ではありません。単語の出現回数を並べた表なら、ある話題で一緒に現れやすい単語のまとまりを成分として解釈できる場合があります。画像でも部分的な模様などが成分になることがありますが、常に人間に分かりやすい意味が得られるわけではありません。
t-SNEは、元の空間で近いデータが、低次元でも近くに配置されることを重視する非線形の手法です。複雑なデータを眺めるのに役立つ一方、離れた二つの集団が図上でどれほど離れているかや、集団の面積は慎重に解釈する必要があります。設定や初期値によって見え方も変わるため、きれいに分かれた図だけを根拠に、分類やクラスタリングが成功したと判断しないことが大切です。
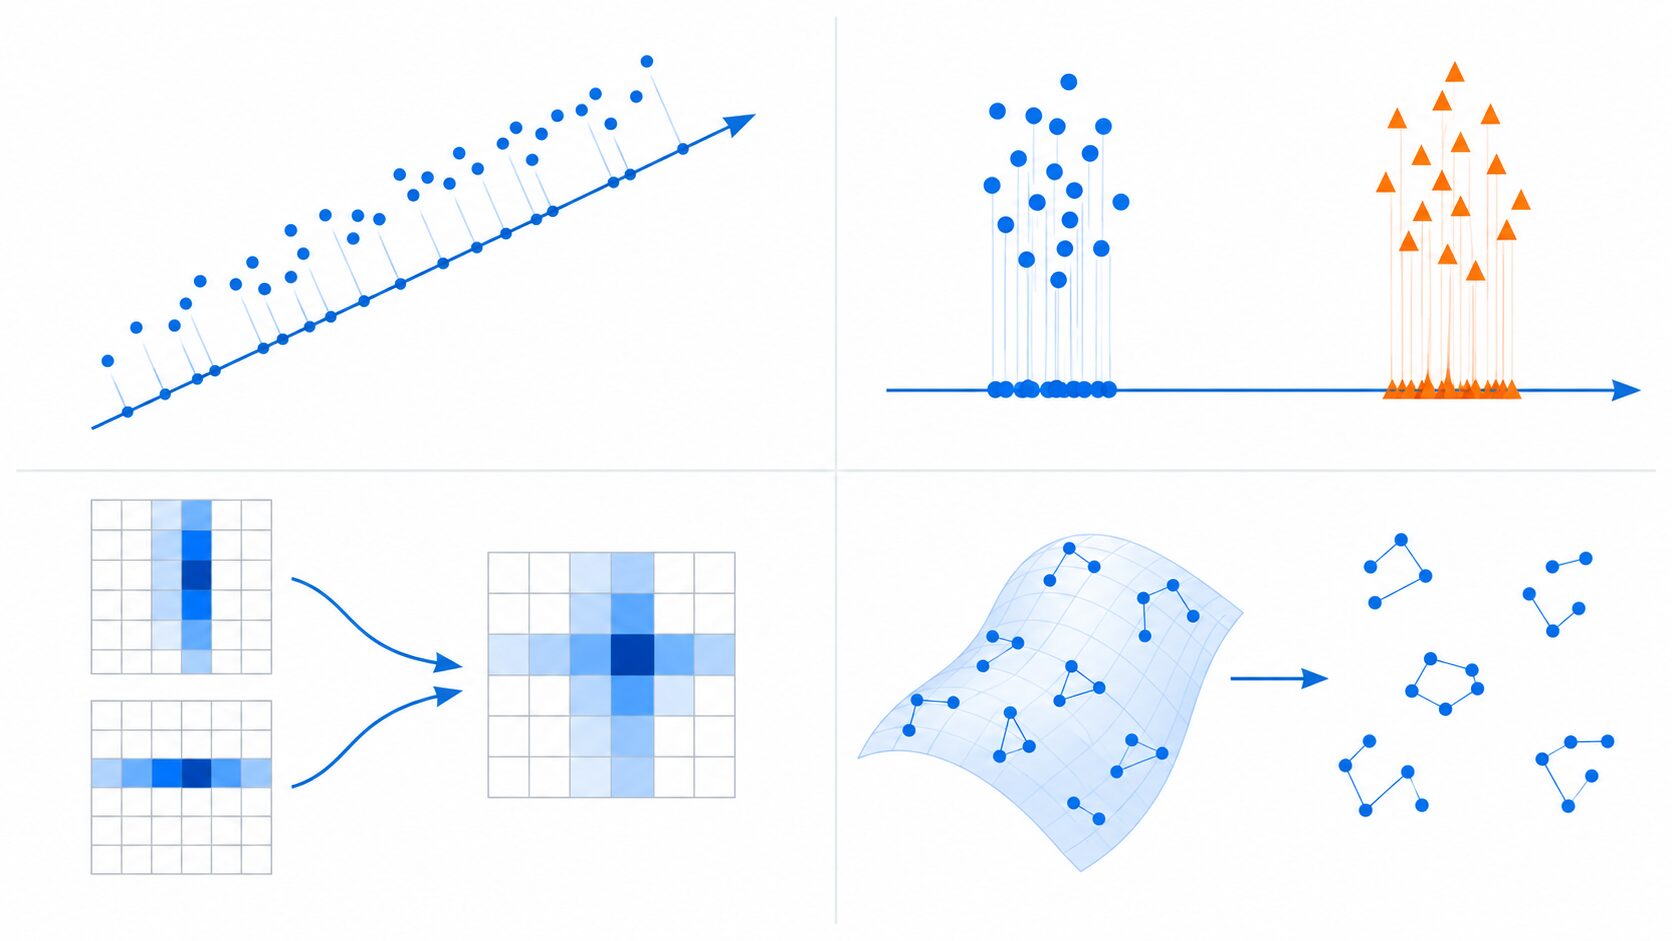
圧縮や前処理ならPCA、ラベルに基づく特徴抽出ならLDA、非負データの成分を読み解くならNMF、近傍関係を可視化するならt-SNEが検討対象になります。どれが一律に優れているかではなく、目的と入力データの条件が合っているかで選びましょう。
画像・顧客・文章・金融での活用例
次元圧縮は、データを分析しやすい表現に変える工程として、さまざまな分野で利用できます。ただし、圧縮した時点で画像認識や顧客分類が完了するわけではありません。得られた少数の特徴を、後段の予測、検索、グループ分けなどにつなげます。
画像認識では、画素の値や、画像から取り出した特徴を少数の成分にまとめます。たとえば、100画素×100画素のグレースケール画像を各画素の値で表すと、1枚で1万次元になります。多くの画像に共通する変化を少数の成分で近似できれば、後段で扱う数値を減らせます。一方、小さな傷や輪郭など、認識に必要な細部まで失うと精度が下がるため、用途に応じた確認が必要です。
顧客分析では、商品カテゴリ別の購入量などをまとめ、購買傾向を調べます。元の列が多くても、少数の座標で表すことで、似た傾向の顧客を探したり、特徴的な行動を確認したりしやすくなります。座標を解釈するときは、どの購入カテゴリが強く関係しているかを、元のデータに戻って確認します。
この後で似た顧客をグループに分ける工程が「クラスタリング」です。次元圧縮は表現を変える操作、クラスタリングは似たデータをまとめる操作であり、目的が異なります。圧縮した座標を使ってクラスタリングすることはできますが、圧縮によって顧客間の距離関係が変わる点にも注意します。
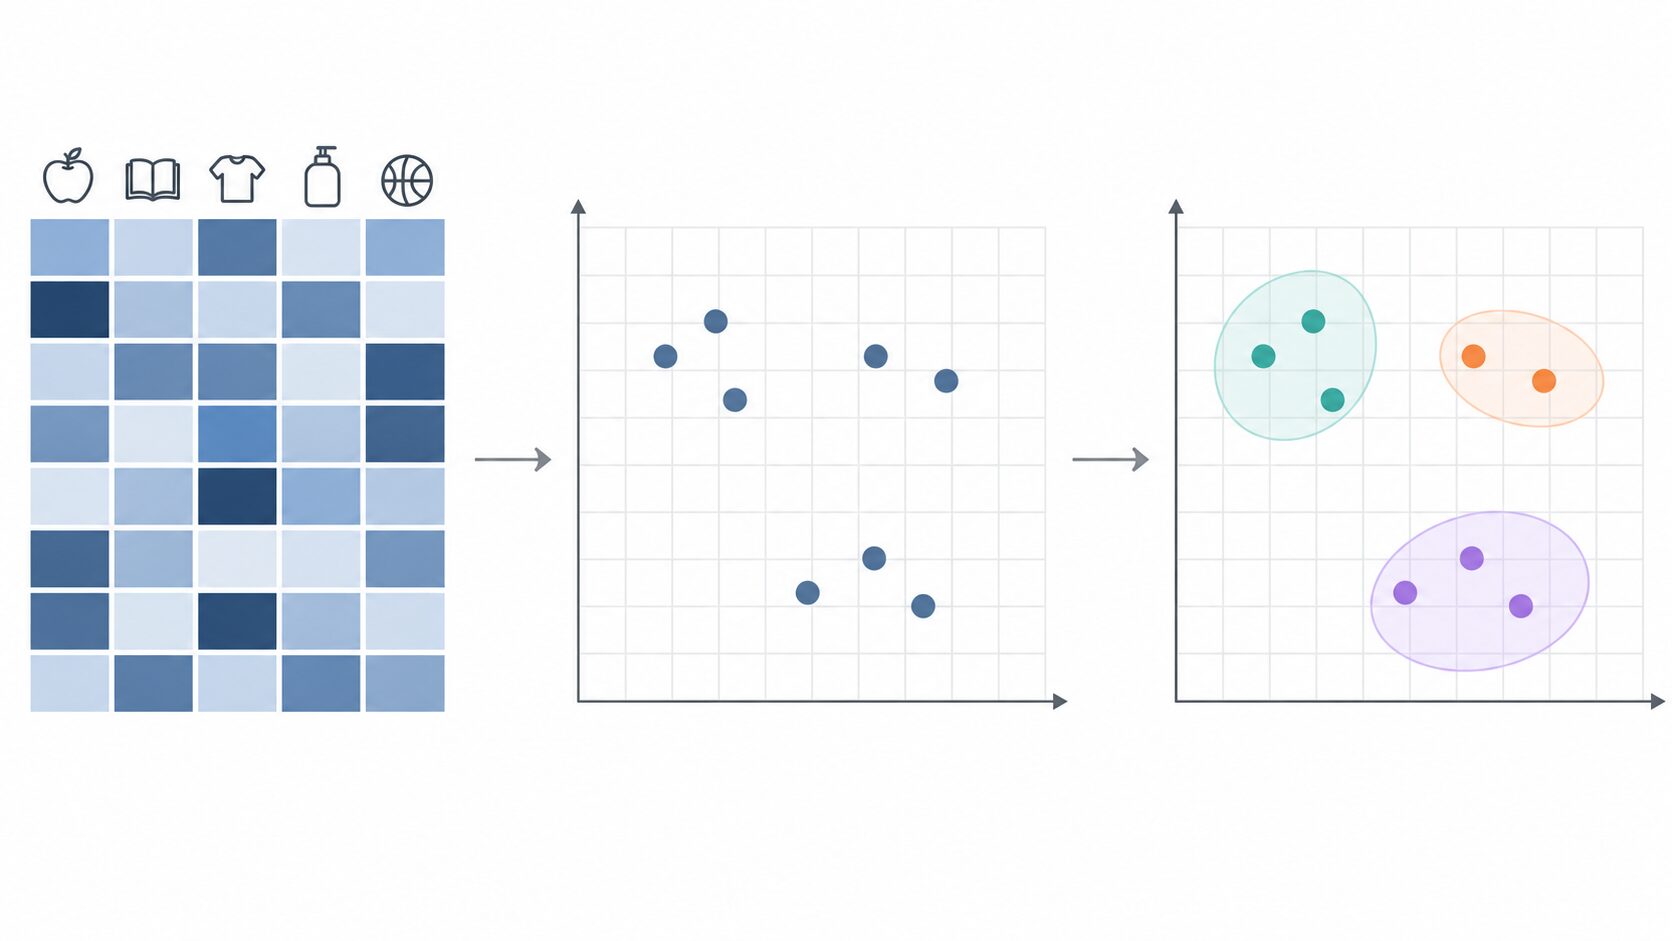
自然言語処理では、文書を単語ごとの出現回数などで表すと、語彙数に応じて次元が大きくなります。NMFなどで少数の成分に近似すれば、文章群に共通する話題の探索や、文書同士の比較に利用できます。ただし、単語頻度だけでは語順や文脈を十分に表せず、圧縮後に意味が完全に保たれるわけでもありません。また、あらかじめ学習された文章の埋め込みベクトルは、単語頻度の表とは異なる表現です。そのベクトルをさらに圧縮する場合も、用途に応じて有効性を確かめます。
金融データの分析では、多くの資産の価格変動や収益率から、共通して動く傾向を少数の成分で整理できます。市場全体に関係する動きと、個別の資産に固有の動きを考える材料になります。ただし、過去のデータから得た関係が将来も続くとは限らず、主成分に経済的な意味が自動的に付くわけでもありません。圧縮した情報は分析材料の一つであり、利益や予測精度を保証するものではありません。
次元数の決め方と利用時の注意点
次元数は、少なければよいというものではありません。扱いやすさと、必要な情報をどれだけ残せるかの両方で判断します。散布図として眺めるなら2次元や3次元が候補になりますが、予測モデルの入力なら、それより多くの次元を残した方がよい場合もあります。
まず、可視化、予測の前処理、データの要約など、目的を決めます。次に欠損値や外れ値、測定単位を確認します。PCAは分散を基準にするので、たとえば重さをグラムで表すかキログラムで表すかによって、結果が変わり得ます。平均を引いて尺度をそろえる標準化は対策の一つですが、本来意味のある変動の大きさまでそろえてしまう場合もあるため、常に実施すればよいとは限りません。NMFに入力する場合は、平均を引く処理によって負の値が生じないかにも注意が必要です。
PCAで次元数を検討するときは、「累積寄与率」が手がかりになります。これは、残した主成分が、PCAに入力したデータ全体の分散のどれだけを説明しているかを表す割合です。たとえば累積寄与率90%なら分散の90%を説明していますが、予測に必要な情報や文章の意味を90%残したという意味ではありません。90%や95%といった値を候補にすることはあっても、すべての課題に共通する正解の基準はありません。
元の特徴へ戻す近似ができる手法では、「再構成誤差」も確認できます。圧縮後の表現から復元した近似値が、元の値とどれだけ違うかを見る指標です。ただし、誤差が小さくても、分類に必要な細かな違いを失っている場合があります。予測に使うなら、後段のモデルの検証結果も合わせて判断します。
予測モデルを評価する場合は、標準化や次元圧縮を学習させる前に、学習用と評価用のデータを分けます。ラベルを使わないPCAでも、評価用データを含めて軸を決めると、本来は未知であるはずのデータの分布を利用してしまいます。これをデータ漏洩と呼び、評価結果が実際の運用を適切に表さなくなる原因になります。
- 元のデータを学習用と評価用に分割します。時系列データなどでは、利用場面に合う分け方にします。
- 標準化の平均や尺度、圧縮の軸などを学習用データだけで求めます。
- 評価用データには、その学習済みの変換を適用します。評価用で軸を作り直してはいけません。
- 候補となる次元数を検証し、圧縮しない場合の精度や処理時間と比較します。
交差検証でも、標準化と次元圧縮は各分割の学習側だけで学習させます。次元数などの設定は検証用データや交差検証で選び、最後の性能確認に使うテストデータは設定選びに使いません。前処理と予測モデルを一つの処理手順にまとめておくと、適用の順序を保ちやすくなります。
評価では精度だけでなく、処理時間、必要なメモリ、結果の説明しやすさも比べましょう。後段の計算が軽くなっても、圧縮の学習や変換自体に時間がかかることがあります。また、元の特徴量なら説明しやすかった判断が、複数の特徴を混ぜた座標になると伝えにくくなる場合もあります。必要な効果が得られなければ、元の特徴量を使うことや、特徴量選択を検討することも妥当な判断です。
深層学習との関係と今後の展望
次元圧縮は、深層学習とも関係があります。代表例の「オートエンコーダー」は、入力をいったん別の表現に変換し、そこから元の入力を再構成するように学習するニューラルネットワークです。途中に低次元の中間表現を置く構成なら、少数の特徴で入力の性質を捉えることを目指せます。
PCAが線形の軸でデータを表すのに対し、オートエンコーダーは非線形の構造を扱う選択肢になります。ただし、再構成しやすい表現が、必ず分類や検索に適しているとは限りません。ネットワークの構成、学習データ、計算量も考慮する必要があり、深層学習を使えば常に単純な手法を上回るわけではありません。また、すべての深層学習で、事前に明示的な次元圧縮が必要になるわけでもありません。
今後の活用を考えるうえでも、大量のデータを要約すること、人が観察できる形に可視化すること、通常と異なるパターンを探索することは重要な用途です。たとえば、再構成の誤差が大きい事例を確認対象にする使い方があります。ただし、大きな誤差がそのまま異常を意味するとは限らないため、元データや業務上の背景と合わせて判断します。
量子計算を用いる次元圧縮も研究上の可能性として考えられますが、データの入力方法や計算環境などの条件を含めた検討が必要です。通常の分析で実用的な高速化が確立しているという前提に立ったり、実現時期を決めつけたりするべきではありません。
次元圧縮を理解する出発点は、「何を残すために、どの表現へ変えるのか」を考えることです。基本的な仕組みをPCAで学び、ラベルの有無や解釈したい性質に応じて手法を比べると、使い分けを捉えやすくなります。次元数を減らした結果を、元のデータと実際の目的の両方に照らして確かめることが、適切な活用につながります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月3日 | 特徴量選択との違いと4手法の比較を補い、次元数の決め方と情報損失の説明を見直した |