
Titansとは?推論時メモリ学習とコンテキスト拡張の違い

AIの初心者
Titansは、AIが会話をずっと覚えてくれる仕組みですか? 長い文章を入力できるモデルとも違うのでしょうか。

AI専門家
特徴は、入力を処理している間にも、モデル内部の記憶用ネットワークを更新することです。会話履歴の保存や、一度に読める文章量の拡大とは仕組みが異なります。過去の文章を一字一句、永久に保存するわけでもありません。
AIの初心者
何を覚え、どう取り出すのかを知ると、要約や検索との違いも分かりそうですね。推論中に「学ぶ」とは、具体的に何が変わることなのですか?
AI専門家
記憶を担う部分のパラメータが変わります。まず通常の推論との違いを押さえ、短期の注意、記憶の更新、忘却の順に見ていきましょう。
Titansとは。
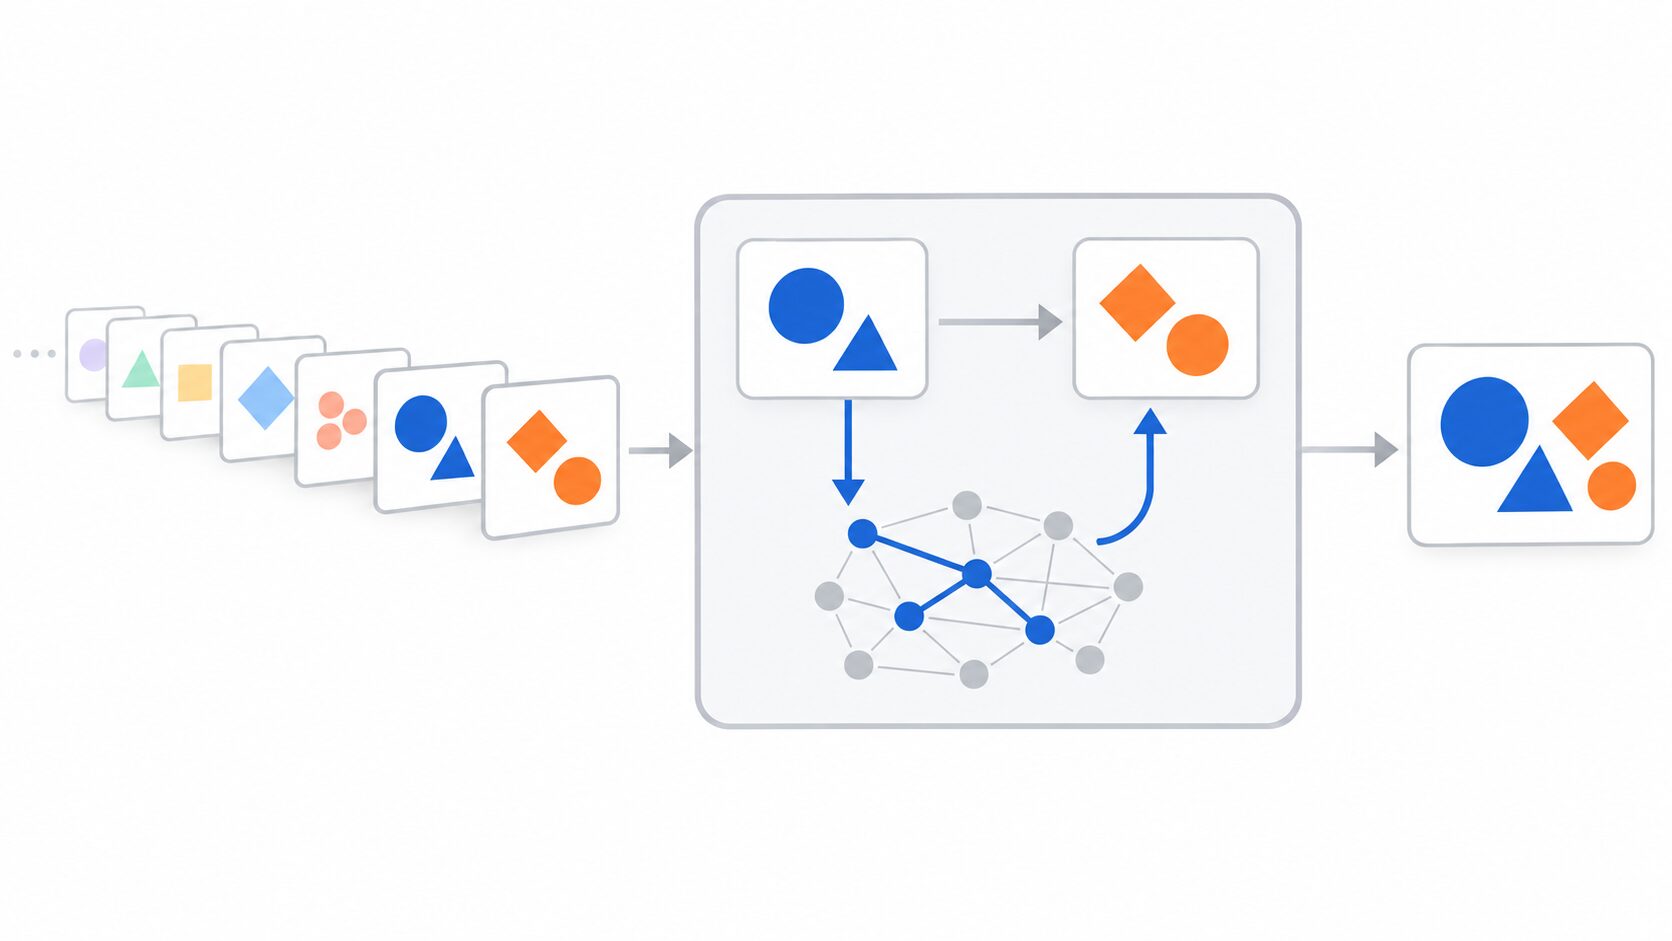
Titansは、推論中にも学習するニューラル長期メモリを、短期的な注意機構などと組み合わせるモデル設計の研究です。ニューラルメモリとは、情報をニューラルネットワークのパラメータに取り込み、後の入力に応じて読み出す仕組みを指します。長い入力の過去の情報を活用することが狙いであり、利用者の会話を恒久的に保存するサービス機能とは区別されます。
読みながら記憶を更新し、後で使う。この流れを押さえると、Titansが長文処理のどの部分を変えようとしているのかが見えてきます。
Titansが推論中に学ぶものとは
通常の言語モデルでは、学習と推論を分けて考えます。学習では、大量のデータを使って、情報の処理方法を決める数値である重みを調整します。推論では、その重みを固定したまま、入力された質問や文章に対する出力を計算します。
会話が進むと返答が変わるのは、必ずしも重みが変化したからではありません。会話履歴が入力に加われば、参照する情報が変わります。また、Transformerで使われるKVキャッシュは、注意機構に必要な途中の計算結果を保持し、同じ計算の繰り返しを減らします。履歴やキャッシュの変化と、パラメータを学習によって更新することは別です。
Titansでは、入力の処理中にも記憶用のニューラルネットワークを更新します。そこで変わるのは、過去の入力から情報を取り込むためのメモリです。新しい文章を読むたびに、言語モデル全体を一から訓練し直すという意味ではありません。
この発想の背景には、入力容量と情報活用の違いがあります。長い報告書が入力欄に収まっても、冒頭の例外条件を最後の質問で正しく使えるとは限りません。「どれだけ入るか」に加え、「離れた情報をどのように保持し、必要なときに使うか」が課題になります。Titansは、後者を考えるための設計です。
短期の注意とニューラル長期メモリの役割
Titansを理解するには、短期の注意、ニューラル長期メモリ、永続メモリという三つの役割を分けると分かりやすくなります。これらは記憶の保存日数による分類ではなく、情報を処理する方法の違いです。
短期の注意は、直近の入力の中で、今の処理に関係する情報を参照します。たとえば「この計画では」という表現が、少し前のどの計画を指すのかを結び付ける働きです。限られた範囲の細かな関係を扱う役割を持ちます。
ニューラル長期メモリは、それまでの入力から学んだ情報をパラメータに取り込みます。図書館のように原文を並べて保存する方式ではなく、手掛かりと情報の対応をネットワークに学ばせる方式です。そのため、長い範囲の情報を反映できる一方、元の文章をそのまま取り出せる保証はありません。
永続メモリは、事前学習によって得られる、処理する入力系列そのものには依存しない知識を担う学習済みのパラメータです。今回読んでいる資料から増える記憶とは役割が異なります。「長期」「永続」という名称から、会話をまたいで利用者情報が保存されると判断することはできません。
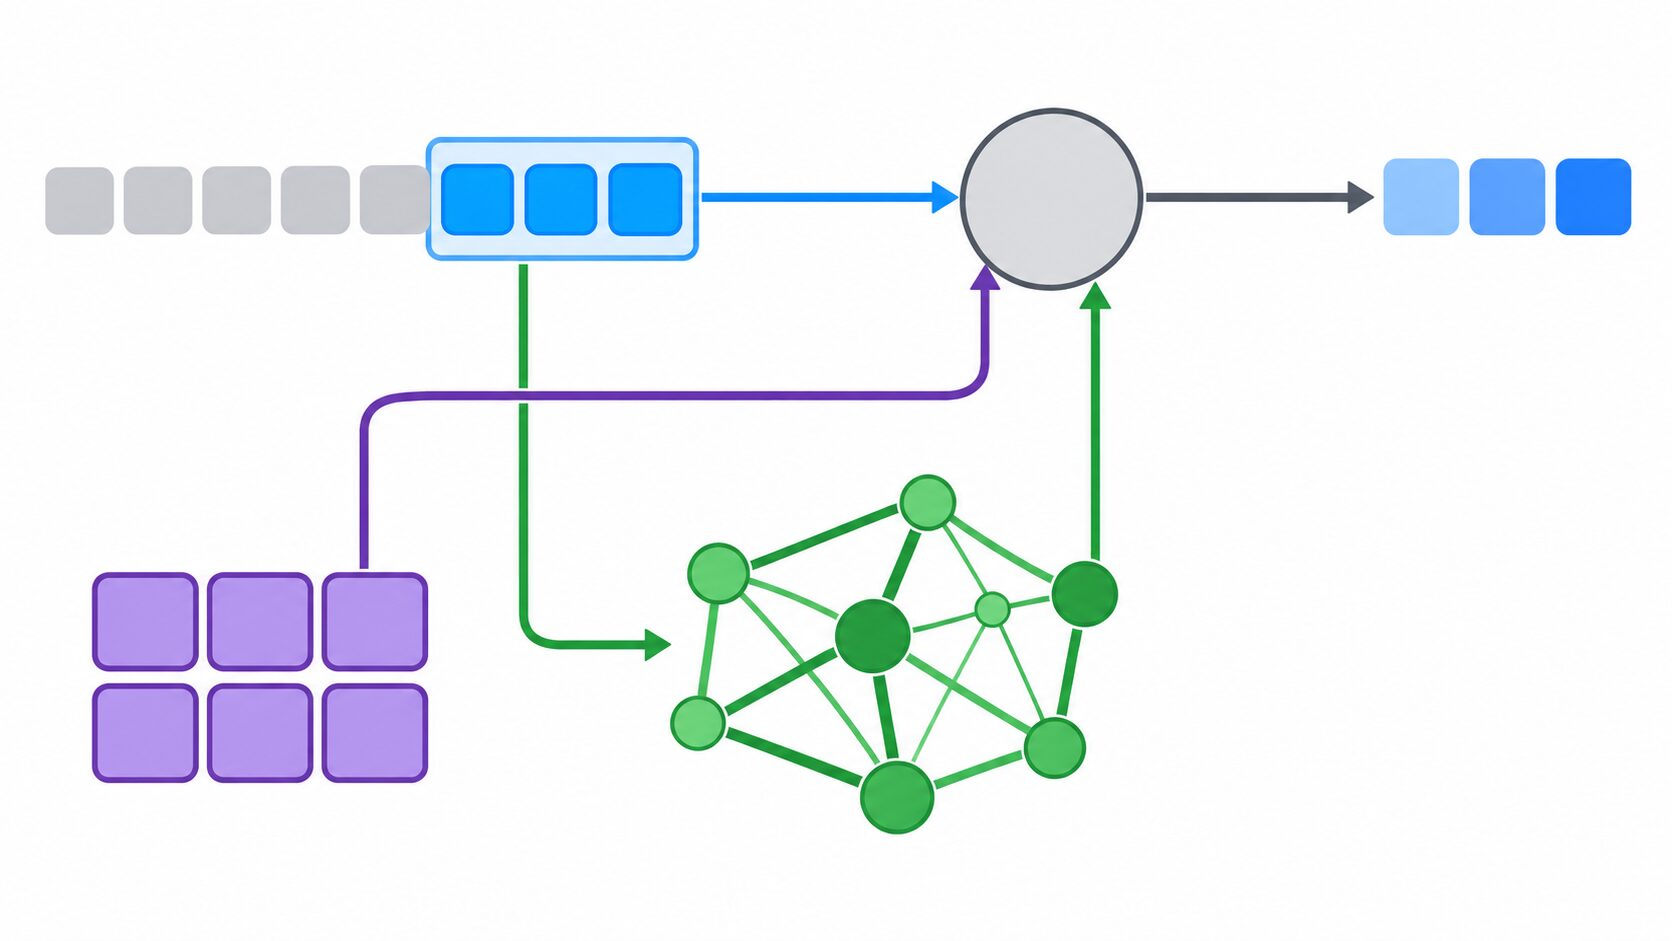
処理の流れとしては、現在の入力から手掛かりを作り、メモリを読み出して、注意機構が扱う情報と組み合わせます。同時に、新しく得た情報によってメモリを更新し、その後の処理に備えます。論文では注意とメモリの結び付け方が複数検討されており、読み出す場所や混ぜ合わせ方がすべて同じとは限りません。
surpriseを手掛かりに覚え、忘れる仕組み
すべての入力を同じ強さで覚えると、限られた記憶が似た情報で埋まったり、新しい情報と古い情報が競合したりします。Titansでは、記憶の更新を考える手掛かりとしてsurprise、つまり「驚き」に相当する量を使います。
ここでいう驚きは、AIが感情を持つという意味ではありません。記憶用ネットワークには、入力から作った手掛かりに対して、対応する情報を再現する学習課題があります。その再現がうまくいかないと誤差が生じ、パラメータをどの方向に変えるべきかを示す勾配が求められます。この誤差や勾配が、記憶を更新する根拠になります。
すでに学んだ内容と合わない入力には、更新が必要になりやすいと考えられます。ただし、記憶にとって予想外であることと、人にとって重要であることは同じではありません。誤記や雑音も予想外になり得るため、重要事項だけを必ず選んで覚える仕組みと理解するのは不正確です。
また、直前までの更新の影響を持ち越す仕組みもあります。これは、ある入力だけを孤立して処理せず、その周辺に続く情報も記憶に反映するための工夫です。一方、古い記憶の影響を弱める忘却は、新しい状況へ適応し、過去の情報が蓄積し続ける問題を抑える役割を持ちます。
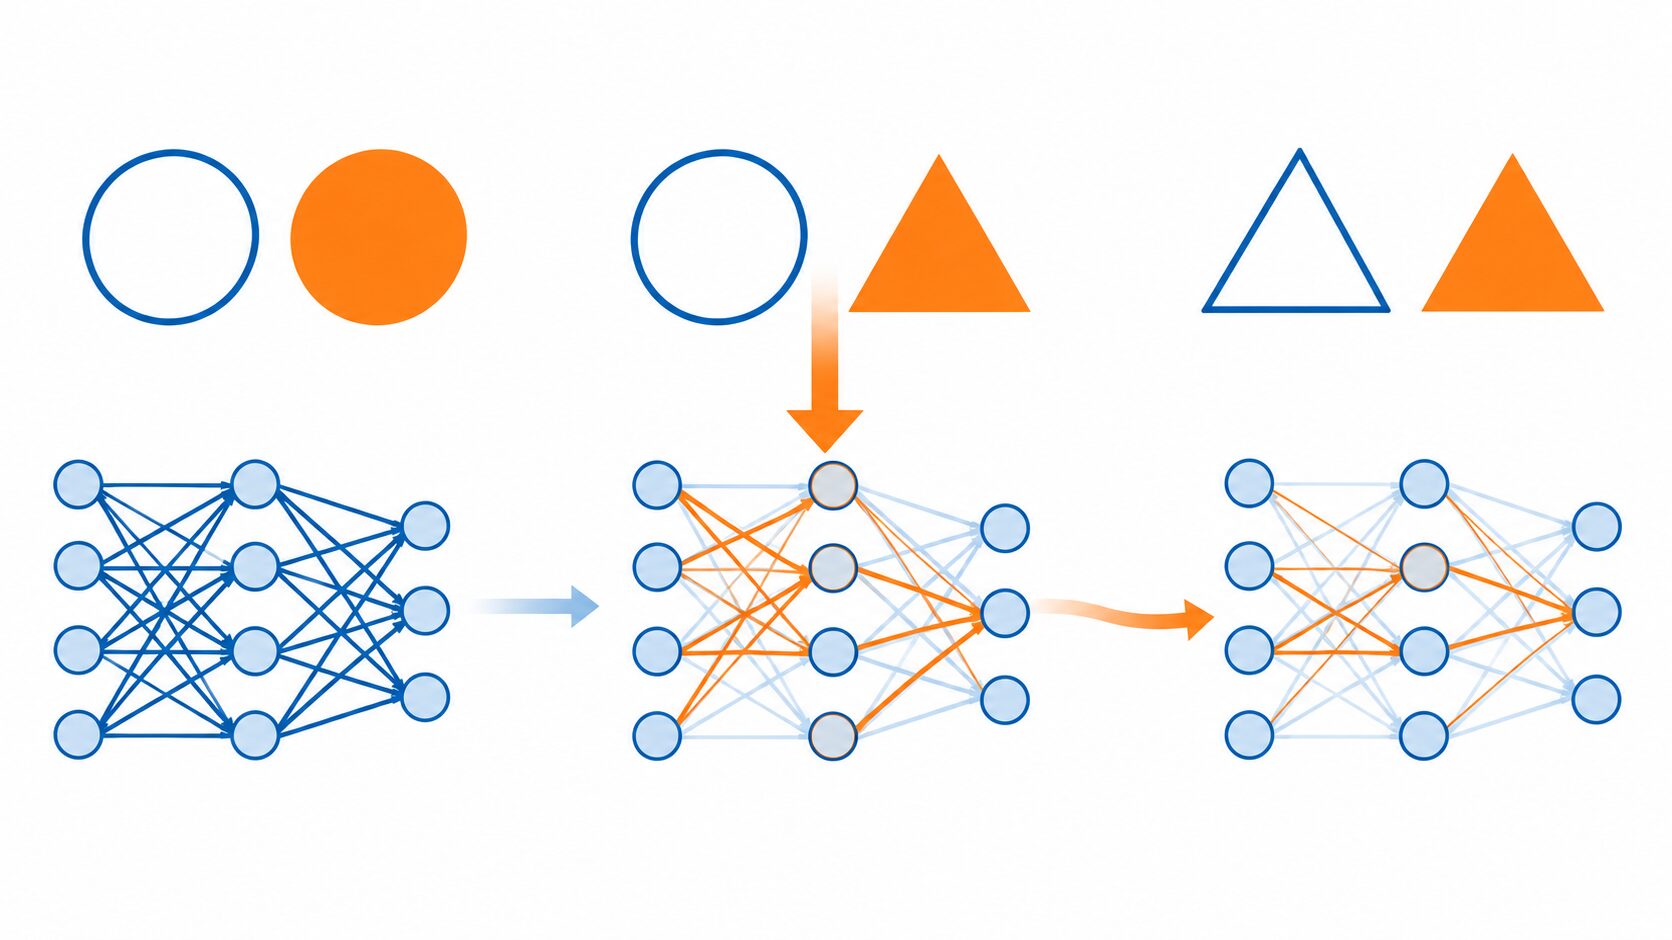
仮に長い議事録の前半で「予算上限は100万円」と決まり、後半で「150万円に変更する」と合意されたとします。新条件を取り込めれば、その後の提案を変更後の予算に合わせられます。しかし「変更前の条件と理由を説明して」という質問には、以前の情報も必要です。新しい状態への適応と、変更の履歴を残すことは別の要求であり、忘却の強さには調整の難しさがあります。
MIRASとTitansはどう関係するのか
Titansが記憶を使うモデルの具体的な設計であるのに対し、MIRASは、そのような記憶ベースのモデルを整理し、新しい設計を考えるための枠組みです。Titansの改称や、同じ製品の次期版を表す名称ではありません。
MIRASで注目するのは、記憶の構造、何を覚えられればよいとするかを決める学習目的、情報を保持・忘却する仕組み、パラメータの更新方法です。「メモリを付ける」という一言の中にも、設計上の選択肢があることを示します。
たとえば、直近の変化を素早く反映したい用途と、長く続く傾向を安定して残したい用途では、望ましい記憶の性質が異なります。MIRASはこうした違いを、共通の観点で考える助けになります。初めて読む段階では、Titansは仕組みの具体例、MIRASは記憶の設計を比較する枠組み、と押さえれば十分です。
コンテキスト拡張・要約・RAGとの違い
似た目的を持つ手法でも、情報の置き場所は異なります。違いを見分けるには、情報をどこに保持するか、推論中にパラメータを変えるか、過去の情報へどうアクセスするかの三点を見ると整理できます。
| 手法・概念 | 主な情報の保持先 | 推論時のパラメータ更新 | 過去情報の参照方法 |
|---|---|---|---|
| Titans | 記憶用ネットワークのパラメータ | メモリを更新する | 現在の入力を手掛かりに、学習した記憶を読み出す |
| コンテキスト拡張 | より長く受け取れる入力列 | 拡張した入力を使うだけなら伴わない | 入力に含めた広い範囲の情報を参照する |
| 文脈内学習 | 入力中の指示や例 | 通常は伴わない | 与えられた例や規則を、その文脈で適用する |
| 履歴の要約 | 短く書き直した文章 | 要約の作成・利用自体には伴わない | 要約文を入力して参照する |
| RAG・外部メモリ | 外部の文書、データベースなど | 検索・参照自体には伴わない | 必要な情報を取得して回答に使う |
| オンライン学習 | 更新対象となるモデルのパラメータなど | データ到着に応じて更新する。回答生成との関係は設計次第 | 更新後のモデルに学習内容を反映させる |
コンテキスト拡張は、一度の処理で受け取れる情報量に関する工夫です。文脈内学習は、入力内の例を見て、その場で回答の仕方を合わせる働きを指します。「学習」という名前が付いていても、通常は重みを書き換えません。要約も、履歴を短い文章に置き換える操作であり、その内容がモデルの知識として追加学習されたことにはなりません。
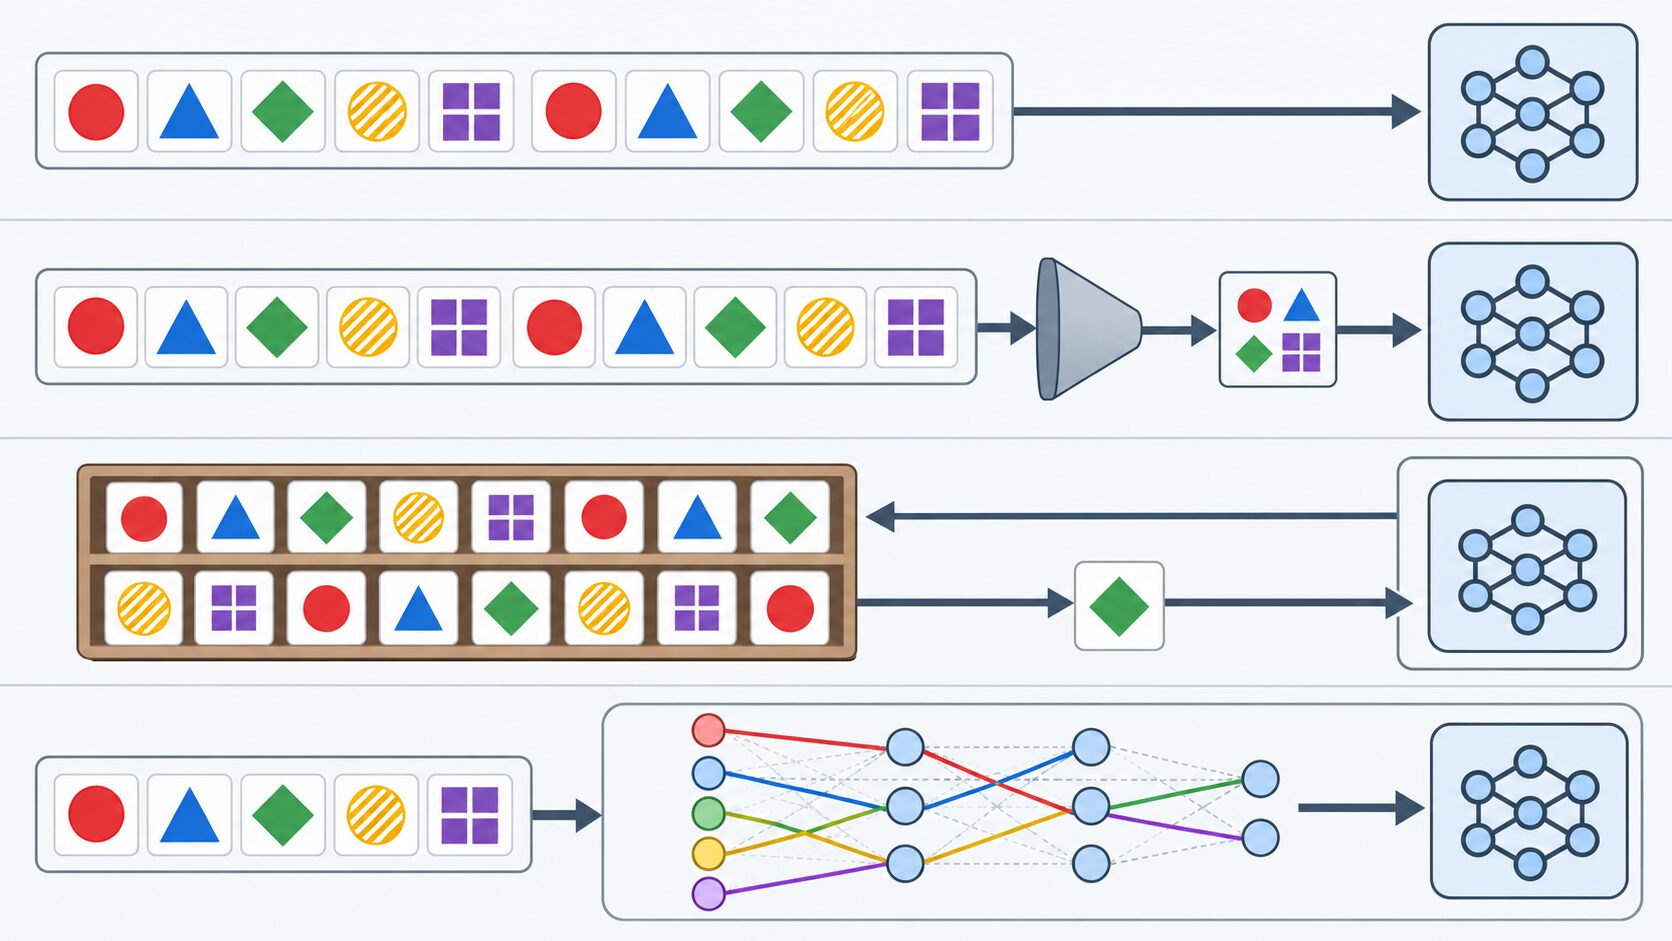
RAGは、外部資料を検索して、その結果を生成に使う方式です。外部メモリは、プロフィールや会話履歴などを外側に保存する仕組みも含む、より広い概念です。外部に記録があっても、必要な情報を取得できなければ回答には使えません。
オンライン学習は、データが到着するたびにモデルを更新する考え方の総称です。Titansの推論時メモリ更新と接点はありますが、オンライン学習のすべてが長文処理用のメモリを備えるわけではありません。これらは排他的な選択肢でもなく、外部検索で原文を補いながら、内部メモリを使うといった組み合わせも考えられます。
長文読解や時系列で期待される使いどころ
期待される用途の一つは、前半で提示された条件を、後半の判断にも使う長文読解です。たとえば、報告書の冒頭に「寒冷地の設備は今回の集計から除外する」とあり、末尾で設備投資の優先順位を尋ねられる場面です。途中に多くのデータが挟まっても、この条件を判断へ反映できることが求められます。
同じ課題でも、全文入力なら報告書全体を文脈に入れ、要約なら除外条件を短い引き継ぎ文に残します。検索なら条件が書かれた箇所を取得します。Titansの考え方では、読み進めながら条件に関わる情報をメモリへ取り込み、後の処理に使います。どの方法でも、条件の取りこぼしがないかを実際の課題で確かめる必要があります。
別の用途として、連続する観測から変化を捉える時系列処理が考えられます。設備の温度や消費電力を追う場合、直近の変動と、それまで続いてきた傾向の両方が判断材料になります。時間とともに記憶を更新する設計は、こうした情報の扱い方を検討するうえで有用です。
これらは仕組みを説明する仮想の応用例であり、その業務での性能や導入実績を示すものではありません。また、学習された記憶を使った回答と、原文の根拠を確認できる回答は別です。条文の引用や数値の照合が必要なら、元の文書と参照位置を残す価値があります。内部メモリだけで出典確認まで済むとは考えないことが大切です。
研究結果を読むときの条件と実用上の課題
研究情報の参照基準日は2026年10月4日です。Titansの原著論文は2024年12月31日付の初稿に始まる研究で、2026年に登場した新製品として扱うのは適切ではありません。Google Researchの2025年12月4日の解説は、TitansとMIRASによる長期メモリの考え方を紹介しています。設計の枠組みについては、MIRASの論文も対応する一次資料です。
論文は改訂されるため、結果を引用するときは参照した版を明らかにする必要があります。本記事では最新版との照合や、一般向けサービスへの搭載・API提供状況の確認は行っていません。2026年10月18日時点の提供状況は未確認であり、研究の仕組みを既存サービスの利用可能な機能と読み替えないようにしてください。
性能を見るときは、モデル規模、扱った系列の長さ、解いた課題、比較した相手、評価指標をセットで読みます。文章中の特定の情報を探す課題で好成績でも、複雑な条件を統合する判断や、正確な引用まで同じように得意とは限りません。長い系列を処理できたという結果も、任意の長さの入力を常に正しく扱える保証ではありません。
実装では、推論中の更新に必要な計算と、回答までの待ち時間の釣り合いが課題になります。注意機構の負担を抑えられる設計でも、メモリの更新には計算が必要です。速さを比べるなら、同じ機器や入力条件で、読み出しと更新を含む処理全体を確認する必要があります。
記憶にも限界があります。新しい情報が古い情報に干渉すること、忘却によって後から必要になる情報が弱まること、原文を正確に再現できないことが考えられます。セッションをまたいで記憶を保持するか、いつ初期化するか、利用者ごとのデータをどう分離・管理するかは実装次第です。
Titansの意義は、長い入力を扱うために、読む範囲だけでなく、推論中の記憶の作り方も設計対象にした点にあります。用途を考える際は、何を残したいのか、どの程度の正確さで取り出したいのか、原文確認が必要かを先に整理すると、要約や検索との役割分担を判断しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月18日 | 初回公開 |