
誤差逆伝播法とは?仕組みと勾配降下法との違いをわかりやすく解説

AIの初心者
「誤差逆伝播法」って難しそうですが、簡単に言うとどんなものなんですか?

AI専門家
カレーの味の調整に例えると、調味料を少し増やしたとき、目標の味からのずれがどう変わるかを調べるイメージだよ。ニューラルネットワークでは、内部の値を少し変えたときに、予測のずれがどう変わるかを計算するんだ。
AIの初心者
ずれを測るだけでなく、調整したときの変化を調べるんですね。では、実際にどれだけ調整するかは、どう決めるんですか?
AI専門家
誤差逆伝播法で求めた「勾配」を、勾配降下法などの更新方法に渡して決めるんだ。一歩の大きさを決める学習率も関係するよ。変化を計算する役割と、その結果を使って値を更新する役割を分けると理解しやすいね。
誤差逆伝播法(バックプロパゲーション)とは、予測のずれを表す損失が、各パラメータの変化によってどう変わるかを、勾配として効率よく計算する方法です。ニューラルネットワークの出力側から入力側へ計算をたどり、重みやバイアスを調整するための情報を求めます。
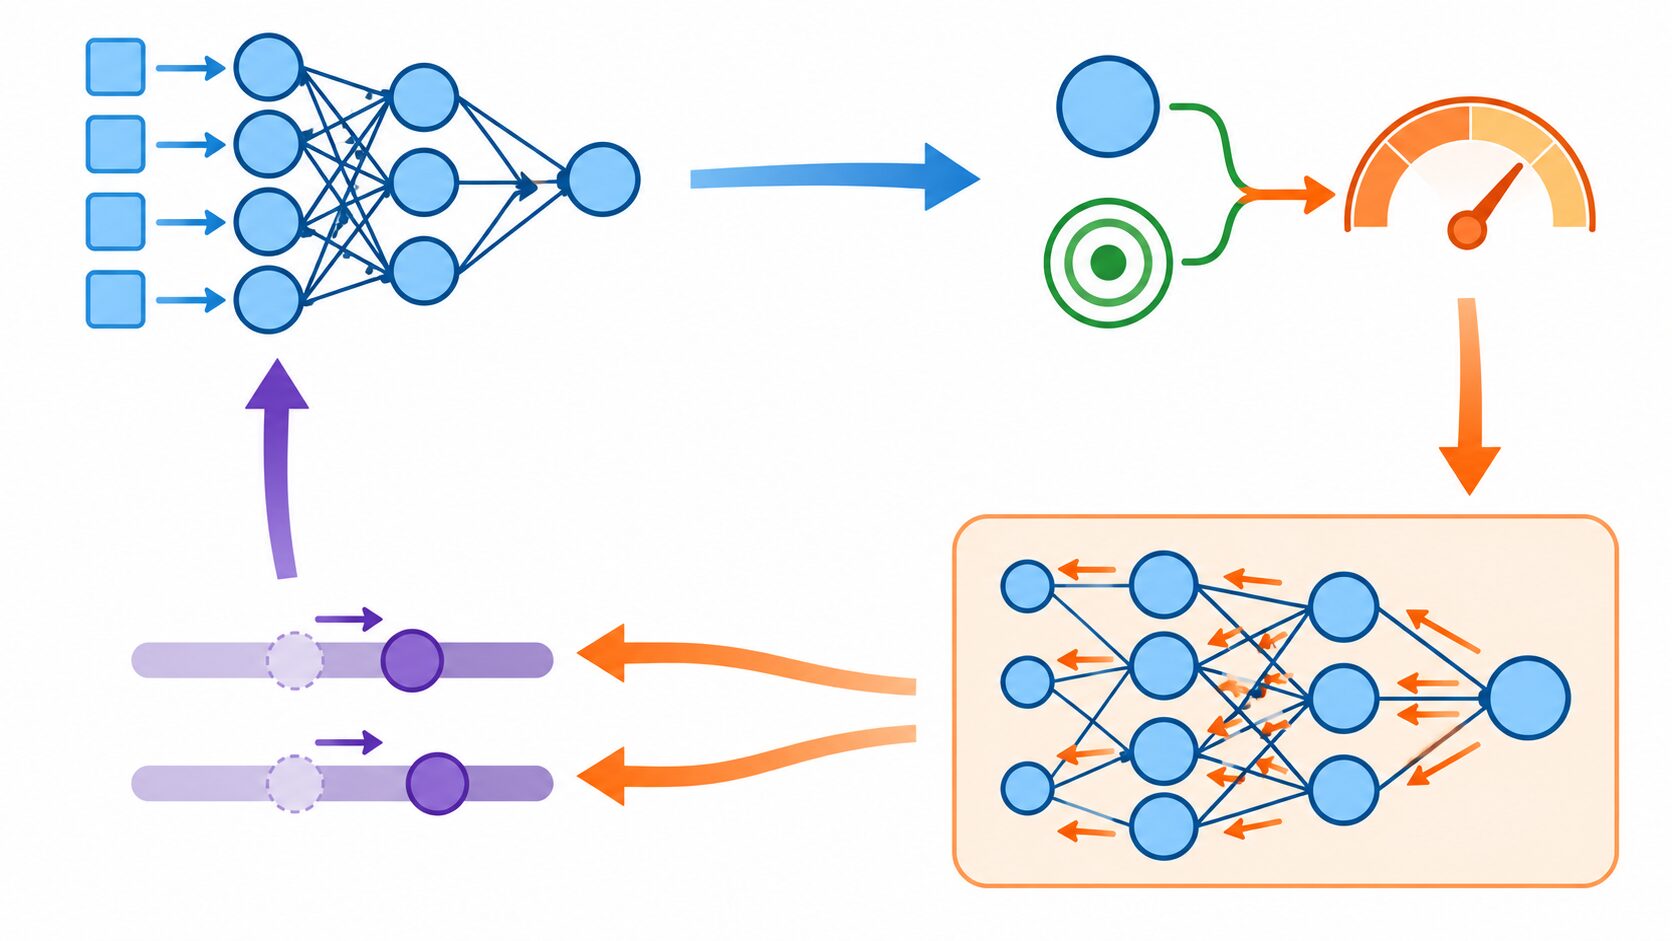
「誤差を逆向きに伝える」と聞くと、間違えた箇所を探して直接直す方法に思えるかもしれません。実際の学習は、予測を出す、損失を計算する、勾配を求める、値を更新する、という段階に分かれます。まず全体の循環を押さえ、その中で誤差逆伝播法が担う勾配計算を、連鎖律と数値例から見ていきましょう。
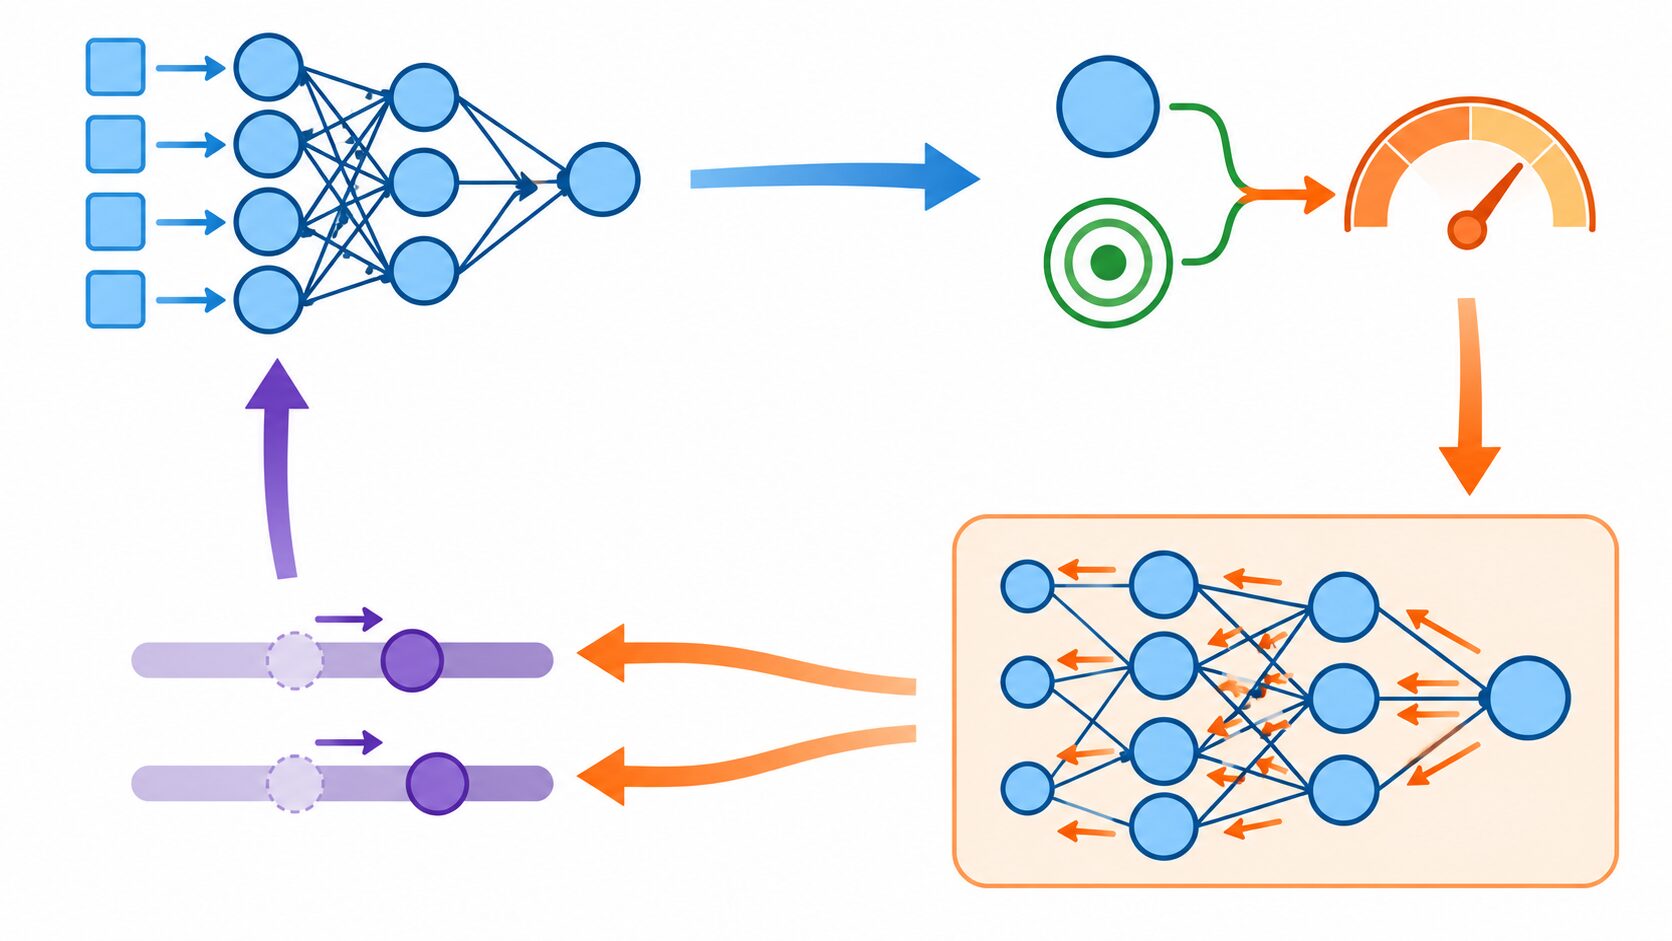
誤差逆伝播法が担う役割
ニューラルネットワークの学習では、多数の数値を調整して予測を改善します。その数値をパラメータと呼び、代表的なものが重みとバイアスです。どの値を増やすか、減らすかを判断するには、現在の値の付近で損失がどの方向に変化するかを知る必要があります。誤差逆伝播法は、数学の連鎖律を使って、この判断材料となる勾配を計算します。
位置づけも確認しておきましょう。機械学習は、データからパターンや規則を学ぶ技術の総称です。ニューラルネットワークはそのためのモデルの一種で、深層学習では多くの層を持つニューラルネットワークを利用します。層を重ねると複雑な特徴を表現できますが、調整する値も多くなります。その多数の値について勾配を効率よく求められることが、誤差逆伝播法の重要な役割です。
ただし、すべてのAIや機械学習が誤差逆伝播法で学習するわけではありません。例えば、決定木はデータを分ける条件を選びながらモデルを作ります。誤差逆伝播法は、主にニューラルネットワークのような、微分を利用してパラメータを調整するモデルで使う方法と捉えるとよいでしょう。
| 用語 | 役割・意味 | 理解の手がかり |
|---|---|---|
| 重み | 入力に掛けて、その入力が次の計算に与える影響を調整する値 | どの情報をどの程度効かせるかを変える |
| バイアス | 重み付きの入力の和に足す値 | 入力との掛け算とは別に、応答の基準をずらす |
| 損失 | 予測が学習の目的からどれだけ外れているかを数値化したもの | 学習で小さくしたい評価値 |
| 勾配 | 各パラメータに対する損失の微分をまとめたもの | 現在の値を少し動かしたときの、損失の変わり方を表す |
ここでいう勾配は、現在の状態での「局所的な変化」を示します。ある重みを大きく動かした先でも同じ変化が続くとは限りません。そのため、一度の計算で最適な値を決めるのではなく、勾配を求めて少し更新し、新しい状態でまた計算する流れを繰り返します。
順伝播から逆伝播までの流れ
学習の流れは、入力から予測へ進む順伝播と、損失側から勾配を計算する逆伝播を分けて考えると追いやすくなります。猫の画像を分類するモデルなら、まず画像を入力し、各層の計算を通して「猫である確率」などの予測を出します。この入力側から出力側への計算が順伝播です。
- 順伝播:現在の重みとバイアスを使い、入力データから各層の出力を順に計算して予測を出します。
- 損失計算:予測を正解と比べ、学習目的に合う損失関数で評価します。
- 逆伝播:損失の微分から出発し、計算を逆順にたどって各パラメータの勾配を求めます。
- パラメータ更新:求めた勾配を使い、勾配降下法などの更新方法で重みとバイアスを変更します。
損失関数は、単なる正解・不正解の数とは限りません。数値を予測する回帰では、予測と正解の差を二乗する二乗誤差がよく使われます。分類では、正解のクラスにどれだけ確率を割り当てたかを評価する交差エントロピーが代表例です。同じ誤分類でも、正解のクラスに割り当てた確率によって損失が変わるため、学習に使う情報が得られます。
逆向きに伝わるのは、予測値や正解そのものではなく、損失の変化を示す勾配の情報です。各層では、後ろの計算から届いた勾配と、その層の計算の微分を組み合わせます。このとき、順伝播で計算した入力値や活性化の値などの中間値も使います。順伝播と逆伝播では、進む方向に加えて、扱う情報の種類も異なります。
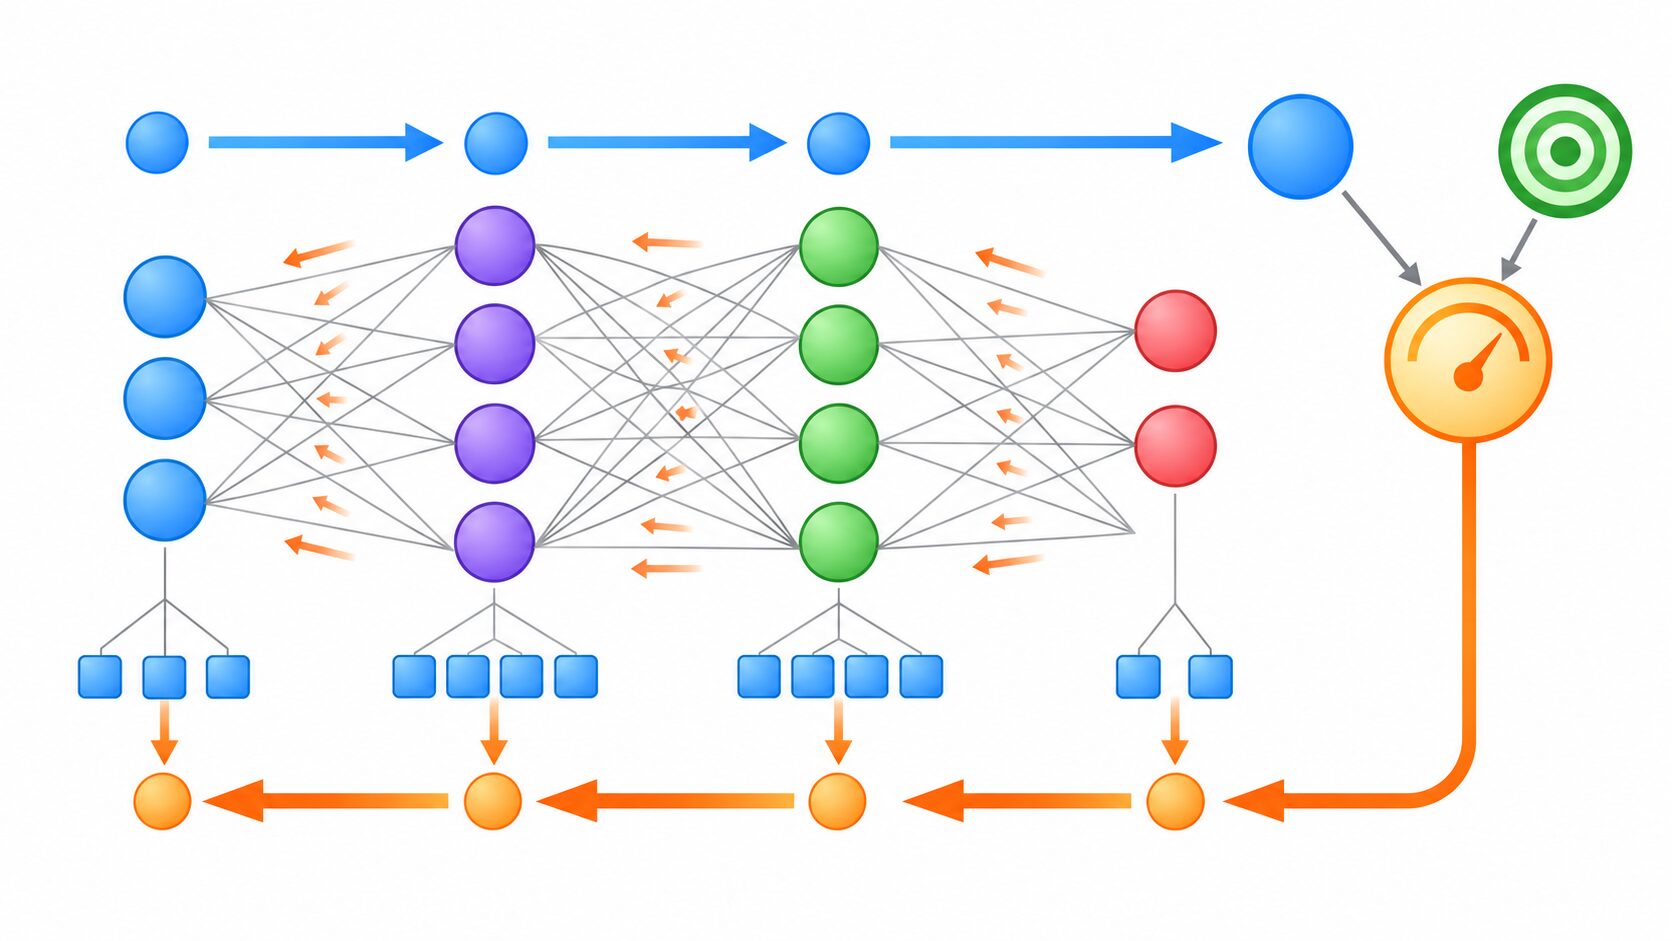
基本的な学習手順では、一回の順伝播で使ったパラメータを固定したまま、必要な勾配を計算し終えます。その後にまとめて更新するため、「逆向きに層を通るたびに、その場で重みを書き換える」という理解は避けましょう。途中で値を変更すると、元の予測を計算したときとは異なる条件で微分することになってしまいます。
実際には、データを小分けにしたミニバッチごとに損失の平均などを求め、計算と更新を繰り返すことが一般的です。例えば32件ずつ画像を処理すれば、一枚だけに基づく更新より多くの情報を使いつつ、全データを一度に処理する負担を抑えられます。学習データ全体を一巡する単位はエポックと呼ばれ、通常は複数のエポックにわたって学習します。
連鎖律で勾配を求める仕組み
連鎖律を確認するため、入力を一つ持つ単純なモデルを考えます。
\(\hat{y}=wx+b,\qquad L=\frac{1}{2}(\hat{y}-y)^2\)\(x\)は入力、\(w\)は重み、\(b\)はバイアス、\(\hat{y}\)は予測、\(y\)は正解、\(L\)は損失です。損失は予測と正解の差を二乗し、2で割っています。係数の\(1/2\)は微分後の式を簡単にするためのもので、この例では予測が正解に近いほど損失が小さくなります。
このモデルでは、重みを変えると予測が変わり、予測が変わると損失が変わります。連鎖律は、このようにつながった計算の微分を、途中の計算ごとの微分を掛け合わせて求める規則です。重みから予測、予測から損失という経路に沿って、変化のつながりを追います。
\(\frac{\partial L}{\partial w}=\frac{\partial L}{\partial \hat{y}}\frac{\partial \hat{y}}{\partial w}=(\hat{y}-y)x\)式の\(\partial L/\partial w\)は、ほかの値を固定して重みだけを少し変えたとき、損失がどれだけ変わるかを示す偏微分です。この例では、予測に対する損失の微分が\(\hat{y}-y\)、重みに対する予測の微分が\(x\)なので、両者を掛ければ重みに対する損失の微分が得られます。
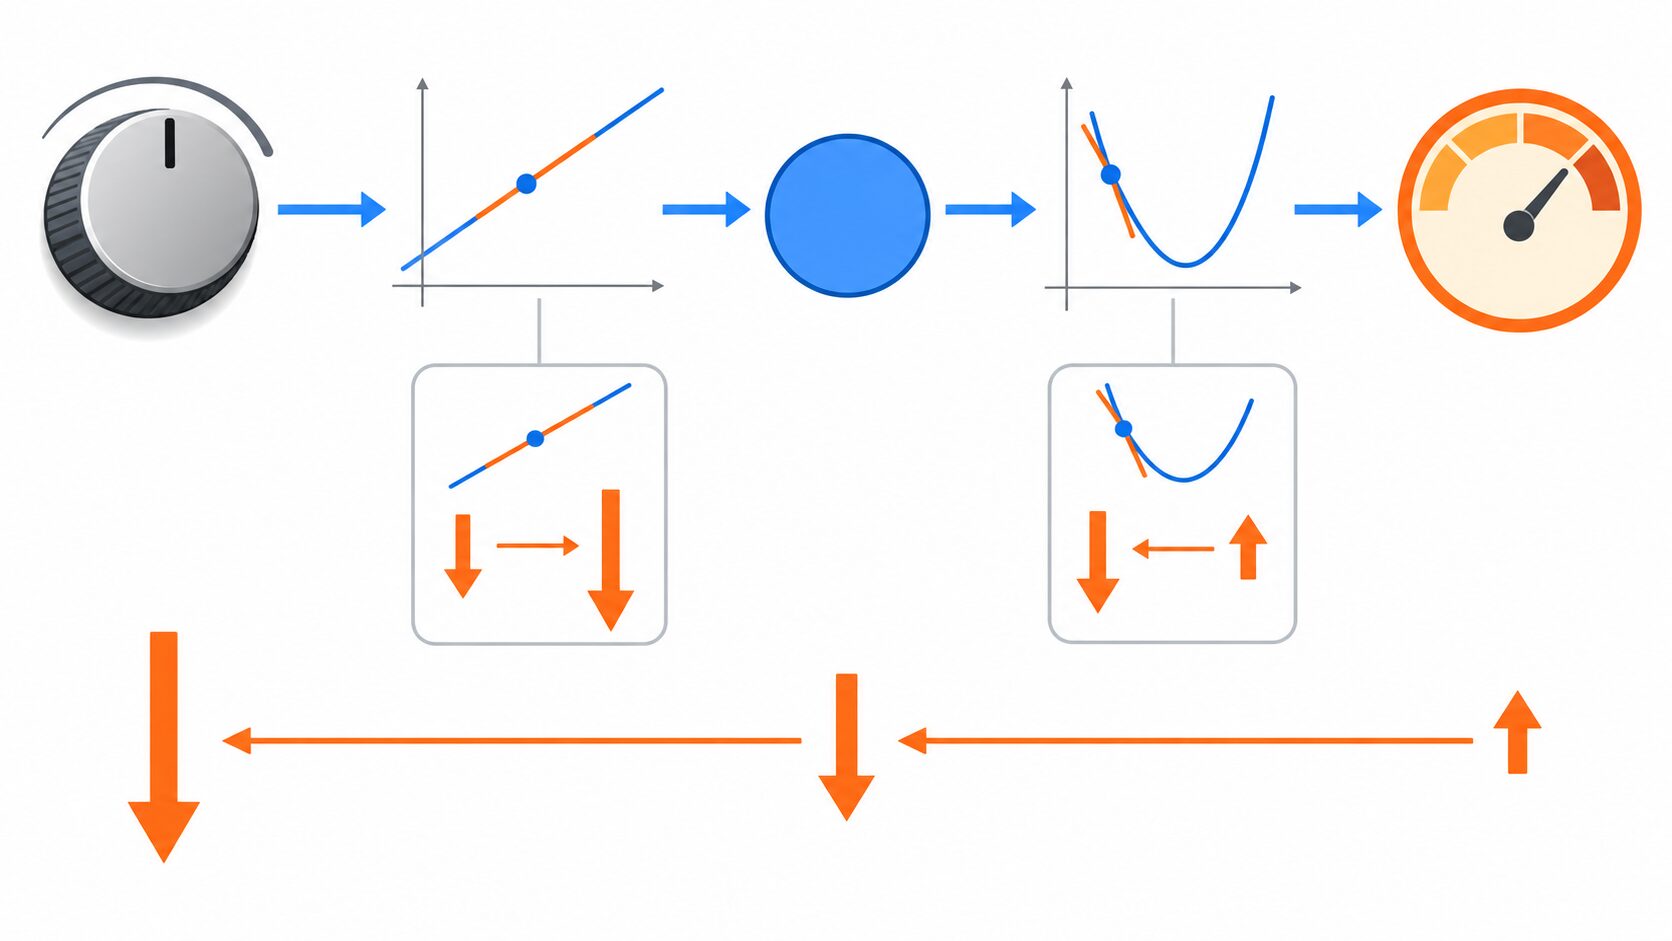
バイアスについても同じように計算できます。バイアスを1だけ増やせば、このモデルの予測も1だけ増えるため、予測のバイアスに対する微分は1です。
\(\frac{\partial L}{\partial b}=\frac{\partial L}{\partial \hat{y}}\frac{\partial \hat{y}}{\partial b}=(\hat{y}-y)\times 1=\hat{y}-y\)深いニューラルネットワークでも、基本はこの繰り返しです。各層の計算を関数と考え、その局所的な微分を順に組み合わせます。ある値から損失までの経路が複数ある場合は、それぞれの経路から来た勾配を足し合わせます。ネットワークを単純な一本の鎖として考えるだけでなく、枝分かれや合流にも同じ規則を適用できる点が大切です。
誤差逆伝播法では、出力側で求めた途中の結果を、その手前の計算にも再利用します。重みを一つずつ少し変えて、そのたびにモデル全体の損失を計算し直す方法に比べ、多数のパラメータの勾配を効率よく求められます。これは、数値を少しずつ動かして差を見る近似とは異なり、計算を構成する演算の微分規則を使う方法です。
勾配の符号が正なら、そのパラメータをわずかに増やすと損失は増える方向に変化し、負なら減る方向に変化します。絶対値はその場所での感度を表しますが、パラメータの尺度にも左右されます。勾配は「間違いの責任が何割あるか」や「唯一の原因がどこか」を示す値ではありません。大きな勾配が出たという理由だけで、無条件に大きく修正してよいわけでもありません。
勾配降下法との違いと学習率
基本的な勾配降下法では、誤差逆伝播法で得た勾配を、次の更新式に使います。
\(\theta\leftarrow\theta-\eta\nabla_{\theta}L\)\(\theta\)は重みやバイアスをまとめたパラメータ、\(\eta\)は学習率、\(\nabla_{\theta}L\)は損失の勾配です。左向きの矢印は、右辺で求めた値を新しいパラメータにすることを表します。勾配は損失が増える向きを示すので、その反対方向へ学習率に応じた分だけ動かします。
誤差逆伝播法は「勾配をどう求めるか」、勾配降下法は「その勾配を使ってどう更新するか」を担います。山の斜面に例えるなら、現在地の傾きを調べる作業と、その傾きを使って下り方向へ一歩進む作業の違いです。両者は組み合わせて使いますが、同じ処理ではありません。
| 比較項目 | 誤差逆伝播法 | 勾配降下法 |
|---|---|---|
| 目的 | 損失の各パラメータに対する勾配を効率よく計算する | 損失を小さくするためにパラメータを更新する |
| 使う情報 | 計算のつながり、各演算の微分、順伝播の中間値 | 現在のパラメータ、勾配、学習率 |
| 得られるもの | 各パラメータの勾配 | 更新後のパラメータ |
| 学習の中での位置 | 損失計算の後、更新の前 | 勾配計算の後、次の順伝播の前 |
学習率は、一歩の大きさを調整する係数です。同じ勾配でも、学習率が大きければ更新幅は大きくなります。大きすぎると損失の低い領域を飛び越えて振動したり、損失が増え続けて発散したりします。小さすぎる場合は一回ごとの変化が乏しく、十分に改善するまで多くの更新が必要になります。
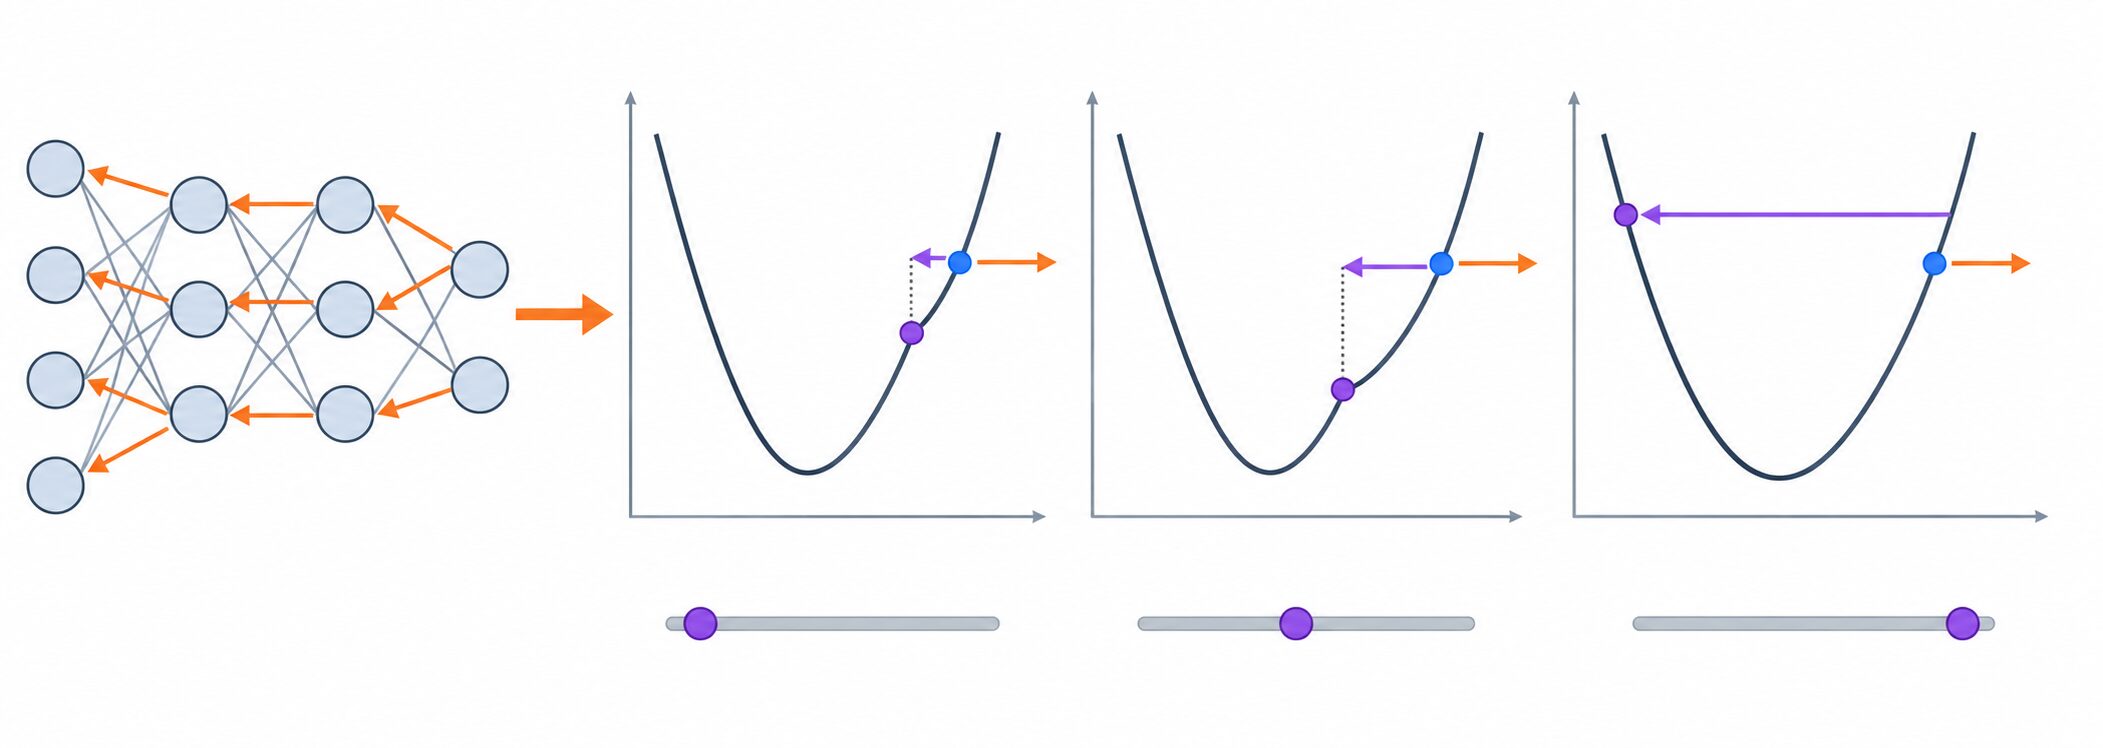
更新方法には、データの一部から求めた勾配を使うSGD(確率的勾配降下法)や、過去の勾配の情報を利用してパラメータごとの更新を調整するAdamなどがあります。これらは最適化手法、あるいはオプティマイザと呼ばれます。どちらも誤差逆伝播法から勾配を受け取る側にあり、Adamを選んだ場合でも学習率の設定は関係します。
なお、勾配は現在地の情報なので、逆方向へ動けばどんな更新幅でも改善するとは限りません。ミニバッチごとに対象データも変わるため、学習中の損失は上下することがあります。複雑なニューラルネットワークでは、毎回の損失の減少や、全体で最も損失が小さい大域的最小値への到達が保証されるわけではありません。
数値例で見る1回の学習
ここまでの線形モデルと損失を使い、一件のデータに対する計算を追います。条件は次のとおりです。
\(x=2,\quad y=4,\quad w=1,\quad b=0,\quad \eta=0.1\)まずは順伝播です。入力2に重み1を掛けてバイアス0を足すので、予測は2です。正解4との差はマイナス2で、その二乗を2で割ると損失は2になります。
\(\hat{y}=1\times 2+0=2,\qquad L=\frac{1}{2}(2-4)^2=2\)次に、更新前の同じ値を使って、重みとバイアスの両方の勾配を求めます。連鎖律で求めた式に代入すると、重みの勾配はマイナス4、バイアスの勾配はマイナス2です。
\(\frac{\partial L}{\partial w}=(2-4)\times 2=-4,\qquad \frac{\partial L}{\partial b}=2-4=-2\)学習率0.1を掛けた勾配を、それぞれの現在値から引きます。今回は勾配が負なので、負の値を引くことで、重みとバイアスはいずれも増えます。重みだけを先に変更してバイアスの勾配を計算し直すのではなく、先ほど求めた二つの勾配を同じ更新に使います。
\(w_{\mathrm{new}}=1-0.1\times(-4)=1.4,\qquad b_{\mathrm{new}}=0-0.1\times(-2)=0.2\)更新後の値で、同じ入力に対してもう一度予測します。予測は3となり、正解4に近づきました。損失も2から0.5へ下がっています。
\(\hat{y}_{\mathrm{new}}=1.4\times 2+0.2=3,\qquad L_{\mathrm{new}}=\frac{1}{2}(3-4)^2=0.5\)| 確認する値 | 更新前 | 更新後 |
|---|---|---|
| 入力/正解 | 2/4 | 2/4(同じデータ) |
| 重み | 1 | 1.4 |
| バイアス | 0 | 0.2 |
| 予測 | 2 | 3 |
| 損失 | 2 | 0.5 |
| この更新に使った勾配 | 重み:−4、バイアス:−2 | 更新前に求めた勾配を使用 |
この例で確認したいのは、勾配を計算した段階では予測は変わらず、その勾配を使ってパラメータを更新すると、次の予測が変わるという順序です。続けて学習するなら、新しい値で順伝播と逆伝播をやり直します。また、一件のデータの損失が下がったことだけでは、ほかの入力でも正しく予測できるとは判断できません。
画像・言語・音声での使いどころ
誤差逆伝播法は、画像を見分けたり文章を生成したりする処理そのものの名前ではありません。そうした処理を行うニューラルネットワークを訓練するときに、パラメータの勾配を求める共通の手段です。対象が画像、文章、音声に変わっても、モデルの出力を損失で評価し、その勾配から学習するという基本は共通しています。
画像認識では、犬と猫の分類、写真内の物体の位置を探す物体検出、顔認証などに使うモデルの学習を支えます。畳み込みニューラルネットワークでは、入力に近い層が輪郭などの単純な特徴を捉え、深い層がそれらを組み合わせた複雑な特徴を捉える、という説明が典型的です。ただし、各層に「ここは目、ここは鼻」と人間が必ず役割を割り振るわけではなく、特徴の表現は学習を通して形成されます。
自然言語処理では、機械翻訳、感情分析、文章要約、対話システムなどの学習に使われます。例えば、文章中の次の単語やトークンを予測する課題では、正解のトークンに高い確率を割り当てるような損失を設計できます。その損失の勾配を求めて重みを更新することで、文脈に応じた予測を学んでいきます。
音声を扱うモデルでも、音声の文字起こしや、話者の感情を推定する課題などで利用されます。文字起こしでは音声と対応する文字列、感情推定では音声と感情のラベルなど、目的に応じたデータと損失が必要です。雑音を含む音声への対応力も、誤差逆伝播法だけで決まるのではなく、学習データの多様性やモデルの設計に左右されます。
| 分野 | 用途の例 | 学習で改善したいこと |
|---|---|---|
| 画像 | 犬猫の分類、物体検出、顔認証 | カテゴリ、物体の位置、顔の対応などを適切に予測する |
| 言語 | 翻訳、感情分析、要約、対話 | 文脈や課題に合う単語・トークンやラベルを予測する |
| 音声 | 文字起こし、話者感情の推定 | 音声に対応する文字列やラベルを予測する |
ここでは学習と推論の違いも押さえておきましょう。学習では損失を計算してパラメータを更新します。一方、学習済みモデルで新しい写真を分類するなどの通常の推論では、重みやバイアスを固定したまま順伝播で出力を求めます。回答や予測を一回出すたびに、必ず逆伝播して学び直しているわけではありません。
学習の注意点と効率化の課題
誤差逆伝播法を使えば、どんなモデルでも安定して学習できるわけではありません。連鎖律では微分を何段も組み合わせるため、層が深くなると、伝わる勾配が極端に小さくなったり大きくなったりすることがあります。小さくなりすぎる勾配消失では入力側の層などが学習しにくくなり、大きくなりすぎる勾配爆発では更新が不安定になります。
対策は症状に応じて選びます。活性化関数や重みの初期化を工夫することは、勾配の大きさを保ちやすくするうえで役立ちます。また、層を飛び越える経路を設ける残差接続は、深いモデルで勾配が伝わる経路を確保する助けになります。勾配爆発に対しては、勾配の大きさに上限を設ける勾配クリッピングも選択肢です。ただし、クリッピングは小さくなった勾配を復活させる方法ではありません。
もう一つの注意点は、学習データでの損失低下と、未知のデータに対する予測性能は別に確認する必要があることです。学習データの細かな特徴や偶然の偏りに合わせすぎると、過学習が起こります。更新に使わない検証データでも損失や目的に合う指標を確認し、正則化で過度な適合を抑える、検証性能が改善しなくなったら早期終了する、といった対策を検討します。
適用できる計算にも条件があります。通常の逆伝播では、勾配を流したい経路の演算について微分を計算できることが必要です。微分できない点を一部に含んでも、ReLUのように、その点で使う値を定めて扱える演算はあります。一方、最大の値を持つクラスを一つ選ぶ処理や、数値を整数に丸める処理などの離散的な判断を挟むと、そのままでは学習に有用な勾配を伝えにくくなります。分類では、最終的なクラス選択の前にある確率などから損失を計算するのが基本です。
規模が大きくなると、計算時間に加えてメモリも課題になります。逆伝播では順伝播の中間値を使うため、多くの層や長い入力を扱うほど、それらを保持する負担が増えます。中間値の一部だけを保存し、逆伝播で必要になったところを再計算する方法は、メモリ使用量を減らす工夫です。その代わり再計算が増えるので、必ず学習時間も短くなるわけではありません。
元の学習を少ない資源で実行する工夫と、学習データの質を上げる工夫も分けて考えましょう。前者は計算量や中間値の保存方法を見直す取り組みです。後者は、ラベルの誤りや偏りを減らし、実際に使う場面に合うデータを揃える取り組みで、同じ計算でも学習から得られる効果を変えます。複雑な構造でも勾配を安定して伝える設計と合わせて、学習の効率や実用性を高めるうえで大切な課題です。
誤差逆伝播法を理解する出発点は、予測のずれを損失で測り、連鎖律で勾配を求め、更新方法がその勾配を使う、という関係です。この役割分担が分かれば、学習率を変える理由や、学習が進まないときに勾配・データ・更新方法をそれぞれ確認する意味もつかみやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月2日 | 初回公開 |
| 2026年10月3日 | 勾配計算と更新の役割を区別し、連鎖律の数値例と学習時の注意点を追記 |