
AdaBoundとは?学習率の仕組みとAdam・SGDとの違い

AIの初心者
『AdaBound』とは、どんな最適化手法ですか? Adamとモーメンタムのよいところを組み合わせる、という説明が気になっています。

AI専門家
AdaBoundは、パラメータごとの学習率に上限と下限を設ける手法だよ。初期はAdamに近い適応的な更新を行い、上下限が近づくにつれて、モーメンタム付きSGDに近い更新へ移っていくんだ。
AIの初心者
学習の途中で手動で切り替えなくてもよいのですか? また、学習率は必ず小さくなるのでしょうか?
AI専門家
上下限を変化させる仕組みによって、徐々に移っていくよ。大きすぎる学習率は抑え、小さすぎる学習率は引き上げるので、すべてが小さくなるわけではないんだ。設定の調整や、検証データでの評価も必要だよ。
AdaBoundは、パラメータごとの学習率に動的な上限と下限を設け、Adamに近い更新からモーメンタム付きSGDに近い更新へ移行させる最適化アルゴリズムです。学習初期の進みやすさと、未知のデータに対する汎化性能の両立を目指します。
仕組みを理解する鍵は、「学習率を一律に小さくする」のではなく、「大きすぎる値と小さすぎる値の両方を制限する」ことです。この記事では、学習率の基礎からクリッピングの数値例、Adam・SGDとの違い、利用時の設定と評価方法までを順に説明します。
AdaBoundとは:学習の速さと汎化性能をつなぐ最適化手法
機械学習では、モデルの予測と正解のずれを損失関数で数値化し、その値が小さくなるように重みなどのパラメータを更新します。この更新方法を決めるのが、最適化アルゴリズム、またはオプティマイザです。AdaBoundはモデルの構造や学習データを変える技術ではなく、学習中にパラメータをどう動かすかを決める手法に当たります。
設計上の出発点は、Adamのような適応的な学習率の利点を生かしながら、学習後半の更新をSGDに近づけることです。Adamはパラメータごとに勾配の履歴を利用して更新の係数を変えます。AdaBoundは、その係数が取り得る範囲を徐々に狭めることで、適応性の強さを時間とともに変えていきます。
ここで区別したいのが、訓練データへの当てはまりと汎化性能です。訓練損失がすぐ下がっても、初めて見るデータへの予測がよくなるとは限りません。例えば、学習に使った動物写真では正解できても、背景や撮影条件が違う写真では間違える場合があります。AdaBoundが目指すのは、学習の進みやすさを保ちながら、こうした未知のデータへの性能も得られるようにすることです。
ただし、これは手法の狙いであり、どの問題でもAdamやSGDを上回るという保証ではありません。データ、モデル、学習率の設定、学習に使える時間によって結果は変わります。
学習率・勾配・モーメンタムの基礎
学習率は、パラメータを更新するときの大きさを調整する係数です。山の斜面を下りながら低い場所を探す場面に例えると、勾配は斜面の傾き、学習率は移動の大きさを調整する役割を持ちます。学習率が大きすぎると低い場所を通り過ぎて振動し、小さすぎると進みが遅くなることがあります。
実際の更新量は学習率だけで決まるわけではなく、勾配やその移動平均の大きさにも依存します。そのため、学習率が一定でも更新量は変化します。「学習率が半分なら学習時間も倍になる」といった単純な関係ではありません。
基本的なSGD、つまり確率的勾配降下法は、学習データの一部から計算した勾配を使ってパラメータを更新します。同じパラメータグループの中では共通の学習率を用いますが、勾配が異なるので各パラメータの移動量まで同じになるわけではありません。
モーメンタムは、過去の勾配の影響を残して更新を滑らかにする考え方です。小さな揺れに毎回反応するのを抑え、一定の方向へ進みやすくします。SGDに組み合わせることができ、Adamにも勾配の移動平均という関連する仕組みが含まれています。
したがって、AdaBoundを「Adamに途中からモーメンタムを追加する方法」と理解するのは正確ではありません。主に変わるのは、パラメータごとに異なる学習率の係数を、どこまで自由に動かせるかという点です。
AdaBoundの仕組み:学習率の上限と下限を近づける
AdaBoundは、Adam型の計算で得られるパラメータごとの学習率を、下限から上限までの範囲に収めます。範囲の外に出た値を境界へ戻す操作が「クリッピング」です。上限・下限を固定するのではなく、学習ステップに応じて変えるところが特徴です。
- ミニバッチと呼ばれる学習データのまとまりから、現在の損失と勾配を計算します。
- 勾配の移動平均と、勾配を二乗した値の移動平均を更新し、Adam型の適応的な係数を求めます。
- その時点の上限・下限で係数をクリッピングし、極端に大きい値と小さい値を制限します。
- 制限後の係数と勾配の移動平均を使って、パラメータを更新します。
学習初期は上下限の間隔を広く取り、Adamに近い自由度を残します。学習が進むと、上限は下がり、下限は上がり、両方が共通の最終学習率に近づきます。パラメータ間の係数の差が小さくなるため、更新はモーメンタム付きSGDに近い形になります。
| 学習段階 | 学習率の範囲 | 更新の特徴 |
|---|---|---|
| 初期 | 上下限の間隔が広い | パラメータごとの適応的な調整を生かしやすい |
| 中期 | 上限が下がり、下限が上がる | 範囲外の係数が制限され、極端な差が抑えられる |
| 後期 | 上下限が共通の値へ近づく | 係数がそろい、モーメンタム付きSGDに近い更新になる |
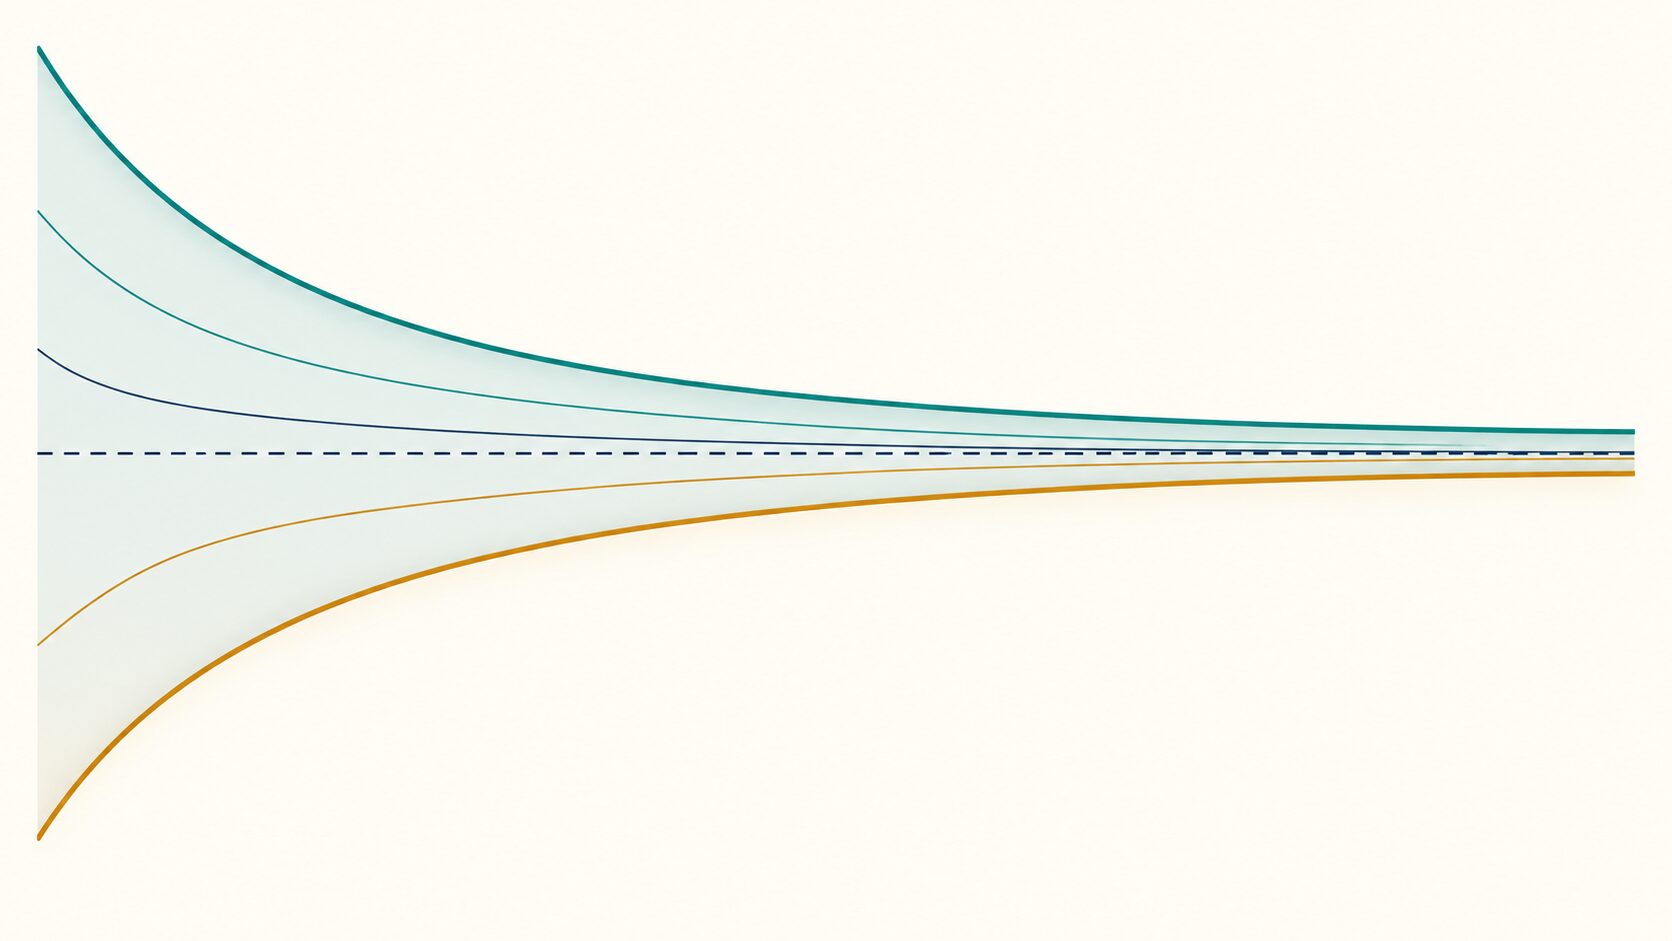
図は、左から右へ学習が進むにつれて、上下限が中央の共通値へ近づく様子を示しています。実測した損失や精度のグラフではありません。上限を下げるだけでなく下限も上げるため、すべての係数が単調に小さくなるとは限りません。
この移行は「何エポック目で別のオプティマイザに交換する」という操作とは異なります。設定した上下限の変化の仕方に従って連続的に進みます。また、通常は検証精度を見て切り替え時を判断する仕組みではなく、学習ステップに応じた規則で範囲を変えます。短い学習では、範囲が十分に狭まる前に終了することもあります。
数値例で理解する学習率のクリッピング
クリッピングの中心となる操作は、次の概念式で表せます。
\(\eta_{t,i}=\min\left(u_t,\max\left(l_t,a_{t,i}\right)\right)\)\(t\)は学習ステップ、\(i\)はパラメータの番号です。\(a_{t,i}\)はAdam型の計算で得た制限前の学習率の係数、\(l_t\)は下限、\(u_t\)は上限、\(\eta_{t,i}\)は制限後の係数を表します。式は「まず下限を下回らないようにし、次に上限を超えないようにする」と読めます。
例えば、あるステップの範囲を0.002〜0.01とし、3つのパラメータで次の係数が計算されたとします。ここでの数値は仕組みを説明するための仮の値であり、推奨設定ではありません。
| 制限前の係数 | 範囲との関係 | 制限後の係数 |
|---|---|---|
| 0.0005 | 下限0.002より小さい | 0.002へ引き上げる |
| 0.005 | 範囲内にある | 0.005のまま |
| 0.05 | 上限0.01より大きい | 0.01へ抑える |
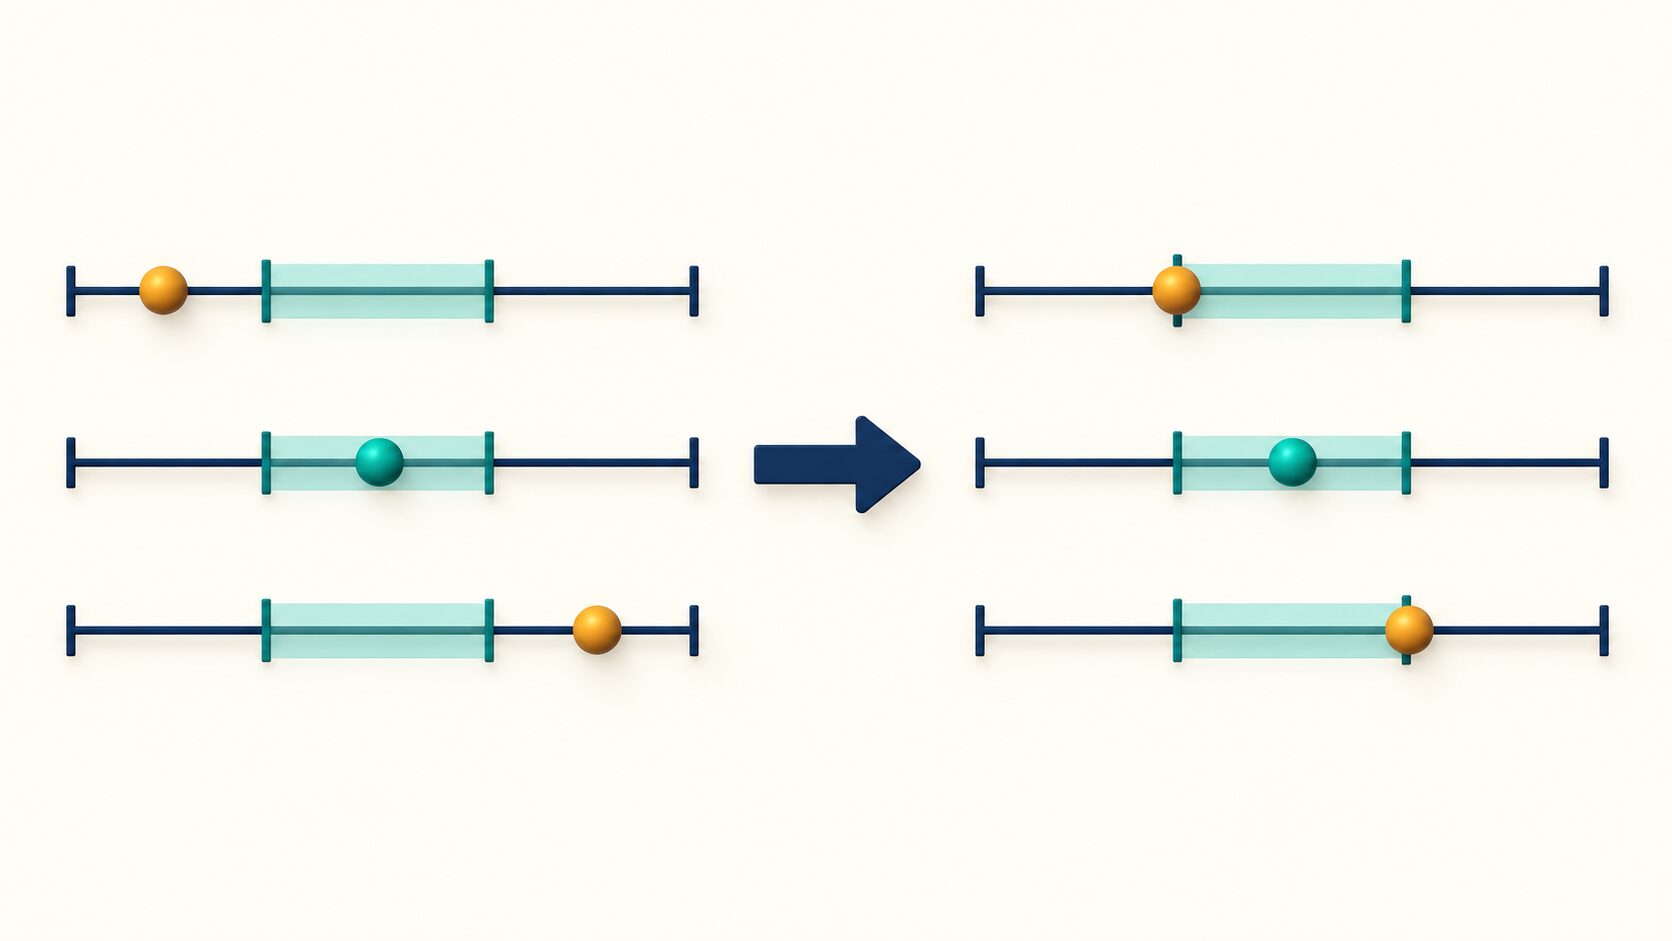
図の上段は小さすぎる値を下限へ、中段は範囲内の値をそのまま、下段は大きすぎる値を上限へ対応させています。重要なのは、すべての係数を同じ値へ置き換えるのではなく、範囲外の値だけを制限することです。上下限が十分に近づくまでは、パラメータごとの違いが残ります。
制限後の係数を使った更新は、補正済みの勾配の移動平均を\(\hat{m}_{t,i}\)とすると、概念的には次のように表せます。
\(\theta_{t+1,i}=\theta_{t,i}-\eta_{t,i}\hat{m}_{t,i}\)\(\theta_{t,i}\)は更新前のパラメータ、\(\theta_{t+1,i}\)は更新後のパラメータです。ここでは上下限制御を理解するために計算を簡略化しています。実際の実装では、初期の移動平均に対する補正をどこへ組み込むか、学習率スケジュールや重み減衰をどう扱うかも確認する必要があります。
また、AdaBoundで制限するのは学習率の係数です。勾配そのものを制限する「勾配クリッピング」とは対象が違います。係数に上限があっても、掛け合わせる勾配の移動平均が大きければ更新量は大きくなり得るため、勾配爆発への対策が自動的に不要になるわけではありません。
Adam・SGD・モーメンタム・AdaGradとの違い
AdaBoundの位置付けを知るには、各手法が勾配の履歴と学習率をどう扱うかを比べると理解しやすくなります。モーメンタムは更新に慣性を持たせる仕組みなので、ここでは実際の比較対象となる「モーメンタム付きSGD」として整理します。
| 手法 | 更新の特徴 | AdaBoundとの関係・注意点 |
|---|---|---|
| SGD | ミニバッチの勾配と共通の学習率で更新する | 単純な基準手法。学習率の設定やスケジュールにより結果が変わる |
| モーメンタム付きSGD | 過去の勾配の影響を残し、更新方向の揺れを抑える | AdaBoundの学習後半が近づく更新の形。常に遅い、常に汎化性能が高いとは限らない |
| Adam | 勾配と二乗勾配の移動平均から、パラメータごとに係数を調整する | AdaBoundの初期に近い。通常のAdamには、上下限を共通値へ近づける制御はない |
| AdaGrad | 過去の二乗勾配を累積し、パラメータごとの係数を調整する | 適応的学習率の関連手法。累積量が増えると係数が小さくなりやすく、AdaBoundとは別の仕組み |
| AdaBound | Adam型の係数を動的な上下限で制限する | 適応性を徐々に弱め、共通の係数に近づける。最終学習率や範囲の変化速度の設定が必要 |
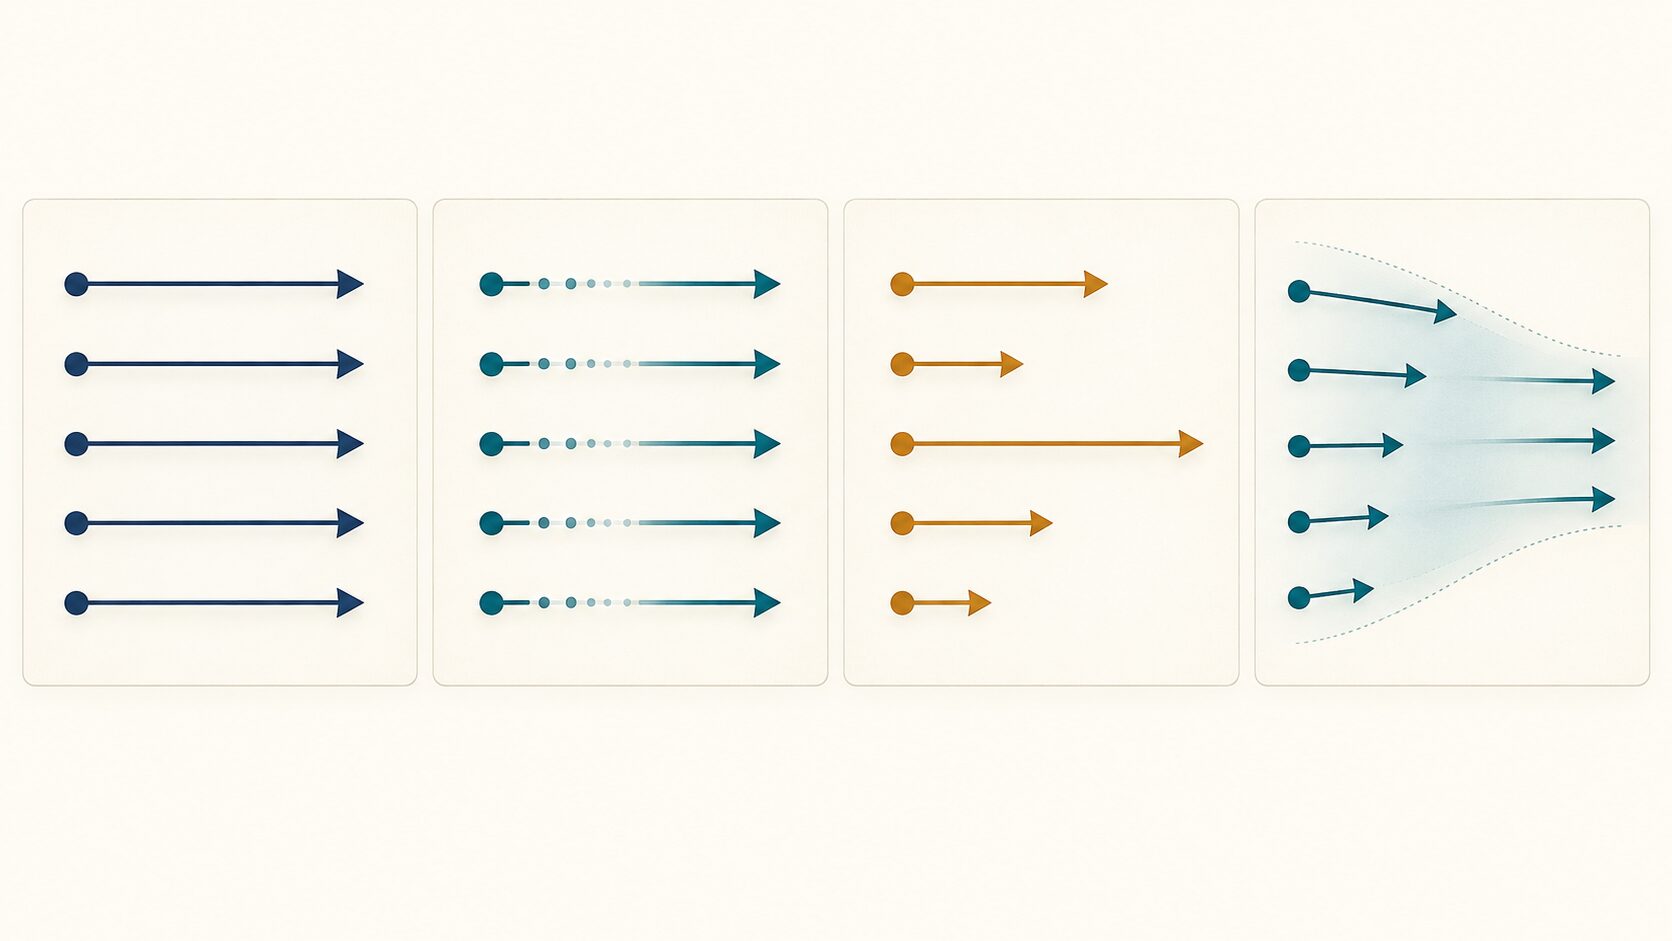
図は左から、共通の係数、過去の勾配の影響、パラメータごとに異なる係数、上下限による係数の制御を表したものです。矢印は考え方の対比であり、実際の更新量や性能順位を示していません。
AdaBoundの仕組みを「AdaGradとSGDを組み合わせたもの」と説明すると、Adam型の移動平均を使う点が伝わりにくくなります。まずAdamを土台に学習率の上下限を加えると捉え、AdaGradは適応的学習率という共通点を持つ別の手法として区別するとよいでしょう。
また、Adamにもモーメンタムに相当する要素があるため、「Adam対モーメンタム」という二者択一ではありません。比較するなら、Adam、モーメンタム付きSGD、AdaBoundのように更新手順が定まった手法を並べます。
AdaBoundの利点と汎化性能の考え方
AdaBoundの利点は、学習の段階に応じて、パラメータごとの適応的な調整を生かす範囲を変えられることです。初期は広い範囲を許し、後半は極端な係数を抑えるという考え方を、一つの更新手順にまとめています。
例えば、あるパラメータだけ係数が非常に小さくなった場合、下限によって係数の縮小を抑えられます。反対に、係数が大きくなりすぎた場合には上限が働きます。ただし、下限があるだけで必ず学習が進むわけではありません。勾配がほぼゼロなら、係数を引き上げても更新量は小さいままです。
もう一つの利点は、AdamからSGDへ手動で切り替えるタイミングを別途決めずに済むことです。一方で、その代わりに最終学習率と上下限の変化の速さを検討します。切り替えの操作を組み込めることと、設定調整が不要なことは別です。
「学習が速い」という評価にも注意が必要です。少ない更新回数で訓練損失が下がることと、同じ予測精度へ短い実時間で到達することは一致しません。1ステップの計算時間、バッチサイズ、使用する計算機によっても変わります。実務では、損失の推移と経過時間を併せて記録すると、改善の意味を判断しやすくなります。
汎化性能についても同様です。訓練損失が下がり続ける一方で検証損失が悪化するなら、過学習の可能性があります。AdaBoundを選んだだけでこの問題が解消するとは限らず、データ拡張、重み減衰、モデルの規模、早期終了なども検討します。学習率の制限は更新方法の工夫であり、データの偏りや学習データへの過剰な適応をすべて解決するものではありません。
活用例:画像分類・自然言語処理・音声認識
AdaBoundは、勾配を用いて学習するニューラルネットワークで、比較候補となるオプティマイザです。画像分類、文章分類、音声認識などに適用を検討できますが、以下は使いどころを理解するための例であり、特定のモデルで性能向上を保証する実績一覧ではありません。
| 分野 | 検討できる課題の例 | 比較時に確認すること |
|---|---|---|
| 画像認識 | 写真の種類を分類するモデルの学習 | 検証データの正解率、訓練損失、学習時間、データ拡張の条件 |
| 自然言語処理 | 文章分類、翻訳、質問応答モデルの学習や追加学習 | 課題に合った評価指標、学習率への感度、事前学習済みモデルへの影響 |
| 音声認識 | 音声を文字列へ変換するモデルの学習 | 認識誤り率、話者や録音環境による差、学習の安定性 |
例えば画像分類なら、まずAdamやモーメンタム付きSGDで基準となる結果を作り、同じモデルとデータ分割でAdaBoundを試します。ResNetやEfficientNetはモデルの構造の名前であり、AdaBoundはそれらの重みの更新方法に当たります。「深いモデルだからAdaBoundが有利」とは決めず、検証結果から選びます。
自然言語処理でも、TransformerやBERTというモデルと、オプティマイザは区別して考えます。事前学習済みモデルの追加学習では、大きな更新によって、すでに獲得している表現が損なわれることもあります。下限や最終学習率を高くしすぎず、既存の学習条件と比較することが大切です。短い追加学習では、AdaBoundがSGDに近い状態へ移る前に学習が終わる可能性もあります。
音声認識では、訓練に含まれる話者や録音環境に偏りがないかも確認します。学習時の損失が改善していても、別の話者の音声で認識誤りが増えるなら、採用の根拠にはなりません。どの分野でも、訓練中の見た目の滑らかさだけでなく、用途に合ったデータと指標で評価する必要があります。
設定と注意点:検証データで効果を確かめる
AdaBoundを使うときは、基準となる学習率だけでなく、上下限が近づく先と、その変化の速さを確認します。自動なのは、設定された規則に従う係数の計算です。データに最適な設定や、最良の終了時点まで自動で決まるわけではありません。
| 設定・確認項目 | 役割 | 確認する理由 |
|---|---|---|
| 基準学習率 | Adam型の適応的な係数を計算する基準 | 大きすぎると不安定になり、小さすぎると学習が進みにくい |
| 最終学習率 | 上下限が近づく共通の値 | 学習後半の挙動を左右する。基準学習率と同じとは限らない |
| 上下限の変化速度 | 範囲をどの程度の速さで狭めるかを調整 | 速すぎると適応性を早く失い、遅すぎると学習中に十分移行しない |
| 移動平均の係数 | 過去の勾配や二乗勾配の影響を調整 | 更新の滑らかさと、新しい勾配への反応が変わる |
| 重み減衰などの正則化 | モデルの複雑さや過学習を抑える工夫 | AdaBoundの上下限制御だけでは代替できない |
| 学習率スケジューラ | 学習の途中で基準学習率などを変化させる | 上下限への反映方法を含め、実装との組み合わせを確認する |
実装によって、設定名、初期値、最終学習率の換算方法、スケジューラとの連動方法は異なります。別の実装でよかった数値を、そのまま同じ意味だと考えて移すのは避けましょう。特に最終学習率は、設定欄の数値がどの係数にどう反映されるかを確認することが大切です。
計算資源も比較対象です。AdaBoundはAdamと同様に、勾配と二乗勾配の移動平均を保持するため、単純なSGDよりもオプティマイザの状態を保存するメモリが必要になります。大きなモデルでは、学習が安定するかだけでなく、メモリ使用量や1ステップの時間も記録すると判断しやすくなります。
比較実験は、次の順序で進めると結果を読み違えにくくなります。
- 訓練用、検証用、最終評価用のテストデータを分け、各手法で同じ分割を使います。時系列や同一人物のデータでは、情報が別の分割へ漏れないようにします。
- 同じモデル、前処理、バッチサイズなどでAdamとモーメンタム付きSGDの基準結果を作ります。手法ごとに適切な学習率を検討します。
- AdaBoundの基準学習率、最終学習率、上下限の変化速度を、検証データで比較します。すべての手法に同じ学習率の数値を与えるだけでは、公平な比較とは限りません。
- 訓練損失、検証損失、課題の評価指標、経過時間を記録します。更新回数をそろえるのか、計算時間をそろえるのかも決めておきます。
- 乱数シードを変えた試行も行い、改善が偶然ではないかを確認します。設定を選び終えてから、未使用のテストデータで最終評価します。
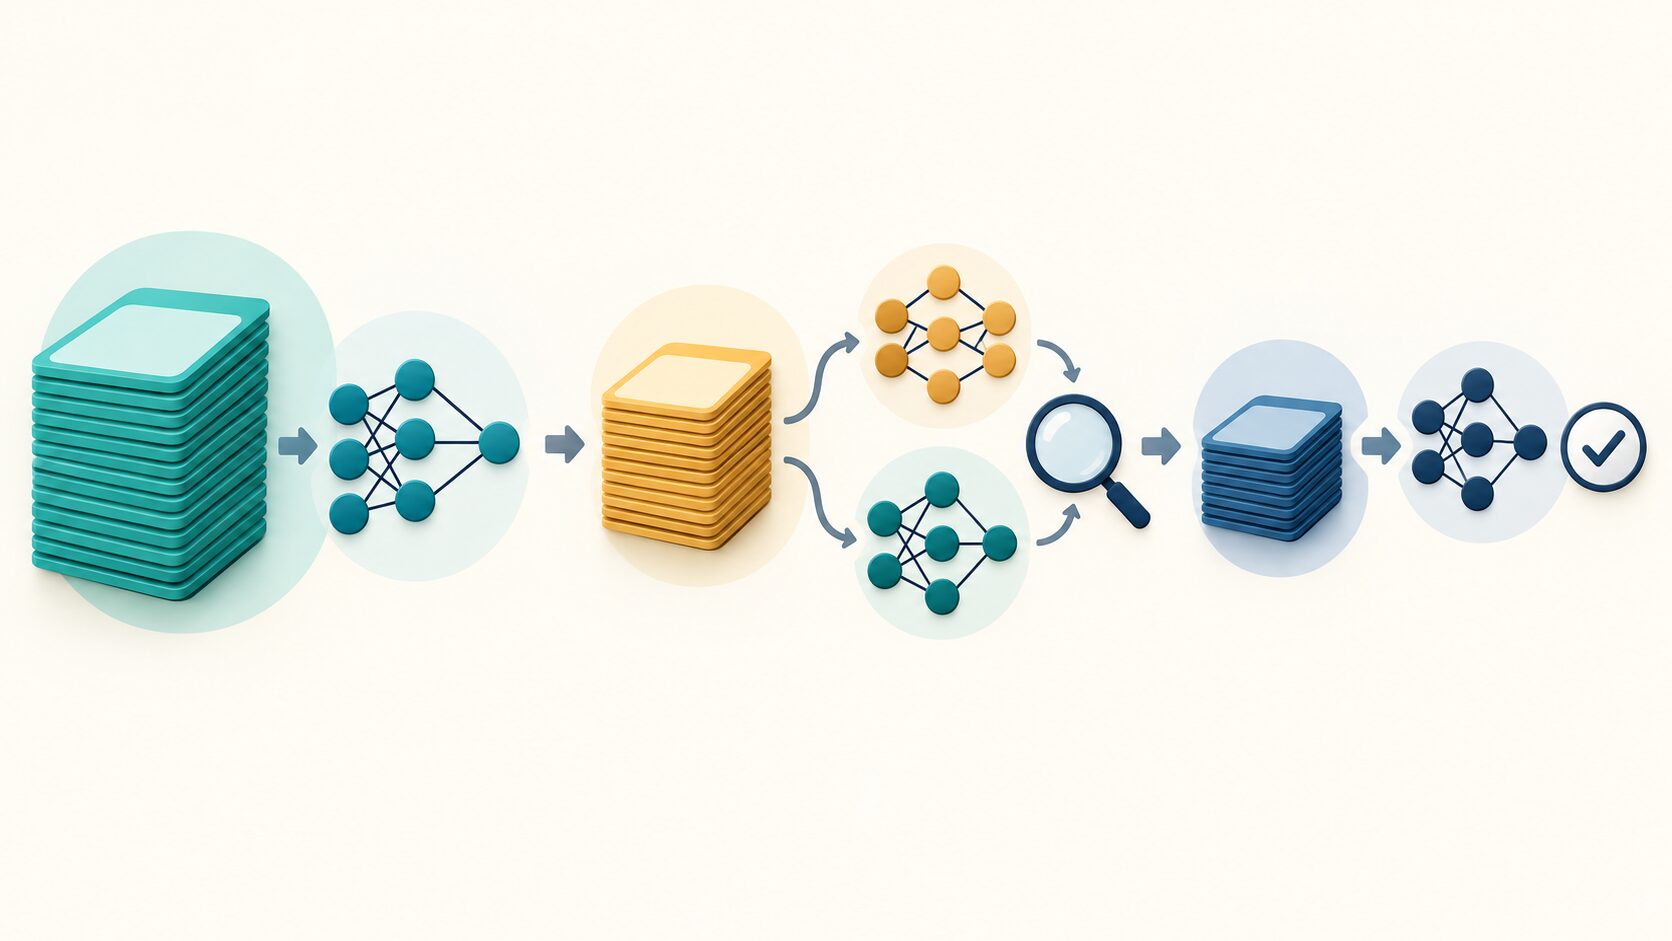
図は訓練、検証、最終評価という作業の順序を示しています。訓練データを順に検証用・テスト用へ使い回す意味ではありません。設定を選ぶための検証と、最後に性能を確かめるテストを分けることで、評価データに合わせすぎるのを防ぎます。
例えば、AdaBoundでは訓練損失が早く下がるものの、同じ時間を使ったSGDの方が検証精度で上回るなら、目的に照らしてSGDを選ぶ判断もあります。逆に、限られた時間で目標精度に到達し、複数の試行で安定しているなら、AdaBoundを採用する理由になります。手法名ではなく、必要な精度と計算資源に対する結果で判断しましょう。
よくある疑問:自動調整で何が省けるのか
- AdaBoundなら、AdamからSGDへの切り替え時点を決めなくてよいのですか?
-
上下限の変化により更新が徐々に近づくので、手動で交換する時点は不要です。ただし、上下限の変化速度や最終学習率は結果に影響します。移行の仕方を設定しなくてよい、という意味ではありません。
- 学習後半は、必ず学習率が小さくなるのですか?
-
上限は下がりますが、下限は上がります。もともと小さすぎた係数は引き上げられることがあります。また、実際の更新量は勾配の移動平均にも依存するため、後半ほど必ず小さな更新になるとは限りません。
- 学習率スケジューラや勾配クリッピングは不要になりますか?
-
どちらもAdaBoundとは役割が異なります。スケジューラは学習率を時間とともに変え、勾配クリッピングは勾配の値や大きさを制限します。必要性を個別に判断し、組み合わせた際の学習率の動きも確認します。
- Adamを使っているモデルは、AdaBoundへ変更すべきですか?
-
一律に変更する必要はありません。現状の性能、学習時間、安定性に課題があり、比較する価値があるときの候補です。オプティマイザだけを交換して同じ数値設定を引き継ぐと、十分な比較にならないことがあります。
まとめ:学習率をどう制限するかでAdaBoundを理解する
AdaBoundは、Adam型の適応的な学習率に動的な上下限を設ける最適化アルゴリズムです。初期は幅広い調整を許し、学習が進むと上下限を同じ値へ近づけて、モーメンタム付きSGDに近い更新へ移行します。
理解のポイントは、大きすぎる係数を抑えるだけでなく、小さすぎる係数を引き上げることです。学習率のクリッピングは、勾配クリッピングや過学習対策そのものとは異なります。
採用するときは、最終学習率と移行の速さを確認し、Adamやモーメンタム付きSGDと同じ条件で比較しましょう。訓練損失の下がり方だけでなく、検証データの性能、学習時間、結果のばらつきまで確かめることが、目的に合った使い方につながります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年9月27日 | 学習率の上下限制御を数値例で示し、他手法との違いと評価手順を追記 |