
全畳み込みネットワーク(FCN)とは?仕組み・活用例と注意点を解説

AIの初心者
「全畳み込みネットワーク」とは、どのようなモデルですか?一般的な画像認識のネットワークとは何が違うのでしょうか?

AI専門家
FCNは、画像を一つのラベルにまとめるのではなく、画像の場所ごとに「何が写っているか」を予測するモデルだよ。道路や空、車などを画素単位で分けるセマンティックセグメンテーションによく使われるんだ。
AIの初心者
画像全体の分類とは、出力の仕方が違うのですね。細かな位置までどうやって判定するのでしょう?
AI専門家
畳み込み層を中心にした構造で、特徴の位置関係を保ちながらクラスごとのスコアマップを作るんだ。いったん粗くなったマップを拡大し、浅い層の細かな特徴も組み合わせて、入力画像上の位置に対応する予測にしていくよ。
全畳み込みネットワーク(Fully Convolutional Network、FCN)は、画像の空間的な配置を保ったまま、場所ごとにクラスを予測するニューラルネットワークです。たとえば街路画像を入力すると、道路、空、車、歩行者といったクラスを画素ごとに割り当て、領域ごとに色分けした結果を得られます。
画像全体に「道路の写真」「猫が写った写真」のようなラベルを付ける画像分類とは異なり、FCNが答えるのは「画像のどこが道路で、どこに車があるか」です。このような画素単位の分類をセマンティックセグメンテーションと呼びます。FCNはそのための代表的な構成の一つであり、画像分類や物体検出とは出力の粒度が異なります。
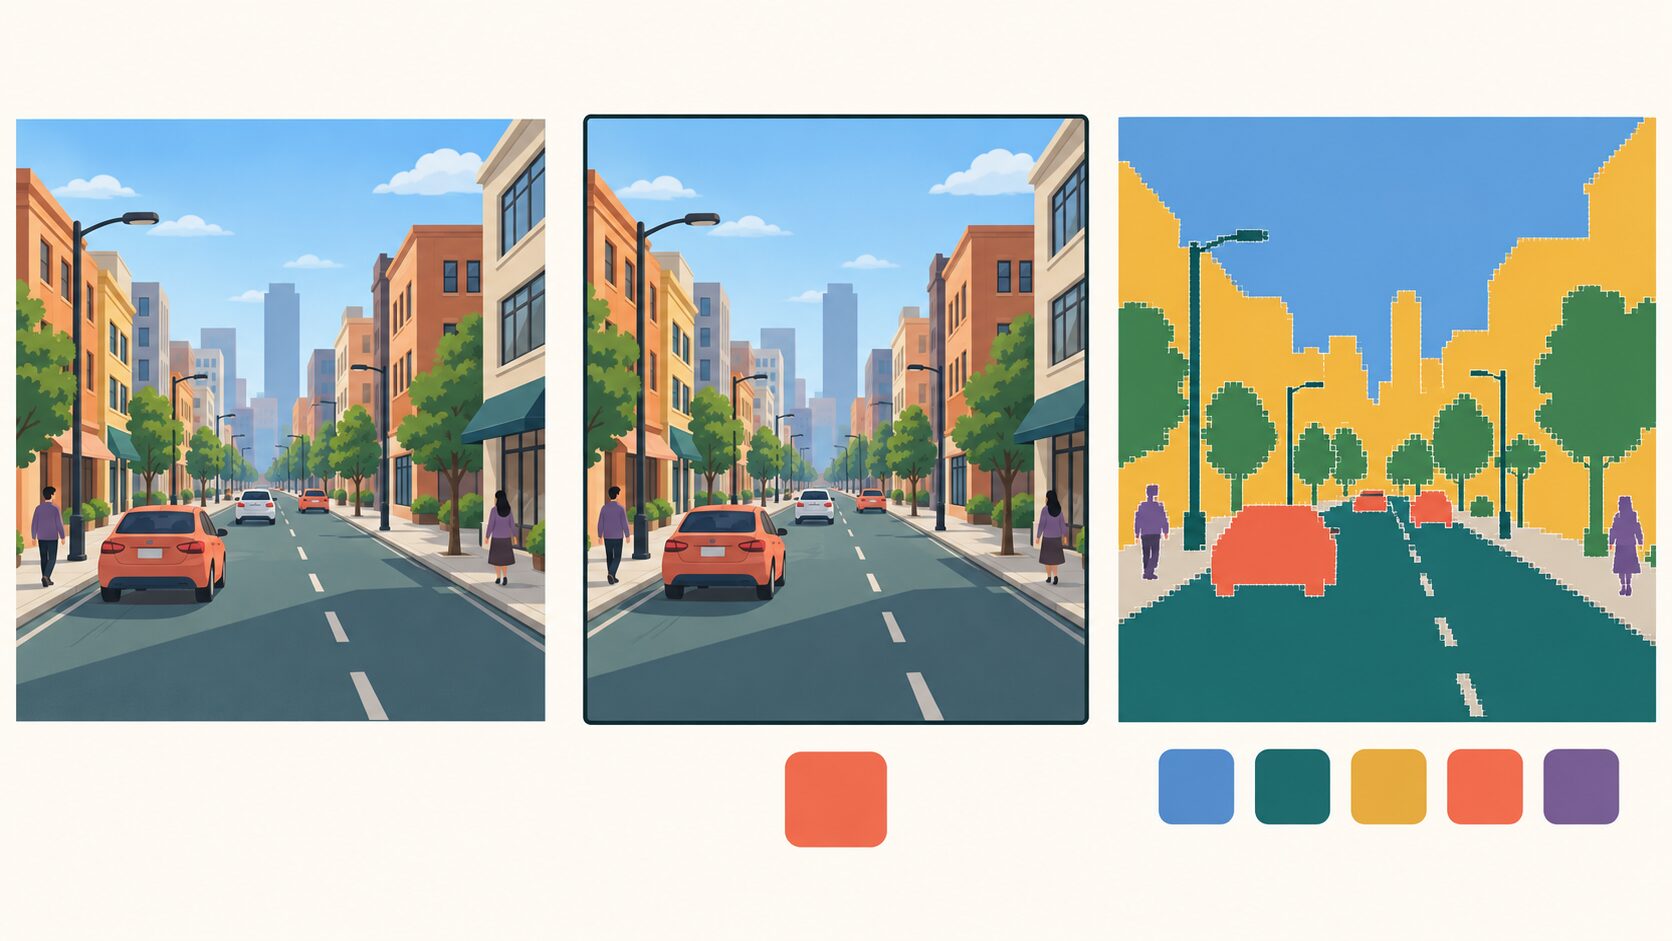
FCNとは:画像全体の分類から画素ごとの分類へ
FCNは、畳み込み層を中心に構成し、特徴マップ上の各位置についてクラスごとのスコアを出力するモデルです。Fully Convolutional Networkを日本語で「全畳み込みネットワーク」と呼びます。名前のとおり、画像全体を固定長のベクトルへまとめる全結合層を使わず、畳み込み演算によって位置ごとの予測を行う点が特徴です。
街路画像を例にすると、画像分類モデルは「道路の写真」など画像全体のラベルを返します。一方、FCNでは、ある画素は道路、別の画素は空、また別の画素は車というように、画像上の場所ごとにクラスを推定します。したがって、単に何が写っているかだけでなく、物体や領域がどこにあるかを含む分割結果を得られます。
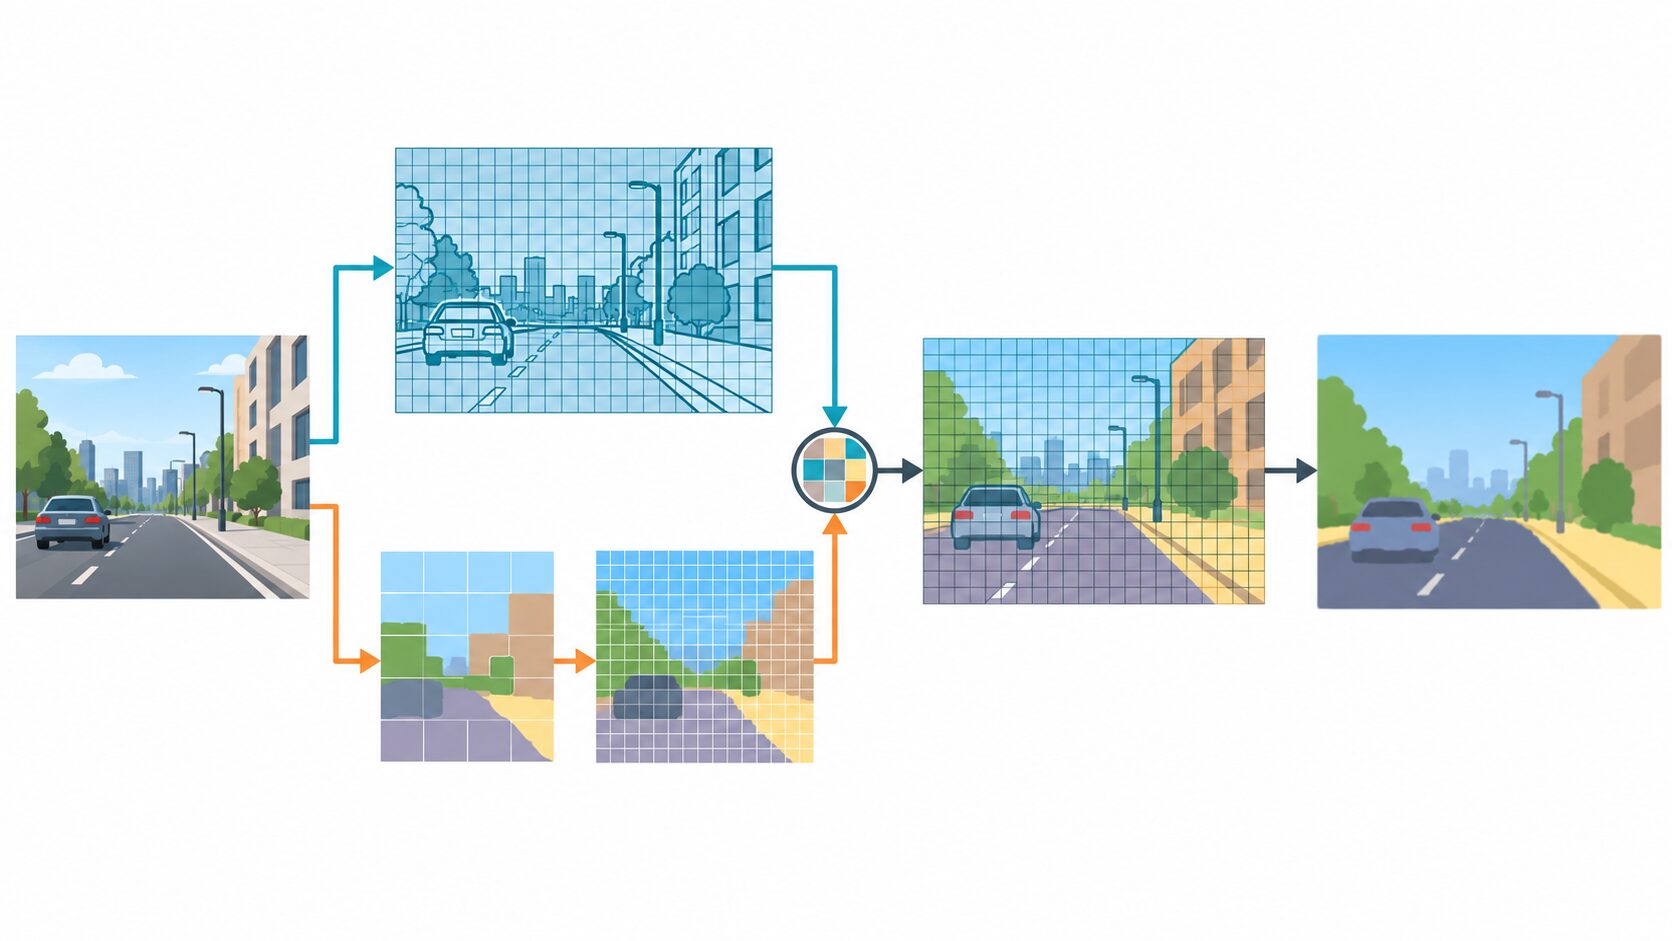
ただし、出力の各位置が必ず入力画像の各画素と一対一で対応するとは限りません。畳み込みやプーリングで特徴マップを縮小するため、いったん粗い解像度で予測し、後段で入力に近いサイズへ戻す構成が一般的です。境界の細かさや位置の精度は、ネットワークの設計や特徴の組み合わせ方にも左右されます。
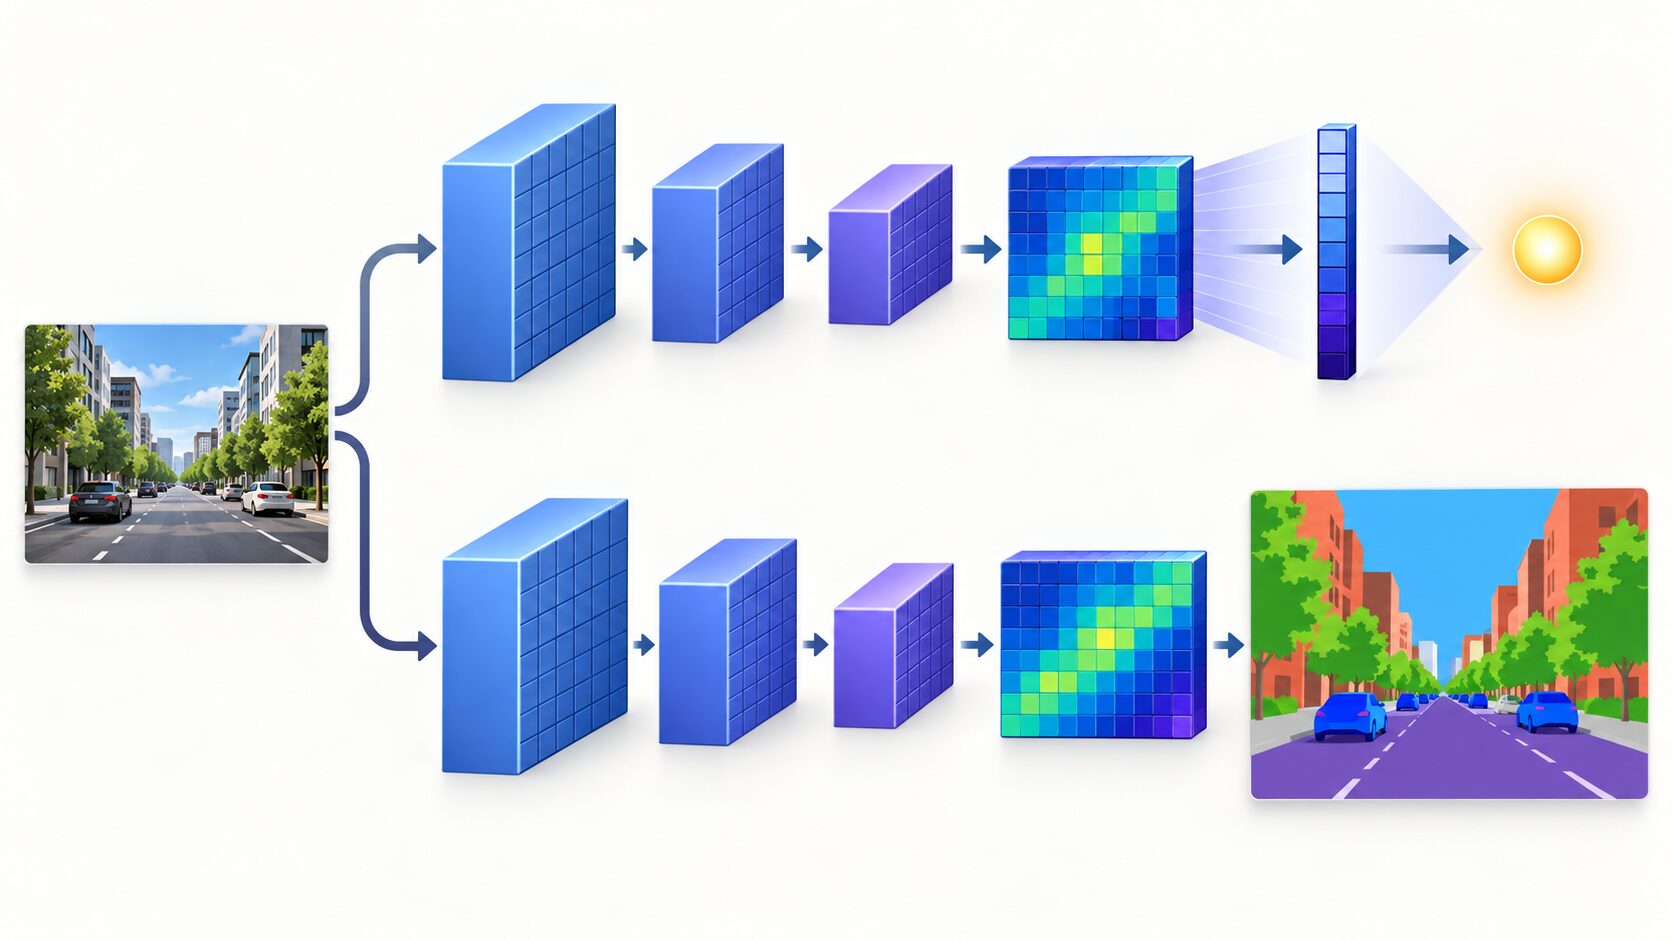
全結合層を畳み込み層に置き換える仕組み
一般的な画像分類用CNNは、畳み込み層で輪郭や模様などの特徴を抽出したあと、全結合層などを使って情報を固定長にまとめ、画像全体のクラスを予測します。「この画像は猫か犬か」のように一つの答えを出すには適した構造です。その処理では特徴の空間配置がまとめられるため、画像の各場所にラベルを付ける用途には、そのままでは向きません。
FCNでは、分類CNNの全結合層を畳み込み層に置き換え、特徴マップ上の位置を保ったままクラスごとのスコアを計算します。出力されるのは単一のラベルではなく、クラス別のスコアマップです。各位置でスコアが最も高いクラスを選ぶことで、道路や建物などの領域を画像上に割り当てられます。
この構造は、入力画像を必ず同じ縦横サイズの固定長ベクトルに変換する必要がないため、異なる大きさの画像を扱いやすくします。ただし「どんなサイズでも無条件に処理できる」という意味ではありません。層のストライドやパディング、特徴マップと出力の位置合わせ、使用可能なメモリーによって制約を受けます。実運用では、学習時と推論時の画像サイズや前処理をそろえ、出力が入力上のどの範囲に対応するかを確認します。
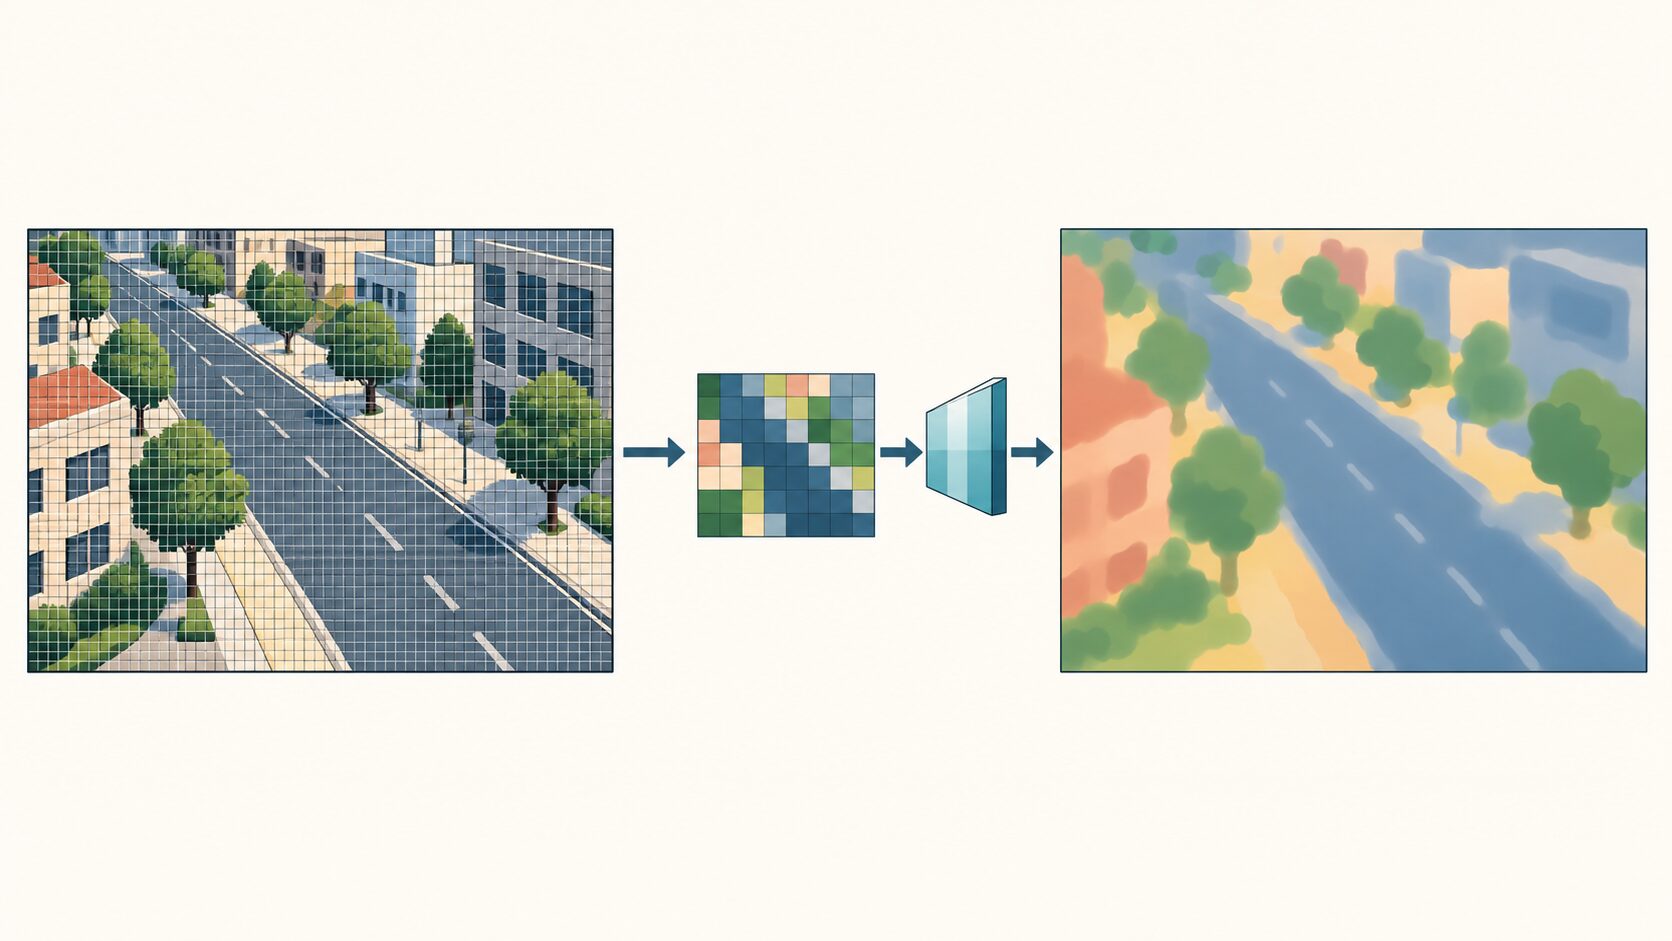
縮小した特徴マップを出力サイズへ戻す
畳み込みのストライドやプーリングによって特徴マップを小さくすると、計算量を抑えながら広い範囲の情報を取り込みやすくなります。一方で、縮小を重ねるほど、物体の境界や細い形状の位置は粗くなります。FCNでは、画像全体の文脈を捉えた特徴を活かしつつ、出力を元画像に対応する解像度へ戻す必要があります。
この拡大処理をアップサンプリングと呼びます。FCNでは転置畳み込みを使う構成が知られています。転置畳み込みは、学習可能なフィルターを使って特徴マップを拡大する方法です。名前や処理の見た目から通常の畳み込みを逆向きに戻す演算と誤解されることがありますが、失われた情報を完全に復元する逆演算ではありません。補間など、別のアップサンプリング方法を選ぶ構成もあります。
拡大したクラススコアを入力サイズに合わせることで、画素ごとの分割結果を作れます。ただし、サイズを大きくしただけで失われた細部がすべて戻るわけではありません。出力の境界を改善するには、後述するスキップ結合などを使って、縮小前の層が持つ位置情報を活用する方法があります。
スキップ結合で位置の細部を補う
ネットワークの浅い層は、輪郭や模様など細かな位置情報を比較的よく保ちます。層を重ねた深い部分は、細部の位置が粗くなる一方で、物体や場面が何を表すかという意味情報を捉えやすくなります。セグメンテーションでは両方が必要です。細部だけでは領域の意味を判断しにくく、意味情報だけでは境界を正確に置きにくいためです。
そこで、深い層の特徴マップを拡大し、浅い層の特徴マップと解像度を合わせて足し合わせたり、連結したりします。このような特徴の融合をスキップ結合と呼びます。深い層の文脈を使ってクラスを判断しながら、浅い層の情報で輪郭や小さな位置のずれを補う狙いがあります。
FCN-32s、FCN-16s、FCN-8sは、出力の細かさを段階的に高める代表的な構成です。数字は最終的な予測マップの縮小率を表し、より細かい特徴を使う構成ほど、位置合わせを改善することを目指します。ただし、スキップ結合を加えれば細部が完全に復元されるわけではありません。入力解像度や学習データ、モデルの設計によって結果は変わります。
セマンティックセグメンテーションと他の画像認識の違い
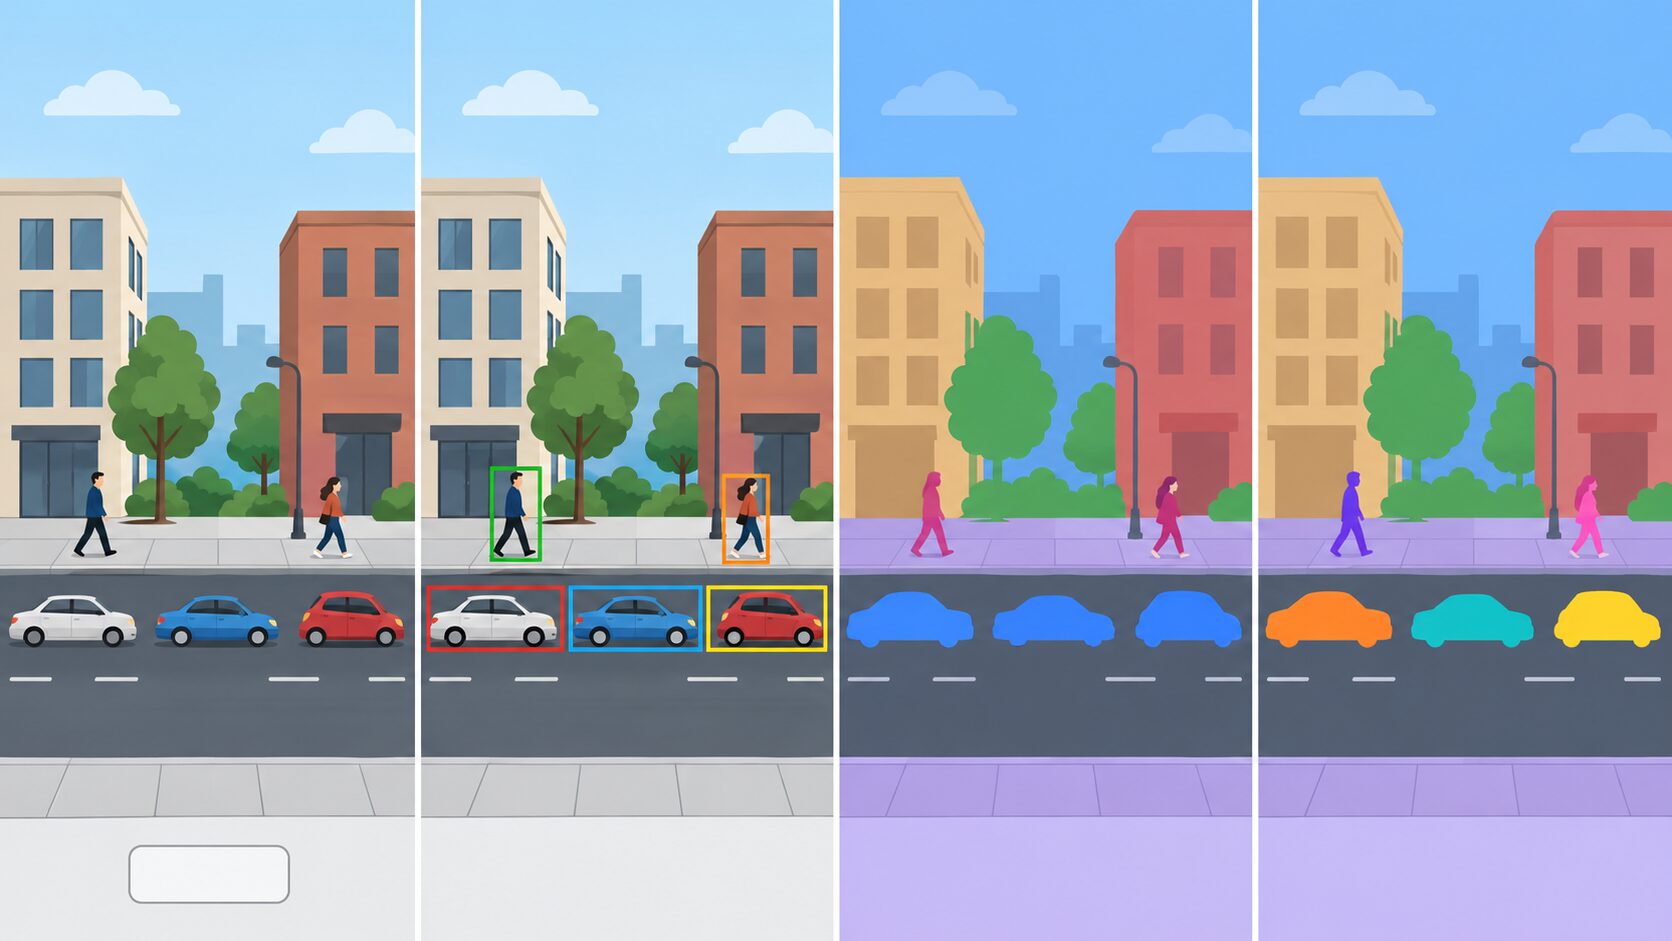
画像認識の手法は、何を出力するかによって役割が異なります。画像分類は画像全体にラベルを付け、物体検出は物体ごとの位置を矩形の枠とクラスで示します。セマンティックセグメンテーションは、画像の各画素にクラスを割り当て、物体の形に沿った領域を出力します。
| 手法 | 主な出力 | 分かること |
|---|---|---|
| 画像分類 | 画像全体のクラス | 画像に何が写っているか |
| 物体検出 | 物体ごとの枠とクラス | 物体がどこにあるか、おおよそどの範囲か |
| セマンティックセグメンテーション | 画素ごとのクラス | 各クラスの領域が画像のどこにあるか |
| インスタンスセグメンテーション | 個体ごとに分けた画素領域とクラス | 同じクラスに属する物体を個別に区別した領域 |
セマンティックセグメンテーションでは、同じクラスの複数の物体を別個体として区別しません。たとえば、画像内に車が2台あっても、どちらも「車」という同じクラスとして塗られます。個々の車を別々に識別したい場合は、インスタンスセグメンテーションが必要です。
FCNは画素ごとのクラス予測を行う代表的な構成ですが、セグメンテーションを実現する唯一のモデルではありません。必要な精度、処理速度、対象画像の性質に応じて、別のネットワーク構成と比較して選びます。
FCNの活用例と導入時の注意点
FCNのような画素単位の予測は、領域の位置や形を知る必要がある場面で役立ちます。自動運転では、道路や歩道、歩行者などの領域把握に利用できます。医療画像では、CTやMRIから臓器や病変の候補領域を抽出し、医師の確認や診断を支援する用途があります。結果は診断を自動で確定するものではなく、データや運用条件を踏まえた専門家の判断が必要です。
衛星画像では土地被覆や森林の分布、都市化の状況を領域ごとに調べる用途があり、工業分野では製品画像から欠陥の候補領域を特定するのに使われます。いずれも、画像全体のラベルだけでなく、対象がどこにあり、どのような形をしているかが重要な課題です。
一方で、小さな物体や細い境界、背景が複雑な画像では誤分類が起きやすくなります。画像を縮小する段階で情報が失われたり、特定のクラスの学習例が少なかったりすることが原因になります。学習データの偏りや撮影環境の違いがあると、実際の利用環境で精度が落ちる可能性もあるため、対象に近いデータで性能を確かめることが大切です。
評価では、全画素のうち正解した割合だけでなく、クラスごとのIoU(Intersection over Union)なども確認します。画素数の多い背景クラスだけが高精度でも、小さな対象クラスを見落としている場合があるためです。また、必要な境界精度、推論速度、メモリーや計算資源を合わせて評価し、実際の用途に合うモデルを選びます。FCNは画素単位の位置情報を得る有力な選択肢ですが、用途と制約に応じた検証が欠かせません。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月17日 | FCNの出力解像度や他方式との違いを補い、導入時の評価ポイントを加筆 |