
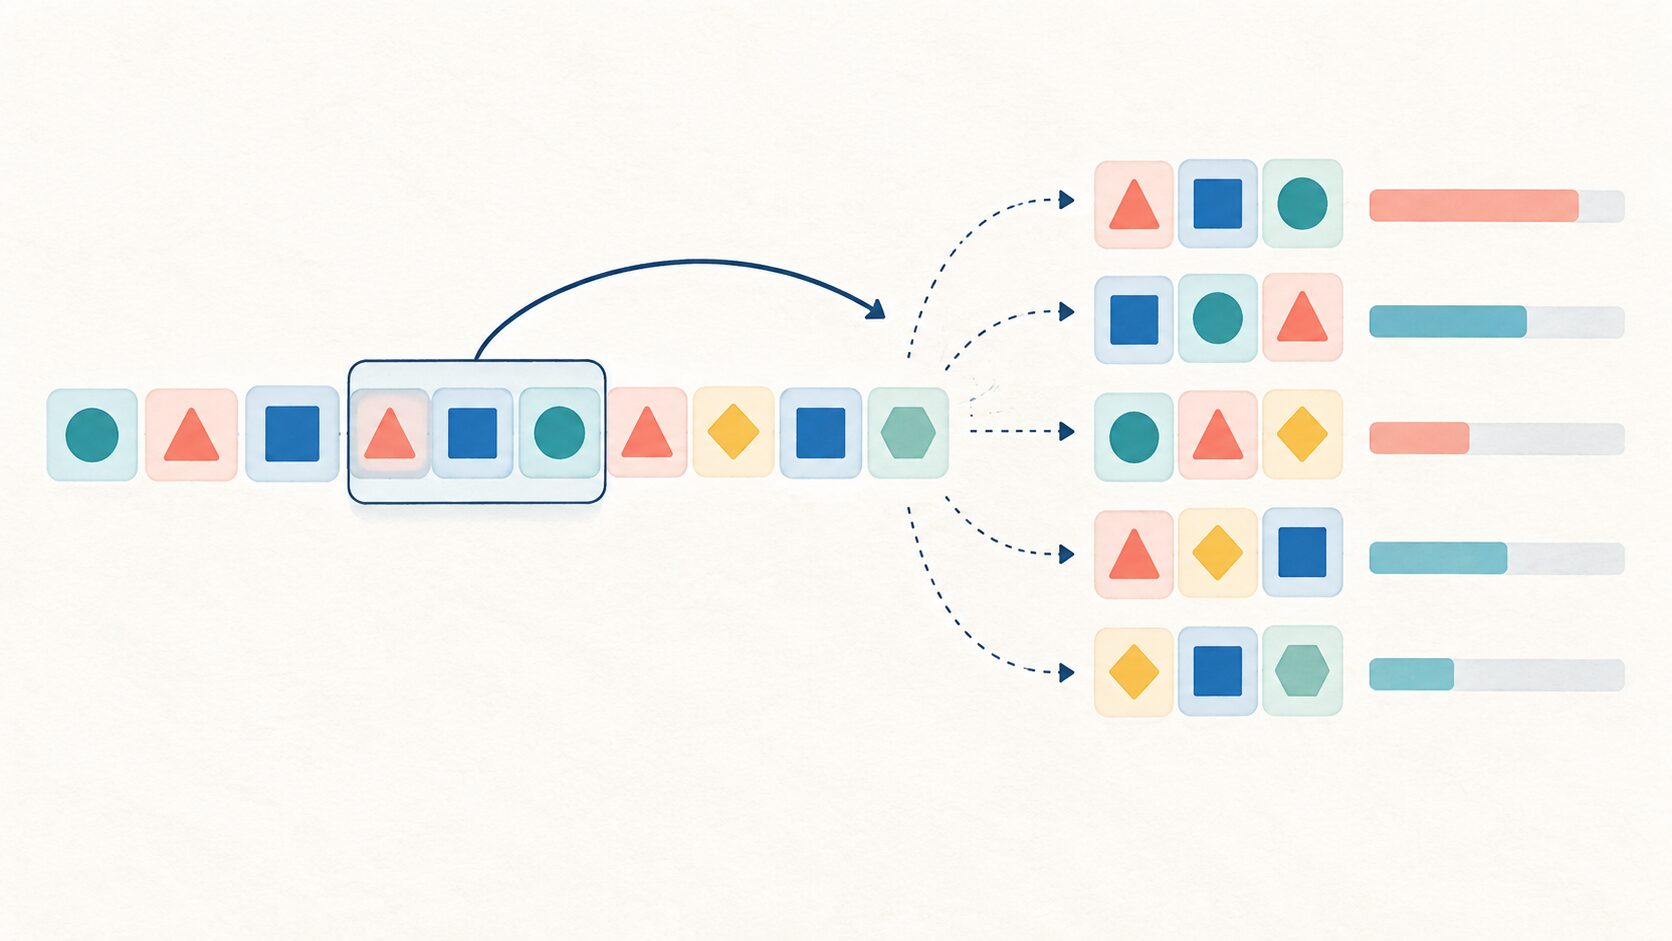
N-gram(エヌグラム)とは、文章の中で連続する文字や単語を、決めた個数ずつ取り出す考え方です。たとえば「こんにちは」の文字を2個ずつ見ると、「こん」「んに」「にち」「ちは」という組になります。隣の組と一部が重なるのがポイントです。
自然言語処理では、この組の出現回数や並び方を、検索、文章分類、入力予測などに利用します。この記事では、N-gramの定義から、文字と単語の違い、具体的な作り方、Nの選び方、スムージングまでを順に説明します。

AIの初心者
N-gramって、単語をいくつか並べたかたまりのことですか?

AI専門家
そうだね。正確には、文章の中で連続する文字や単語をN個ずつ取り出した組のことだよ。文字を3個ずつ取り出すなら、文字の3-gramになるんだ。
AIの初心者
「こんにちは」を文字の3-gramにすると、どんな組になりますか?
AI専門家
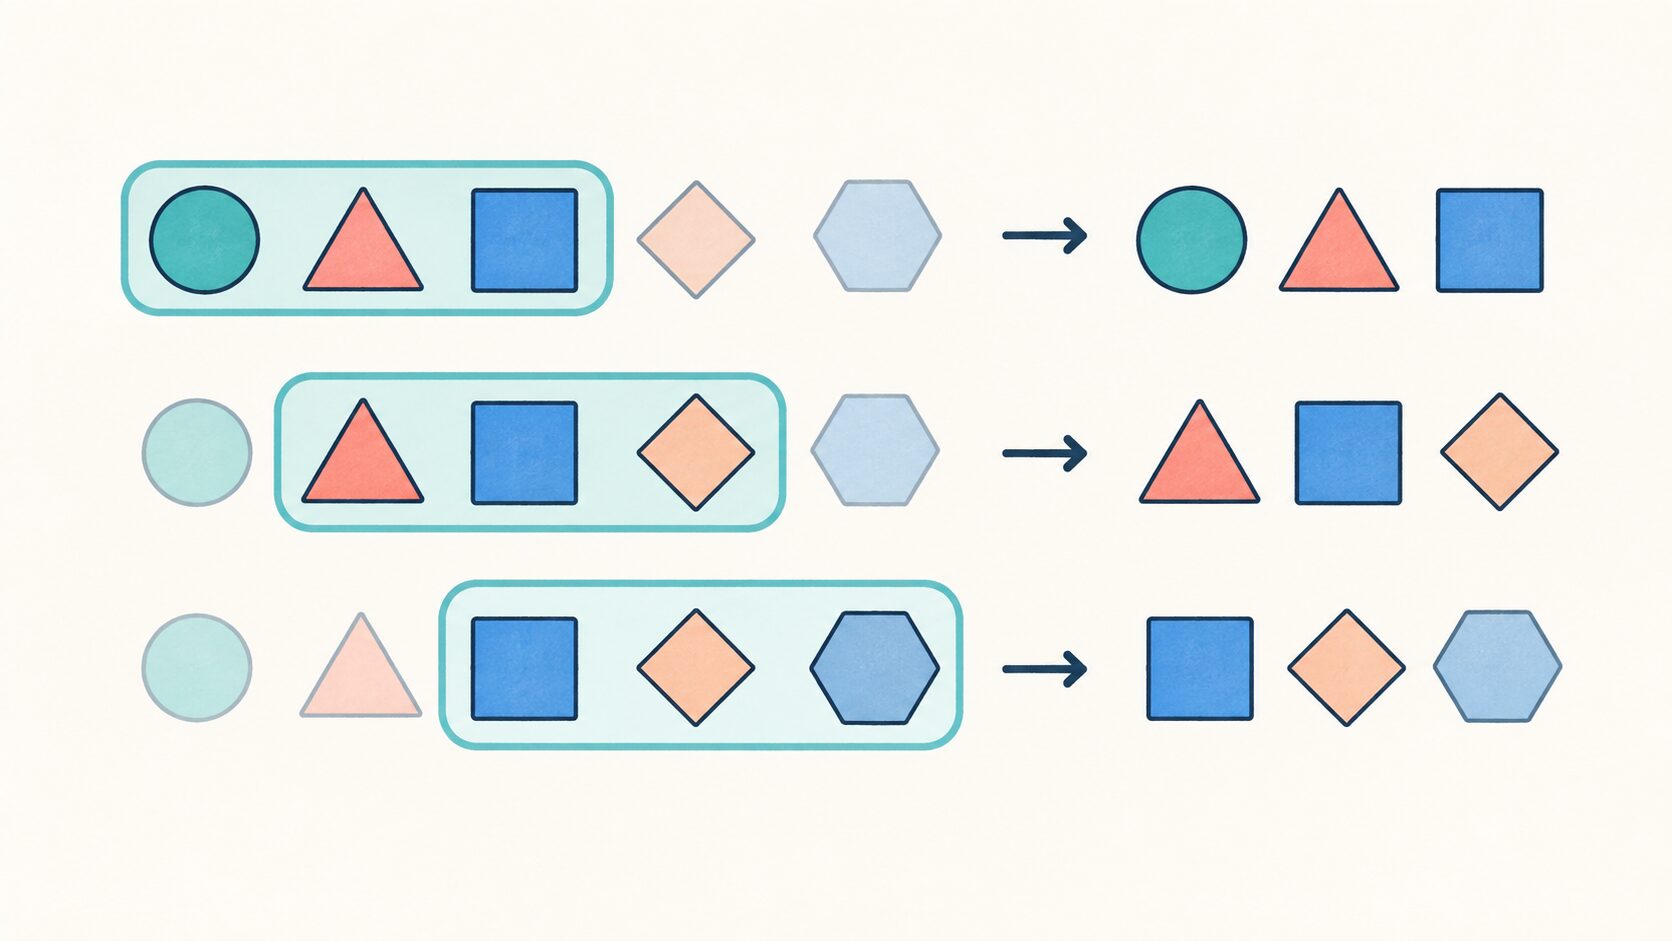
「こんに」「んにち」「にちは」の3組だよ。開始位置を1文字ずつずらすので、隣の組と文字が重なるんだ。「こん」「んに」「にち」「ちは」なら、2文字ずつの2-gramだね。
N-gramとは?連続する文字や単語を捉える方法
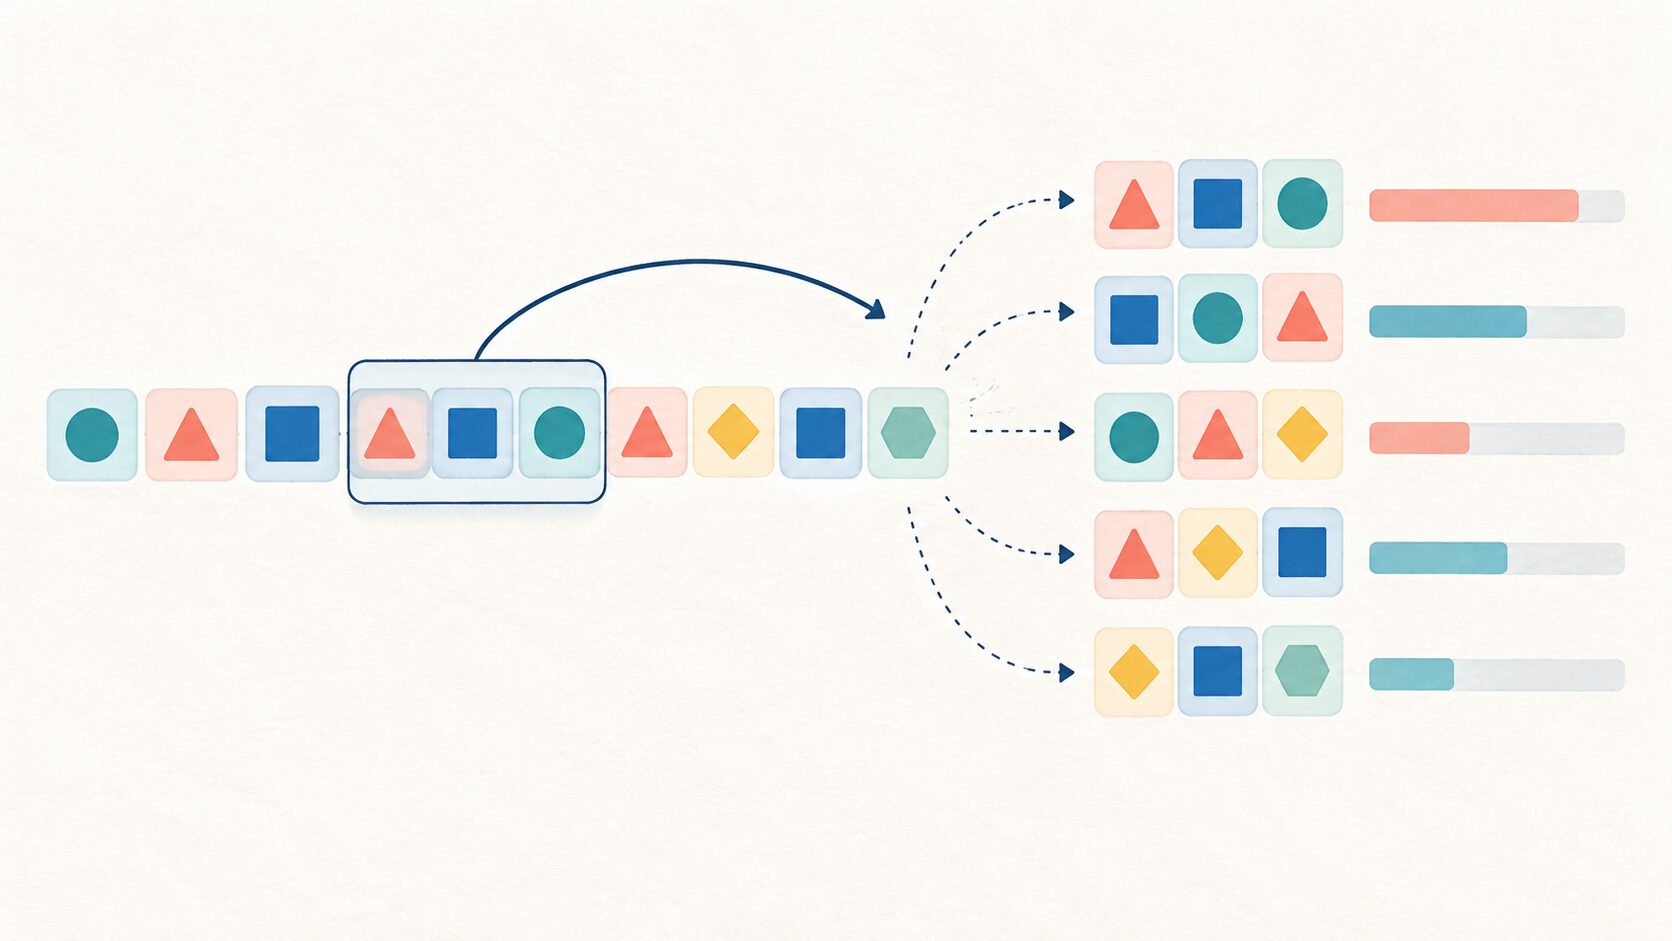
N-gramは、連続するN個の単位を、順序を保ったまま取り出した組です。「Nグラム」「ngram」と表記されることもあります。Nは組に含める個数を表し、単位には文字や単語などを使います。N-gramという言葉は、取り出した組そのものと、それを使って文章を分析する方法の両方を指します。
大切なのは、「連続する」という条件です。「今日は良い天気です」を「今日/は/良い/天気/です」と分けた場合、単語の2-gramは「今日 は」「は 良い」「良い 天気」「天気 です」です。「今日 天気」のように途中を飛ばした組は、通常のN-gramには含めません。
また、「白い 車」と「車 白い」は順序が違うため別の組です。単語を一つずつ数える場合よりも、どんな言葉が隣り合っているかを特徴として残せます。ただし、並びの特徴を捉えることと、文章の意味を理解することは同じではありません。N-gramは言葉を計算できる形へ整理する材料であり、それだけで文章全体の意図や背景まで判断できるわけではありません。
ユニグラム・バイグラム・トライグラムの違い
Nが1ならユニグラム(unigram)、2ならバイグラム(bigram)、3ならトライグラム(trigram)と呼びます。4なら4-gram、5なら5-gramです。トライグラムは「3個の組」を指し、3個以上の総称ではありません。
「こんにちは」を文字単位で取り出すと、次のようになります。ここでは文の始まりや終わりを示す特別な記号を加えず、表示されている5文字だけを対象にします。
| 名称 | 1組に含める文字数 | 取り出される組 | 組の数 |
|---|---|---|---|
| ユニグラム(1-gram) | 1文字 | こ/ん/に/ち/は | 5個 |
| バイグラム(2-gram) | 2文字 | こん/んに/にち/ちは | 4個 |
| トライグラム(3-gram) | 3文字 | こんに/んにち/にちは | 3個 |
3-gramでは、最初に「こんに」を取り出し、開始位置を1文字ずらして「んにち」、さらに1文字ずらして「にちは」を取り出します。このように一定幅の範囲を動かす方法を、スライディングウィンドウと呼びます。
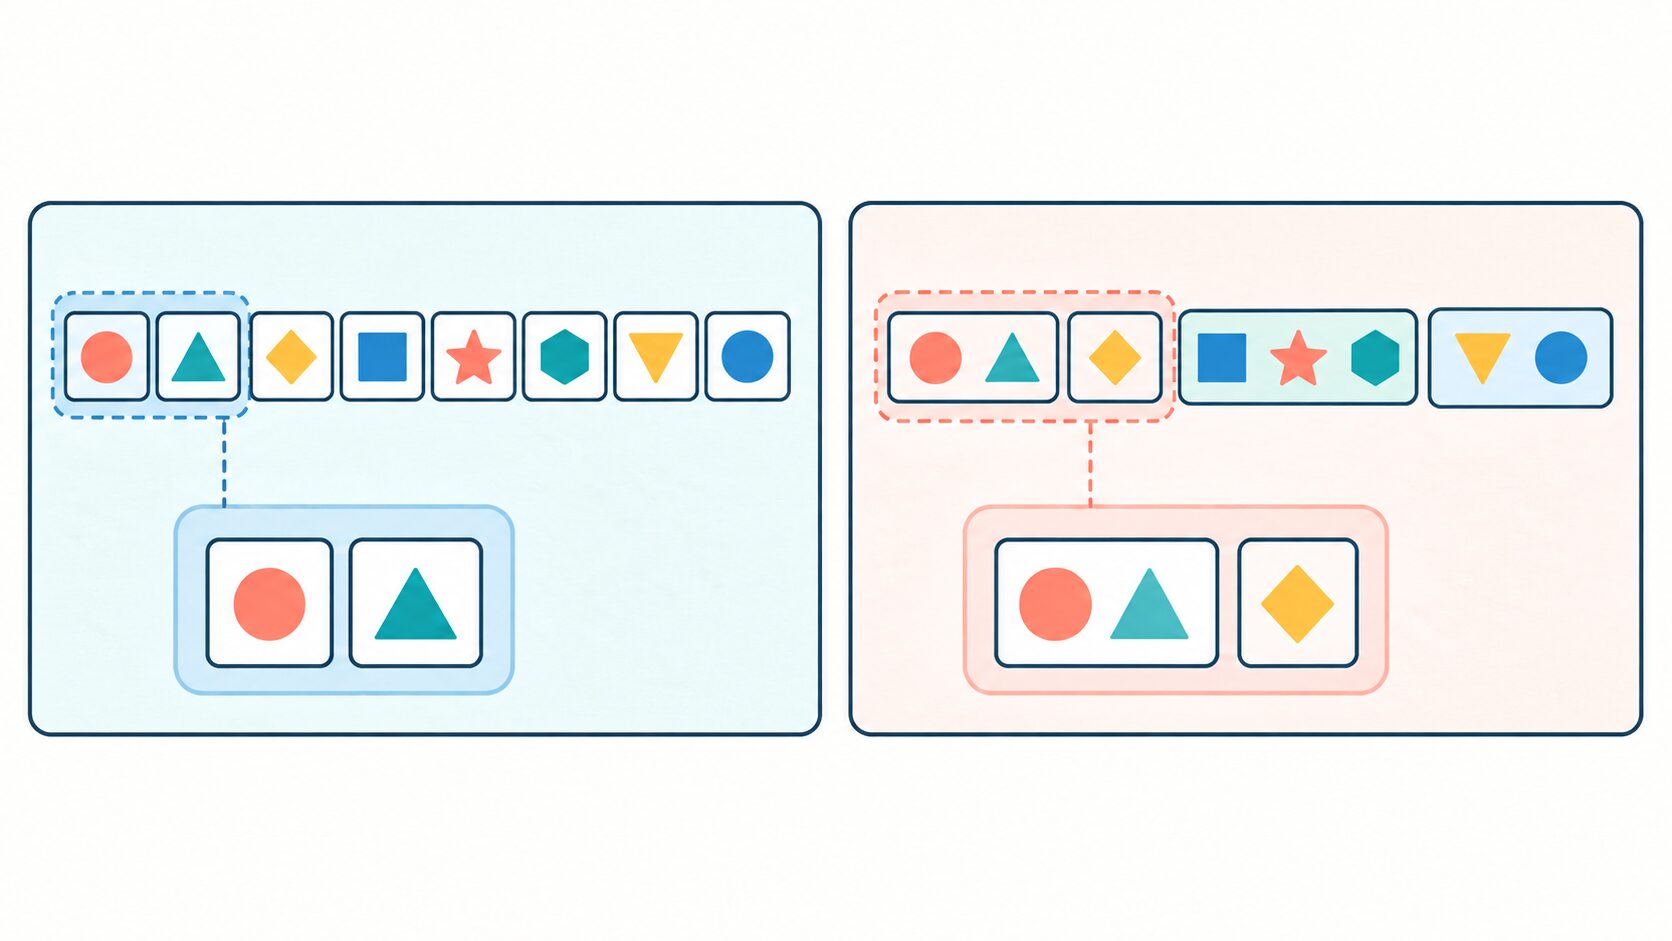
N文字ごとに重ならないように区切る方法ではなく、開始位置を1単位ずつずらすのが通常の作り方です。「こんにちは」を「こん/にち/は」と区切っても、すべての文字2-gramを得たことにはなりません。学習するときは、組の長さと開始位置を別々に確認すると混乱を防げます。
文字N-gramと単語N-gramの違い
文字N-gramと単語N-gramの違いは、数える単位です。同じ2-gramでも、2文字の組と2単語の組では、取り出す内容が変わります。先に単位を決めてから、Nを選ぶ必要があります。
| 比較点 | 文字N-gram | 単語N-gram |
|---|---|---|
| 単位 | 文字 | 分かち書きした単語などのトークン |
| 「今日は良い天気です」の2-gram | 今日/日は/は良/良い/い天/天気/気で/です | 今日 は/は 良い/良い 天気/天気 です |
| 取り出す前の準備 | 文字の扱いと表記の統一を決める | 単語への分割方法を決める |
| 捉えやすい特徴 | 綴り、接頭部分、接尾部分、短い部分一致 | 語の組み合わせや定型的な言い回し |
| 注意点 | 語の境界をまたぐ組や、意味を持たない組もできる | 分割の違いが、抽出する組や頻度に影響する |
日本語は単語の間に空白がないことが多いため、単語N-gramでは、形態素解析などで先に分割するのが一般的です。この記事の「今日/は/良い/天気/です」は説明用の分割例です。実際には解析器や辞書によって区切り方が異なり、文法上の単語と解析器の出力単位が完全に一致するとは限りません。
文字N-gramなら、単語辞書にない新しい名称も文字列として取り出せます。ただし、知らない名称の意味まで分かるわけではありません。表記が少し異なる名称の共通部分を拾う用途には向きますが、異なる対象を似ていると判定する可能性もあります。単語のまとまりが重要なのか、文字の一致が重要なのかを考えて使い分けましょう。
N-gramを作る手順と数え方
\(\max(L-N+1, 0)\)これは、長さ\(L\)の列から取り出せるN-gramの数です。\(N\)は1組の長さで、どちらも単位をそろえて数えます。式は、境界記号を足さず、開始位置を1単位ずつずらす場合に使います。列が組の長さより短い場合は0個です。「こんにちは」は5文字なので、文字3-gramは「5−3+1」で3個になります。
実際の処理は、次の順序で進めると確認しやすくなります。
- 分析する文章を用意し、全角・半角、英字の大文字・小文字、空白や句読点の扱いを決める。
- 文字単位か単語単位かを選び、必要なら単語に分割する。
- Nを決め、列の左端から1単位ずつ開始位置をずらして組を取り出す。
- 同じ組が何回出たかを数え、分類用の特徴や言語モデルの確率計算に使う。
ここで、組が現れた回数と、異なる組の種類数を区別します。「あああ」の文字2-gramは「ああ」「ああ」の2個です。出現回数は2回ですが、種類は「ああ」の1種類だけです。最初から重複を取り除くと、頻度の情報は失われます。一方、文章間でどんな組が共通するかだけを比べたい場合には、種類の集合を使う方法もあります。
前処理も結果に影響します。句読点を取り除いて文をつなぐと、本来は別の文にある単語同士が隣り合ってしまいます。文ごとに抽出するのか、文境界を表す記号を入れるのかを決めておきましょう。文字単位の実装では、絵文字や結合文字など、見た目の1文字が複数の符号位置から成る場合もあるため、「1文字」の扱いを確認します。
N-gram言語モデルは次の単語をどう予測する?
\(P(v \mid u) = \frac{C(u,v)}{\sum_x C(u,x)}\)この式は、バイグラムの出現回数から次の単語の確率を推定する基本形です。\(u\)は直前の単語、\(v\)は次の単語の候補、\(C(u,v)\)はその2語が続いた回数です。分母は、\(u\)の後に何らかの単語が続いた回数の合計で、\(x\)を後続候補全体にわたって足し合わせます。
たとえば、用意した学習用の文章で「天気」の直後に単語が続く例が10回あり、そのうち「天気 は」が6回なら、「天気」の次に「は」が来る確率を6÷10=0.6と見積もります。これはそのデータから得た推定値であり、どんな文章でも必ず6割になるという意味ではありません。
N-gramの抽出と、N-gram言語モデルは役割が異なります。前者は組を取り出す処理です。後者は、その組の頻度などから次の単語の確率を推定するモデルです。単語N-gram言語モデルは、直前の\(N-1\)個の単語を手がかりにします。バイグラムなら直前の1語、トライグラムなら直前の2語です。
この推定を繰り返すと文章の続きを生成でき、単語列の確率を組み合わせると表現の出やすさを比べられます。文の始まりと終わりには専用の記号を使うなど、境界の処理も必要です。ただし、出やすい表現が事実として正しいとは限りません。自然な語のつながりと、内容の正確さは別に確認する必要があります。
N-gramの活用例
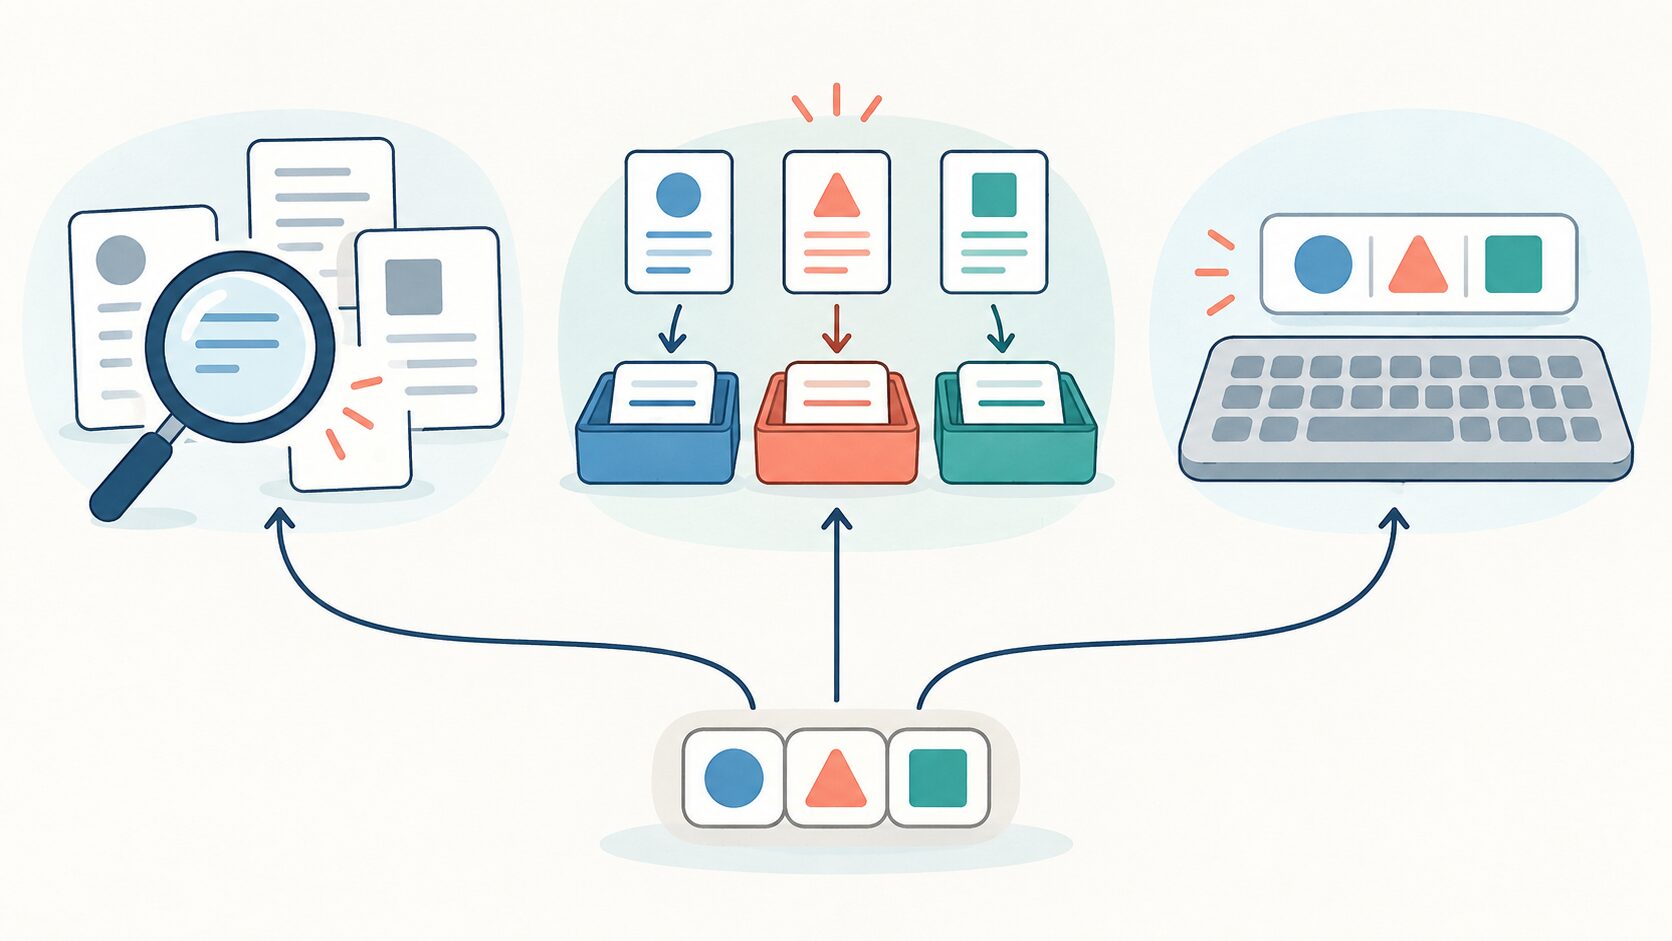
N-gramは、検索や分類などの処理で使う特徴、または候補の出やすさを評価する材料になります。どの用途でも、文字や単語の組を取り出した後に、照合、分類、候補生成などの処理を組み合わせます。
| 用途 | N-gramを使う部分 | 具体例と補足 |
|---|---|---|
| 検索・類似文書の比較 | 検索語と文書が共有する文字列や語の組を調べる | 「エアコン設置」と「エアコンの設置方法」の共通部分を探す。組の一致だけで関連性が決まるわけではない |
| 文章分類 | 組の出現回数などを分類器に渡す | ニュースの分野分類、迷惑メール判定、レビューの分類 |
| 入力予測・文章生成 | 直前の並びに続きやすい候補を評価する | 「東京 天気」の後に「予報」を候補として出す仕組みの一部 |
| 誤字・スペル修正 | 文字の共通部分や、文脈中での候補の出やすさを比較する | 「こんいちわ」に対して「こんにちは」を修正候補として評価する |
| 機械翻訳 | 翻訳先の言語で候補文がどの程度出やすいかを評価する | 統計的機械翻訳で使われてきた言語モデル。原文との対応付けには別の仕組みが必要 |
| 著者識別 | 文字の並びや言い回しの頻度を比較する | 文体の傾向を分類の手がかりにする。文章だけで書き手を確定できるとは限らない |
文章分類では、単語を一つずつ数えるだけでは区別しにくい表現を、複数語の組で捉えられることがあります。たとえば「良い」と「良く ない」では評価が異なります。分割方法と組の長さが合っていれば、否定表現を特徴に含められます。ただし、離れた場所に否定がある場合や皮肉まで、同じ方法で扱えるとは限りません。
誤字修正では、N-gramは候補を比較する材料の一つです。辞書や文字の挿入・削除・置換の距離などを組み合わせると、似た綴りの候補を作り、その中から文脈に合うものを選ぶ流れを設計できます。共通する文字列が多いという理由だけで、自動的に正しい表記が決まるわけではありません。
また、よく現れる語句を重要な表現の候補として扱い、要約で残す文を選ぶ手がかりにする使い方もあります。ただし、N-gramだけで文章の論旨を整理した要約が完成するわけではありません。検索や翻訳についても、ここでの例は利用方法の説明であり、特定サービスの内部実装を示すものではありません。
N-gramを使うメリット
N-gramの利点は、仕組みが単純で、どの並びを数えたか確認しやすいことです。短い文章であれば手作業でも抽出できるため、想定した特徴が得られているかを点検しやすくなります。分類結果に影響した語句を調べる場合にも、特徴と元の文章を対応させやすい方法です。
比較的小さいNと扱いやすい語彙数に絞れば、頻度表を中心に実装でき、学習や予測の処理を軽くできる場合があります。新しい文章分類の方法を試すときに、まずN-gramの特徴を使った基準となるモデルを作り、改善の効果を比較する使い方もできます。ただし、大規模なデータから多数の組を保存すれば、メモリや集計の負担は増えます。
同じ考え方を、日本語、英語、中国語など異なる言語にも適用できます。特に文字単位なら、単語辞書への依存を減らせます。一方、文字体系や表記の慣習は言語ごとに異なるため、前処理や適切なNが共通とは限りません。
学習用の文章を増やすと、観測できる並びが増える利点もあります。しかし、目的と異なる分野の文章や誤記が多いデータを加えると、望ましくない傾向を強めることもあります。データは量だけでなく、利用場面との近さや品質も確認しましょう。
Nの値はどう選ぶ?
Nが小さいと、同じ組を繰り返し観測しやすい一方、保持できる語のつながりは短くなります。Nが大きいと長い言い回しをそのまま捉えられますが、その並びが学習用の文章に十分出てくるとは限りません。Nを大きくすれば、必ず精度が上がるわけではありません。
| 選択 | 得られる情報 | 注意点 |
|---|---|---|
| ユニグラム | 個々の文字や単語の出現傾向 | 頻度に集約すると、単語間の順序は残らない |
| バイグラム・トライグラム | 隣接する要素や短い言い回し | 長い文のつながりは捉えきれない |
| さらに大きなN | 長い定型句や局所的な文脈 | 未観測・低頻度の組が増えやすい |
| 複数のNを併用 | 短い語と長い語句の両方 | 特徴の種類が増え、保存量や処理時間に影響する |
たとえば、文章分類なら単語ユニグラムを基準に、バイグラムを加えて効果を比べられます。文字列の部分一致を使う検索なら、文字バイグラムやトライグラムを試し、短い検索語でも候補を拾えるかを確認します。これらは出発点の例であり、どのデータにも共通する最適値ではありません。
比較には、学習に使わない評価用のデータを用意します。分類なら正しく分けられるか、検索なら必要な文書を拾えているかと無関係な候補が増えていないかを見ます。予測の良さだけでなく、メモリ使用量や処理速度も判断材料です。また、5-gramだけを指定した場合に、2-gramや3-gramも自動的に含まれるわけではありません。複数の長さを使う場合は、その範囲を明示します。
N-gramの限界とスムージング
N-gramの代表的な課題は、データの疎性と、参照できる範囲の短さです。この2つは原因が違うため、対処も分けて考える必要があります。
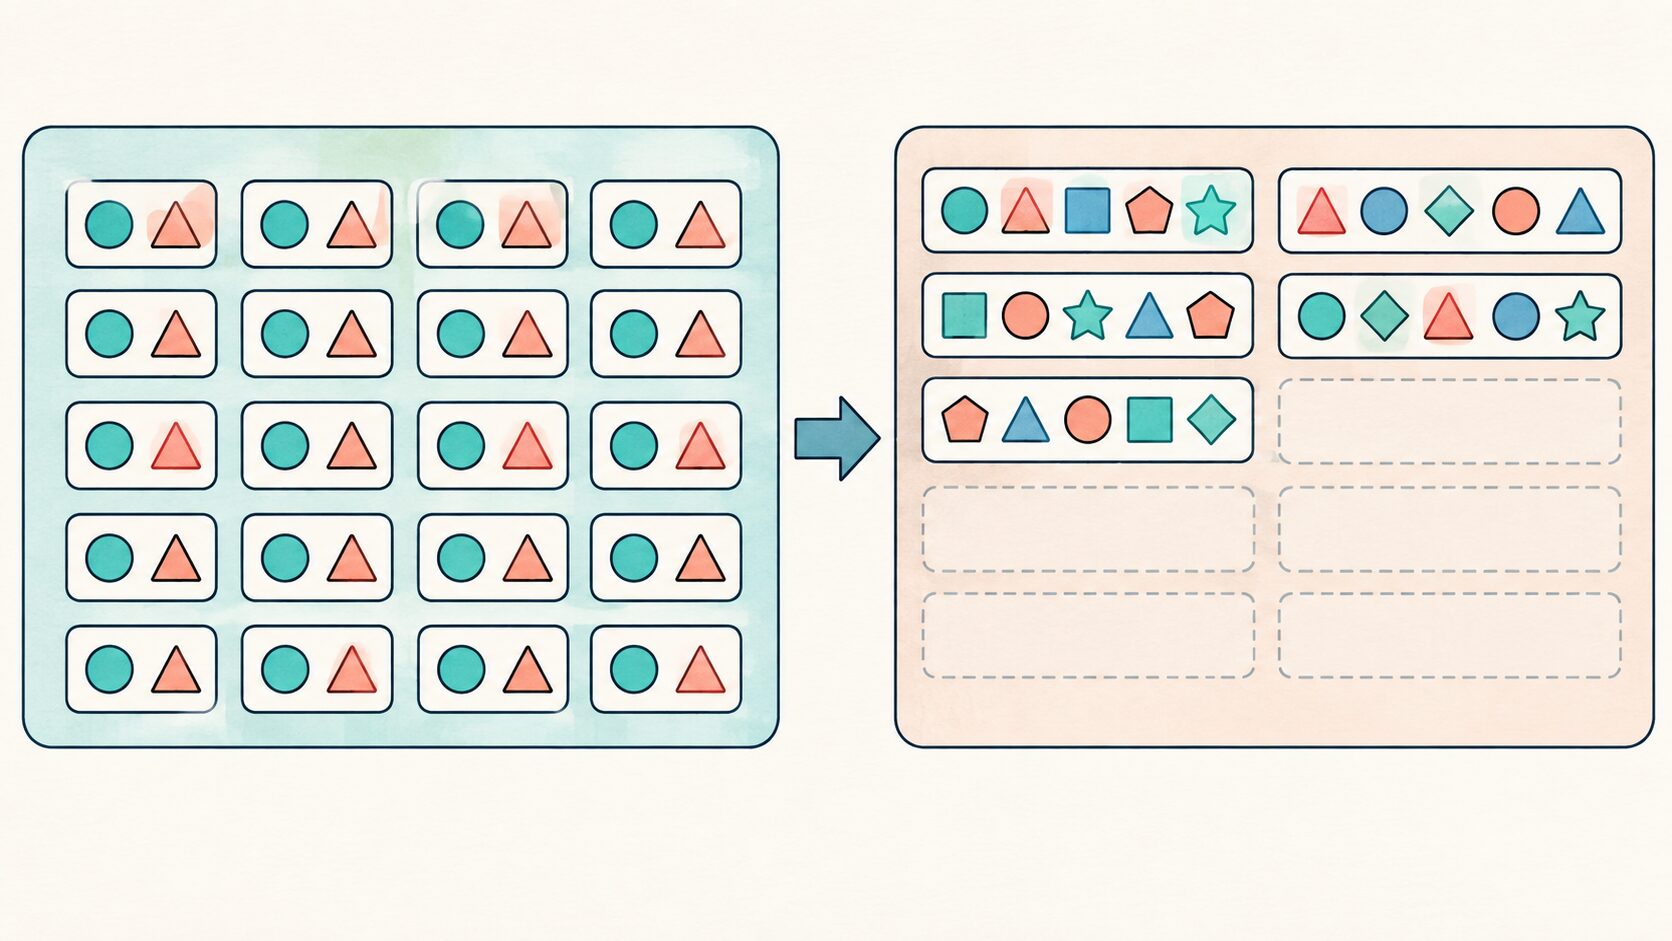
データの疎性とは、あり得る並びに対して、実際に観測できた例が少ない状態です。Nが大きくなると、単語の組み合わせとして考えられる種類は急速に増えます。一方、同じ長い並びが何度も出るとは限りません。なお、同じ長さの文章から切り出す位置の数自体は、Nを大きくすると減ります。「候補となる種類が多い」ことと「一つの文章から取り出す個数が多い」ことは別です。
単純に回数の割合だけで確率を求める言語モデルでは、学習時に一度も現れなかった並びの確率が0になってしまいます。実際には自然な表現でも、手元のデータにないだけかもしれません。この問題を和らげるのが、観測済みの並びに割り当てた確率の一部を調整し、未観測の並びにも確率を残すスムージングです。
説明用の簡単な方法には、あらかじめ決めた候補の回数に一定値を加える加算スムージングがあります。ただし、候補が多いと確率の配分を変えすぎることがあり、常に良い方法とは限りません。長い組の情報が足りないときに短い組の推定へ切り替えるバックオフや、複数の長さの推定を混ぜる補間も、関連する対処法です。どの方法を使うかは評価用のデータで確認します。
もう一つの制約は、離れた単語同士の関係を扱いにくいことです。たとえば主語と述語の間に長い説明が入ると、小さいNだけでは両方を同じ組に含められません。スムージングは未観測の並びへの対処であり、長い文脈の理解を可能にする方法ではありません。遠く離れた要素の関係や文全体の意味が重要なら、別のモデルや特徴との組み合わせを検討します。
単語単位では、学習用の語彙にない未知語の扱いも決めます。未知語を共通の記号に置き換えると語彙を管理できますが、未知語同士の違いは失われます。文字単位の特徴を加える方法も考えられますが、何を区別したいかに合わせた評価が必要です。
形態素解析・Bag of Words・TF-IDFとの違い
これらの用語は、文章を分析する流れの異なる部分を指します。互いに一つだけを選ぶ関係ではなく、組み合わせて使えます。
| 用語 | 主な役割 | N-gramとの関係 |
|---|---|---|
| 形態素解析 | 文章を形態素に分け、品詞などの情報を付ける | 単語N-gramを作る前の分割に利用できる |
| Bag of Words | 文書を語などの出現回数のまとまりとして表す | 通常の単語だけでなく、N-gramを数える特徴として採用できる |
| TF-IDF | 文書内の出現頻度と、文書集合での広がりを使って重みを付ける | N-gramの各組にも重みを付けられる |
| 単語・文の埋め込み | 学習によって語や文を数値のベクトルで表す | 文字列の一致だけでは捉えにくい類似性を扱う別の表現方法 |
たとえば、日本語の文章を形態素解析で分割し、単語の1-gramと2-gramを取り出し、TF-IDFで重みを付け、その値を分類器に渡す構成が考えられます。N-gramは「どんなまとまりを見るか」、TF-IDFは「そのまとまりにどんな重みを付けるか」を決めるものです。
Bag of Words型の表現でバイグラムを数えれば、「白い 車」のような組の内部の順序は残ります。ただし、その組が文書のどこにあり、別の組とどう並んでいたかという文全体の順序までは通常残りません。N-gramを使うだけで、元の文章を完全に再現できると考えないことが大切です。
また、「自動車」と「車」のように表記が異なる語の意味的な近さは、組の一致だけでは捉えにくい場合があります。埋め込みはそのような類似性を表す方法の一つですが、学習データや用途によって結果が変わります。表記の一致を確かめたいのか、意味が近い文章を探したいのかで必要な方法は変わります。
まとめ
N-gramは、連続する文字や単語を一定の長さで取り出し、その並びや頻度を利用する考え方です。重なりを保って1単位ずつずらす仕組みを押さえると、ユニグラム・バイグラム・トライグラムの違いを具体的に理解できます。
実際に使うときは、まず文字か単語かを決め、前処理をそろえ、Nを選んで抽出・集計します。検索や分類では必要な情報を拾えるかを評価し、言語モデルでは未観測の並びへの対処も考えます。短い例を手で切り出して結果と照合することが、実装や学習のよい出発点になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月26日 | 文字3-gramの例を訂正し、単語との違いや確率推定の注意点を追記 |