
プリフィルとデコードとは?処理の違いとLLM推論を分離する仕組み

AIの初心者
生成AIで、返答が始まるまで長く待つときと、文章が少しずつ遅く出てくるときがあります。どちらも同じ処理が遅いのでしょうか?

AI専門家
原因は分けて考えられます。LLMの推論には、入力をまとめて処理する「プリフィル」と、続きの文章を順に生成する「デコード」があります。
AIの初心者
では、この二つを別のGPUに任せれば、いつでも速くなるのですか?画像を送る場合も気になります。
AI専門家
役割分担は有効ですが、処理の途中結果を渡す時間も増えます。画像の変換処理まで含め、どの段階が待ち時間を生んでいるかを見ることが大切です。
プリフィルとデコードとは。
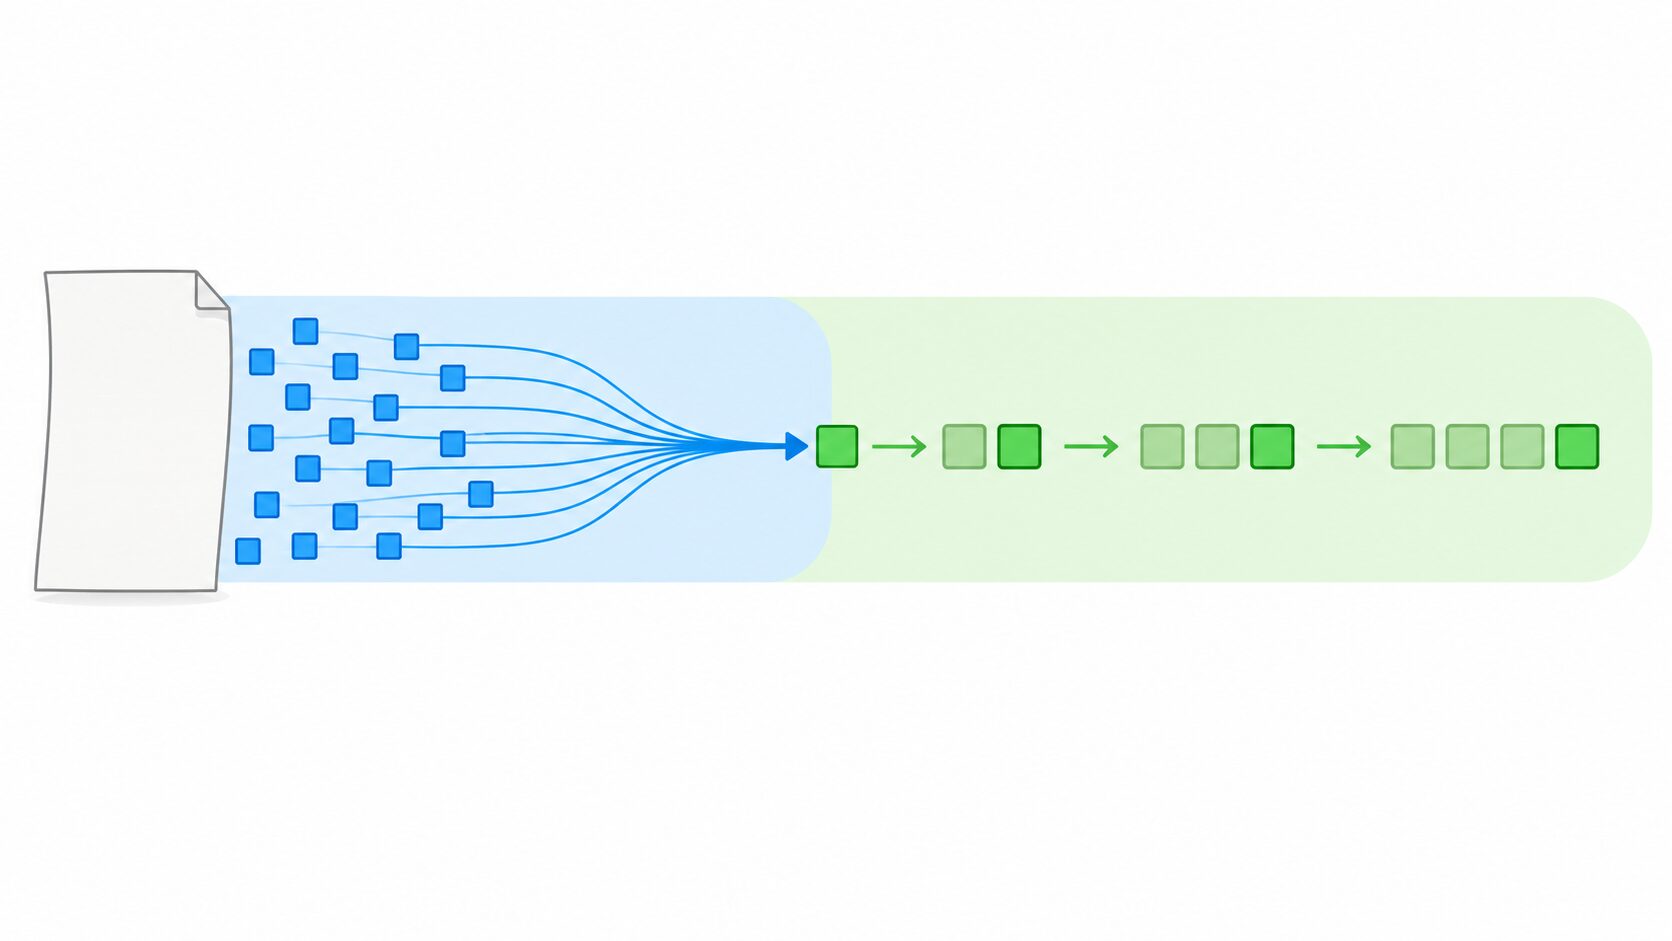
プリフィルは、LLMが入力されたトークン群を処理し、文章の生成に必要な状態を準備する段階です。デコードは、その状態と直前までの文脈を使って、出力トークンを逐次追加する段階です。この二つに別々の実行資源を割り当てる構成をPD分離と呼び、画像などを特徴表現へ変換するエンコードも独立させる構成をEPD分離と呼びます。
まずは「入力を処理する時間」と「返答を伸ばす時間」を分けると、応答の遅さを理解しやすくなります。処理段階の違いと、それをどのGPUで実行するかという構成上の違いを順に見ていきましょう。
プリフィルとデコードはLLM推論の2つの段階
LLMは文章をそのまま一つの文字列として計算するのではなく、トークンという単位に分けて扱います。トークンは単語や単語の一部、文字などに対応しますが、区切り方はモデルによって異なります。日本語の一文字が必ず一トークンになるわけではありません。
プリフィルでは、質問文、会話履歴、参照資料などの入力トークンをモデルへ通します。入力はすでにそろっているため、文脈の参照範囲を守りながら、多くの計算を並列に進められます。この過程で後続の生成に使う情報を用意し、最初の出力トークンもプリフィルの計算結果から選ばれます。
続くデコードでは、選ばれたトークンを文脈に加え、次のトークンを予測して選ぶ処理を繰り返します。基本的な自己回帰生成では、次の計算に直前の出力が必要になるため、未来の出力をすべてまとめて確定することはできません。終了を示すトークンが出るか、指定した出力上限などに達するまで生成が続きます。
長い会議録から短い要約を作る場合、会議録を処理する部分がプリフィル、要約を順に書き足す部分がデコードです。反対に、短い指示から長い物語を書く場合は、入力処理よりも生成を繰り返す部分が長くなりやすいと考えられます。
ここでいう「読み込み」は、ファイルをダウンロードすることや、知識を追加学習することではありません。通常の推論では学習済みのモデルを使い、今回の入力に応じた計算を行います。また、プリフィルとデコードは、同じGPUで動かしていても存在する処理段階です。段階が二つあること自体は、機器を分離しているという意味ではありません。
応答の速さを分けて見るTTFTとトークン間遅延
応答速度を評価するときは、返答が始まるまでの時間と、始まってからの生成間隔を分けます。TTFTは「Time To First Token」の略で、リクエストを出してから最初の出力トークンが届くまでの時間です。ユーザーが「なかなか返答が始まらない」と感じる状況に対応します。
TTFTにはプリフィルの計算だけでなく、処理順を待つ時間、入力の前処理、通信なども含まれます。画像入力なら、画像をモデル向けの表現に変換する時間も関係します。したがって、TTFTが長いという理由だけでプリフィル用GPUの性能不足と決めつけることはできません。
一方、トークン間遅延は、生成中にトークンが届く間隔です。間隔が短く安定していれば、文章は滑らかに表示されます。ただし、アプリが複数トークンをまとめて送信する場合などは、画面上の表示間隔とモデル内部の生成間隔が一致しないこともあります。比較では、利用者側とサーバー側のどこで測った値かをそろえます。
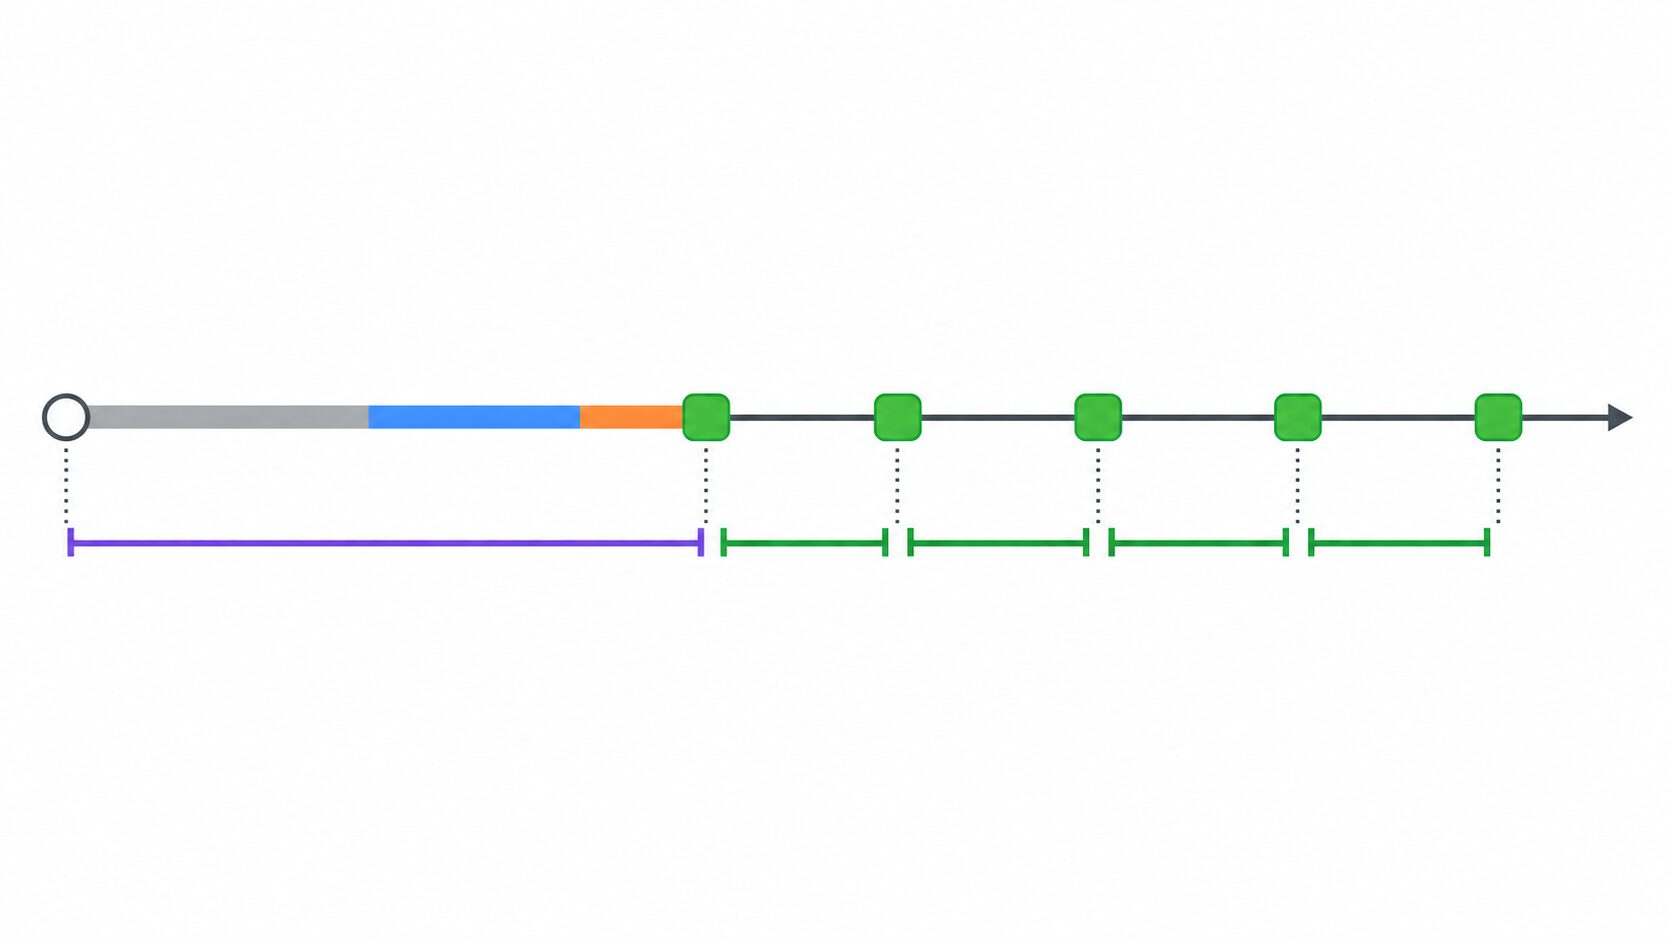
大量の資料から一文だけ答える用途では、生成が始まるまでの時間が体感を左右しやすくなります。短い質問に長い解説を返す用途では、最初の反応が速くても、その後の生成が遅いと完了まで待たされます。全文がそろうまでの時間を改善したい場合には、TTFTと生成中の遅延、出力の長さを合わせて見る必要があります。
処理の性質にも違いがあります。プリフィルは多くの入力をまとめて計算するため、GPUの計算能力が制約になりやすい段階です。デコードは各ステップでモデルの重みや過去の文脈情報を参照するため、とくに少ないリクエストを同時処理する条件ではメモリ帯域が制約になりやすくなります。ただし、モデルの構造、文脈の長さ、同時に処理する量によって、この傾向は変わります。
PD分離は入力処理と生成に別の実行資源を割り当てる
一般的な同居構成では、同じGPUやGPU群がプリフィルとデコードの両方を担当します。PD分離では、Prefill用とDecode用のGPU群、または処理を担うワーカーを分けます。各段階に適した資源量や、複数のリクエストをまとめて実行する方法を選びやすくする構成です。
例えば、複数のユーザーへ文章を生成している最中に、非常に長い資料の入力が届いたとします。同居構成では、新しい入力の計算と、進行中の生成が同じ資源を取り合う場合があります。プリフィルを別の資源で進めれば、生成中の応答への干渉を抑え、トークン間遅延を安定させられる可能性があります。
この分業をつなぐのがKVキャッシュの引き継ぎです。一般的なTransformer型LLMでは、注意機構が過去のトークンを参照します。KVキャッシュは、その計算に使うキー(Key)と値(Value)を保持したものです。過去のトークンについて同じ情報を毎回計算し直す負担を減らします。
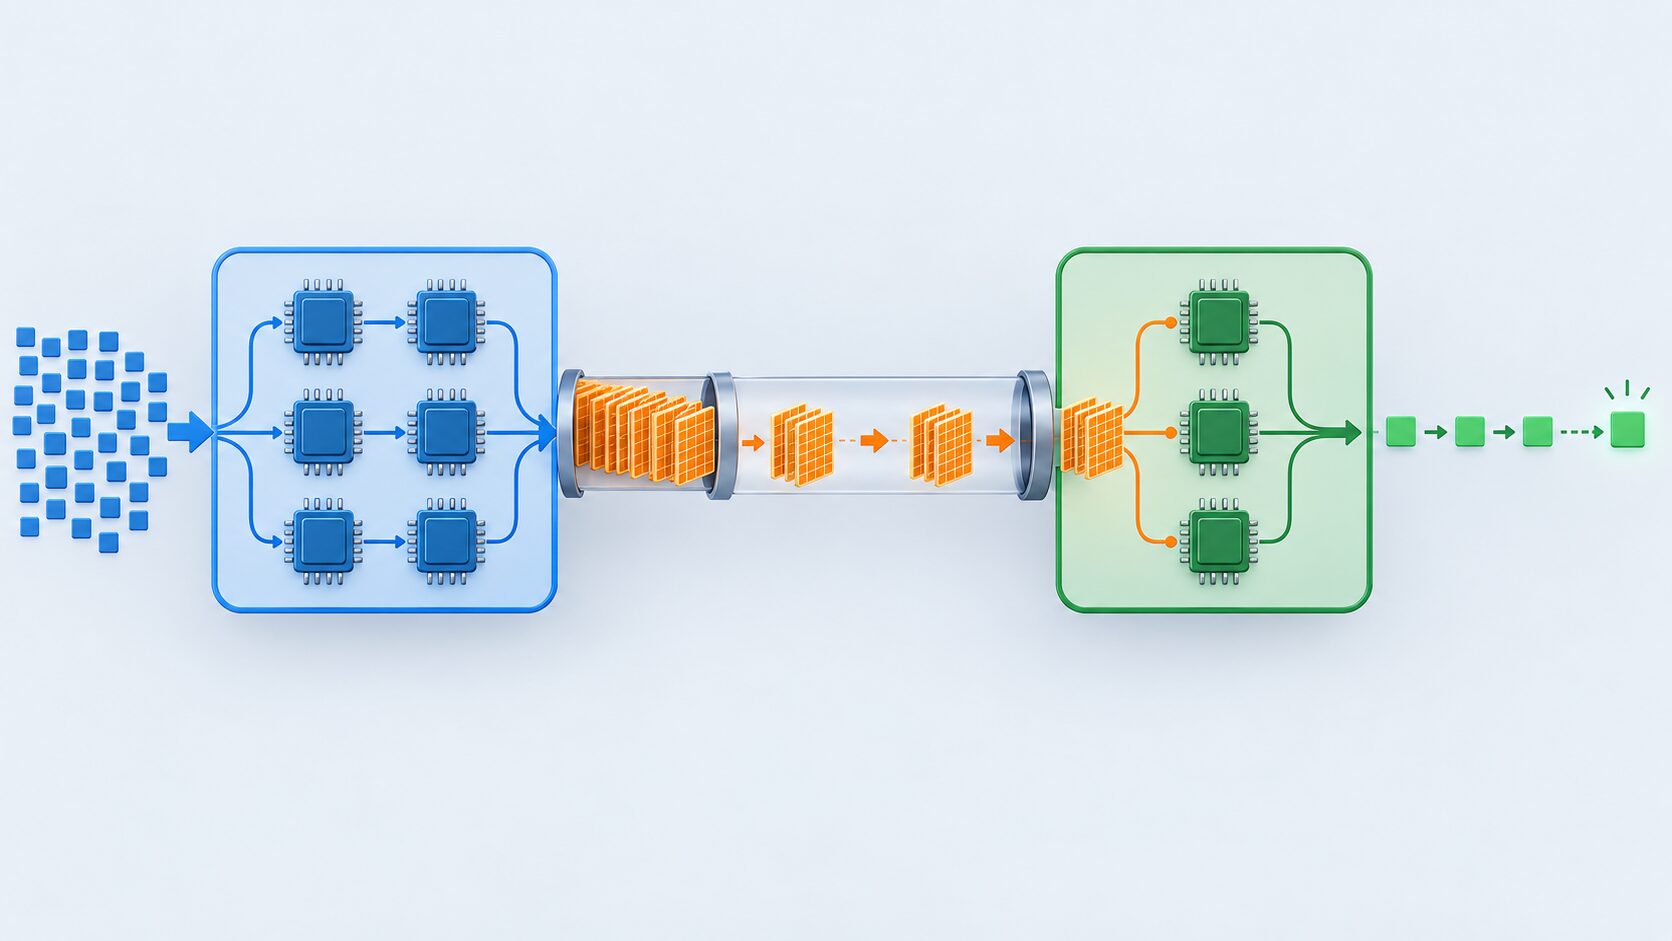
プリフィル側で入力に対応するKVキャッシュを作り、デコード側はそれを参照して生成を続けます。KVキャッシュは、入力文の単純なコピーや完成済みの回答ではなく、モデル内部の計算で使う中間データです。生成が進むと、新たなトークンに対応する情報もキャッシュへ追加されます。
ただし、別の実行資源へ引き継ぐには、GPU間やサーバー間の通信が必要です。キャッシュの量は入力長、モデル構造、保存する数値の精度などで変わり、転送時間とメモリ容量の両方に影響します。分離で計算の競合を減らしても、この転送が長ければ返答開始が遅くなる可能性があります。
資源配分にも偏りが生じます。プリフィル側だけが混雑すれば、デコード側に余力があっても生成を始められません。PD分離の価値は、単にGPUを二組用意することではなく、各段階の負荷に合わせて処理能力を配分できることにあります。
EPD分離は画像のエンコードも独立させる
画像に対応するモデルでは、文章の処理に入る前に、視覚エンコーダーが画像を数値の特徴表現へ変換します。この表現は埋め込みと呼ばれ、モデルが画像の内容を後続の計算で扱うために使われます。画像の大きさや枚数、分割方法などによって、変換の計算量や出力される表現の量は変わります。
EPD分離は、Encode・Prefill・Decodeの三段階にそれぞれ実行資源を割り当てる構成です。視覚エンコードを独立させる点がPD分離との違いです。画像処理が重いときにエンコード側の資源を増やすなど、言語部分の処理とは別に能力を調整できます。
例えば、複数の商品写真を渡して相違点を短く説明してもらう場合、最初に各写真を埋め込みへ変換し、次に質問文と画像由来の表現を使ってプリフィルを行い、その結果から説明文を生成します。画像対応モデルの内部構造は一様ではありませんが、視覚エンコーダーを持つ構成では、この流れで役割を整理できます。
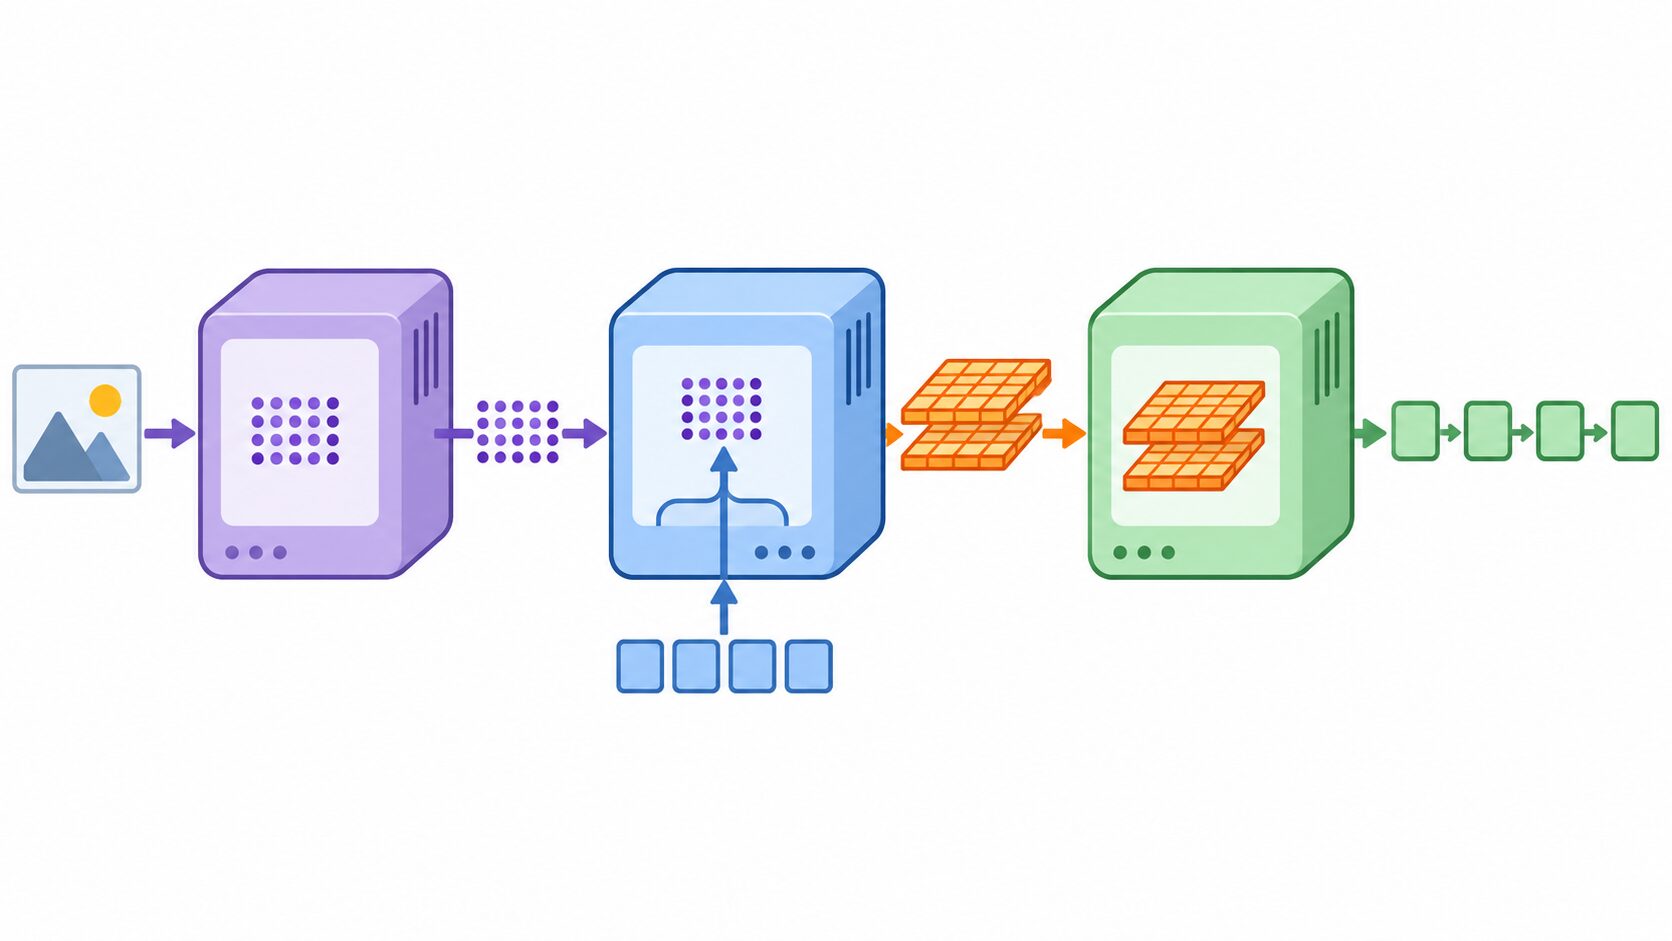
注意したいのは、段階間で渡すデータが二種類あることです。EncodeからPrefillへ渡すのは画像の埋め込みです。一方、PrefillからDecodeへ引き継ぐのは、文脈の処理で作られたKVキャッシュです。それぞれデータの量と通信経路が異なるため、片方の転送が軽いからといって、もう片方も軽いとは限りません。
また、ここでのencodeとdecodeは、ファイルを圧縮して元に戻すような対の変換ではありません。Encodeは画像を扱いやすい表現に変える処理、Decodeは文脈に続く出力を逐次生成する処理です。デコード側が埋め込みを元の写真へ戻すわけではありません。
分離が役立つ場面と効果が小さい場面
同居実行、PD分離、EPD分離は、担当を分ける範囲と追加の転送負担が異なります。構成を選ぶ際は、次のように整理できます。
| 構成 | 処理の配置 | 主な利点 | 分離に伴う転送負担 |
|---|---|---|---|
| 同居実行 | 各段階を同じGPU群で扱う | 構成を簡潔に保ち、資源を共有しやすい | 段階分離のための転送は不要。モデル分割などの通信は別に存在する |
| PD分離 | プリフィルとデコードを分ける | 入力処理と生成の干渉を抑え、個別に資源を配分できる | 主にKVキャッシュの引き継ぎ |
| EPD分離 | 画像のエンコードも独立させる | 視覚処理を含めて段階ごとの能力を調整できる | 画像の埋め込みとKVキャッシュの引き継ぎ |
EPD分離を検討しやすい例は、多数の画像を入力し、短い、または中程度の長さの回答を返すサービスです。画像変換の占める割合が大きければ、その段階を独立させる余地があります。画像付きの依頼とテキストだけの依頼が混在し、画像処理の負荷がほかの応答へ影響する場合も検討対象です。
小型モデルや、一部の専門ネットワークを選んで計算するMoEモデル、数値の精度を下げて計算やメモリの負担を抑える量子化モデルでは、言語処理に対して画像処理の負担が相対的に目立つ場合があります。ただし、モデルの種類だけでEPD分離の効果は決まりません。画像数や言語側の実際の処理時間を確認する必要があります。
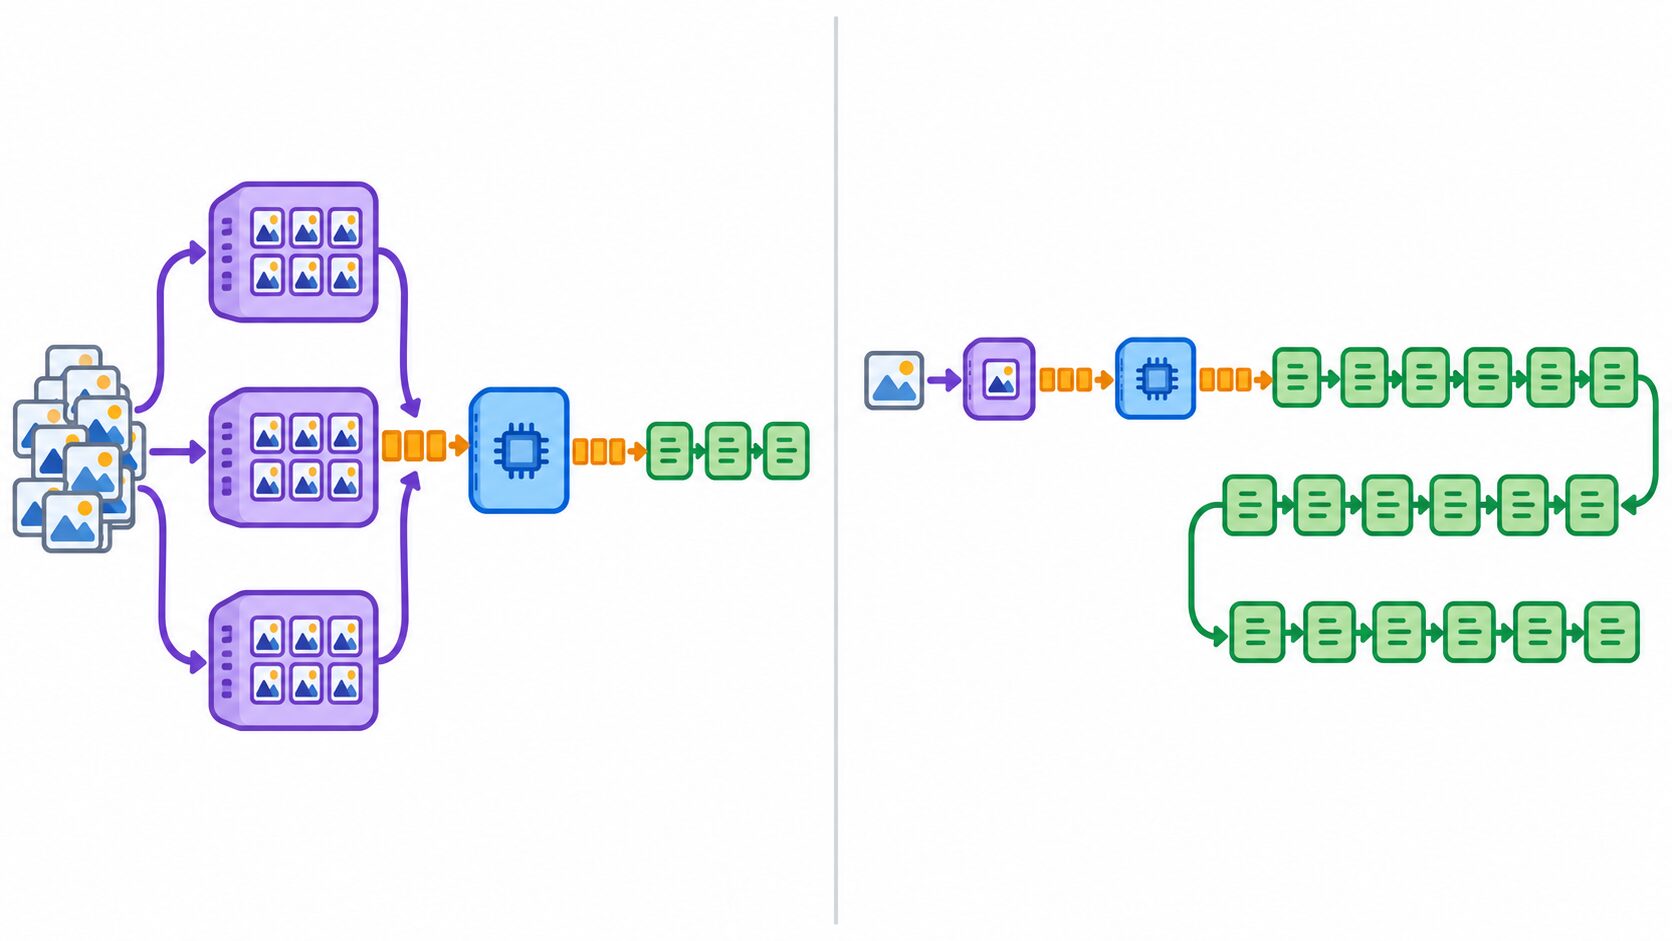
一方、長文の生成が処理時間の大部分を占める用途では、画像処理を切り離しても全体の短縮幅は小さくなりがちです。画像が少なく変換が軽い場合も、エンコード専用の資源を設ける利点は限られます。テキスト中心のサービスでは、まずPD分離による改善余地を評価するのが自然です。
リクエストが少なく、現在の同居構成で応答目標を満たしている場合も、分離を急ぐ必要はありません。専用のGPUが待機する時間が増えたり、段階ごとの振り分けや転送で時間を使ったりする可能性があります。分離によって減る待ち時間より、追加の通信や調整の時間が大きければ逆効果になります。
導入判断は転送コストと実際の負荷で行う
導入を判断するには、まず同居構成の実測値を基準にします。確認するのはTTFT、トークン間遅延、単位時間あたりに処理できる量、GPUの使用量と費用です。処理量についても、回答が長いだけで出力トークン数は増えるため、完了したリクエスト数などと合わせて用途に即して比較します。
比較条件には、入力の長さ、画像数、出力の長さ、同時リクエスト数を含めます。モデルと出力条件をそろえ、同じ負荷を同居構成と分離構成に与えて測ります。総GPU数を増やした構成なら、速くなった理由に資源増加も含まれるため、必要な速度をどの費用で達成できたかまで確認します。
次に、処理時間を段階ごとに分け、KVキャッシュの大きさと転送時間、利用できる通信帯域、各段階の待ち行列を調べます。EPD分離では画像の埋め込みの転送も別に測ります。計算が短くても、次のワーカーが空くまで長く待っていれば、利用者の待ち時間は改善しません。
平均だけを見ると、混雑時の遅い応答を見落とします。例えば95パーセンタイルは、対象リクエストの95%がその値以下となる境界を示します。平均とともにこうした値も使い、長い入力や画像の多い依頼が重なる時間帯でも、応答目標を満たせるかを評価します。
関連する最適化も区別しておきましょう。KVキャッシュは同居構成でも使われるため、その利用自体はPD分離を意味しません。共有プレフィックスのキャッシュ再利用は、共通するシステム指示や資料など、入力の先頭部分で計算した結果を別のリクエストでも使う方法です。成立すればプリフィルの計算を減らせますが、実行資源を分ける方法とは別です。
バッチ処理は、複数のリクエストをまとめて計算し、GPUを効率よく使う方法です。これらは分離と併用できますが、同居構成の処理のまとめ方を改善するだけで目標に届く場合もあります。適用できるキャッシュ再利用やバッチ設定を確認してから比較すれば、分離による効果を判断しやすくなります。
結局のところ、選ぶ基準は「段階を多く分けたか」ではなく、現在のボトルネックを緩和し、転送負担を含めても応答目標と費用に見合うかです。まず返答開始と生成中の速さを分けて測り、入力処理、画像処理、生成のどこに資源が必要かを確かめることが、構成選びの出発点になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月3日 | 初回公開 |