
llm-dとは?AIエージェント向け分散推論の仕組み

AIの初心者
AIエージェントの利用者が増えると、推論サーバーを増やすだけで応答は速くなるのでしょうか?

AI専門家
処理できる総量は増やせても、長い入力の再計算や特定サーバーの混雑が残る場合があります。要求の送り先と計算結果の再利用を一緒に考える必要があります。
AIの初心者
そこで使うのがllm-dですか? エージェントを作るための仕組みとは違うのですか?
AI専門家
はい。llm-dが主に担うのは、エージェントなどが呼び出すLLMの推論を複数のサーバーで効率よく提供する部分です。役割と処理の流れを順に見ていきましょう。
llm-dとは。
llm-dは、Kubernetes上でLLMの分散推論を支えるオープンソースのソフトウェアスタックです。Kubernetesは、アプリケーションの実行単位であるコンテナの配置や稼働を管理する基盤です。llm-dは推論エンジンなどと連携し、要求の振り分け、計算途中のデータの再利用、入力処理と生成処理の分離を組み合わせて、推論サービスを構成します。
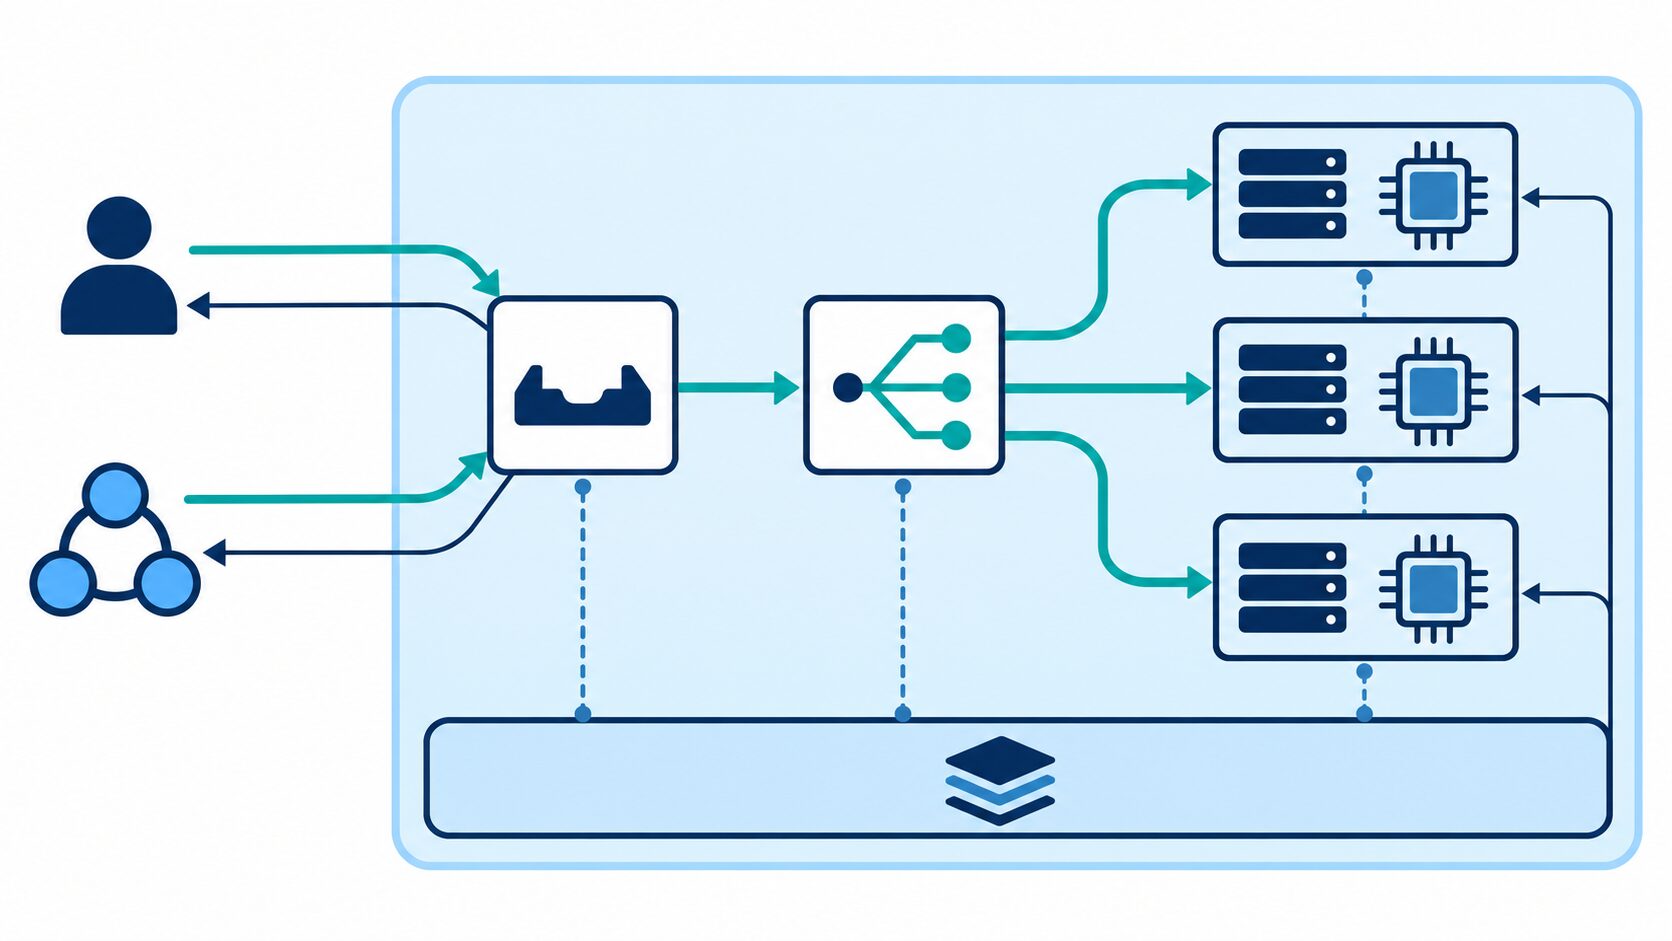
全体像は、利用者やエージェントが要求を送り、推論基盤が送り先を選び、モデルを動かすサーバーが応答を生成する流れです。どこで計算し、何を再利用するかが、応答の待ち時間と資源の使い方に関わります。
llm-dの役割と推論エンジンとの違い
llm-dを理解する鍵は、モデルを実行する役割と、複数の実行先を連携させる役割を分けることです。要求を受け付ける入口、送信先を選ぶ処理、実際に計算する推論エンジンが連携して、一つの推論サービスになります。llm-d自体が学習済みモデルやGPUの代わりになるわけではありません。
例えば、同じモデルを提供するサーバーが3台ある場合、各サーバーの推論エンジンは入力を処理して文章を生成します。一方、どのサーバーに次の要求を送るかは、混雑や再利用できる計算データも関わる基盤側の課題です。各要素の主な担当は次のように整理できます。
| 要素 | 主な役割 | 推論サービスでの位置づけ |
|---|---|---|
| Kubernetes | コンテナの配置や稼働状態を管理する | 推論サーバーなどを動かす土台 |
| vLLMなどの推論エンジン | モデルを読み込み、入力処理とトークン生成を実行する | モデルの計算を担う実行部分 |
| llm-d | 要求の振り分けやキャッシュの扱いなどを組み合わせる | 複数の実行先を連携させる推論基盤 |
| エージェント側のアプリケーション | 作業手順を管理し、検索などのツールを実行する | 推論サービスを呼び出して目的の処理を進める利用側 |
「分散」には異なる意味もあります。複数のモデルサーバーへ要求を分ける方式と、一つのモデルの計算を複数GPUに分けるテンソル並列などは別の仕組みです。前者は同時に届く要求を受け持つ先を増やし、後者は大きなモデルの実行や計算の分担に使います。両者は併用でき、各送信先が複数GPUで構成される場合もあります。
キャッシュとセッションを考慮したリクエストの振り分け
要求を順番に均等配分するだけでは、長い入力の再計算が増える場合があります。例えば、すべての要求に同じ長い業務指示が付くサービスでは、その部分を処理済みのサーバーへ送ると、保存された中間計算を再利用できる可能性があります。こうした再利用の見込みを送り先の選択に含める考え方が、キャッシュを考慮したルーティングです。
再利用で重要なのは、入力の先頭から共通する部分である「接頭辞」です。同じ指示文でも、その前に毎回異なる情報を入れると、共通部分として扱える範囲が変わります。単に似た話題の質問を同じサーバーへ送ればよいわけではなく、モデルが受け取る入力の並びが関係します。
セッションを考慮したルーティングは、一連の会話など、継続する要求の関係を手掛かりにします。前の会話を処理したサーバーに関連するキャッシュが残っていれば、続きを送る際の再計算を減らせる可能性があります。ただし、同じセッションであることだけで再利用が確定するわけではありません。履歴の編集やキャッシュの削除も影響します。
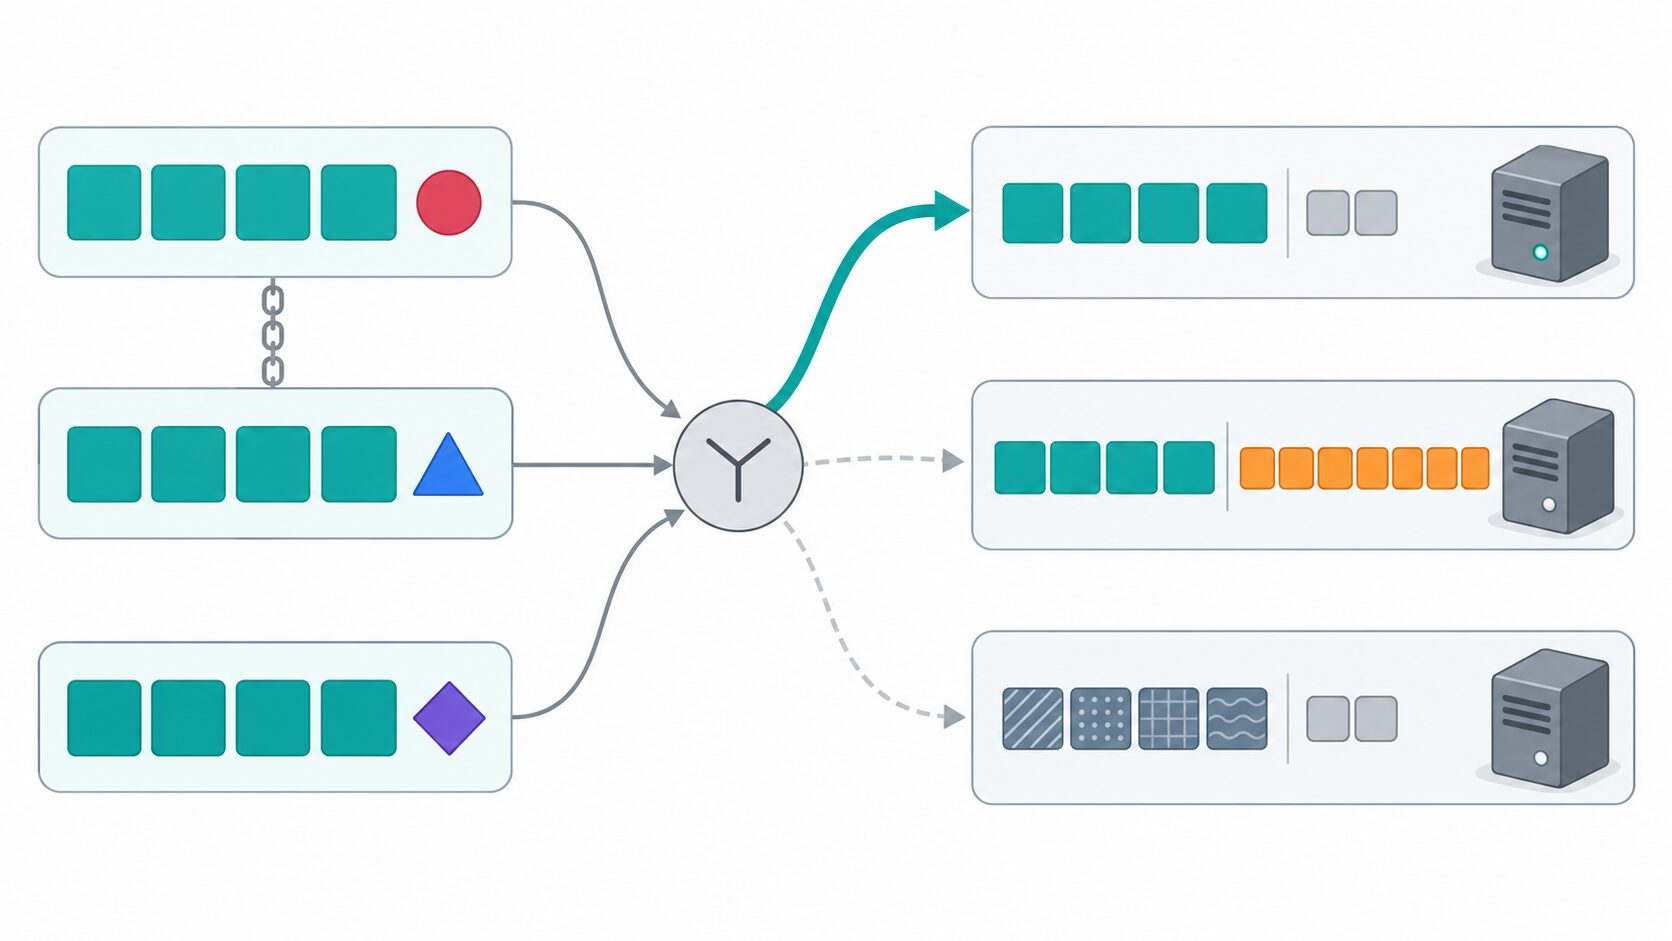
送り先を選ぶ際には、再利用できる量と待ち時間の両方を考えます。キャッシュを持つサーバーでも、長い待ち行列があれば、空いている別のサーバーで再計算した方が早い場合があります。同じ会話の送信先を固定するだけでは負荷が偏り、障害時にも処理を続けにくくなります。具体的な選択方法や切り替え方は、導入する構成に合わせて確認します。
階層型KVキャッシュで長い文脈を再利用する
KVキャッシュは、LLMが文脈を参照するために計算したKeyとValueという中間データを保存する仕組みです。生成中に過去の入力について同じ計算を繰り返す負担を減らし、条件が合えば別の要求でも共通部分を再利用できます。完成した回答を保存して返す「回答キャッシュ」とは異なり、再利用後も続きの生成処理が必要です。
再利用には、使うモデルや入力の接頭辞、キャッシュの形式などが整合している必要があります。文章の意味が似ているだけで流用できるわけではありません。会話履歴を要約し直した場合も、意味は引き継いでいても入力が変わるため、それまでの計算結果を同じ範囲で使えるとは限りません。
長い文脈を多数の利用者が扱うと、キャッシュの保存容量も大きくなります。高速にアクセスできるGPUメモリには限りがあり、モデル本体や実行中の処理にも容量が必要です。階層型KVキャッシュは、速度や容量の異なる保存先を組み合わせ、必要なデータを保持・取得する考え方です。よく使うものを近くに置き、それ以外を別の保存階層へ退避する設計が考えられます。
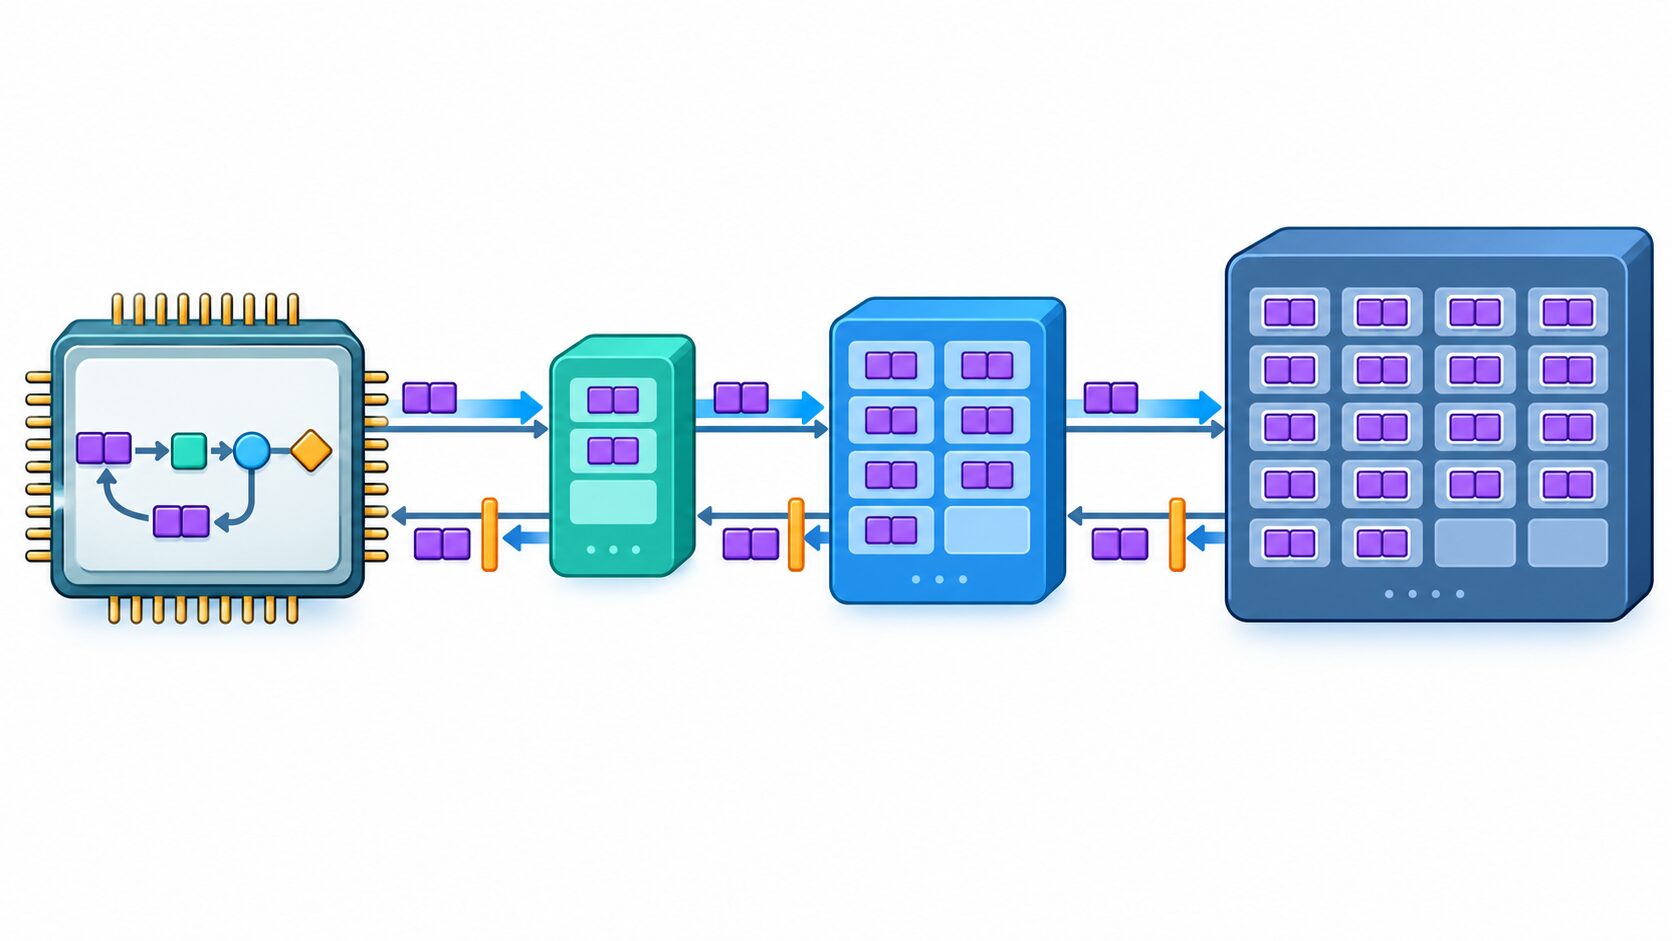
階層化で保存できる量が増えても、退避や取得には時間がかかります。再計算より取得・転送が遅ければ、再利用が応答の短縮につながらない場合もあります。保存を管理する仕組みと、どの実行先で再利用するかを選ぶルーティングを結び付け、データの所在と移動の負担を考える必要があります。
対応する保存先や必要な構成は、対象バージョンの資料で確認します。また、KVキャッシュは入力に由来するデータです。複数の利用者や組織で基盤を共有する場合は、アクセスを分離し、どの範囲で共有・保持・削除するかを決めます。保存場所を増やす際には、その管理範囲も併せて確認します。
Prefill・Decode分離とフロー制御の連携
LLMの推論は、大きく入力を処理するPrefillと、続きを少しずつ生成するDecodeに分けられます。トークンは、モデルが扱う文字列の単位です。Prefillでは入力のトークンをまとめて処理し、生成に必要な中間データを用意します。Decodeでは、それまでの文脈を参照しながらトークンを逐次生成します。
長い入力を読む処理と、出力を継続して生成する処理では、資源の使い方や負荷のかかり方が異なります。同じ実行先に両方が集まる構成では、入力処理の増加が生成中の応答に影響することがあります。PrefillとDecodeを分離すると、それぞれの負荷に合わせて資源を割り当てやすくなります。ただし、どの程度改善するかは要求の長さや同時実行数にも左右されます。
分離した構成の流れは、要求受付、Prefillの実行、KVデータの引き渡し、Decodeの実行、応答の返却です。入力側の計算が終わると、生成側がその結果を使えるようにする必要があります。ここにサーバー間の通信やキャッシュ転送が加わるため、ネットワークの速度と転送するデータ量が性能に関わります。
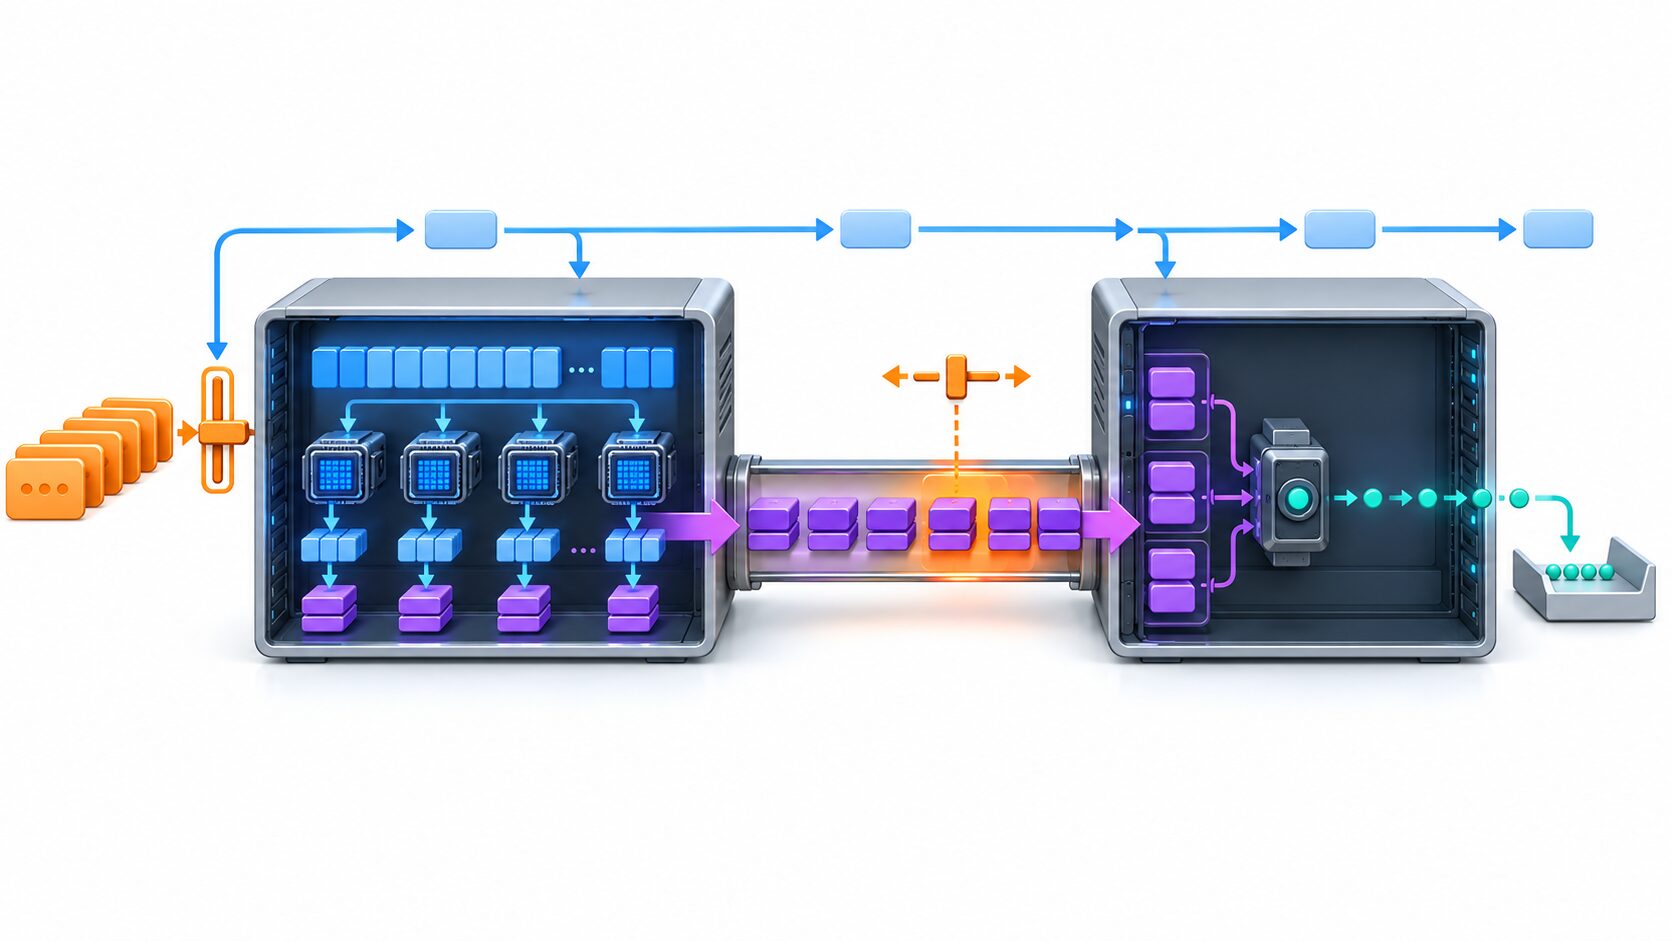
フロー制御は、受け手の処理能力に合わせて要求やデータの流れを調整する役割です。例えば入力処理が速く進んでも、生成側が混雑していれば、未処理の要求や引き渡すデータがたまります。構成を分けただけで待ち行列やメモリ不足が解消するわけではなく、受け入れ量と後段の処理能力を釣り合わせる必要があります。
具体的にどこで流量を調整するか、混雑をどう検知するかは、採用する構成と対象版の資料で確認します。分離の効果を評価する際も、各段階の計算時間だけでなく、段階間で待つ時間と転送時間を含めて測ります。
AIエージェントで効果を検討できる場面
社内文書を調べるエージェントを例にすると、一つの質問に対して複数回の推論が発生します。最初の推論で検索すべき内容を判断し、アプリケーションが検索ツールを実行し、その結果を含めて再びモデルを呼び出して回答を作ります。llm-dが担うのは、この流れの中で呼ばれるLLM推論の提供部分です。検索の実行や作業手順の管理はエージェント側が受け持ちます。
こうした処理では、共通の業務指示、ツールの説明、会話履歴などが繰り返し入力に含まれます。長い共通文脈があり、多数の利用者が同時に推論を呼び出すなら、キャッシュ再利用と負荷分散を検討する理由があります。ただし、ツールの待ち時間が大半を占める場合は、推論部分が速くなっても利用者が感じる改善は限られます。
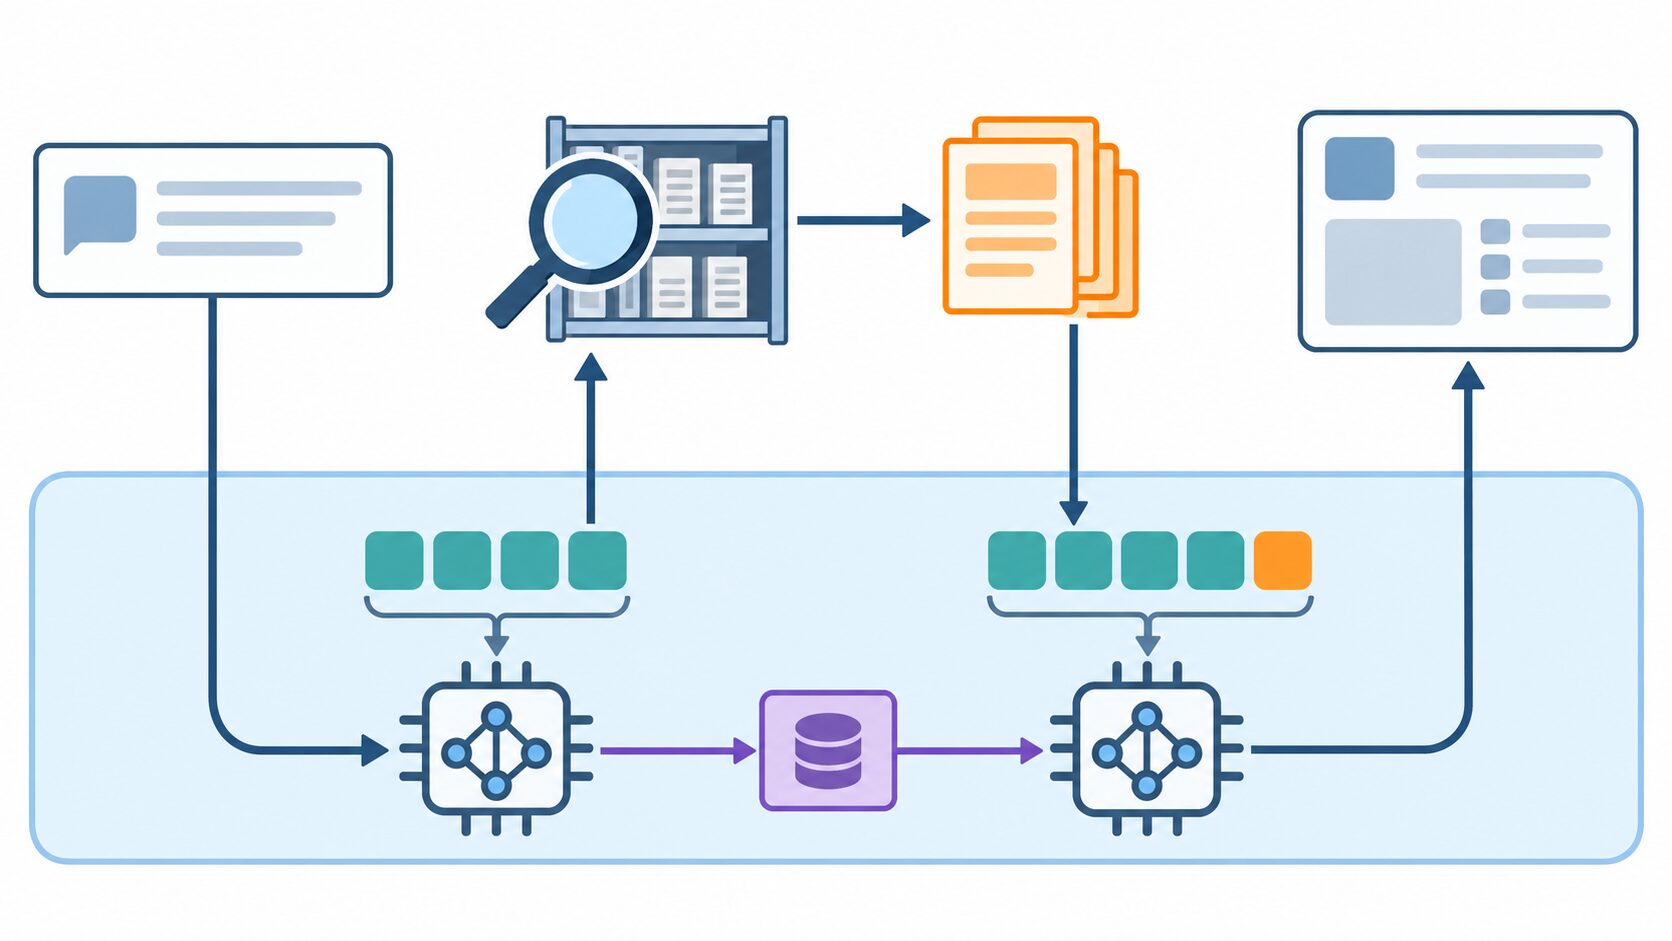
再利用の範囲は、入力のどこが変わるかによって変化します。共通の指示が先頭にあり、新しい検索結果を後ろへ追加するなら、先頭の共通部分を再利用できる可能性があります。一方、毎回冒頭を書き換えたり、履歴全体を組み直したりすれば、再利用できる部分が減る場合があります。前回のキャッシュが残っているかも条件の一つです。
短い単発要求が中心で利用者も少ないなら、単純な推論サーバー構成で十分な場合があります。分散構成を管理する負担に見合う効果があるかを比較することが大切です。また、この仕組みはエージェント専用ではありません。長文を扱う対話サービスなど、共通する入力を繰り返し処理する用途にも同じ検討軸を使えます。
導入判断と性能評価で確認すること
2026年10月20日のllm-d 1.0の発表は、Google Cloudの発表記事で案内されています。発表日と、実際に導入するソフトウェアのバージョンは分けて確認しましょう。構成要素の組み合わせ、対応する保存先、設定方法は、採用する版の資料に照らし合わせる必要があります。
Googleなどが示すベンチマークを読む際は、モデル、ハードウェア、入力長と出力長、同時実行数、比較対象、キャッシュの状態を一組の条件として確認します。同じモデルでも、初回の要求と共通入力を繰り返す要求では結果が変わります。特定条件での測定値を、そのまま自分の環境の性能保証として扱うことはできません。
評価指標も用途によって使い分けます。対話なら、要求を送ってから最初のトークンが届くまでの時間が待ちやすさに関わります。生成中の読みやすさにはトークン間の時間、処理の完了には全体の応答時間が関係します。多数の要求を受ける用途では単位時間当たりの処理量も重要です。コストはGPUの稼働費だけでなく、通信、保存、運用の負担も含めて比べます。
処理量を比べるときは、許容する待ち時間もそろえることが大切です。多くの要求を受け付けても、応答が遅すぎれば用途を満たせません。平均値に加え、例えば95%の要求が収まる時間を示す95パーセンタイルも見れば、一部の利用者が長く待っていないかを確認できます。測定時の負荷や失敗した要求の扱いも合わせます。
導入前には、GPUメモリの余裕、サーバー間ネットワーク、障害時の振り分け、監視、構成管理を確認します。キャッシュの再利用率だけを追わず、待ち行列、転送時間、メモリ使用量も観測すると、再利用が実際の応答改善につながっているかを判断しやすくなります。
最初は小規模な比較環境で、自分のサービスに近い要求を流すとよいでしょう。共通入力が少ない場合と多い場合、通常時と混雑時を比べ、必要に応じて分離や階層化を加えます。llm-dの導入判断では、どの待ち時間や再計算を減らしたいのかを明確にし、その改善が追加の通信・保存・運用コストに見合うかを確かめることが重要です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月21日 | 初回公開 |