
深層学習における二重降下現象とは?意味・仕組み・注意点を解説

AIの初心者
「二重降下現象」って何ですか?モデルを大きくすると、初めて見るデータへの予測が一度悪くなって、その後また良くなることがあると聞きました。

AI専門家
そのように、未知のデータへの誤差が下がり、上がり、もう一度下がる現象だよ。特に、訓練データにちょうど誤りなく合わせられる境界付近では、データに含まれる偶然のばらつきや誤ったラベルの影響を強く受けて、予測が悪くなる場合があるんだ。
AIの初心者
訓練データには正解できても、初めて見るデータでは間違えるんですね。それなら、もっと大きくすると再び良くなるのはなぜですか?
AI専門家
さらに大きくなると、訓練データに合う解の選択肢が増え、その中から学習方法によって未知のデータにも対応しやすい解が選ばれる場合があるんだ。ただし、大きくすれば必ず回復するわけではないよ。モデルの大きさだけでなく、データや学習条件も合わせて考える必要があるんだ。
二重降下現象(double descent)とは、モデルの容量などを増やしたとき、未知のデータに対する予測誤差が「低下・上昇・再低下」と変化する現象です。「降下」は性能が下がることではなく、誤差が下がって予測が良くなることを指します。
深層学習では、大きなモデルが高い性能を示す一方、規模を少し増やしただけでは結果が悪くなることもあります。二重降下を知ると、その一度の悪化だけでモデルの限界を判断しにくい理由が分かります。まずはモデルの容量と誤差の関係を押さえ、その後に過学習との関係、学習時間・データ量による違い、モデル選択での注意点を見ていきましょう。
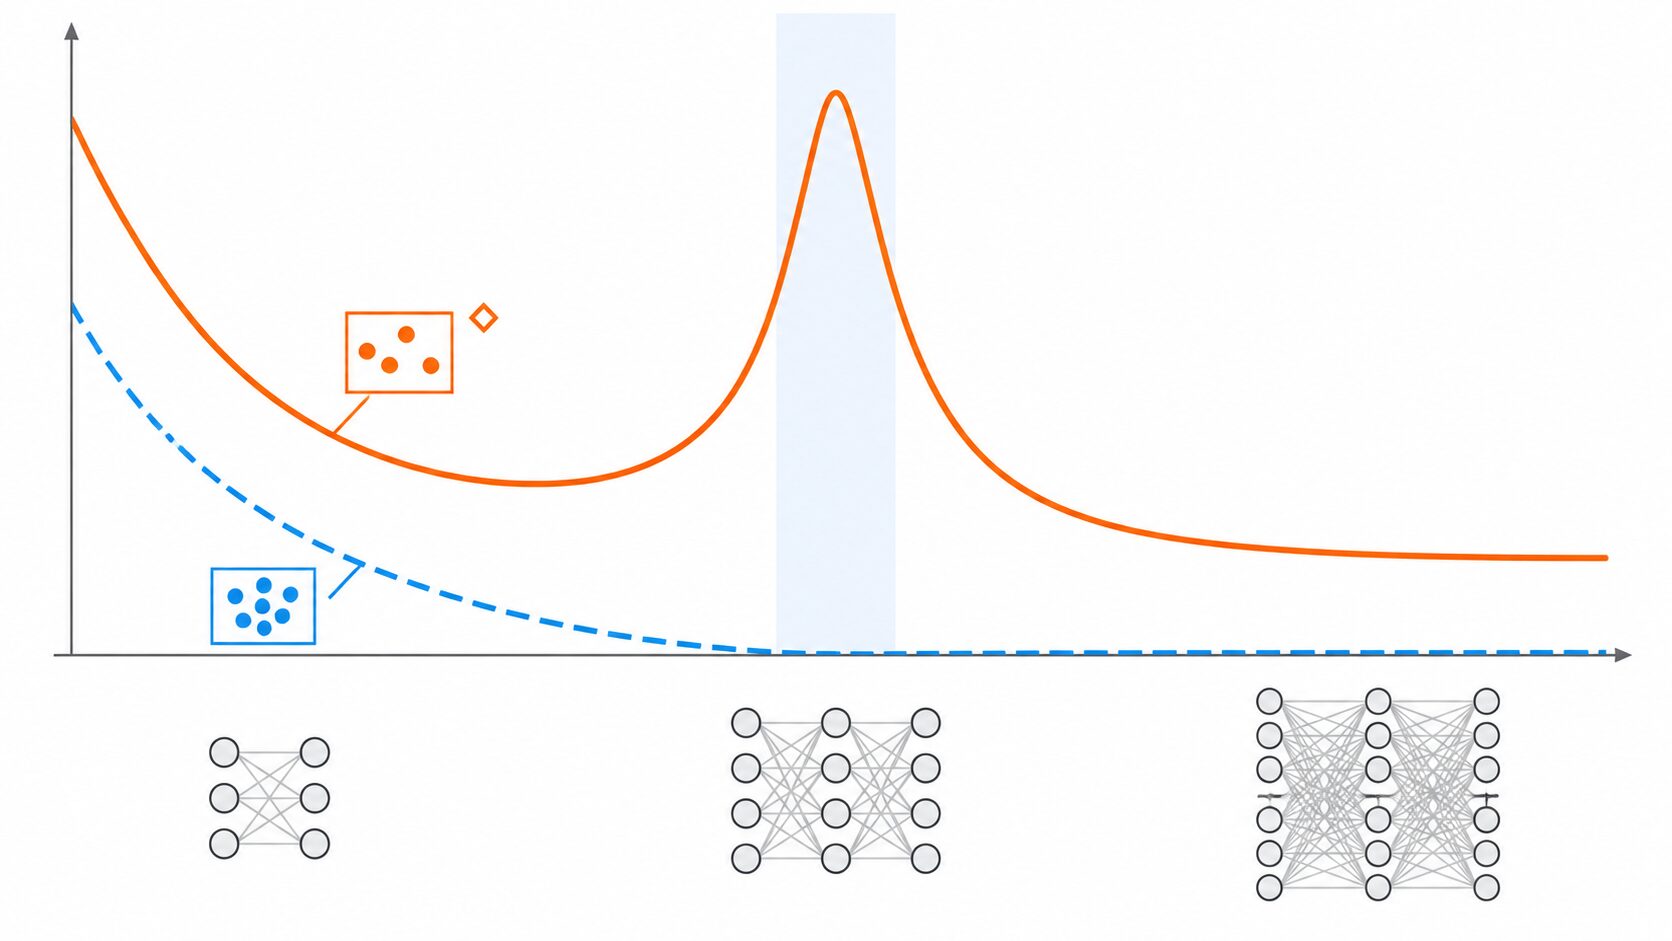
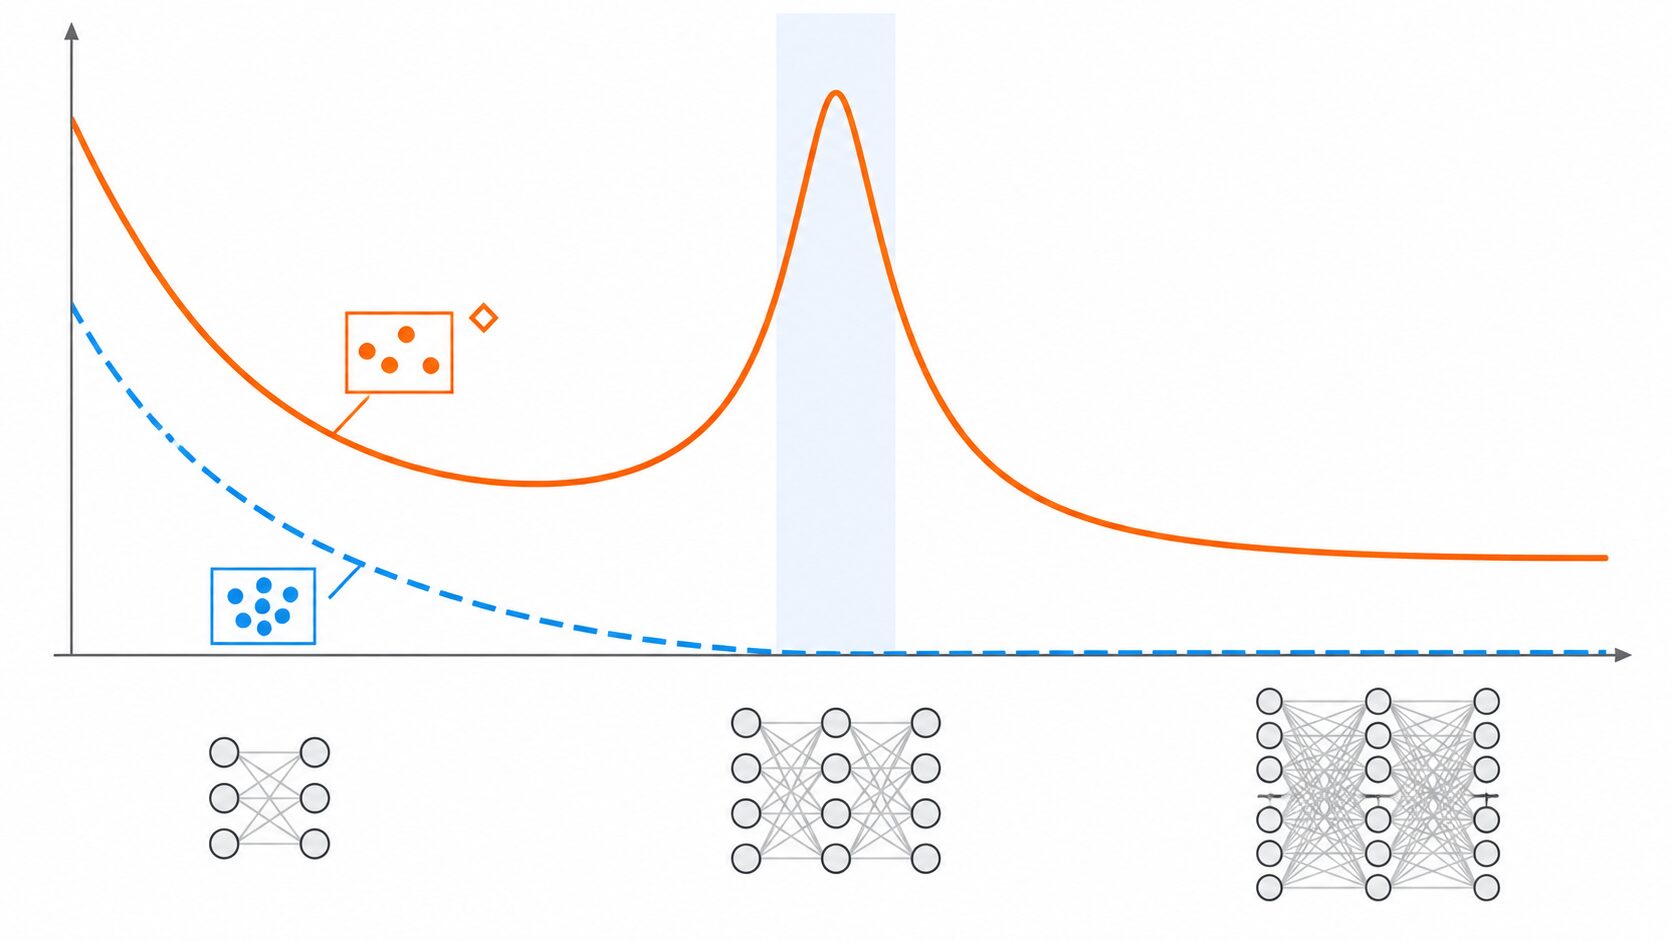
誤差曲線を読むときは、訓練に使ったデータへの誤差と、学習に使っていないデータへの誤差を分けることが出発点です。以下で説明する曲線は概念的なもので、すべての実験で同じ形になるとは限りません。
誤差曲線で見る二重降下現象
まず、横軸を「モデル容量」、縦軸を「未知のデータへの誤差」として考えます。モデル容量とは、モデルがどれほど多様な関係やパターンを表現できるかという能力です。ニューラルネットワークでは層の幅や深さ、パラメータ数が関係しますが、実際に学習できる内容は構造や学習方法にも左右されます。
縦軸の誤差は低いほど良い指標です。例えば画像分類なら、学習に使っていない画像を犬や猫に分類したときの間違いの割合を使えます。未知のデータ全体に対する誤差を「汎化誤差」といい、手元の検証データやテストデータで測る「評価誤差」は、その推定に使う値です。
モデル規模による二重降下は、次の三つの段階で捉えられます。
- 容量が小さい領域での最初の降下:単純すぎるモデルは、必要な特徴を捉えきれず、訓練データにも十分に適合できません。容量を増やすと表現できる関係が増え、訓練誤差と評価誤差が下がっていきます。
- 補間しきい値付近での上昇:訓練データに誤りなく適合できる境界に近づくと、個々のデータやノイズへの感度が高くなり、評価誤差が増える場合があります。訓練誤差が小さくても、未知のデータでの成績が良いとは限らない領域です。
- さらに容量を増やした領域での第二の降下:訓練データに適合するために必要な規模を超え、パラメータに余裕がある領域では、評価誤差が再び下がることがあります。これが二つ目の降下です。
ここで重要なのは、訓練誤差まで同じ山を描く必要はないことです。典型的なモデル規模方向の二重降下では、訓練誤差は容量の増加につれて下がり、ほぼゼロになった後も低い状態を保ちます。その間に、評価誤差が上昇してから再び低下します。
また、評価値が数回上下しただけで二重降下とは判断できません。評価データが少ないことや、初期値・データの並び順の違いでも値は揺れます。条件をそろえた複数のモデルを比較し、再現性のある傾向かどうかを確かめる必要があります。第二の降下が見えても、最初の谷より必ず低い誤差に到達するわけではありません。
補間しきい値付近で誤差が増える理由
補間とは、訓練データに誤差なく適合することです。例えば回帰では、訓練用の各入力について、予測値が観測値と一致する状態を指します。その状態を達成できるようになるモデル容量の境界を「補間しきい値」と呼びます。
分類では、すべての訓練例を正しいクラスに分類できることを補間の目安にする場合があります。ただし、「分類誤りがゼロ」と「学習に使う損失がゼロ」は同じではありません。正解のクラスを選べていても、そのクラスに割り当てる確率によって、交差エントロピーなどの損失は残ります。実験を見る際には、どの指標で補間を判定しているかを確認します。
境界付近では、限られた自由度で訓練例の一つ一つに合わせるため、データの小さな違いに予測が大きく反応する場合があります。例えば本来なめらかな関係に測定誤差が混じっていると、そのずれまで無理に再現することで、訓練点の間にある未知の入力への予測が不安定になることがあります。画像分類でも、誤ったラベルを含む訓練例への適合が、未知の画像への予測を悪化させる場合があります。
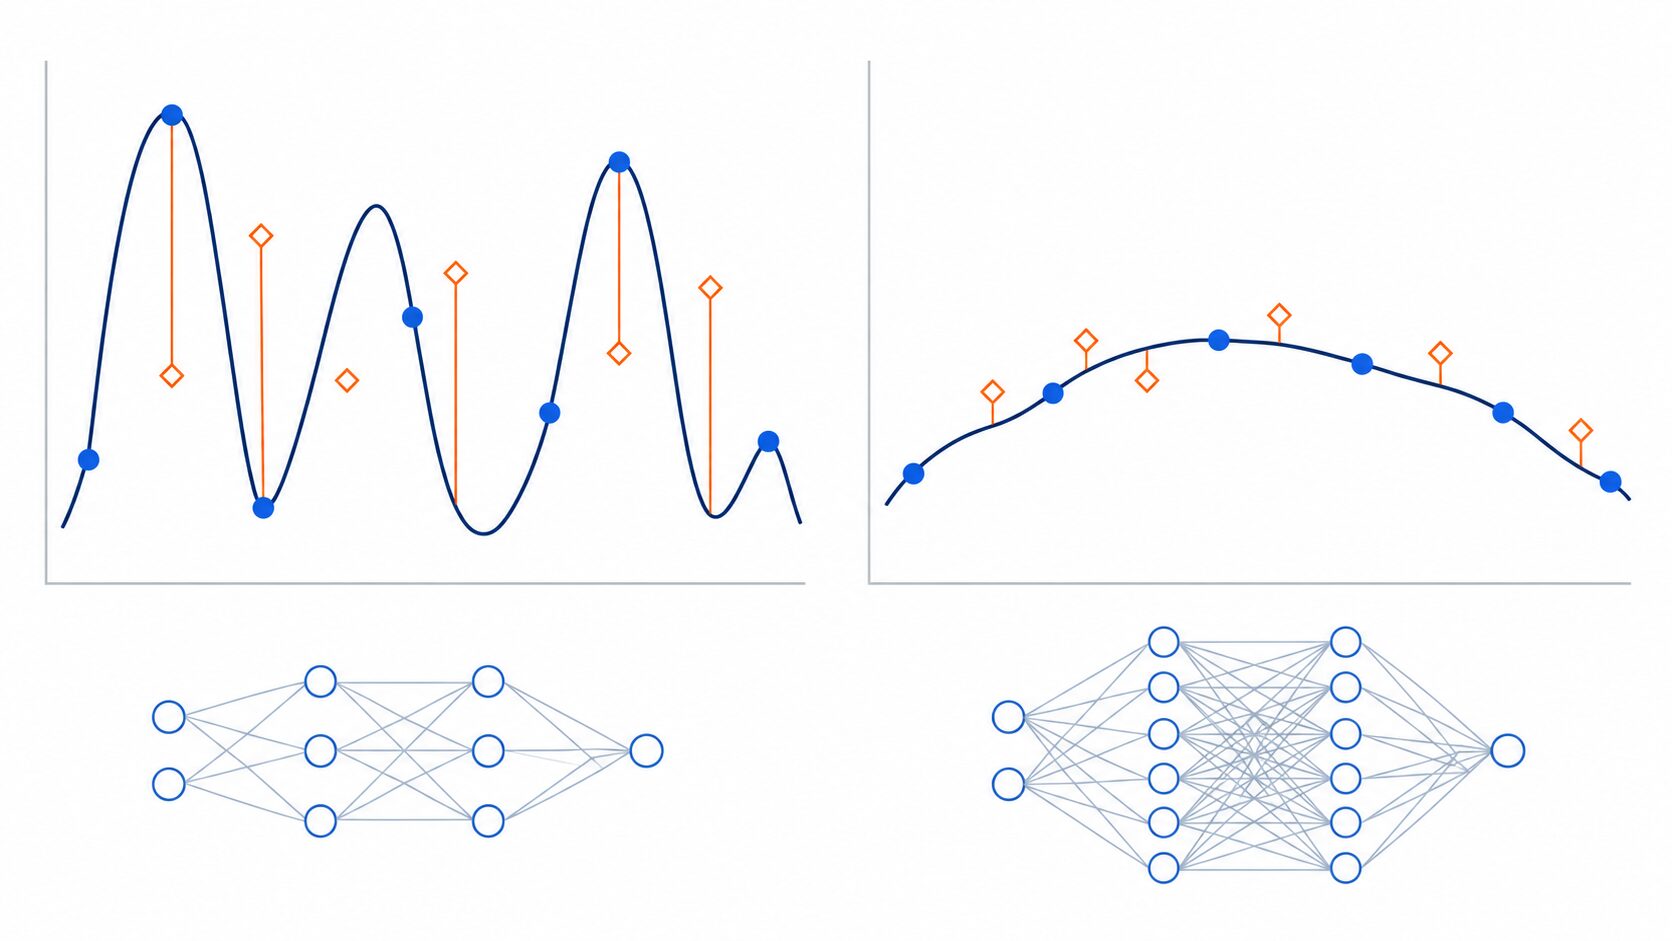
訓練点をすべて通る予測の仕方にも、未知の点では大きく外れるものと、比較的良い予測をするものがあります。したがって、訓練データへの適合だけでは、どちらの解が得られたか判断できません。
さらに容量を増やすと、同じ訓練データに適合する解の選択肢が増えます。その中で、初期値や最適化手法によっては、未知のデータにも対応しやすい解が選ばれる場合があります。明示的な罰則を設けなくても学習方法が特定の性質を持つ解を選びやすくする働きは、暗黙の正則化と呼ばれます。単純な線形モデルでは、条件によって重みの大きさが小さい解を選ぶ性質などから、第二の降下を説明できます。
ただし、これを「大きくなるとモデルが問題の解き方を理解する」と捉えると、発生条件が見えなくなります。汎化の改善には、データの性質と、どの解を学習が選ぶかの両方が関わります。また、パラメータ数と訓練標本数が一致する点は、一部の単純なモデルでは境界の目安になりますが、深層学習全般に使える判定式ではありません。
過学習とバイアス・分散の関係
古典的な説明では、モデル容量を増やすと評価誤差はU字型に変化します。小さすぎるモデルでは学習不足になり、適度な容量で誤差が小さくなりますが、さらに大きくすると訓練データの偶然の特徴まで拾い、評価誤差が増えるという見方です。二重降下は、その上昇の先まで容量を増やしたとき、再び改善する領域があり得ることを示します。
この関係を考えるための言葉が「バイアス」と「分散」です。バイアスは、モデルや学習方法の制約によって生じる予測の系統的なずれを指します。分散は、訓練データを取り替えたときに予測がどれだけ変わるかを表します。例えば、曲線的な関係を直線だけで捉えようとすればずれが残りやすく、一部の訓練例に強く左右される学習方法では予測のばらつきが大きくなります。
次の表は、二重降下が見られる場合の典型的な関係です。容量を増やす比較では、データや学習条件をそろえることが前提になります。
| モデル容量の領域 | 訓練誤差 | 汎化誤差の傾向 | 考え方の要点 |
|---|---|---|---|
| 容量が小さい | 大きくなりやすい | 大きくなりやすい | 必要な関係を表現できず、学習不足になりやすい |
| 容量を増やす初期の領域 | 下がる傾向 | 最初の低下が見られる | 表現力の不足が緩和される |
| 補間しきい値付近 | ゼロまたはそれに近づく | 上昇してピークになる場合がある | 訓練例への感度が高まり、未知のデータで誤りやすくなる |
| 補間に必要な容量を十分に超えた領域 | 低い状態を保つ | 再び低下する場合がある | データに適合する解の中から、汎化しやすい解が選ばれることがある |
過学習は、訓練データにはよく適合しているのに、未知のデータではその良さが保たれない状態を指します。一方、二重降下は、容量などを変えたときの誤差曲線の形を指す言葉です。両者は互いに排他的な現象ではなく、説明している対象が異なります。二重降下の途中に、過学習が問題になる領域が含まれることもあります。
二重降下が観測されても、バイアスと分散を分けて考える理論そのものが否定されるわけではありません。「容量を増やすほど分散が一方的に増える」という単純な想定では、広い範囲の挙動を捉えきれないということです。過剰なパラメータを持つ領域も含め、使うモデルと学習方法に応じて関係を考える必要があります。
モデル規模・学習時間・データ量の三つの軸
二重降下は、モデルの規模を変えた場合だけでなく、学習時間や訓練標本数を変えた場合にも観測されることがあります。ただし、横軸が変われば比較している実験も変わります。「何を増やし、何を固定したのか」を分けて読むことが、混乱を避けるポイントです。
| 比較する軸 | 変える量 | 主に固定する条件 | 見るべき点 |
|---|---|---|---|
| モデル規模 | 層の幅など、モデル容量に関わる設定 | 訓練データ、評価データ、正則化や学習手順の基本条件 | どの規模で訓練誤差がほぼゼロになり、評価誤差がどう変わるか |
| 学習時間 | 学習エポック数や更新回数 | モデル構造、訓練データ、評価データ、学習率を変える手順など | 同じモデルの学習途中で、評価誤差が悪化した後に回復するか |
| 訓練データ量 | 同じ分布から得た訓練標本の数 | モデル構造、評価データ、データの作り方、基本的な学習条件 | データ量とモデル容量の関係が変わり、補間の境界に近づいていないか |
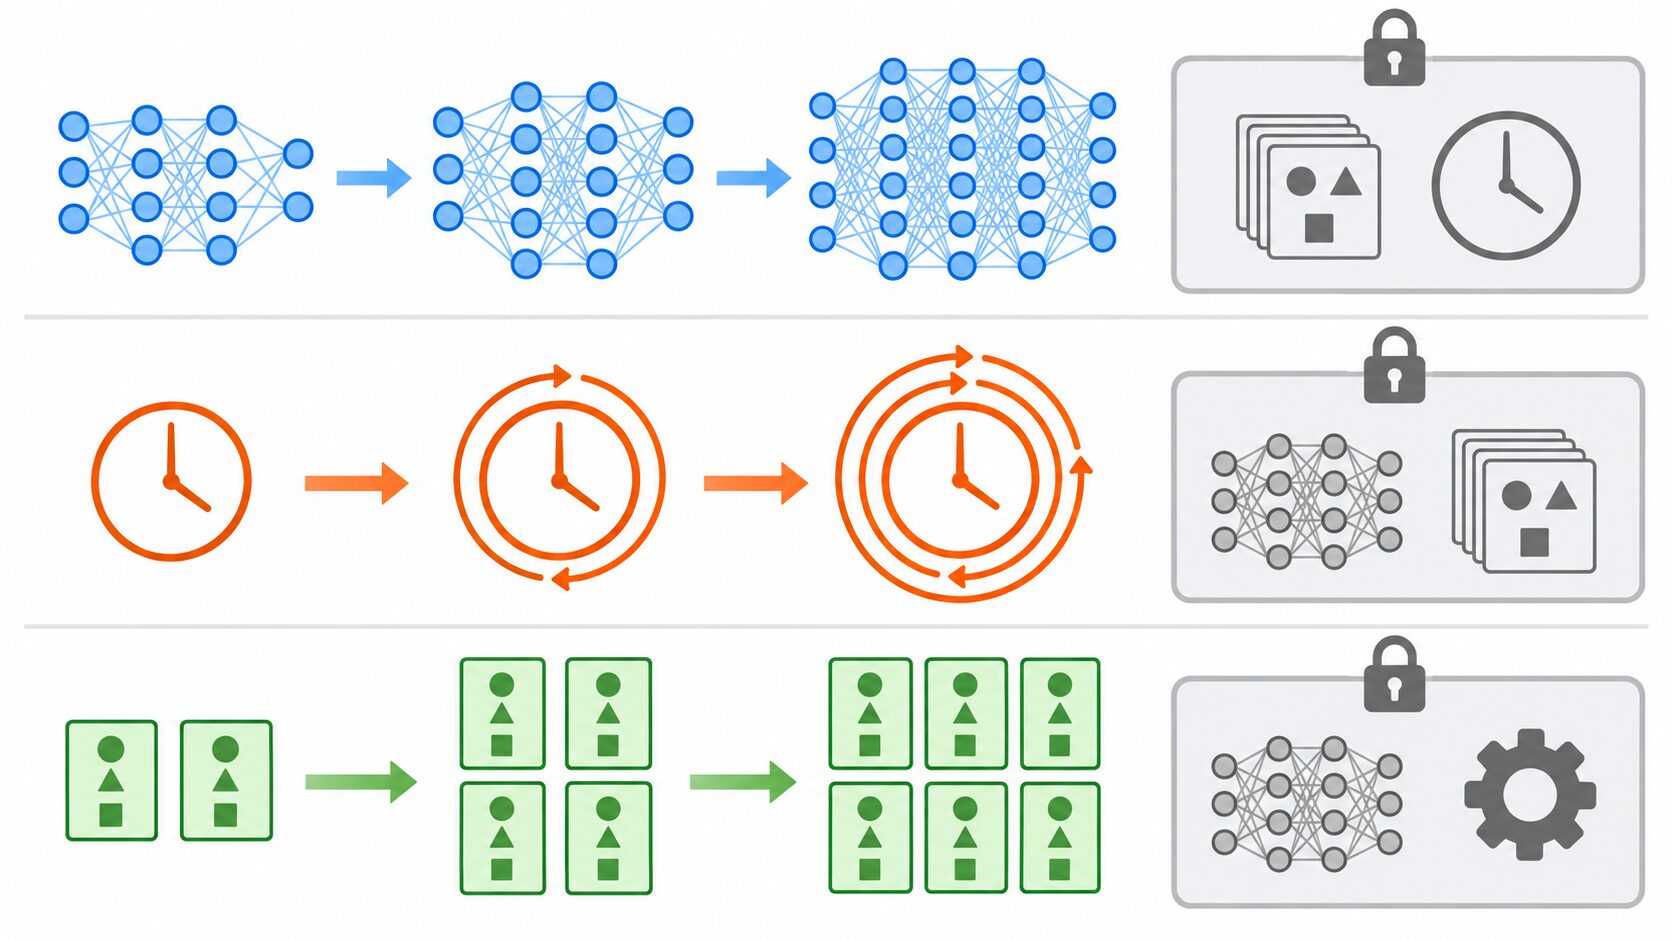
学習時間を横軸にする場合、エポックとは訓練データ全体を一巡する単位です。固定したモデルを学習させると、評価誤差が最初に下がり、その後上がり、長く学習することで再び下がる場合があります。これは、異なる規模のモデルを並べる実験とは異なり、一つのモデルの学習経過を追うものです。モデル規模の図をそのまま時間の図に読み替えることはできません。
また、評価誤差が悪化した時点から学習を続ければ、必ず第二の降下が現れるわけではありません。高い誤差のままになる場合もあり、学習率の変更など別の要因による改善も考えられます。長く学習したときの結果と、途中の良い時点で学習を止めた結果を、同じ検証データで比べることが必要です。
データ量を変える場合は、同じ分布から標本を追加しても、一時的に評価誤差が悪化することがあります。固定したモデルに対して訓練例が増えると、適合しなければならない条件も増えます。その結果、補間に十分な余裕があった状態から、ちょうど適合できる境界付近へ関係が変わり、予測が不安定になる場合があります。
これは「データが多すぎると雑音が増え、モデルが混乱する」という一般則ではありません。追加データに誤ったラベルが多い場合や、撮影条件・対象の種類が変わった場合の性能低下とも区別します。同じエポック数でも標本数が増えると更新回数が増えるため、データ量の実験では学習量の変化にも注意が必要です。三つの軸すべてで同じ形の二重降下が現れるとは限らず、データを減らすことが一般的な改善策になるわけでもありません。
画像分類を例に発生条件を考える
犬と猫の画像を分類する実験を考えてみましょう。同じ訓練画像と検証画像を使い、畳み込みニューラルネットワーク(CNN)や残差ネットワーク(ResNet)の層の幅を段階的に変えます。CNNの幅を増やす例としては、各層で使う特徴の種類に関わるチャネル数を増やす方法があります。層の数を変えなくても、幅を増やすことでモデル容量を変えられます。
次の小・中・大の比較は、仕組みを考えるための仮想例です。特定のデータセットで測定した結果や、必ず成立する規模の対応を示すものではありません。
- 小さいモデルでは、画像の違いを捉える能力が足りず、訓練画像でも間違いが残ります。幅を少し増やすことで必要な特徴を学習できるようになれば、検証画像への誤差も下がります。
- 中くらいのモデルが補間しきい値付近にある場合、訓練画像にはほぼすべて正解しても、個々の画像の特徴や誤ったラベルに強く影響され、検証画像への誤差が増えることがあります。
- 十分に大きいモデルでは、訓練画像に適合する解の選択肢が広がります。データと学習方法の組み合わせによっては、訓練誤差を低く保ったまま、検証画像への誤差が再び下がります。
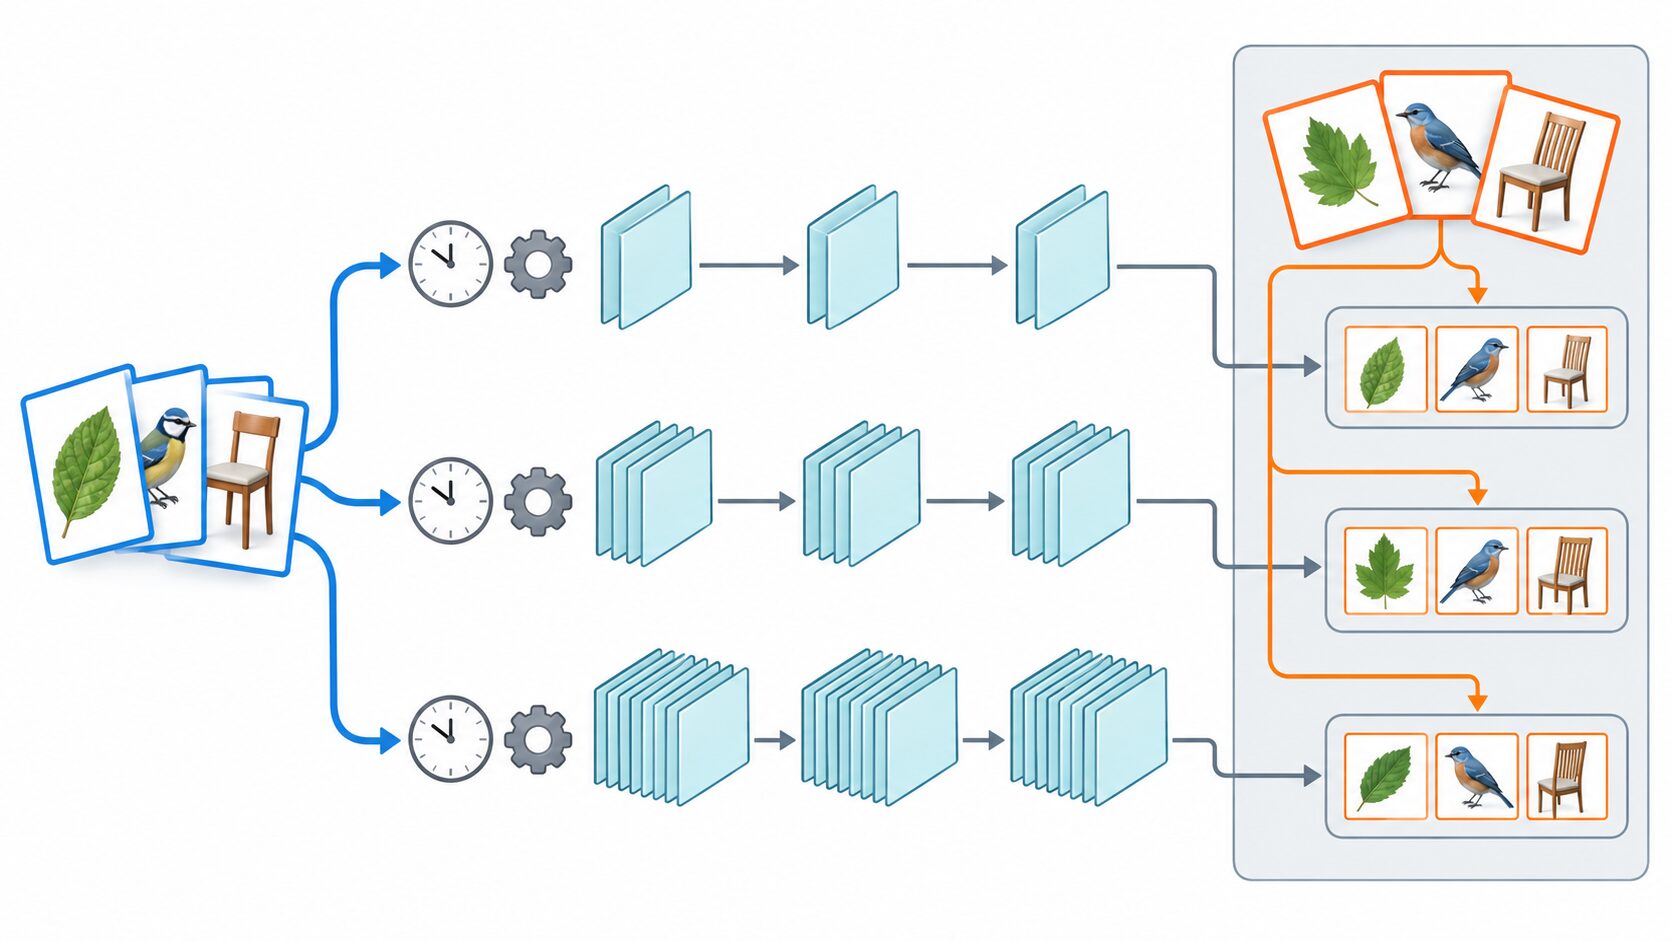
この比較では、画像の分け方、前処理、データ拡張、正則化、学習率の設定などをそろえて記録します。大きいモデルだけ学習が終わっていない場合、単に学習不足による悪化を見ている可能性もあります。訓練誤差が十分に下がったかを併せて確かめることで、容量の影響を判断しやすくなります。
ラベルノイズも曲線に影響します。例えば一部の犬の画像に猫というラベルが付いていると、それにまで適合することが汎化を損ね、補間付近のピークを目立たせる場合があります。一方で、ノイズだけが発生条件ではありません。データの特徴、標本数、正則化の強さ、最適化の進み方も関係します。
二重降下にはTransformerでの観測例もあり、CNNやResNetに固有の現象ではありません。ただし、特定の構造を使うだけで発生が決まるわけでもありません。「層が深い」「大量のデータを使う」「構造が複雑」という条件だけを原因にせず、容量とデータ、学習条件の組み合わせを見ることが大切です。
モデル選択と学習での向き合い方
二重降下の知識が役立つのは、性能が悪化した理由を考えるときと、比較実験を設計するときです。あるモデルを一段階大きくして結果が悪くなったとしても、その一点だけでは、より大きなモデルもすべて悪いとは判断できません。同様に、途中の評価誤差が上がったことだけで、長い学習の結果まで決まるわけではありません。
実務では、次の順序で条件を比べると、結果の解釈とモデル選択を結びつけやすくなります。
- 訓練・検証・テストの役割を分ける:訓練データで重みを学習し、検証データでモデル規模や学習の停止時点などを選びます。最終評価には、条件選択で使っていないテストデータを使います。
- モデル容量と学習時間を分けて比較する:まず同じデータで複数の容量を試し、それぞれの訓練誤差と検証誤差の推移を記録します。一つの規模・一つの時点だけに依存した判断を避けます。
- 正則化などの条件を比較する:基準となる実験を用意し、重み減衰の強さ、データ拡張、早期終了などの効果を確認します。複数の条件を同時に変えると原因が分かりにくいため、比較の目的を明確にします。
- 複数回の試行でばらつきを見る:初期値やデータの並び順を変えて学習し、改善や悪化が一度きりの偶然ではないか確かめます。小さな差であれば、平均的な成績だけでなく結果の広がりも判断材料にします。
- 計算コストを含めて選ぶ:検証結果を使い、性能の差と学習時間、メモリ、運用時の推論速度を比較します。選択を終えてから、未使用のテストデータで最終的な性能を確認します。
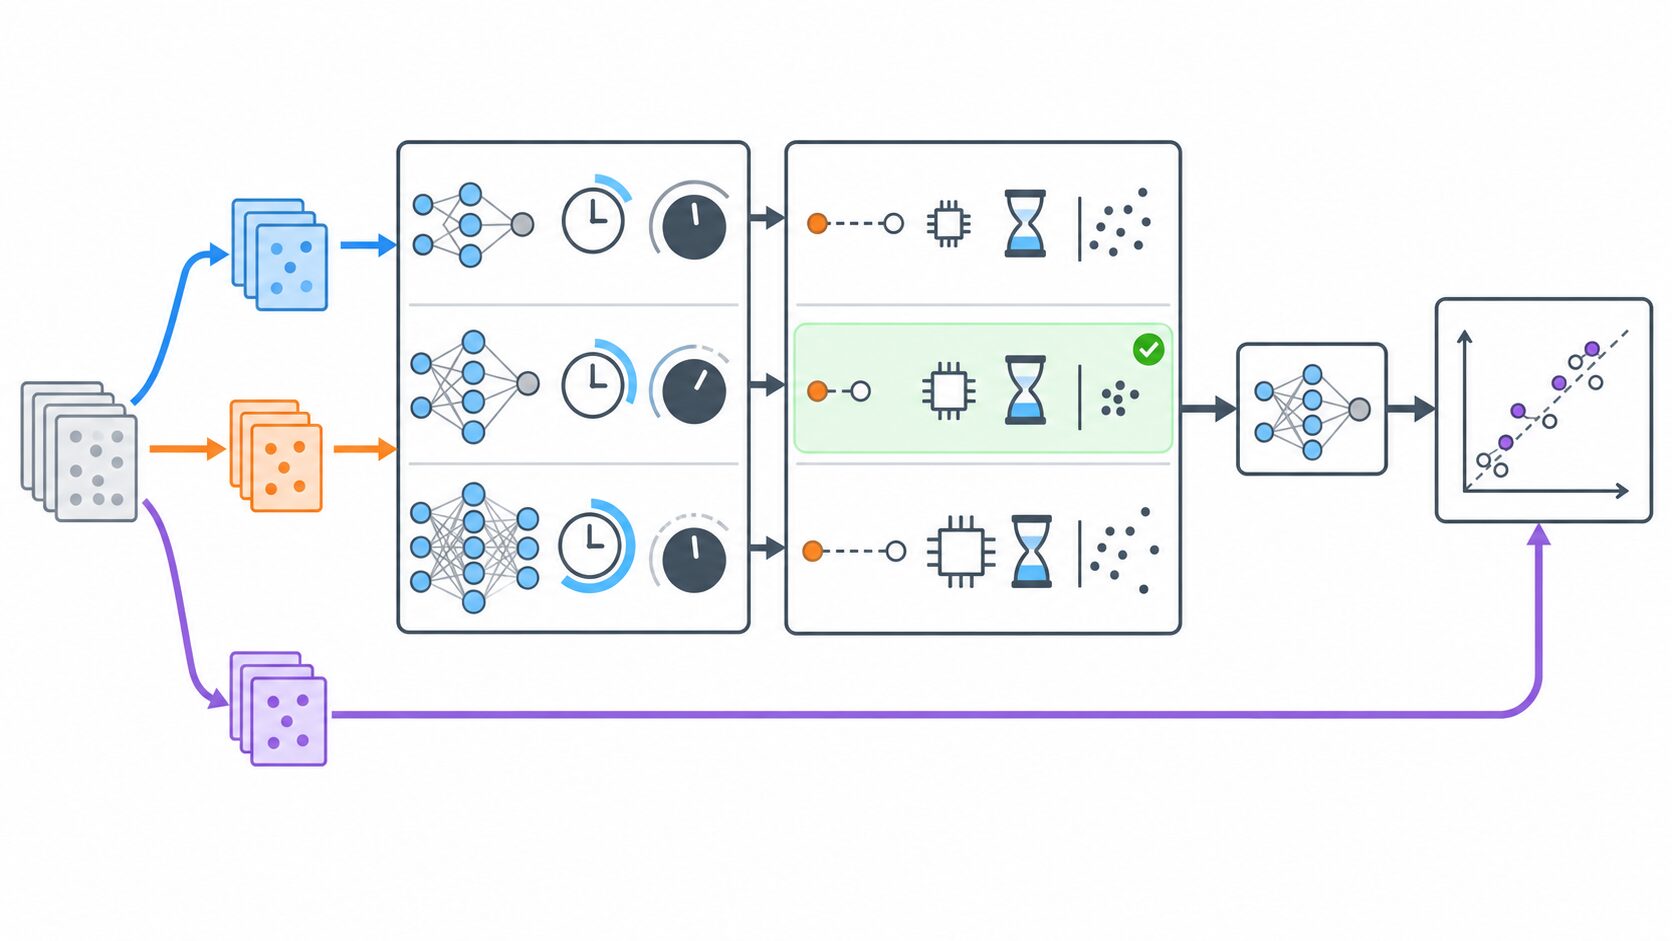
正則化の一つである重み減衰は、重みが過度に大きくなることを抑える働きを持ちます。データ拡張は、画像の切り出しなど、正解ラベルを保つ変換を加えて学習例を増やす工夫です。早期終了は、検証結果を見て学習を途中で止め、過学習を抑える方法です。いずれも誤差のピークを小さくする場合がありますが、効果はデータや設定によって変わります。
特に早期終了には、良い性能を少ない計算で得られる可能性がある一方、学習時間方向の第二の降下に到達する前に止める可能性もあります。どちらが有利かは実験で判断します。十分な予算がある場合には長い学習も比較し、その途中で得られた良い状態を保存しておくと、停止時点の違いを検討できます。
第二の降下を待つこと自体を目標にする必要はありません。小さいモデルや早期終了で必要な性能が得られるなら、その方が運用に適することもあります。逆に、追加の計算で十分な改善が得られるなら、大きいモデルや長い学習を選ぶ根拠になります。二重降下は、無条件の大規模化や訓練データの削減を勧める考え方ではなく、比較する範囲と判断材料を広げるための知識です。
分かっていることと残る研究課題
二重降下は、すべてが未解明の現象ではありません。単純化した線形回帰や特徴量を使うモデルなどでは、補間付近でノイズの影響が大きくなる仕組みや、過剰なパラメータを持つ領域で誤差が再び下がる条件を、理論的に調べられます。訓練データを完全に再現するモデルでも、一定の条件では未知のデータに良い予測ができることが理解されています。
一方、実際の深層学習では、特徴の表現自体も学習によって変わります。モデル容量、データの構造、ラベルノイズ、正則化、最適化の設定が同時に影響するため、単純なモデルでの説明をそのまますべてのネットワークへ当てはめることはできません。ある実験で第二の降下が見えても、別のデータや学習条件で同じ結果になる保証はありません。
研究上の課題には、どの条件でピークが現れるかを事前に予測すること、学習中に使える容量の適切な指標を見つけること、正則化などがピークや第二の降下へ与える影響を明らかにすることがあります。さらに、追加計算に見合う改善が得られる条件や、少ない試行で安定した設定を選ぶ方法も重要です。これらは、単に曲線の形を説明するだけでなく、学習とモデル選択を効率化することにつながります。
二重降下から学べるのは、「大きいほど常に良い」「大きいと必ず過学習する」というどちらの断定でも、汎化性能を十分に説明できないということです。訓練誤差と評価誤差を分け、何を変えた実験なのかを確かめ、データと学習条件を含めて判断する。その姿勢が、現象を理解し、実際のモデル選択に生かす基礎になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月3日 | 補間付近の誤差増大と、規模・時間・データ量別の見方を補足 |