

AIの初心者
「事前学習」って、何を事前に学ぶのですか?学習済みのAIを使うこととは違うのでしょうか?

AI専門家
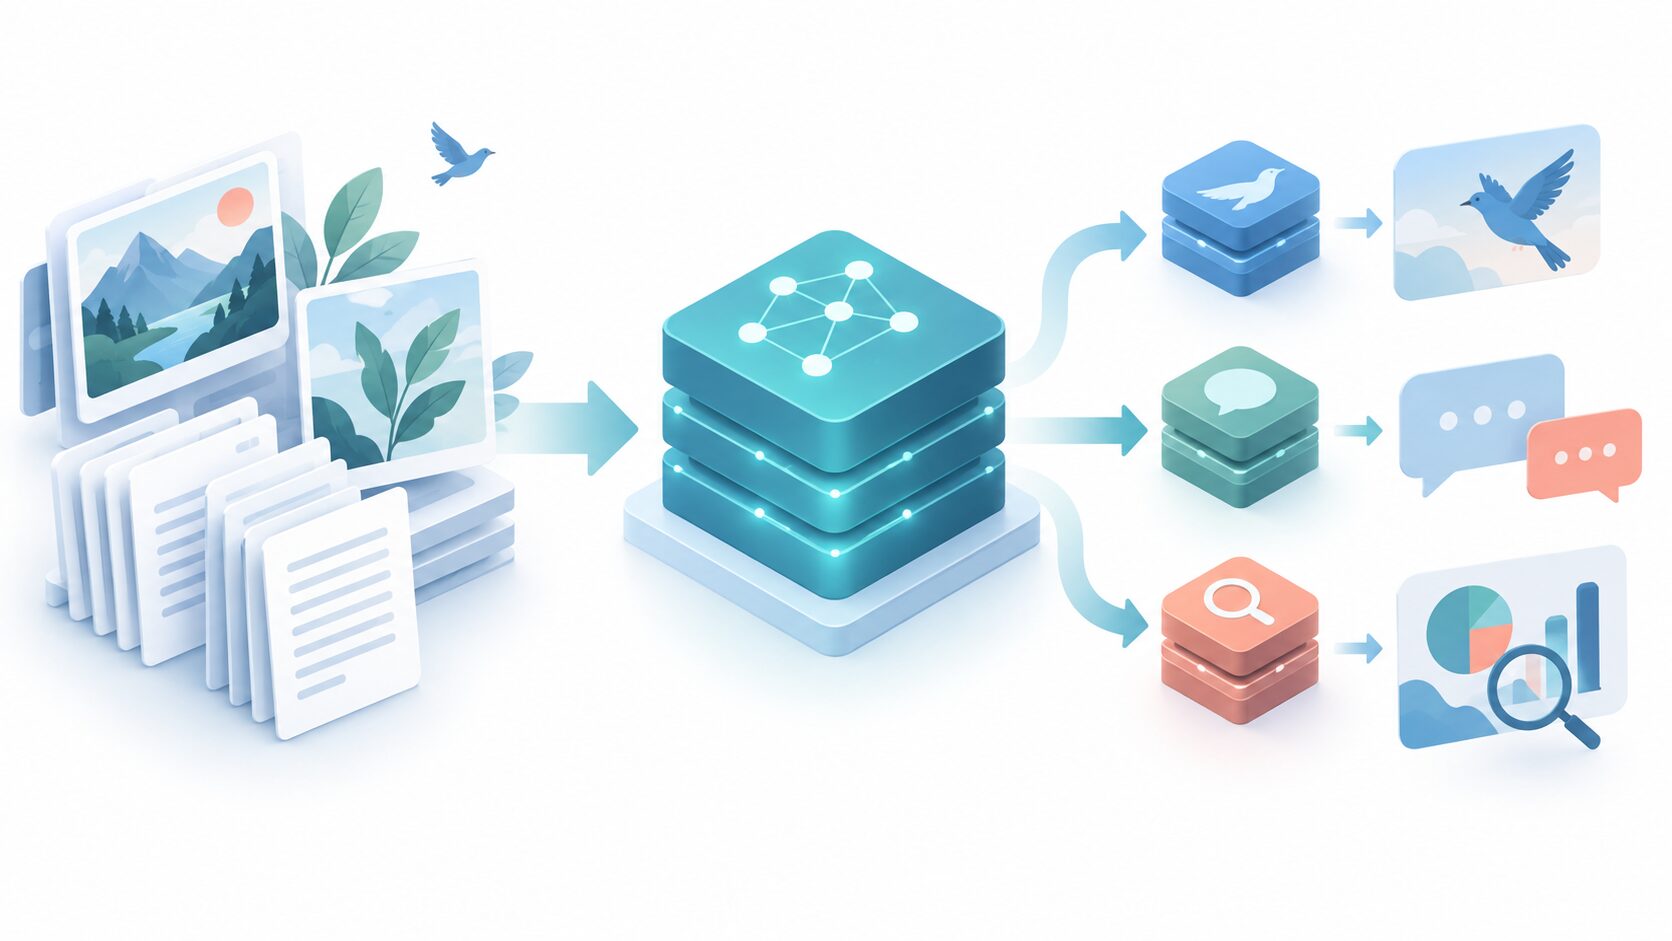
事前学習は、あとでさまざまな課題に役立てられるように、モデルに基礎となる特徴を先に学ばせる段階のことだよ。例えば、多くの画像から輪郭や模様などを学ばせておくんだ。その学習済みのモデルを使えば、鳥の種類を見分けるモデルを作るときにも、画像の特徴を捉える力を土台にできるよ。
AIの初心者
基礎を学ぶ段階と、その基礎を別の課題に使う段階があるのですね。学習済みなら、どんな課題でもうまくいきますか?
AI専門家
必ずうまくいくわけではないよ。学んだ特徴を別の課題に活かすことは転移学習と呼ぶけれど、元のデータと新しいデータの性質が違うと、十分な効果が出ないこともあるんだ。目的に合うモデルを選び、学習に使っていないデータで確かめることが大切だよ。
AIのモデルを作るたびに、すべてをゼロから学習させる必要はありません。大量のデータから基礎となる特徴を学んだ「事前学習済みモデル」を活用すると、独自の課題に必要なデータや学習時間を抑えられる場合があります。
ただし、事前学習は基礎を学ぶ段階であり、学習済みモデルを別の課題に再利用すること自体とは区別します。この記事では、事前学習の意味と仕組み、転移学習・ファインチューニングとの違い、モデル構築での使い方と注意点を、鳥の分類や文章処理の例で説明します。
事前学習とは?モデルの基礎をつくる学習段階
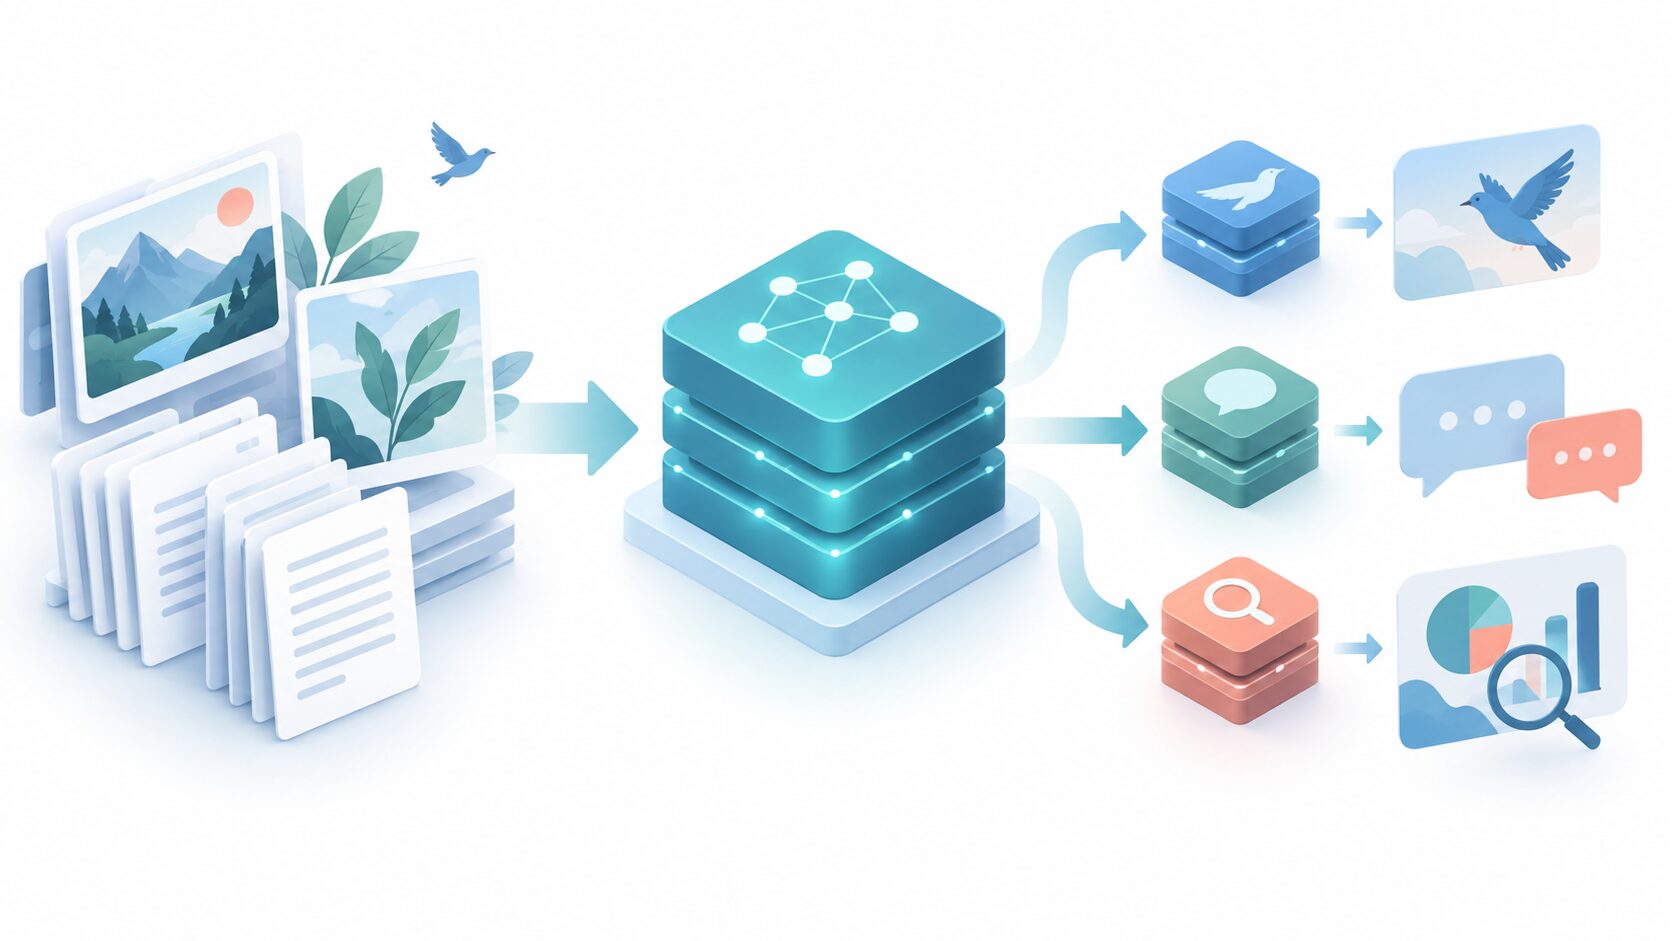
事前学習(Pre-training)とは、後の課題に役立つ特徴やパターンを、あらかじめデータからモデルに学習させることです。多くの場合、画像や文章などの大規模なデータを使います。この段階を終え、学習によって調整された内部の値を持つモデルを「事前学習済みモデル」と呼びます。
ここでいう「特徴」は、予測や分類の手がかりになる情報です。画像なら輪郭、質感、形の組み合わせなど、文章なら単語の並びや文脈に応じた関係などが含まれます。モデルは、こうした手がかりを扱えるように内部のパラメータを調整します。パラメータとは、入力に対する処理や出力を左右する数値で、ニューラルネットワークの「重み」などがその例です。
事前学習のあとに取り組む具体的な課題は「下流タスク」と呼ばれます。一般的な画像で学んだモデルにとっての鳥の種類の分類や、文章で学んだモデルにとっての問い合わせ内容の分類が該当します。学校で読み書きの基礎を身につけてから専門分野を学ぶ、と考えると、二つの段階の関係をつかみやすいでしょう。
注意したいのは、事前学習そのものが軽い処理とは限らない点です。大きなモデルを大量のデータで事前学習するには、多くの計算資源が必要になることがあります。個別のモデル開発を効率化できるのは、すでに行われた学習の成果を再利用し、用途に応じた調整へ集中できるからです。
事前学習の仕組み:データから特徴を学び、次の課題へつなぐ
モデルは、データを一度読むだけで能力を身につけるわけではありません。入力から予測を出し、学習目標に対するずれが小さくなるようにパラメータを繰り返し更新します。その過程で、さまざまな入力に共通する特徴を捉えるようになります。
事前学習には、正解ラベルを使う「教師あり学習」も、データ自体から学習用の課題を作る「自己教師あり学習」も使われます。例えば、画像に写る物体の種類を予測する学習は前者の例です。文章の一部を隠して補わせたり、続きに現れる語を予測させたりする学習は後者の例です。自己教師あり学習でも、何を予測し、どのずれを小さくするかという学習目標は必要です。
事前学習で得た能力を使うときの流れは、次のように考えられます。
- 基礎となる特徴を学ぶ:多様なデータを使い、画像や文章のパターンを捉えるモデルを作ります。公開された事前学習済みモデルを利用すれば、この工程を自分で実施せずに始められます。
- 目的の課題に適応させる:鳥の種類や問い合わせ区分など、必要な出力に合わせて分類部分を設けたり、対象データで追加学習したりします。
- 実際の用途で評価する:学習に使っていないデータでも期待した結果が得られるかを確認し、使える条件と苦手な条件を把握します。
事前学習の目標と、最終的な用途の目標は同じとは限りません。例えば、文章の続きを予測する学習だけで、社内問い合わせの区分や回答ルールまで身につくわけではありません。基礎能力をどのように用途へつなぐかが、モデル構築の重要な工程になります。
転移学習・ファインチューニングとの違い
事前学習、転移学習、ファインチューニングは関連していますが、説明している対象が異なります。事前学習は「土台を学ぶ段階」、転移学習は「学んだことを別の課題に活かす考え方」、ファインチューニングは「学習済みモデルを追加学習で調整する方法」です。
| 用語 | 意味・役割 | 鳥の分類での例 |
|---|---|---|
| 事前学習 | 後の課題に役立つ特徴を先に学ぶ | 多くの画像から物体の形や模様などを学ぶ |
| 転移学習 | あるデータや課題で得た学習成果を別の課題に活かす | 一般的な画像認識のモデルを鳥の分類へ転用する |
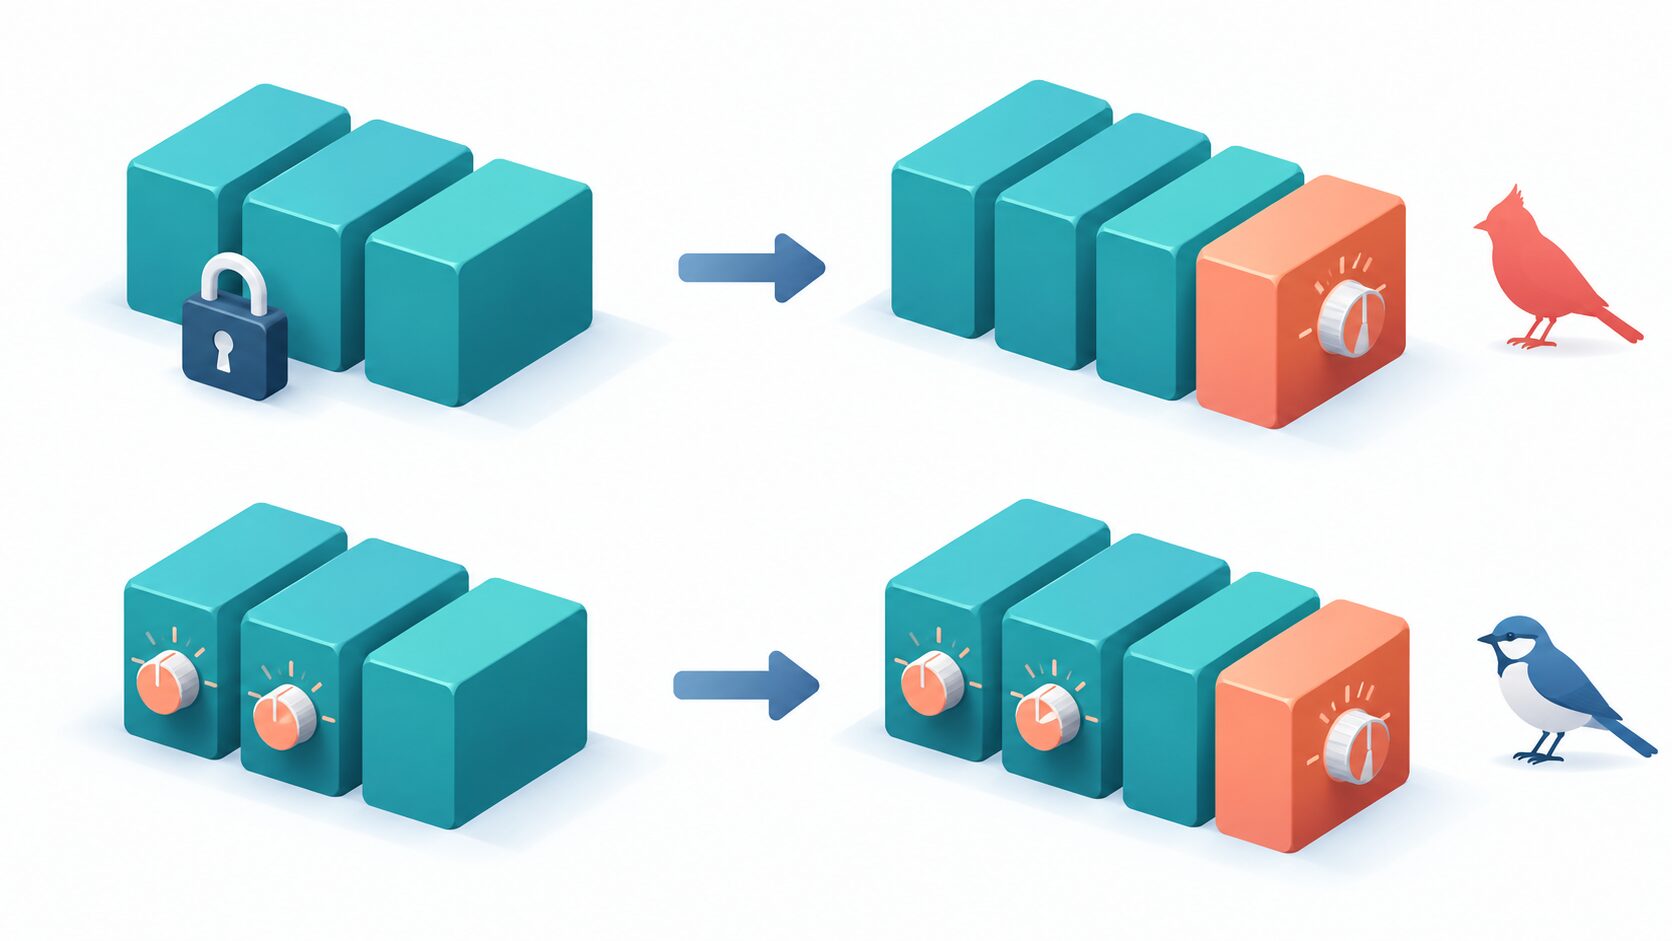
| 特徴抽出器としての利用 | 学習済み部分を固定し、取り出した特徴を新しい課題に使う | 画像の特徴を取り出す部分は変えず、鳥の種類を判定する分類部分を学習する |
| ファインチューニング | 学習済みパラメータの一部または全体を、追加データで調整する | 鳥の画像を使い、分類部分とともに画像の特徴を捉える部分も調整する |
学習済み部分を更新しないことを「凍結」といいます。元のモデルの最後の分類層を、必要な鳥の種類数に合うものへ置き換え、その新しい部分だけを学習する方法が一例です。土台のパラメータを更新しないため、調整する範囲を小さくできます。
一方、撮影条件や見分けたい特徴に合わせて土台も調整したい場合には、凍結していた一部を更新対象にするなどのファインチューニングを検討します。ただし、更新する範囲を広げれば必ず精度が上がるわけではありません。データが少ないと、手元の画像だけに合わせすぎる可能性もあります。
資料によっては、分類層だけを学習する方法を狭い意味の「転移学習」と呼び、ファインチューニングと並べて説明することもあります。広い意味では、ファインチューニングも転移学習を実現する方法の一つです。名称に加えて、学習済み部分のどこを固定し、どこを更新するのかを確認すると混乱を防げます。
事前学習済みモデルを使うメリット
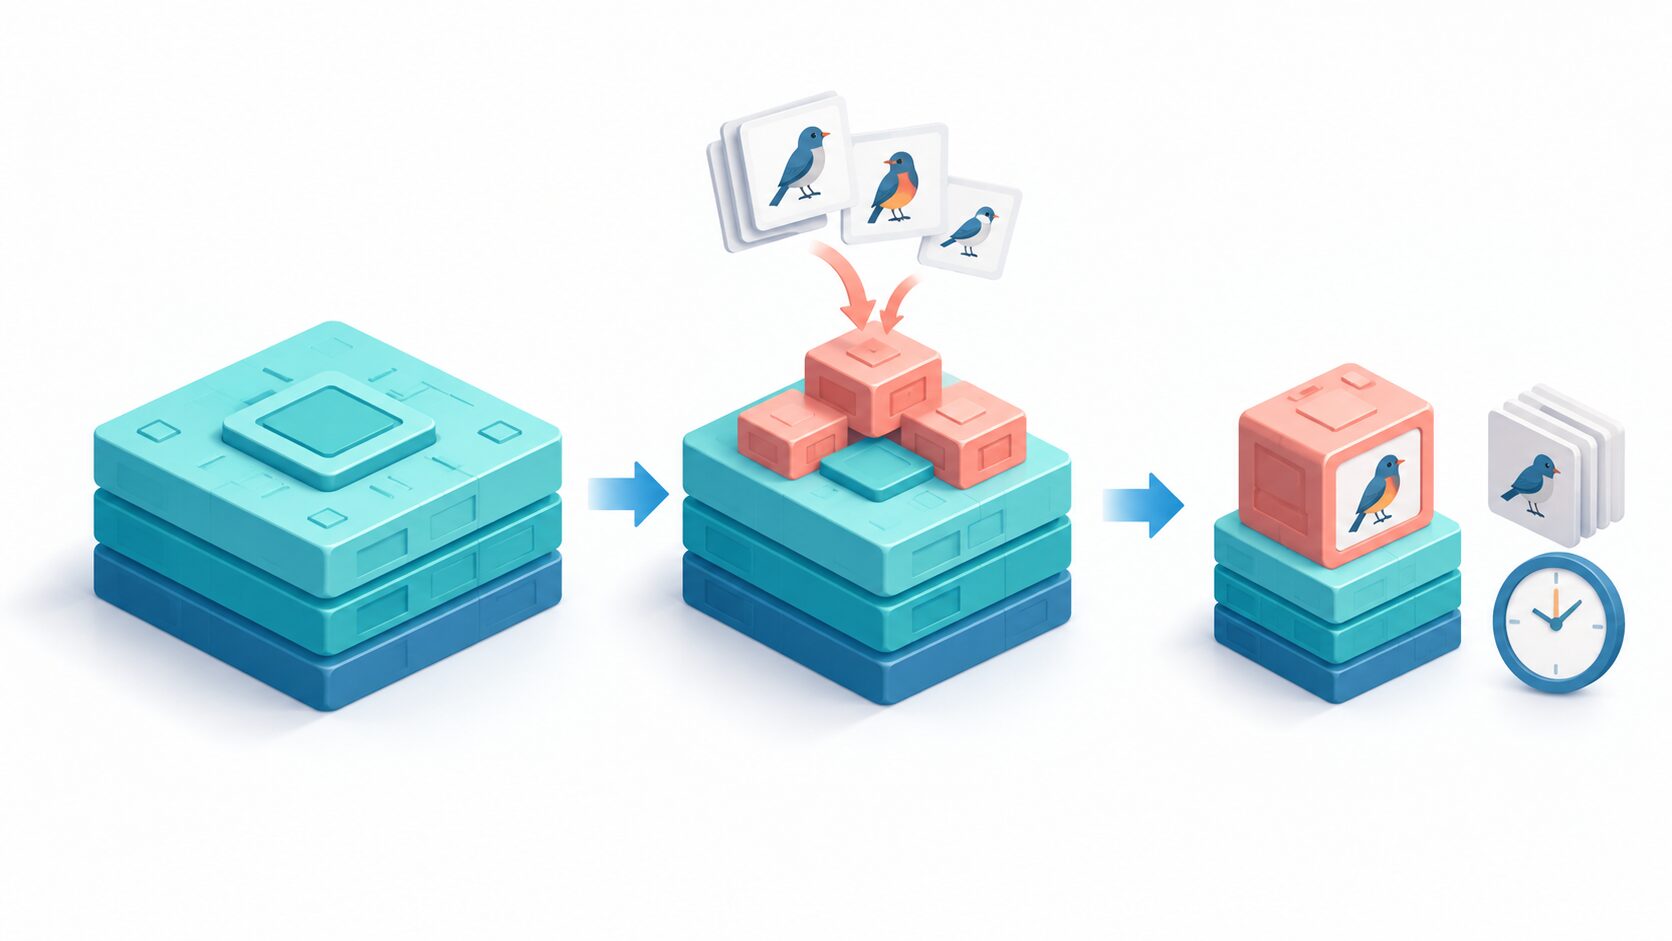
事前学習済みモデルを使う主な利点は、データ、学習時間、性能の三つの面にあります。特に、独自の正解ラベル付きデータを大量に集めにくいときは、既存の特徴を活かして開発を始められることに価値があります。
- 用途ごとの学習データを抑えやすい:輪郭や形などを最初から学び直す必要が減り、対象の違いを学ぶことにデータを使えます。ただし、必要な量は課題の難しさやデータのばらつきによって変わります。
- 学習と試行錯誤を進めやすい:学習済みのパラメータを出発点にできるため、ゼロからの学習より短い学習で有用な結果を得られる場合があります。まず動く基準モデルを作り、課題を確認しやすくなります。
- 未知のデータへの対応を助ける:手元の少数の例だけでなく、多様なデータから得た特徴を使えるため、初めて見る入力にも対応しやすくなる可能性があります。この性質を汎化性能と呼びます。
例えば、手元に限られた鳥の画像しかない場合、ゼロから大きなモデルを学習すると、羽の特徴よりも背景の枝や空の色を覚えてしまうかもしれません。事前学習で得た画像の特徴は、そのような状況で有用な出発点になります。ただし、背景への依存や過学習を自動的に防いでくれるわけではなく、学習後の確認は欠かせません。
また、学習コストの削減と、モデルを使う際の処理コストは別です。大きな事前学習済みモデルは、追加学習が少なく済んでも、予測時に多くのメモリや処理時間を必要とする場合があります。精度だけでなく、実行環境や応答速度に合う大きさも考えて選びましょう。
事前学習の活用例:画像認識・自然言語処理・専門分野
画像認識では、一般的な物体の画像で学んだモデルを、鳥の種類の識別や製品の外観分類などへ転用できます。鳥の分類なら、共通する輪郭や模様の情報を使いながら、くちばしの形や羽の色などの違いを学ぶイメージです。実際には、人が特徴を一つずつ指定するのではなく、画像と正解ラベルを使って必要な判別を学習させます。
自然言語処理では、大量の文章で事前学習した言語モデルが、文章分類、翻訳、質問応答などの土台になります。例えば問い合わせを「配送」「返品」「操作方法」に分類したい場合、文章の表現の違いを捉える能力を活かし、自社で使う区分との対応を学ばせます。汎用的な文章のパターンを扱う力と、自社固有の業務ルールは分けて考える必要があります。
翻訳や質問応答についても、事前学習を終えれば必ず十分な性能になるわけではありません。対象言語、専門用語、回答の形式などに応じた調整や評価が必要です。特に、モデルが自然な文章を出せることと、その内容が正しいことは同じではありません。
医療画像は、専門分野への転用を考える例です。一般画像で得た特徴が役立つ場合もありますが、画像の種類、撮影方法、対象の特徴が異なるため、用途への適合性を確かめなければなりません。関連する医療画像で事前学習したモデルも比較候補になりますが、それだけで優劣や実用性は決まりません。研究上の画像分類の結果を、そのまま診断能力とみなすこともできません。
| 活用する課題 | 利用できる土台 | 個別に確かめること |
|---|---|---|
| 鳥の種類の分類 | 画像の輪郭や模様を捉える特徴 | 似た種類や異なる背景でも識別できるか |
| 問い合わせの分類 | 文章の表現や文脈の特徴 | 業務で使う区分や独自の言い回しに対応できるか |
| 翻訳・質問応答 | 言語のパターンや文脈を扱う能力 | 対象言語・専門用語・回答内容が用途に合うか |
| 医療画像の分析研究 | 一般画像または関連分野で学んだ特徴 | 撮影条件や対象の違いを含めて性能を評価できているか |
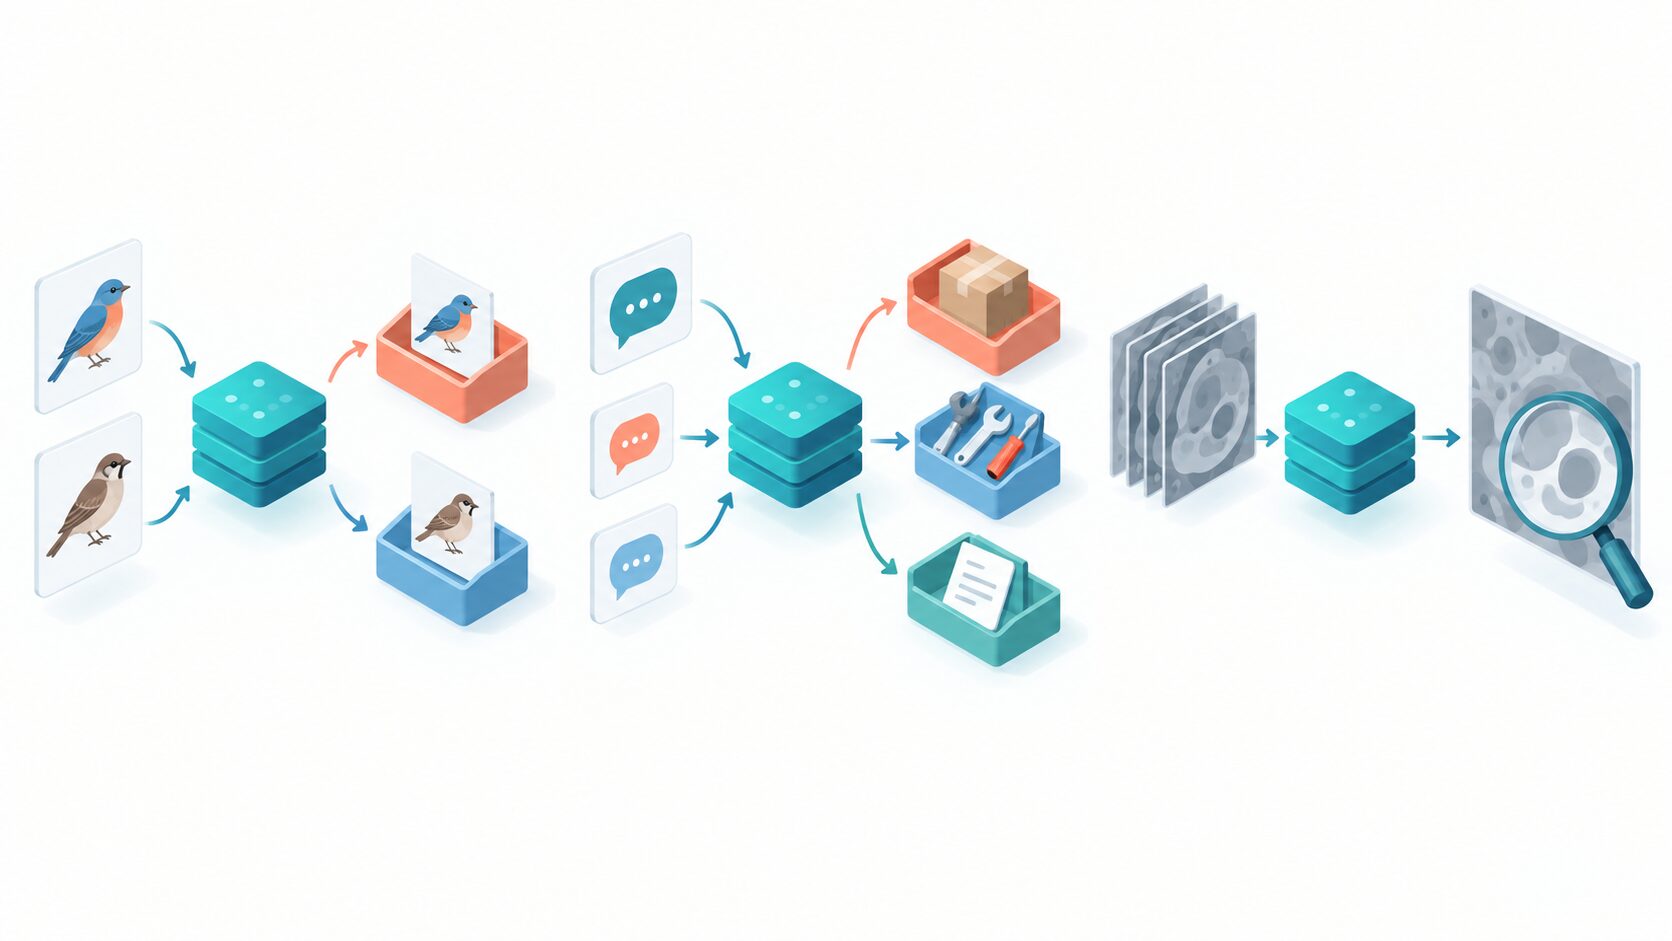
事前学習済みモデルを使ったモデル構築の手順
初めて取り組むなら、目的を一つに絞り、学習済み部分を固定した簡単な構成から始めると、どこに改善が必要かを調べやすくなります。鳥の画像分類を例に、準備から評価までの流れを見てみましょう。
- 目的と評価方法を決める:どの鳥を見分けるのか、どのような画像が入力されるのかを決めます。全体の正解率だけでなく、特定の種類だけ間違いが多くないかも確認できるようにします。種類ごとの画像数に偏りがあると、全体の正解率だけでは弱点を見落とすことがあります。
- データを用意して分割する:画像と正解ラベルを点検し、学習用、設定を調整するための検証用、最後に性能を確認するテスト用に分けます。同じ写真の加工版や同じ連写の似た画像が別々の集合に混ざると、実力以上によく見える可能性があります。
- モデルと前処理を合わせる:対象に近いデータで学んだモデルを候補にし、入力画像の大きさ、色の扱い、画素値の変換などを確認します。モデルが想定する前処理と違う入力を与えると、学習済みの特徴を十分に活かせないことがあります。
- 分類部分を学習する:学習済み部分を凍結し、必要な鳥の種類に対応した分類層を学習します。まずこの構成を基準にすると、データやラベルの不備も見つけやすくなります。
- 必要に応じて微調整する:検証用データで改善の余地が見えたら、学習済み部分の一部も更新します。一回の更新の大きさを決める学習率や学習回数を調整し、学習用だけで成績が伸びていないかを見ます。どの設定が適切かはデータとモデルによって異なります。
- 未使用のデータで最終確認する:設定が決まったら、調整に使わなかったテスト用データで評価します。誤分類した画像を見て、種類、明るさ、背景などに共通点がないかを調べます。
同じテスト用データの結果を見ながら何度も設定を選ぶと、そのデータに都合のよいモデルを選んでしまいます。検証用とテスト用の役割を分けるのは、まだ見ていない入力でどの程度使えるかを判断するためです。「学習が終わった」ことと「目的の環境で使える」ことを分けて評価しましょう。
事前学習の注意点:負の転移・過学習・データの偏り
最初に確認したいのは、事前学習のデータと転用先のデータの関係です。画像という形式が同じでも、日常の写真、顕微鏡画像、医療画像では、色や質感、重要な特徴が異なります。こうしたデータの性質や出現傾向の違いを、データ分布の違いと呼びます。
学習済みの知識を転用した結果、転用しない場合より性能が悪くなることを「負の転移」といいます。ただし、分野が違うだけで必ず負の転移になるわけではありません。一般画像のモデルと専門分野のモデルを同じ条件で評価し、必要に応じてゼロから学ぶ小さなモデルなどの基準とも比較すると、転用の効果を判断しやすくなります。
次に、少ないデータへの過学習に注意します。過学習とは、学習用データに合わせすぎて、新しいデータへの対応が悪くなる状態です。事前学習済みモデルでも起こり得ます。鳥の写真なら、特定の種類がいつも同じ背景で撮られていると、鳥そのものではなく背景を手がかりにすることがあります。学習用と検証用の結果の差を確認し、データの偏りや更新する範囲を見直します。
追加学習によって、元のモデルが持っていた能力が低下する場合もあります。新しい課題の成績だけを見ず、維持したい能力があるなら、それも評価対象に含めます。データの少ない状態で広範囲のパラメータを急激に変えるより、変更範囲や学習率を抑えた設定から比較すると、影響を把握しやすくなります。
また、事前学習データや追加学習データに偏りがあれば、その影響が出力に残る可能性があります。特定の撮影条件や表現だけでよい結果が出ていないか、実際の入力を代表するデータで確認してください。公開モデルを利用するときも、用途を説明した資料、入力条件、必要なメモリ、利用条件を確かめることが、継続して使えるモデル選びにつながります。
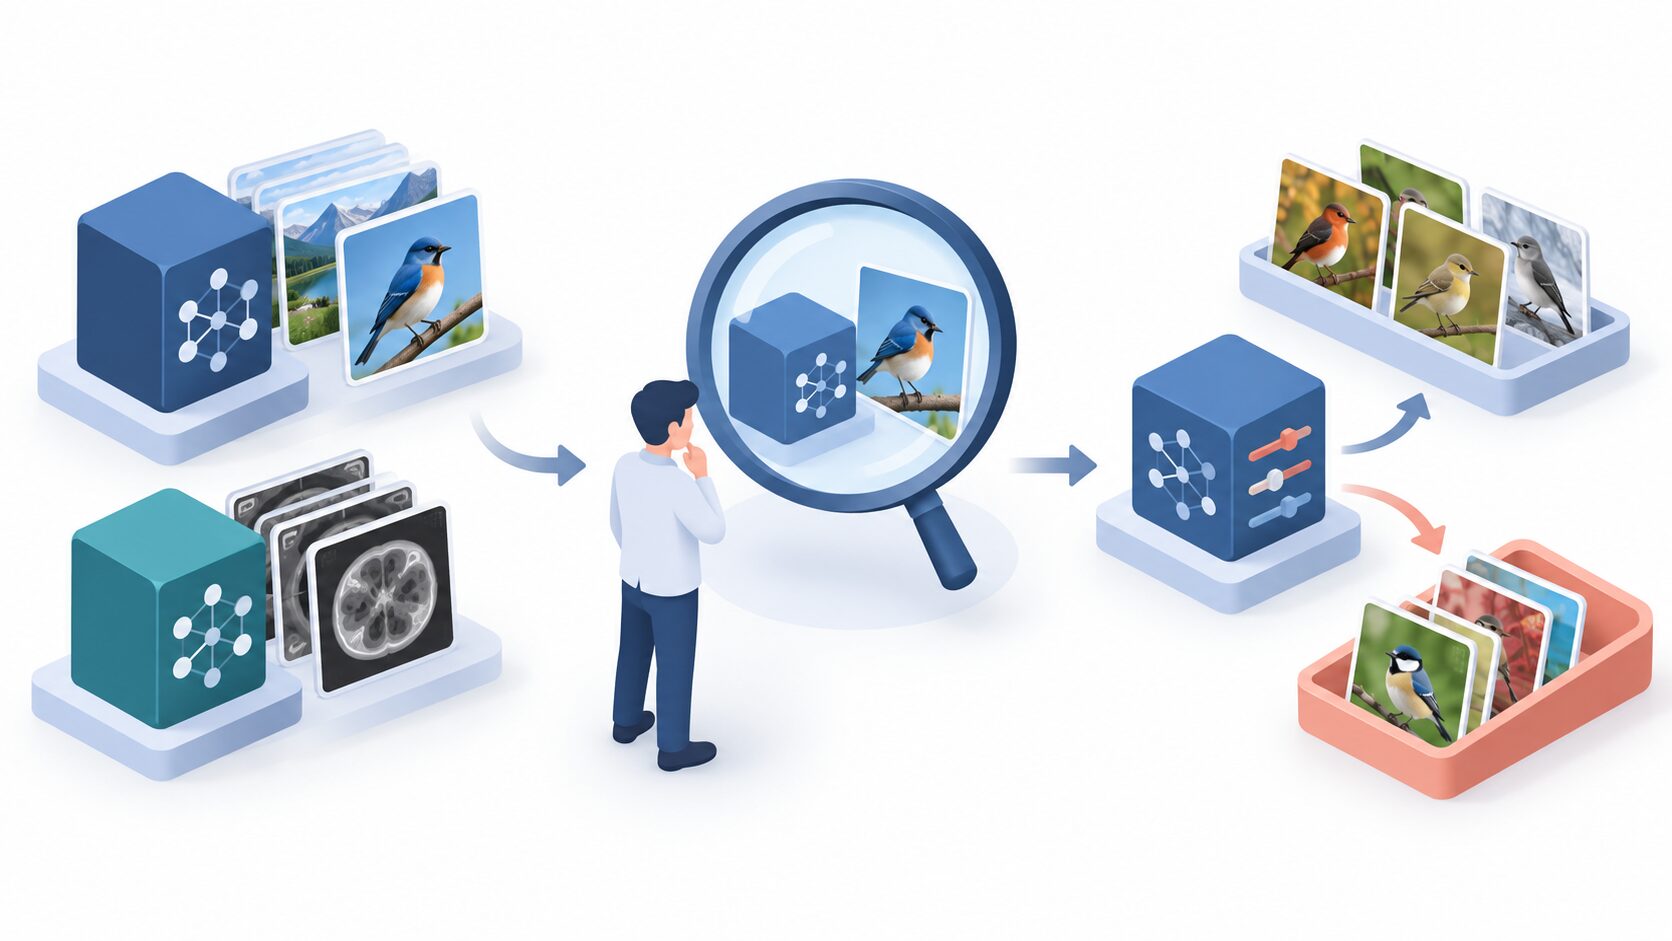
今後の展望:モデルの規模だけでなく、使いやすさも重要
事前学習を発展させる方向として、より大規模で多様なデータを扱うモデルと、限られたデータや計算資源でも使いやすいモデルの両方が考えられます。幅広い特徴を学べる土台は応用先を広げる可能性がありますが、規模を大きくすれば、学習や利用に必要な資源も増えやすくなります。
実際のモデル構築では、「最大のモデルを使う」ことよりも、目的に必要な性能をどの程度のデータと費用で得られるかが大切です。少量の専門データを有効に使う調整方法や、用途に合う事前学習済みモデルを選ぶ方法は、データ収集が難しい分野でも重要になります。
医療、創薬、自動運転などは応用が期待される分野ですが、事前学習だけで実用上の課題が解決するわけではありません。用途に応じたデータ、評価方法、実際の環境での確認を組み合わせて初めて、基礎能力を役立つ仕組みへつなげられます。将来の可能性と、個々のモデルで確認できた能力を区別して捉えることが大切です。
まとめ:事前学習を土台に、目的に合うモデルを育てる
事前学習は、後の課題に役立つ特徴を先に学ぶ段階です。その成果を別の課題へ活かすのが転移学習であり、学習済み部分を追加学習で調整する方法がファインチューニングです。これらを組み合わせることで、ゼロからすべてを学ぶ負担を減らし、目的に応じたモデルを構築しやすくなります。
ただし、少ないデータで必ず高精度になるとは限りません。用途に合う土台を選び、必要な範囲を調整し、学習に使っていないデータで確かめることが基本です。初めて試すなら、鳥の分類など目的が明確な課題で、分類部分だけを学ぶ構成と、一部を微調整した構成を比較すると、事前学習を活かす仕組みを具体的に理解できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年9月26日 | 事前学習と転移学習の区別を修正し、モデル選択と評価の手順を追記 |