

N-gramとは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「N-gram」って、どういう意味ですか?文章をいくつかに分けることなのでしょうか?

AI専門家
N-gramは、連続する単語や文字をN個ずつ取り出したまとまりのことだよ。たとえば「今日/は/良い/天気/です」を2単語ずつ見ると、「今日 は」「は 良い」「良い 天気」「天気 です」になる。1単語ずつずらして、重なりを残すのがポイントなんだ。
AIの初心者
「N」は、1つのまとまりに入る単語や文字の数なんですね。まとまりを作ると、何がわかるんですか?
AI専門家
どの並びがよく現れるかを数えられるよ。その情報は、検索や文章の分類、次の単語の予測などに使える。ただし、短い並びを数えるだけで文章全体の意味まで理解できるわけではないんだ。
N-gram(Nグラム、エヌグラム)とは、文章などの列から、連続するN個の要素を取り出したまとまりです。自然言語処理では、単語や文字の並びを数え、文章の特徴を表すために使います。Nが1ならユニグラム、2ならバイグラム、3ならトライグラムと呼びます。
理解の出発点は、「何を1要素とするか」と「何個ずつ取り出すか」の2つです。この記事では、同じ例文を使って抽出の手順を確かめたうえで、単語と文字の違い、出現頻度から予測する仕組み、活用例と注意点を説明します。
N-gramとは?連続するN個の単語・文字を取り出す考え方
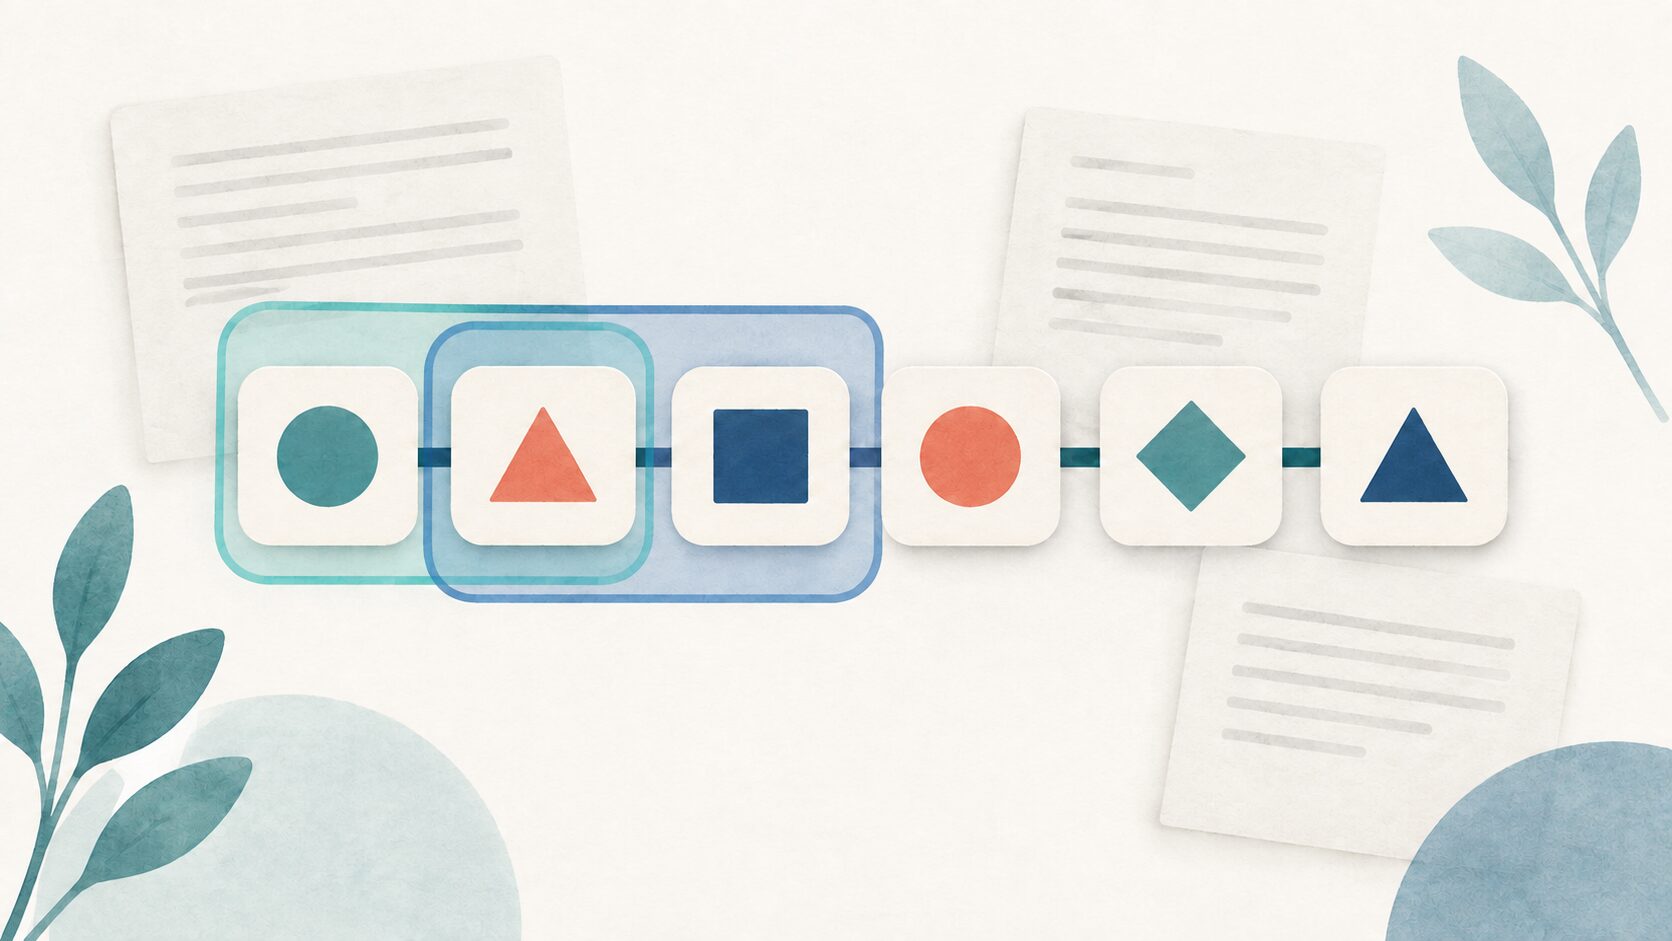
Nグラムでは、対象の文章を順番のある要素の列として扱います。単語を要素にする場合も、文字を要素にする場合も、取り出すのは隣り合っているN個の要素です。Nは「文章を何分割するか」や「最終的に何組できるか」を表す数字ではありません。
たとえば、「今日は良い天気です」を「今日/は/良い/天気/です」という5つの単語に分けたとします。Nを2にすると、最初の組は「今日 は」、次の組は「は 良い」です。このように開始位置を1単語ずつ動かすため、「は」は両方の組に含まれます。ここでの単語分割は説明用の一例で、実際の分割結果は使う辞書や処理方法によって異なります。
Nグラムそのものは取り出した並びを指し、その抽出・集計方法をまとめて「Nグラム」と呼ぶこともあります。さらに、その頻度を使って次の要素の確率を求める仕組みが「Nグラム言語モデル」です。並びを取り出すことと、確率を使って予測することは、関連していますが別の段階です。
単語を個別に数えるだけでは、「良い」と「天気」が隣り合う情報は残りません。「良い 天気」を1つの特徴として扱えば、その表現が使われていることを記録できます。ただし、1文からその組を取り出しただけでは「一般によく使われる」とはいえません。使われやすさを知るには、複数の文章から頻度を集計する必要があります。
ユニグラム・バイグラム・トライグラムの違い
3種類の違いは、1組に含める要素数です。ここでは単語の区切りを「今日/は/良い/天気/です」に固定し、文の開始・終了を示す特別な記号は加えずに比較します。
| 種類 | Nの値 | 取り出される単語の並び | わかることの例 |
|---|---|---|---|
| ユニグラム(unigram) | 1 | 「今日」「は」「良い」「天気」「です」の5組 | どの単語が、何回現れるか |
| バイグラム(bigram) | 2 | 「今日 は」「は 良い」「良い 天気」「天気 です」の4組 | 隣り合う2単語に、どのような組み合わせがあるか |
| トライグラム(trigram) | 3 | 「今日 は 良い」「は 良い 天気」「良い 天気 です」の3組 | 3単語の範囲で、どのような表現が現れるか |
Nが大きいほど、1つの特徴に含められる局所的な文脈は長くなります。たとえば「良い」だけより「良い 天気」、さらに「良い 天気 です」のほうが、どのような並びで使われたかを細かく区別できます。一方、表現が少し変わるだけでも別の特徴になり、同じ並びを十分な回数観測しにくくなります。
ユニグラムにも、話題に関係する語を集計しやすい利点があります。長い並びほど常に優れているのではなく、単語単位の情報と短いフレーズの情報を組み合わせることもできます。
Nグラムを作る手順:1要素ずつずらして取り出す
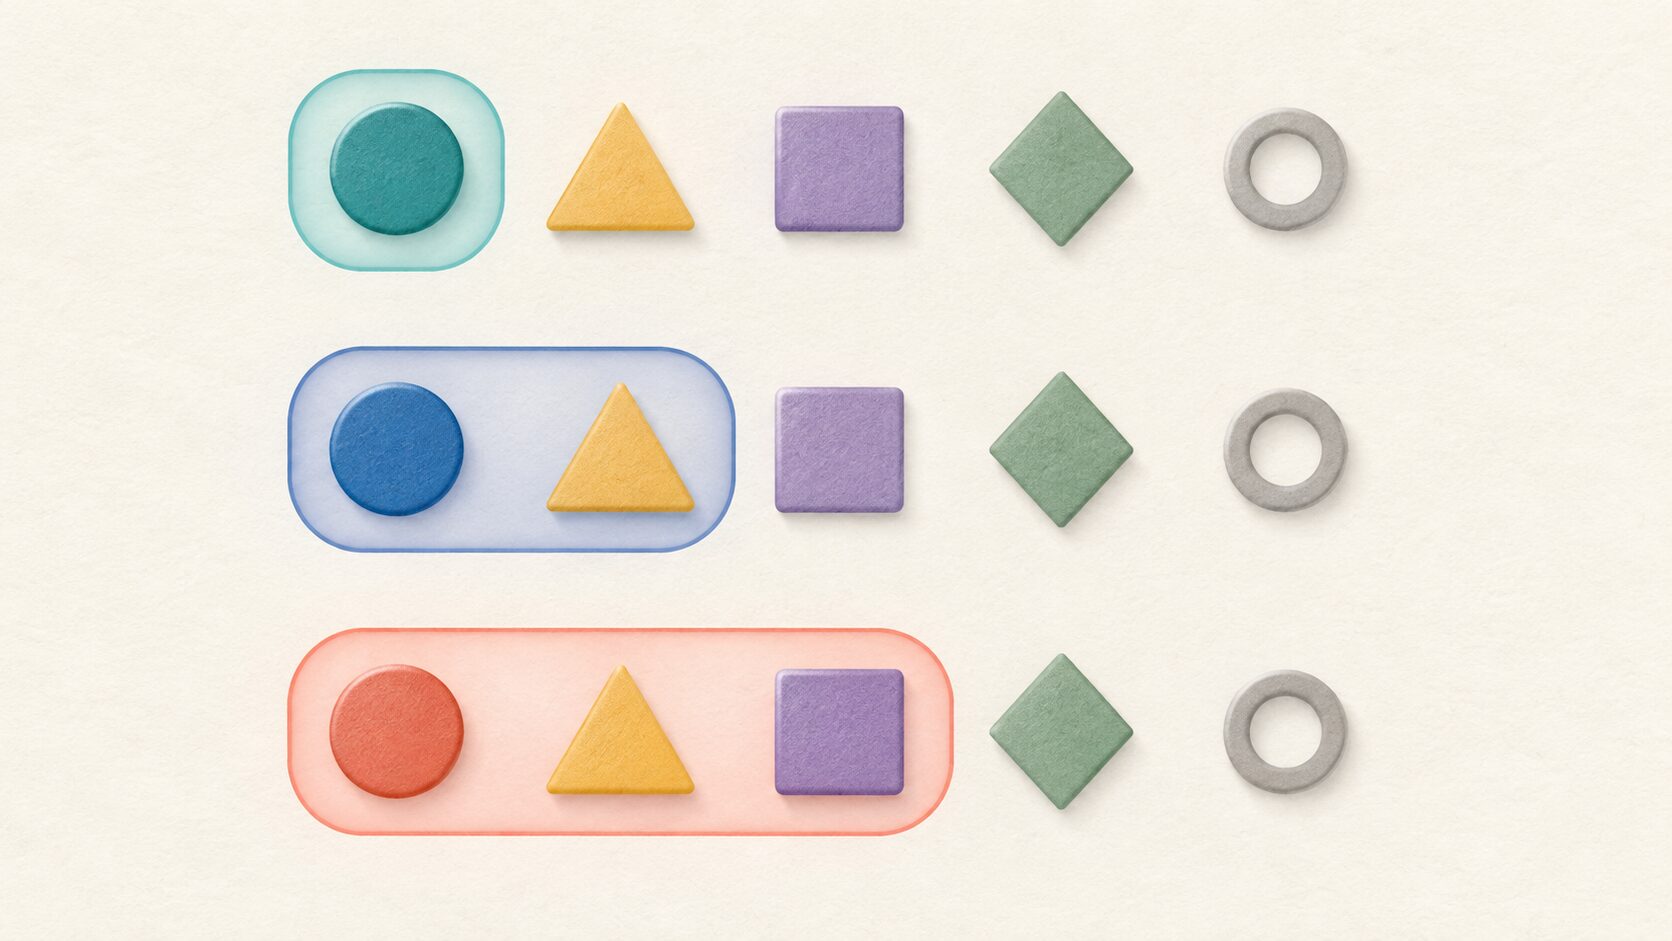
Nグラムの抽出は、一定の幅の窓を文章の上で動かすイメージで考えると理解しやすくなります。この「窓」の幅がNです。次の手順で、抽出と集計を分けて確認しましょう。
- 単語を数えるか、文字を数えるかを決めます。分析対象が日本語なら、単語をどう区切るかも決めます。
- 文章を要素の列にします。例では「今日/は/良い/天気/です」の5要素です。
- Nを決め、先頭からN個を取り出します。バイグラムなら、最初は「今日 は」です。
- 開始位置を1要素だけ進めて、同じ幅で取り出します。「は 良い」「良い 天気」「天気 です」と続けます。
- 必要な長さを取り出せなくなったら終了し、各組が何回現れたかを集計します。
「今日 は」「良い 天気」のように、2単語ごとに飛ばして取り出すと「は 良い」が抜けてしまいます。通常のNグラムは、N個ずつ進むのではなく、1個ずつ進んで取り出します。また、同じ組が複数回現れた場合、出現回数を数える分析では重複を消しません。
開始・終了の記号を加えない場合、要素が5個ある文章から取れるバイグラムは4組、トライグラムは3組です。Nを6にすれば、その文章からは1組も取り出せません。この例からも、Nを大きくすると1文からの抽出数まで増えるわけではないとわかります。
複数の文を扱うときは、文末と次の文頭をまたぐ組を作るかどうかも決めます。言語モデルでは文の開始・終了を特別な記号で表すこともあります。こうした境界の扱いによって抽出結果が変わるため、データ全体で同じルールを使うことが大切です。
単語Nグラムと文字Nグラムは何が違う?
「2-gram」と聞いただけでは、2単語なのか2文字なのかは決まりません。Nの値と同じくらい、1要素の単位を確認することが重要です。自然言語処理では、処理の単位として取り出した要素を「トークン」と呼びます。トークンは単語のことも、文字や単語の一部のこともあります。
| 比較項目 | 単語Nグラム | 文字Nグラム |
|---|---|---|
| 基本の単位 | 区切られた単語など | 文字 |
| バイグラムの例 | 「今日/は/良い/天気/です」から「良い 天気」など | 「すもも」から「すも」「もも」 |
| 捉えやすい特徴 | 単語の組み合わせや短いフレーズ | 語の一部、接頭・接尾の並び、表記の部分一致 |
| 主な注意点 | 分割方法や辞書の違いで特徴が変わる | 単語の意味的な区切りをまたぐ組もできる |
日本語は単語の間に空白を置かないことが多いため、単語Nグラムを作る前に、形態素解析などによる分割を行います。形態素解析は、文を意味や文法上の小さな単位に分け、品詞などの情報を付ける処理です。解析結果のどの単位を採用するかによって、「単語Nグラム」と呼ぶものの中身も変わります。
文字Nグラムなら、単語の境界を決めずに処理できます。未知の語や表記ゆれがあっても、共通する文字列を特徴として残せる場合があります。ただし、誤字を必ず補えるわけではなく、意味が違う語でも一部の文字が一致することがあります。検索や分類に使うときは、部分一致のしやすさと誤った一致の両方を確認します。
たとえば「こんにちは世界」を文字バイグラムにすると、「こん」「んに」「にち」「ちは」「は世」「世界」です。「こんにちは」と「世界」の2つに分けること自体は、文字バイグラムではありません。説明用の普通の日本語では文字を直感的に数えられますが、絵文字や結合文字を含むデータでは、何を1文字として処理するかも実装上の確認点になります。
出現頻度から次の単語を予測する仕組み
Nグラム言語モデルは、観測した並びの頻度を使って、次の単語が現れる確率を推定します。バイグラムで、直前の単語から次の単語の確率を求める基本形は次の式です。
\(P(y\mid x)=\frac{C(x,y)}{\sum_v C(x,v)}\)ここで、\(x\)は直前の単語、\(y\)は予測したい次の単語です。\(C(x,y)\)は、その2単語が続けて現れた回数を表します。分母の\(\sum_v C(x,v)\)は、\(x\)に続くすべての候補\(v\)について回数を合計したものです。つまり「その直前の単語に続く観測全体のうち、目的の単語が続いた割合」を計算します。これは頻度に基づく、補正を加える前の推定です。
小さな架空の学習データで、「良い」の直後の単語を8回観測し、そのうち6回が「天気」、2回が「景色」だったとします。このデータでは「良い」の次が「天気」である確率を75%、「景色」である確率を25%と推定します。日本語全体で常にこの割合になるという意味ではなく、集めた文章と分割方法に依存する値です。
バイグラムモデルが予測に使うのは直前の1単語、トライグラムモデルなら直前の2単語です。Nには、予測する単語自身も含まれます。ユニグラムモデルは前の単語を条件にせず、各単語の出現頻度に基づいて予測します。
この予測を繰り返せば、短い文を生成する仕組みを作れます。たとえば、候補の中から確率に応じて次の単語を選び、新しい末尾をもとにさらに予測を続けます。ただし、使う文脈が限られるため、近くの語のつながりが自然でも、文章全体では同じ話を繰り返したり、話題がずれたりします。
Nグラムの活用例:検索・分類・校正・翻訳・文章生成
Nグラムは、抽出した並びを特徴量にする使い方と、並びの確率を評価する使い方で役立ちます。どの用途でも、Nグラムだけで処理全体が完成するとは限りません。検索の照合や分類器への入力など、仕組みの一部として使う場合があります。
| 用途 | Nグラムの役割と具体例 | 効果を判断するときの注意点 |
|---|---|---|
| 検索 | 文書と検索語を文字Nグラムにし、共通する並びを持つ候補を探す。単語Nグラムならフレーズの特徴も使える | 部分一致は関連性や意味の一致を保証しない。候補の確認や順位付けと組み合わせる |
| テキスト分類 | 「配送 遅れ」などの並びの有無や頻度を特徴にして、問い合わせの種類や記事の話題を分類する | 分類用の学習データが必要。単語分割や特徴量の選び方で結果が変わる |
| スペルチェック・文章校正 | 文字の並びや周辺の単語を手がかりに、不自然な箇所や修正候補を評価する | まれな専門用語や人名を誤りと決めつけない。候補生成や辞書などの仕組みも必要 |
| 機械翻訳 | 統計的機械翻訳では、訳文候補の語順やつながりの自然さを評価する言語モデルとして使われてきた | 訳文が自然でも原文に忠実とは限らない。原文との対応を扱う仕組みとは役割が異なる |
| 文章生成・入力候補の予測 | 直前の並びに続きやすい単語を選び、候補を提示したり、短い文章を組み立てたりする | 長い文脈や事実の正しさを保証しない。局所的なつながりを学ぶ仕組みとして捉える |
分類では、単語だけでなく並びを持たせることで表現の違いを残せます。たとえば「良く/ない」のように分割された表現なら、バイグラム「良く ない」を特徴として使えます。ただし、否定表現の範囲が長い場合や皮肉の場合まで、この1つの特徴で判定できるわけではありません。
翻訳については、原文と訳文のNグラムを単純に比較すれば意味を変換できる、という理解は適切ではありません。また、文章生成も、自然な小説やニュース記事の全体構成をNグラムだけで維持できるわけではありません。元の文章にどのような並びがあったかを利用する技術として、担当する役割を切り分けると理解しやすくなります。
Nの決め方と、データが少ないときの注意点
Nを決めるときは、残したい表現の長さと、利用できるデータの量を一緒に考えます。小さなNは同じ並びを観測しやすい一方、区別できる文脈が短くなります。大きなNは細かな表現を区別できますが、完全に同じ並びが何度も現れるとは限りません。
この「候補となる並びに対して観測が少ない状態」を、データが疎であるといいます。観測されなかった並びの確率を、そのままゼロとする単純な推定では、自然な新しい表現にも対応しにくくなります。学習データにないことと、言語としてあり得ないことは同じではありません。
言語モデルでは、未観測の並びにも確率を配分する「スムージング」や、長い並びの情報が乏しいときに短い並びの推定を利用する「バックオフ」などの考え方があります。また、複数の長さのモデルを混ぜる方法もあります。これらは頻度の不足を補う手段ですが、データの偏りや長文理解の問題をすべて解消するものではありません。
Nを大きくすると、候補となり得る並びの種類は増えます。ただし、前に見たとおり、長さが決まった1文から抽出する組の数はむしろ減ります。実際のメモリや処理時間は、観測された異なる組の数、保存方法、複数のNを併用するかなどに左右されます。「Nが大きいから抽出数も必ず増える」とは考えないようにしましょう。
学習や実務で比べるときは、次の点を先にそろえると、結果の違いを追いやすくなります。
- 同じ単位で比べる:単語バイグラムと文字バイグラムは、どちらもNが2でも見る範囲が違います。
- 前処理を統一する:英字の大小、全角・半角、句読点、空白の扱いをそろえます。ただし区別が必要な表記まで一律に消さないようにします。
- 助詞などの削除に注意する:単語を先に取り除くと、元の文では離れていた語が隣接し、Nグラムが変わります。
- 少ない種類から比較する:まずユニグラム、次にユニグラムとバイグラムの併用などを試し、目的に対する効果を確認します。
- 学習用と評価用を分ける:機械学習に使う場合、語彙や重みの学習には学習用データだけを使い、Nの調整には検証用データを使います。最終的な性能確認用のデータは調整に流用しません。
Bag-of-Words・TF-IDF・形態素解析・ニューラル言語モデルとの違い
Nグラムを学ぶと、文章を扱うほかの用語も出てきます。これらはすべて同じ種類の手法ではなく、文章を分ける処理、特徴を表す方法、重みを付ける方法、予測モデルという役割の違いがあります。
| 用語 | 主な役割 | Nグラムとの関係 |
|---|---|---|
| 形態素解析 | 日本語などを形態素に分け、品詞などを調べる | 単語Nグラムを作る前の分割に使える。連続するN個を取り出す処理とは別 |
| Bag-of-Words(BoW) | 文書を、特徴の有無や回数の集合として表す | 単語だけでなくNグラムも特徴にできる。Nグラム内の順序は残るが、特徴同士の文書全体での順序は通常保持しない |
| TF-IDF | 文書内での出現頻度と、文書集合全体での広がりを使って特徴に重みを付ける | 単語にもNグラムにも適用できる。Nグラムと競合する分割方法ではない |
| ニューラル言語モデル | ニューラルネットワークで、文脈から次の要素などの確率を学習する | 単純なNグラム頻度表とは異なる仕組み。Transformerなどは設計や入力長の範囲内で、より広い文脈を扱える |
たとえば「形態素解析で区切る→単語バイグラムを抽出する→TF-IDFで重み付けする→分類器に入力する」という組み合わせが考えられます。それぞれが別の処理を担当するため、「NグラムとTF-IDFはどちらがよいか」だけでは、比較の条件がそろいません。
深層学習やほかの言語モデルとの併用を考える場合も、何を改善したいかを決めて検証します。たとえば、Nグラムによる分類を比較基準にしたり、特徴を追加したときの変化を調べたりできます。組み合わせただけで皮肉や比喩を理解できるようになる、といった保証はありません。Nグラムには、どの並びを数えたか確認しやすく、処理を追いやすい利点があります。
よくある疑問:共起との違いとNグラムの限界
Nグラムと共起は同じですか?
共起は、語が同じ文書や同じ文、一定範囲の中などで一緒に現れることを扱う、より広い考え方です。通常のNグラムでは、連続していることと、その順序が条件になります。隣接するバイグラムは共起の一種として調べられますが、離れた位置にある2語を数える処理まで、すべてバイグラムと呼ぶわけではありません。
Nを大きくすれば、文章全体の意味がわかりますか?
より長い並びを特徴にできますが、それだけで意味理解になるわけではありません。たとえば、長い説明を挟んだ否定や、前の段落にある話題との関係は、小さなNの範囲には入りません。Nを増やしても同じ並びの観測例が不足しやすく、単純に長くすれば解決する問題ではありません。
Nグラムは文章以外にも使えますか?
順序のある要素列なら、考え方を応用できます。たとえば操作の記録をイベントの列として扱い、連続する操作のパターンを調べることができます。この場合も、何を1要素とするか、どこを列の境界とするかを決める必要があります。
まとめ:まずは単位とNを決めて、並びを数える
Nグラムは、連続するN個の要素を取り出して、文章の局所的な並びを扱う方法です。単語や文字を個別に見るだけでなく、そのつながりを特徴として残せるため、検索、分類、校正、翻訳候補の評価、次の単語の予測などに利用できます。
初めて学ぶときは、「今日は良い天気です」を5単語に分け、ユニグラム、バイグラム、トライグラムを紙に書き出してみてください。続いて短い別の文も同じルールで分け、同じ組が何回現れたかを数えると、抽出と頻度の違いがつかめます。
実際に使うときの判断点は、要素の単位、Nの大きさ、前処理のルール、データの量です。Nグラムで残せる情報と失われる情報を知っておくと、ほかの自然言語処理の手法を学ぶ際にも、役割の違いを理解しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月26日 | 単語・文字の抽出例を修正し、確率モデルとデータ不足時の注意点を追記 |