
LSTMとは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「エルエスティーエム」って何ですか?過去の情報を覚えられると聞いたのですが、どんな仕組みなのでしょうか。

AI専門家
LSTMは、文章や音声、日々の売上のような順序のあるデータを扱うニューラルネットワークの一種だよ。必要な過去の情報を、後の処理まで引き継ぎやすい仕組みがあるんだ。
AIの初心者
全部をそのまま記憶するわけではないんですね。何を残すかは、どうやって決めるのですか?
AI専門家
記憶を保持する「セル状態」と、情報の量を調整する3つの「ゲート」を使うんだ。学習を通して、何を残し、何を書き込み、何を出力に使うかを調整できるようになるよ。
LSTM(長短期記憶)は、過去から現在へ続くデータの関係を学習するために、RNNを発展させたニューラルネットワークです。文章の前半の内容を後半の処理に利用したり、販売数の推移から翌日の需要を推定したりするときに使われます。
名前に「記憶」とありますが、人間の経験をそのまま保存する装置ではありません。この記事では、通常のRNNとの違いから、セル状態と3つのゲート、更新式、応用例、学習時の注意点まで順に説明します。
LSTMとは?時系列のつながりを学ぶRNNの一種
LSTMは「Long Short-Term Memory」の略で、日本語では「長短期記憶」と呼ばれます。読み方は「エルエスティーエム」です。RNN(再帰型ニューラルネットワーク)の一種であり、時間や順序に沿って入力されるデータを処理します。
順序のあるデータは「系列データ」と呼ばれます。文章なら単語や文字の並び、音声なら短い時間ごとに取り出した音の特徴、時系列予測なら日ごとの販売数などが該当します。同じ値や単語でも、前後の並びによって意味が変わるため、個々の入力に加えて過去の情報を利用することが大切です。
たとえば「週末は雪山に行く予定だ。交通手段や宿泊先を決めた。最後に、防寒具を準備した」という文章では、後半の「防寒具」を理解する手がかりが、離れた位置にある「雪山」に含まれています。このような離れた位置どうしの関係を長期依存関係といいます。LSTMは、この関係を学びやすくする設計を備えています。
基本的な処理は、入力を一つ受け取り、内部の状態を更新し、次の入力へ進むという流れです。各時点の状態を予測に使う方法も、系列の最後の状態から文章全体の分類などを行う方法もあります。LSTMが保持するのは学習した数値表現であり、元の文章やデータを丸ごと保管するデータベースではありません。
通常のRNNはなぜ長い関係を学びにくいのか
単純なRNNは、現在の入力と一つ前の「隠れ状態」を組み合わせて、次の隠れ状態を計算します。隠れ状態は、それまでの入力を処理した結果を表す数値のまとまりです。この繰り返しによって、過去の情報を現在の処理へ反映します。
課題になるのは、長い系列を学習する際の勾配消失です。学習では、予測の誤差を減らすために、重みをどの方向へどれだけ変えるかを「勾配」から求めます。RNNでは時間方向にも計算をさかのぼるため、遠い過去へ伝わる途中で勾配が非常に小さくなり、その時点に関係する重みを十分に修正しにくくなることがあります。
つまり、勾配消失は単に「古いデータを保存できない」という意味ではなく、遠い過去の入力が予測にどう役立ったかを学びにくくなる問題です。先ほどの文章なら、後半の処理を改善するための学習信号が、冒頭の「雪山」に関係する処理まで届きにくい状況に当たります。逆に勾配が大きくなりすぎる「勾配爆発」も起こり得ます。
LSTMは、記憶を引き継ぐセル状態と、その更新量を調整するゲートを導入し、長期依存関係を学びやすくしています。ただし、どれほど長い系列でも必ず学習できるわけではありません。また、単純なRNNも重みによって過去の影響を変えるため、「すべての過去の情報を均等に扱う」という理解は正確ではありません。
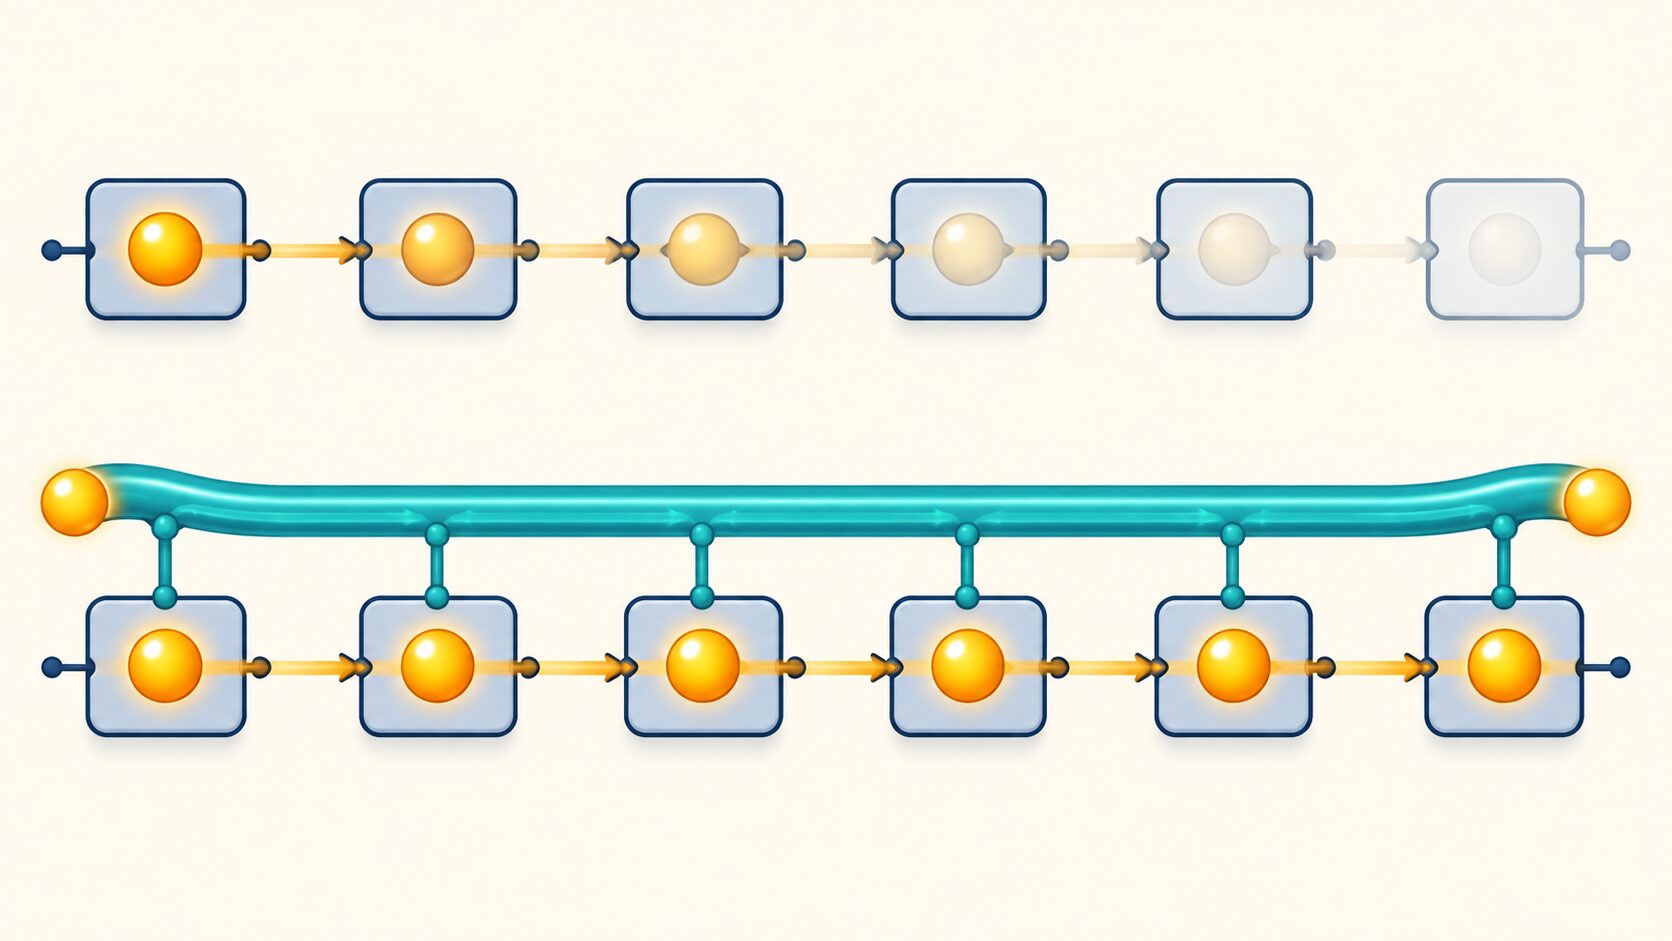
図は、長い依存関係の学習の難しさと、記憶を引き継ぐ経路の考え方を模式的に示しています。実際の保持能力や精度は、データと学習条件によって変わります。
セル状態と3つのゲートの仕組み
標準的なLSTMでは、「セル状態」と「隠れ状態」という2種類の状態を使います。セル状態は記憶を引き継ぐ経路、隠れ状態はその時点の処理結果として外へ渡す表現と考えると、役割を区別しやすくなります。どちらも通常は複数の数値からなるベクトルです。
セル状態の更新と隠れ状態の計算には、忘却ゲート、入力ゲート、出力ゲートが関わります。「ゲート」は情報の流れを調整する弁のようなものですが、単純な開閉スイッチではありません。通常はシグモイド関数によって、成分ごとに0から1の間の連続値を出します。
| 構成要素 | 役割 | 理解するためのイメージ |
|---|---|---|
| セル状態 | 過去の情報を保持し、新しい情報を加えながら次の時点へ渡す | 処理を進めながら内容を書き換えるメモ |
| 忘却ゲート | 一つ前のセル状態を、成分ごとにどれだけ残すか調整する | 既存のメモの残し方を決める |
| 入力ゲート | 新しく計算した記憶の候補を、どれだけ書き込むか調整する | 追加する内容の量を決める |
| 出力ゲート | 更新後のセル状態から、隠れ状態へどれだけ情報を出すか調整する | メモの内容を今の処理にどれだけ使うか決める |
| 隠れ状態 | 次の時点の計算や、後続の層の入力に使う | 現時点の処理結果をまとめた出力 |
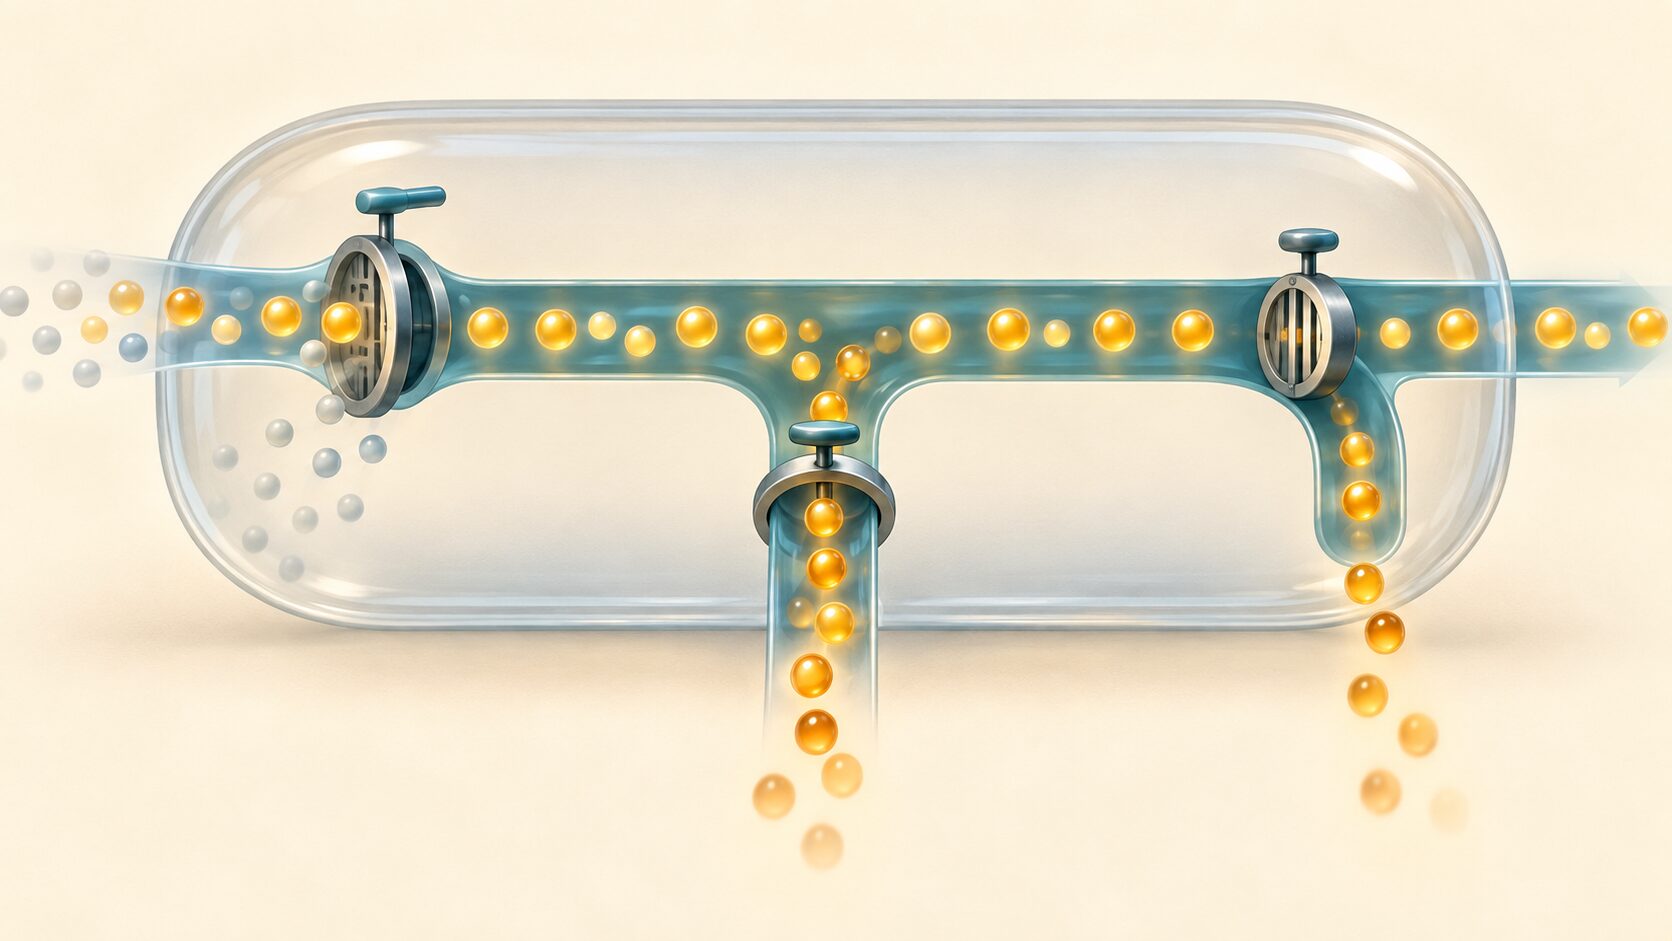
処理の流れは、まず過去のセル状態をどれだけ残すかを決め、次に現在の入力と前の隠れ状態から作った新しい記憶の候補を加え、最後に出力用の隠れ状態を計算する、という順序で捉えられます。出力に使う量を抑えても、セル状態の情報まで必ず消えるわけではありません。
忘却ゲートのある成分が1に近ければ、その成分の古い情報は残りやすく、0に近ければ弱まります。ただし、何日後に消すかという保存期限を直接指定する仕組みではありません。また、値が0.8であっても「情報が正しい確率は80%」という意味にはなりません。
ゲートの働きを決める重みは、予測などの課題に合わせて学習します。通常の推論では学習済みの重みを使い、入力と前の隠れ状態に応じてゲートの値や状態が変化します。入力のたびに重み自体を学び直すわけではない点も、押さえておきたい区別です。
更新式で見るLSTMの動作
セル状態の更新は、次の式で表せます。
\(c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t\)式の前半が「過去の記憶を残す処理」、後半が「新しい記憶を書き込む処理」です。記号の意味は次のとおりです。
- \(t\):系列の中での現在の時点。
- \(c_t\)、\(c_{t-1}\):現在と一つ前のセル状態。
- \(f_t\):忘却ゲート。前のセル状態をどれだけ残すかを調整します。
- \(i_t\):入力ゲート。新しい記憶をどれだけ加えるかを調整します。
- \(\tilde{c}_t\):現在の入力と前の隠れ状態から計算する、新しい記憶の候補。
- \(\odot\):対応する成分どうしを掛ける演算。
たとえば一つの成分だけに注目し、前のセル状態が0.8、忘却ゲートが0.9、入力ゲートが0.2、記憶の候補が0.5なら、更新後の値は \(0.9 \times 0.8 + 0.2 \times 0.5 = 0.82\) です。過去の値を一部残し、新しい値を少し足したことが分かります。これは説明用の数値例であり、実際は多くの成分を同時に計算します。
続いて、隠れ状態は次のように計算します。
\(h_t = o_t \odot \tanh(c_t)\)\(h_t\) は現在の隠れ状態、\(o_t\) は出力ゲートです。\(\tanh\) は数値を−1から1の間へ変換する関数で、セル状態を変換した結果に出力ゲートを掛けます。忘却・入力・出力の各ゲートは、現在の入力と前の隠れ状態をもとに計算されます。
セル状態に情報を足し合わせる経路があることが、LSTMの重要な特徴です。忘却ゲートが情報を十分に残すときは、時間をさかのぼる学習信号も保ちやすくなります。一方、ゲートの値や学習条件によって信号は弱まるため、この式だけで勾配消失が完全になくなるわけではありません。
隠れ状態は、そのまま売上数や単語を表すとは限りません。需要予測なら後続の層で数値へ変換し、分類なら分類先のスコアなどへ変換して、課題に応じた出力を作ります。
RNN・LSTM・GRU・Transformerの違い
RNNは系列を再帰的に処理するネットワークの総称で、LSTMとGRUはその仲間です。「RNNとLSTMを比較する」という場合、RNNはゲートを持たない単純なRNNを指すことが多いため、言葉の範囲をそろえて考えましょう。
| モデル | 情報を扱う仕組み | 比較するときのポイント |
|---|---|---|
| 単純RNN | 前の隠れ状態と現在の入力から、次の隠れ状態を計算する | 構造は比較的単純だが、長い依存関係の学習が難しくなりやすい |
| LSTM | セル状態と隠れ状態を持ち、3つのゲートで情報を調整する | 長期依存を扱いやすくする一方、同じ隠れ状態の幅なら単純RNNよりパラメータが多い |
| GRU | 主に更新ゲートとリセットゲートを使い、セル状態を別に設けない | 標準的な構成では同じ状態の幅のLSTMよりパラメータが少なく、比較候補になる |
| Transformer | 注意機構を使い、参照可能な位置の情報どうしの関係を計算する | 再帰的な状態更新とは異なる。長い入力での計算量やメモリ使用量も比較する |
LSTMとGRUのどちらがよいかは、系列の長さ、データ量、必要な精度、実行環境によって変わります。パラメータ数が少ないことだけで処理時間が決まるわけでもありません。入力条件と評価方法をそろえて確かめることが大切です。
Transformerの標準的な自己注意は、参照できる位置どうしを直接結び付けて計算します。LSTMは基本的に時点ごとの状態更新を順に行うため、学習の並列化に制約があります。ただし、逐次生成などではTransformerにも順番に処理する部分があるので、「常にすべて同時に処理できる」とは言い切れません。
モデル名だけで優劣を決めず、同じ課題で精度、速度、メモリ使用量を比べることが、実務での選び方になります。
LSTMの活用例:文章・音声・需要予測・異常検知
LSTMの使いどころは、「現在の値だけでは判断しにくく、過去からの並びに手がかりがある課題」です。対象が文章でもセンサーの数値でも、順序を持つ入力として扱える点は共通しています。
| 分野 | 入力の例 | LSTMを使う処理の例 | 確認したい点 |
|---|---|---|---|
| 自然言語処理 | 単語や文字を数値化した系列 | 文章分類、翻訳、文章生成、要約、質問応答の構成要素 | 用途に応じて入力の符号化や出力の生成方法を設計する |
| 音声認識 | 音声から短い時間ごとに抽出した特徴量 | 前後の音のつながりを考慮した認識 | 雑音、話す速さ、利用できる前後の範囲を考える |
| 需要予測 | 販売数、曜日、販促、利用可能な天気情報 | 翌日や翌週の販売数を推定する | 予測する時点で入手できる情報だけを使う |
| 異常検知 | 設備の温度、振動、通信量の時系列 | 通常のパターンから外れる変化を検出する | 正常時の変動や誤検知を考慮して判定基準を調整する |
自然言語処理では、入力文を読み取る部分と、出力文を順に作る部分にLSTMを組み込む構成が考えられます。ただし、LSTMの層を置くだけで翻訳や質問応答が完成するわけではなく、学習データ、出力形式、目的に合った損失関数なども必要です。音声認識でも、前後の短い音の特徴をまとめる働きが、音の判別を助けます。
需要予測では、直近の売上に加えて曜日ごとの傾向や販促後の変化などを学び、在庫管理や生産計画に役立てる使い方があります。異常検知では、次のセンサー値を予測し、実測値との差が大きい時点を候補として調べる方法が一例です。ただし、大きな差が必ず故障や不正アクセスを意味するわけではありません。
市場の価格変動や気象データも、時系列分析の対象になります。一方で、過去にない出来事や観測していない要因の影響は、過去の系列だけでは捉えきれません。元データとの関係を学習できても、将来の予測精度が保証されるわけではなく、不確実性を含めて結果を評価する必要があります。
学習と評価の進め方:需要予測を例に
たとえば「過去28日分のデータから、翌日の販売数を予測する」という課題を考えます。28日は説明用の設定であり、すべての需要予測に適した長さではありません。次の手順で、モデルより先に予測条件と評価方法を決めると、結果を判断しやすくなります。
- 予測する時点と対象を決める。 前日の閉店時に翌日の販売数を予測するのか、当日の朝に予測するのかを明確にします。欠品時の販売数は本来の需要より小さくなることがあるため、何を正解データとするかも確認します。
- 時間順にデータを分ける。 古い期間を学習、その後を検証、最後をテストにします。入力窓を作る際も予測対象の日付を基準に区分し、同じ対象や未来の正解が学習側へ混ざらないようにします。
- 入力と前処理を用意する。 販売数、曜日、販促などを一定の時間間隔にそろえ、欠損の扱いを決めます。標準化の平均や分散は学習期間だけで求め、同じ変換を検証・テストにも適用します。
- 入力窓と正解を組にする。 連続した28日分を一つの入力、直後の1日を正解にし、開始日をずらして学習例を作ります。各例では「時間の長さ」と「各時点の特徴量数」を区別します。
- 比較対象と一緒に学習・調整する。 前日の値、前週の同じ曜日、移動平均などの単純な予測も用意します。LSTMの状態の大きさや入力期間などは検証データで調整し、過学習も確認します。
- 残したテスト期間で評価する。 MAE(平均絶対誤差)なら、平均して販売数を何個ほど外すかを確認できます。RMSE(平方平均二乗誤差)は大きな誤差の影響を受けやすい指標です。通常日と販促日など、条件ごとの差も調べます。
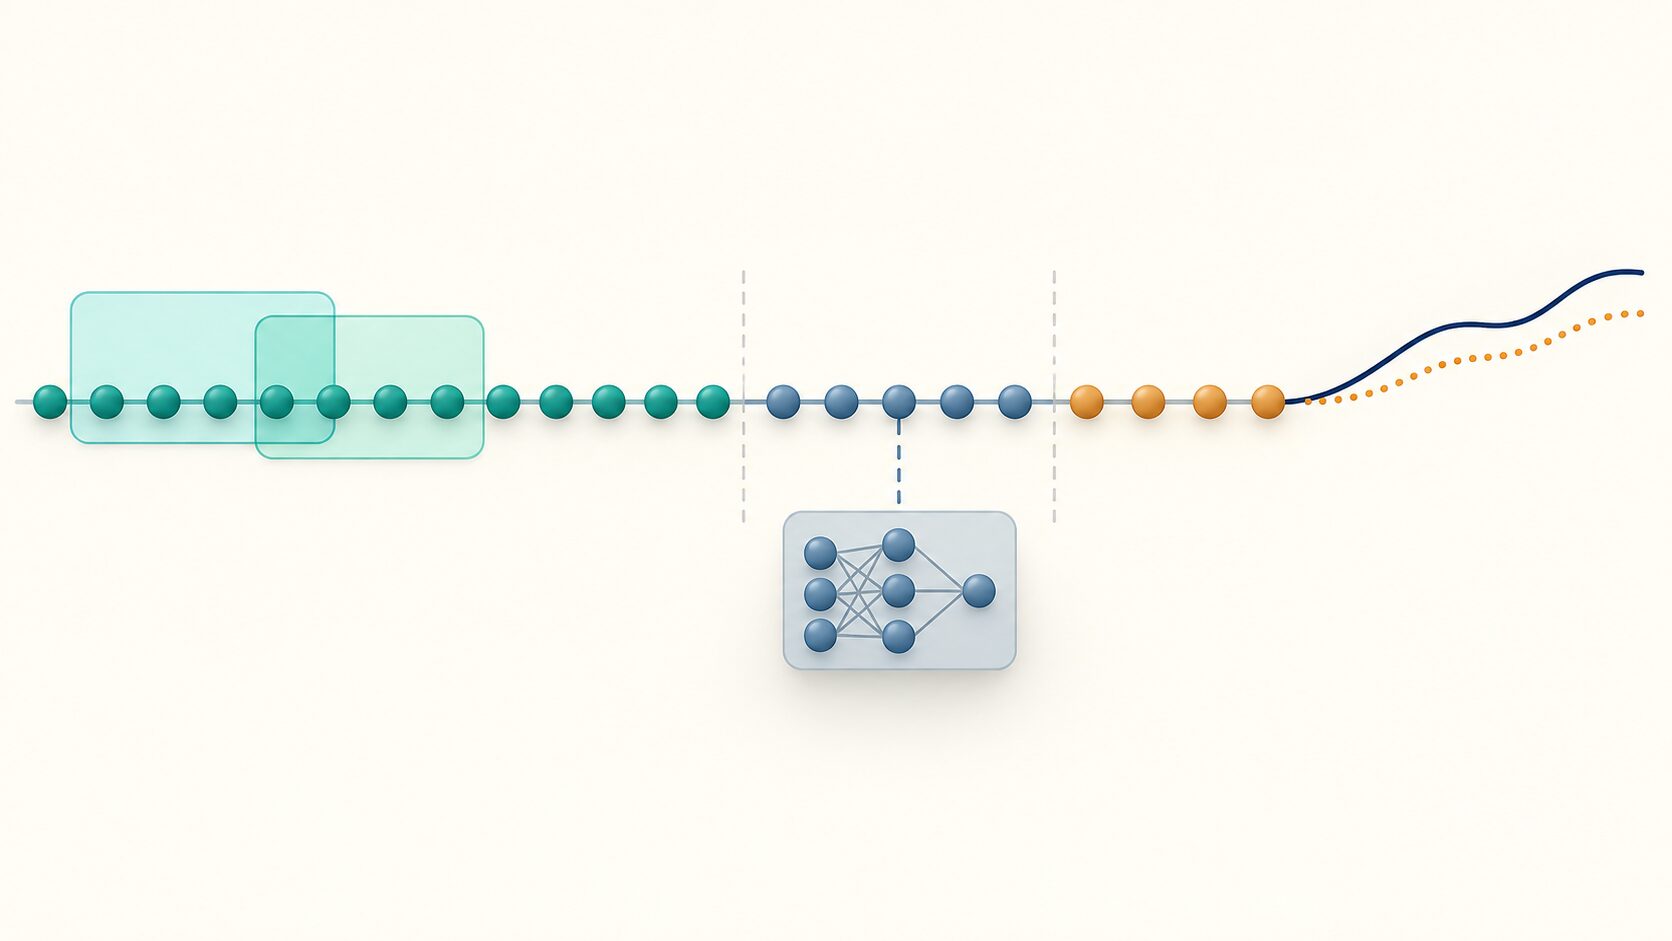
検証やテストの最初の予測で、それ以前に観測済みのデータを入力窓に含めること自体は不正ではありません。大切なのは、各予測を行う時点で、その情報を本当に知り得たかです。たとえば翌日の曜日は分かりますが、翌日の実際の販売数や実測気温は分かりません。天気を使うなら、その時点で入手できる予報などに条件をそろえます。
テスト結果を見ながら何度も設定を変えると、テスト期間に合うモデルを選んでしまいます。調整は検証期間で行い、テストは最終確認に使いましょう。運用に近づけたい場合は、時間を進めながら複数の期間で評価し、季節や状況が変わっても性能が保たれるかを調べます。
LSTMを使うときの注意点と限界
LSTMを使えば、長期依存や予測の問題がすべて解決するわけではありません。特に、次の点が結果に影響します。
- 保持できる情報には限界があります。 状態の大きさは有限で、必要な情報が常に残るとは限りません。学習でさかのぼる範囲を途中で区切る場合も、離れた時点の関係を学ぶ難しさに影響します。
- データ不足や過学習が起こり得ます。 層や状態を大きくすると表現できることは増えますが、学習データの細かな変動まで覚える場合があります。検証誤差を見ながら、モデルの大きさ、正則化、早期終了などを調整します。
- 計算量と待ち時間を確認する必要があります。 時点を順に処理するため、長い系列や大きなモデルでは学習・推論の負担が増えます。必要な応答速度と、単純な手法から得られる改善を比較します。
- 勾配爆発は別に対処することがあります。 LSTMでも学習が不安定になる場合があり、勾配の大きさを制限する勾配クリッピングなどを検討します。これは未来情報の混入やデータ不足を解決する方法ではありません。
- データ漏洩に注意が必要です。 全期間で前処理を学習したり、未来の実測値を入力したりすると、評価が実運用よりよく見えてしまいます。時系列を無作為に分割すると、この問題を見落としやすくなります。
- 状態を引き継ぐ範囲を決める必要があります。 別の顧客や無関係な設備など、独立した系列をまたいで状態を引き継ぐと、意図しない情報が混ざります。推論やバッチ処理で状態を保持するか、どこで初期化するかを明確にします。
ゲートの値を観察することは内部動作の手がかりになりますが、それだけで予測理由を完全に説明できるわけではありません。入力を一部変えた場合の出力や、条件ごとの誤差も調べ、実際の挙動を確かめることが大切です。
LSTMの発展と他の技術との組み合わせ
LSTMの改善を考えるうえでは、学習の効率化、モデルの軽量化、動作の把握が重要な論点になります。単に層を増やすだけでなく、必要な入力期間や特徴量を見直し、用途に見合った大きさで動かすことも選択肢です。
ほかの技術と組み合わせる場合には、それぞれの役割を分けて考えられます。たとえばCNNで音声やセンサーの局所的な特徴を抽出し、その系列をLSTMで処理する構成や、注意機構を加えて参照したい時点の情報を選びやすくする構成があります。組み合わせによる改善は、単独のモデルとの比較で確かめます。
強化学習では、現在の観測だけでは状況を十分に判断できないときに、過去の観測をまとめる役割としてLSTMを使うことが考えられます。ロボット制御などで、直前までの変化を行動選択の手がかりにする使い方です。
医療での経時データの分析、教育での学習履歴の把握、交通量の予測なども応用先として考えられます。ただし、LSTMを採用しただけで診断、個別支援、安全性などが実現するわけではありません。目的に合うデータと評価を用意し、どの判断を支援するのかを具体化する必要があります。
LSTMについてよくある疑問
LSTMはどのくらい前の情報まで覚えられますか?
何日、何単語といった共通の上限は決まっていません。入力の時間間隔、系列長、状態の大きさ、学習のさかのぼり方、データ中の規則性によって変わります。長い入力を与えたことと、その全範囲の関係を学べたことは別です。
入力する「時刻数」と「特徴量数」は何が違いますか?
過去28日について、販売数・気温・販促の有無という3種類の値を渡すなら、1例あたりの時刻数は28、各時点の特徴量数は3です。LSTM内部の状態の大きさは、これらとは別に設定します。単純に特徴量を増やすよりも、予測に使える情報かどうかを確かめることが先です。
双方向LSTMは未来予測にも使えますか?
双方向LSTMは、与えられた系列を前からと後ろからの両方向で処理します。全文が分かっている文章の分析などで、前後の文脈を利用できます。未来予測でも、すでに観測済みの過去の入力窓を両方向から読む構成は可能です。一方、まだ観測していない予測対象以降の値を読み込むと未来情報の漏洩になります。リアルタイムで逐次判断する用途では、どこまで入力を受け取れるかにも注意します。
まとめ:LSTMは必要な過去の情報を選んで引き継ぐ
LSTMは、RNNが長い依存関係を学びにくい課題に対し、セル状態と3つのゲートを用いて情報を引き継ぎやすくしたモデルです。忘却ゲートで過去の情報を残す量を、入力ゲートで書き込む量を、出力ゲートで隠れ状態に使う量を調整します。
文章、音声、需要予測、異常検知などに利用できますが、記憶能力や予測精度は無条件には保証されません。仕組みを学んだ後は、時間順のデータ分割と単純な予測手法との比較を行い、その課題でLSTMを使う効果を確かめましょう。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年9月27日 | セル状態とゲートの更新式、GRUとの違い、時系列評価の注意点を追記 |