
画像認識の鍵、局所結合構造とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「局所結合構造」って、画像のどこを見ている仕組みなんですか?

AI専門家
一つの出力を計算するときに、画像全体ではなく、近くにある画素のまとまりを使う仕組みです。小さな窓を通して、その範囲の明るさや色の変化を調べるイメージですね。
AIの初心者
小さな範囲だけを使って、どうやって顔や猫だと判断するんですか?
AI専門家
画像の各場所で特徴を取り出し、層を重ねて組み合わせていきます。輪郭から目や耳のような形へ、さらに広い範囲の情報へとつなげる考え方です。部分の特徴だけでなく、全体の配置も判断の手掛かりになります。
局所結合構造とは。
局所結合構造とは、ニューラルネットワークの各出力ユニットが、直前の層の限られた範囲と結びつく構造です。画像認識では、近隣の画素から輪郭や模様などの特徴を取り出す土台になります。畳み込みニューラルネットワーク(CNN)は、この局所的な接続と、同じフィルタを各位置で使う重み共有を組み合わせています。
画像の部分を調べる処理が、どう全体の認識につながるのでしょうか。小さな窓での計算から、全結合との違い、層を重ねる意味、画像以外の活用例まで順に見ていきます。「局所結合だから全体情報は不要」「フィルタは人が一つずつ用意する」といった誤解も、仕組みに沿って確認しましょう。
局所結合構造とは何か
ここでいう「結合」は、入力の値を出力の計算に使うためのつながりです。各つながりには「重み」という数値があり、どの入力をどのように計算へ反映するかを決めます。局所結合では、一つの出力につながる入力を、空間的に近い範囲へ限定します。例えば3×3の窓なら、縦3画素、横3画素のまとまりを使って一つの値を求めます。
近くの画素をまとめて扱うのは、その並びに画像の手掛かりがあるからです。一つの画素の明るさだけでは、それが背景なのか、物体の輪郭なのかは判断しにくいでしょう。一方、隣り合う画素を比べると、急に暗くなる境界、同じ方向に続く線、繰り返す模様などが見えてきます。画素の位置関係を保ったまま計算することで、こうした特徴を捉えやすくなります。
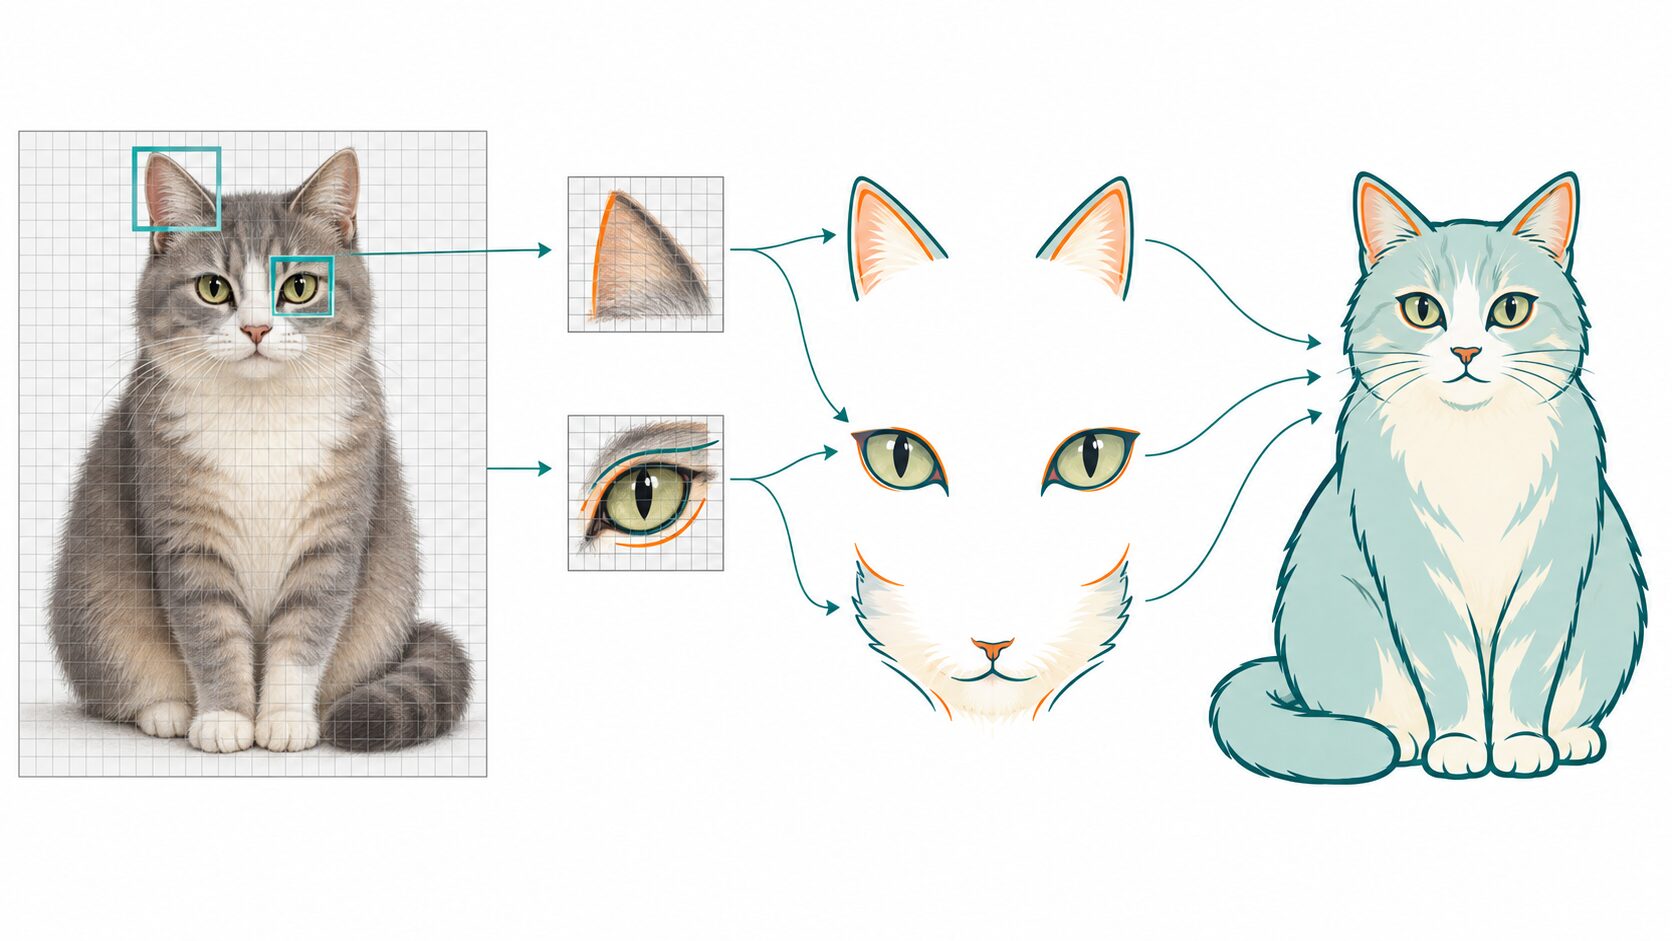
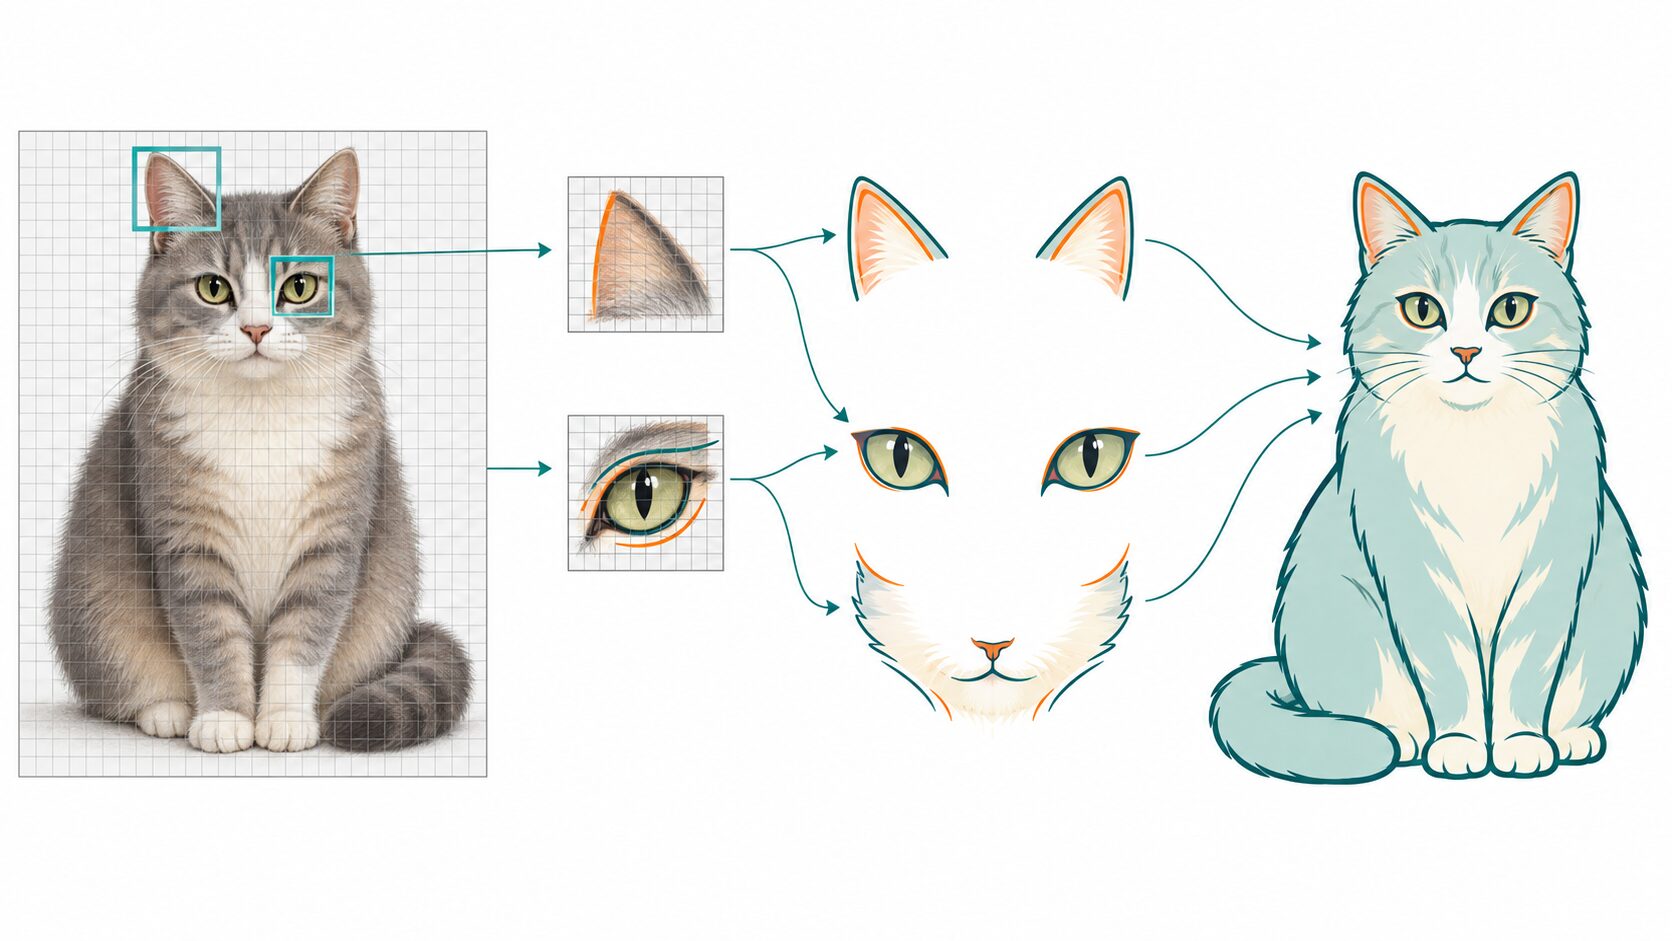
猫の耳なら、周囲との境界や尖った形が手掛かりになります。顔なら、目や鼻の周辺にある明暗や輪郭が役立ちます。ただし、最初の小さな窓だけで「これは耳」「これは目」と決まるわけではありません。細かな変化を検出し、それらを後続の層で組み合わせることで、より大きな形を捉えます。
最初の層が扱うのは画像の画素ですが、後続の層が扱うのは、前の層が作った「特徴マップ」の近傍です。特徴マップとは、どの位置でどのような特徴が検出されたかを数値として並べたものです。そのため、後ろの層ほど、元画像のより広い範囲に由来する情報を組み合わせられます。
「窓」は参照する範囲を表す比喩であり、画像を実際に拡大する道具ではありません。また、目立つ部分だけを選び、残りを無視する仕組みでもありません。通常のCNNは、設定された位置ごとに計算を行います。人間が気になる場所へ視線を移す行動を、そのまま再現していると考えると、処理の理解がずれてしまいます。
フィルタをずらして特徴を計算する仕組み
CNNの一般的な畳み込み層では、「フィルタ」または「カーネル」と呼ばれる重みの配列を使います。基本となるのは、入力とフィルタの対応する値を掛け、その結果をすべて足し、最後にバイアスを加える計算です。バイアスは、入力との掛け算とは別に加える調整用の値です。
単一チャンネルの画像を例に、3×3の入力の各行が「0、1、1」、フィルタの各行が「−1、0、1」だとします。0を暗い画素、1を明るい画素と考えると、各行の計算は \(0\times(-1)+1\times0+1\times1=1\) です。3行とも同じ計算になるので、次のように整理できます。
| 行 | 入力の値(左から) | フィルタの重み(左から) | 対応する値を掛けた合計 |
|---|---|---|---|
| 上の行 | 0、1、1 | −1、0、1 | 1 |
| 中央の行 | 0、1、1 | −1、0、1 | 1 |
| 下の行 | 0、1、1 | −1、0、1 | 1 |
バイアスを0とすると、一つの出力は \(1+1+1+0=3\) になります。このフィルタは左側の明るさを引き、右側の明るさを足すため、左が暗く右が明るい、縦方向に延びる境界に正の反応を示します。左右が同じ明るさなら差が打ち消され、明暗が逆なら負の値になります。このように、値の大きさだけでなく、符号にも計算上の意味があります。
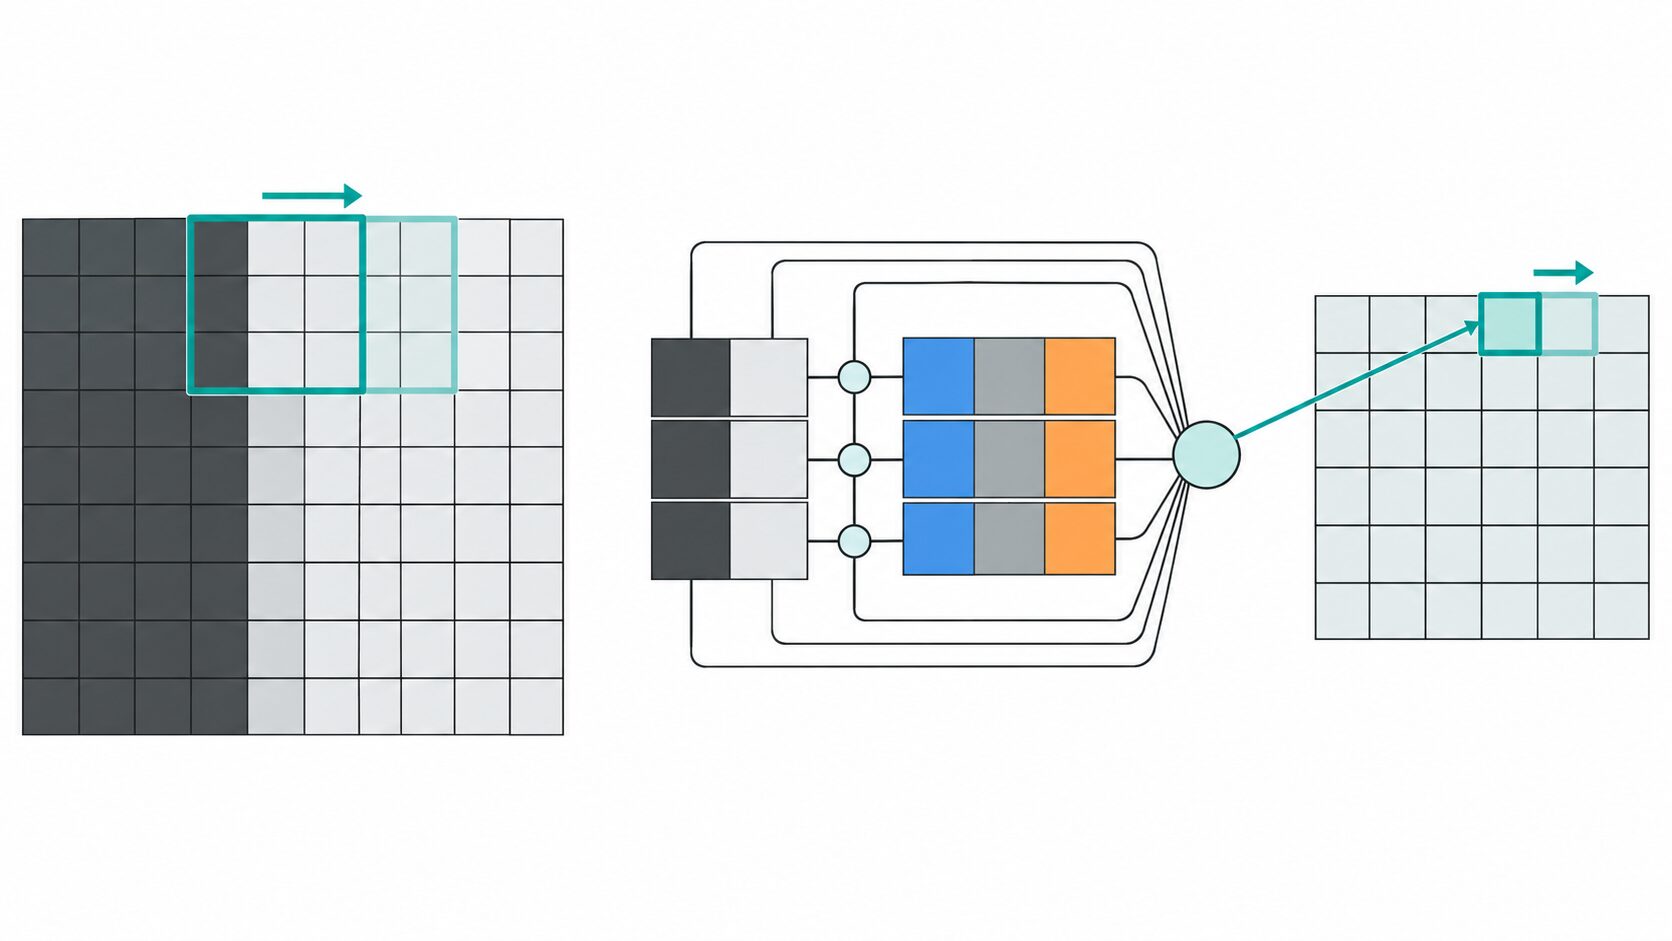
同じ計算を隣の位置でも行い、結果を位置に対応させて並べると特徴マップができます。窓を移動する幅を「ストライド」といい、ストライド1なら1画素ずつ、2なら2画素ずつ進めます。入力が5×5、フィルタが3×3、ストライド1で、画像の外にはみ出さない範囲だけを使う場合、出力は3×3になります。
画像の端も扱いやすくするために、周囲へ値を補う処理が「パディング」です。例えば先ほどの5×5画像の周囲に1画素分の0を補えば、同じ3×3フィルタとストライド1で、出力を5×5に保てます。ただし、端では補った値も計算に入るため、中央とまったく同じ条件になるわけではありません。
実際のCNNでは、異なる重みを持つ複数のフィルタを使い、複数の特徴マップを作ります。また、一般的な畳み込みでRGB画像を扱う場合、3×3の空間範囲にある赤・緑・青の3チャンネルの値をまとめて計算します。ここまでの例は、計算を追いやすくするため、一つのチャンネルに限定しています。
説明用のフィルタは手で設定しましたが、CNNの重みとバイアスは通常、学習データから調整されます。予測と正解のずれをもとに値を更新し、課題に役立つ特徴を取り出せるようにしていきます。人が「目専用」「鼻専用」のフィルタをすべて設計する必要はありません。また、ここで得た3という値は、特徴への反応を表す中間値です。一般的な類似度や、「猫である確率」を直接表しているわけではありません。
全結合・局所結合・重み共有の違い
全結合、局所結合、重み共有は、区別して理解するとCNNの特徴が見えてきます。全結合と局所結合は「どこにつなぐか」、重み共有は「別の位置でも同じ重みを使うか」という違いです。通常の畳み込み層は、局所結合と重み共有を併用します。
28×28画素の単一チャンネル画像を考えます。一つの出力を全画素につなぐ全結合なら接続は784本ですが、3×3の局所結合なら9本です。この比較ではバイアスを除きます。さらに出力を複数設けたとき、各位置で独立した重みを持つのか、同じ9個の重みを再利用するのかで、学習する重みの総数が変わります。
| 構造 | 一つの出力が使う入力 | 位置をまたぐ重み共有 | 一つの出力への接続数 | 層全体で学習する重み数 |
|---|---|---|---|---|
| 全結合 | 画像全体 | 通常はしない | 784本 | 出力数の784倍 |
| 重みを共有しない局所結合 | 3×3の近傍 | しない | 9本 | 出力位置数の9倍 |
| 通常の3×3畳み込み | 3×3の近傍 | 同じフィルタを各位置で使う | 9本 | 全位置を合わせて9個 |
表の畳み込みは、入力も出力も1チャンネルで、フィルタが一つの場合です。出力位置が増えても、そのフィルタの重みは9個のままです。ただし、各位置で掛け算と足し算を行うため、重みを共有しても、計算そのものが一回で済むわけではありません。入力チャンネルやフィルタの数が増えれば、重み数も計算量も増えます。
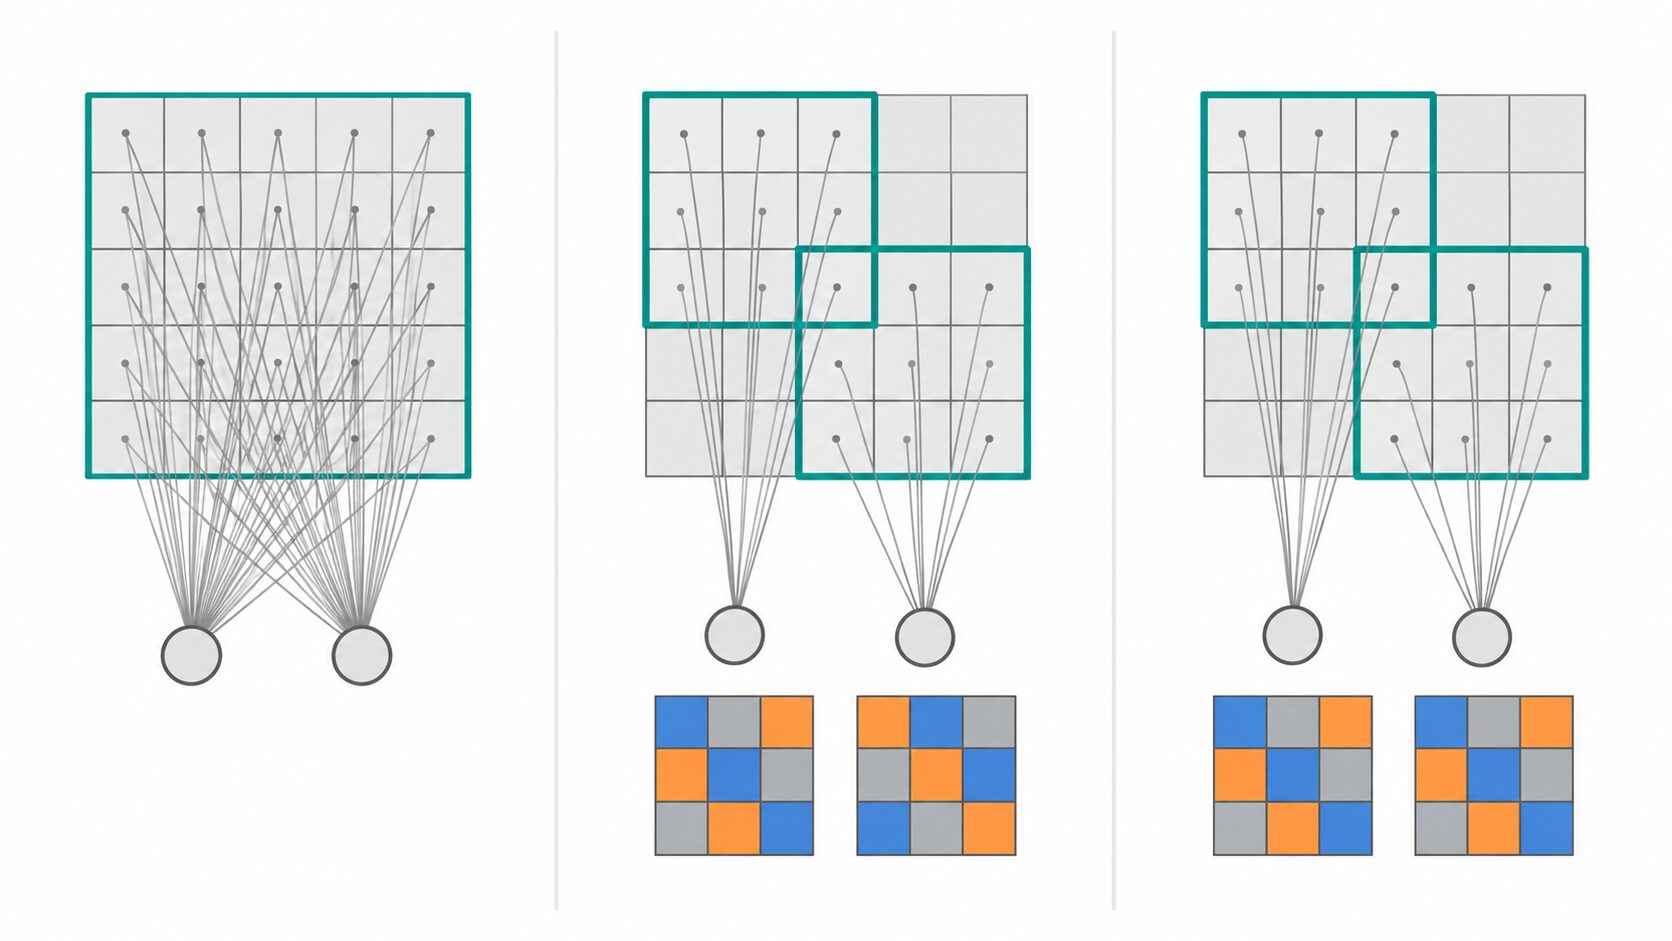
重み共有には、画像の別の位置にある同種の特徴へ同じ計算を適用できる利点があります。例えば縦方向の境界を捉えるフィルタなら、左上にある境界にも右下にある境界にも使えます。位置ごとに別々の検出方法を覚える必要が減り、学習するパラメータ数も抑えられます。
一方、局所結合という言葉だけでは重み共有まで意味しません。近傍だけにつなぎながら、位置ごとに異なる重みを学習する層もあります。また、全結合にも、離れた入力の情報を直接まとめて扱える役割があります。単にどちらが優れているかではなく、データの位置関係を生かしたいのか、広く情報を組み合わせたいのかで使い方が変わります。
局所結合と重み共有は計算や記憶容量の削減に役立ちますが、CNNなら必ず高速だとは限りません。画像の解像度、出力数、チャンネル数、層数、実行環境によって処理時間は変わります。実装時には、重み数だけでなく、特徴マップを保持するメモリや各層の計算量も確認する必要があります。
層を重ねて部分から全体を捉える
小さな窓を使う層でも、積み重ねることで広い範囲の情報を扱えます。その範囲を考えるための言葉が「受容野」です。ある出力に対して、元の入力のどこまでが影響し得るかを表します。
ストライド1、窓の間隔を広げる拡張処理なしの3×3畳み込み層を考えましょう。1層目の一つの出力は、元画像の3×3の範囲から計算されます。2層目は、その出力を含む3×3の近傍を参照します。隣り合う出力が見ている範囲は1画素ずつずれているため、それらを合わせると、画像の端を除いた位置では理論上の受容野が5×5に広がります。
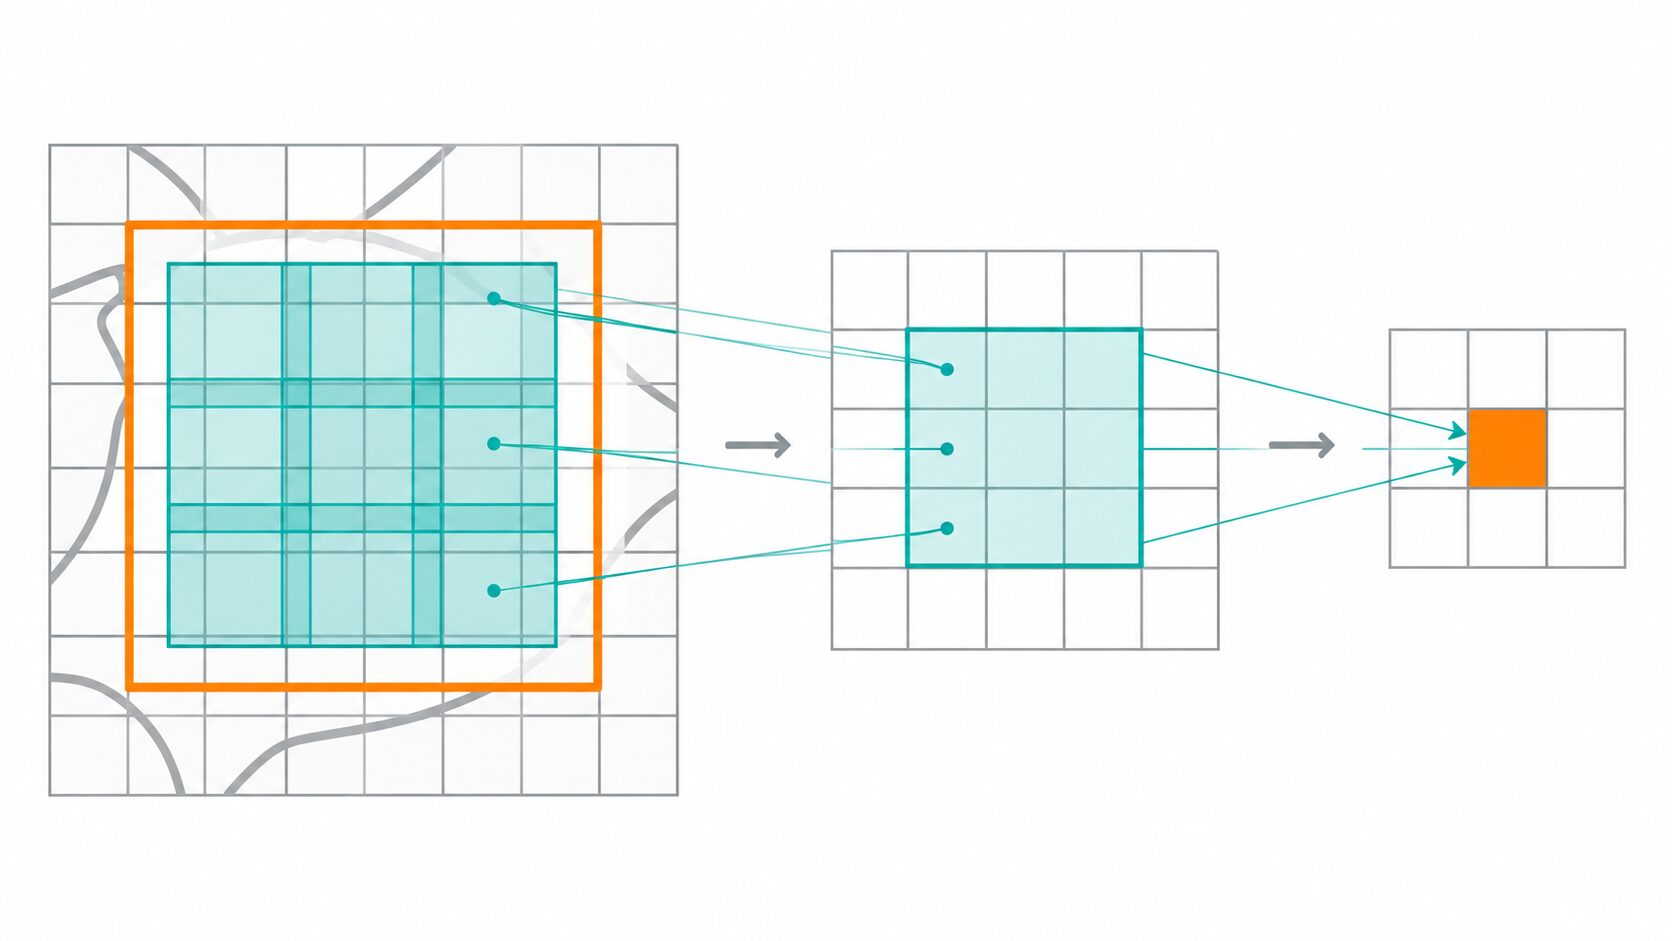
この仕組みによって、最初は明るさの境界や角を捉え、次に線の組み合わせや模様を捉え、さらに大きな形へとつなげられます。顔なら目・鼻・口の周辺の特徴を、車ならタイヤ・窓・車体に関わる特徴を組み合わせて、対象の判断に使うというイメージです。
ただし、これは階層的な特徴抽出を理解するための模式的な説明です。「2層目は必ず目、3層目は必ず顔を認識する」といった固定の役割があるわけではありません。学習の結果、一つの特徴が複数のチャンネルに分かれて表現されることもあり、各フィルタへ人間に分かりやすい名前を付けられるとは限りません。また、理論上の受容野に含まれるすべての位置が、実際の判断へ同じ強さで影響するわけでもありません。
特徴を複雑に組み合わせるには、畳み込みの間に入る非線形な「活性化関数」も重要です。例えばReLUは、負の値を0にし、正の値をそのまま通します。単なる重み付きの足し算を繰り返すだけでは表しにくい関係を、こうした処理を挟むことで学習できるようになります。
近傍の最大値や平均値を取り出す「プーリング」は、特徴マップを小さくする方法の一つです。さらに画像分類では、最終段で各位置の特徴を平均するなどして集約し、分類結果につなげる構成があります。物体検出では位置を推定する必要もあるため、位置情報の残し方が重要になります。
部分を組み合わせる際は、それらの配置も判断材料です。目のような模様が二つあるだけで、必ず顔になるわけではありません。目と鼻と口がどの位置関係にあるか、離れた部品がどうつながるかも関係します。局所結合の役割は、全体情報を不要にすることではなく、近傍の特徴から広い範囲の理解へと処理を積み上げることです。
画像・文章・音声での活用例
局所結合は画像認識でよく使われますが、「近くに並ぶデータの関係を捉える」という考え方は、文章や音声にも応用できます。画像では縦横の2次元の近傍、文章では単語などの並ぶ順序、音声では時間方向の近傍を扱います。データに応じて「近い」の意味が変わる点が大切です。
| 用途 | 扱うデータ | 捉える局所的な特徴の例 | 判断へのつなげ方 |
|---|---|---|---|
| 顔・物体認識 | 写真や映像の画像 | 輪郭、模様、部品周辺の形 | 複数の特徴を組み合わせ、対象の識別や分類に使う |
| 自動運転の物体検出 | 車載カメラの画像 | 歩行者や車両の輪郭、車輪などの特徴 | 対象の種類や位置の推定に使う |
| 医療画像の確認支援 | 体の断面画像など | 周囲と異なる濃淡、形、組織の模様 | 異常候補を見つけるための特徴抽出に使う |
| 文章分類 | 数値のベクトルに変換した単語などの列 | 近接する語の組み合わせや短い表現 | 文章の分類に役立つ手掛かりとして集約する |
| 音声認識・音の分類 | 波形やスペクトログラム | 短時間の波形変化、時間と周波数の局所パターン | 発話内容や音の種類を推定する処理へつなげる |
| 時系列の分析 | センサー値や株価などの数値列 | 短い区間の上昇、下降、周期的な変化 | 状態の分類や予測モデルへの入力特徴として使う |
画像では、局所結合を使った畳み込み層が、顔や物体を見分けるための特徴抽出を支えます。自動運転の物体検出や医療画像の異常候補の検出支援も、その応用例です。ただし、局所結合だけで検出や診断が完成するわけではありません。抽出した特徴を判断へつなげる処理や、用途に応じた性能の確認が必要です。
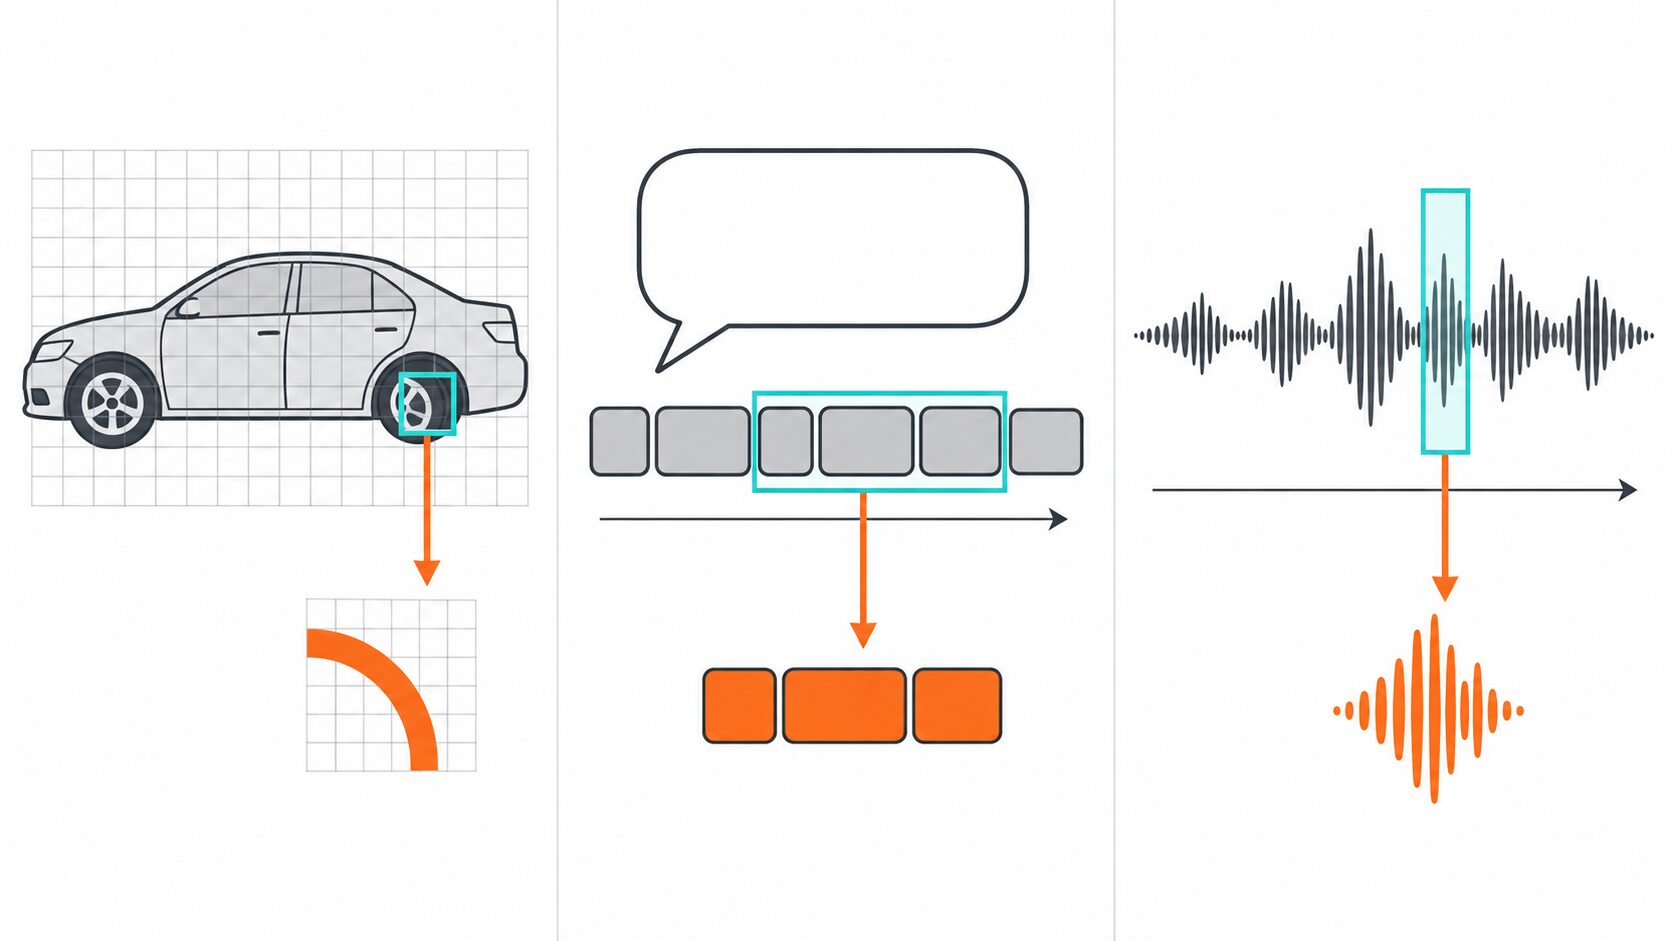
文章なら、「青い空」と「赤い空」では、隣にある語が変わるだけで表す情景が変わります。単語などを数値のベクトルへ変換し、順序方向に小さな窓を動かす1次元の畳み込みを使えば、こうした近接する語の組み合わせを特徴にできます。一方、「その色が好きではない」のような否定や、前の文を受ける表現まで理解するには、より広い文脈も扱う必要があります。文章全体の意味が近くの数語だけで決まるわけではありません。
音声では、波形の短い区間を1次元の畳み込みで処理したり、時間ごとの周波数成分を並べた「スペクトログラム」を2次元の畳み込みで処理したりできます。短時間の音の変化を組み合わせ、音の種類や発話の特徴を捉えます。声の高低や強弱は感情推定の手掛かりになる場合もありますが、話者や状況による違いがあるため、声が高いことだけで興奮していると断定はできません。
センサーの時系列や株価の系列でも、短い区間の変動パターンを抽出する使い方が考えられます。ただし、似た形の変化が常に同じ結果につながるとは限りません。局所的なパターンが捉えられることと、将来を高精度に予測できることは別です。どの長さの区間を使うか、過去と異なる条件でも役立つかを、目的に合わせて確かめます。
局所結合構造の限界と注意点
局所結合の強みは近傍の関係を扱いやすいことですが、受容野が狭い段階では、遠く離れた領域の関係を直接捉えにくいという制約があります。離れた部品の配置が重要な課題では、層の積み重ねや特徴の集約など、広い範囲の情報を組み合わせる設計が必要です。単に層数を増やせば十分とは限らず、必要な範囲まで情報が届く構成になっているかを確認します。
重み共有によって同じ特徴を別の位置でも検出できることと、最終的な認識結果が位置に左右されないことも別です。入力の特徴が移動すると、特徴マップ上の反応位置も移動するのが基本であり、最終出力への影響は、その後の集約や位置の扱いによって変わります。画像の端やストライドの影響もあるため、位置を変えれば常に同じ結果になるとは限りません。
また、同じフィルタを使っても、物体が回転したり大きさが変わったりすれば、窓の中に現れるパターンは変わります。回転や拡大縮小に強い性質が、局所結合だけで自動的に備わるわけではありません。用途に合ったデータの増やし方や、異なる大きさの特徴を扱う設計などを検討します。
細部の保持と処理効率にも兼ね合いがあります。ストライドを大きくしたり、画像や特徴マップを早い段階で小さくしたりすると、後続の計算を減らせる一方、小さな特徴が弱まる可能性があります。例えば、数画素しかない小さな異常は、周囲とまとめられて目立たなくなるかもしれません。窓の大きさ、ストライド、入力解像度を、検出したい対象の大きさに合わせることが重要です。
学習データや撮影条件にも性能は左右されます。明るい場所の画像で学習したモデルが、暗所やぼけた画像でも同じように働くとは限りません。対象の形ではなく、背景の模様を手掛かりにしてしまうこともあります。実務では、利用時に近い条件のデータで確認し、どのような場面で誤るのかを調べる必要があります。
学習するときは、まず「一つの出力はどの入力につながるか」、次に「その重みは別の位置でも共有されるか」、最後に「層を通してどこまでの範囲を扱えるか」を順に確認すると理解しやすくなります。局所結合は近傍の特徴を取り出す土台であり、重み共有、活性化、広い範囲への情報の集約と組み合わさることで、画像などの認識を支えています。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月17日 | 重み共有との違いを明記し、積和計算の例と受容野の広がりを追記 |