
特徴抽出とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「特徴抽出」って、何を取り出すことなんですか?画像を見ただけでは、どこが特徴なのかよくわかりません。

AI専門家
例えば、りんごの写真から「赤い部分の割合」や「輪郭の丸さ」を計算するんだ。写真のままでは扱いにくい性質を、分析や判断に使いやすい数値に変える。こうして特徴を取り出す処理が、特徴抽出だよ。
AIの初心者
必要な情報を選ぶだけではなく、数値に変えるんですね。その数値があれば、りんごかどうかも決まるのでしょうか?
AI専門家
数値は判断の材料で、それを使って種類を決めるのは分類の役割だよ。赤くないりんごもあるから、色だけで決めず、形や表面の模様なども組み合わせて考える。何を特徴にすると役立つかは、見分けたいものや撮影条件によって変わるんだ。
特徴抽出とは。
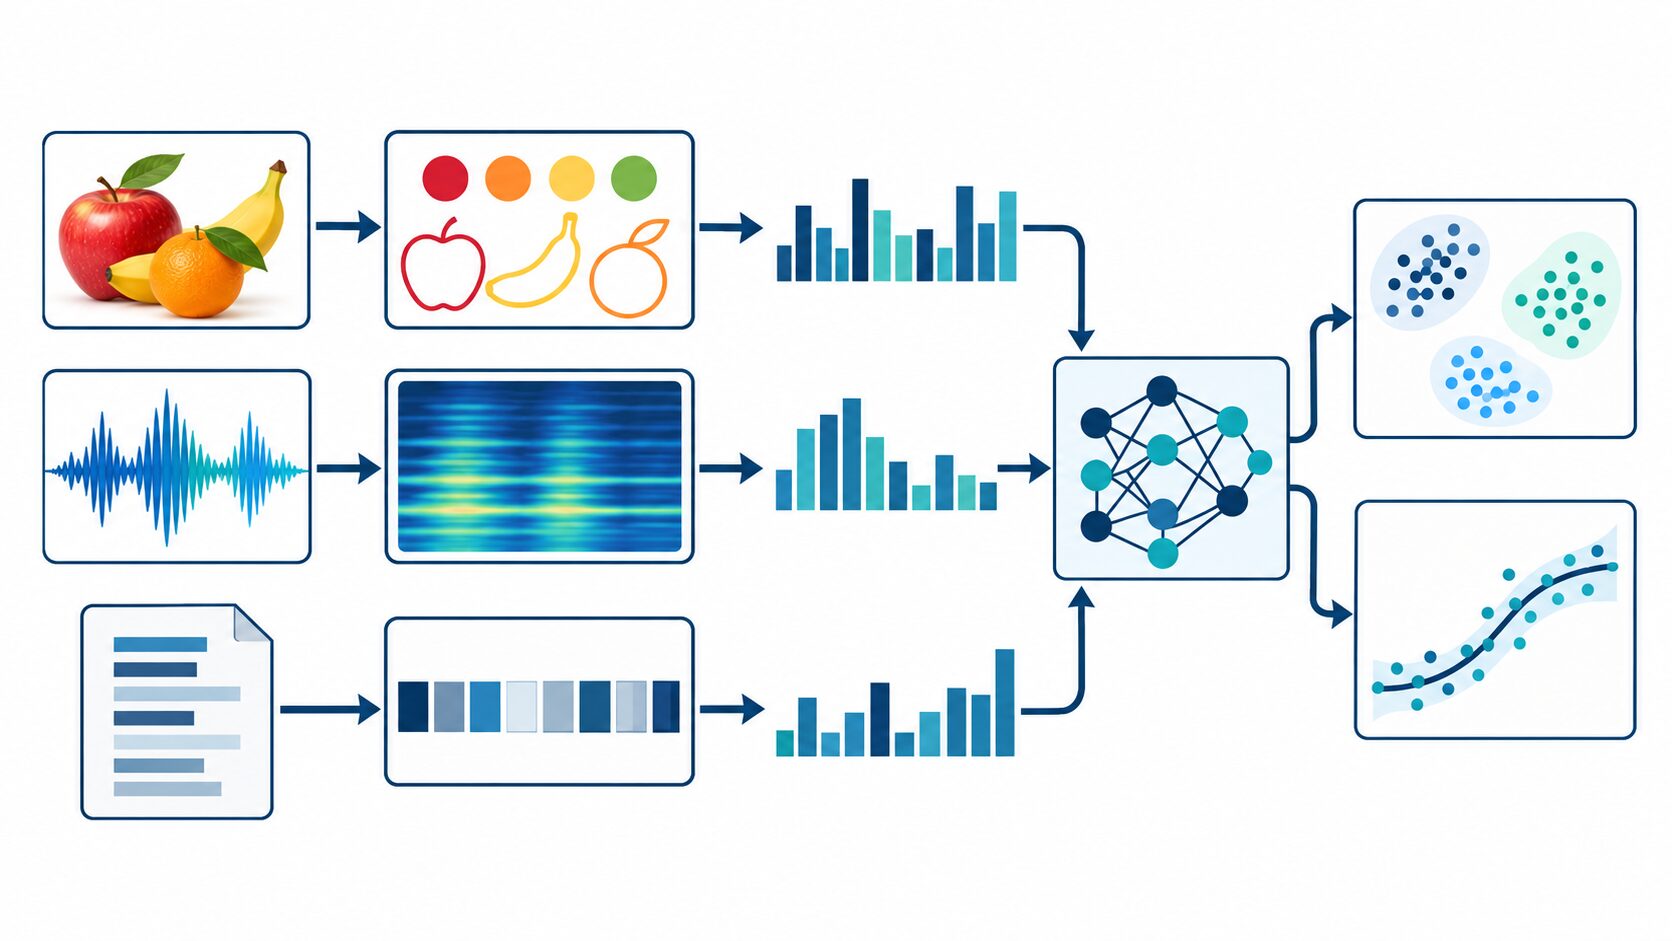
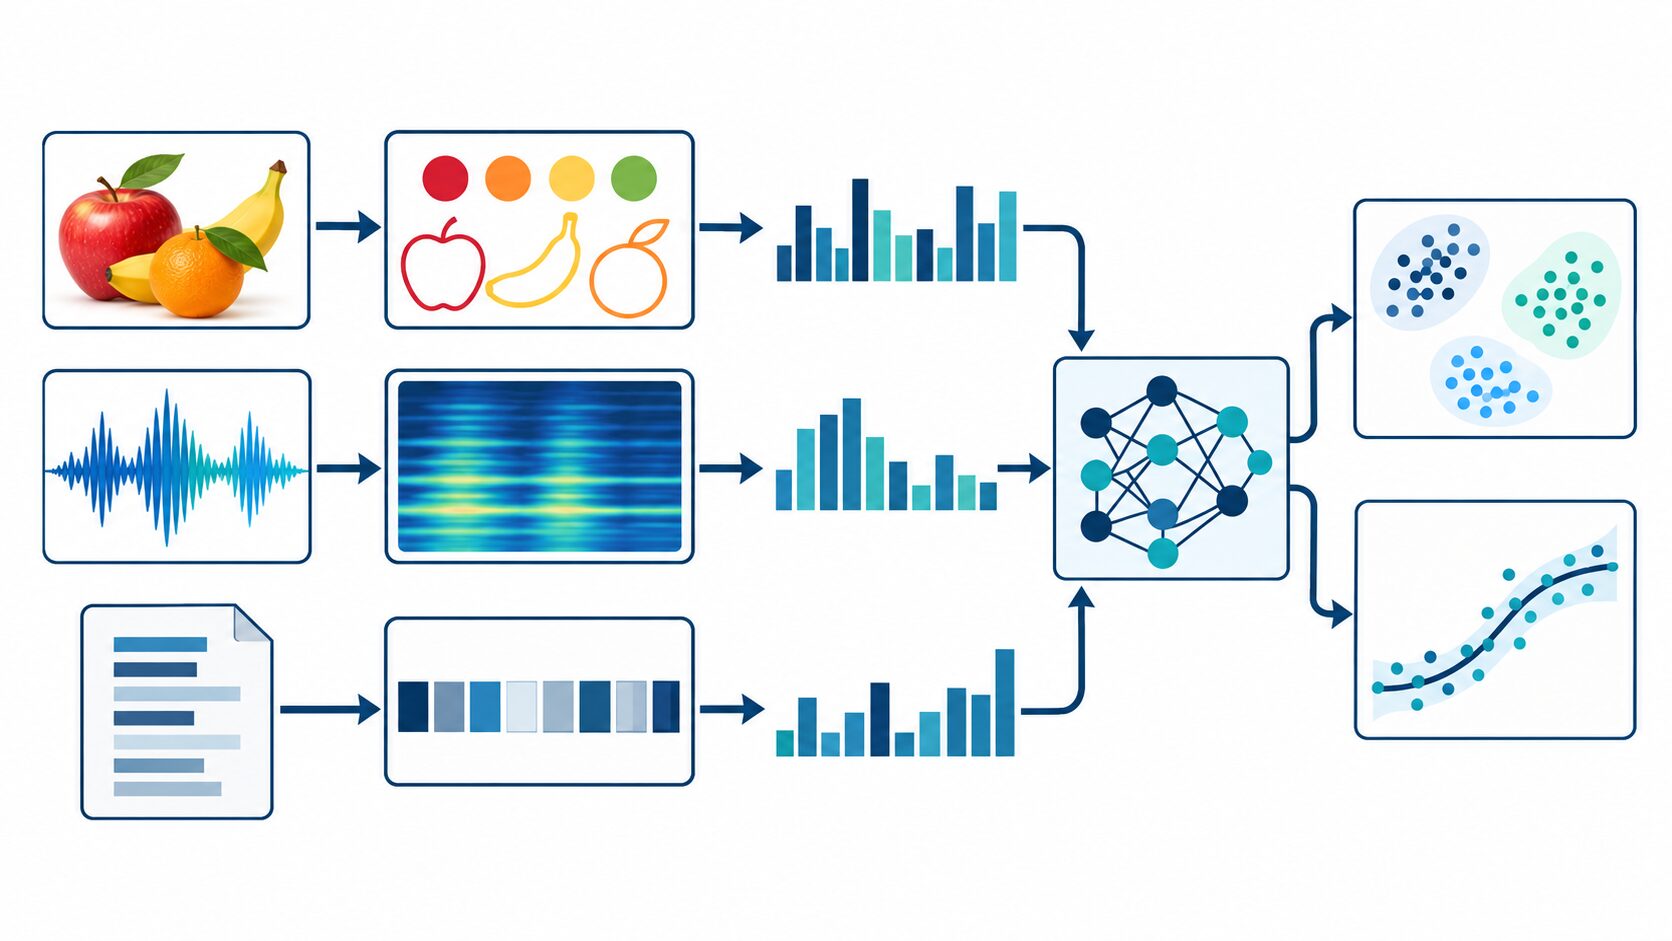
特徴抽出とは、画像・音声・文章などの生データを、分析や予測に使う「特徴量」へ変換する処理です。例えば、写真の色の分布、音声の周波数成分、文章中の単語の出現回数などを数値として表します。必要な情報を単に選び出すだけでなく、計算や学習によって新しい表現をつくる点が重要です。
機械学習を学ぶと、特徴抽出とともに「特徴選択」や「次元削減」という言葉も出てきます。この記事では、果物を見分ける例から特徴量ができる仕組みをたどり、データごとの方法、関連用語との違い、実際に使うときの注意点まで説明します。
画像・音声・文章では処理の方法が異なりますが、データの性質を分析に使える形で表すという役割は共通しています。
特徴抽出とは:データを判断に使える形にする
コンピュータが受け取る写真は、画素ごとの明るさや色を並べたデータです。しかし、その数値の並びに「丸い」「赤い」「表面がざらざらしている」といった性質が、わかりやすい項目として用意されているわけではありません。特徴抽出は、生データを加工して、目的に合う性質を扱いやすく表す役割を担います。
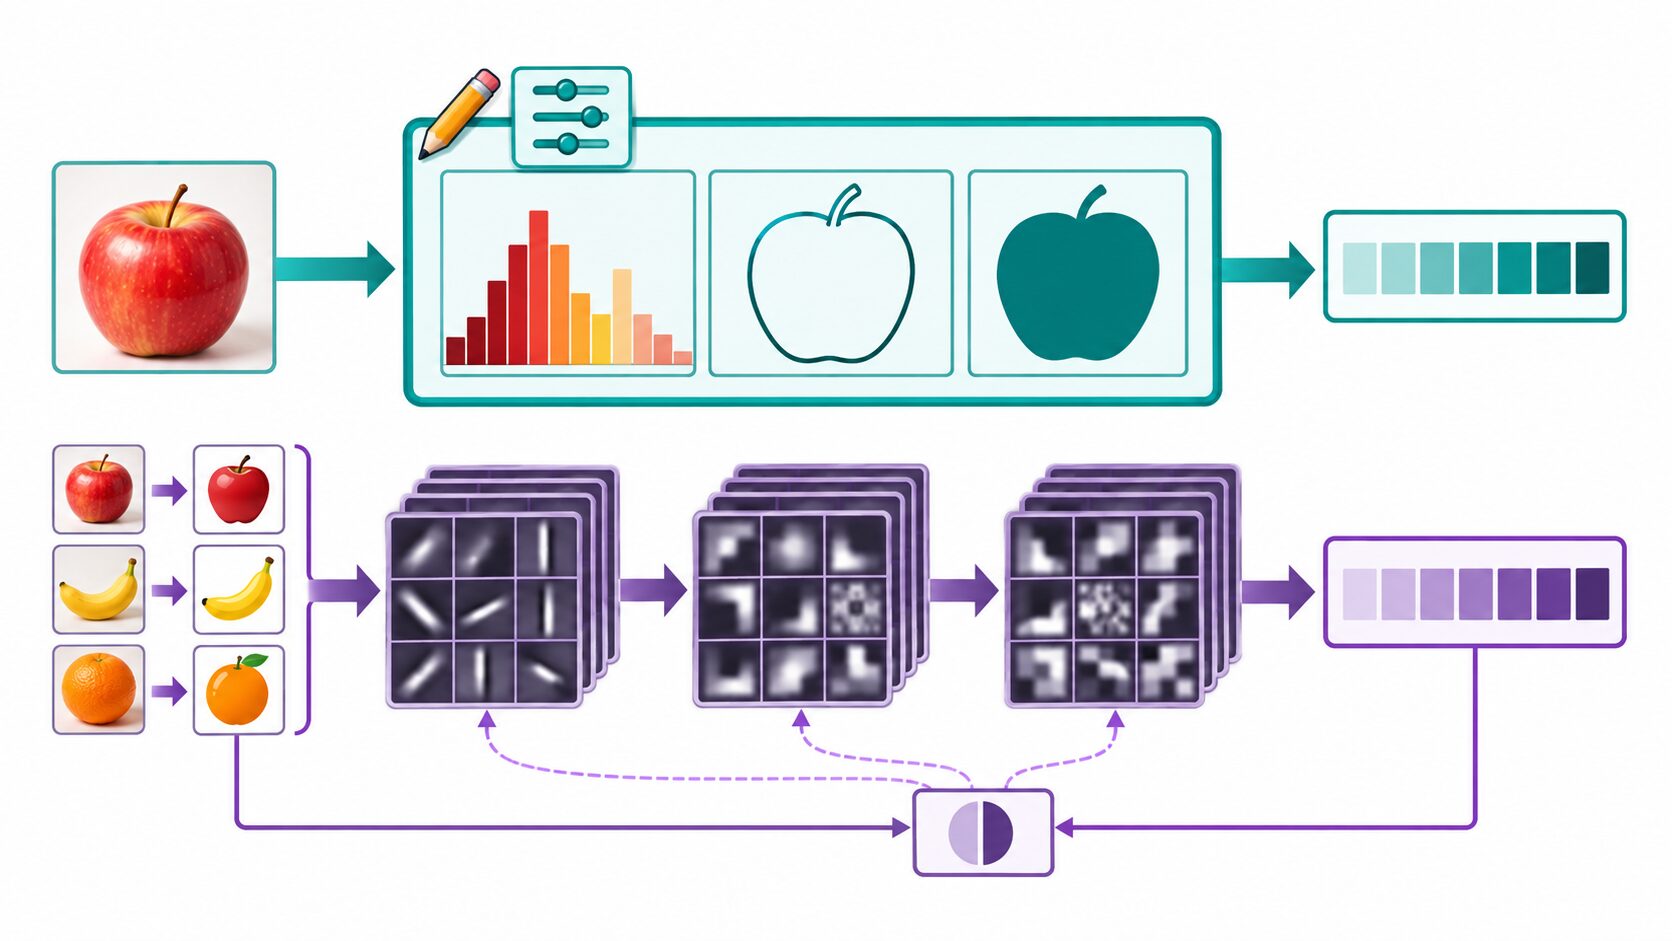
特徴量はデータの性質を表す数値で、複数の特徴量を決まった順番に並べたものを特徴ベクトルと呼びます。りんごの画像なら、赤い画素の割合、輪郭の丸さ、画像内で果物が占める面積の割合などが候補になります。色の分布のように、一つの性質を複数の数値で表すこともあります。
ここで区別したいのが、特徴を取り出すことと、その特徴から答えを決めることです。「赤い部分が多く、輪郭が丸い」という表現をつくるのが特徴抽出で、それをもとに「りんご」と判定するのが分類です。同じ特徴ベクトルを、種類の分類だけでなく、見た目の似た果物を探す検索に使うこともできます。
役に立つ特徴は、何を知りたいかによって変わります。果物の種類を写真から見分けるなら色や輪郭が候補になりますが、品質や出荷後の日持ちを予測するなら、収穫時期や保存条件などの記録が重要になる場合もあります。産地についても、一律に不要とはいえません。画像から得られる性質と、別の記録から得られる情報を区別したうえで、目的に対する有用性を検討します。
また、特徴抽出は必ず情報量や項目数を減らす処理ではありません。一つの測定値から複数の特徴をつくることもあり、変換後の次元数が増える場合もあります。一方で、画像を平均色だけに置き換えると、色の配置や細かな模様は失われます。特徴をつくっただけで、必要な情報が残るとは限らないため、実際の課題で確かめる必要があります。
特徴量をつくり、機械学習へ渡す仕組み
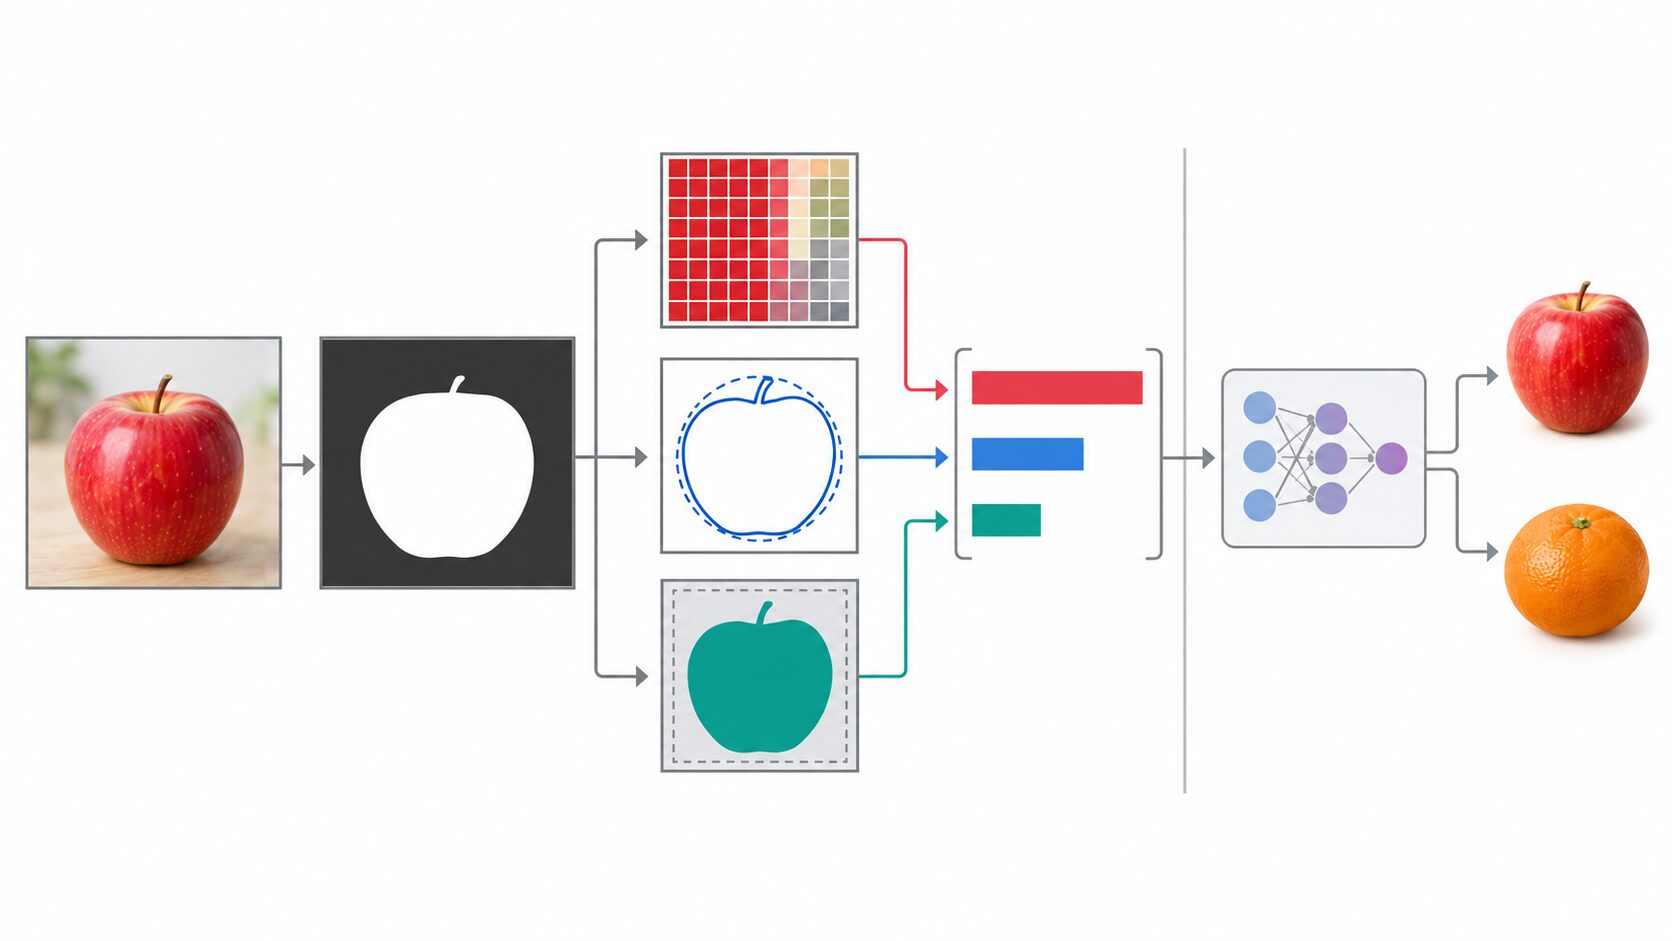
りんごとみかんの画像を分類する場合を考えてみましょう。人が計算方法を設計する特徴抽出では、まず対象をどのように捉え、何を数値にするかを決めます。基本的な流れは次のとおりです。
- 画像と正解を用意する:りんご・みかんの画像に種類のラベルを付け、学習用と評価用に分けます。同じ果物を連続撮影した画像などは、両方に混ざらないようにします。
- 対象領域を取り出す:画像から果物の位置を見つけて切り出したり、果物の画素と背景の画素を区別したりします。色を測るときに背景が混ざらないようにするためです。
- 色や形を計算する:果物領域の赤い画素の割合、輪郭の丸さ、元の画像全体に対する果物領域の面積比などを求めます。
- 特徴ベクトルにまとめる:すべての画像で同じ計算方法と順番を使い、数値を並べます。モデルによっては、数値の尺度をそろえる処理も加えます。
- 分類モデルへ渡す:学習時には特徴ベクトルと正解ラベルの関係を学ばせます。利用時には新しい画像から同じ手順で特徴をつくり、学習済みモデルで種類を予測します。
例えば、赤い画素の割合が0.72、丸さを表す指標が0.86、面積比が0.35なら、この順番で並べた3つの数値が一つの特徴ベクトルになります。これは説明用の値であり、この組み合わせなら必ずりんごになるという意味ではありません。また、丸さの値が何を意味するかは、採用する計算方法によって決まります。
注意したいのは、画像中の面積は、そのまま実物の大きさを示すわけではないことです。カメラに近い果物は大きく写り、切り抜き方を変えても面積比は変わります。実際の大きさを特徴にしたい場合は、撮影距離をそろえたり、長さの基準になる物を一緒に写したりする工夫が必要です。
画像サイズの統一やノイズの軽減など、入力を整える処理は一般に前処理と呼びます。これに対して、色の分布や輪郭の指標をつくるのが特徴抽出です。ただし、対象領域の切り出しを特徴抽出の一部として扱うなど、両者の境界は処理方法や説明の範囲によって重なります。
次の流れでは、色・丸さ・面積比を数値にまとめる段階と、その数値から果物の種類を決める段階を分けています。特徴の計算方法は、学習時と利用時でそろえることが大切です。
有効な特徴ができれば、少ない数値でも違いを捉えやすくなり、学習や予測の負担を抑えられる場合があります。ただし、複雑な特徴を計算する時間が増えることもあります。精度だけでなく、画像の読み込みから特徴抽出、予測までを含む処理時間を測って判断しましょう。
画像・音声・文章に使う特徴抽出の方法
特徴抽出の方法は、データにどのような構造があるかによって変わります。画像なら画素の位置関係、音声なら時間とともに変わる波形、文章なら単語や文脈のつながりを考慮します。どのデータにも同じ特徴を使えばよいわけではありません。
画像では、色の分布・輪郭・模様などを数値化します。例えば、色ごとに画素数を数える「色ヒストグラム」は、どの色がどれくらい含まれているかを表します。明るさが大きく変わる境目を調べると輪郭を捉えられ、細かな濃淡の繰り返しからは表面の模様を表せます。果物の分類や製品表面の検査などで、こうした性質が判断材料になります。
ただし、赤い色だけではりんごを特定できず、耳の形だけで犬と猫を確実に区別することもできません。品種や個体差、見える向きによって特徴が変わるためです。顔画像でも、目・鼻・口の位置関係、顔の輪郭、局所的な模様など、複数の手がかりを使います。何が有効かは、対象や撮影条件と合わせて考える必要があります。
音声では、短い時間区間ごとに周波数成分や音の強さを調べます。音声波形をフーリエ変換などで分析すると、低い周波数から高い周波数まで、どの成分がどれくらい含まれるかを表せます。その時間変化を捉えることで、母音の違いや、太鼓・笛などの楽器音の性質を扱えます。
母音の違いは声の高さだけで決まるものではなく、口や喉の形によって強調される周波数帯などにも表れます。楽器についても、音の高さに加え、鳴り始めの変化や倍音の含まれ方が手がかりになります。周囲の雑音を抑える処理は役立ちますが、音量の変化そのものが重要な課題では、それを消しすぎないようにします。
文章では、単語の出現回数や重み、学習済みモデルによる埋め込みなどを使います。単語の出現回数を並べる方法は仕組みが理解しやすく、どの語が判断に使われたかを確認しやすいのが利点です。TF-IDFは、ある文書内での出現頻度と、文書集合の中での珍しさをもとに語へ重みを付けます。多くの文書に共通する語より、その文書を特徴づける語を目立たせるための方法です。
埋め込みは、単語や文章を、学習済みモデルによって数値の並びへ変換する表現です。文や文章の埋め込みは、意味や用法が近い文章を探す類似検索などに利用されます。ただし、意味を完全に理解していることを保証するものではなく、学習した言語や分野によって得意・不得意があります。
感情分析では、「楽しい」「嬉しい」といった語の数だけを使うと、「楽しいとは思わなかった」のような否定を取り違えることがあります。語順、否定表現、前後の文脈まで必要かを考え、単語の数だけで十分か、より文脈を扱える表現が必要かを選びます。
| データ | 抽出方法の例 | 得られる特徴 | 用途の例 |
|---|---|---|---|
| 画像 | 色ヒストグラム、輪郭や模様の計算 | 色の割合、丸さ、濃淡の変化 | 果物の分類、外観検査 |
| 音声 | 短時間ごとの周波数分析 | 周波数成分の分布、強さの時間変化 | 音声認識、楽器音の分類、設備音の監視 |
| 文章 | 単語の出現回数、TF-IDF | 単語ごとの回数や重み | 文書分類、キーワードに基づく検索 |
| 文章 | 学習済みモデルによる埋め込み | 意味や用法の関係を反映した数値の並び | 類似文章の検索、問い合わせの分類 |
特徴選択・次元削減との違いと重なり
特徴抽出・特徴選択・次元削減は、一緒に使われることも多い言葉です。区別するときは、単に「情報を減らすかどうか」ではなく、どのような操作をするかに注目すると理解しやすくなります。
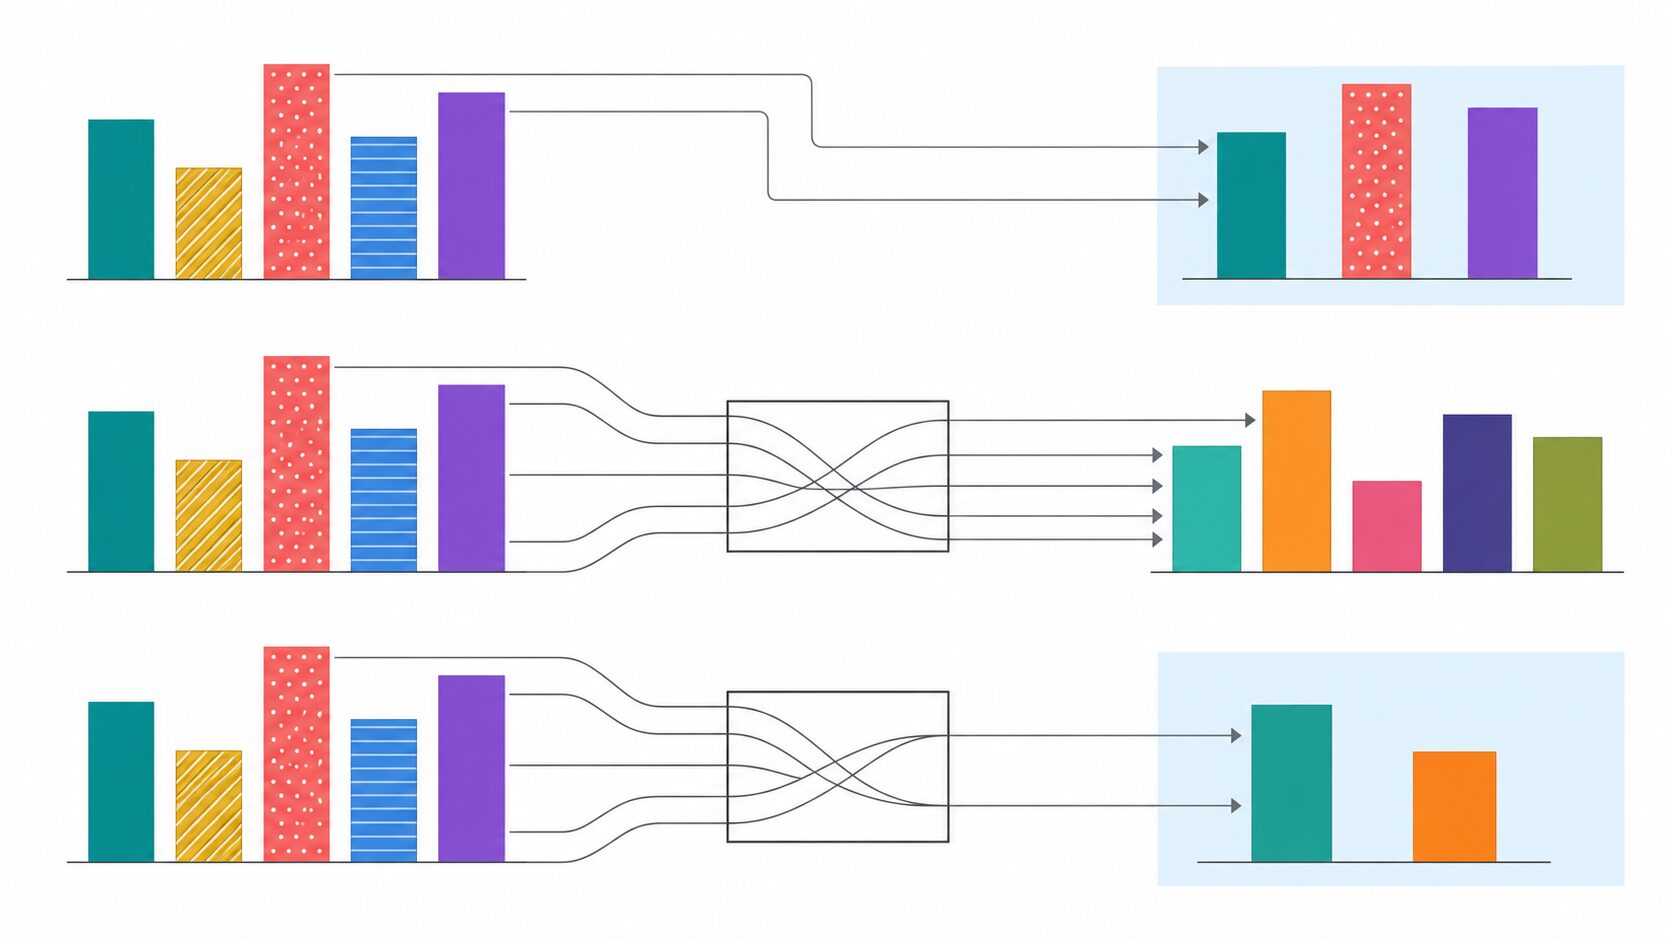
特徴抽出はデータから表現をつくる処理で、特徴選択は用意済みの特徴量から使う項目を選ぶ処理です。果物画像から色の割合や丸さを計算するのは特徴抽出です。その後、「色・丸さ・面積比」の3項目から色と丸さの2項目を選んで使うのは特徴選択に当たります。
次元削減は、データを表す特徴ベクトルの次元数、つまり並んでいる数値の数を減らすことです。特徴選択によって項目を減らす方法も、複数の特徴を組み合わせて少数の新しい特徴へ変換する方法もあります。したがって、次元削減と特徴抽出の目的が完全に別というわけではなく、両者には重なる部分があります。
| 用語 | 主な操作 | 出力の特徴 | 例 |
|---|---|---|---|
| 特徴抽出 | 計算や学習でデータの表現をつくる | 新たな数値表現になる。次元数は減るとは限らない | 画像から色の割合や丸さを計算する |
| 特徴選択 | 既存の特徴量から一部を選ぶ | 残した項目の意味は基本的に変わらない | 色・丸さ・面積比から色と丸さを選ぶ |
| 次元削減 | 選択や変換によって次元数を減らす | 元より少ない数値でデータを表す | 多数の測定値を少数の主成分で表す |
代表例が主成分分析(PCA)です。PCAは複数の変数を重み付きで組み合わせ、データのばらつきが大きい方向を新しい軸としてつくります。その軸に沿って表した数値が主成分得点です。主成分を少数に絞って利用すると、新しい特徴をつくると同時に次元数を減らすため、特徴抽出による次元削減になります。
ただし、通常のPCAは正解ラベルを見ずにばらつきを捉えます。ばらつきの小さい方向に分類の重要な手がかりが含まれていることもあるため、残した分散が大きいほど予測精度も高いとは限りません。また、測定単位の違いで結果が変わるため、必要に応じて各変数の尺度をそろえてから適用します。
以下では、既存の項目を選ぶ操作と、項目を組み合わせて新しい表現をつくる操作を対比しています。どちらも出力の次元数を減らす場合は、次元削減として捉えられます。
なお、次元数とファイルの容量は別の話です。例えば、同じ縦横サイズの画像を圧縮してファイルを小さくしても、読み込んだ後の画素数が減るとは限りません。次元削減では、分析に使う表現の項目数がどう変わるかを確認しましょう。
深層学習による特徴の自動学習
ここまでの果物の例では、人が「色の割合と丸さを計算しよう」と決めていました。これに対して深層学習では、複数の層を持つニューラルネットワークが、学習データと学習の目的に応じて表現のつくり方を調整します。特徴の自動学習は、将来だけの話ではなく、すでに使われている技術です。
画像で使われる畳み込みニューラルネットワーク(CNN)では、近くにある画素の関係を調べながら、層を重ねて表現を変換します。浅い層で局所的な明暗の境目や模様を捉え、深い層でそれらを組み合わせた複雑なパターンを表す傾向があります。特徴抽出を担う部分と、最後に分類する部分をまとめて学習させることもできます。
ただし、内部の各数値に「耳の形」「りんごの赤さ」といった、人が理解できる名前が一つずつ付くわけではありません。多数の数値の組み合わせとして性質を表すため、設計した特徴量に比べて判断材料を説明しにくい場合があります。予測が合っているかに加え、何に反応しているかを調べることも大切です。
人が設計する方法では、測りたい性質と計算方法を直接指定します。モデルが学ぶ方法では、データと学習の目的から表現が調整されます。この違いを押さえると、それぞれの特徴を使い分けやすくなります。
学習済みモデルの途中の層の出力や、特徴ベクトルとして用意された出力を利用する方法もあります。例えば、画像を学習済みモデルへ入力して得たベクトルを使い、手元のデータ向けに別の分類モデルを学習させたり、似た画像を探したりできます。すべてを最初から学習する負担を減らせますが、元の学習データと利用先の画像が大きく異なると、十分な性能が得られないこともあります。
自動化されるのは表現を学ぶ過程の一部です。何を予測するか、どのデータを集めるか、どう評価するかは設計が必要です。特徴抽出の進歩だけから、将来のAIの能力や技術的特異点の実現を断定することはできません。まずは具体的な課題で、必要な情報を捉えられているかを確かめることが重要です。
特徴抽出が役立つ場面
特徴抽出は、種類を分類する場合だけでなく、異常を見つける、似たものを探す、データ全体の傾向を調べるといった場面でも役立ちます。利用目的によって、何を残すべきか、どのように良し悪しを測るかが変わります。
製品表面の外観検査:傷や汚れを見つけるには、局所的な輪郭、色のむら、表面の模様などが手がかりになります。正常な製品でも照明や反射によって見え方が変わるため、製品の違いと撮影条件の違いを区別できる特徴が必要です。評価では、不良品の見逃しと、正常品を不良と判定する誤りを分けて確認します。
設備音の異常検知:モーターなどの稼働音から周波数成分やその変化を取り出し、通常の運転音との違いを調べます。回転速度や負荷が変わっても音は変わるため、正常な条件の幅を捉えておくことが大切です。異常音を検知できるかだけでなく、正常運転中に誤った警報が頻発しないかも評価します。
文章の類似検索:問い合わせ文や社内文書をTF-IDFや埋め込みで表し、数値表現の近さを使って候補を探します。キーワードの一致を重視するのか、言い換えを含む意味の近さを重視するのかで、適した方法は変わります。検索結果の上位に、実際に役立つ文書が並ぶかを確認します。
医用画像の解析支援:画像内の領域の形や模様、学習によって得られる表現を、領域の分類や候補箇所の提示などに使うことがあります。ただし、有効な特徴が得られたことだけで、病気の早期発見や診断性能が保証されるわけではありません。撮影装置や対象集団の違いを含め、用途に応じた検証が必要です。
傾向把握では、特徴量の分布や、少数の次元へ変換したデータを可視化し、似た事例のまとまりを探す使い方もあります。ただし、見た目で分かれた集団がそのまま意味のある分類になるとは限りません。先に利用目的を決め、その目的に合う特徴と評価方法を組み合わせることが、活用の出発点になります。
特徴抽出で失敗しないための注意点
特徴抽出で重要なのは、手元のデータに合う数値をつくることだけではありません。新しいデータでも使える性質を捉えられているかを確認する必要があります。特に、判断対象とは直接関係のない手がかりに頼っていないか注意しましょう。
例えば、学習画像でりんごがいつも白い台に、みかんがいつも黒い台に置かれていたとします。背景を含む画像から特徴をつくると、果物の違いより台の色を使うほうが簡単に分類できてしまいます。同じ撮影環境の画像では正解が多くても、台の色が変わった途端に誤る可能性があります。
背景と種類の結び付きは、評価用の画像にも残っていると見逃しやすくなります。背景を変えた画像や、撮影場所・時期の異なる画像でも確かめることが大切です。
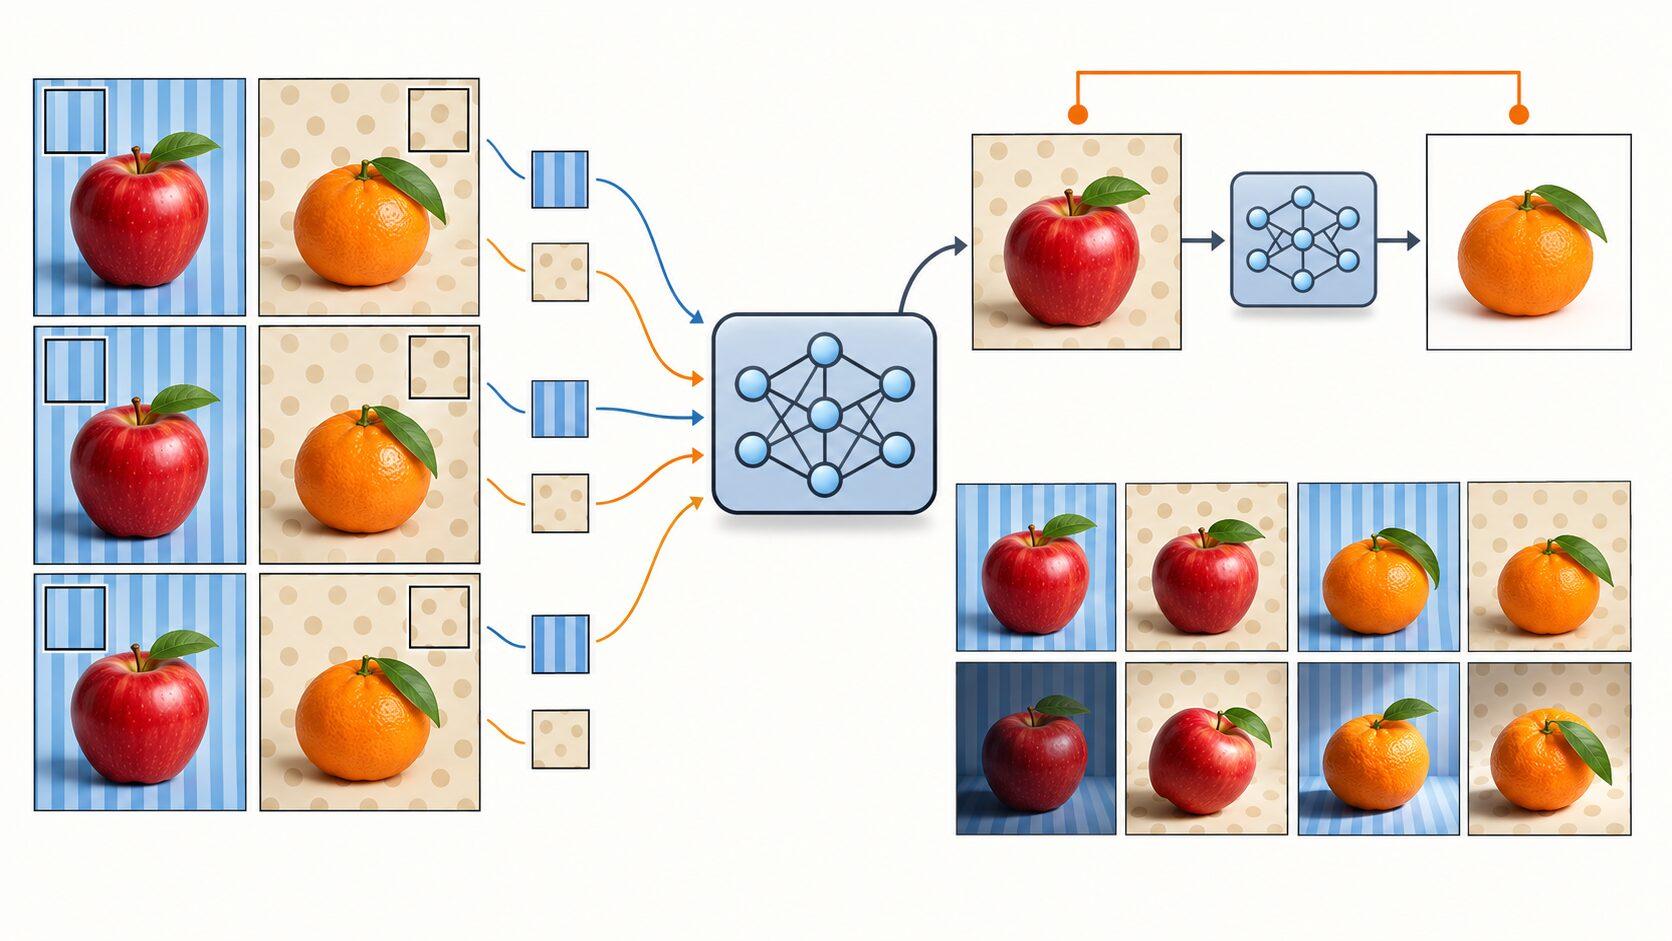
背景以外にも、照明、品種、撮影の向き、解像度などによって特徴量は変わります。色を使うなら照明の違い、輪郭を使うなら一部が隠れた場合、音声を使うなら録音機器や周囲の音の違いを含め、実際の利用条件に近いデータで評価します。
何を除くかは、目的に応じて決めます。顔全体の形や肌の色、音声の音量などを、どの課題でも不要と決めつけることはできません。例えば、顔の輪郭が手がかりになる分析もあれば、音の強さの変化が重要な設備監視もあります。一方で、肌の色などに不必要に依存すると、対象集団による性能差や偏りにつながるおそれがあります。関連がありそうという理由だけで採用せず、必要性と影響を確認します。
データは先に学習用と評価用へ分けます。平均や標準偏差を使う標準化、PCA、TF-IDFの語彙や重みの決定、特徴選択など、データからルールを決める処理は学習用だけで調整します。評価用には、そこで決めたルールをそのまま適用します。全データを使って変換を調整すると、評価用の情報が学習側へ入り込む「情報漏洩(データリーケージ)」が起こり、実力より良く見えることがあります。
交差検証を使う場合も、各回の学習部分だけで変換を調整します。また、同じ対象の類似画像が学習用と評価用に分かれていないか、予測する時点ではまだ得られない情報を特徴に含めていないかも確認します。手法を選ぶために使った検証データとは別に、最終確認用のデータを確保すると、調整のしすぎを見つけやすくなります。
特徴を増やした分だけ良くなるとは限りません。関係の薄い特徴や似た特徴を大量に加えると、計算負担が増えたり、学習データの偶然に合わせすぎる過学習が起きたりします。まずは色の分布など少数の特徴を基準にし、形や模様を加えたときに未知のデータで精度が改善するかを比べます。特徴抽出を含む処理時間、情報の欠落、条件ごとの誤り方も併せて確認しましょう。
特徴抽出を理解するには、「何を数値にしたか」「その変換で何が失われたか」「新しいデータでも役立つか」をたどることが有効です。手法の名前を覚えるだけでなく、目的と特徴量の対応を説明できるようになると、機械学習やデータ分析での使いどころを判断しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月20日 | 特徴選択・次元削減との関係を見直し、抽出手順と情報漏洩の注意点を補足 |