
ウォード法とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「ウォード法」って、どのようにデータをグループ分けする方法ですか?似たもの同士をまとめると聞いたのですが、何を比べるのでしょうか。

AI専門家
グループの中で、データが平均からどのくらい離れているかを比べるんだ。最初は一つのデータを一つのグループとして扱い、まとめたときにばらつきが最も増えにくい二つのグループを選んでいくよ。
AIの初心者
ばらつきが増えにくい、とはどういうことですか?グループの数も先に決めるのでしょうか。
AI専門家
例えば身長なら、近い身長の人をまとめると、グループの平均からのずれは小さくなるよね。ウォード法は、そのずれを二乗して足し合わせた値の増え方を比べるんだ。グループ数は必ずしも先に決めなくてよく、まとまっていく過程を樹形図で見て、目的に合う数を選べるよ。
ウォード法は、グループ内のばらつきの増加が最小になる組を順に結合する、階層的クラスタリングの手法です。顧客の購買傾向や製品の特性など、複数の数値から似た対象をまとめ、データ全体の構造を調べるために使います。
理解の要点は、「何を似ているとみなすか」と「どの段階でグループ分けを確定するか」です。小さな数値例で結合の計算を確かめたうえで、樹形図の読み方、他の手法との違い、実務での注意点を見ていきましょう。
ウォード法とは:似たデータをまとめる階層的手法
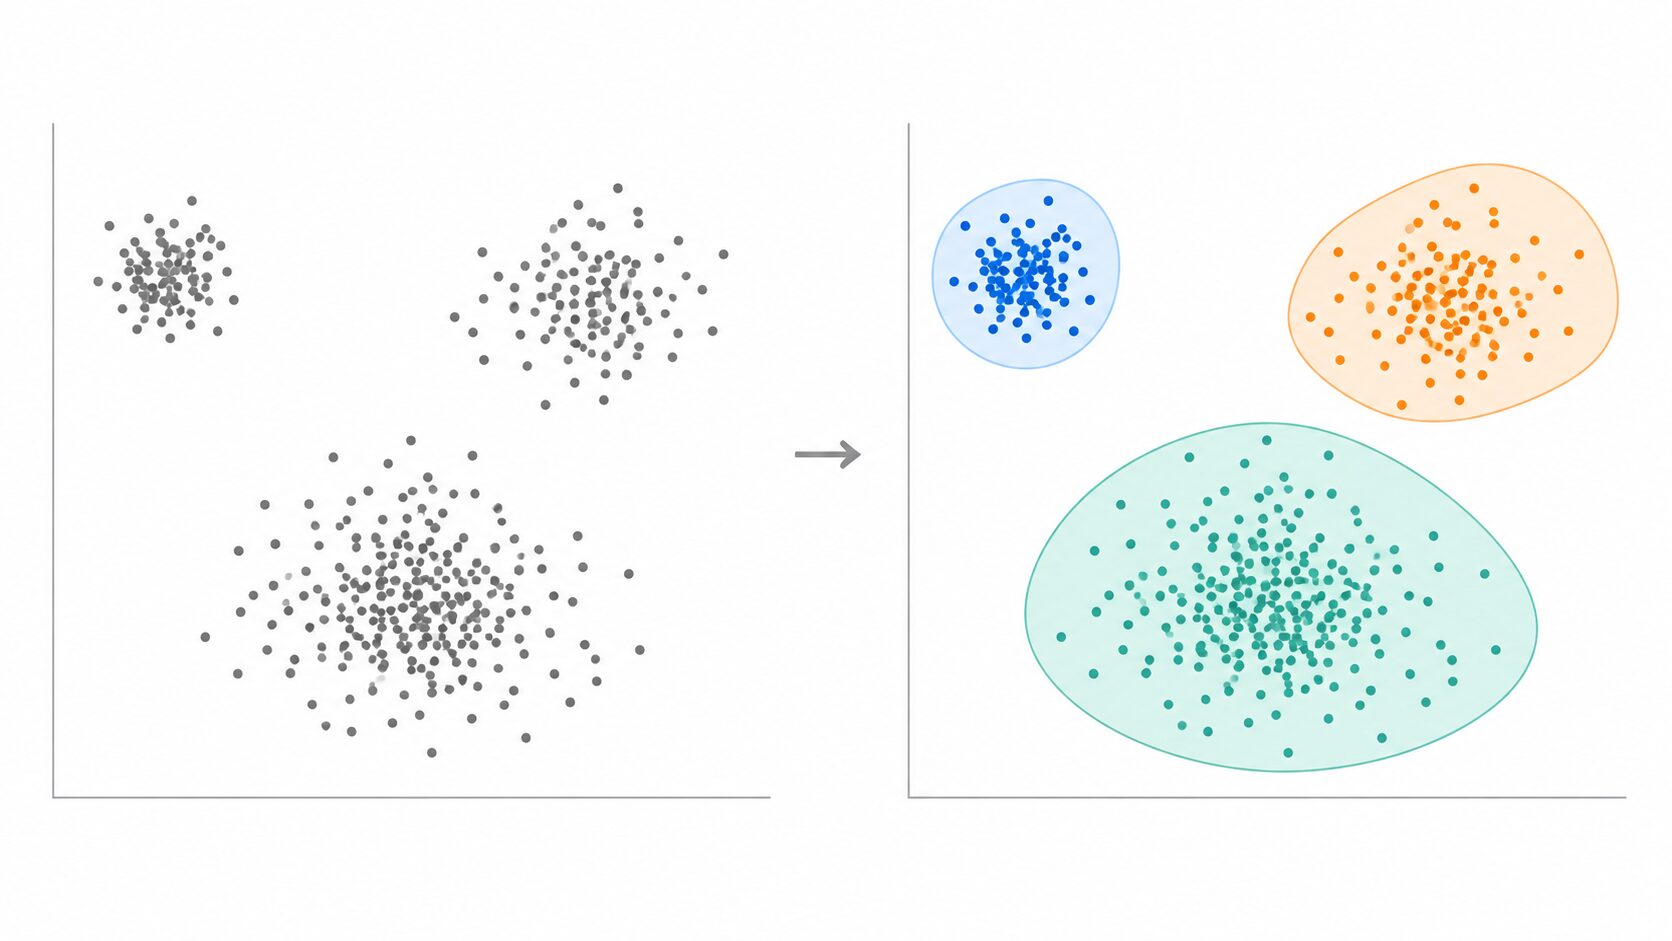
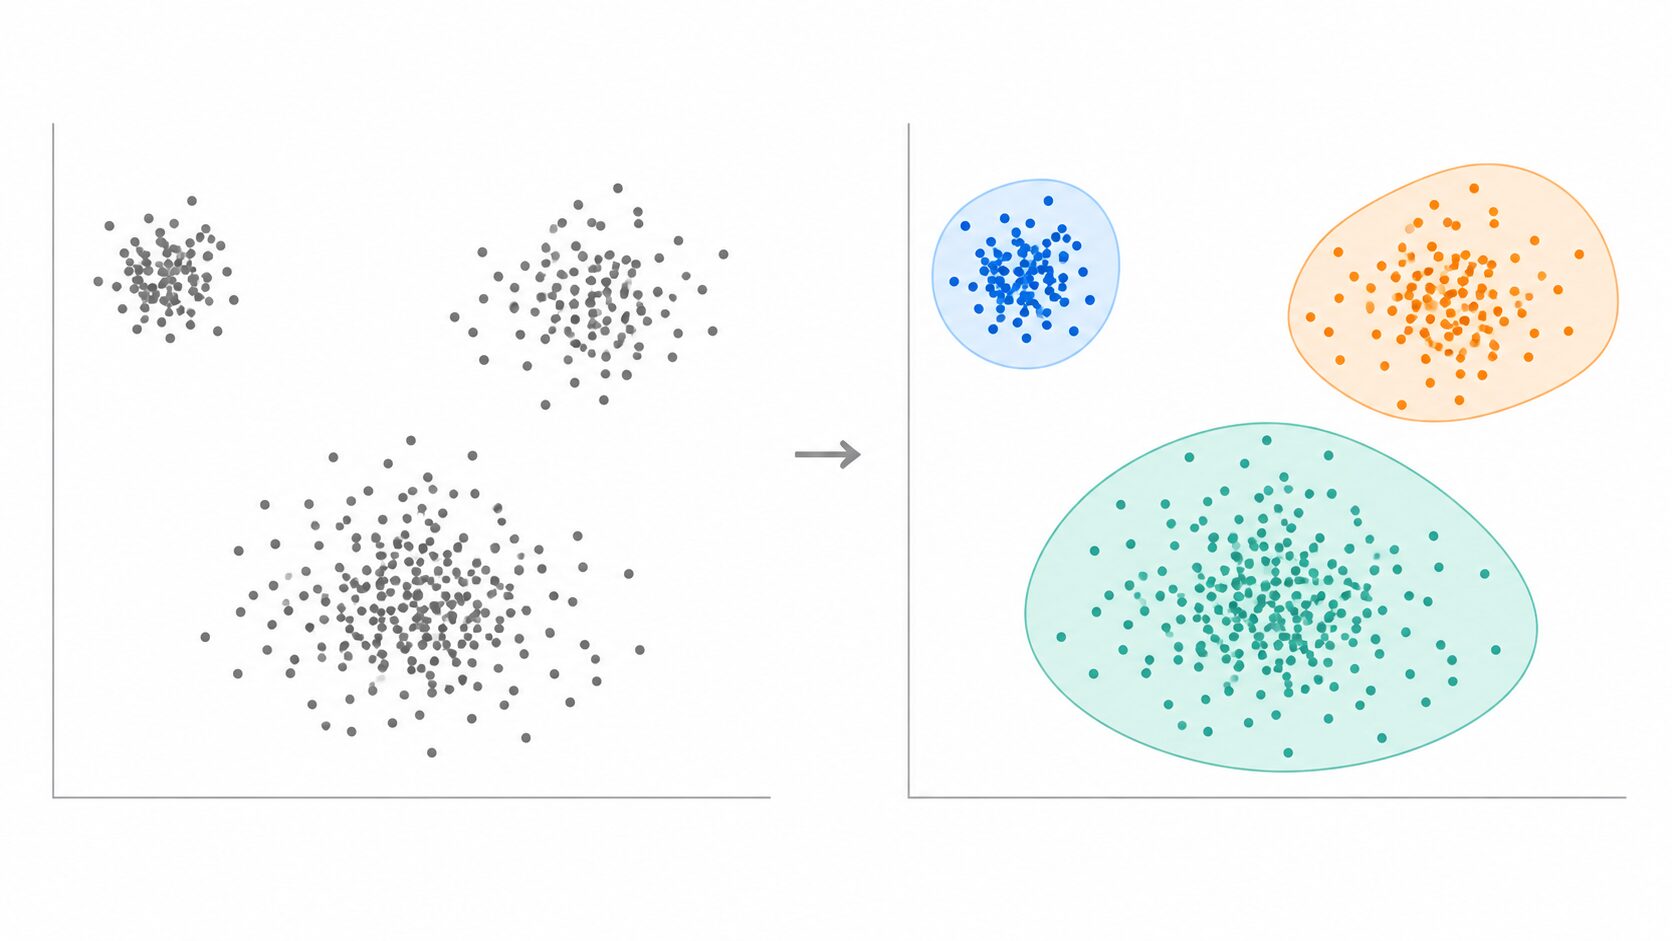
クラスタリングとは、データの特徴をもとに、似た対象をクラスターと呼ばれる集団へまとめることです。あらかじめ「この顧客はこのグループ」といった正解ラベルを用意せずに構造を探るため、機械学習では教師なし学習に位置づけられます。
日常語では「分類」と表現することもありますが、既知のラベルを予測する教師あり学習の分類とは目的が異なります。例えば、過去にラベルを付けた迷惑メールから新しいメールの種類を予測するのが分類です。一方、顧客の購入回数や購入金額から、どのような購買傾向の集団があるかを探すのがクラスタリングです。
ウォード法は、小さな集団を二つずつまとめる「凝集型」の階層的クラスタリングで使う結合基準の一つです。最初は各データが独立したクラスターで、結合を一回行うごとにクラスター数が一つ減ります。全体が一群になるまで続けると、小さなまとまりが大きなまとまりに含まれる階層ができ、この過程を樹形図で確認できます。
中心からのばらつきを抑えるため、ウォード法は中心の周囲に比較的コンパクトに集まったクラスターを作りやすい傾向があります。大きさが極端に偏らない結果になることもありますが、人数を均等にする制約はありません。例えば100人の顧客を4群に分けても、各群が25人になるとは限らず、選んだ特徴量や分布に応じて人数は変わります。
偏差平方和の増加で結合先を決める仕組み
ばらつきの指標となるクラスター内偏差平方和は、次のように表せます。
\(S(C)=\sum_{x_i\in C}\|x_i-\mu_C\|^2\)ここで、\(C\) は一つのクラスター、\(x_i\) はその中のデータ、\(\mu_C\) はクラスターの平均です。\(\|x_i-\mu_C\|^2\) は、データから平均までのユークリッド距離の二乗を表します。身長だけなら「身長と平均身長の差の二乗」であり、特徴量が複数なら、それぞれの特徴量について平均との差を二乗し、足し合わせます。
偏差平方和は、平均からのずれが大きいほど大きくなります。分散と関連する量ですが、ここではデータ数で割らず、二乗したずれの合計を使います。さらに全クラスターの偏差平方和を足した値を、分割全体のばらつきとして考えます。
二つのクラスター \(A\) と \(B\) をまとめると、平均が変わり、偏差平方和も変化します。ウォード法が比べるのは結合後の値だけではなく、結合前と比べて偏差平方和がどれだけ増えるかです。結合しないクラスターの値は変わらないため、候補となる二群だけを計算すれば、全体の増加量も分かります。
\(\Delta(A,B)=S(A\cup B)-S(A)-S(B)=\frac{n_A n_B}{n_A+n_B}\|\mu_A-\mu_B\|^2\)\(n_A\) と \(n_B\) は各群のデータ数、\(\mu_A\) と \(\mu_B\) は各群の平均です。式には平均どうしの距離とデータ数の両方が含まれています。したがって、単に中心が最も近い二群を選ぶ方法とは異なり、中心間の距離が同じでも、群の大きさによって結合の増加量は変わります。
一次元のデータ「1・2・6・8」で考えてみましょう。最初はすべて単独のクラスターなので、各データは自分自身が平均となり、偏差平方和は0です。1と2を結合すると平均は1.5になり、増加量は次のようになります。
\((1-1.5)^2+(2-1.5)^2=0.5\)同様に6と8を結合すると平均は7で、増加量は2です。最初の段階で考えられるすべての組を比較すると、以下のようになります。
| 結合するデータ | 結合後の平均 | 偏差平方和の増加量 |
|---|---|---|
| 1と2 | 1.5 | 0.5 |
| 1と6 | 3.5 | 12.5 |
| 1と8 | 4.5 | 24.5 |
| 2と6 | 4 | 8 |
| 2と8 | 5 | 18 |
| 6と8 | 7 | 2 |
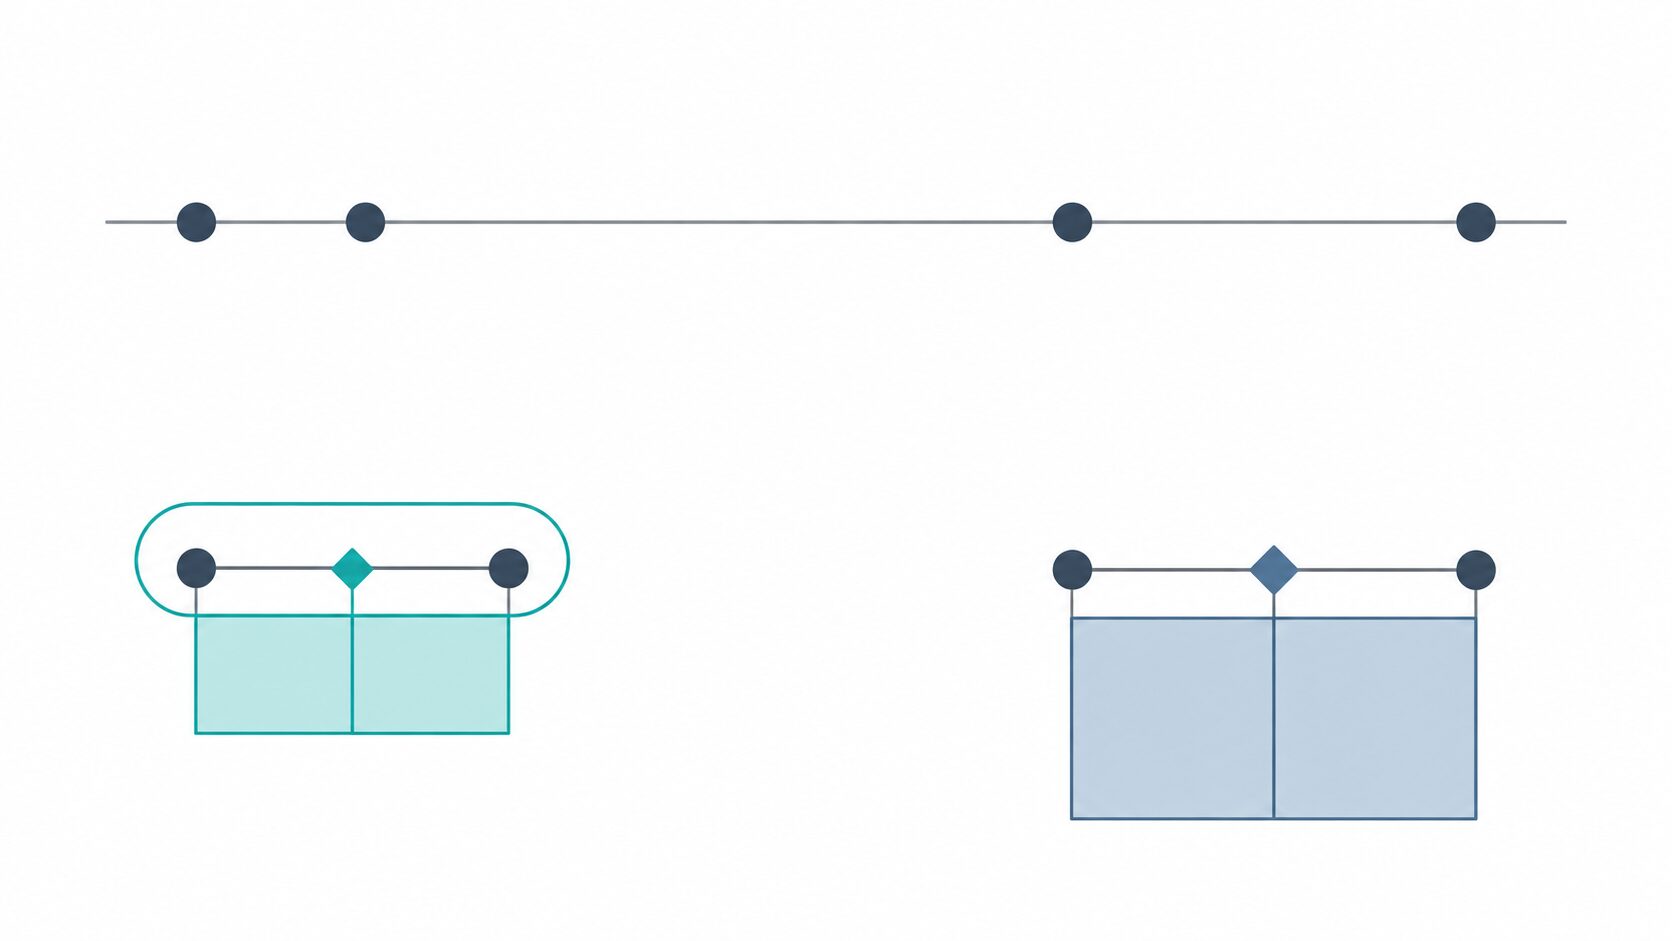
最も増加量が小さいのは1と2なので、まずこの二つを結合します。その後は、できた群を一つの候補として、残りの群との増加量を計算し直します。「1・2」の群と6をまとめる増加量は13.5なので、この例では増加量2の6と8の結合が次に選ばれます。
このように、その時点で最も増加量の小さい組を選ぶ方法を「貪欲な手順」と呼びます。一度結合した群を後から分け直すことはありません。そのため、各段階で増加を抑えていても、任意のクラスター数について、考えられるすべての分け方の中で偏差平方和が最小になる保証はありません。
樹形図の読み方とクラスター数の決め方
樹形図は、データがどの順番で同じクラスターになったかを枝分かれで示す図で、デンドログラムとも呼ばれます。下から上へ結合が進む向きの図なら、下端の「葉」が個々の対象、枝の合流点が二群の結合を表します。低い位置で合流した対象ほど、その段階で小さな結合コストでまとめられたと読めます。
先ほどの1・2・6・8では、まず1と2、次に6と8がまとまり、最後に「1・2」と「6・8」が結合します。樹形図に横線を引き、その線を横切る枝を数えると、切った位置でのクラスター数が分かります。同じ枝につながる葉をたどれば、それぞれの群にどの対象が含まれるかも確認できます。
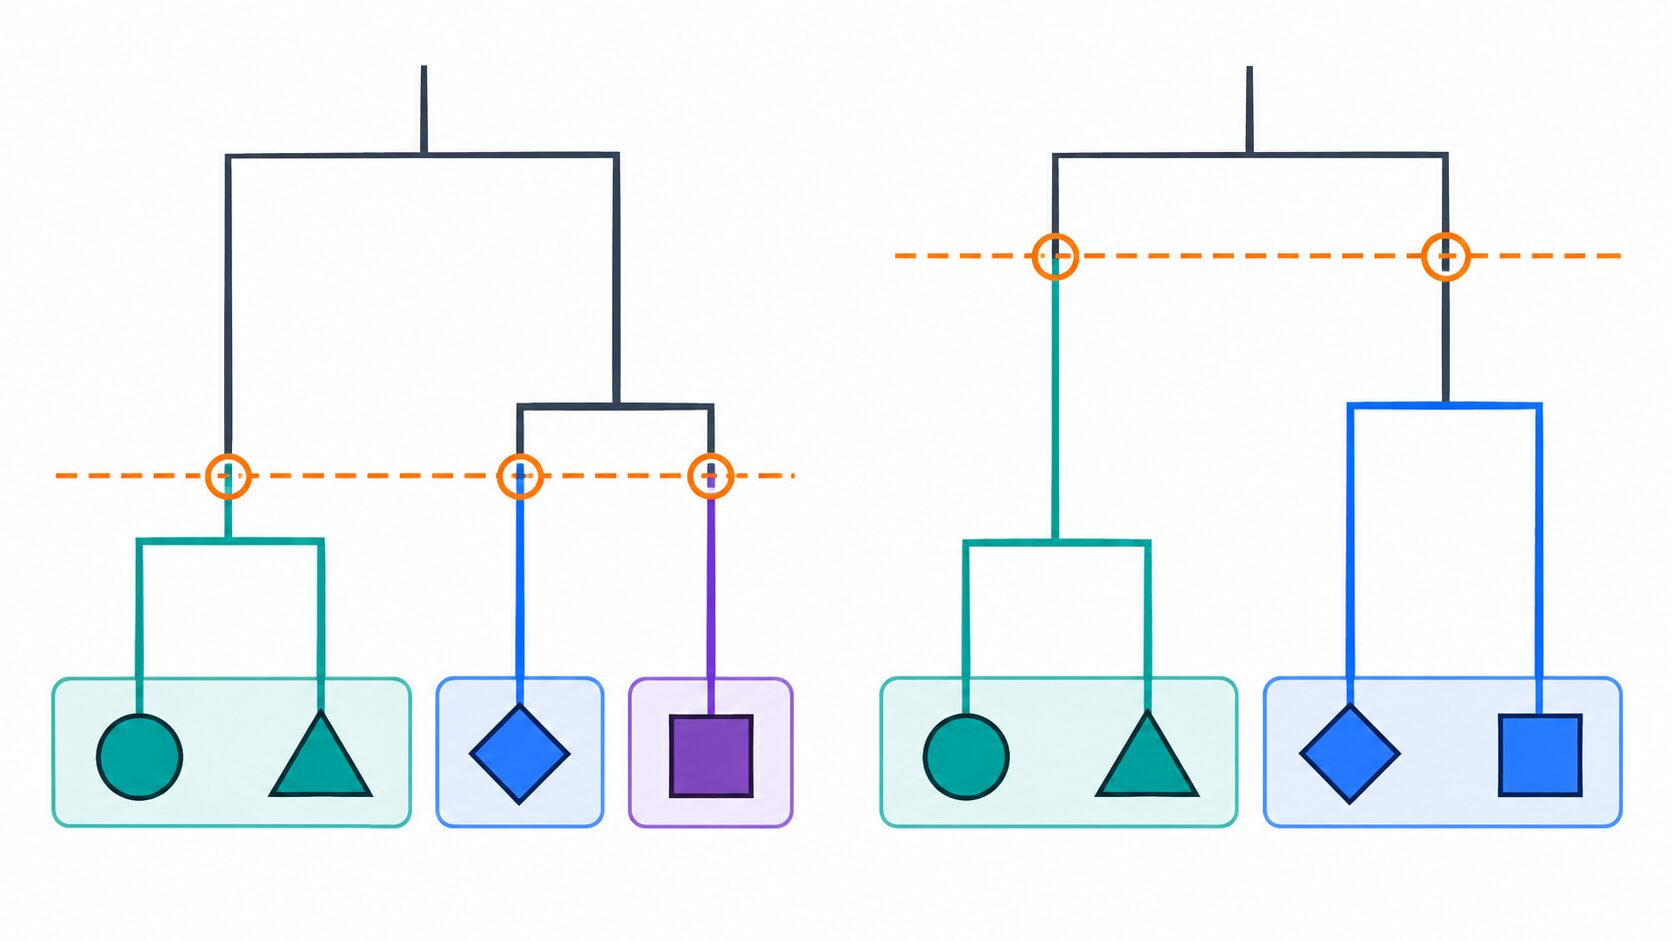
結合の増加量をそのまま高さにした場合、この例の結合高さは順に0.5、2、30.25です。高さ0.5と2の間で切れば「1・2」「6」「8」の三群、高さ2と30.25の間で切れば「1・2」「6・8」の二群になります。最後の結合で高さが大きく上がるため、その直前で切る二群の分け方は、有力な候補と考えられます。
ただし、縦軸の数値が偏差平方和の増加量そのものか、平方根などで変換した値かは、使用する実装によって異なります。ソフトウェアで描いた図の数値が手計算と違うときは、軸と結合基準の定義を確認してください。また、葉の横方向の並びは枝を入れ替えても表現できるため、横に隣り合っていることだけでは類似度を判断できません。
クラスター数を事前に固定せず、複数の切り方を比較できる点は階層的手法の利点です。ただし、高さの急増だけで数を決定する必要はありません。顧客向け施策なら運用できる群数か、各群に十分な人数がいるか、群の特徴を説明できるかも検討します。対象期間や特徴量を少し変えたときにも似た集団が現れるかを確かめると、結果の安定性を判断する材料になります。
最短距離法・最長距離法・k-meansとの違い
階層的クラスタリングでも、どの二群を結合するかの基準が変われば結果も変わります。代表的な最短距離法・最長距離法に加え、同じく中心からのばらつきを使うk-meansとの違いを整理します。
| 手法 | 結合・分割の基準 | 階層の有無 | 特徴 |
|---|---|---|---|
| ウォード法 | 結合によるクラスター内偏差平方和の増加が最小の二群を選ぶ | あり | 中心の周囲にまとまった群を作りやすく、群の大きさも結合に影響する |
| 最短距離法 | 二群の間で最も近い点どうしの距離を求め、その値が最小の二群を選ぶ | あり | 近い点を介して、データが鎖状につながりやすい |
| 最長距離法 | 二群の間で最も遠い点どうしの距離を求め、その値が最小の二群を選ぶ | あり | 群間の最遠点の距離に着目して結合する |
| k-means | 通常は先に群数を指定し、クラスター内偏差平方和を抑えるように所属と中心を反復更新する | なし | 初期の中心の置き方によって結果が変わることがある |
例えば二つの大きな集団の間に、少数の点が橋のように並んでいるとします。最短距離法では近い点どうしのつながりがあれば結合が進むため、離れた集団まで一つにつながることがあります。これが「鎖状効果」です。最長距離法では、二群をまたぐ最も遠い点の距離が判断に使われるため、近い点が一組あるだけでは結合されやすいとは限りません。
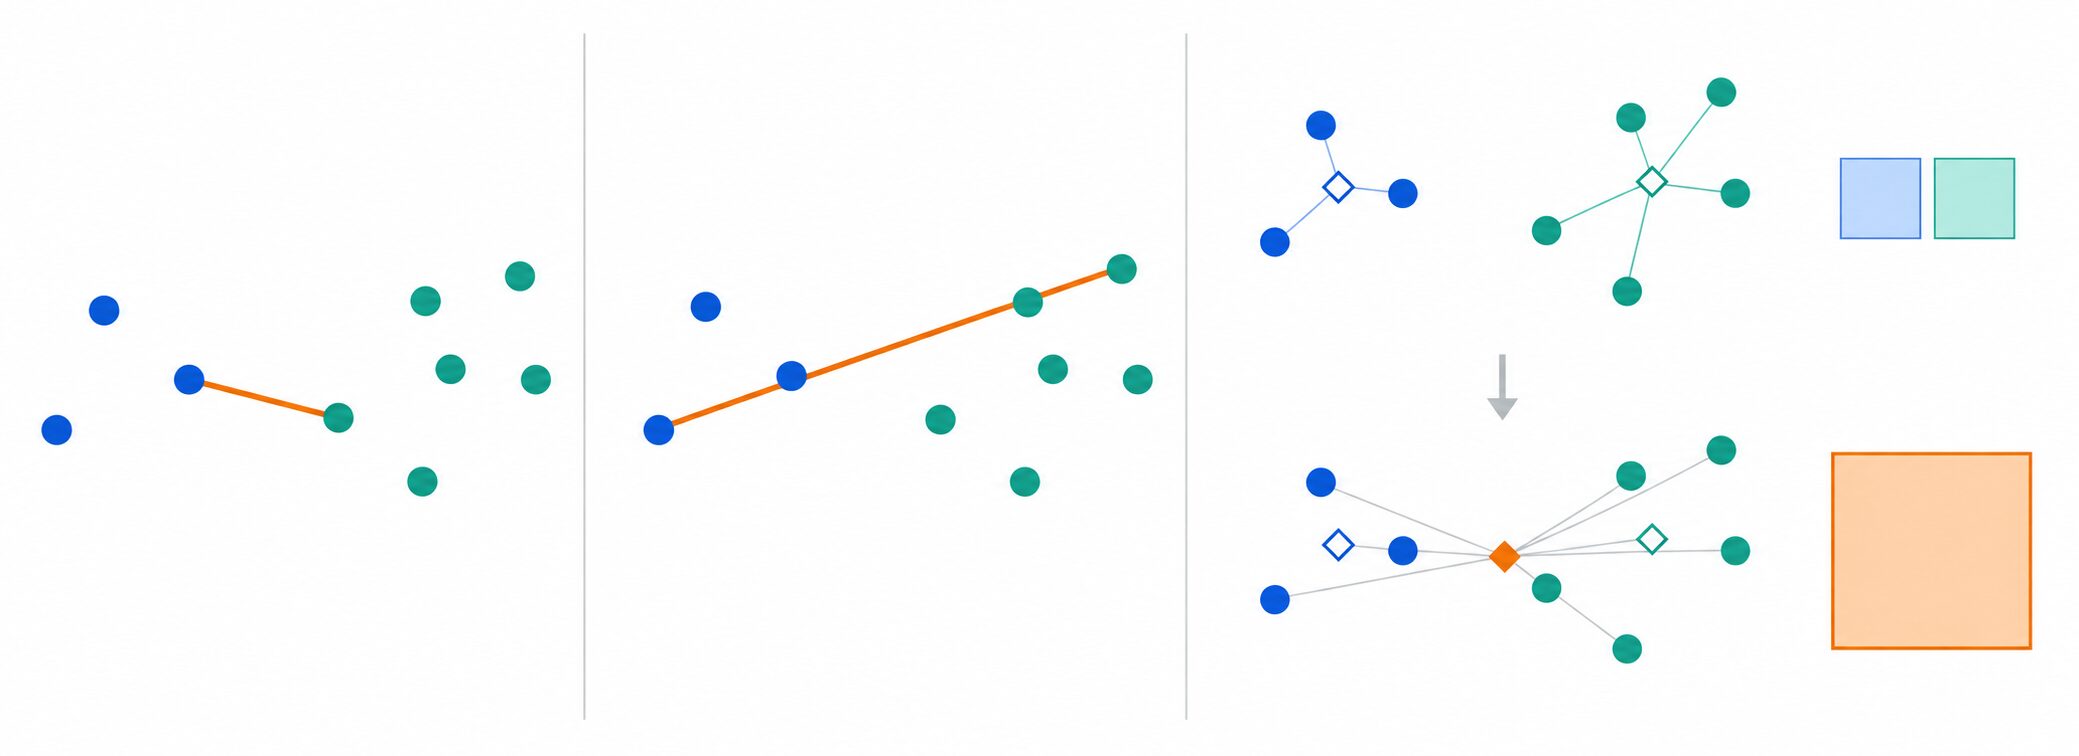
これらに対し、ウォード法は特定の一組の点ではなく、群の平均とデータ数を通じて、結合に伴うばらつきの増加を評価します。どの基準が適切かは、連続したつながりを見つけたいのか、中心の近くにまとまる集団を作りたいのか、といった目的によって変わります。
k-meansもクラスター内偏差平方和を抑えますが、ウォード法は結合を積み重ね、k-meansは各データの所属と中心を更新するという違いがあります。k-meansでは途中で所属先を変えられる一方、結合の履歴を示す樹形図は作りません。同じデータを同じ群数に分けても、両者の結果が一致するとは限らず、どちらも常に全体で最良の分割を見つけるわけではありません。
顧客分析などでの活用と結果の読み解き方
ウォード法は、すでに決めた区分に対象を当てはめるよりも、「データの中にどのような集団があるか」を探索する場面に向いています。顧客分析であれば、購入頻度や購入金額などの違いから集団を見つけ、それぞれに合う商品案内や販売促進の仮説を立てる材料になります。
例えば、直近6か月の購買傾向を調べるなら、次のように分析を進めます。
- 比較する特徴量を決める:顧客ごとに購入回数、合計購入金額、最終購入からの日数などを用意します。集計期間をそろえ、新規顧客のように観測期間が短い対象をどう扱うかも決めます。
- 分析に使える状態へ整える:欠損や入力誤りを確認し、金額と回数の尺度を調整します。似た情報を持つ特徴量を重ねすぎると、その側面が強く反映されることにも注意します。
- 結合過程を見て群数を選ぶ:ウォード法を実行し、樹形図で候補を比較します。運用上の目的と各群の人数を踏まえ、解釈できる分け方を選びます。
- 元の単位で群の特徴を確認する:標準化した値だけでなく、人数、購入回数、金額、購入間隔などの平均・中央値や分布を確認します。
- 施策の仮説を確かめる:「購入頻度は高いが1回の金額は小さい」といった観察から施策を考え、実施後の反応を測って判断します。
例えば、低い購入金額の群が見つかっても、それだけで「価格に敏感」とは言えません。利用し始めたばかりの顧客や、少量の商品だけが必要な顧客も含まれ得るためです。割引への反応やアンケートで確かめて初めて、価格重視という解釈に根拠ができます。同様に、高額購入の群を「品質重視」と呼ぶなら、購入商品の特性や選択理由も確認する必要があります。
顧客分析以外にも、次のような対象を整理する用途があります。
| 分野 | 分析する特徴量の例 | 結果の使いどころ |
|---|---|---|
| 製品開発・市場調査 | 価格、サイズ、性能、機能の評価値 | 似た製品群を整理し、競合製品や品ぞろえの検討材料にする |
| 画像の整理 | 色や形状、画像から抽出した数値特徴量 | 似た特徴の画像をまとめ、画像集合の傾向を調べる |
| 医療データの探索 | 患者の検査値や数値化した症状 | 共通する特徴を持つ集団を見つけ、追加分析の仮説にする |
| 金融データの探索 | 取引額、取引頻度、利用時間帯など | 似た取引傾向の集団を整理し、詳しく調べる対象を検討する |
医療や金融で得られるのも、選んだ特徴量が似ているという分析上のまとまりです。所属群だけで病気の診断、治療効果、不正の有無、返済能力が確定するわけではありません。それぞれの目的に対応した情報と検証を組み合わせて解釈します。
数値の基準で群分けできることと、分析が自動的に公平になることは別です。同じデータと設定なら結果を再現しやすい一方、誰をデータに含めたか、どの特徴量を選んだかが結果を左右します。群に名前を付ける際も、観察できた特徴と推測を区別すると、過度な決めつけを防げます。
標準化・外れ値・計算量の注意点
ウォード法を使う前に確認したいのは、数値としての距離が、分析したい「似ている」を表しているかどうかです。基本となる偏差平方和の考え方は、ユークリッド空間の数値データを前提にします。任意の距離尺度へそのまま置き換えると、平均からの二乗距離という説明が成立しなくなる場合があります。
カテゴリ変数にも注意が必要です。例えば地域に1・2・3という番号を付けても、地域3が地域1から地域2の2倍離れているという意味にはなりません。カテゴリを数値化する場合は、符号化によって生じる距離が目的に合うかを検討します。数値とカテゴリが混在するデータでは、別の距離尺度と、それに適したクラスタリング手法を組み合わせる方がよい場合もあります。
尺度と欠損値を整える
購入金額が数万円単位、購入回数が数回単位のデータをそのまま使うと、距離の計算は金額に強く左右されがちです。例えば金額の差が10,000円、回数の差が5回なら、それぞれを二乗した値は100,000,000と25になります。単位の違いだけで、購入回数の差がほとんど反映されなくなることがあります。
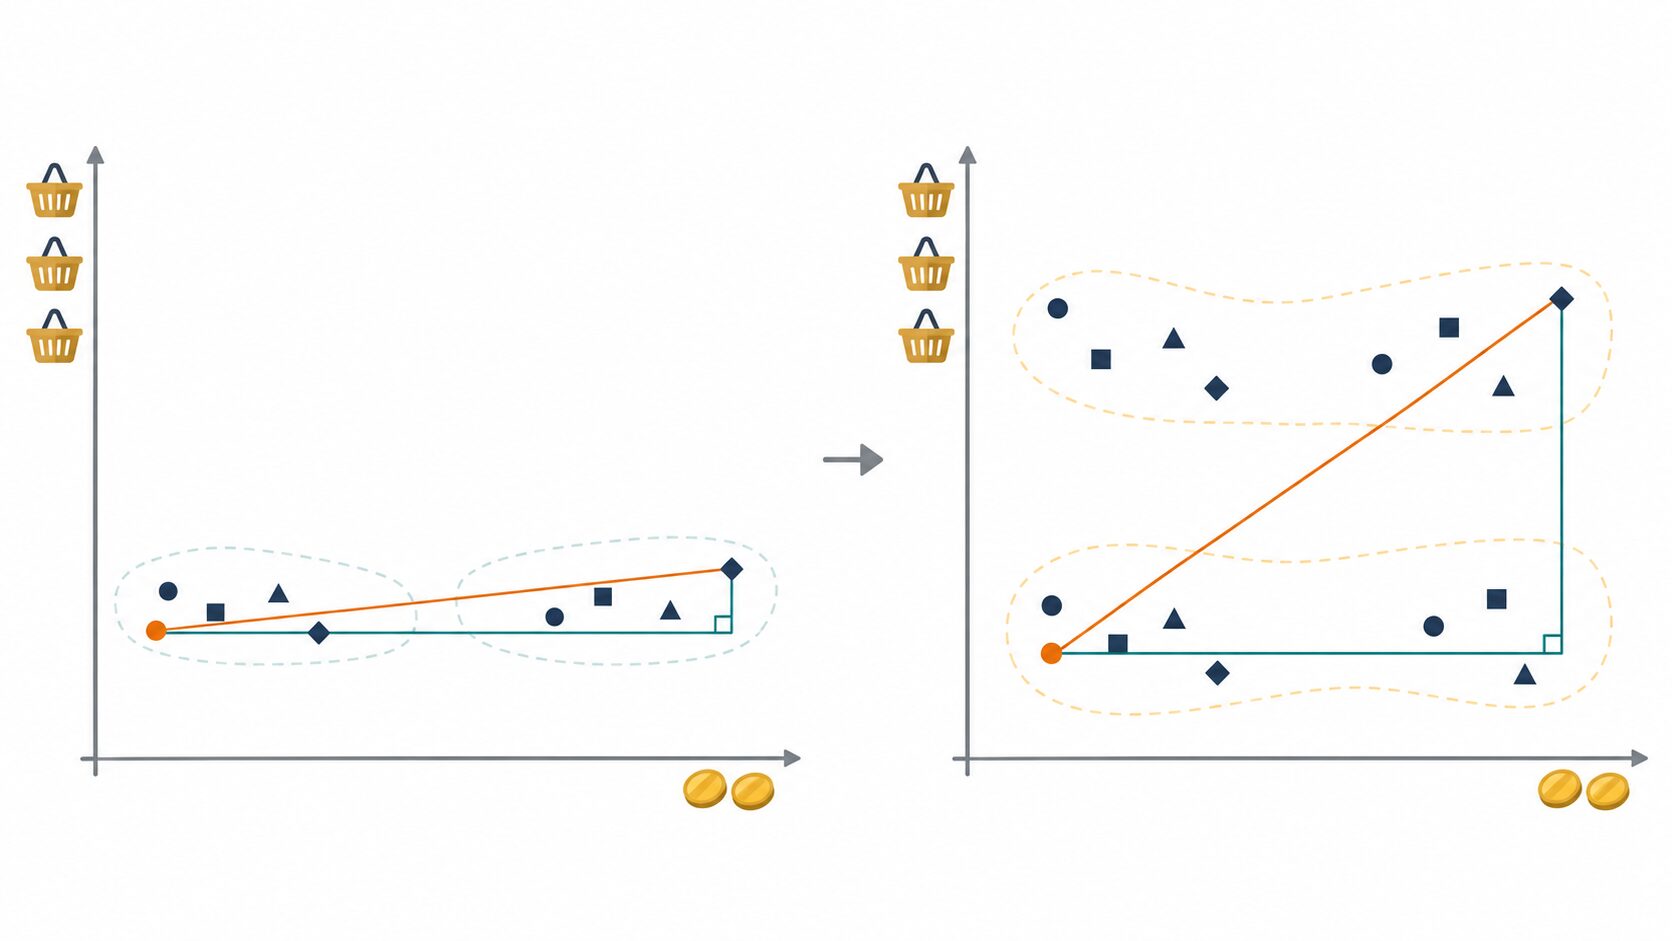
代表的な対処が、各特徴量から平均を引いて標準偏差で割る標準化です。尺度をそろえることで、金額と回数の相対的な違いを比較しやすくします。ただし、標準化すれば必ず適切になるわけではなく、何を重視して分けたいかに応じて尺度や重みを決める必要があります。金額の絶対差そのものが重要なら、その意味を保つ選択もあり得ます。欠損値についても、除外や補完の方法と、その方法が距離に与える影響を確認します。
外れ値とデータの形を確かめる
ウォード法では距離を二乗するため、平均から大きく離れた外れ値の影響が強くなります。極端な値を見つけたら、まず入力ミスなのか、実際に存在する重要な対象なのかを調べます。外れ値を含めるかどうか、値の変換を行うかによって群分けが変わるため、目的に沿った処理が必要です。
また、中心を囲むようなまとまりに比べ、細長い群や曲がった群では、期待する分け方にならない場合があります。密度や大きさが大きく異なる群でも、偏差平方和を抑える過程で、大きな集団を分けたり、近くの小さな集団をまとめたりすることがあります。元の対象の見た目ではなく、分析に使う特徴量の空間でどのように分布しているかを、散布図などで確認することが大切です。
データ量に合う実装を選ぶ
計算時間や必要なメモリは実装によって異なりますが、一般的な階層的クラスタリングでは、対象間の距離などを保持するために標本数の二乗規模のメモリを要する場合があります。この場合、対象数が10倍になると必要量はおよそ100倍になるため、「大量データでも常に高速」とは言えません。
対象が多い場合は、まず一部のデータで処理時間と結果の傾向を確かめ、階層全体が必要かを検討します。目的によっては、k-meansなど別の手法で全体を分ける、対象を絞って階層を詳しく調べるといった方法も候補になります。特徴量、尺度、分布、データ量を確認し、得られた群を具体的な言葉で説明できるかまで確かめることで、ウォード法の結果を分析や施策に結びつけやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月18日 | 結合コストの数値例と樹形図の読み方を補い、標準化・計算量の注意点を追記 |