

AIの初心者
「アルファ碁」は、囲碁で有名になったAIですよね。何が画期的だったのですか?

AI専門家
囲碁は次に打てる手が多く、先の展開をすべて計算するのが難しいゲームなんだ。アルファ碁は学習と探索を組み合わせ、2015年にプロ棋士のファン・フイ氏、2016年には世界トップ級のイ・セドル氏との対局で勝ち越したんだよ。
AIの初心者
計算が速いだけでは勝てないのですね。どうやって次の一手を選んだのですか?
AI専門家
棋譜から有望な手を学び、自己対戦で強さを磨き、対局中は候補となる手の先を調べたんだ。人間の直感に頼ると思われていた判断を、学習したモデルと探索で高い水準まで実現したことが大きかったんだよ。
アルファ碁(AlphaGo)は、DeepMindが開発した囲碁AIです。2015年にプロ棋士のファン・フイ氏に勝利し、2016年には世界トップ級のイ・セドル氏との五番勝負を4勝1敗で制しました。囲碁のように選択肢が膨大な問題でも、学習による判断と、先の展開を調べる探索を組み合わせれば、高い能力を発揮できることを示したのが大きな意義です。
この記事では、アルファ碁が何をするAIなのか、なぜ強かったのか、プロ棋士との対局がどのような意味を持ったのかを順に解説します。後継のAlphaGo Zero・AlphaZeroとの違いや、囲碁以外へ技術を応用するときの注意点も確認します。
アルファ碁(AlphaGo)とは
アルファ碁は、囲碁の盤面を入力として受け取り、次に打つ手を選ぶプログラムです。開発したDeepMindは、当時Google傘下のAI研究企業でした。囲碁のルールのもとで勝つことを目的に作られており、文章を書いたり、生活上の相談に答えたりするためのAIではありません。
歴史的な成果として知られるのは、通常の19路盤で、ハンディキャップなしにプロ棋士を破ったことです。「初めて人間に勝ったAI」という説明では条件が広すぎます。それ以前にもコンピューター囲碁は存在しており、人間とAIの対局の難しさは、盤の大きさや相手の実力、置き石などの条件によって変わるためです。
アルファ碁の登場が注目された理由は、対局の勝敗だけではありません。人間が一つずつ「この形ならこう打つ」とルールを書き込む方法だけに頼らず、大量の対局データと自己対戦から判断の仕方を学ばせた点にもあります。囲碁を題材として、機械学習が複雑な意思決定に使えることを示しました。
ただし、囲碁が強いことと、人間と同じ知能や意識を持つことは別です。アルファ碁は、目的とルールが定まった領域で能力を発揮する「特化型AI」の例として捉えると理解しやすくなります。
なぜ囲碁で勝つことが難しかったのか
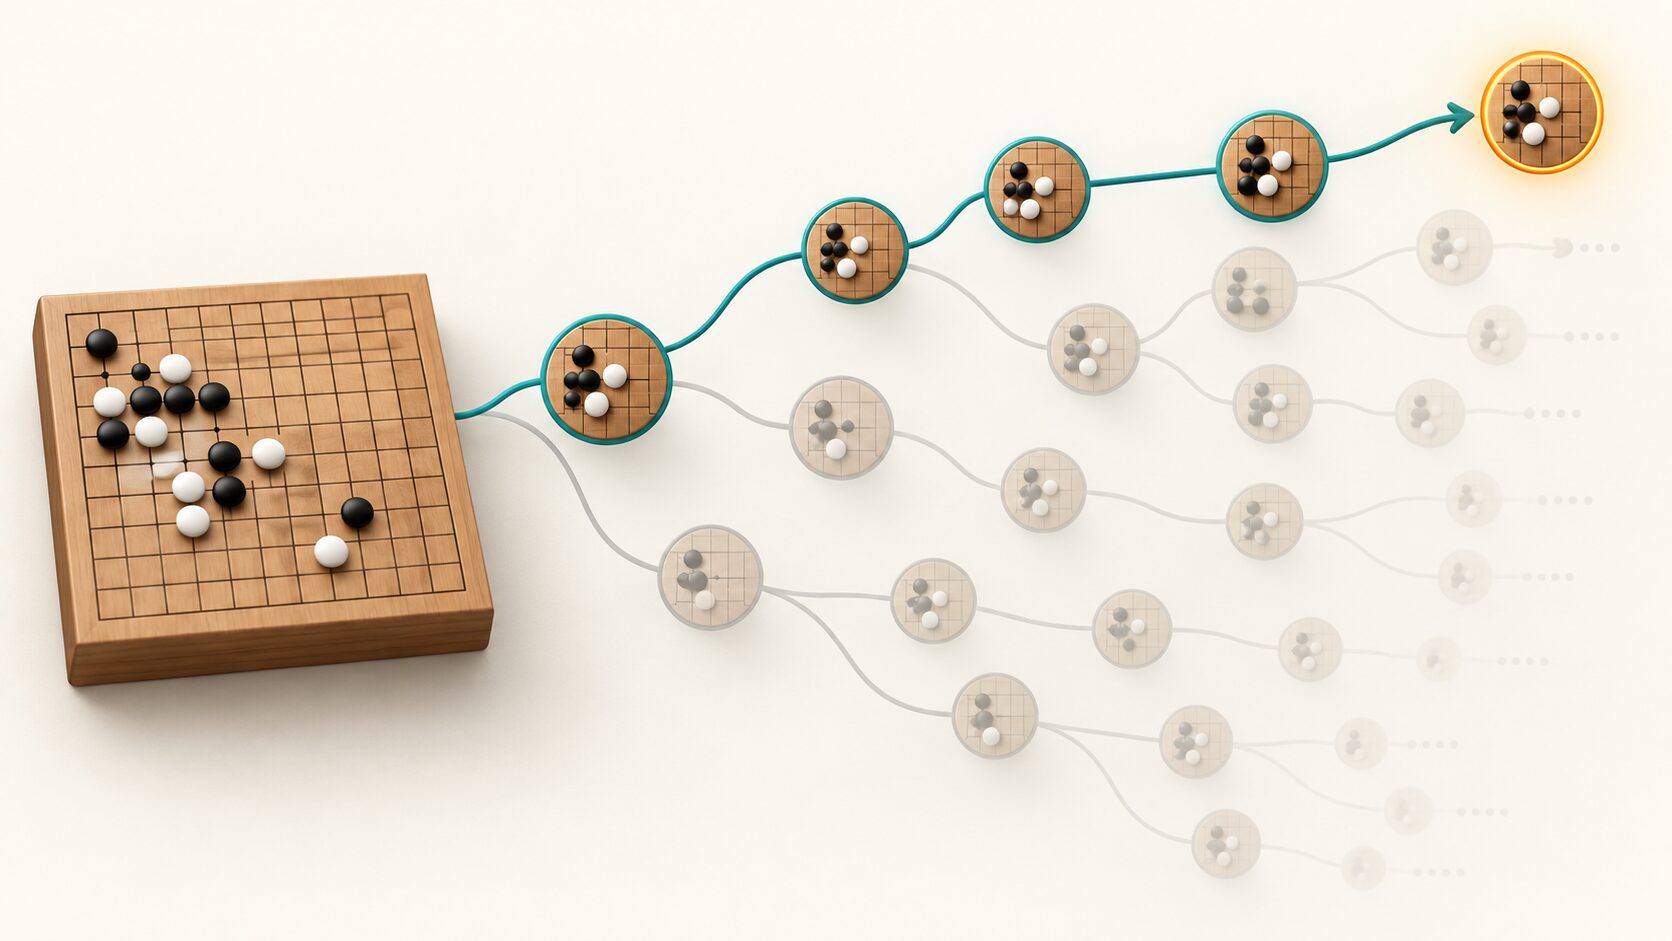
囲碁では、縦横19本の線が交わる361か所の交点に、黒石と白石を交互に置きます。基本的には、相手より広い領域を確保することを目指すゲームです。盤面には多くの候補手があり、一手進むたびに相手の応手、その次の自分の手へと可能性が枝分かれしていきます。
最初の候補をいくつか調べるだけなら難しくなくても、対局の終わりまで全パターンを調べようとすると、必要な計算は急激に増えます。さらに、打てる場所が多いだけでなく、途中の盤面でどちらが有利かを評価することも簡単ではありません。
例えば、目の前の相手の石を取る手が、必ずしも対局全体で最善とは限りません。石を取ることに手数を使う間に、相手が別の場所で広い陣地を築く場合もあります。局所的な得と盤面全体の見通しを比較する必要があり、ここに棋士の経験や大局観が生きます。
チェスや将棋でも探索は重要ですが、囲碁では多数の候補手と局面評価の難しさが大きな障壁でした。そこでアルファ碁は、すべての手を同じ深さまで調べるのではなく、有望な手に計算を集中させる方向へ進みました。学習したモデルで候補を絞り、盤面の勝ちやすさを見積もることが、その土台になっています。
アルファ碁の仕組み:深層学習・強化学習・探索
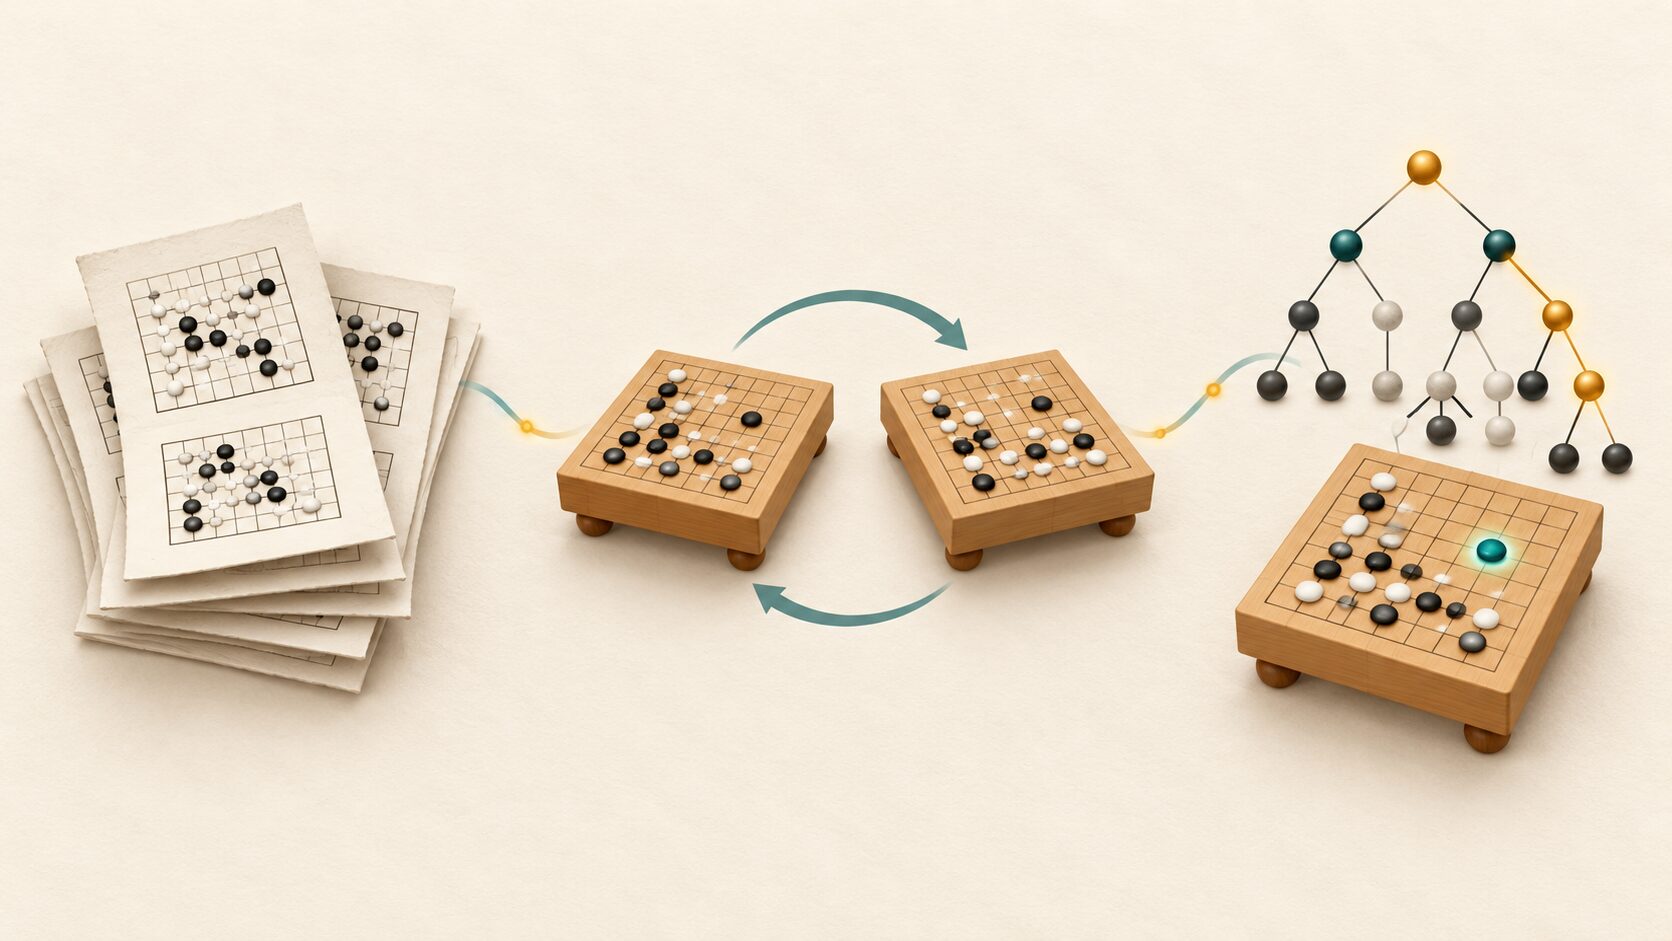
アルファ碁の強さは、一つの技術だけで説明できません。初期のアルファ碁では、人間の棋譜から学ぶ教師あり学習、自己対戦を通じた強化学習、対局中に候補手を調べる探索が組み合わされました。深層学習は、その中で盤面の特徴や着手の傾向を表現するために使われています。
深層学習とは、多層のニューラルネットワークを使い、データに含まれる特徴や規則性を学ぶ方法です。脳の神経回路から着想を得ていますが、人間の脳や思考をそのまま再現するものではありません。また、「深層学習」はモデルを使った学習手法を指し、「教師あり学習」「強化学習」は何を手がかりに学ぶかの違いを指すため、互いに排他的な分類ではありません。
| 技術・要素 | 役割 | 初心者向けの捉え方 |
|---|---|---|
| 教師あり学習 | 人間の棋譜から、盤面と次の着手の関係を学ぶ | 過去の対局例を使って、有望な手の選び方を身につける |
| 強化学習 | 自己対戦の勝敗などを手がかりに、勝ちやすい方策へ改善する | 対局の結果を振り返り、選び方を磨く |
| 方策ネットワーク | 各候補手がどれくらい有望かを示す | 「どこを重点的に調べるか」の目安を出す |
| 価値ネットワーク | ある局面から勝てる見込みを推定する | 「この盤面はどれくらい有利か」を見積もる |
| モンテカルロ木探索 | 候補手の先の展開を繰り返し調べ、評価を集めて着手を選ぶ | 限られた時間で有望な展開を重点的に読む |
学習の出発点では、人間の棋譜を使って「この盤面ではどの手が選ばれたか」を学びます。これにより、一から無作為に打つ場合よりも、意味のある候補を選びやすくなります。ただし、棋譜の着手をまねることと、勝つために最善の手を選ぶことは同じではありません。
そこで自己対戦を行い、勝敗という結果を手がかりに方策を改善します。これが強化学習です。「一度勝った対局の手は全部正しい」と扱うわけではなく、多くの経験から、どのような行動が良い結果につながりやすいかを統計的に学びます。価値ネットワークも、自己対戦で得られた局面と結果を使って、盤面から勝ちやすさを推定できるように学習します。
実際に一手を選ぶ場面では、方策ネットワークが示す有望度などを使いながら、探索を進めます。例えば、目先の石を取る手と、別の場所を守る手が候補なら、それぞれの先の応手を調べ、価値ネットワークなどによる評価を集めて比較します。初期のアルファ碁は、簡略化した方策で終局まで進めるシミュレーションも局面評価に利用しました。
ここで区別したいのは、経験からモデルを改善する「学習」と、そのモデルを使って目の前の一手を選ぶ「探索」です。対局中に先を読むたび、ニューラルネットワーク自体を学習し直しているわけではありません。両者を分けて考えると、アルファ碁がどの段階で強くなり、どの段階で計算を使うのかが見えてきます。
プロ棋士との対局:2015年と2016年の違い
アルファ碁の歴史を理解するうえで、ファン・フイ氏との対局と、イ・セドル氏との対局は分けて押さえる必要があります。前者は2015年10月、後者は2016年3月です。「2015年にイ・セドル氏へ勝利した」という説明は正しくありません。
| 時期 | 対戦相手 | アルファ碁の成績 | 主な意義 |
|---|---|---|---|
| 2015年10月 | 欧州囲碁王者のファン・フイ氏 | 5勝0敗 | 19路盤・ハンディキャップなしでプロ棋士を破った節目 |
| 2016年3月 | 世界トップ級の棋士、イ・セドル氏 | 4勝1敗 | 世界最高水準の棋士にも勝ち越せる実力を示した対局 |
2015年の結果は、囲碁AIがプロの水準に到達したことを示す重要な成果でした。さらに2016年の対局では、世界トップ級の棋士に対しても力を発揮し、AIの可能性が広く注目されました。段階の異なる二つの成果を区別すると、研究の進展を過不足なく捉えられます。
一方、イ・セドル氏は第4局で勝利しています。五番勝負を制したことは高い棋力の証拠ですが、常に最善手を選ぶ無敵のプログラムになったことを意味しません。学習した評価には誤りがあり、限られた時間で行う探索にも見落としが生じ得ます。
人間には意外に見える手が有効に働くことも、アルファ碁への関心を高めました。ただし、意外な着手だけを見て「人間と同じ発想で考えた」と判断することはできません。学習と探索による評価が、人間の経験則とは異なる選択につながる場合がある、と理解するのが適切です。
AlphaGo Zero・AlphaZeroとの違い
アルファ碁の発展を調べると、「AlphaGo Zero」と「AlphaZero」という似た名前も出てきます。どちらも2017年に発表された後続の研究ですが、初期のアルファ碁と学習の出発点や対象が異なります。
| 名称 | 学習の出発点 | 主な対象・特徴 |
|---|---|---|
| AlphaGo(初期) | 人間の棋譜を学び、自己対戦でも改善 | 囲碁。方策・価値のネットワークと探索を組み合わせる |
| AlphaGo Zero | 人間の棋譜を使わず、ルールのもとで自己対戦 | 囲碁。方策と価値を一つのネットワークで扱う |
| AlphaZero | 各ゲームのルールのもとで自己対戦 | 囲碁・チェス・将棋に共通する学習の枠組みを示す |
AlphaGo Zeroの重要な点は、人間の棋譜を学習の手本としなくても、自己対戦から強い方策を獲得できたことです。ただし、「人間の知識が何も要らない」という意味ではありません。囲碁のルール、勝敗の定義、学習を行う仕組みや計算環境は、人間が用意しています。
AlphaZeroは、その考え方を囲碁以外のゲームにも広げました。共通の学習方法が複数のゲームで機能することは重要ですが、一度囲碁を覚えただけで、あらゆる仕事ができるようになったわけではありません。ゲームごとの学習が必要であり、日常のあらゆる課題に対応する汎用AIとは区別されます。
こうした違いを押さえると、初期AlphaGoの「棋譜から学ぶ」説明を、そのままAlphaGo Zeroにも当てはめる誤解を防げます。名前が似ていても、何を学習材料にし、何を成果として示したのかを確認することが大切です。
アルファ碁がAI研究と社会に与えた影響
アルファ碁の成功は、学習したモデルと探索を組み合わせることで、複雑な意思決定を扱える可能性を広く示しました。囲碁に詳しくない人にとっても、AIが単純な計算の速さだけで評価されるものではないと知るきっかけになりました。
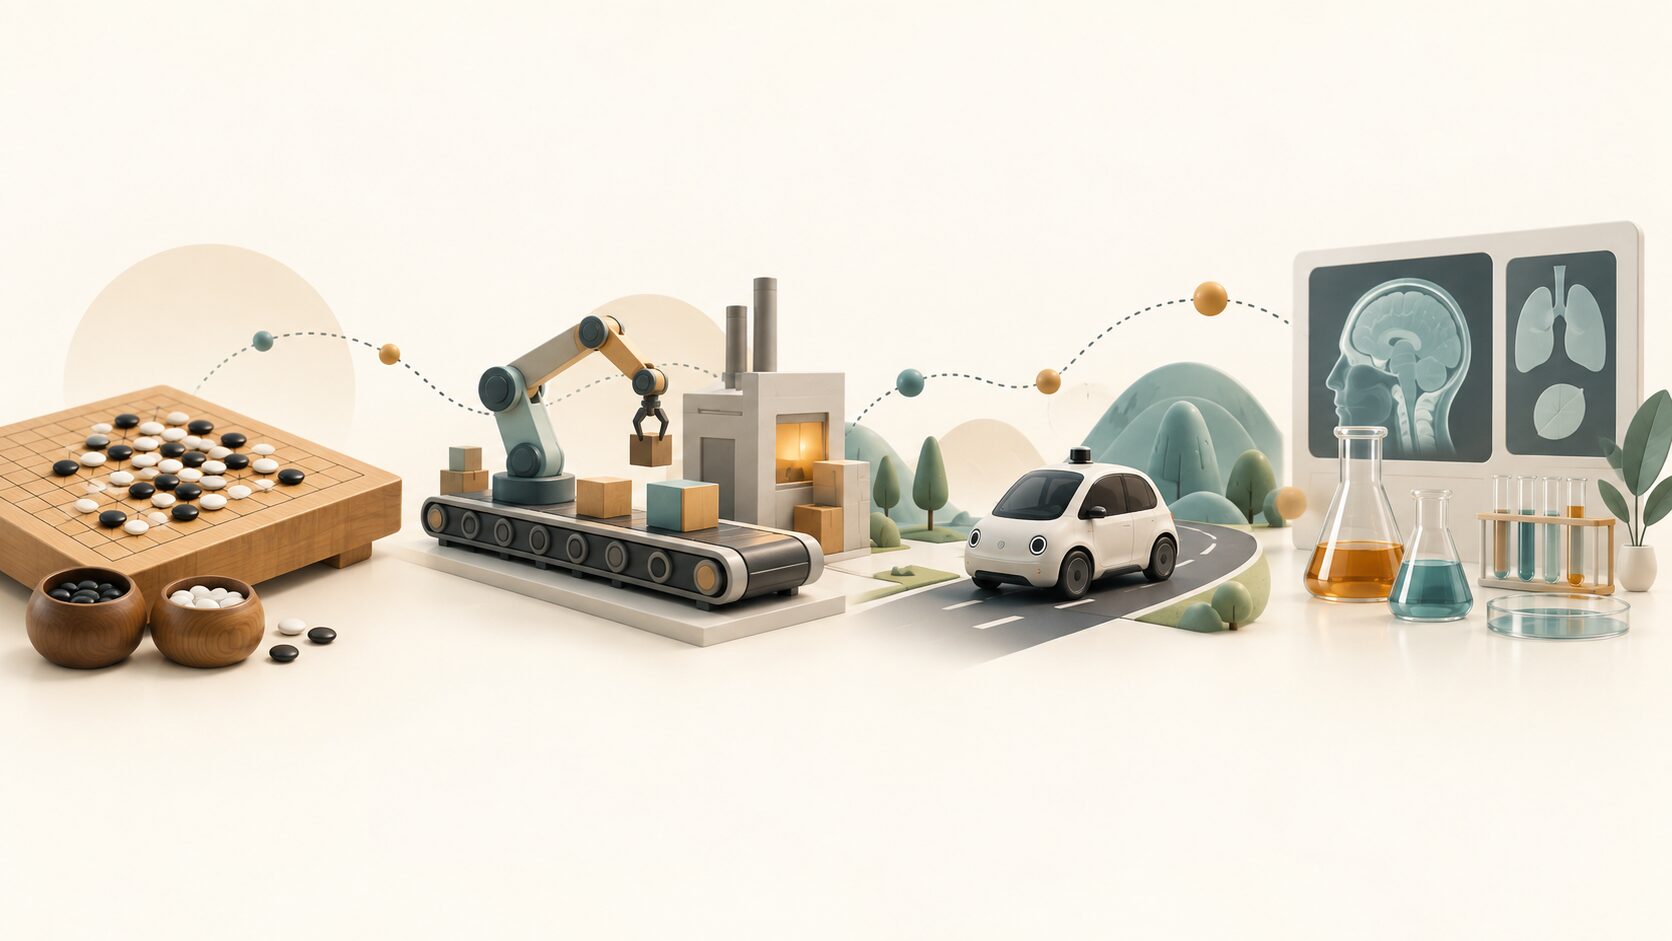
囲碁以外では、画像認識、予測、制御、最適化など、目的に応じてさまざまなAI技術が研究・利用されています。上の図は関連する研究分野を表す概念図です。アルファ碁という囲碁プログラムが、そのまま自動運転や医療に使われていることを示すものではありません。
| 分野 | AIに期待される役割 | 囲碁との違い・注意点 |
|---|---|---|
| 工場・生産計画 | 設備の動かし方や作業順序の最適化 | 生産量だけでなく、安全性、故障、資源の制約も考える必要がある |
| 自動運転 | 周囲の認識や行動選択の支援・研究 | 他者の行動や見えない情報があり、現実で自由に試行錯誤できない |
| 画像診断・創薬 | 画像の特徴抽出や候補物質の探索など | 用途ごとの検証が必要で、すべてが強化学習で実現されるわけではない |
| 金融・災害予測 | データからの予測や判断材料の提示 | 環境が変わるため、過去のデータで高精度でも将来の正しさは保証されない |
例えば、画像から特徴を見つける仕事では深層学習が役立ちますが、それだけで自己対戦や強化学習を使っているとは言えません。一方、工場で設備の動かし方を連続的に選ぶような課題は、状態・行動・結果という強化学習の考え方と結び付けて検討できます。
ただし、これらの分野の進歩をすべてアルファ碁の直接的な成果とするのは適切ではありません。各分野には独自の研究の蓄積があります。アルファ碁の影響は、特定の成功事例を通じて研究の可能性を具体的に示し、学習と意思決定への関心を高めたこととして捉えると正確です。
AIを仕事や学習に取り入れる際は、「何を入力し、何を選び、何を良い結果とみなすのか」を先に整理すると役立ちます。囲碁では勝敗が明確ですが、現実には費用、品質、安全、利用者の納得など、同時に考えるべき評価軸があるからです。
アルファ碁から学ぶAIの限界と人間の役割
アルファ碁の成果は大きいものの、それだけで「AIが人間の知性をすべて超えた」「シンギュラリティが目前だ」と結論付けることはできません。囲碁での能力は、明確なルール、観測できる盤面、判定可能な勝敗、大量の自己対戦が可能な環境に支えられています。
現実の仕事では、この条件がそろわないことが珍しくありません。必要な情報が欠けたり、何が成功かについて人によって意見が分かれたりします。安全に試せるシミュレーションがあっても、そこで学んだ振る舞いが実際の環境で同じように機能するかは、別途確かめる必要があります。
例えば、工場のAIに「生産量を最大にする」ことだけを求めると、保守や作業者への負担が評価から抜け落ちるおそれがあります。AIが指標を改善できることと、その指標が人間にとって適切であることは別です。目的や制約を決め、出力を点検し、問題が起きたときの対応を用意する役割は欠かせません。
プライバシーについても、囲碁の自己対戦と、個人情報を含む実社会のデータでは事情が異なります。どのデータを何の目的で使うのか、誰がアクセスできるのかを考える必要があります。雇用への影響も、ある作業の自動化がそのまま職業全体の代替を意味するとは限らず、作業の組み合わせや責任の所在を見直す視点が重要になります。
人間の役割を考える際は、「創造性や共感はAIには絶対にできない」と固定的に区切るより、利用者の意図を理解し、価値観の違いを調整し、判断の理由を説明して責任を持つことに目を向けると実践的です。アルファ碁の事例は、AIの得意な条件を理解し、人間が利用目的を設計することの大切さも教えてくれます。
まとめ:アルファ碁の衝撃をどう捉えるか
アルファ碁は、囲碁で有望な手や局面の価値を学習し、探索と組み合わせることで、プロ棋士を上回る成績を示したAIです。2015年のファン・フイ戦と2016年のイ・セドル戦は、その進歩を示す異なる節目でした。
理解の要点は、棋譜から学ぶこと、自己対戦で改善すること、対局中に候補手の先を調べることの違いです。後継のAlphaGo ZeroやAlphaZeroは、学習の出発点や対象を広げましたが、囲碁での成功だけで万能な知能が実現したわけではありません。
アルファ碁の衝撃は、経験や直感が重要とされた領域でも、学習と探索が強い判断につながることを示した点にあります。その成果を現実の課題に生かすには、目的、データ、評価方法、運用上の制約を確かめながら使うことが大切です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月26日 | 対局年表を修正し、学習と探索の役割、後継技術との違いを追記 |